

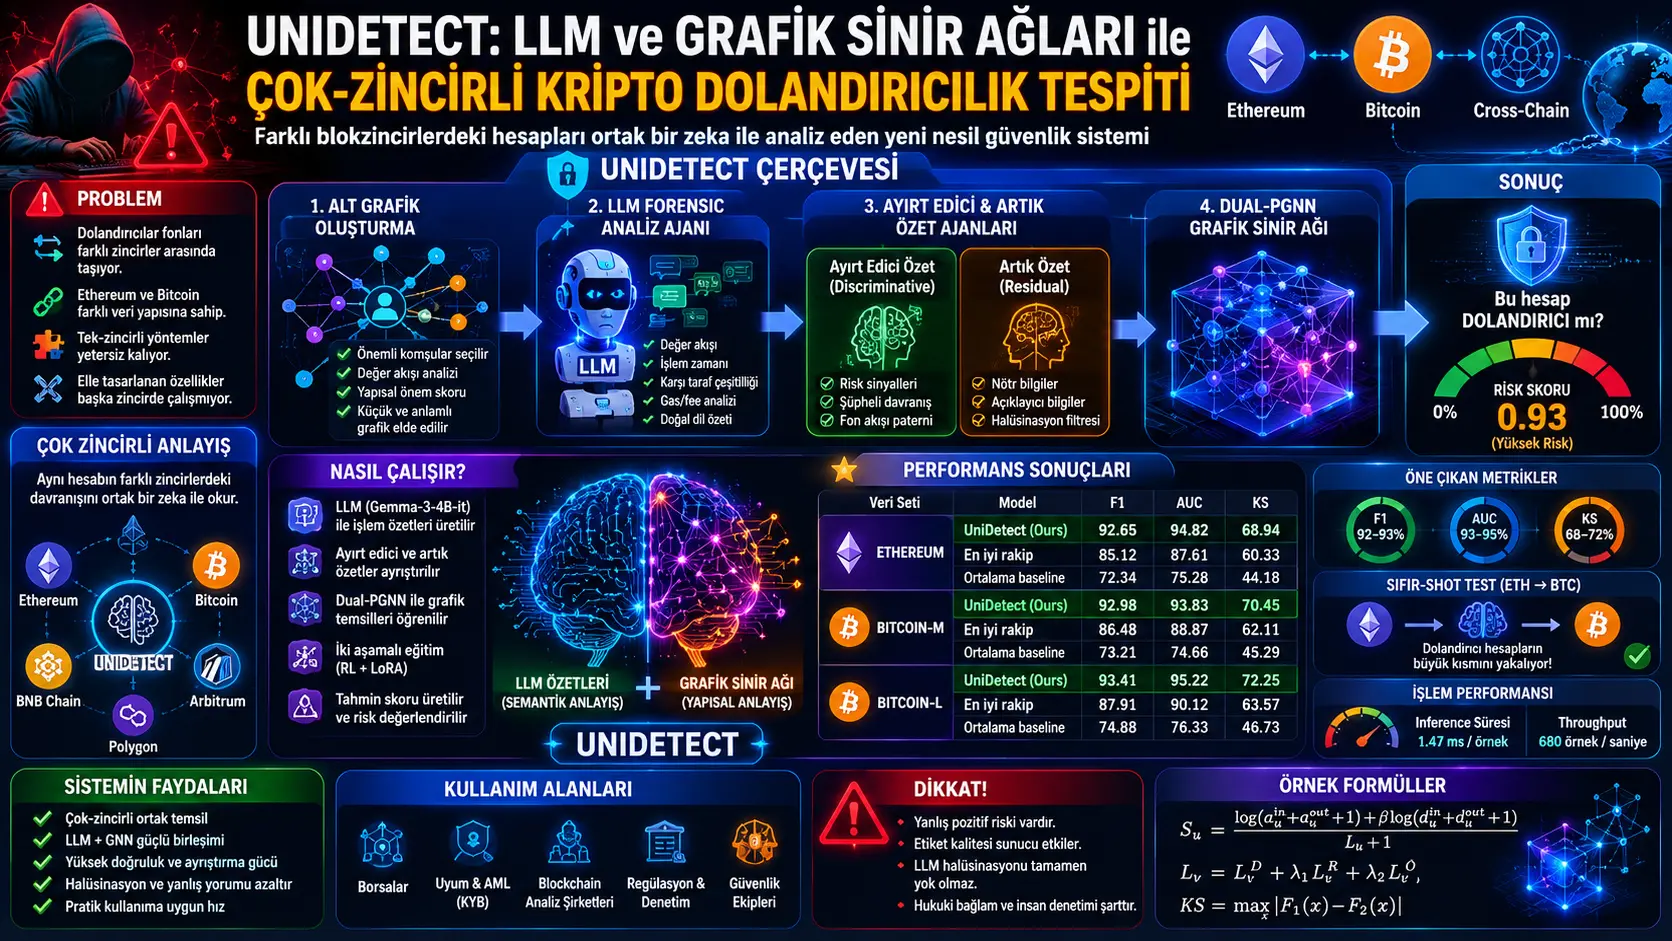
Kripto para ekosisteminde dolandırıcı hesapları tespit etmek giderek zorlaşıyor. Bunun önemli nedenlerinden biri, suç amaçlı fonların artık tek bir zincirde kalmaması. Cross-chain köprüler, merkeziyetsiz finans protokolleri ve farklı varlıklar arasında dönüşüm imkânı, fonların bir blokzincirden diğerine taşınmasını kolaylaştırıyor. Bu durum, yalnızca Ethereum, Bitcoin veya tek bir zincire özel tasarlanmış tespit sistemlerini zayıflatabiliyor.
Bu çalışma, UniDetect adlı çok-zincirli bir dolandırıcı hesap tespit yöntemi öneriyor. Sistem, işlem grafiğini analiz eden grafik sinir ağlarıyla büyük dil modellerinin ürettiği işlem özetlerini birleştiriyor. Amaç, farklı blokzincirlerdeki heterojen işlem yapılarını ortak ve anlaşılabilir bir temsil hâline getirmek.
UniDetect, önce hesap merkezli alt grafikler oluşturuyor. Ardından bir LLM tabanlı forensic analysis agent, hesabın işlem geçmişini değer akışı, işlem zamanı, karşı taraf çeşitliliği ve gas harcaması gibi boyutlarda özetliyor. Daha sonra iki ayrı özet analiz ajanı devreye giriyor: biri dolandırıcılık tespiti için ayırt edici bilgileri çıkarıyor, diğeri ise görevle doğrudan ilişkili olmayan artık/factual bilgileri ayırıyor. Bu özetler, Dual-PGNN adlı çift yollu grafik sinir ağına node feature olarak veriliyor.
Çalışmanın raporladığı sonuçlara göre UniDetect, Ethereum, Bitcoin-M ve Bitcoin-L veri setlerinde klasik grafik öğrenme yöntemleri, tek-zincirli tespit yöntemleri ve mevcut çok-zincirli yaklaşımların çoğundan daha iyi performans gösteriyor. Ayrıca Ethereum’da eğitilip Bitcoin üzerinde sıfır-shot test edildiğinde dolandırıcı hesapların büyük kısmını yakalayabildiği belirtiliyor. Ancak bu tür sistemler yanlış pozitif riski taşıdığı için, gerçek kullanımda insan denetimi ve hukuki bağlamla birlikte değerlendirilmelidir.
Problem Ne?
Blokzincirler açık işlem kayıtları sunduğu için, teoride dolandırıcılık tespiti için güçlü veri sağlar. Ancak pratikte birkaç temel zorluk vardır.
Birinci sorun zincir heterojenliğidir. Ethereum hesap tabanlı çalışır; Bitcoin ise UTXO modeline dayanır. İşlem alanları, adres davranışları, gas/fee bilgisi, input-output yapısı ve işlem semantiği zincirden zincire değişir. Bu nedenle bir zincir için elle tasarlanmış özellikler başka zincirde aynı anlamı taşımayabilir.
İkinci sorun cross-chain kaçış davranışıdır. Dolandırıcılar fonları birden fazla zincir arasında taşıyabilir, farklı tokenlara dönüştürebilir veya köprüler ve DeFi protokolleriyle izleri dağıtabilir. Böyle bir durumda tek-zincir odaklı izleme sistemleri, davranışın tamamını göremeyebilir.
Üçüncü sorun veri modalitesidir. Blokzincir verisi sadece sayısal işlem miktarlarından ibaret değildir. İşlem frekansı, fon akışı, karşı taraf çeşitliliği, zamanlama, gas kullanımı, input data mesajları, graph topology ve adres etkileşimleri birlikte anlam taşır. Bu nedenle yalnızca sayısal tablo veya yalnızca grafik yapısı yeterli olmayabilir.
Dördüncü sorun LLM güvenilirliğidir. Büyük dil modelleri işlem özetlerini anlamlandırmada güçlü olabilir; fakat halüsinasyon, aşırı yorum, unsupported risk çıkarımı ve yanlış pozitif üretme riski taşır. Dolandırıcılık tespiti gibi hassas bir alanda, modelin “kanıta dayalı” olmayan yorumlar üretmesi ciddi güven sorunu yaratır.
Makalenin çözmeye çalıştığı ana problem şudur: Farklı blokzincirlerden gelen karmaşık işlem verilerini, hem grafik yapısını hem de işlem semantiğini koruyacak şekilde ortak bir dolandırıcılık tespit çerçevesinde nasıl birleştirebiliriz?
Yöntem Ne Öneriyor?
UniDetect’in yöntemi dört ana parçaya ayrılabilir.
1. Hesap merkezli alt grafik oluşturma: Tüm zincir grafiğini doğrudan modele vermek çok maliyetli olduğu için, hedef hesabın çevresindeki önemli komşular seçilir. Bu seçimde ortalama işlem değeri gibi davranışsal sinyaller kullanılır. Daha sonra yapısal önem skoruyla gereksiz düğümler elenir ve daha küçük ama anlamlı bir alt grafik elde edilir.
2. LLM tabanlı işlem özeti üretimi: Forensic analysis agent, her hesabın işlem geçmişini doğal dil özetine dönüştürür. Bu özet; değer akışı, partner oranı, işlem zamanı ve gas harcaması gibi boyutları kapsar. Böylece farklı zincirlerin teknik farklılıkları daha ortak bir semantik dile çevrilir.
3. Discriminative ve residual summary ayrımı: İlk özetin tamamı dolandırıcılık tespiti için aynı değerde değildir. Bu nedenle discriminative summary analyst agent, dolandırıcılık açısından ayırt edici olabilecek fon akışı, çoklu karşı taraf etkileşimi, yoğun işlem davranışı ve riskli adreslerle ilişki gibi sinyalleri çıkarır. Residual summary analyst agent ise doğrudan sınıflandırmaya katkı sağlamayan, daha çok açıklayıcı veya nötr bilgileri ayırır.
4. İki aşamalı dönüşümlü eğitim: İlk aşamada LLM tabanlı özet ajanları, özet kalitesini artırmak için LoRA ve reinforcement learning ile ince ayar görür. İkinci aşamada LLM dondurulur ve grafik modeli eğitilir. Böylece hem dilsel özetler hem de işlem grafiği temsilleri birbirini besleyen bir sistem hâline gelir.
Bu yaklaşımın ana fikri şudur: LLM, işlem geçmişini okunabilir ve semantik olarak zengin bir özet hâline getirir; grafik sinir ağı ise hesabın ağ içindeki davranışsal ve yapısal konumunu öğrenir. UniDetect bu iki kanalı birlikte kullanarak daha genel bir çok-zincirli dolandırıcılık tespit sistemi kurmaya çalışır.
Formüller Ne Anlatıyor?
PDF’teki formüller; işlem grafiği tanımı, alt grafik örnekleme, yapısal önem skoru, üçlü kayıp fonksiyonu, reinforcement learning tabanlı özet iyileştirme ve Dual-PGNN temsil öğrenmesini anlatıyor. Formüller MathJax uyumlu olarak aşağıda verilmiştir.
1. İşlem grafiği veri modeli
Burada \(G\), işlem grafiğini temsil eder. \(V\), hesap düğümleri kümesidir. \(E\), hesaplar arasındaki yönlü işlem kenarlarını gösterir. Kripto para işlemlerinde bir adresin diğer adrese fon göndermesi, grafikte yönlü kenar olarak modellenir.
\(X_E\), kenar özellik matrisidir. \(m\), işlem kenarı sayısını; \(d\), her kenar için kullanılan özellik boyutunu temsil eder. Bu özellikler işlem miktarı, işlem frekansı, fee/gas gibi zincire göre değişebilen ayrıntıları içerebilir.
2. Dolandırıcı hesap tespit görevi
Bu formül, görevin node classification olarak kurulduğunu gösterir. Bazı hesapların etiketleri \(Y_L\) bilinir; modelin amacı etiketsiz hesapların \(Y_U\) etiketlerini, yani normal mi dolandırıcı mı olduklarını tahmin etmektir.
3. Semantics-aware komşu örnekleme
Bu formül, hedef hesabın çevresinden hangi komşuların seçileceğini gösterir. \(N_v\), \(v\) düğümünün bir-hop komşularıdır. \(K\), her hop için seçilecek komşu sayısıdır. \(R[v,N_v]\), aday komşularla ortalama işlem değerini temsil eder. Böylece yüksek değerli veya davranış açısından önemli etkileşimler önceliklendirilir.
\(C_v\), hedef hesap \(v\) etrafında \(h\)-hop örnekleme ile elde edilen düğüm kümesidir. Bu küme, hesabın işlem çevresini temsil eden account-centered subgraph için temel oluşturur.
4. Yapısal önem skoru
Bu formül, komşu düğüm \(u\)’nun yapısal önemini hesaplar. \(a_u^{in}\) ve \(a_u^{out}\), düğümün gelen ve giden işlem tutarlarını; \(d_u^{in}\) ve \(d_u^{out}\), gelen ve giden derece sayılarını gösterir. \(L_u\), hedef düğüme en kısa yol uzaklığıdır. \(\beta\), parasal davranış ile yapısal bağlantı sinyali arasındaki dengeyi kontrol eder.
Skor yüksekse düğüm daha önemli kabul edilir. Ancak yalnızca yüksek bağlantılı olmak her zaman dolandırıcılık sinyali değildir; borsalar veya büyük servis cüzdanları da yüksek bağlantılı olabilir. Bu nedenle makale \(\beta\) ayarının dikkatli seçilmesi gerektiğini gösterir.
5. Discriminative summary kaybı
Bu kayıp, discriminative summary kullanılarak yapılan sınıflandırmanın gerçek etiketle ne kadar uyumlu olduğunu ölçer. \(p_v^D\), discriminative summary’den elde edilen tahmin olasılığıdır. Amaç, dolandırıcılık tespiti için ayırt edici özetlerin sınıflandırma başarısını artırmasıdır.
6. Residual summary kaybı
Residual summary, doğrudan dolandırıcılık tespiti için ayırt edici olmaması beklenen bilgileri temsil eder. Bu nedenle model, residual özetin sınıflandırmada güçlü bir yön vermesini istemez. \(U_v\), uniform dağılımdır. Bu kayıp, residual özetin tahmininin mümkün olduğunca nötr kalmasını hedefler.
7. Ortogonallik kaybı
Bu formül, discriminative ve residual temsilin birbirine karışmasını engellemeye çalışır. Eğer iki temsil birbirine çok benzer hâle gelirse, ayırt edici sinyal ile nötr/factual bilgi ayrımı zayıflar. Ortogonallik kaybı bu karışmayı azaltmak için kullanılır.
8. Üçlü toplam kayıp
UniDetect, özet kalitesini üç açıdan kontrol eder: dolandırıcılık tespitine yardımcı olan discriminative bilgi, nötr kalması beklenen residual bilgi ve bu iki temsilin birbirinden ayrışması. \(\lambda_1\) ve \(\lambda_2\), residual kayıp ve ortogonallik kaybının ağırlıklarını belirler.
9. RL ödülü
Toplam kayıp düşükse ödül yüksek olur. Bu ödül, LLM tabanlı summary analyst agent’ın daha iyi özet üretmesini teşvik etmek için kullanılır.
10. Advantage hesabı
\(b_t\), eğitim adımındaki exponential moving-average baseline’dır. Reward’dan baseline çıkarılarak avantaj değeri elde edilir. Bu, RL eğitiminde varyansı azaltmaya ve eğitimi daha kararlı hâle getirmeye yardımcı olur.
11. RL hedef fonksiyonu
Bu formül, discriminative ve residual summary üretim olasılıklarını ödülle ilişkilendirir. İyi özet üreten ajanlar daha yüksek ödül alır; zayıf veya gereksiz özetler üreten ajanlar cezalandırılır.
12. Dual-PGNN node temsil üretimi
İlk formül, discriminative veya residual özetlerden grafik tabanlı node temsili üretir. İkinci formül, orijinal işlem özetinden ayrı bir temsil üretir. Burada \(A_v\), hedef hesap etrafındaki alt grafiğin adjacency matrisidir. \(\theta(\cdot)\), özelliğin kendisini koruyan doğrusal bir katmandır.
13. Attention ile temsil füzyonu
Bu formül, discriminative/residual özet temsili ile orijinal özet temsilinin attention ağırlıklarıyla birleştirildiğini gösterir. \(W_1\) ve \(W_2\), iki bilgi kanalının göreli önemini öğrenen parametrelerdir.
14. KS metriği
KS metriği, kredi skorlama ve risk modellemede sık kullanılan bir ayrıştırma ölçüsüdür. Burada normal ve dolandırıcı hesapların skor dağılımlarının ne kadar ayrıştığını gösterir. KS ne kadar yüksekse, modelin iki sınıfı ayırma kapasitesi o kadar güçlü kabul edilir.
Grafik, Tablo ve Şema Ana Mesajı
Sayfa 1’deki Figure 1: Görsel, klasik zincir-özel dolandırıcılık tespit yöntemleriyle UniDetect’i karşılaştırıyor. Geleneksel yöntemler Bitcoin veya Ethereum gibi tek zincire özel kurallar ve özellikler kullanırken, UniDetect LLM tabanlı işlem özetleriyle çok-zincirli ortak temsil üretmeye çalışıyor. Ana mesaj: Zincire özel feature engineering yerine, zincirler arası ortak semantik ve grafiksel temsil hedefleniyor.
Sayfa 4’teki Figure 2: UniDetect’in genel çerçevesi gösteriliyor. Sol tarafta alt grafik oluşturma ve transaction summary generation adımları var. Orta bölümde iki aşamalı eğitim yapısı bulunuyor: Stage 1’de özet ajanları eğitiliyor, Stage 2’de graph inference training yapılıyor. Alt tarafta inference aşamasında sistemin “bu hesap dolandırıcı mı?” sorusuna olasılıksal cevap verdiği gösteriliyor.
Sayfa 4–5’teki prompt şablonları: Forensics analyst agent, işlem verisini değer akışı, partner oranı, işlem zamanı ve gas harcaması üzerinden özetliyor. Discriminative summary agent, dolandırıcılık açısından ayırt edici işlem kalıplarını çıkarıyor. Residual summary agent ise doğrudan risk yargısı taşımayan factual bilgileri ayırıyor. Ana mesaj, LLM’in serbestçe yorum yapması değil, kanıta dayalı ve görev odaklı özet üretmesidir.
Sayfa 6’daki veri seti tablosu: Ethereum veri setinde 187.960 node, 397.038 edge, 1.991 fraud ve 1.439 normal hesap bulunuyor. Bitcoin-M veri setinde 2.505.841 node ve 14.181.316 edge; Bitcoin-L veri setinde ise 20.085.231 node ve 203.419.765 edge yer alıyor. Bu tablo, yöntemin küçük bir oyuncak veri setinde değil, büyük ölçekli grafiklerde test edildiğini gösteriyor.
Sayfa 7’deki Ethereum sonuç tablosu: UniDetect, Ethereum üzerinde Precision 91.39, Recall 93.95, F1 92.65, AUC 94.82 ve KS 68.94 değerleriyle en iyi sonucu veriyor. UniDetect’in sıfır-shot LLM kullanılan versiyonu da güçlü sonuç veriyor; ancak fine-tuning ve iki aşamalı eğitim tam modelde belirgin ek kazanç sağlıyor.
Sayfa 8’deki Bitcoin-M ve Bitcoin-L sonuç tablosu: UniDetect, Bitcoin-M’de F1 92.98, AUC 93.83, KS 70.45; Bitcoin-L’de F1 93.41, AUC 95.22, KS 72.25 sonuçlarını veriyor. Ana mesaj, yöntemin yalnızca Ethereum’a özel kalmadığı, Bitcoin veri yapılarında da güçlü performans sergilediğidir.
Sayfa 8’deki hyperparameter duyarlılık grafikleri: \(N_c\), \(\beta\), \(\lambda_1\) ve \(\lambda_2\) değiştikçe performansın nasıl etkilendiği gösteriliyor. Model geniş bir aralıkta istikrarlı görünse de çok küçük veya çok büyük parametrelerin performansı bozabileceği belirtiliyor. Özellikle \(\beta\) çok büyürse yüksek bağlantılı ama masum servis cüzdanları modele fazla önemli görünebilir.
Sayfa 8’deki ablation tablosu: Model bileşenleri çıkarıldığında performans değişiyor. Residual agent çıkarıldığında F1’in 78.37’ye düşmesi, residual/discriminative ayrımının önemli olduğunu gösteriyor. RL kaldırıldığında ve Dual-PGNN yerine standart GNN kullanıldığında da performans düşüyor.
Sayfa 9’daki verimlilik tablosu: Alt grafik oluşturma ortalama 1.26 saniye/samples, inference 1.47 ms/sample, throughput 680 sample/s olarak raporlanıyor. LLM tabanlı eğitim maliyetli olsa da inference aşamasında sistemin pratik konuşlandırmaya yakın olduğu savunuluyor.
Sayfa 13’teki RL convergence grafiği: Ödül eğrisinin ilk 50 adım içinde hızlı yükseldiği ve 0.5–0.6 bandında dengelendiği gösteriliyor. Makale bunu RL tabanlı LLM fine-tuning sürecinin çökmeden kararlı ilerlediğine dair destekleyici kanıt olarak sunuyor.
Deneyler Nasıl Yapılmış?
Çalışma Ethereum ve Bitcoin üzerinde deney yapıyor. Ethereum tarafında dolandırıcı etiketleri Etherscan label cloud, XLabelCloud ve CryptoScamDB gibi kaynaklardan alınmış. Phishing, Upbit vulnerability attack, gambling ve honeypot gibi yasa dışı veya riskli hesap türleri kapsanmış. Miner ve finansal hizmet sağlayıcıları gibi bilinen özel kimlik hesapları ise benign olarak değerlendirilmiş.
Ethereum işlemleri 7 Ağustos 2015 ile 10 Nisan 2025 arasından toplanmış. Sıfır miktarlı ve başarısız işlemler çıkarılmış. Gönderici ve alıcı hesaplar arasında yönlü işlem grafiği kurulmuş. Tekrarlanan transferlerde aynı hesap çifti arasındaki işlemler tek kenarda toplanarak kümülatif transfer miktarı ve işlem frekansı gibi özellikler kullanılmış.
Bitcoin tarafında iki veri seti kullanılmış: Bitcoin-M ve Bitcoin-L. Bitcoin-M, Haziran 2015 öncesindeki ilk 1.5 milyon işlemi kapsıyor. Bitcoin-L, Haziran–Eylül 2015 arasındaki tüm işlemleri içeriyor. Bitcoin veri setlerinde gambling ve mixing servisleriyle ilişkili adresler dolandırıcılık veya yasa dışı faaliyetle bağlantılı pozitif sınıf olarak ele alınmış.
Model, eğitim/doğrulama/test için 8:1:1 oranında bölünmüş. Karşılaştırma için DeepWalk, Node2Vec, GCN, GAT, GIN, GraphSAGE, APPNP, CARE-GNN, BWGNN, GRIT, DGA-GNN, PMP, Trans2Vec, TSGN, Ethident, TEGDetector, SIGTRAN, BERT4ETH ve DIAM gibi 20 baseline yöntem kullanılmış.
UniDetect tarafında 2-hop komşu örnekleme yapılmış ve her hop için en fazla \(K=10\) komşu tutulmuş. Sıkıştırma sonrası final alt grafik boyutu \(N_c=10\) olarak ayarlanmış. LLM omurgası olarak Gemma-3-4B-it, embedding için Sentence-BERT, grafik omurgası olarak CARE-GNN tabanlı Dual-PGNN kullanılmış. Eğitimde LoRA ile parametre verimli ince ayar yapılmış.
Değerlendirme metrikleri Precision, Recall, F1, AUC ve KS olarak belirlenmiş. Ayrıca cross-chain zero-shot testte Ethereum’da eğitilen model Bitcoin’e uygulanmış; cross-domain transfer testinde ise Instagram sosyal ağ veri setinde business account sınıflandırması denenmiş.
Sonuçlar Ne Gösteriyor?
1. UniDetect Ethereum’da güçlü performans veriyor. Ethereum veri setinde UniDetect F1 92.65, AUC 94.82 ve KS 68.94 değerlerine ulaşıyor. Bu sonuçlar, manuel feature engineering kullanan tek-zincirli yöntemlere ve genel grafik öğrenme modellerine göre belirgin iyileşme gösteriyor.
2. Bitcoin veri setlerinde de genellenebilirlik görülüyor. Bitcoin-M’de UniDetect F1 92.98, AUC 93.83 ve KS 70.45; Bitcoin-L’de F1 93.41, AUC 95.22 ve KS 72.25 raporluyor. Bu, yöntemin Ethereum’a özgü veri biçimine aşırı bağımlı kalmadığını düşündürüyor.
3. Cross-chain zero-shot test güçlü ama asimetrik. Ethereum’da eğitilen model Bitcoin’e doğrudan uygulandığında dolandırıcı hesapları yüksek oranda yakalayabiliyor. Fakat makale, normal hesapları ayırmada precision tarafında zorluk olduğunu da belirtiyor. Bu, gerçek dünyada yanlış pozitif kontrolünün önemini artırır.
4. LLM özet kalitesi kritik rol oynuyor. İki aşamalı eğitim çıkarıldığında performans düşüyor. Bu sonuç, yalnızca LLM’den rastgele özet almak yerine, dolandırıcılık tespiti görevine göre ayarlanmış ve graph model ile birlikte optimize edilmiş özetlerin önemli olduğunu gösteriyor.
5. Residual agent halüsinasyon ve aşırı yorum riskine karşı faydalı görünüyor. Residual summary agent çıkarıldığında performans ciddi biçimde düşüyor. Bu, task-relevant bilgiyle task-irrelevant veya over-inference içeriği ayırmanın güvenilir fraud detection için önemli olduğunu destekliyor.
6. Dual-PGNN neighbourhood camouflage sorununa karşı yardımcı oluyor. Dolandırıcı hesaplar kendilerini masum komşularla kamufle edebilir. Dual-PGNN, node’un kendi özet özelliklerini komşu agregasyonundan bağımsız kanal olarak koruyarak bu etkiyi azaltmaya çalışıyor.
7. Verimlilik pratik kullanım açısından umut verici görünüyor. Eğitim aşaması LLM nedeniyle maliyetli olsa da inference 1.47 ms/sample ve 680 sample/s throughput ile raporlanıyor. Bu, sistemin offline training + hızlı online skor üretimi yaklaşımına uygun olabileceğini gösteriyor.
Bu Neden Önemli?
Kripto suç gelirlerinin farklı zincirler arasında taşınması, finansal suç izleme sistemleri için ciddi bir zorluk oluşturur. Bir adres Ethereum’da şüpheli görünmeyebilir; fakat Bitcoin, köprü, mixer veya başka zincirlerdeki hareketleriyle birlikte değerlendirildiğinde daha anlamlı bir risk profili ortaya çıkabilir.
UniDetect’in önemli tarafı, zincir farklarını elle tek tek özellik tasarlayarak çözmeye çalışmamasıdır. Bunun yerine LLM ile işlem davranışını ortak bir doğal dil temsilinde özetler, ardından bu özetleri işlem grafiğiyle birlikte kullanır. Böylece “hesap ne yaptı?” sorusu hem metinsel hem de yapısal olarak cevaplanmaya çalışılır.
Bu yaklaşım yalnızca blokzincir için değil, başka dolandırıcılık alanları için de fikir vericidir. Bankacılık, e-ticaret, sosyal ağlar, ödeme sistemleri ve sigorta gibi alanlarda da davranış grafikleri ve metinsel açıklamalar birlikte kullanılabilir. Çalışmanın Instagram veri setinde cross-domain test yapması bu genel yaklaşımın başka alanlara taşınabileceğini göstermeyi amaçlar.
Ancak bu önem, dikkatle birlikte düşünülmelidir. Dolandırıcılık tespit sistemleri yanlış pozitif üretebilir. Bir hesabın “riskli” görünmesi, kesin suç kanıtı değildir. Bu nedenle UniDetect benzeri sistemler otomatik cezalandırma aracı değil; analistleri destekleyen, açıklanabilir kanıt çıkaran ve insan incelemesine öncelik veren karar destek sistemleri olarak kullanılmalıdır.
Dikkat Noktaları
1. Bu çalışma preprinttir. Bulgular hakemli nihai sürüm kesinliğiyle değerlendirilmemelidir.
2. Güvenlik bilgilendirmesi amacı taşır. Buradaki içerik dolandırıcılık tespit yöntemini açıklamaktadır; herhangi bir hesap veya kişi hakkında kesin hüküm üretmek için kullanılmamalıdır.
3. Yanlış pozitif riski önemlidir. Cross-chain zero-shot testte dolandırıcıları yakalama oranı yüksek görünse de normal hesapların yanlış işaretlenmesi riski ayrıca yönetilmelidir.
4. Etiket kalitesi sonuçları etkiler. Etherscan, XLabelCloud, CryptoScamDB veya Bitcoin etiketleri eksik, gecikmeli veya tartışmalı olabilir. Model ancak kullandığı etiketler kadar güvenilir öğrenir.
5. LLM halüsinasyonu tamamen ortadan kalkmaz. Makale residual agent ve RL fine-tuning ile bu riski azaltmaya çalışır. Ancak gerçek dünyada LLM çıktıları yine denetlenmeli, kanıt dışı iddialar filtrelenmelidir.
6. Zincirler arası veri yapıları sürekli değişir. Yeni protokoller, köprüler, mixer teknikleri, privacy araçları ve DeFi davranışları modelin zaman içinde yeniden eğitilmesini gerektirebilir.
7. Regülasyon ve etik boyut vardır. Dolandırıcılık tespiti, kara para aklama izleme ve hesap risk skorlama gibi alanlar hukuki sorumluluk doğurabilir. Otomatik karar sistemleri insan hakları, itiraz mekanizması ve veri gizliliğiyle birlikte tasarlanmalıdır.
Riskli alan notu: Çalışma kripto hesaplarında dolandırıcılık tespitiyle ilgilidir. Bu yazı güvenlik ve araştırma bilgilendirmesi amacı taşır. Herhangi bir adres, kişi, kurum veya işlem hakkında tek başına kesin suçlama aracı olarak kullanılmamalıdır. Gerçek dünyada bu tür sistemlerin insan incelemesi, ek kanıt, hukuki süreç ve yanlış pozitif kontrolüyle birlikte kullanılması gerekir.
Genel değerlendirme: Makale, kripto para dolandırıcılığının artık tek bir blokzincirle sınırlı kalmadığını, fonların farklı zincirler arasında taşınarak izleme sistemlerinden kaçabildiğini vurguluyor. Bu nedenle Ethereum için tasarlanmış bir yöntem Bitcoin’e, Bitcoin için tasarlanmış bir yöntem başka zincirlere doğrudan taşınamayabilir. UniDetect’in temel fikri, farklı zincirlerden gelen işlem davranışlarını ortak bir dilsel ve grafiksel temsil altında birleştirmektir.
Sonuç
UniDetect çalışması, kripto dolandırıcılığı tespitinde önemli bir eğilimi temsil ediyor: Sadece grafik sinir ağı veya sadece elle tasarlanmış zincir özellikleri yeterli olmayabilir. Cross-chain dünyada, işlem davranışını hem semantik olarak özetleyen hem de grafik yapısı içinde değerlendiren multimodal sistemlere ihtiyaç artıyor.
Makale, LLM ajanlarının işlem verisini okunabilir özetlere dönüştürebileceğini, fakat bu özetlerin mutlaka görev odaklı filtrelenmesi gerektiğini gösteriyor. Discriminative summary tespit için ayırt edici bilgiyi çıkarırken, residual summary halüsinasyon ve over-inference riskini azaltmaya yardımcı oluyor. Dual-PGNN ise bu metinsel bilgileri hesap grafiğiyle birleştirerek node-level fraud detection yapıyor.
Deneylerde UniDetect’in Ethereum, Bitcoin-M ve Bitcoin-L üzerinde güçlü sonuçlar verdiği raporlanıyor. Ayrıca cross-chain ve cross-domain testler, yöntemin yalnızca tek bir zincire bağlı kalmadığını gösteriyor. Yine de gerçek dünyada bu tür sistemlerin tek başına hüküm veren araçlar değil, analistleri destekleyen kanıt üretim sistemleri olarak kullanılması gerekir.
Verianla okuru için ana mesaj şudur: Kripto dolandırıcılığı artık tek zincirde izlenecek kadar basit değil. Fon akışları zincirler arasında dağılırken, tespit sistemlerinin de dilsel özet, grafik yapısı, davranış paterni ve insan denetimini birlikte kullanan daha evrensel yaklaşımlara geçmesi gerekiyor.
Kaynak ve Yöntem Notu
Bu yazı, “UniDetect: LLM-Driven Universal Fraud Detection across Heterogeneous Blockchains” başlıklı akademik PDF temel alınarak hazırlanmış özgün Türkçe editoryal içeriktir. Metin birebir çeviri değildir; çalışmadaki problem, yöntem, formüller, grafikler, tablolar, deneyler, sonuçlar ve sınırlılıklar sadeleştirilerek anlatılmıştır.
Güvenlik ve dolandırıcılık tespiti konuları kesin suçlama diliyle değil, risk analizi ve karar destek çerçevesinde aktarılmıştır.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir