

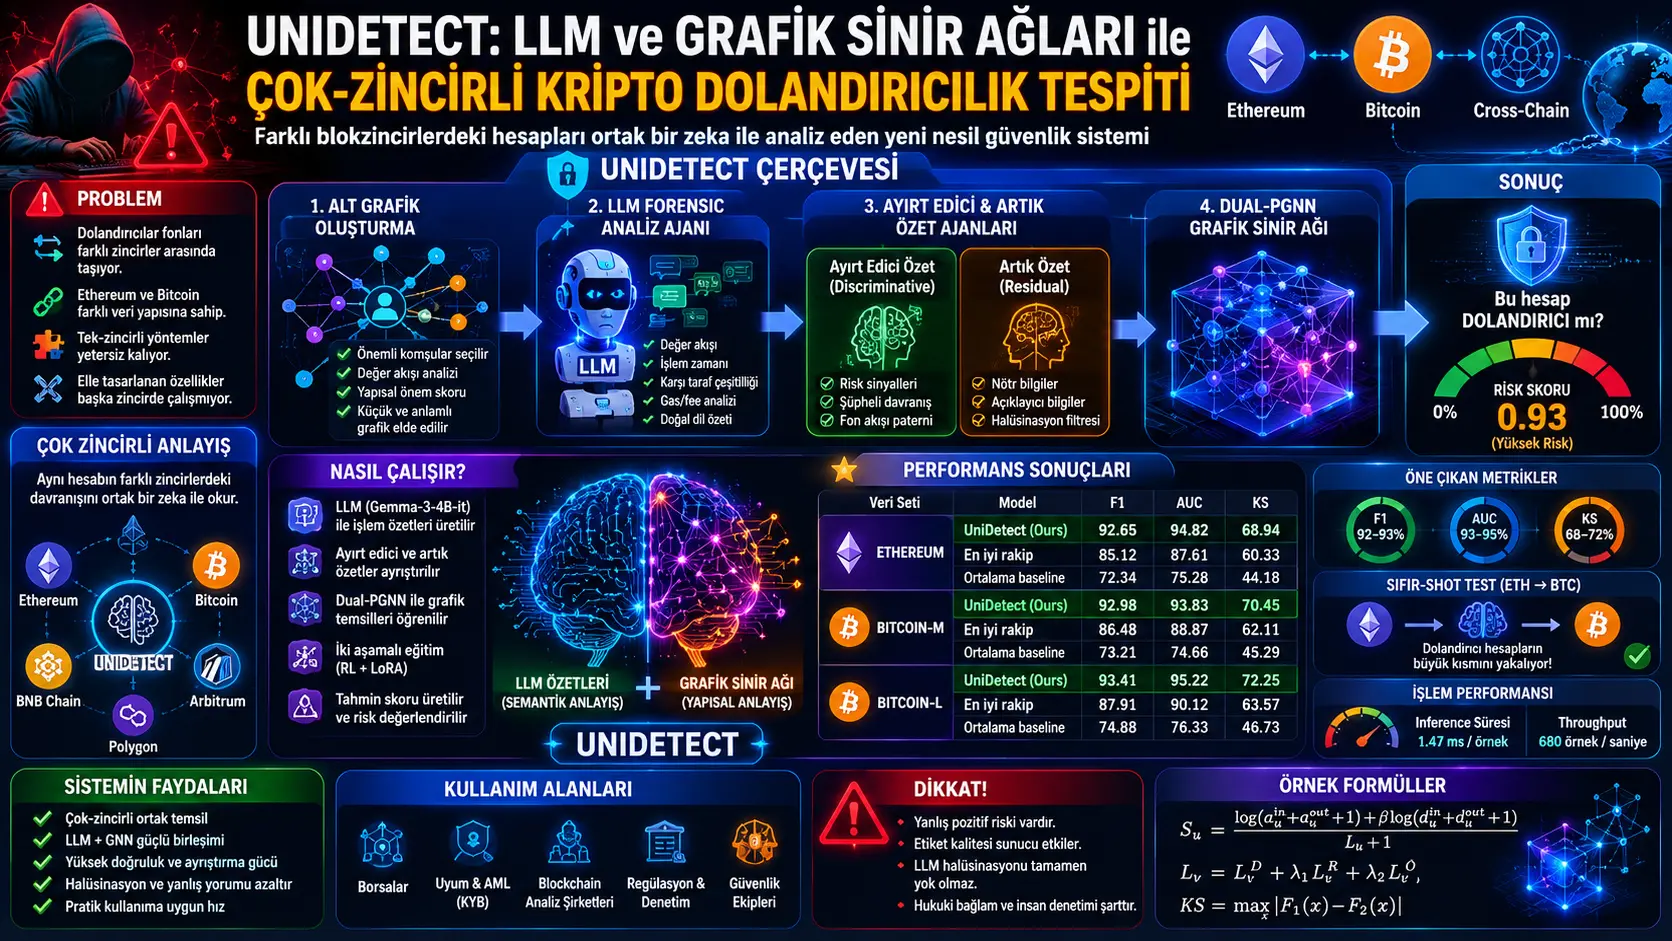
Kutambua akaunti za ulaghai katika mfumo wa sarafu za kripto kunazidi kuwa vigumu. Sababu muhimu ni kwamba fedha zinazotumiwa kwa uhalifu hazibaki tena katika mnyororo mmoja. Madaraja ya cross-chain, itifaki za fedha zilizogatuliwa na uwezekano wa kubadilisha kati ya mali tofauti hurahisisha kuhamisha fedha kutoka blokcheni moja kwenda nyingine. Hali hii inaweza kudhoofisha mifumo ya utambuzi iliyoundwa mahususi kwa Ethereum, Bitcoin au mnyororo mmoja pekee.
Utafiti huu unapendekeza mbinu ya utambuzi wa akaunti za ulaghai ya minyororo mingi iitwayo UniDetect . Mfumo huunganisha mitandao ya neva ya grafu inayochanganua grafu ya miamala na mihtasari ya miamala inayozalishwa na miundo mikubwa ya lugha. Lengo ni kubadilisha miundo tofauti ya miamala katika blokcheni mbalimbali kuwa uwakilishaji wa pamoja unaoeleweka.
Kwanza, UniDetect huunda grafu ndogo zinazolenga akaunti. Kisha forensic analysis agent inayotegemea LLM hufupisha historia ya miamala ya akaunti kwa vipengele kama mtiririko wa thamani, muda wa muamala, utofauti wa wahusika wenza na matumizi ya gas. Baadaye, mawakala wawili tofauti wa uchanganuzi wa muhtasari huanza kufanya kazi: mmoja hutoa taarifa zinazobagua kwa ajili ya utambuzi wa ulaghai, na mwingine hutenganisha taarifa residual/factual ambazo hazihusiani moja kwa moja na kazi. Mihtasari hii hutolewa kama node feature kwa mtandao wa neva ya grafu wenye njia mbili unaoitwa Dual-PGNN.
Kulingana na matokeo yaliyoripotiwa na utafiti, UniDetect hufanya vizuri kuliko mbinu za kawaida za ujifunzaji wa grafu, mbinu za utambuzi za mnyororo mmoja na mbinu nyingi zilizopo za minyororo mingi katika seti za data za Ethereum, Bitcoin-M na Bitcoin-L. Pia inasemekana kwamba inapofunzwa kwenye Ethereum na kujaribiwa kwa zero-shot kwenye Bitcoin, inaweza kunasa sehemu kubwa ya akaunti za ulaghai. Hata hivyo, kwa kuwa mifumo ya aina hii ina hatari ya matokeo chanya ya uongo, katika matumizi halisi inapaswa kutathminiwa pamoja na usimamizi wa binadamu na muktadha wa kisheria.
Tatizo Ni Nini?
Kwa sababu blokcheni hutoa rekodi wazi za miamala, kinadharia zinatoa data yenye nguvu kwa utambuzi wa ulaghai. Hata hivyo, kwa vitendo kuna changamoto kadhaa za msingi.
Tatizo la kwanza ni utofauti wa minyororo. Ethereum hufanya kazi kwa modeli inayotegemea akaunti; Bitcoin hutegemea modeli ya UTXO. Sehemu za miamala, tabia za anwani, taarifa za gas/fee, muundo wa input-output na semantiki za miamala hutofautiana kutoka mnyororo mmoja hadi mwingine. Kwa hiyo, sifa zilizobuniwa kwa mkono kwa mnyororo mmoja huenda zisibebe maana ileile katika mnyororo mwingine.
Tatizo la pili ni tabia ya kukwepa ufuatiliaji kwa cross-chain. Walaghai wanaweza kuhamisha fedha kati ya minyororo mingi, kuzibadilisha kuwa tokeni tofauti au kutawanya athari zao kwa kutumia madaraja na itifaki za DeFi. Katika hali kama hii, mifumo ya ufuatiliaji inayolenga mnyororo mmoja huenda isione tabia yote.
Tatizo la tatu ni modaliti ya data. Data ya blokcheni si kiasi cha namba za miamala pekee. Marudio ya miamala, mtiririko wa fedha, utofauti wa wahusika wenza, muda, matumizi ya gas, ujumbe wa input data, graph topology na mwingiliano wa anwani huwa na maana kwa pamoja. Kwa hiyo, jedwali la namba pekee au muundo wa grafu pekee huenda usitoshe.
Tatizo la nne ni uaminifu wa LLM. Miundo mikubwa ya lugha inaweza kuwa na nguvu katika kufasiri mihtasari ya miamala; lakini ina hatari ya halusinesheni, ufafanuzi uliopitiliza, hitimisho la hatari lisiloungwa mkono na matokeo chanya ya uongo. Katika eneo nyeti kama utambuzi wa ulaghai, modeli inapotoa maoni yasiyo “na msingi wa ushahidi”, huibua tatizo kubwa la uaminifu.
Tatizo kuu ambalo makala inajaribu kutatua ni hili: Tunawezaje kuunganisha data changamano ya miamala kutoka blokcheni tofauti katika mfumo mmoja wa utambuzi wa ulaghai, huku tukihifadhi muundo wa grafu na semantiki za miamala?
Mbinu Inapendekeza Nini?
Mbinu ya UniDetect inaweza kugawanywa katika sehemu kuu nne.
1. Kuunda grafu ndogo inayolenga akaunti: Kwa kuwa kuingiza grafu nzima ya mnyororo moja kwa moja kwenye modeli ni ghali sana, majirani muhimu karibu na akaunti lengwa huchaguliwa. Ishara za kitabia kama wastani wa thamani ya muamala hutumiwa katika uchaguzi huu. Kisha node zisizo za lazima huondolewa kwa alama ya umuhimu wa kimuundo, na grafu ndogo iliyo ndogo zaidi lakini yenye maana hupatikana.
2. Kuzalisha muhtasari wa miamala unaotegemea LLM: Forensic analysis agent hubadilisha historia ya miamala ya kila akaunti kuwa muhtasari wa lugha asilia. Muhtasari huu unajumuisha vipengele kama mtiririko wa thamani, uwiano wa washirika, muda wa muamala na matumizi ya gas. Kwa njia hii, tofauti za kiufundi za minyororo mbalimbali hubadilishwa kuwa lugha ya semantiki iliyo ya pamoja zaidi.
3. Kutenganisha discriminative na residual summary: Si kila sehemu ya muhtasari wa kwanza ina thamani sawa kwa utambuzi wa ulaghai. Kwa hiyo, discriminative summary analyst agent hutoa ishara zinazoweza kubagua ulaghai, kama mtiririko wa fedha, mwingiliano na wahusika wengi wenza, tabia ya miamala mingi na uhusiano na anwani hatarishi. Residual summary analyst agent hutenganisha taarifa ambazo hazichangii moja kwa moja katika uainishaji na ambazo zaidi ni za maelezo au zisizoegemea upande.
4. Mafunzo ya hatua mbili yanayobadilishana: Katika hatua ya kwanza, mawakala wa muhtasari wanaotegemea LLM hufanyiwa fine-tuning kwa LoRA na reinforcement learning ili kuboresha ubora wa muhtasari. Katika hatua ya pili, LLM hugandishwa na modeli ya grafu hufunzwa. Hivyo, mihtasari ya lugha na uwakilishaji wa grafu ya miamala huunda mfumo ambao kila upande huimarisha mwingine.
Wazo kuu la mbinu hii ni hili: LLM hubadilisha historia ya miamala kuwa muhtasari unaosomeka na wenye semantiki tajiri; mtandao wa neva ya grafu hujifunza nafasi ya kitabia na kimuundo ya akaunti ndani ya mtandao. UniDetect hujaribu kujenga mfumo wa jumla zaidi wa utambuzi wa ulaghai wa minyororo mingi kwa kutumia njia hizi mbili pamoja.
Fomula Zinaeleza Nini?
Fomula katika PDF zinaeleza ufafanuzi wa grafu ya miamala, usampulishaji wa grafu ndogo, alama ya umuhimu wa kimuundo, fomula ya hasara ya sehemu tatu, uboreshaji wa muhtasari unaotegemea reinforcement learning na ujifunzaji wa uwakilishaji wa Dual-PGNN. Fomula zimewasilishwa hapa chini katika muundo unaooana na MathJax.
1. Modeli ya data ya grafu ya miamala
Hapa \(G\) inawakilisha grafu ya miamala. \(V\) ni mkusanyiko wa node za akaunti. \(E\) inaonyesha kingo elekezi za miamala kati ya akaunti. Katika miamala ya sarafu za kripto, anwani moja inapotuma fedha kwenda anwani nyingine, hali hiyo huwakilishwa kama ukingo elekezi katika grafu.
\(X_E\) ni matriksi ya sifa za kingo. \(m\) inawakilisha idadi ya kingo za miamala; \(d\) inawakilisha kipimo cha sifa kinachotumiwa kwa kila ukingo. Sifa hizi zinaweza kujumuisha maelezo yanayotofautiana kulingana na mnyororo, kama kiasi cha muamala, marudio ya miamala na fee/gas.
2. Kazi ya kutambua akaunti za ulaghai
Fomula hii inaonyesha kwamba kazi imeundwa kama node classification. Lebo za baadhi ya akaunti, \(Y_L\), zinajulikana; lengo la modeli ni kutabiri lebo za akaunti zisizo na lebo, \(Y_U\), yaani kama ni za kawaida au za ulaghai.
3. Usampulishaji wa majirani unaozingatia semantiki
Fomula hii inaonyesha ni majirani gani huchaguliwa karibu na akaunti lengwa. \(N_v\) ni majirani wa hop moja wa node \(v\). \(K\) ni idadi ya majirani watakaochaguliwa kwa kila hop. \(R[v,N_v]\) inawakilisha wastani wa thamani ya miamala na majirani wanaogombea kuchaguliwa. Kwa njia hii, mwingiliano wenye thamani kubwa au ulio muhimu kitabia hupewa kipaumbele.
\(C_v\) ni mkusanyiko wa node unaopatikana karibu na akaunti lengwa \(v\) kwa usampulishaji wa \(h\)-hop. Mkusanyiko huu huunda msingi wa account-centered subgraph inayowakilisha mazingira ya miamala ya akaunti.
4. Alama ya umuhimu wa kimuundo
Fomula hii huhesabu umuhimu wa kimuundo wa node jirani \(u\). \(a_u^{in}\) na \(a_u^{out}\) zinaonyesha kiasi cha miamala inayoingia na kutoka kwenye node; \(d_u^{in}\) na \(d_u^{out}\) zinaonyesha idadi ya degree zinazoingia na kutoka. \(L_u\) ni umbali wa njia fupi zaidi kwenda node lengwa. \(\beta\) hudhibiti usawa kati ya tabia ya kifedha na ishara ya muunganisho wa kimuundo.
Ikiwa alama ni ya juu, node huchukuliwa kuwa muhimu zaidi. Hata hivyo, kuwa na miunganisho mingi pekee si mara zote ishara ya ulaghai; masoko ya kubadilishana au pochi kubwa za huduma zinaweza pia kuwa na miunganisho mingi. Kwa hiyo, makala inaonyesha kwamba mpangilio wa \(\beta\) unapaswa kuchaguliwa kwa tahadhari.
5. Hasara ya discriminative summary
Hasara hii hupima kiwango ambacho uainishaji uliofanywa kwa kutumia discriminative summary unalingana na lebo halisi. \(p_v^D\) ni uwezekano wa utabiri unaopatikana kutoka discriminative summary. Lengo ni kwamba mihtasari inayobagua kwa ajili ya utambuzi wa ulaghai iongeze mafanikio ya uainishaji.
6. Hasara ya residual summary
Residual summary inawakilisha taarifa ambazo hazitarajiwi kuwa za kubagua moja kwa moja katika utambuzi wa ulaghai. Kwa hiyo, modeli haitaki muhtasari wa residual utoe mwelekeo wenye nguvu katika uainishaji. \(U_v\) ni usambazaji uniform. Hasara hii inalenga kuweka utabiri wa muhtasari wa residual kuwa wa kati kadiri iwezekanavyo.
7. Hasara ya ortogonali
Fomula hii hujaribu kuzuia uwakilishaji wa discriminative na residual usichanganyike. Ikiwa uwakilishaji huo mbili unafanana sana, utengano kati ya ishara inayobagua na taarifa neutral/factual hudhoofika. Hasara ya ortogonali hutumiwa kupunguza mchanganyiko huu.
8. Jumla ya hasara ya sehemu tatu
UniDetect hudhibiti ubora wa muhtasari kwa mitazamo mitatu: taarifa ya discriminative inayosaidia utambuzi wa ulaghai, taarifa ya residual inayotarajiwa kubaki neutral, na kutengana kwa uwakilishaji huu mbili. \(\lambda_1\) na \(\lambda_2\) huamua uzito wa hasara ya residual na hasara ya ortogonali.
9. Zawadi ya RL
Jumla ya hasara ikiwa ndogo, zawadi huwa kubwa. Zawadi hii hutumiwa kuhimiza summary analyst agent inayotegemea LLM kuzalisha mihtasari bora zaidi.
10. Hesabu ya advantage
\(b_t\) ni exponential moving-average baseline katika hatua ya mafunzo. Thamani ya advantage hupatikana kwa kuondoa baseline kutoka reward. Hii husaidia kupunguza variansi katika mafunzo ya RL na kufanya mafunzo yawe thabiti zaidi.
11. Fomula lengwa ya RL
Fomula hii inaunganisha uwezekano wa kuzalisha discriminative na residual summary na zawadi. Mawakala wanaozalisha mihtasari mizuri hupata zawadi kubwa zaidi; wale wanaozalisha mihtasari dhaifu au isiyo ya lazima huadhibiwa.
12. Uzalishaji wa uwakilishaji wa node kwa Dual-PGNN
Fomula ya kwanza huzalisha uwakilishaji wa node unaotegemea grafu kutoka mihtasari ya discriminative au residual. Fomula ya pili huzalisha uwakilishaji tofauti kutoka muhtasari asilia wa miamala. Hapa \(A_v\) ni matriksi ya adjacency ya grafu ndogo inayozunguka akaunti lengwa. \(\theta(\cdot)\) ni tabaka la mstari linalohifadhi sifa yenyewe.
13. Muunganisho wa uwakilishaji kwa attention
Fomula hii inaonyesha kwamba uwakilishaji wa muhtasari wa discriminative/residual huunganishwa na uwakilishaji wa muhtasari asilia kwa uzito wa attention. \(W_1\) na \(W_2\) ni parameta zinazojifunza umuhimu wa jamaa wa njia mbili za taarifa.
14. Metriki ya KS
Metriki ya KS ni kipimo cha utenganishaji kinachotumiwa mara nyingi katika credit scoring na uundaji wa modeli za hatari. Hapa inaonyesha kiwango ambacho usambazaji wa alama za akaunti za kawaida na za ulaghai umetengana. Kadiri KS inavyokuwa juu, ndivyo uwezo wa modeli kutenganisha madarasa hayo mawili unavyochukuliwa kuwa wenye nguvu zaidi.
Ujumbe Mkuu wa Grafu, Jedwali na Mchoro
Figure 1 katika ukurasa wa 1: Mchoro unalinganisha mbinu za jadi za utambuzi wa ulaghai zilizo mahususi kwa mnyororo na UniDetect. Wakati mbinu za jadi zinatumia kanuni na sifa mahususi kwa mnyororo mmoja kama Bitcoin au Ethereum, UniDetect hujaribu kuzalisha uwakilishaji wa pamoja wa minyororo mingi kwa mihtasari ya miamala inayotegemea LLM. Ujumbe mkuu ni huu: Badala ya feature engineering ya mnyororo mmoja, lengo ni uwakilishaji wa pamoja wa semantiki na grafu kati ya minyororo.
Figure 2 katika ukurasa wa 4: Mfumo wa jumla wa UniDetect unaonyeshwa. Upande wa kushoto kuna hatua za kuunda grafu ndogo na transaction summary generation. Katikati kuna muundo wa mafunzo wa hatua mbili: Katika Stage 1, mawakala wa muhtasari hufunzwa; katika Stage 2, graph inference training hufanywa. Chini, inaonyeshwa kwamba katika hatua ya inference mfumo hujibu swali “je, akaunti hii ni ya ulaghai?” kwa uwezekano.
Violezo vya prompt katika kurasa za 4–5: Forensics analyst agent hufupisha data ya miamala kupitia mtiririko wa thamani, uwiano wa washirika, muda wa muamala na matumizi ya gas. Discriminative summary agent hutoa mifumo ya miamala inayobagua kwa upande wa ulaghai. Residual summary agent hutenganisha taarifa factual zisizobeba hukumu ya moja kwa moja ya hatari. Ujumbe mkuu si kwamba LLM itoe maoni kwa uhuru, bali izalishe muhtasari wenye msingi wa ushahidi na unaolenga kazi.
Jedwali la seti za data katika ukurasa wa 6: Katika seti ya data ya Ethereum kuna node 187.960, edge 397.038, fraud 1.991 na akaunti za kawaida 1.439. Katika seti ya data ya Bitcoin-M kuna node 2.505.841 na edge 14.181.316; katika seti ya data ya Bitcoin-L kuna node 20.085.231 na edge 203.419.765. Jedwali hili linaonyesha kwamba mbinu haikujaribiwa kwenye seti ndogo ya data ya mfano, bali kwenye grafu za kiwango kikubwa.
Jedwali la matokeo ya Ethereum katika ukurasa wa 7: UniDetect inatoa matokeo bora zaidi kwenye Ethereum kwa Precision 91.39, Recall 93.95, F1 92.65, AUC 94.82 na KS 68.94. Toleo la UniDetect linalotumia zero-shot LLM pia linatoa matokeo yenye nguvu; lakini fine-tuning na mafunzo ya hatua mbili huleta faida ya ziada iliyo wazi katika modeli kamili.
Jedwali la matokeo ya Bitcoin-M na Bitcoin-L katika ukurasa wa 8: UniDetect inatoa F1 92.98, AUC 93.83, KS 70.45 kwenye Bitcoin-M; na F1 93.41, AUC 95.22, KS 72.25 kwenye Bitcoin-L. Ujumbe mkuu ni kwamba mbinu haibaki mahususi kwa Ethereum pekee, bali inaonyesha utendaji wenye nguvu pia katika miundo ya data ya Bitcoin.
Grafu za unyeti wa hyperparameter katika ukurasa wa 8: Inaonyeshwa jinsi utendaji unavyoathiriwa wakati \(N_c\), \(\beta\), \(\lambda_1\) na \(\lambda_2\) zinabadilika. Ingawa modeli inaonekana thabiti katika masafa mapana, inaelezwa kwamba parameta ndogo sana au kubwa sana zinaweza kudhoofisha utendaji. Hasa, ikiwa \(\beta\) inakuwa kubwa sana, pochi za huduma zenye miunganisho mingi lakini zisizo na hatia zinaweza kuonekana kuwa muhimu kupita kiasi kwa modeli.
Jedwali la ablation katika ukurasa wa 8: Utendaji hubadilika vipengele vya modeli vinapoondolewa. F1 kushuka hadi 78.37 residual agent inapoondolewa kunaonyesha umuhimu wa utengano wa residual/discriminative. Utendaji pia hushuka RL inapoondolewa na GNN ya kawaida inapotumiwa badala ya Dual-PGNN.
Jedwali la ufanisi katika ukurasa wa 9: Uundaji wa grafu ndogo umeripotiwa kuwa wastani wa sekunde 1.26/samples, inference 1.47 ms/sample na throughput 680 sample/s. Ingawa mafunzo yanayotegemea LLM ni ghali, inadaiwa kwamba mfumo uko karibu na kuweza kutekelezwa kwa vitendo katika hatua ya inference.
Grafu ya RL convergence katika ukurasa wa 13: Inaonyeshwa kwamba mkunjo wa zawadi hupanda haraka ndani ya hatua 50 za kwanza na kutulia katika ukanda wa 0.5–0.6. Makala inawasilisha hali hii kama ushahidi unaounga mkono kwamba mchakato wa RL-based LLM fine-tuning uliendelea kwa uthabiti bila kuporomoka.
Majaribio Yalifanywaje?
Utafiti unafanya majaribio kwenye Ethereum na Bitcoin. Kwa Ethereum, lebo za akaunti za ulaghai zilichukuliwa kutoka vyanzo kama Etherscan label cloud, XLabelCloud na CryptoScamDB. Aina za akaunti haramu au hatarishi kama Phishing, Upbit vulnerability attack, gambling na honeypot zilijumuishwa. Akaunti zenye utambulisho maalumu unaojulikana, kama miners na watoa huduma za kifedha, zilitathminiwa kuwa benign.
Miamala ya Ethereum ilikusanywa kati ya 7 Agosti 2015 na 10 Aprili 2025. Miamala yenye kiasi sifuri na miamala iliyoshindwa iliondolewa. Grafu elekezi ya miamala iliundwa kati ya akaunti za watumaji na wapokeaji. Katika uhamisho unaorudiwa, miamala kati ya jozi ileile ya akaunti ilikusanywa katika ukingo mmoja na sifa kama jumla ya kiasi cha uhamisho na marudio ya miamala zilitumiwa.
Seti mbili za data zilitumiwa kwa Bitcoin: Bitcoin-M na Bitcoin-L. Bitcoin-M inajumuisha miamala ya kwanza milioni 1.5 kabla ya Juni 2015. Bitcoin-L inajumuisha miamala yote kati ya Juni–Septemba 2015. Katika seti za data za Bitcoin, anwani zinazohusishwa na huduma za gambling na mixing zilichukuliwa kama darasa chanya linalohusishwa na ulaghai au shughuli haramu.
Modeli iligawanywa kwa uwiano wa 8:1:1 kwa mafunzo/uthibitishaji/majaribio. Kwa ulinganisho, mbinu 20 za baseline zilitumiwa, zikiwemo DeepWalk, Node2Vec, GCN, GAT, GIN, GraphSAGE, APPNP, CARE-GNN, BWGNN, GRIT, DGA-GNN, PMP, Trans2Vec, TSGN, Ethident, TEGDetector, SIGTRAN, BERT4ETH na DIAM.
Kwa UniDetect, usampulishaji wa majirani wa 2-hop ulifanywa na majirani wasiozidi \(K=10\) walihifadhiwa kwa kila hop. Baada ya kubana, kipimo cha mwisho cha grafu ndogo kiliwekwa kuwa \(N_c=10\). Gemma-3-4B-it ilitumiwa kama uti wa mgongo wa LLM, Sentence-BERT kwa embedding, na Dual-PGNN inayotegemea CARE-GNN kama uti wa mgongo wa grafu. Fine-tuning yenye ufanisi wa parameta ilifanywa kwa LoRA wakati wa mafunzo.
Metriki za tathmini ziliwekwa kuwa Precision, Recall, F1, AUC na KS. Pia, katika jaribio la cross-chain zero-shot, modeli iliyofunzwa kwenye Ethereum ilitumika kwa Bitcoin; katika jaribio la cross-domain transfer, uainishaji wa business account ulijaribiwa kwenye seti ya data ya mtandao wa kijamii wa Instagram.
Matokeo Yanaonyesha Nini?
1. UniDetect inatoa utendaji wenye nguvu kwenye Ethereum. Katika seti ya data ya Ethereum, UniDetect inafikia F1 92.65, AUC 94.82 na KS 68.94. Matokeo haya yanaonyesha uboreshaji ulio wazi dhidi ya mbinu za mnyororo mmoja zinazotumia manual feature engineering na miundo ya jumla ya ujifunzaji wa grafu.
2. Uwezo wa kueneza unaonekana pia katika seti za data za Bitcoin. UniDetect inaripoti F1 92.98, AUC 93.83 na KS 70.45 kwenye Bitcoin-M; na F1 93.41, AUC 95.22 na KS 72.25 kwenye Bitcoin-L. Hii inadokeza kwamba mbinu haitegemei kupita kiasi muundo wa data ulio mahususi kwa Ethereum.
3. Jaribio la cross-chain zero-shot ni lenye nguvu lakini si linganifu. Modeli iliyofunzwa kwenye Ethereum inapotumiwa moja kwa moja kwenye Bitcoin, inaweza kunasa akaunti za ulaghai kwa kiwango cha juu. Hata hivyo, makala pia inataja ugumu katika precision wakati wa kutenganisha akaunti za kawaida. Hili linaongeza umuhimu wa kudhibiti matokeo chanya ya uongo katika ulimwengu halisi.
4. Ubora wa muhtasari wa LLM una jukumu muhimu. Utendaji hushuka mafunzo ya hatua mbili yanapoondolewa. Matokeo haya yanaonyesha umuhimu wa kutumia mihtasari iliyorekebishwa kwa kazi ya utambuzi wa ulaghai na kuboreshwa pamoja na modeli ya grafu, badala ya kuchukua tu mihtasari nasibu kutoka LLM.
5. Residual agent inaonekana kuwa na manufaa dhidi ya halusinesheni na ufafanuzi uliopitiliza. Utendaji hushuka sana residual summary agent inapoondolewa. Hii inaunga mkono kwamba kutenganisha taarifa task-relevant na maudhui task-irrelevant au over-inference ni muhimu kwa fraud detection yenye kuaminika.
6. Dual-PGNN husaidia dhidi ya tatizo la neighbourhood camouflage. Akaunti za ulaghai zinaweza kujificha kwa kuzungukwa na majirani wasio na hatia. Dual-PGNN hujaribu kupunguza athari hii kwa kuhifadhi sifa za muhtasari za node yenyewe katika njia iliyo huru na ujumlishaji wa majirani.
7. Ufanisi unaonekana kuwa na matumaini kwa matumizi ya vitendo. Ingawa hatua ya mafunzo ni ghali kwa sababu ya LLM, inference inaripotiwa kuwa 1.47 ms/sample na throughput 680 sample/s. Hii inaonyesha kwamba mfumo unaweza kufaa kwa mbinu ya offline training + uzalishaji wa haraka wa alama online.
Kwa Nini Hili Ni Muhimu?
Kuhamishwa kwa mapato ya uhalifu wa kripto kati ya minyororo tofauti ni changamoto kubwa kwa mifumo ya ufuatiliaji wa uhalifu wa kifedha. Anwani inaweza isionekane ya kutiliwa shaka kwenye Ethereum; lakini inapochunguzwa pamoja na mienendo yake kwenye Bitcoin, madaraja, mixer au minyororo mingine, wasifu wa hatari wenye maana zaidi unaweza kujitokeza.
Jambo muhimu kuhusu UniDetect ni kwamba haijaribu kutatua tofauti za minyororo kwa kubuni sifa moja moja kwa mkono. Badala yake, hufupisha tabia ya miamala katika uwakilishaji wa pamoja wa lugha asilia kwa LLM, kisha hutumia mihtasari hii pamoja na grafu ya miamala. Hivyo, mfumo hujaribu kujibu swali “akaunti ilifanya nini?” kwa njia ya kimaandishi na ya kimuundo.
Mbinu hii inaweza kutoa mawazo si kwa blokcheni pekee, bali pia kwa maeneo mengine ya ulaghai. Grafu za tabia na maelezo ya kimaandishi zinaweza kutumiwa pamoja katika maeneo kama benki, biashara mtandao, mitandao ya kijamii, mifumo ya malipo na bima. Jaribio la cross-domain katika seti ya data ya Instagram linalenga kuonyesha kwamba mbinu hii ya jumla inaweza kuhamishwa kwenda maeneo mengine.
Hata hivyo, umuhimu huu unapaswa kuzingatiwa kwa tahadhari. Mifumo ya utambuzi wa ulaghai inaweza kutoa matokeo chanya ya uongo. Akaunti kuonekana kuwa “hatarishi” si ushahidi wa uhakika wa uhalifu. Kwa hiyo, mifumo kama UniDetect inapaswa kutumiwa si kama zana ya adhabu ya kiotomatiki, bali kama mifumo ya kusaidia maamuzi inayowaunga mkono wachambuzi, kutoa ushahidi unaoelezeka na kuweka uchunguzi wa binadamu mbele.
Mambo ya Kuzingatia
1. Utafiti huu ni preprint. Matokeo hayapaswi kutathminiwa kwa uhakika wa toleo la mwisho lililopitiwa na wataalamu.
2. Unalenga kutoa taarifa za usalama. Maudhui hapa yanaeleza mbinu ya utambuzi wa ulaghai; hayapaswi kutumiwa kutoa uamuzi wa uhakika kuhusu akaunti au mtu yeyote.
3. Hatari ya matokeo chanya ya uongo ni muhimu. Ingawa kiwango cha kunasa walaghai kinaonekana kuwa cha juu katika jaribio la cross-chain zero-shot, hatari ya kuainisha akaunti za kawaida kimakosa inapaswa kudhibitiwa kando.
4. Ubora wa lebo huathiri matokeo. Lebo za Etherscan, XLabelCloud, CryptoScamDB au Bitcoin zinaweza kuwa pungufu, zilizochelewa au zenye utata. Modeli hujifunza kwa uaminifu unaolingana tu na lebo inazotumia.
5. Halusinesheni ya LLM haiondolewi kabisa. Makala hujaribu kupunguza hatari hii kwa residual agent na RL fine-tuning. Hata hivyo, katika ulimwengu halisi matokeo ya LLM bado yanapaswa kukaguliwa na madai yasiyo na ushahidi kuchujwa.
6. Miundo ya data kati ya minyororo hubadilika daima. Itifaki mpya, madaraja, mbinu za mixer, zana za privacy na tabia za DeFi zinaweza kufanya modeli ihitaji kufunzwa upya kwa muda.
7. Kuna upande wa udhibiti na maadili. Maeneo kama utambuzi wa ulaghai, ufuatiliaji wa utakatishaji fedha na uwekaji alama za hatari kwa akaunti yanaweza kuleta wajibu wa kisheria. Mifumo ya maamuzi ya kiotomatiki inapaswa kubuniwa pamoja na haki za binadamu, utaratibu wa kukata rufaa na faragha ya data.
Dokezo la eneo hatarishi: Utafiti unahusu utambuzi wa ulaghai katika akaunti za kripto. Makala hii inalenga kutoa taarifa za usalama na utafiti. Haipaswi kutumiwa peke yake kama zana ya kutoa shtaka la uhakika dhidi ya anwani, mtu, taasisi au muamala wowote. Katika ulimwengu halisi, mifumo ya aina hii inapaswa kutumiwa pamoja na uchunguzi wa binadamu, ushahidi wa ziada, mchakato wa kisheria na udhibiti wa matokeo chanya ya uongo.
Tathmini ya jumla: Makala inasisitiza kwamba ulaghai wa sarafu za kripto hauko tena ndani ya blokcheni moja, na kwamba fedha zinaweza kukwepa mifumo ya ufuatiliaji kwa kuhamishwa kati ya minyororo tofauti. Kwa hiyo, mbinu iliyoundwa kwa Ethereum huenda isihamishike moja kwa moja kwenda Bitcoin, na mbinu iliyoundwa kwa Bitcoin huenda isihamishike kwenda minyororo mingine. Wazo kuu la UniDetect ni kuunganisha tabia za miamala kutoka minyororo tofauti chini ya uwakilishaji wa pamoja wa lugha na grafu.
Hitimisho
Utafiti wa UniDetect unawakilisha mwelekeo muhimu katika utambuzi wa ulaghai wa kripto: Mtandao wa neva ya grafu pekee au sifa za minyororo zilizobuniwa kwa mkono pekee huenda zisitoshe. Katika ulimwengu wa cross-chain, mahitaji yanaongezeka kwa mifumo ya multimodal inayofupisha tabia ya miamala kisemantiki na pia kuitathmini ndani ya muundo wa grafu.
Makala inaonyesha kwamba mawakala wa LLM wanaweza kubadilisha data ya miamala kuwa mihtasari inayosomeka, lakini mihtasari hii lazima ichujwe kwa kuzingatia kazi. Discriminative summary hutoa taarifa inayobagua kwa utambuzi, huku residual summary ikisaidia kupunguza hatari ya halusinesheni na over-inference. Dual-PGNN huunganisha taarifa hii ya kimaandishi na grafu ya akaunti ili kufanya node-level fraud detection.
Katika majaribio, UniDetect imeripotiwa kutoa matokeo yenye nguvu kwenye Ethereum, Bitcoin-M na Bitcoin-L. Majaribio ya cross-chain na cross-domain pia yanaonyesha kwamba mbinu haitegemei mnyororo mmoja pekee. Hata hivyo, katika ulimwengu halisi mifumo ya aina hii inapaswa kutumiwa si kama zana zinazotoa hukumu zenyewe, bali kama mifumo ya kuzalisha ushahidi inayowaunga mkono wachambuzi.
Ujumbe mkuu kwa msomaji wa Verianla ni huu: Ulaghai wa kripto si rahisi tena kiasi cha kufuatiliwa katika mnyororo mmoja. Kadiri mtiririko wa fedha unavyotawanyika kati ya minyororo, mifumo ya utambuzi pia inahitaji kuhamia kwenye mbinu za jumla zaidi zinazotumia pamoja muhtasari wa lugha, muundo wa grafu, muundo wa tabia na usimamizi wa binadamu.
Maelezo ya Chanzo na Mbinu
Makala hii ni maudhui asilia ya uhariri kwa Kituruki yaliyotayarishwa kwa msingi wa PDF ya kitaaluma yenye kichwa “UniDetect: LLM-Driven Universal Fraud Detection across Heterogeneous Blockchains”. Si tafsiri ya neno kwa neno; tatizo, mbinu, fomula, grafu, majedwali, majaribio, matokeo na vikwazo vya utafiti vimeelezwa kwa lugha iliyorahisishwa.
Mada za usalama na utambuzi wa ulaghai zimewasilishwa ndani ya mfumo wa uchanganuzi wa hatari na usaidizi wa maamuzi, si kwa lugha ya shtaka la uhakika.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *