

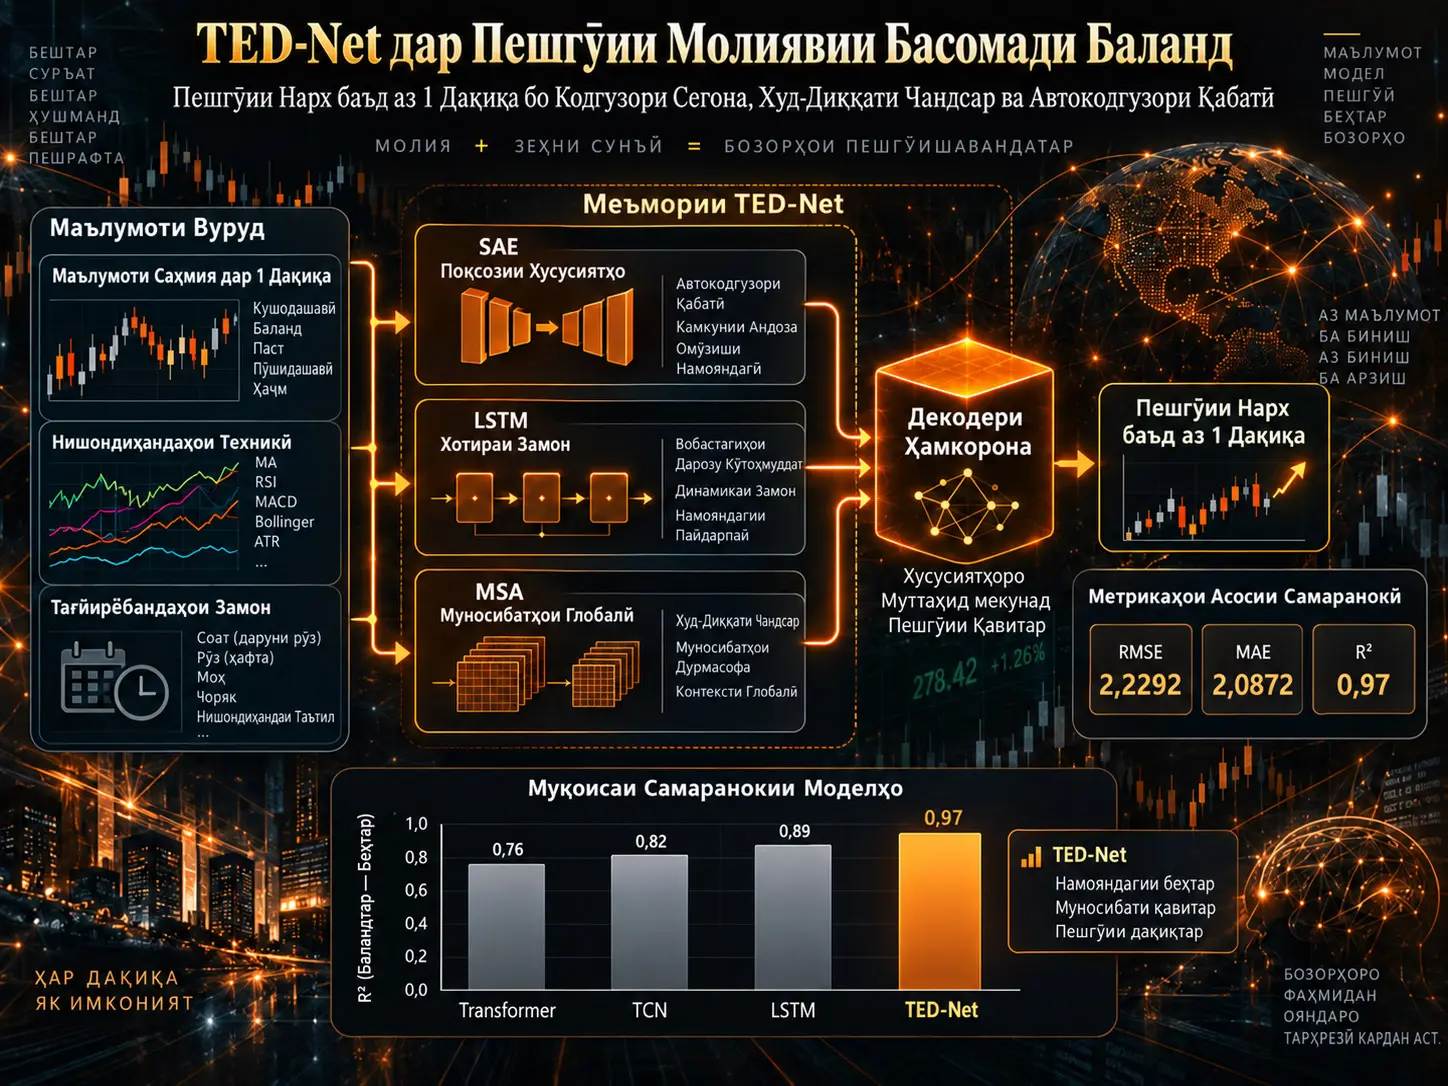
Қаторҳои вақти молиявӣ аз сабаби сохтори ғайрихаттӣ, хусусиятҳои омории тағйирёбанда, садои баланд ва вобастагиҳои дарозмуддат барои моделҳои пешгӯӣ манбаъҳои душвори додаҳо мебошанд. Ин таҳқиқот барои баррасии ҳамзамони ин мушкилот дар як модел TED-Net (Triple Encoder-Decoder Network) ном меъмории гибридии омӯзиши амиқро пешниҳод мекунад. TED-Net се механизми ҷудогонаи рамзгузориро муттаҳид мекунад: Stacked Autoencoder (SAE) хусусиятҳоро тоза карда, намояндагии камҳаҷмтар месозад; LSTM-Seq2Seq вобастагиҳои кӯтоҳмуддат ва дарозмуддатро дар тӯли вақт меомӯзад; Multi-Head Self-Attention (MSA) бошад, кӯшиш мекунад робитаҳои глобалиро байни нуқтаҳои гуногуни вақт ва зерфазоҳои намояндагӣ дарёфт кунад. Ин се манбаи иттилоот тавассути collaborative decoder, ки gated fusion ва attention-ро истифода мебарад, муттаҳид шуда, пешгӯии нархи навбатиро тавлид мекунанд.
Дар таҷрибаҳо барои 15 саҳмияи A-share аз бахшҳо ва арзишҳои гуногуни бозорӣ барои ҳар кадом 24.000 мушоҳидаи якдақиқагӣ истифода шудааст; %80-и аввал барои training ва %20-и охир барои validation ҷудо шудааст. Дар вазифаи асосии пешгӯӣ бо истифода аз маълумоти 30 дақиқаи қаблӣ нархи пӯшидашавии дақиқаи оянда пешгӯӣ мешавад. Дар манбаъ гуфта мешавад, ки TED-Net дар муқоисаҳо бо Transformer, TCN ва LSTM-Seq2Seq дар аксар ё ҳамаи ҷадвалҳои миёнаи саҳмияҳо дақиқии баландтари гузоришшударо нишон додааст. Дар таҷрибаи ҷудогонаи CATL барои TED-Net RMSE 2,2292, MAE 2,0872 ва R² 0,97 гузориш шудааст.
Бо вуҷуди ин, ибораи “high-frequency trading” дар таҳқиқот бояд бо эҳтиёт шарҳ дода шавад. Додаҳои истифодашуда қаторҳои вақти якдақиқагӣ мебошанд ва модел бо паёмҳои воқеии дафтари фармоишҳо ё ҷараёни execution дар сатҳи микросония кор намекунад. Илова бар ин, таҳқиқот на стратегияи савдо, балки пешгӯии нархро месанҷад; натиҷаҳои P&L, transaction cost, slippage, Sharpe ratio ё иҷрои зиндаи фармоишҳо пешниҳод нашудаанд.
| Ҷузъ | Вазифаи асосӣ |
|---|---|
| Stacked Autoencoder — SAE | Коҳиш додани садои хусусиятҳо ва тавлиди намояндагии фишурдатар |
| LSTM-Seq2Seq | Моделсозии вобастагиҳои кӯтоҳмуддат ва дарозмуддати вақтӣ |
| Multi-Head Self-Attention — MSA | Дарёфти робитаҳои глобалӣ байни нуқтаҳои гуногуни вақт |
| Dynamic Window Attention | Маҳдуд кардани майдони ҳисобкунии attention дар пайдарпаии дароз |
| Collaborative Decoder | Муттаҳид кардани иттилооти аз се encoder омада ба таври мутобиқшаванда |
| Баромад | Пешгӯии нархи дақиқаи оянда |
TED-Net кадом се мушкилро ҳал кардан мехоҳад?
Таҳқиқоти манбаъ пешгӯии молиявии басомади баландро тавассути се мушкили асосӣ муайян мекунад.
Мушкилоти хусусиятҳо: Нишондиҳандаҳои молиявӣ метавонанд бо ҳам коррелятсияи баланд дошта бошанд ва миқдори зиёди садоро дар бар гиранд. Теъдоди зиёди тағйирёбандаҳои монанд ё камиттилоъ метавонад омӯзиши моделро душвор созад.
Мушкилоти вақтӣ: Дар пайдарпаии дароз маълумоти гузашта бо мурури вақт гум шуда метавонад. Гарчанде LSTM нисбат ба RNN-ҳои классикӣ ин мушкилро коҳиш медиҳад, дар пайдарпаии хеле дароз нигоҳ доштани тамоми маълумоти таърихӣ бо дараҷаи баробар боз ҳам душвор буда метавонад.
Мушкилоти коррелятсия: Дар ҳоле ки як модели пайдарпай метавонад робитаҳои наздики вақтӣ омӯзад, робитаҳои глобалиро байни қисмҳои гуногуни пайдарпаӣ нопурра намояндагӣ карда метавонад.
TED-Net кӯшиш мекунад ба ин се мушкил мутаносибан бо SAE, LSTM ва MSA ҷавоб диҳад.
Меъмории рамзгузории сегона чӣ гуна кор мекунад?
Ҷараёни умумии омӯзиш дар манбаъ:
Тозакунии хусусиятҳо → Моделсозии вақтӣ → Истихроҷи коррелятсияи глобалӣ → Decoding-и муштарак → Пешгӯӣ
ба ин шакл ҷамъбаст мешавад.
SAE дар марҳилаи аввал нишондиҳандаҳои молиявиро ба намояндагии latent-и фишурдатар табдил медиҳад. Ин баромад аз ҷониби LSTM ҳамчун пайдарпаии вақтӣ коркард мешавад. MSA робитаҳои байни нуқтаҳои гуногуни вақти пайдарпаиро бо вазнҳои attention ҳисоб мекунад. Сипас Decoder ин се намояндагиро барои тавлиди як пешгӯӣ муттаҳид мекунад.
Чаро Stacked Autoencoder истифода мешавад?
Autoencoder шабакаи нейронӣ аст, ки вурудро ба намояндагии latent-и камҳаҷмтар рамзгузорӣ карда, сипас онро аз нав барқарор кардан мехоҳад. Вақте модел аз нав тавлид кардани вурудро бо нигоҳ доштани танҳо намунаҳои муҳим меомӯзад, таъсири садо ва тағйирёбандаҳои нолозим коҳиш дода мешавад.
Дар манбаъ қабатҳои encoding:
\[ h^{(l)} = \sigma \left( W^{(l)}h^{(l-1)}+b^{(l)} \right) \]
ба ин шакл ифода шудаанд.
Дар TED-Net, SAE танҳо воситаи мустақили пешкоркард нест, балки ҷузъи якуми сохтори encoder-и сегона мебошад.
LSTM кадом иттилоотро интиқол медиҳад?
LSTM бо ёрии ҳуҷайраи хотира, input gate, forget gate ва output gate меомӯзад, ки кадом маълумоти гузашта нигоҳ дошта ё фаромӯш карда шавад.
Манбаъ навсозии асосии LSTM-ро:
\[ i_t=\sigma(W_{xi}x_t+W_{hi}h_{t-1}+W_{ci}c_{t-1}+b) \]
\[ f_t=\sigma(W_{xf}x_t+W_{hf}h_{t-1}+W_{cf}c_{t-1}+b) \]
\[ c_t=f_tc_{t-1}+i_t\tanh(W_{xc}x_t+W_{hc}h_{t-1}+b) \]
\[ o_t=\sigma(W_{xo}x_t+W_{ho}h_{t-1}+W_{co}c_t+b) \]
\[ h_t=o_t\tanh(c_t) \]
бо ин формулаҳо муайян мекунад.
Дар сохтори Seq2Seq, encoder пайдарпаии гузаштаро коркард мекунад ва decoder бо ёрии намояндагии аз encoder гирифташуда пайдарпаии ҳадаф ё қимати ояндаро тавлид мекунад.
Чаро Multi-Head Self-Attention илова шудааст?
Азбаски LSTM пайдарпай кор мекунад, робитаи байни ду нуқтаи дури вақт тавассути бисёр ҳолатҳои миёна интиқол меёбад. Self-attention метавонад бевосита ҳисоб кунад, ки як нуқтаи вақт ба нуқтаҳои дигари вақт то чӣ андоза таваҷҷуҳ кунад.
Манбаъ:
\[ Q=W_QX+b_Q,\qquad K=W_KX+b_K,\qquad V=W_VX+b_V \]
табдилҳоро истифода мебарад.
Сипас вазнҳои attention:
\[ \alpha_t= Softmax \left( \frac{Q_tK_t^T}{\sqrt{d_h}} \right) \]
ҳисоб карда мешаванд.
Dynamic Window Self-Attention чист?
Азбаски self-attention-и пурра дар пайдарпаии дароз муқоисаи ҳамаи нуқтаҳои вақтро бо ҳам талаб мекунад, хароҷоти ҳисоббарорӣ метавонад зуд афзоиш ёбад.
Аз ин рӯ TED-Net пешниҳод мекунад, ки барои ҳар нуқтаи \(t\) танҳо векторҳои key ва value дар равзанаи муайяни \(S_t\) истифода шаванд.
Ҳадафи ин равиш:
- коҳиш додани хароҷоти attention,
- тамаркуз ба нуқтаҳои наздик ва марбут ба вақт,
- маҳдуд кардани бори ҳисоббарорӣ дар пайдарпаии дарози молиявӣ мебошад.
Манбаъ алгоритм ё қоидаи оптимизатсияро барои он ки дарозии равзана чӣ гуна динамикӣ интихоб мешавад, муфассал намедиҳад; сохтори асосии математикӣ ҳисобкунии self-attention дар дохили равзана аст.
Оё модел воқеан додаҳои HFT-и микросониягиро истифода мебарад?
Не. Гарчанде манбаъ дар муқаддима аз табиати микросониягии HFT ёд мекунад, додаҳои таҷрибавӣ бо басомади якдақиқагӣ мебошанд.
Вазифаи асосӣ:
маълумоти 30 дақиқаи охир → нархи пӯшидашавии 1 дақиқаи оянда
мебошад.
Аз ин рӯ, таҳқиқот бояд на ҳамчун таҳқиқоти order-book HFT ё execution бо таъхири паст, балки дар заминаи пешгӯии қаторҳои вақти молиявии баландҳалшаванда арзёбӣ шавад.
Усул ва Натиҷаҳои Таҳқиқот
Сохтори додаҳо
Дар таҳқиқот 15 саҳмияи A-share аз бахшҳо ва арзишҳои гуногуни бозорӣ интихоб шудаанд.
Барои ҳар саҳмия:
- 24.000 мушоҳидаи якдақиқагӣ,
- %80 training,
- %20 validation,
- sequence-и кӯтоҳмуддати 30-дақиқагӣ,
- sequence-и дарозмуддати 120-дақиқагӣ
муайян шудаанд.
Манбаъ дар ҳамин бахш мегӯяд, ки модел бо истифода аз 30 дақиқаи қаблӣ нархи пӯшидашавии дақиқаи ояндаро пешгӯӣ мекунад. Тарзи дақиқи истифодаи sequence-и дарозмуддати 120-дақиқагӣ дар дохили модел камтар муфассал шарҳ дода шудааст.
Хусусиятҳо
Гуфта мешавад, ки сохтори ибтидоии додаҳо 15 indicator дорад. Пас аз PCA манбаъ ҳафт нишондиҳандаро гузориш мекунад:
- MACD,
- TRIX,
- VR,
- OBV,
- ROC,
- MTM,
- PSY.
Ба онҳо қиматҳои 0,78, 0,69, 0,76, 0,68, 0,75, 0,72 ва 0,67 вобаста карда шудаанд. Аммо манбаъ шарҳ намедиҳад, ки ин қиматҳо PCA loading, саҳми variance ё feature score-и дигар мебошанд.
Параметрҳои асосии омӯзиш
| Параметр | Қимат |
|---|---|
| Қабати LSTM | 3 |
| Hidden unit | 128 |
| Learning rate | 0,007 |
| Dropout | 0,03 таҷрибаи асосӣ; 0,1 таҷрибаи муқоисавӣ |
| Optimizer | Adam |
| Batch size | 100 |
| Sequence length | 30 |
| Loss | MSE + L2 regularization |
Дар таҷрибаи муқоисавӣ барои Transformer \(d_m=128\), ҳашт attention head ва шаш encoder/decoder layer; барои TCN kernel size 3, dilation base 2, шаш residual block ва 64 filter дода шудаанд.
Таҷрибаҳои ablation
| Модел | AUC | Precision | Recall | MF1 |
|---|---|---|---|---|
| LSTM-Seq2Seq | 0,83 | 0,95 | 0,80 | 0,87 |
| + SAE | 0,88 | 0,96 | 0,85 | 0,91 |
| TED-Net: SAE + MSA | 0,92 | 0,98 | 0,89 | 0,94 |
Ҷадвал нишон медиҳад, ки бо илова шудани SAE ва MSA метрикаҳои гузоришшуда баланд мешаванд.
Аммо бо вуҷуди он ки вазифаи асосии модел регрессияи нарх аст, дар ин ҷадвал метрикаҳои classification истифода мешаванд. Дар манбаъ шарҳ дода нашудааст, ки нархи пешгӯишуда чӣ гуна ба тамғаи “rising / non-rising” табдил дода шудааст, decision threshold ё тақсимоти синфҳо чӣ гуна аст. Аз ин рӯ, ин ҷадвали ablation-ро пурра бозтавлид кардан имконнопазир аст.
Муқоисаи понздаҳ саҳмия
Манбаъ дар Table 3 барои Transformer, TCN, LSTM-Seq2Seq ва TED-Net дар 15 саҳмия фоизҳои “prediction accuracy”-ро медиҳад.
| Саҳмия | Transformer | TCN | LSTM-Seq2Seq | TED-Net |
|---|---|---|---|---|
| ZTE | %87,73 | %86,04 | %87,18 | %89,12 |
| Gansu Consulting | %95,37 | %95,14 | %95,08 | %96,21 |
| East Money | %96,79 | %96,63 | %96,91 | %97,82 |
| BYD | %91,96 | %92,28 | %92,15 | %93,67 |
| Shanxi Coking | %71,13 | %68,28 | %72,79 | %75,06 |
TED-Net дар ҳамаи 15 сатри миёнаи дар Table 3 овардашуда қимати баландтаринро нишон медиҳад.
Бо вуҷуди ин, азбаски манбаъ таърифи математикии меъёри “prediction accuracy”-ро намедиҳад, шарҳи ин фоизҳо ҳамчун classification accuracy-и классикӣ бехатар нест.
Маҷмӯи додаҳои таҷрибаи CATL
Дар таҷрибаи ҷудогона барои CATL:
- 8 июли 2025 – 13 марти 2026,
- 39.604 мушоҳидаи якдақиқагӣ,
- %80 training,
- %20 validation
истифода шудаанд.
Манбаъ дар Figure 5 давомнокии оптималии омӯзишро тақрибан 40 epoch муайян мекунад ва мегӯяд, ки loss тақрибан дар сатҳи 0,00575 устувор мешавад.
Натиҷаҳои CATL
| Модел | RMSE | MAE | R² |
|---|---|---|---|
| LSTM | 3,4521 | 2,8910 | 0,92 |
| TCN | 3,2145 | 2,7234 | 0,93 |
| Transformer | 3,0876 | 2,6012 | 0,94 |
| TED-Net | 2,2292 | 2,0872 | 0,97 |
Ин ҷадвал нишон медиҳад, ки TED-Net дар таҷрибаи манбаъ пасттарин RMSE ва MAE ва баландтарин R²-ро додааст.
Оё коҳиши %42-и RMSE, ки дар манбаъ гуфта шудааст, бозтавлид мешавад?
Дар бахши натиҷаҳо гуфта мешавад, ки TED-Net RMSE-ро нисбат ба baseline %42,0 коҳиш додааст. Аммо ҳангоми истифодаи қиматҳои CATL Table 4:
- LSTM → TED-Net: тақрибан %35,4 коҳиш,
- TCN → TED-Net: тақрибан %30,7 коҳиш,
- Transformer → TED-Net: тақрибан %27,8 коҳиш
ба даст меояд.
Манбаъ шарҳ намедиҳад, ки нисбати %42 аз кадом таҷриба ё baseline-и дигар ҳисоб шудааст. Аз ин рӯ, Verianla ин нисбатро ҳамчун натиҷаи тасдиқшудаи CATL истифода намекунад.
Оё ин таҳқиқот стратегияи фоидаовари HFT-ро нишон медиҳад?
Не. Модел нархи дақиқаи ояндаро пешгӯӣ мекунад.
Дар таҳқиқот:
- қоидаи қарори харид/фурӯш,
- андозаи мавқеъ,
- bid-ask spread,
- commission,
- slippage,
- queue position,
- network latency,
- P&L-и савдои иҷрошуда,
- Sharpe ratio,
- maximum drawdown
бар асоси онҳо trading backtest гузаронда нашудааст.
Аз ин рӯ, RMSE-и паст ё R²-и баланд мустақиман ба стратегияи савдои аз ҷиҳати иқтисодӣ фоидаовар баробар нест.
Ҷиҳатҳои қавии таҳқиқот
- Якҷо кардани SAE, LSTM ва MSA дар як меъморӣ бо нақшҳои равшан.
- Муттаҳид кардани намудҳои гуногуни намояндагӣ тавассути collaborative decoder.
- Гузаронидани муқоиса дар понздаҳ саҳмияи гуногун.
- Пешниҳоди натиҷаҳои ablation барои SAE ва MSA.
- Гузориш кардани метрикаҳои равшани регрессия, аз ҷумла RMSE, MAE ва R² дар CATL.
- Истифодаи моделҳои пурқуввати қаторҳои вақтӣ, ба монанди Transformer ва TCN, ҳамчун benchmark.
Маҳдудиятҳои асосӣ
- Таҳқиқот ҳанӯз v1 preprint аст ва аз арзёбии ҳамсолон нагузаштааст.
- Додаҳои якдақиқагӣ бо таърифи классикии HFT-и микросониягӣ яксон нестанд.
- Иддаои додаҳои “Million-level” бо шумораи observation-и шарҳдодашуда мувофиқат намекунад.
- Методологияҳои арзёбии regression ва classification бо ҳам омехта шудаанд.
- Таърифи метрикаи Table 3 accuracy дода нашудааст.
- Дар таҷрибаҳои гуногун андозаи вуруд 10 ва 8 тағйир меёбад.
- Истифодаи якҷояи ду сохтори sequence-и 30 ва 120 дақиқагӣ ба қадри кофӣ шарҳ дода нашудааст.
- Маънои коэффисиентҳои натиҷаи PCA равшан нест.
- Коҳиши %42-и RMSE бо ҷадвали CATL мустақиман тасдиқ намешавад.
- Ибораи “1,5 yuan average error” бо MAE 2,0872 мувофиқат намекунад.
- Trading profitability ё execution backtest вуҷуд надорад.
- Дар матни манбаъ placeholder-ҳои таҳрирӣ ҳанӯз боқӣ мондаанд.
Ёддошт оид ба Манбаъ ва Усул
Унвони аслӣ: A Triple Encoder-Decoder Network with Multi-Head Self-Attention and Stacked Autoencoder for High-Frequency Trading Prediction
Муаллифон: Zhuxi Zhang; Yan Zhang; Haolin Yuan; Min Zhu; Zihan Zhao.
Муассисаҳо: China Institute of Finance, University of International Business and Economics, Beijing; Digital Technology Research and Development Center, Beijing Research Institute of Ansteel Co., Ltd., Beijing.
Навъи манбаъ: Preprint / Article.
Платформа: Preprints.org.
Версия: Version 1.
Пешниҳод шудааст: 10 сентябри 2026.
Нашр шудааст: 14 сентябри 2026.
DOI: 10.20944/preprints202609.0978.v1.
Ҳолати ҳамсанҷӣ: Аз арзёбии ҳамсолон нагузаштааст. Манбаъ ва сабти Preprints.org ба таври равшан ибораи “Not peer-reviewed”-ро доранд.
Иҷозатнома: Creative Commons Attribution 4.0 International — CC BY 4.0.
Усули асосӣ: Stacked Autoencoder + LSTM-Seq2Seq + Multi-Head Self-Attention + Dynamic Window Attention + collaborative decoder.
Вазифаи асосӣ: Пешгӯии нархи саҳмияи дақиқаи оянда аз додаҳои молиявии якдақиқагӣ тавассути регрессия.
Таҷрибаи асосӣ: 15 саҳмияи A-share × 24.000 мушоҳидаи якдақиқагӣ; %80 training ва %20 validation.
Маҷмӯи таҷрибаи CATL: Аз 8 июли 2025 то 13 марти 2026 39.604 мушоҳидаи якдақиқагӣ.
Натиҷаи асосии CATL: TED-Net RMSE 2,2292; MAE 2,0872; R² 0,97.
Маблағгузорӣ: National Major Science and Technology Project of Intelligent Manufacturing Systems and Robots; grant 2025ZD1607900.
Дастрасии додаҳо: Муаллифон мегӯянд, ки додаҳоро аз corresponding author бо дархост гирифтан мумкин аст.
Бархӯрди манфиатҳо: Муаллифон эълом мекунанд, ки бархӯрди манфиатҳо вуҷуд надорад.
Огоҳии draft-status: Ёддошти таҳририи тасдиқ дар бахши Author Contributions ва placeholder-и муаллифи нопурра дар Reference 22 дар версияи preprint боқӣ мондааст.
Огоҳии методологӣ: Гузариш байни метрикаҳои classification дар бахши ablation ва вазифаи асосии regression шарҳ дода нашудааст. Таърифи метрикаи Table 3 prediction-accuracy низ дода нашудааст.
Огоҳии истилоҳоти HFT: Таҳқиқот execution-и микросониягӣ ё tick-level limit-order-book HFT-ро намесанҷад; таҷрибаҳо дар қаторҳои вақти якдақиқагӣ гузаронда шудаанд.
Ҳудуди тафсири иқтисодӣ: Дақиқии пешгӯӣ ё R², бе натиҷаҳои стратегияи савдо, ки transaction cost ва рафтори execution-ро дар бар мегиранд, нишондиҳандаи мустақими фоидаоварӣ нест.
Шарҳ гузоред
Нишонии почтаи электронии шумо нашр намешавад. Майдонҳои ҳатмӣ бо * нишон дода шудаанд