

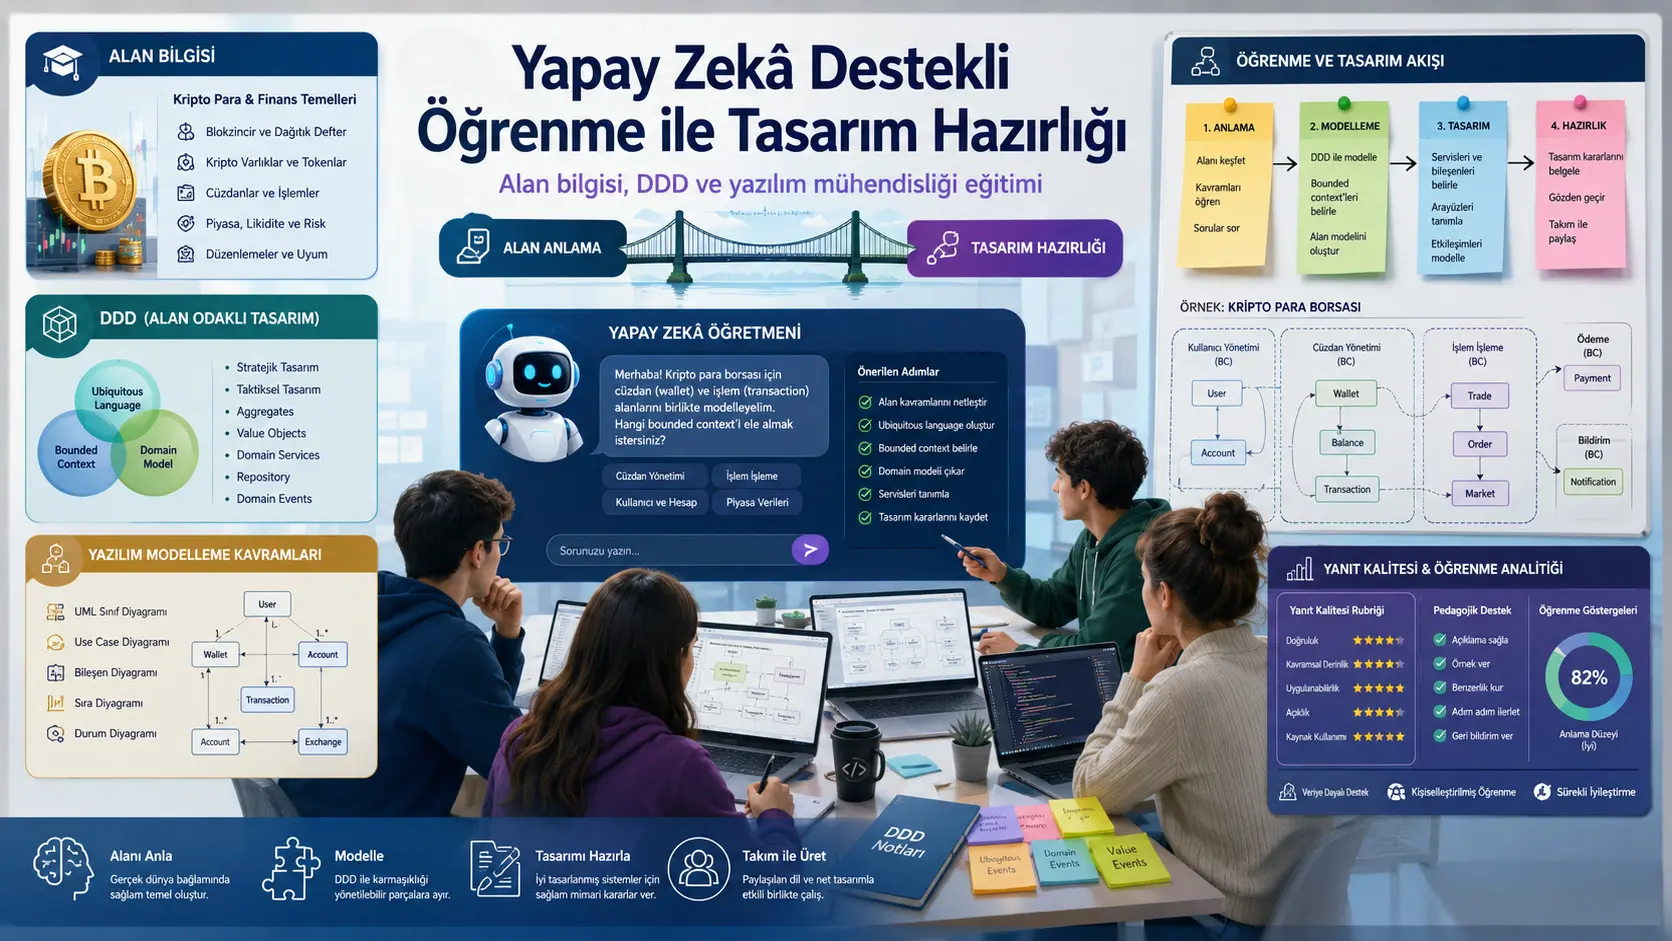
Ин таҳқиқот ба масъалае тамаркуз мекунад, ки донишҷӯёни муҳандисии нармафзор бояд на танҳо барномасозиро омӯзанд, балки дар муддати кӯтоҳ соҳаи корие, ки барои он нармафзор таҳия мекунанд, ва усулҳои лозим барои моделсозии ин соҳаро низ аз худ намоянд. Дар таҳқиқот 29 донишҷӯи магистр барои омӯхтани мафҳумҳои асосии молиявӣ дар арбитражи криптовалюта ва равиши Domain-Driven Design аз омӯзгори ChatGPT истифода карданд, ки бо маводи дарсӣ махсусгардонӣ шуда буд.
Татбиқ дар марҳилаи дӯҳфтаинаи тарҳрезии як курси functional programming дар Carnegie Mellon University Silicon Valley анҷом дода шуд. Барои низоми автоматии арбитражи криптовалюта бо номи “ArbitrageGainer”, ки донишҷӯён дар гурӯҳҳо таҳия мекарданд, онҳо аввал бояд соҳаи молиявиро дарк мекарданд ва сипас унсурҳои Domain-Driven Design, аз ҷумла event storming, commands, external systems, workflows ва bounded contexts-ро муайян менамуданд.
Омӯзгори махсуси зеҳни сунъӣ бар GPT-3.5 Turbo сохта шуда, бо слайдҳои дарс, талаботи лоиҳа ва намунаи тарҳи як донишҷӯ асоснок карда шудааст. Дар се фаъолияти ҷудогонаи пеш аз дарс ба донишҷӯён ҳар дафъа ду standard prompt дода шуда, аз онҳо хоста шудааст сабтҳои гуфтугӯро содир кунанд ва ҳисоботи кӯтоҳи санҷиши донишро пур намоянд. Ҳамин тавр тақрибан 174 ҷуфти standard prompt-response ба вуҷуд омадааст. Муҳаққиқ 60 адади онҳоро, яъне 34,5 фоизро, бо stratified random sampling арзёбӣ кардааст.
Холи дурустии ҷавобҳо 98,9 фоиз, холи мувофиқати мавзӯӣ 92,2 фоиз ва холи арзиши педагогӣ 89,4 фоиз гузориш шудааст. Аз ҷиҳати cognitive load миёна 82,78 фоиз буд, дар ҳоле ки supportiveness, ки ҳамчун ташвиқи донишҷӯ ва роҳнамоӣ ба қадами баъдӣ таъриф шудааст, танҳо 37,78 фоиз монд. Дар 60 ҷавоби баррасишуда мундариҷае, ки муҳаққиқ онро “hallucination ё misinformation” тасниф кунад, ёфт нашуд; дар ду ҷавоб иштибоҳи хурде ошкор гардид, ки донишҷӯро ба таври назаррас гумроҳ намекард.
Худсамаранокии донишҷӯён дар истифодаи зеҳни сунъӣ барои омӯхтани дониши соҳа ва татбиқи Domain-Driven Design пас аз татбиқ ба таври назаррас афзоиш ёфт. Бо вуҷуди ин, study гурӯҳи назоратӣ надорад. Фаъолиятҳои зеҳни сунъӣ ҳамзамон бо lecture-ҳои кӯтоҳ, кори гурӯҳӣ, санҷишҳои ҳатмии дониш ва ҳавасмандкунии баҳо амалӣ шуданд. Аз ин рӯ гуфтан мумкин нест, ки афзоиши эътимод танҳо аз омӯзгори зеҳни сунъӣ ба вуҷуд омадааст.
Муҳимтарин натиҷаи таҳқиқот на фоизҳои муваффақияти омӯзгори зеҳни сунъӣ, балки дастури 17-бандии амалӣ барои омӯзгорон мебошад. Истифодаи knowledge base-и назоратшаванда аз маводи дарсӣ, маҳдуд кардани тафсил ва дарозии ҷавоб, пешакӣ санҷидани мисолҳо, пешгирӣ кардани истилоҳҳои ношинос, роҳнамоии донишҷӯ ба як саволи пайгирии маънодор ва дастгирии фаъолият бо миқдори ками credit-и дарсӣ аз тавсияҳои асосӣ мебошанд.
Масъалаи асосии таҳқиқот чист?
Таҳсилоти муҳандисии нармафзор танҳо забонҳои барномасозӣ ва тавлиди кодро дар бар намегирад. Таҳиягари нармафзор бояд мафҳумҳо, иштирокчиён, қоидаҳо, рӯйдодҳо ва ҳудудҳои соҳаи корие, ки барои он ҳалли нармафзорӣ месозад, дарк кунад. Бе фаҳмиши мафҳумҳои асосии соҳаҳое мисли молия, тандурустӣ, истеҳсолот ё логистика, сохтани модели дурусти талабот ва меъмории нармафзор душвор мешавад.
Ин талабот дар муҳити таълимӣ ду мушкили муҳим ба вуҷуд меорад:
- Донишҷӯён маҷбуранд ҳамзамон бо усулҳои таҳияи нармафзор соҳаҳои татбиқиро, ки барояшон ношиносанд, дар муддати кӯтоҳ омӯзанд.
- Барои омӯзгор таъмин кардани шарҳи инфиродӣ ва feedback-и фаврӣ ба ҳар донишҷӯ ё ҳар гурӯҳ дар вақти дарс scalable нест.
Дар study зикр шудааст, ки дар семестрҳои қаблӣ ҳатто вақте омӯзгор байни гурӯҳҳо мегашт, баъзе саволҳо то охири дарс боқӣ мемонданд ва барои баъзе гурӯҳҳои донишҷӯён 10-30 дақиқаи иловагӣ лозим мешуд. Он ки teaching assistant-и таъйиншуда дар контексти курс дар дастгирии дохилисинфӣ иштирок намекард, низ камбуди ёрии инфиродиро зиёд кардааст.
Ҳадафи асосии таҳқиқот санҷидани он аст, ки оё омӯзгори generative AI, ки бо маводи дарсӣ маҳдуд шудааст, метавонад ин камбуди ёриро коҳиш диҳад. Study мустақиман саволи “Оё AI натиҷаи имтиҳони донишҷӯёнро беҳтар кард?”-ро намесанҷад; се саволи таҳқиқотии зерин баррасӣ шудаанд:
- AI-supported learning то чӣ андоза дастгирии баландсифат барои омодагии донишҷӯён ба марҳилаи тарҳрезӣ таъмин кардааст?
- Ҷавобҳои омӯзгори AI аз ҷиҳати арзиши педагогӣ, cognitive load ва supportiveness чӣ гуна сифат нишон додаанд?
- Кадом амалҳои таълимӣ метавонанд самаранокии AI-supported learning-ро дар муҳити курс зиёд кунанд?
Контексти курс ва лоиҳа
Татбиқ дар курси магистрии 12-unit-и functional programming дар семестри тирамоҳи 2024 анҷом дода шуд. Курс яке аз фанҳои асосии барномаи Software Engineering дар Carnegie Mellon University Silicon Valley мебошад. Ҳафтае ду машғулияти рӯбарӯ баргузор шуда, ҳар машғулият 1 соат 50 дақиқа давом мекард.
Яке аз ҳадафҳои курс омӯзиши functional programming ба таври амалӣ ва нишон додани истифодаи он дар контекстҳои саноатӣ буд. Донишҷӯён дар гурӯҳҳои се ё чорнафара дар низоми воқеиятмонанди automatic trading бо номи “ArbitrageGainer” кор карданд.
Лоиҳаи ArbitrageGainer ба арбитражи криптовалюта асос ёфтааст. Танҳо барномасозӣ кофӣ набуд; донишҷӯён бояд чунин мафҳумҳои соҳавиро мефаҳмиданд:
- Биржаҳои криптовалюта ва хадамоти market data,
- Фарқи байни нархи харид ва фурӯш,
- Имкониятҳои арбитраж байни биржаҳои гуногун,
- Механизмҳои order, balance, fee ва иҷрои transaction,
- External systems ва API dependencies,
- Business events ва commands дар низоми automated trading.
Лоиҳа ба чор марҳилаи дӯҳфтаина тақсим шуда буд. Study танҳо марҳилаи аввалро фаро мегирад. Дар ин марҳила донишҷӯён functional requirements-ро ба модели Domain-Driven Design табдил доданд; марҳилаҳои минбаъдаи implementation ва coding ба study дохил нашудаанд.
Чаро Domain-Driven Design истифода шудааст?
Domain-Driven Design ё DDD равиши моделсозист, ки мақсад дорад сохтори нармафзор ва забони истифодашударо бо мафҳумҳои соҳаи асосии тиҷорат мувофиқ созад. Он ба technical team ва domain experts кумак мекунад, ки дар бораи як маҷмӯи муштараки мафҳумҳо ба мувофиқа расанд.
Дар study мафҳумҳои DDD бо lecture-ҳои кӯтоҳи тақрибан 30-дақиқаина қадам ба қадам муаррифӣ шуданд. Пас аз ҳар lecture донишҷӯён дар Miro board гурӯҳӣ кор карданд. Фаъолиятҳо унсурҳои зеринро дар бар гирифтанд:
- Муайян кардани business events бо event storming,
- Ҷойгир кардани рӯйдодҳо бо тартиби вақт,
- Баровардани commands, ки рӯйдодҳоро оғоз мекунанд,
- Муайян кардани external systems берун аз solution scope,
- Ҳуҷҷатгузории workflows бо pseudocode,
- Ташкили bounded contexts.
Дар курсҳои қаблӣ мушоҳида шуда буд, ки донишҷӯён ҳатто external systems-и ошкоро номбаршуда дар project requirements, мисли cryptocurrency exchange ва market-data API, аз модел ҷудо карда наметавонистанд. Аз ин рӯ дар яке аз AI activities prompt-и махсус истифода шудааст, ки typical subsystems ва components-и automatic trading system-ро мепурсид.
Гарчанде дар баъзе individual reports хатоҳо идома доштанд, гузориш шудааст, ки дар final design submissions-и гурӯҳҳо ҳамаи external systems дуруст муайян шудаанд. Бо вуҷуди ин, азбаски study муқоисаи назоратшаванда бо семестри қаблӣ надорад, исбот намешавад, ки ин беҳбудӣ танҳо натиҷаи AI activity буд.
Иштирокчиён киҳо буданд?
Ҳамаи 29 донишҷӯи магистр, ки курсро ба анҷом расониданд, ихтиёран дар study иштирок карданд. Заминаи бакалаврии онҳо чунин буд:
- Computer Science: 15 донишҷӯ,
- Electrical and Computer Engineering: 4 донишҷӯ,
- Software Engineering: 3 донишҷӯ,
- Дигар соҳаҳои муҳандисӣ, молия ё математика: 7 донишҷӯ.
Дар байни донишҷӯёне, ки таҷрибаи равшантар дар молия доштанд, панҷ individual investor, ду донишҷӯе, ки дар fintech sector кор карда буданд, ва як донишҷӯ бо minor дар finance ё economics буданд. Таҷрибаи Domain-Driven Design бошад, барои се донишҷӯ аз курсҳои қаблӣ ва барои ду донишҷӯ аз industrial experience омада буд.
Шакли 1: Дониши ибтидоии донишҷӯён
Figure 1 дар саҳифаи дуюми PDF self-report-и донишҷӯёнро дар мавзӯъҳои finance ва DDD бо ду pie chart нишон медиҳад.
| Сатҳи дониш | Дониш ё таҷрибаи молиявӣ | Дониш ё таҷрибаи DDD |
|---|---|---|
| Ҳеҷ | %31 | %39 |
| Каме | %38 | %38 |
| Миёна | %19 | %19 |
| Равшан | %12 | %4 |
Дар finance 69 фоиз ва дар DDD 77 фоизи донишҷӯён дониши худро “ҳеҷ” ё “каме” арзёбӣ кардаанд. Ин тақсимот нишон медиҳад, ки AI activities барои омодагии сатҳи ибтидоӣ ва миёна истифода шудаанд, на барои expertise-и пешрафта.
AI activities чӣ гуна ба барномаи курс ҷойгир карда шуданд?
Барои пешгирӣ аз он ки донишҷӯён AI work-ро ҳамчун optional extra assignment қабул кунанд, муҳаққиқ дар course design се тағйирот ворид кард:
- AI usage-ро ба learning outcome-и ошкори курс табдил дод.
- Ҳадафи activities ва нақши онҳо дар курс ба донишҷӯён такроран шарҳ дода шуд.
- Ҳамаи AI activities ҳатмӣ ва бо course credit мукофотонидашаванда шуданд.
Learning outcome-и муайяншуда талаб мекард, ки донишҷӯён generative AI-ро барои гирифтани domain knowledge ва дуруст татбиқ кардани DDD дар collaborative project истифода кунанд.
Донишгоҳ инчунин талаб мекард, ки ҳамаи донишҷӯён дар ҳафтаи аввали курс module-и generative-AI literacy-и 90-120-дақиқаинаро ба анҷом расонанд. Ин module, ки ба 1 фоизи course grade баробар буд, principles-и кори AI systems, ethical ва contextual issues ва responsible-use strategies-ро фаро мегирифт.
Ҷадвали дӯҳфтаинаи фаъолиятҳо
| Марҳила | Вақти тахминӣ | Ҳадаф | Фаъолияти донишҷӯ | Натиҷаи тавлидшуда |
|---|---|---|---|---|
| Пеш аз дарс 1 | 30-45 дақиқа | Оғоз кардани дониш дар соҳаи finance | Хондани project specification, иҷрои prompts 1.1 ва 1.2, optional follow-up questions, knowledge check 1 | Conversation record-и ду standard prompt ва report бо се open-ended question |
| Дар синф 1 | 1 соат 50 дақиқа | Оғози project ва DDD modeling | System introduction, DDD mini-lecture ва group event storming | Miro board бо business events |
| Пеш аз дарс 2 | 20-30 дақиқа | Омӯхтани core DDD concepts | Иҷрои prompts 2.1 ва 2.2, export-и conversation ва knowledge check 2 | Conversation record ва report бо ду open-ended question |
| Дар синф 2 | 1 соат 50 дақиқа | Анҷом додани core DDD activity | Ordering events, extracting commands ва external systems | Updated team Miro board |
| Пеш аз дарс 3 | 30-45 дақиқа | Татбиқи DDD terminology ба project deliverables | Иҷрои prompts 3.1 ва 3.2, export-и conversation ва knowledge check 3 | Conversation record ва report бо як open-ended question |
| Дар синф 3 | 1 соат 50 дақиқа | Ташкили stage deliverables | Team definition of workflows and bounded contexts | Miro board бо bounded contexts ва workflow pseudocode draft |
Пас аз ҳар AI activity донишҷӯён бояд conversation transcript-ро ҳамроҳ бо knowledge check ва short reflection report месупориданд. Барои он ки report дар пешниҳоди аввал pass ҳисоб шавад, ҳамаи knowledge-check questions бояд бо short justification дуруст ҷавоб дода шуда, conversation record замима мешуд.
Гузориш шудааст, ки тақрибан 93 фоизи донишҷӯён ҳамаи се report-ро дар вақти интизоршуда супорида ва дар first submission гузаштаанд. Ин нишон медиҳад, ки омодагӣ ба курс баланд буд; аммо таъсири mandatory work ва grade incentive ба participation алоҳида чен нашудааст.
Омӯзгори махсуси ChatGPT чӣ гуна сохта шуд?
Омӯзгор бо GPT-3.5 Turbo сохта шудааст. Model бо ду роҳ махсусгардонӣ шуд:
- System prompt-и муфассал истифода шуд, ки role, tasks, boundaries, корҳое ки бояд кунад ва набояд кунад, шарҳ медод.
- Course slides, project specification ва sample student DDD solution ба ChatGPT knowledge configuration бор карда шуданд.
Дар system prompt унсурҳои зерин буданд:
- Tutor persona ва context,
- Дастур барои истифодаи course materials ҳамчун primary source,
- Learning tasks, ки бояд дастгирӣ шаванд,
- Restrictions ва prohibited behaviors,
- Desired response format ва presentation characteristics,
- Қоидаҳои пайравӣ ба course terminology.
Instructor пеш аз оғози семестр configuration-ро бо scripted trials, ки expected student interactions-ро намояндагӣ мекарданд, такроран санҷид. Ҳар version дар панҷ trial арзёбӣ шуда, то он даме ислоҳ шуд, ки responses correct course terminology, depth-и кофӣ барои workshop-и баъдӣ ва миқдори ками boilerplate text диҳанд.
Configuration дар version чорум ниҳоӣ ва дар оғози activity-и аввал frozen карда шуд. Ин decision consistency байни донишҷӯёнро таъмин кард, вале possibility-и adaptation ба different interaction styles-ро кам кард.
Донишҷӯён ба shared tutor instance бе authentication дастрасӣ доштанд. Азбаски temperature ё other generation parameters дар ChatGPT interface тағйир дода намешуданд, default values истифода шуданд. Муқоисаи GPT-3.5 бо дигар models анҷом дода нашуд.
Кадом додаҳо ҷамъоварӣ шуданд?
Study дар се time point дода ҷамъ кард:
- Пеш аз татбиқ: Student background, experience дар finance, functional programming ва DDD, ва панҷ self-efficacy statement.
- Ҳангоми татбиқ: Conversation records-и standard prompts, knowledge checks ва student reflection reports.
- Пас аз татбиқ: End-of-term student views ва self-efficacy measurements.
Ду measure-и асосӣ дар self-efficacy analysis чунин буданд:
- “Ман метавонам generative AI-ро барои гирифтани domain knowledge истифода кунам.”
- “Ман метавонам generative AI-ро барои дуруст татбиқ кардани DDD дар collaborative project истифода кунам.”
Ифодаи “Ман метавонам барои real business requirements як domain-driven model тарҳрезӣ кунам” ҳамчун measure-и сеюм ва exploratory истифода шуд. Азбаски ин statement мустақиман ба AI ишора намекунад, improvement-и бадастомада метавонад аз project practice ё mini-lectures низ сарчашма гирифта бошад.
Додаҳои гуфтугӯ ва усули намунагирӣ
Барои ҳар донишҷӯ пешбинӣ шуда буд, ки дар се activity ҳар дафъа ду standard prompt иҷро кунад:
\[ 29 \times 3 \times 2 = 174 \]
Ҳамин тавр тақрибан 174 standard prompt-response pair ба вуҷуд омад. Ду prompt дар ҳар activity ҳамчун як conversation unit қабул шуда, дар маҷмӯъ:
\[ 29 \times 3 = 87 \]
conversation unit ба даст омад.
Аз ҳар session 10 conversation unit ба таври random интихоб шуд. Ҳамин тавр аз се session дар маҷмӯъ 30 conversation unit ва 60 prompt-response pair арзёбӣ шуд.
Таносуби зерин дар мақола ҳамчун equation-и ҷудогона дода нашудааст; барои шарҳи sampling ratio илова шудааст:
\[ \text{Örnekleme oranı} =\frac{60}{174}\times100 \approx34{,}5\% \]
Sampling бо random.org, stratified by session ва without replacement анҷом дода шуд. Интихоби ду standard prompt якҷоя контексти дохили conversation-ро нигоҳ дошт; гирифтани шумораи баробари units аз ҳар session representation-и finance, basic DDD ва advanced DDD topics-ро таъмин кард.
Follow-up questions-и интихобкардаи худи донишҷӯён иҷозат дода шуданд, вале азбаски стандартӣ набуданд, ба evaluation дохил нашуданд. Аз ин рӯ results тамоми real ва free-form AI use-ро намояндагӣ намекунанд, балки ҷавобҳо ба predefined prompts-ро инъикос мекунанд.
Ҷавобҳо бо кадом меъёрҳо арзёбӣ шуданд?
Ҳар ҷавоб дар панҷ dimension аз 0 то 3 хол гирифтааст:
| Dimension | Хусусияти ченшуда | Маънои холи баландтарин |
|---|---|---|
| Дурустии иттилоот | Дурустии factual, conceptual ва technical | Ҷавоб дуруст, бо domain knowledge мувофиқ ва бе significant error аст |
| Relevance | Ҷавоби мустақим ва мувофиқ ба context | Мундариҷаи unnecessary ё off-topic надорад |
| Арзиши педагогӣ | Depth, structured explanation, terminology ва examples | Explanation-и кофӣ ва appropriate example барои пешбурди learning медиҳад |
| Cognitive load | Clarity, brevity, accessibility ва level appropriateness | Бе unnecessary complexity осон фаҳмида мешавад |
| Support and encouragement | Эътирофи кӯшиши донишҷӯ ва роҳнамоӣ ба қадами баъдӣ | Донишҷӯро тасдиқ, ташвиқ ва ба идомаи learning даъват мекунад |
Supportiveness як proxy measure-и сохтаи муҳаққиқ мебошад. Он ҳамчун омезиши praise ё validation-и кӯтоҳ бо invitation барои exploring next step таъриф шудааст. Ин psychological emotion ё motivation scale-и validated нест.
Барои шарҳи табдили dimensions ба percentage муносибати зерин истифода шуданаш мумкин аст. Ин statement дар мақола ҳамчун equation пешниҳод нашудааст:
\[ \text{Boyut yüzdesi} =\frac{\sum_{i=1}^{n}s_i}{3n}\times100 \]
Дар ин ҷо si холи ҳар response аз 0-3 ва n шумораи responses-и evaluated мебошад.
Кӣ арзёбӣ кард?
Scoring-и асосиро instructor-и курс ва author-и study анҷом дод. Гарчанде author шахсе буд, ки course context ва expected terminology-ро беҳтарин медонист, single evaluator будан risk-и observer bias ба вуҷуд меорад.
Барои consistency check ду trained teaching assistant, ки қаблан курсро гирифта буданд, ҳамон 15 conversation record-ро, панҷ адад аз ҳар session, мустақилона score карданд. Evaluators аввал дар панҷ anonymized record 90-дақиқа rubric calibration гузарониданд.
Weighted Cohen kappa values байни instructor ва ду assistant чунин буданд:
- Teaching assistant-и аввал: κ=0,76,
- Teaching assistant-и дуюм: κ=0,78.
Exact agreement 72-74 фоиз ва agreement бо фарқи на бештар аз як хол 99,3 фоиз гузориш шудааст. Ин қиматҳо дар subset-и баррасишуда consistency-и қавиро нишон медиҳанд; ҳамаи 60 response аз ҷониби ду ё се evaluator score нашудаанд.
Дурустии ҷавобҳо
Миёнаи accuracy 98,9 фоиз аст. Мувофиқи Figure 3 тақрибан 97 фоизи responses холи 3 ва 3 фоиз холи 2 гирифтаанд. Ин distribution бо он мувофиқ аст, ки 58 response full score ва ду response level-и minor inaccuracy гирифтаанд.
Муҳаққиқ мегӯяд, ки дар sample-и баррасишуда “hallucination”-и комилан нодуруст ё донишҷӯро гумроҳкунанда ошкор накардааст. Ду мушкили хурд чунинанд:
- Дар advanced DDD topics таърифи қисман misleading-и “domain service”, ки дар secondary internet sources низ дида мешавад,
- Дар як example номи event ба bounded context-и зикршуда пурра мувофиқ набуд.
Ин натиҷа маънои онро надорад, ки GPT-3.5 умуман 98,9 фоиз дуруст аст. Measurement танҳо барои шаш standard prompt, knowledge base-и бо course materials маҳдуд ва 60 response дар як course context эътибор дорад.
Relevance-и ҷавобҳо
Миёнаи relevance 92,2 фоиз аст. Мувофиқи Figure 3 тақрибан 77 фоизи responses highest score ва 23 фоиз second-level score гирифтаанд; ҳеҷ response ба 0 ё 1 хол наафтодааст.
Се масъала relevance-ро кам кардаанд:
- Норасоии баъзе supporting finance concepts дар knowledge base,
- Берун рафтани response аз project scope-и донишҷӯ,
- Дароз шудани матн бо introduction, repetition ва conclusion paragraphs бе иловаи иттилооти нав.
Донишҷӯён гузориш карданд, ки model бо донистани project description ҷавобҳоро кӯтоҳтар ва contextual месозад. Баъзе донишҷӯён гуфтанд, ки аз байни unnecessary content интихоб кардани қисми муфид баъзан душвор аст.
Арзиши педагогӣ
Миёнаи pedagogical value 89,4 фоиз аст. Дар Figure 3, 70 фоизи responses холи 3, тақрибан 28 фоиз холи 2 ва тақрибан 2 фоиз холи 1 гирифтаанд.
Аксари responses correct terms, structured explanation ва ҳадди ақал як example доштанд. Дар abstract topics баъзан ду example истифода шудааст. Танҳо як response барои он ки typical components-и automated arbitrage system-ро бе шарҳ ҳамчун general headings рӯйхат кард, холи 1 гирифт.
Донишҷӯён ду мушкили муқобилро гузориш карданд:
- Баъзе explanations барои beginner student аз ҳад technical буданд,
- Баъзе explanations барои student-и аллакай огоҳ аз мавзӯъ аз ҳад superficial монданд.
Ин мушкил нишон медиҳад, ки як standard detail level барои ҳамаи донишҷӯён бо prior knowledge-и гуногун мувофиқ нахоҳад буд.
Cognitive load
Миёнаи dimension-и cognitive load 82,78 фоиз аст. Дар Figure 3 тақрибан 55 фоиз highest, 38 фоиз second ва 7 фоиз third level дида мешавад. Lower scores бо response length, repetition, unexplained terms ва too many examples алоқаманд шудаанд.
Муҳаққиқ дар text 5 фоизи responses-ро “overwhelming” тавсиф мекунад, дар ҳоле ки дар Figure 3 lowest observed distribution тақрибан 7 фоиз аст. Ин фарқи хурд яке аз numerical inconsistencies-и report мебошад.
Манбаъҳои асосии cognitive load чунин муайян шудаанд:
- Такрори як нуқта дар introduction, main body ва conclusion,
- Истифодаи terms-и дар course knowledge base набуда бе explanation,
- Додани examples аз ҳад зиёд барои concept-и оддӣ,
- Мутобиқ нашудани response ба detail level-и дархостшудаи донишҷӯ.
Чаро supportiveness паст монд?
Миёнаи support and encouragement танҳо 37,78 фоиз аст. Мувофиқи Figure 3 тақрибан 87 фоизи responses холи 1 ва 13 фоиз холи 2 гирифтаанд; ҳеҷ response highest support level-ро нагирифтааст.
Model асосан tone-и neutral ва information-delivery истифода кардааст. Ифодаҳое, ки саволи донишҷӯро мусбат тасдиқ мекунанд, кӯшиши ӯро мешиносанд ё ба next specific step даъват мекунанд, кам буданд.
Аксари encouraging expressions дар activity-и сеюм дида шуданд, ки standard prompt ошкоро нишон медод, донишҷӯ task-ро анҷом додааст. Ин нишон медиҳад, ки supportive tone бештар аз contextual cue-и prompt пайдо шудааст, на spontaneous behavior-и model.
Supportiveness-и паст маънои нодуруст будани иттилоотро надорад. Аммо агар мақсад ин бошад, ки tutor на танҳо answer диҳад, балки ongoing learning process-и student-ро дастгирӣ кунад, light tutoring ё coaching tone бояд дар system prompt ошкоро таъриф шавад.
Номувофиқиҳои рақамӣ дар Figure 3 ва матн
Figure 3 дар саҳифаи ҳафтуми PDF distribution-и scores-и dimensions-ро нишон медиҳад. Вақте figure ва reported averages якҷоя арзёбӣ мешаванд, approximate distribution чунин аст:
| Dimension | Score 3 | Score 2 | Score 1 | Reported average |
|---|---|---|---|---|
| Accuracy | %97 | %3 | %0 | %98,9 |
| Relevance | %77 | %23 | %0 | %92,2 |
| Pedagogical value | %70 | %28 | %2 | %89,4 |
| Cognitive load | %55 | %38 | %7 | %82,78 |
| Supportiveness | %0 | %13 | %87 | %37,78 |
Distributions дар figure ва averages аз ҷиҳати математикӣ ба ҳам наздиканд. Аммо дар main text:
- Фоизи highest score дар relevance 82,5 фоиз,
- Фоизи highest score дар pedagogical value 77,5 фоиз
навишта шудааст. Ин ratios бо Figure 3 мувофиқ нестанд.
Илова бар ин, ду minor error аз 60 response ба:
\[ \frac{2}{60}\times100=3{,}33\% \]
баробар аст. Дар abstract section 2/60 ва 3,3 фоиз дуруст дода шудааст, дар ҳоле ки discussion section 1,1 фоиз менависад. Ин хато main direction-и results-ро тағйир намедиҳад, аммо барои reporting accuracy бояд қайд шавад.
Натиҷаҳои self-efficacy
Self-efficacy-и донишҷӯён пеш ва пас аз implementation бо paired analysis муқоиса шуд.
| Self-efficacy item | Statistical result | Effect size | Interpretation |
|---|---|---|---|
| Гирифтани domain knowledge бо AI | F(1,22)=24,41; p<0,001 | Partial η²=0,53; dz≈1,03 | Афзоиши калони confidence |
| Татбиқи DDD дар collaborative project бо AI | F(1,21)=14,81; p<0,001 | Partial η²=0,41; dz≈0,82 | Афзоиши калони confidence |
| Тарҳрезии DDD model барои real business requirements | F(1,21)=45,82; p<0,001 | Partial η²=0,69; dz≈1,44 | Афзоиши хеле калон; exploratory result, ки AI-specific нест |
F(1,22) барои item-и аввал ба 23 paired observation ва F(1,21) барои дигар items ба 22 paired observation ишора мекунад. Аз ин рӯ self-efficacy analyses ҳамаи 29 донишҷӯро дар бар намегиранд. Сабабҳои missing paired responses ба таври муфассал шарҳ дода нашудаанд.
Partial eta squared effect size аст, ки нишон медиҳад чӣ қадар аз total variation бо time ё pre-post difference алоқаманд аст. Paired Cohen dz бошад mean change-ро нисбат ба variability байни individuals standardize мекунад. Reported values ба confidence gains-и practically substantial ишора мекунанд, на танҳо small statistical difference.
Аммо self-efficacy худи skill нест. Донишҷӯ метавонад худро competentтар ҳис кунад, вале дар objective design exam ҳамон миқдор improvement нишон надиҳад. Study independent blind-scored competency test ё control group надорад.
Figure 2: Confidence пеш ва пас аз implementation
Figure 2 дар саҳифаи шашуми PDF group averages-и items оид ба гирифтани domain knowledge ва татбиқи DDD бо AI-ро бо 95 фоиз confidence intervals нишон медиҳад.
Аз graph тахминан хонда мешавад, ки:
- Confidence барои гирифтани domain knowledge аз сатҳи 58 то тақрибан 85,
- Confidence барои татбиқи DDD аз сатҳи 51 то тақрибан 77
афзоиш ёфтааст. Ин values аз graph тақрибан хонда шудаанд; main text exact means-ро дар table надодааст. Vertical error bars 95 фоиз confidence intervals-ро нишон медиҳанд.
Чаро афзоиши self-efficacy натиҷаи causal нест?
AI tutor танҳо татбиқ нашудааст. Дар ҳамон давра донишҷӯён:
- DDD mini-lectures гирифтанд,
- Дар real project гурӯҳӣ кор карданд,
- Дар Miro board event storming анҷом доданд,
- Knowledge-check questions-ро ҷавоб доданд,
- Аз instructor ё дигар sources ёрӣ гирифтанд,
- Дар mandatory ва graded activities иштирок карданд.
Азбаски ин combined interventions аз ҳам ҷудо карда нашудаанд, observed confidence increase бо тамоми AI-supported learning environment алоқаманд аст. Statement-и causal мисли “ChatGPT self-efficacy-ро ҳамин қадар зиёд кард” аз ҷониби study дастгирӣ намешавад.
Чорчӯбаҳои назариявии истифодашуда дар instructional design
Муҳаққиқ results-ро бо се learning theory тафсир кардааст:
Cognitive Load Theory
Unnecessary repetition, excessive length, too many examples ва unexplained terms метавонанд working memory-и student-ро бо content-и ба learning кумакнакунанда пур кунанд. Тавсияҳои маҳдуд кардани response length ва number of examples ба ҳамин framework такя мекунанд.
ICAP framework
ICAP participation-и student-ро дар levels passive, active, constructive ва interactive баррасӣ мекунад. Танҳо хондани response метавонад дар active level монад. Агар model specific follow-up question ё application task пешниҳод кунад, student метавонад ба constructive ва interactive engagement ҳаракат кунад.
Self-efficacy
Боварии донишҷӯ ба он ки метавонад task-ро иҷро кунад, метавонад ба идомаи learning ва persistence дар difficult tasks таъсир расонад. Муҳаққиқ пешниҳод мекунад, ки low supportiveness шояд confidence growth-ро дар баъзе students маҳдуд карда бошад. Ин possibility мустақим experimentally test нашудааст.
17 амали тавсияшудаи таълимӣ
| Code | Practice | Purpose | Implementation |
|---|---|---|---|
| P1 | Expected detail level-ро муайян кунед | Пешгирӣ аз response-и хеле superficial ё excessively detailed | Маҳдудият нависед, масалан “дар 3-4 sentence ва як concrete example шарҳ деҳ” |
| P2 | Length-ро маҳдуд кунед | Кам кардани cognitive load аз repetition ва long introductions | At most two short paragraphs ва ban on unnecessary intro/summary |
| P3 | Number of examples-ро маҳдуд кунед | Пешгирӣ аз пинҳон шудани main concept бо examples-и зиёд | Як example барои simple topic ва at most two барои complex topic |
| P4 | Guardrail examples-ро пешакӣ интихоб кунед | Кам кардани generic ё context-inappropriate examples | Аз trial runs 1-3 example-и беҳтаринро ба system prompt илова кунед |
| P5 | Unfamiliar terms-ро манъ кунед | Кам кардани cognitive load аз unexplained jargon | Forbidden-term list ва requirement for definition of every out-of-course term |
| P6 | Supportive tone илова кунед | Neutral information delivery-ро бо light tutoring tone пурра кунед | Persona муайян кунед, ки effort-и student-ро мешиносад ва ба exploration даъват мекунад |
| P7 | Knowledge base-ро бодиққат созед | Ҳифзи accuracy ва relevance | Short reliable course materials, ки main ва supporting domains-ро фаро мегиранд, илова кунед |
| P8 | Signpost, don't repeat | Пешгирӣ аз такрори same information дар sections-и гуногун | Short headings, one-pass rule ва brief reference ба definition-и қаблӣ |
| P9 | AI guidance илова кунед | Гузаронидани student ба constructive follow-up interaction | Дар ҳар session як specific follow-up question барои explanation, application ё extension пешниҳод кунед |
| P10 | AI use-ро learning outcome кунед | Visible кардани relevance-и activity ба course | Responsible AI use барои analysis ё modeling-ро ба course outcome илова кунед |
| P11 | Дар оғоз workshop-и хурд ташкил кунед | Кам кардани фарқи AI literacy байни students | 30-45-дақиқа prompt, follow-up question ва critical evaluation practice |
| P12 | Ба work course credit диҳед | Нигоҳ доштани participation ва legitimizing time spent | 1-5 фоизи total grade-ро мувофиқи required effort ҷудо кунед |
| P13 | Instructions-ро centralize кунед | Кам кардани access and usage confusion | Дар LMS як page бо access, prompt examples ва expectations созед |
| P14 | Short conversation notes талаб кунед | Таъмини reflection ва usage traceability | Student аз short template барои export-и conversation record истифода барад |
| P15 | Simple knowledge-check rubric истифода кунед | Ҷудо кардани careful use аз superficial participation | Three-level rapid scoring барои ҳар question |
| P16 | Evaluation-ро дар scale delegate кунед | Кам кардани instructor workload | TAs-ро бо shared examples calibrate карда, batch scoring by question анҷом диҳед |
| P17 | Question difficulty ва format-ро diversify кунед | Мутобиқ шудан ба starting levels-и гуногун | Definition, application to project ва small design tasks-ро якҷоя истифода кунед |
Панҷ practice-и баландтарин leverage
Table 3 дар саҳифаи нуҳуми PDF аз ҷиҳати implementation cost ва transferability ба different software-engineering courses панҷ practice-ро ҳамчун highest priority интихоб мекунад:
| Priority | Practice | Targeted problem | Implementation cost |
|---|---|---|---|
| P7 | Knowledge base-ро бодиққат сохтан | Accuracy ва relevance | Medium |
| P2 | Response length-ро маҳдуд кардан | Cognitive load ва unnecessary text | Low |
| P8 | Information-ро signpost карда, такрор накардан | Repetition-related cognitive load | Low |
| P9 | Як meaningful follow-up guidance илова кардан | Learning interaction ва purposeful continuation questions | Low |
| P4 | Examples-ро пешакӣ review кардан | Incorrect ё context-mismatched examples | Medium |
Ҷиҳатҳои қавии study кадомҳоянд?
- AI tutor-ро дар real course ва real team project арзёбӣ мекунад.
- Ба ҷои programming support ба less-studied skills, мисли domain knowledge ва software modeling, тамаркуз мекунад.
- Tutor-ро бо course slides, project requirements ва sample submission асоснок мекунад.
- Бо standard prompts байни students comparable data тавлид мекунад.
- Бо session-stratified random sampling representation-и three topic domains-ро таъмин мекунад.
- Accuracy-ро танҳо criterion намегирад; relevance, pedagogical value, cognitive load ва supportiveness-ро ҳамзамон арзёбӣ мекунад.
- Бо ду teaching assistant consistency-и evaluators-ро дар subset месанҷад.
- На танҳо positive results, балки мушкилоти supportiveness, length, jargon ва example mismatch-ро низ гузориш мекунад.
- Findings-ро ба 17-item guide табдил медиҳад, ки educators метавонанд мустақим истифода кунанд.
- Ошткора мегӯяд, ки study causal нест ва self-efficacy маънои skill-ро надорад.
- Гузориш мекунад, ки replication package бо prompts, configuration, anonymized records, rubric ва analysis scripts пешниҳод шудааст.
Маҳдудиятҳои study кадомҳоянд?
- Як institution ва як course: Results танҳо аз контексти як graduate course дар Carnegie Mellon Silicon Valley меоянд.
- Small participant count: Дар маҷмӯъ 29 student вуҷуд дорад.
- No control group: Comparison group, ки same activities-ро бе AI анҷом диҳад, вуҷуд надорад.
- No causal separation: Mini-lectures, team practice, knowledge checks ва grade incentive ҳамзамон бо AI татбиқ шуданд.
- Self-efficacy measure: Confidence increase increase-и direct knowledge ё design skill нест.
- Missing paired surveys: Self-efficacy analyses ба 22 ё 23 student асос ёфтаанд, на 29.
- Standard prompts: Шаш predefined prompt арзёбӣ шуд, на free and natural student conversations.
- Exclusion of follow-up questions: Interactive teaching performance-и AI tutor пурра чен нашудааст.
- Single model: Танҳо GPT-3.5 Turbo истифода шуд; comparison бо other models нест.
- Model version: Behavior-и GPT-3.5 дар 2024 метавонад current models-ро намояндагӣ накунад.
- Single primary evaluator: Entire sample аз ҷониби course instructor score шудааст.
- Ceiling effect: Accuracy ва relevance scores хеле баланд буданд, бинобар ин rubric метавонад small quality differences-ро бад фарқ кунад.
- Supportiveness scale: Psychological scale-и validated нест, балки proxy measure-и researcher-defined мебошад.
- Mandatory participation: Course credit метавонад participation-ро баланд кунад, вале инчунин students-ро ба superficial completion ташвиқ намояд.
- Shared and unauthenticated tutor: User-level personalization ва secure access арзёбӣ нашудаанд.
- Knowledge-base gaps: Нокифоя фаро гирифтани баъзе finance ва advanced DDD topics ба response quality таъсир кардааст.
- Numerical reporting issues: Баъзе percentages дар text бо Figure 3 ва basic arithmetic мувофиқ нестанд.
- Long-term outcomes: Маълум нест, ки students баъд аз weeks ё months knowledge-ро нигоҳ доштанд ё не.
- Privacy and monitoring: Таъсири collecting conversation records ба student privacy ба таври муфассал баррасӣ нашудааст.
Study чиро дастгирӣ мекунад?
- AI tutor, ки бо course materials grounded ва бо prompt rules constrained аст, метавонад ба standard questions-и баррасишуда бо accuracy-и баланд ҷавоб диҳад.
- AI метавонад пеш аз short and intensive design phase дар вақти интихобии students дар domain knowledge ва modeling concepts support диҳад.
- Knowledge base, response length, term usage ва example selection configuration elements ҳастанд, ки ба tutor quality таъсири назаррас доранд.
- Correct ва relevant responses автоматӣ маънои supportive ё motivating tutoring-ро надоранд.
- Embedding AI activities дар program бо explicit learning outcome, small course credit ва knowledge check метавонад participation-ро зиёд кунад.
- Students пас аз implementation confidence-и баландтар дар гирифтани domain knowledge ва applying DDD бо AI гузориш карданд.
- Short conversation records ва simple rubric метавонанд workflow-и амалиро барои monitoring tutor use ва evaluating quality ташкил кунанд.
- Calibration-и TAs бо shared examples метавонад sharing evaluation workload дар larger classes-ро дастгирӣ кунад.
Study чиро исбот намекунад?
- Исбот намекунад, ки AI tutor objective exam ё design performance-и students-ро беҳтар кардааст.
- Нишон намедиҳад, ки self-efficacy increase танҳо аз ChatGPT use ба вуҷуд омадааст.
- Нишон намедиҳад, ки GPT-3.5 дар general educational questions бо 98,9 фоиз accuracy кор мекунад.
- Исбот намекунад, ки ҳамаи course-material-grounded AI systems hallucination-free мешаванд.
- Нишон намедиҳад, ки tutor метавонад instructor ё teaching assistant-ро пурра иваз кунад.
- Нишон намедиҳад, ки ҳамин quality дар free, long ва unexpected student conversations нигоҳ дошта мешавад.
- Исбот намекунад, ки results мустақим ба undergraduate students, large classes ё fields outside software engineering transferable мебошанд.
- Experimentally нишон намедиҳад, ки supportive expressions learning ё achievement-ро зиёд мекунанд.
- Бо separate experiment нишон намедиҳад, ки course credit benefits аз risk-и superficial use зиёдтаранд.
- Исбот намекунад, ки current ё more powerful language models бо same configuration better results медиҳанд.
- Нишон намедиҳад, ки AI use масъалаҳои ethics, privacy ва academic integrity-ро ҳал кардааст.
Аҳамият барои таълими муҳандисии нармафзор
Саҳми асосии study дар он аст, ки AI-ро пеш аз code-writing assistant ҳамчун “design-readiness tool” баррасӣ мекунад. Дар software project, wrong domain model метавонад боис шавад, ки ҳатто агар баъдтар code technically correct бошад, system wrong problem-ро ҳал кунад.
AI tutor-и бо course materials маҳдуд метавонад дар чунин preparation tasks истифода шавад:
- Шарҳ додани basic terms дар unfamiliar business domain,
- Ба student кумак кардан, ки actors ва external systems дар project requirements-ро пай барад,
- Пайваст кардани modeling concepts бо project-и student,
- Ташкили common starting level пеш аз class work,
- Кам кардани вақте, ки instructor ба repeated basic explanations сарф мекунад.
Аммо tutor бояд на танҳо response system, балки tool-и integrated бо course flow тарҳрезӣ шавад. Бе knowledge check, reflection, purposeful follow-up question ва instructor oversight student метавонад answer-ро танҳо copy кунад.
Роҳи тавсияшудаи adoption
Муҳаққиқ барои courses, ки AI-supported teaching-ро бори аввал истифода мебаранд, staged path-и зеринро пешниҳод мекунад:
- AI use-ро бо explicit learning outcome муайян кардан.
- Small credit, мисли 1-2 фоизи total course grade ҷудо кардан.
- Simple quality ва knowledge-check rubric истифода кардан.
- Аз ҳар student ё team як purposeful follow-up question талаб кардан.
- Вақте student count тақрибан аз 30 мегузарад, short conversation-record template истифода кардан.
- Teaching assistants-ро бо shared examples calibrate кардан.
- Low-quality ё risky responses-ро бо automated classification flag карда, final decision-ро ба instructor гузоштан.
Future-work recommendations replication дар different software-engineering topics ва class sizes, evaluation-и quality-load balance-и free follow-up questions ва rubric-based semi-automated quality screening-ро дар бар мегиранд.
Усул ва натиҷаҳои таҳқиқот
Хулосаи техникии усул
| Technical element | Implementation дар study |
|---|---|
| Research approach | Classroom implementation ва experience-based quantitative evaluation дар single-course context |
| Course | Тирамоҳи 2024, graduate functional-programming course-и 12-unit |
| Institution | Carnegie Mellon University Silicon Valley |
| Participant | 29 graduate students |
| Team size | 3-4 students |
| Project | Automated cryptocurrency arbitrage system бо номи ArbitrageGainer |
| Period examined | First two-week project phase |
| Learning domains | Cryptocurrency finance ва Domain-Driven Design |
| AI system | Customized ChatGPT tutor based on GPT-3.5 Turbo |
| Knowledge base | Course slides, project specification ва sample DDD student solution |
| Configuration | Persona, tasks, constraints, dos/don’ts ва response format |
| Prototyping | Five trials per version; configuration frozen at fourth version |
| Pre-class activity | Three sessions; two standard prompts per session |
| Total standard pairs | Approximately 174 prompt-response pairs |
| Conversation unit | Two standard prompts in same session; total 87 units |
| Sampling | 10 units from each session; 30 conversations and 60 prompt-response pairs |
| Sampling ratio | 34,5 фоиз |
| Sampling method | Stratified by session, random selection without replacement |
| Evaluation dimensions | Accuracy, relevance, pedagogical value, cognitive load ва supportiveness |
| Scoring | 0-3 in each dimension |
| Primary evaluator | Course instructor and study author |
| Consistency check | Two teaching assistants, 15 conversations; weighted κ=0,76 and 0,78 |
| Student outcome | Pre- and post-implementation self-efficacy |
| Causal control | No control group |
Натиҷаҳои сифати ҷавоб
| Dimension | Average | Main finding |
|---|---|---|
| Accuracy | %98,9 | Дар ду аз 60 response minor inaccuracy; no significant error ё researcher-classified hallucination |
| Relevance | %92,2 | Ҳеҷ response аз холи 2 паст наафтод |
| Pedagogical value | %89,4 | Responses generally structured and example-based; one superficial response got 1 point |
| Cognitive load | %82,78 | Most responses understandable; repetition, jargon and length main issues |
| Supportiveness | %37,78 | Responses mostly neutral; weak validation and follow-up guidance |
Натиҷаҳои self-efficacy
- Афзоиши калон дар self-efficacy барои гирифтани domain knowledge бо AI: F(1,22)=24,41; p<0,001; partial η²=0,53; dz≈1,03.
- Афзоиши калон дар self-efficacy барои applying DDD in collaborative project with AI: F(1,21)=14,81; p<0,001; partial η²=0,41; dz≈0,82.
- Афзоиши хеле калон дар self-efficacy барои general DDD-model creation: F(1,21)=45,82; p<0,001; partial η²=0,69; dz≈1,44.
- Азбаски item-и сеюм ба AI мустақим ишора намекунад, exploratory result ҳисоб шудааст.
- Analyses на ҳамаи 29 student, балки 22 ё 23 paired response-ро дар бар мегиранд.
Тафсири техникии results
Қавитарин result ин аст, ки AI tutor, ки бо course materials grounded шудааст, метавонад барои specific ва pre-designed questions response-и high-accuracy ва relevant диҳад. Ин result ба scope-и knowledge base ва prompt constraints сахт вобаста аст.
Pedagogical quality танҳо бо correct information муайян намешавад. Response length, appropriateness of terminology to student level, alignment of examples with project context ва guiding student to a meaningful next step separate design problems мебошанд.
Self-efficacy increases нишондиҳандаи мусбати learning environment мебошанд; аммо бо сабаби набудани control group ва objective competency test, causal evidence барои learning achievement нестанд. Findings бештар дастгирӣ мекунанд, ки AI дар course flow-и тарҳрезишудаи instructor ҳамчун scalable preparation layer хизмат кунад, на ин ки instructor-ро иваз намояд.
Номувофиқиҳои хурди percentages main pattern-ро тағйир намедиҳанд: accuracy, relevance ва pedagogical value баланд, supportiveness паст аст. Бо вуҷуди ин, дар replication studies нашри raw score distributions ва calculation scripts open-ly auditability-и results-ро қавитар мекунад.
Ёддошт оид ба манбаъ ва усул
Номи пурраи аслии study: From Domain Understanding to Design Readiness: a playbook for GenAI-supported learning in Software Engineering
Муаллиф: Rafal Wlodarski.
Equal contribution ё equal first author: Азбаски study якмуаллифӣ аст, equal contribution вуҷуд надорад.
Corresponding author: Дар PDF аломати ҷудогонаи “corresponding author” истифода нашудааст. Email-и sole author rafal.wlodarski@sv.cmu.edu дода шудааст.
Institutional affiliation: Electrical & Computer Engineering, Carnegie Mellon University Silicon Valley, Mountain View, California, USA.
Вазифаи муассисавии муаллиф: Assistant Teaching Professor, Electrical and Computer Engineering, Carnegie Mellon University.
Навъи манбаъ: Peer-reviewed conference paper, ки real classroom implementation, response-quality evaluation, self-efficacy analysis ва teaching practices-ро дар бар мегирад.
Conference: Companion Proceedings of the 34th ACM Symposium on the Foundations of Software Engineering, FSE Companion ’26.
Conference section: Software Engineering Education.
Conference date and location: 5-9 July 2026; Montreal, Quebec, Canada.
Pages: 1078-1088.
Publication year: 2026.
Publisher: Association for Computing Machinery.
DOI: 10.1145/3803437.3805783.
ACM ISBN: 979-8-4007-2636-1/26/07.
Peer-review status: Study дар FSE 2026 Software Engineering Education program қабул ва дар ACM conference proceedings нашр шудааст. Conference call мегӯяд, ки ин section double-anonymous review process истифода мекунад.
License: Creative Commons Attribution 4.0 International.
Official ACM link:https://dl.acm.org/doi/10.1145/3803437.3805783
Official conference program:https://conf.researchr.org/track/fse-2026/fse-2026-software-engineering-education
ArXiv version: arXiv:2604.00120v1; 31 March 2026.
ArXiv DOI: 10.48550/arXiv.2604.00120. Ин DOI ба preprint version тааллуқ дорад; primary published DOI-и study ACM DOI мебошад.
Official arXiv link:https://arxiv.org/abs/2604.00120
Funding: Study дар доираи Generative Artificial Intelligence Teaching as Research Fellowship маблағгузорӣ шудааст. Ба Eberly team барои support дар implementation ташаккур гуфта шудааст.
Replication package: Study мегӯяд, ки standard prompts, tutor configuration, rubric materials, anonymized conversations ва scores то ҳадди иҷозашуда ва analysis scripts ҳамчун supplementary materials пешниҳод шудаанд. PDF direct open-repository address нишон намедиҳад.
Маҳдудиятҳои асосии study: single institution ва small sample, no control group, self-efficacy being not direct skill, all responses scored by one expert, only standard prompts evaluated, GPT-3.5 not compared with other models ва short implementation period мебошанд.
Study исбот намекунад, ки AI tutor метавонад human instructor-ро иваз кунад ё objective design skill-и students-ро мустақилона зиёд кунад. Findings нишон медиҳанд, ки AI tutor-и бо course materials маҳдуд ва бодиққат configured метавонад ҳамчун complementary tool дар short-term domain-knowledge ва modeling readiness истифода шавад.
Шарҳ гузоред
Нишонии почтаи электронии шумо нашр намешавад. Майдонҳои ҳатмӣ бо * нишон дода шудаанд