

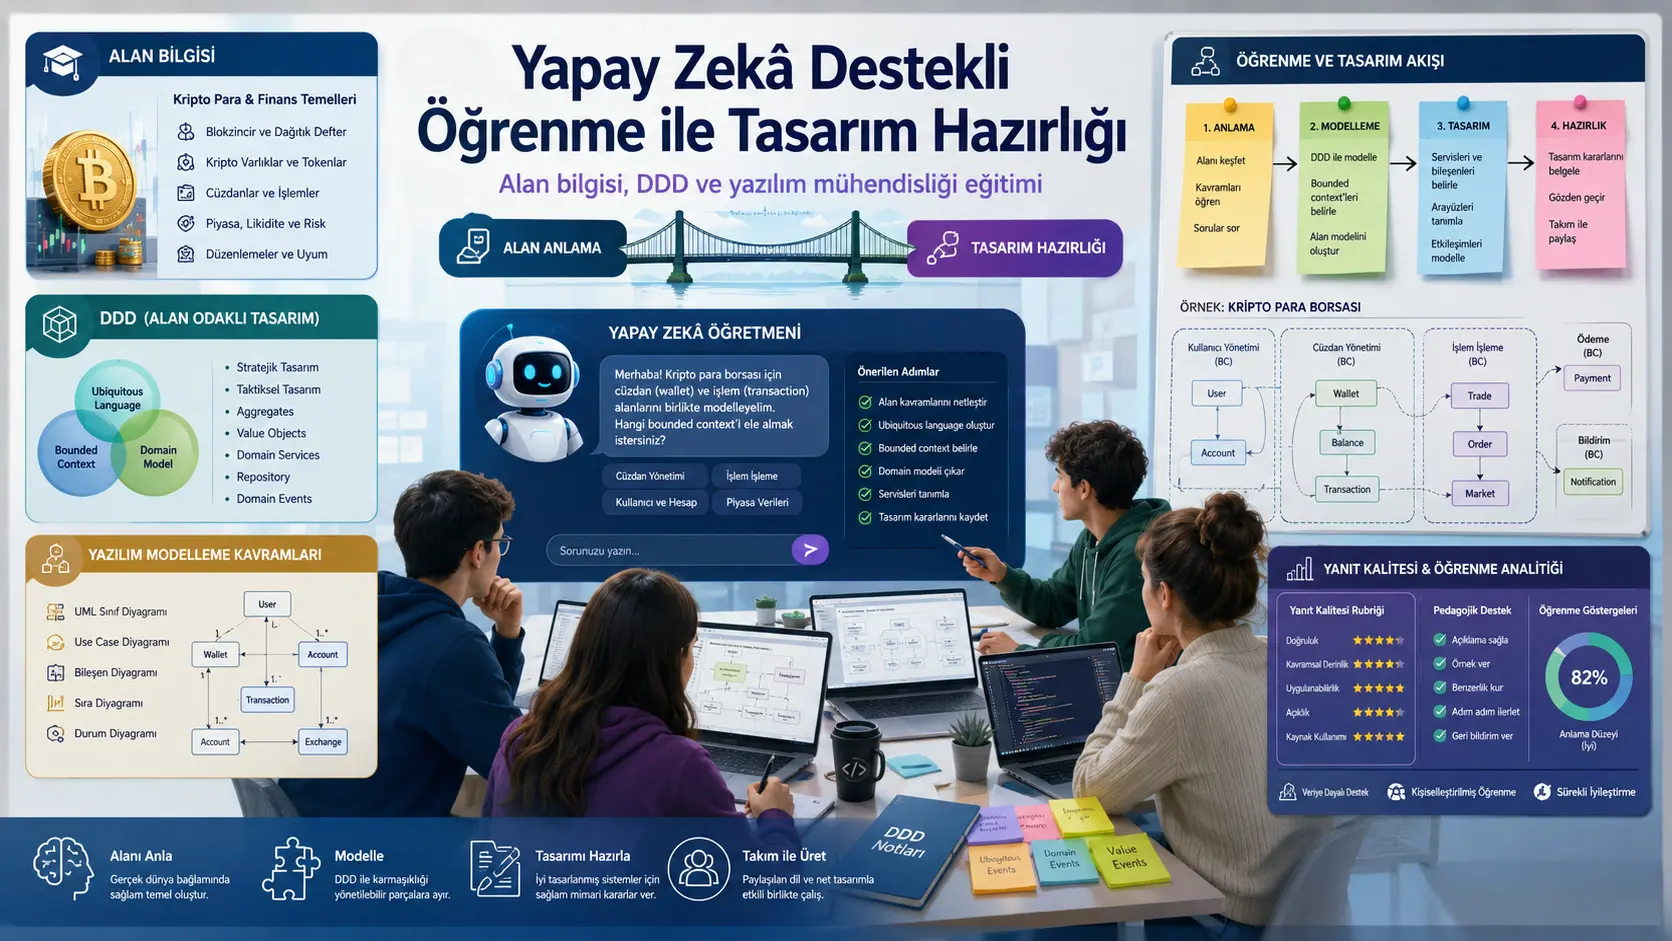
Utafiti huu unalenga tatizo la wanafunzi wa uhandisi wa programu kutohitaji kujifunza programu pekee, bali pia kujifunza kwa muda mfupi eneo la biashara ambamo watatengeneza programu na mbinu zinazohitajika kulimodeli eneo hilo. Katika utafiti, wanafunzi 29 wa shahada ya uzamili walitumia mwalimu wa ChatGPT aliyebinafsishwa kwa nyenzo za kozi ili kujifunza dhana za msingi za fedha katika arbitrage ya sarafu za kidijitali na mbinu ya Domain-Driven Design.
Utekelezaji ulifanyika katika awamu ya usanifu ya wiki mbili ya kozi ya functional programming katika Carnegie Mellon University Silicon Valley. Kwa mfumo wa automatic cryptocurrency arbitrage uitwao “ArbitrageGainer” uliotengenezwa na wanafunzi kwa timu, walihitaji kwanza kuelewa eneo la fedha, kisha kubaini vipengele vya Domain-Driven Design kama event storming, commands, external systems, workflows na bounded contexts.
Mwalimu maalumu wa AI ulijengwa juu ya GPT-3.5 Turbo na kuwekwa katika msingi wa course slides, project requirements na mfano wa student design. Katika shughuli tatu tofauti za kabla ya darasa, wanafunzi walipewa standard prompts mbili kila mara, wakaombwa ku-export conversation logs na kukamilisha short knowledge-check reports. Hivyo takribani 174 standard prompt-response pairs ziliundwa. Mtafiti alitathmini 60 kati yake, yaani asilimia 34,5, kwa stratified random sampling.
Accuracy score ya responses iliripotiwa kuwa asilimia 98,9, relevance score asilimia 92,2 na pedagogical-value score asilimia 89,4. Kwa cognitive load, average ilikuwa asilimia 82,78, wakati supportiveness, iliyofafanuliwa kama kumtia moyo mwanafunzi na kumwelekeza kwenye hatua inayofuata, ilibaki asilimia 37,78 pekee. Katika responses 60 zilizochunguzwa, hakuna content iliyopatikana ambayo mtafiti ali-classify kama “hallucination au misinformation”; minor inaccuracies ziligunduliwa katika responses mbili ambazo hazikumpotosha mwanafunzi kwa kiwango kikubwa.
Self-efficacy ya wanafunzi katika kutumia AI kujifunza domain knowledge na kutekeleza Domain-Driven Design iliongezeka kwa kiasi kikubwa baada ya implementation. Hata hivyo, study haina control group. AI activities zilifanyika katika kipindi kilekile na short lectures, team work, mandatory knowledge checks na grade incentive. Kwa hiyo haiwezi kusemwa kwamba confidence increase ilitokana na AI tutor pekee.
Output muhimu zaidi ya research si success percentages za AI tutor, bali implementation guide ya vipengele 17 kwa educators. Kutumia controlled knowledge base yenye course materials, kupunguza response detail na length, kukagua examples mapema, kuzuia unfamiliar terms, kumwelekeza mwanafunzi kwenye one meaningful follow-up question na ku-support activity kwa small course credit ni miongoni mwa recommendations kuu.
Tatizo kuu la utafiti ni lipi?
Elimu ya uhandisi wa programu haijumuishi programming languages na code generation pekee. Software developer anahitaji kuelewa concepts, actors, rules, events na boundaries za business domain ambamo anatatua tatizo. Bila kuelewa basic concepts katika maeneo kama fedha, afya, uzalishaji au logistics, inakuwa vigumu kujenga correct requirements model na software architecture.
Hitaji hili linaleta matatizo mawili muhimu katika mazingira ya elimu:
- Wanafunzi lazima wajifunze kwa muda mfupi application domains wasizozifahamu pamoja na software-development methods.
- Kwa instructor, kutoa personalized explanation na immediate feedback kwa kila mwanafunzi au timu wakati wa darasa si scalable.
Study inaeleza kwamba katika semesters zilizopita, licha ya instructor kuzunguka kati ya teams, baadhi ya questions zilibaki hadi mwisho wa class na baadhi ya student groups zilihitaji dakika 10-30 za extra attention. Teaching assistant aliyekuwa assigned katika course context kutoshiriki kwenye in-class support pia kuliongeza pengo la individual help.
Lengo kuu la research ni kuchunguza kama generative-AI tutor aliyefungwa kwa course materials anaweza kupunguza pengo hili la msaada. Study haiulizi moja kwa moja “Je, AI iliongeza exam performance ya wanafunzi?”; badala yake ilishughulikia research questions tatu zifuatazo:
- AI-supported learning ilitoa high-quality support kwa kiwango gani ili kuwaandaa wanafunzi kwa design phase?
- Responses za AI tutor zilikuwa na quality gani kwa pedagogical value, cognitive load na supportiveness?
- Ni teaching practices zipi zinaweza kuongeza effectiveness ya AI-supported learning katika course environment?
Muktadha wa kozi na mradi
Implementation ilifanyika katika graduate functional-programming course ya units 12 katika semester ya autumn 2024. Course ni mojawapo ya core courses za Software Engineering program katika Carnegie Mellon University Silicon Valley. Kulikuwa na face-to-face sessions mbili kwa wiki, kila moja ikidumu saa 1 dakika 50.
Moja ya goals za course ilikuwa kufundisha functional programming kwa vitendo na kuonyesha jinsi inavyoweza kutumika katika industrial contexts. Wanafunzi walifanya kazi kwa teams za watu watatu au wanne kwenye realistic automated trading system iitwayo “ArbitrageGainer”.
ArbitrageGainer project inategemea cryptocurrency arbitrage. Programming pekee haikutosha; wanafunzi walihitaji kuelewa domain concepts kama:
- Cryptocurrency exchanges na market-data services,
- Tofauti kati ya buy na sell prices,
- Arbitrage opportunities zinazotokea kati ya exchanges tofauti,
- Order, balance, fee na transaction-execution mechanisms,
- External systems na API dependencies,
- Business events na commands katika automated trading system.
Project iligawanywa katika awamu nne za wiki mbili kila moja. Study iliyochunguzwa inahusu awamu ya kwanza tu. Katika awamu hii wanafunzi walibadilisha functional requirements kuwa Domain-Driven Design model; subsequent implementation na coding phases hazikujumuishwa katika study.
Kwa nini Domain-Driven Design ilitumika?
Domain-Driven Design au DDD ni modeling approach inayolenga kufanya structure ya software na lugha inayotumika iendane na concepts za main business domain. Inasaidia technical team na domain experts kuelewana juu ya concepts zilezile.
Katika study, DDD concepts zilitambulishwa hatua kwa hatua kwa short lectures za takribani dakika 30. Baada ya kila lecture, wanafunzi walifanya team work kwenye Miro board. Activities zilihusisha:
- Kubaini business events kwa event storming,
- Kuweka events kwa chronological order,
- Kutoa commands zinazoanzisha events,
- Kubaini external systems zilizo nje ya solution scope,
- Kudocument workflows kwa pseudocode,
- Kuunda bounded contexts.
Katika previous course offerings, ilionekana kwamba wanafunzi hawakuweza hata kutoa external systems kama cryptocurrency exchange na market-data API zilizotajwa wazi katika project requirements. Kwa sababu hiyo, moja ya AI activities ilitumia special prompt iliyouliza typical subsystems na components za automated trading system.
Ingawa baadhi ya individual reports ziliendelea kuwa na makosa, team final design submissions ziliripotiwa kubaini external systems zote kwa usahihi. Hata hivyo, kwa kuwa study haina controlled comparison na previous semester, improvement hii haijathibitishwa kuwa ilitokana na AI activity pekee.
Washiriki walikuwa kina nani?
Wanafunzi wote 29 wa shahada ya uzamili waliokamilisha course walishiriki kwa hiari katika study. Undergraduate backgrounds zao zilikuwa:
- Computer Science: wanafunzi 15,
- Electrical and Computer Engineering: wanafunzi 4,
- Software Engineering: wanafunzi 3,
- Other engineering, finance au mathematics fields: wanafunzi 7.
Miongoni mwa students wenye clearer finance experience walikuwa individual investors watano, wanafunzi wawili waliowahi kufanya kazi katika fintech sector na mwanafunzi mmoja mwenye minor katika finance au economics. Domain-Driven Design experience ilitokana na previous courses kwa students watatu na industrial experience kwa students wawili.
Figure 1: Maarifa ya mwanzo ya wanafunzi
Figure 1 kwenye page ya pili ya PDF inaonyesha self-reports za wanafunzi kuhusu finance na DDD kupitia pie charts mbili.
| Knowledge level | Finance knowledge or experience | DDD knowledge or experience |
|---|---|---|
| None | %31 | %39 |
| Some | %38 | %38 |
| Moderate | %19 | %19 |
| Substantial | %12 | %4 |
Katika finance, asilimia 69 ya students, na katika DDD asilimia 77, walieleza knowledge yao kama “none” au “some”. Distribution hii inaonyesha AI activities zilitumika kwa beginner na intermediate preparation badala ya advanced expertise.
AI activities ziliwekwaje katika course schedule?
Ili kuzuia wanafunzi kuona AI work kama optional extra assignment, researcher alifanya mabadiliko matatu katika course design:
- Aliifanya AI use kuwa explicit course learning outcome.
- Purpose ya activities na role yake katika course ilielezwa repeatedly kwa students.
- AI activities zote zilifanywa mandatory na zikatolewa course credit.
Learning outcome iliyowekwa ilitaka wanafunzi kutumia generative AI kupata domain knowledge na kutekeleza DDD kwa usahihi katika collaborative project.
University pia ilihitaji students wote wakamilishe generative-AI literacy module ya dakika 90-120 katika first week ya course. Module hii, iliyokuwa asilimia 1 ya course grade, ilihusisha operating principles za AI systems, ethical na contextual issues, pamoja na responsible-use strategies.
Ratiba ya shughuli ya wiki mbili
| Stage | Estimated time | Purpose | Student activity | Output produced |
|---|---|---|---|---|
| Pre-class 1 | 30-45 dakika | Kuanzisha finance-domain knowledge | Kusoma project specification, ku-run prompts 1.1 na 1.2, optional follow-up questions, knowledge check 1 | Conversation record ya standard prompts mbili na report yenye open-ended questions tatu |
| In-class 1 | Saa 1 dakika 50 | Kuanzisha project na DDD modeling | System introduction, DDD mini-lecture na team event storming | Miro board yenye business events |
| Pre-class 2 | 20-30 dakika | Kujifunza core DDD concepts | Ku-run prompts 2.1 na 2.2, ku-export conversation na knowledge check 2 | Conversation record na report yenye open-ended questions mbili |
| In-class 2 | Saa 1 dakika 50 | Kukamilisha core DDD activity | Kupanga events, kutoa commands na external systems | Updated team Miro board |
| Pre-class 3 | 30-45 dakika | Kutumia DDD terminology kwenye project deliverables | Ku-run prompts 3.1 na 3.2, ku-export conversation na knowledge check 3 | Conversation record na report yenye open-ended question moja |
| In-class 3 | Saa 1 dakika 50 | Kuunda stage deliverables | Team definition ya workflows na bounded contexts | Miro board yenye bounded contexts na workflow pseudocode draft |
Baada ya kila AI activity, students walihitajika ku-submit knowledge check na short reflection report pamoja na conversation transcript. Ili report ipass kwenye first submission, knowledge-check questions zote zilihitaji kujibiwa correctly kwa short justifications na conversation record kuambatishwa.
Takribani asilimia 93 ya students waliripotiwa ku-submit reports zote tatu kwa wakati uliotarajiwa na kupass kwenye first submission. Hii inaonyesha high course preparation; hata hivyo effect ya mandatory work na grade incentive kwenye participation haikupimwa separately.
Custom ChatGPT tutor iliundwaje?
Tutor iliundwa kwa kutumia GPT-3.5 Turbo. Model ilibinafsishwa kwa njia mbili:
- Detailed system prompt ilitumika kueleza tutor role, tasks, boundaries, dos na don’ts.
- Course slides, project specification na sample student DDD solution zilipakiwa katika ChatGPT knowledge configuration.
System prompt ilikuwa na:
- Tutor persona na context,
- Instruction ya kutumia course materials kama primary source,
- Learning tasks zinazopaswa ku-supportiwa,
- Restrictions na prohibited behaviors,
- Desired response format na presentation characteristics,
- Rules za kufuata course terminology.
Instructor alijaribu configuration repeatedly kabla semester kuanza kwa scripted trials zinazowakilisha expected student interactions. Kila version ilitathminiwa katika five trials; responses zilirekebishwa hadi zikatumia correct course terminology, depth ya kutosha kwa workshop inayofuata na low amount ya boilerplate text.
Configuration ilifungwa kwenye fourth version na kufreeziwa mwanzoni mwa activity ya kwanza. Decision hii ilitoa consistency kati ya students lakini ikapunguza possibility ya adaptation kwa interaction styles tofauti.
Students walifikia shared tutor instance bila authentication. Kwa kuwa temperature au other generation parameters hazikuweza kubadilishwa kwenye ChatGPT interface, default values zilitumika. Hakuna comparison ya GPT-3.5 na other models iliyofanywa.
Ni data gani zilikusanywa?
Study ilikusanya data katika time points tatu:
- Pre-implementation: Student background, finance, functional-programming na DDD experience, na self-efficacy statements tano.
- During implementation: Conversation records za standard prompts, knowledge checks na student reflection reports.
- Post-implementation: End-of-term student views na self-efficacy measurements.
Measures mbili kuu katika self-efficacy analysis zilikuwa:
- “Naweza kutumia generative AI kupata domain knowledge.”
- “Naweza kutumia generative AI kutekeleza DDD kwa usahihi katika collaborative project.”
Statement “Naweza ku-design domain-driven model kwa real business requirements” ilitumika kama third, exploratory measure. Kwa kuwa statement hii hairefer AI moja kwa moja, improvement iliyopatikana inaweza kutokana na project practice au mini-lectures.
Conversation data na sampling method
Kila mwanafunzi alipangwa ku-run standard prompts mbili katika kila moja ya activities tatu:
\[ 29 \times 3 \times 2 = 174 \]
Hivyo takribani 174 standard prompt-response pairs ziliundwa. Prompts mbili katika kila activity zilikubaliwa pamoja kama one conversation unit, na jumla ya:
\[ 29 \times 3 = 87 \]
conversation units zikapatikana.
Conversation units 10 zilichaguliwa randomly kutoka kila session. Hivyo 30 conversation units na 60 prompt-response pairs zilitathminiwa kutoka sessions tatu.
Ratio ifuatayo haikutolewa katika paper kama separate equation; imeongezwa kueleza sampling ratio:
\[ \text{Örnekleme oranı} =\frac{60}{174}\times100 \approx34{,}5\% \]
Sampling ilifanywa kupitia random.org, stratified by session na without replacement. Kuchagua standard prompts mbili pamoja kulihifadhi within-conversation context; kuchukua equal number of units kutoka kila session kulihakikisha representation ya finance, basic DDD na advanced DDD topics.
Student-selected follow-up questions ziliruhusiwa lakini hazikujumuishwa katika evaluation kwa sababu hazikuwa standardized. Kwa hiyo results haziwakilishi full real na free-form AI use, bali responses kwa predefined prompts.
Responses zilitathminiwa kwa vigezo gani?
Kila response ilipewa score kutoka 0 hadi 3 katika dimensions tano:
| Dimension | Feature measured | Meaning ya highest score |
|---|---|---|
| Information accuracy | Factual, conceptual na technical correctness | Response ni correct, consistent na domain knowledge na haina significant error |
| Relevance | Kujibu question directly na in context | Haina unnecessary au off-topic content |
| Pedagogical value | Depth, structured explanation, terminology na examples | Inatoa explanation ya kutosha na appropriate example kuendeleza learning |
| Cognitive load | Clarity, brevity, accessibility na level appropriateness | Inaeleweka kwa urahisi bila unnecessary complexity |
| Support and encouragement | Kutambua effort ya student na kumwelekeza kwenye next step | Inavalidate, inatia moyo na inaalika student kuendelea kujifunza |
Supportiveness ni proxy measure iliyoundwa na researcher. Ilifafanuliwa kama combination ya brief praise au validation na invitation ya exploring the next step. Si validated psychological emotion au motivation scale.
Relationship ifuatayo inaweza kutumika kueleza conversion ya dimensions kuwa percentage. Statement hii haikutolewa kama equation katika paper:
\[ \text{Boyut yüzdesi} =\frac{\sum_{i=1}^{n}s_i}{3n}\times100 \]
Hapa si ni score ya kila response kati ya 0-3, na n ni number of evaluated responses.
Nani alifanya evaluation?
Primary scoring ilifanywa na course instructor ambaye pia ni author wa study. Ingawa author ndiye aliyefahamu course context na expected terminology zaidi, kuwa single evaluator kunaleta observer-bias risk.
Kwa consistency check, trained teaching assistants wawili waliokuwa wamewahi kuchukua course wali-score independently same 15 conversation records, tano kutoka kila session. Evaluators kwanza walifanya rubric calibration ya dakika 90 kwa anonymized records tano.
Weighted Cohen kappa values kati ya instructor na assistants wawili zilikuwa:
- Teaching assistant wa kwanza: κ=0,76,
- Teaching assistant wa pili: κ=0,78.
Exact agreement iliripotiwa kuwa asilimia 72-74, na agreement ndani ya tofauti ya point moja ilikuwa asilimia 99,3. Values hizi zinaonyesha strong consistency katika subset iliyochunguzwa; responses zote 60 hazikuscorewa na evaluators wawili au watatu.
Accuracy ya responses
Mean accuracy ilikuwa asilimia 98,9. Kwa Figure 3, takribani asilimia 97 ya responses zilipata score 3 na asilimia 3 score 2. Distribution hii inaendana na responses 58 kutathminiwa full na responses mbili kuwa na minor inaccuracies.
Researcher anasema hakupata “hallucination” iliyo completely wrong au misleading kwa student katika sample iliyochunguzwa. Minor issues mbili zilikuwa:
- Partially misleading definition ya “domain service” katika advanced DDD topics, ambayo pia inaonekana katika secondary internet sources,
- Event name iliyotumika katika example moja kutolingana fully na stated bounded context.
Result hii haimaanishi GPT-3.5 kwa ujumla ni asilimia 98,9 accurate. Measurement hii inahusu six standard prompts, knowledge base iliyofungwa kwa course materials na responses 60 katika one course context.
Relevance ya responses
Mean relevance ilikuwa asilimia 92,2. Kwa Figure 3, takribani asilimia 77 ya responses zilipata highest score na asilimia 23 second-level score; hakuna response iliyoshuka hadi 0 au 1 point.
Issues tatu zilipunguza relevance:
- Kukosekana kwa baadhi ya supporting finance concepts katika knowledge base,
- Response kwenda nje ya project scope ya student,
- Introduction, repetition na conclusion paragraphs kuongeza length bila kuongeza new information.
Students waliripoti kuwa model kujua project description kulifanya responses ziwe shorter na more context-specific. Baadhi ya students walisema wakati mwingine ilikuwa difficult kuchagua useful parts kutoka unnecessary content.
Pedagogical value
Mean pedagogical value ilikuwa asilimia 89,4. Figure 3 inaonyesha asilimia 70 ya responses zikipata score 3, takribani asilimia 28 score 2 na takribani asilimia 2 score 1.
Responses nyingi zilikuwa na correct terms, structured explanation na at least one example. Kwa abstract topics, wakati mwingine examples mbili zilitumika. Response moja tu ilipata score 1 kwa sababu ili-list typical components za automated arbitrage system kama general headings bila explanation.
Students waliripoti two opposite issues:
- Baadhi ya explanations zilikuwa too technical kwa beginner student,
- Baadhi ya explanations zilikuwa too superficial kwa student anayejua topic.
Issue hii inaonyesha single standard detail level haitafaa students wote wenye different prior knowledge.
Cognitive load
Mean ya cognitive-load dimension ilikuwa asilimia 82,78. Figure 3 inaonyesha takribani asilimia 55 highest, asilimia 38 second na asilimia 7 third level. Lower scores zilihusishwa na response length, repetition, unexplained terms na too many examples.
Researcher katika text anaita asilimia 5 ya responses “overwhelming”, wakati Figure 3 inaonyesha lowest observed distribution takribani asilimia 7. Difference hii ndogo ni mojawapo ya numerical inconsistencies katika report.
Main sources za cognitive load zilizobainishwa ni:
- Kurudia same point katika introduction, main body na conclusion,
- Kutumia terms zisizopo katika course knowledge base bila explanation,
- Kutoa examples nyingi kuliko inavyohitajika kwa simple concept,
- Response kutoadapt na detail level inayotakiwa na student.
Kwa nini supportiveness ilibaki low?
Mean ya support and encouragement ilikuwa asilimia 37,78 pekee. Kwa Figure 3, takribani asilimia 87 ya responses zilipata score 1 na asilimia 13 score 2; hakuna response iliyofikia highest support level.
Model mara nyingi ilitumia neutral, information-delivery tone. Expressions zinazovalidate question ya student positively, kutambua effort yake au kumwalika kwenye specific next step zilikuwa rare.
Encouraging expressions nyingi zilionekana katika third activity, ambapo standard prompt ilisema wazi kuwa student alikuwa amekamilisha task. Hii inaonyesha supportive tone ilitokana zaidi na contextual cue katika prompt kuliko spontaneous behavior ya model.
Low supportiveness haimaanishi information ilikuwa wrong. Lakini ikiwa tutor inatarajiwa si kujibu tu bali pia ku-support ongoing learning process ya student, light tutoring au coaching tone inapaswa kufafanuliwa explicitly katika system prompt.
Numerical inconsistencies katika Figure 3 na text
Figure 3 kwenye page ya saba ya PDF inaonyesha score distributions za dimensions. Figure na reported averages zikizingatiwa pamoja, approximate distribution ni:
| Dimension | Score 3 | Score 2 | Score 1 | Reported average |
|---|---|---|---|---|
| Accuracy | %97 | %3 | %0 | %98,9 |
| Relevance | %77 | %23 | %0 | %92,2 |
| Pedagogical value | %70 | %28 | %2 | %89,4 |
| Cognitive load | %55 | %38 | %7 | %82,78 |
| Supportiveness | %0 | %13 | %87 | %37,78 |
Distributions katika figure na averages ziko mathematically close. Hata hivyo, main text imeandika:
- Asilimia 82,5 kama proportion ya highest score katika relevance,
- Asilimia 77,5 kama proportion ya highest score katika pedagogical value.
Ratios hizi hazipatani na Figure 3.
Pia, minor inaccuracies mbili kati ya responses 60 ni:
\[ \frac{2}{60}\times100=3{,}33\% \]
Katika abstract section, 2/60 na asilimia 3,3 zimetolewa correctly, wakati discussion section imeandika asilimia 1,1. Error hii haibadilishi main direction ya results, lakini inapaswa kutajwa kwa reporting accuracy.
Self-efficacy results
Self-efficacy ya students ililinganishwa pre- na post-implementation kwa paired analysis.
| Self-efficacy item | Statistical result | Effect size | Interpretation |
|---|---|---|---|
| Kupata domain knowledge kwa AI | F(1,22)=24,41; p<0,001 | Partial η²=0,53; dz≈1,03 | Large confidence increase |
| Kutumia DDD katika collaborative project kwa AI | F(1,21)=14,81; p<0,001 | Partial η²=0,41; dz≈0,82 | Large confidence increase |
| Ku-design DDD model kwa real business requirements | F(1,21)=45,82; p<0,001 | Partial η²=0,69; dz≈1,44 | Very large increase; exploratory result isiyo AI-specific |
F(1,22) kwa first item inaashiria 23 paired observations, na F(1,21) kwa other items inaashiria 22 paired observations. Kwa hiyo self-efficacy analyses hazijumuishi students wote 29. Sababu za missing paired responses hazijaelezwa kwa detail.
Partial eta squared ni effect size inayoonyesha kiasi gani cha total variation kinahusiana na time au pre-post difference. Paired Cohen dz inastandardize mean change relative to within-person variability. Reported values zinaonyesha practically substantial confidence gains badala ya small statistical difference tu.
Hata hivyo, self-efficacy si skill yenyewe. Student anaweza kujihisi more competent lakini asionyeshe improvement sawa katika objective design exam. Study haina independent blind-scored competency test wala control group.
Figure 2: Confidence kabla na baada ya implementation
Figure 2 kwenye page ya sita ya PDF inaonyesha group averages za items kuhusu kupata domain knowledge na kutumia DDD kwa AI, pamoja na asilimia 95 confidence intervals.
Kutoka graph, approximate values zinaonyesha:
- Confidence ya kupata domain knowledge ikiongezeka kutoka level 58 hadi karibu 85,
- Confidence ya kutumia DDD ikiongezeka kutoka level 51 hadi karibu 77.
Values hizi zimesomwa approximately kutoka graph; main text haitoi exact means katika table. Vertical error bars zinaonyesha asilimia 95 confidence intervals.
Kwa nini self-efficacy increase si causal result?
AI tutor haikutumika peke yake. Katika same period, students:
- Walipokea short DDD lectures,
- Walifanya kazi kwa team kwenye real project,
- Walifanya event storming kwenye Miro board,
- Walijibu knowledge-check questions,
- Walipata help kutoka instructor au other sources,
- Walishiriki katika mandatory na graded activities.
Kwa kuwa interventions hizi hazikutenganishwa, observed confidence increase inahusiana na entire AI-supported learning environment. Causal statement kama “ChatGPT iliongeza self-efficacy kwa kiasi hiki” haisupportiwi na study.
Theoretical frameworks zilizotumika katika instructional design
Researcher alitafsiri results kupitia learning theories tatu:
Cognitive Load Theory
Unnecessary repetition, excessive length, too many examples na unexplained terms zinaweza kujaza working memory ya student kwa content isiyosaidia learning. Recommendations za kupunguza response length na number of examples zinategemea framework hii.
ICAP framework
ICAP inaangalia student engagement katika passive, active, constructive na interactive levels. Student kusoma response tu kunaweza kubaki active level. Model kupendekeza specific follow-up question au application task kunaweza kumpeleka student kwenye constructive na interactive engagement.
Self-efficacy
Imani ya student kwamba anaweza kufanikiwa kwenye task inaweza kuathiri kuendelea kujifunza na persistence kwenye difficult tasks. Researcher anapendekeza kuwa low supportiveness huenda ilipunguza confidence growth kwa baadhi ya students. Possibility hii haikujaribiwa directly kwa experiment.
Teaching practices 17 zilizopendekezwa
| Code | Practice | Purpose | Implementation |
|---|---|---|---|
| P1 | Weka expected detail level | Kuzuia response kuwa too superficial au excessively detailed | Andika limit kama “eleza kwa sentences 3-4 na one concrete example” |
| P2 | Punguza length | Kupunguza cognitive load ya repetition na long introductions | At most two short paragraphs na ban on unnecessary intro/summary |
| P3 | Punguza number of examples | Kuzuia examples nyingi kuficha main concept | One example kwa simple topic, at most two kwa complex topic |
| P4 | Chagua guardrail examples mapema | Kupunguza generic au context-inappropriate examples | Ongeza best 1-3 examples kutoka trial runs kwenye system prompt |
| P5 | Zuia unfamiliar terms | Kupunguza cognitive load ya unexplained jargon | Tumia forbidden-term list na require definition kwa every out-of-course term |
| P6 | Ongeza supportive tone | Kukamilisha neutral information delivery kwa light tutoring tone | Define persona inayotambua effort ya student na kumwalika ku-explore |
| P7 | Jenga knowledge base kwa uangalifu | Kudumisha accuracy na relevance | Ongeza short reliable course materials zinazofunika main na supporting domains |
| P8 | Signpost, usirudie | Kuzuia same information kusemwa upya katika sections tofauti | Tumia short headings, one-pass rule na brief reference to previous definition |
| P9 | Ongeza AI guidance | Kumpeleka student kwenye constructive follow-up interaction | Katika kila session pendekeza one specific follow-up question kwa explanation, application au extension |
| P10 | Fanya AI use kuwa learning outcome | Kufanya relevance ya activity kwa course ionekane | Ongeza responsible AI use kwa analysis au modeling kwenye course outcome |
| P11 | Fanya small workshop mwanzoni | Kupunguza AI-literacy differences kati ya students | 30-45-minute practice ya prompting, follow-up question na critical evaluation |
| P12 | Toa course credit | Kudumisha participation na kuhalalisha time spent | Tenga asilimia 1-5 ya total grade kulingana na required effort |
| P13 | Centralize instructions | Kupunguza access na usage confusion | Tengeneza single LMS page yenye access, prompt examples na expectations |
| P14 | Omba short conversation notes | Kuwezesha reflection na usage traceability | Omba student ku-export conversation record kwa short template |
| P15 | Tumia simple knowledge-check rubric | Kutenganisha careful use na superficial participation | Tumia three-level rapid scoring kwa each question |
| P16 | Delegate evaluation at scale | Kupunguza instructor workload | Calibrate teaching assistants kwa shared examples na kufanya batch scoring by question |
| P17 | Diversify question difficulty na format | Kushughulikia different starting levels | Changanya definition, project application na small design tasks |
Practices tano zenye highest leverage
Table 3 kwenye page ya tisa ya PDF inachagua practices tano kama highest priority kwa implementation cost na transferability katika different software-engineering courses:
| Priority | Practice | Targeted problem | Implementation cost |
|---|---|---|---|
| P7 | Kujenga knowledge base kwa uangalifu | Accuracy na relevance | Medium |
| P2 | Kupunguza response length | Cognitive load na unnecessary text | Low |
| P8 | Signpost information, usirudie | Repetition-related cognitive load | Low |
| P9 | Kuongeza one meaningful follow-up guidance | Learning interaction na purposeful continuation questions | Low |
| P4 | Kukagua examples mapema | Incorrect au context-mismatched examples | Medium |
Nguvu za study ni zipi?
- Inatathmini AI tutor ndani ya real course na real team project.
- Inafocus kwenye less-studied skills kama domain knowledge na software modeling badala ya programming support pekee.
- Ina-ground tutor kwa course slides, project requirements na sample submission.
- Inatumia standard prompts kutoa comparable data kati ya students.
- Inahakikisha representation ya three topic domains kwa session-stratified random sampling.
- Haitumii accuracy kama criterion pekee; inatathmini relevance, pedagogical value, cognitive load na supportiveness pamoja.
- Inakagua evaluator consistency katika subset kwa teaching assistants wawili.
- Inaripoti supportiveness, length, jargon na example-mismatch problems pamoja na positive results.
- Inageuza findings kuwa guide ya vipengele 17 inayoweza kutumiwa moja kwa moja na educators.
- Inasema wazi study si causal na self-efficacy si sawa na skill.
- Inaripoti replication package yenye prompts, configuration, anonymized records, rubric na analysis scripts.
Mapungufu ya study ni yapi?
- Single institution and single course: Results zinatoka only katika context ya graduate course moja katika Carnegie Mellon Silicon Valley.
- Small participant count: Kuna students 29 kwa jumla.
- No control group: Hakuna comparison group iliyokamilisha same activities bila AI.
- No causal separation: Mini-lectures, team practice, knowledge checks na grade incentive zilitumika katika same period na AI.
- Self-efficacy measurement: Confidence increase si direct increase ya knowledge au design skill.
- Missing paired surveys: Self-efficacy analyses zinategemea students 22 au 23 badala ya 29.
- Standard prompts: Six predefined prompts zilitathminiwa badala ya free and natural student conversations.
- Follow-up questions excluded: Interactive teaching performance ya AI tutor haikupimwa fully.
- Single model: GPT-3.5 Turbo pekee ilitumika; hakuna comparison na other models.
- Model version: GPT-3.5 behavior katika 2024 huenda haiwakilishi current models.
- Single primary evaluator: Entire sample iliscorewa na course instructor.
- Ceiling effect: Accuracy na relevance scores zilikuwa very high, hivyo rubric huenda ikashindwa kutenganisha small quality differences.
- Supportiveness scale: Si validated psychological scale, bali researcher-defined proxy measure.
- Mandatory participation: Course credit inaweza kuongeza participation lakini pia kuhamasisha superficial completion.
- Shared and unauthenticated tutor: User-level personalization na secure access hazikutathminiwa.
- Knowledge-base gaps: Insufficient coverage ya baadhi ya finance na advanced DDD topics iliathiri response quality.
- Numerical reporting issues: Baadhi ya percentages katika text hazipatani na Figure 3 na basic arithmetic.
- Long-term outcomes: Haikupimwa kama students walihifadhi knowledge baada ya weeks au months.
- Privacy and monitoring: Effect ya collecting conversation logs kwa student privacy haikuchunguzwa kwa detail.
Study inaunga mkono nini?
- AI tutor iliyogroundiwa na course materials na constrained kwa prompt rules inaweza kujibu examined standard questions kwa high accuracy.
- AI inaweza kutoa support ya domain knowledge na modeling concepts kwa students on demand kabla ya short intensive design phase.
- Knowledge base, response length, term use na example selection ni configuration elements zenye substantial effect kwa tutor quality.
- Correct na relevant responses hazimaanishi automatically supportive au motivating tutoring.
- Kuingiza AI-supported activities kwenye program kwa explicit learning outcome, small course credit na knowledge check kunaweza kuongeza participation.
- Students waliripoti higher confidence baada ya implementation katika kupata domain knowledge na kutumia DDD kwa AI.
- Short conversation records na simple rubric zinaweza kuunda practical workflow kwa monitoring tutor use na evaluating quality.
- Calibrating teaching assistants kwa shared examples kunaweza kusaidia kugawanya evaluation workload katika larger classes.
Study haithibitishi nini?
- Haithibitishi AI tutor iliongeza objective exam au design performance ya students.
- Haionyeshi self-efficacy increase ilitokana na ChatGPT use pekee.
- Haionyeshi GPT-3.5 inafanya kazi kwa asilimia 98,9 accuracy katika general educational questions.
- Haithibitishi all course-material-grounded AI systems zitakuwa hallucination-free.
- Haionyeshi tutor inaweza kuchukua nafasi ya instructor au teaching assistant kabisa.
- Haionyeshi same quality itadumishwa katika free, long na unexpected student conversations.
- Haithibitishi results zina-transfer directly kwa undergraduate students, large classes au fields outside software engineering.
- Haionyeshi experimentally supportive expressions zinaongeza learning au achievement.
- Haionyeshi kwa separate experiment kwamba benefits za course credit ni kubwa kuliko risk ya superficial use.
- Haithibitishi current au more powerful language models zitatoa better results kwa same configuration.
- Haionyeshi AI use imetatulia ethics, privacy na academic-integrity issues.
Umuhimu kwa elimu ya uhandisi wa programu
Main contribution ya study ni kuangalia AI kama “design-readiness tool” kabla ya kuwa code-writing assistant. Katika software project, wrong domain model inaweza kusababisha system kutatua wrong problem hata kama code iliyoandikwa baadaye ni technically correct.
AI tutor iliyofungwa kwa course materials inaweza kutumika katika preparation tasks kama:
- Kueleza basic terms katika unfamiliar business domain,
- Kumsaidia student kuona actors na external systems katika project requirements,
- Kuunganisha modeling concepts na project ya student,
- Kuunda common starting level kabla ya class work,
- Kupunguza muda instructor anaotumia kwa repeated basic explanations.
Hata hivyo, tutor inapaswa ku-designiwa si kama response system pekee bali kama tool iliyointegratewa na course flow. Bila knowledge check, reflection, purposeful follow-up question na instructor oversight, student anaweza ku-copy answer tu.
Njia ya adoption iliyopendekezwa
Researcher anapendekeza staged path ifuatayo kwa courses zinazotumia AI-supported teaching kwa mara ya kwanza:
- Kufafanua AI use kwa explicit learning outcome.
- Kutenga small credit kama asilimia 1-2 ya total course grade.
- Kutumia simple quality na knowledge-check rubric.
- Kuomba one purposeful follow-up question kutoka kila student au team.
- Kutumia short conversation-record template wakati student count inazidi takribani 30.
- Kucalibrate teaching assistants kwa shared examples.
- Kuflag low-quality au risky responses kwa automated classification huku final decision ikibaki kwa instructor.
Future-work recommendations zinajumuisha replication katika different software-engineering topics na class sizes, evaluation ya quality-load balance ya free follow-up questions na rubric-based semi-automated quality screening.
Mbinu na Matokeo ya Utafiti
Technical method summary
| Technical element | Implementation katika study |
|---|---|
| Research approach | Classroom implementation na experience-based quantitative evaluation katika single-course context |
| Course | Autumn 2024, graduate functional-programming course ya units 12 |
| Institution | Carnegie Mellon University Silicon Valley |
| Participant | Graduate students 29 |
| Team size | Students 3-4 |
| Project | Automated cryptocurrency arbitrage system iitwayo ArbitrageGainer |
| Period examined | First two-week project phase |
| Learning domains | Cryptocurrency finance na Domain-Driven Design |
| AI system | Customized ChatGPT tutor based on GPT-3.5 Turbo |
| Knowledge base | Course slides, project specification na sample DDD student solution |
| Configuration | Persona, tasks, constraints, dos/don’ts na response format |
| Prototyping | Five trials per version; configuration frozen at fourth version |
| Pre-class activity | Three sessions; two standard prompts per session |
| Total standard pairs | Approximately 174 prompt-response pairs |
| Conversation unit | Two standard prompts in same session; total 87 units |
| Sampling | 10 units from each session; 30 conversations and 60 prompt-response pairs |
| Sampling ratio | Asilimia 34,5 |
| Sampling method | Stratified by session, random selection without replacement |
| Evaluation dimensions | Accuracy, relevance, pedagogical value, cognitive load na supportiveness |
| Scoring | 0-3 in each dimension |
| Primary evaluator | Course instructor and study author |
| Consistency check | Two teaching assistants, 15 conversations; weighted κ=0,76 and 0,78 |
| Student outcome | Pre- and post-implementation self-efficacy |
| Causal control | No control group |
Response-quality findings
| Dimension | Average | Main finding |
|---|---|---|
| Accuracy | %98,9 | Minor inaccuracies katika responses mbili kati ya 60; no significant error au researcher-classified hallucination |
| Relevance | %92,2 | Hakuna response iliyoshuka chini ya score 2 |
| Pedagogical value | %89,4 | Responses generally structured and example-based; one superficial response got 1 point |
| Cognitive load | %82,78 | Most responses understandable; repetition, jargon and length main issues |
| Supportiveness | %37,78 | Responses mostly neutral; weak validation and follow-up guidance |
Self-efficacy findings
- Large increase katika self-efficacy ya kupata domain knowledge kwa AI: F(1,22)=24,41; p<0,001; partial η²=0,53; dz≈1,03.
- Large increase katika self-efficacy ya kutumia DDD katika collaborative project kwa AI: F(1,21)=14,81; p<0,001; partial η²=0,41; dz≈0,82.
- Very large increase katika self-efficacy ya general DDD-model creation: F(1,21)=45,82; p<0,001; partial η²=0,69; dz≈1,44.
- Kwa kuwa third item hairefer AI directly, ilitathminiwa kama exploratory result.
- Analyses hazijumuishi students wote 29, bali paired responses za 22 au 23.
Technical interpretation ya results
Strongest result ni kwamba AI tutor iliyogroundiwa na course materials inaweza kutoa high-accuracy na relevant responses kwa specific, pre-designed questions. Result hii inahusiana closely na scope ya knowledge base na prompt constraints.
Pedagogical quality haijaamuliwa na correct information pekee. Response length, suitability ya terms kwa student level, alignment ya examples na project context na guiding student to meaningful next step ni separate design problems.
Self-efficacy increases ni positive indicator ya learning environment; lakini kwa kuwa hakuna control group wala objective competency test, si causal evidence ya learning achievement. Findings zina-support zaidi AI kutumika kama scalable preparation layer ndani ya instructor-designed course flow kuliko kuchukua nafasi ya instructor.
Minor percentage inconsistencies hazibadilishi main pattern: accuracy, relevance na pedagogical value ni high; supportiveness ni low. Hata hivyo, replication studies zikinpublish raw score distributions na calculation scripts openly, auditability ya results itaimarika.
Maelezo ya Chanzo na Mbinu
Jina kamili asilia la study: From Domain Understanding to Design Readiness: a playbook for GenAI-supported learning in Software Engineering
Author: Rafal Wlodarski.
Equal contribution au equal first author: Kwa kuwa ni single-author study, hakuna equal-contribution status.
Corresponding author: PDF haitumii separate “corresponding author” mark. Email ya sole author rafal.wlodarski@sv.cmu.edu imetolewa.
Institutional affiliation: Electrical & Computer Engineering, Carnegie Mellon University Silicon Valley, Mountain View, California, USA.
Author institutional role: Assistant Teaching Professor, Electrical and Computer Engineering, Carnegie Mellon University.
Source type: Peer-reviewed conference paper yenye real classroom implementation, response-quality evaluation, self-efficacy analysis na teaching practices.
Conference: Companion Proceedings of the 34th ACM Symposium on the Foundations of Software Engineering, FSE Companion ’26.
Conference section: Software Engineering Education.
Conference date and location: 5-9 July 2026; Montreal, Quebec, Canada.
Pages: 1078-1088.
Publication year: 2026.
Publisher: Association for Computing Machinery.
DOI: 10.1145/3803437.3805783.
ACM ISBN: 979-8-4007-2636-1/26/07.
Peer-review status: Study ilikubaliwa katika FSE 2026 Software Engineering Education program na kuchapishwa katika ACM conference proceedings. Conference call inaeleza section hii ilitumia double-anonymous review process.
License: Creative Commons Attribution 4.0 International.
Official ACM link:https://dl.acm.org/doi/10.1145/3803437.3805783
Official conference program:https://conf.researchr.org/track/fse-2026/fse-2026-software-engineering-education
ArXiv version: arXiv:2604.00120v1; 31 March 2026.
ArXiv DOI: 10.48550/arXiv.2604.00120. DOI hii ni ya preprint version; primary published DOI ya study ni ACM DOI.
Official arXiv link:https://arxiv.org/abs/2604.00120
Funding: Study ilifadhiliwa kupitia Generative Artificial Intelligence Teaching as Research Fellowship. Eberly team ilishukuriwa kwa support katika implementation.
Replication package: Study inaripoti standard prompts, tutor configuration, rubric materials, anonymized conversations na scores kwa kiwango kinachoruhusiwa, pamoja na analysis scripts, zimetolewa kama supplementary materials. PDF haionyeshi direct open-repository address.
Main limitations za study ni single institution na small sample, no control group, self-efficacy kutokuwa direct skill, all responses kuscorewa na one expert, only standard prompts evaluated, GPT-3.5 kutolinganishwa na other models na short implementation period.
Study haithibitishi AI tutor inaweza kuchukua nafasi ya human instructor au kuongeza objective design skill ya students peke yake. Findings zinaonyesha AI tutor iliyofungwa kwa course materials na configured kwa uangalifu inaweza kutumika kama complementary tool katika short-term domain-knowledge na modeling readiness.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *