

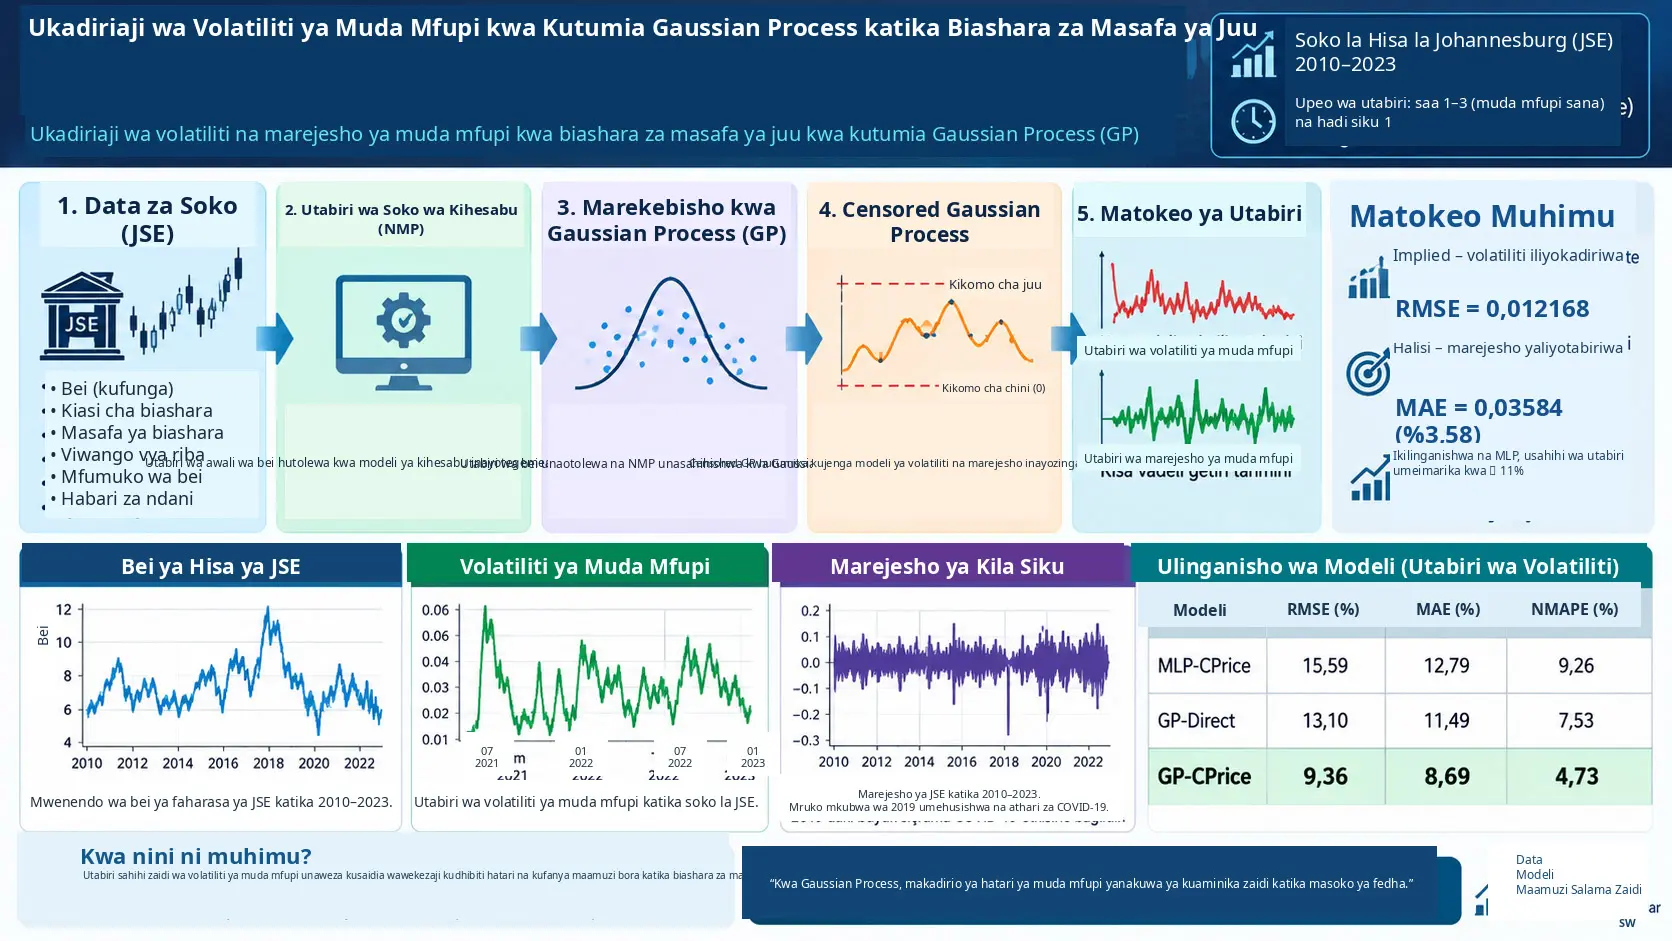
Ukadiriaji wa volatiliti ya muda mfupi ni tatizo la utabiri wa kiasi linalolenga kukadiria kiwango ambacho bei ya mali ya kifedha inaweza kubadilika ndani ya saa au siku zijazo. Utafiti uliofanywa na Leonard Mushunje, Maxwell Mashasha na Edina Chandiwana unaunganisha modeli ya Numerical Market Prediction (NMP) na mbinu za Gaussian Process juu ya data za Johannesburg Stock Exchange ili kuendeleza utabiri wa volatiliti na mapato ya muda mfupi unaoweza kutumika hasa katika biashara za masafa ya juu.
Mbinu kuu ya utafiti ina hatua mbili. Kwanza, utabiri wa stock-price uliotolewa na modeli ya NMP husahihishwa kwa Gaussian Process. Kisha Censored Gaussian Process hutumiwa kuiga uhusiano kati ya bei zilizorekebishwa na stock return au volatility. Automatic Relevance Determination hutumiwa kubainisha ni lipi kati ya stock prices, trading volumes, trade frequency, interest rates, inflation na insider news lina mchango mkubwa zaidi katika utabiri.
Kulingana na chanzo, modeli ilitoa matokeo mazuri hasa katika upeo wa utabiri wa saa 1–3. Katika ulinganisho wa implied volatility na estimated volatility, RMSE iliripotiwa kuwa 0,012168; katika ulinganisho wa thamani halisi na zinazokadiriwa za stock return, MAE ilipatikana kuwa 0,03584, yaani takribani %3,58. Katika utabiri wa volatiliti, modeli ya GP-CPrice ilitoa makosa madogo kuliko modeli nyingine zilizolinganishwa, ikiwa na RMSE %9,36, MAE %8,69 na NMAPE %4,73.
Matokeo haya ni ya kutia moyo kwa upande wa makadirio ya hatari ya muda mfupi katika mifumo ya biashara za masafa ya juu, lakini utafiti haupimi moja kwa moja faida ya mfumo wa utekelezaji wa oda wa HFT wa wakati halisi wala trading latency yake. Matokeo yanahusu usahihi wa utabiri na yamewekewa mipaka ya mazingira ya uigaji yaliyojengwa juu ya data za JSE.
Kwa nini volatiliti ni muhimu katika biashara za muda mfupi?
Volatiliti inaeleza jinsi bei ya mali ya kifedha inaweza kubadilika kwa kasi na kwa kiwango kikubwa kwa muda. Katika mikakati ya biashara ya masafa ya juu au ya muda mfupi sana, mienendo ya bei inaweza kutokea ndani ya sekunde, dakika au saa, hivyo vipimo vya volatiliti ya muda mrefu pekee huenda visitoshe.
Chanzo kinasisitiza kwamba utabiri wa saa 1–3 ni muhimu kwa maamuzi ya wawekezaji kuhusu nafasi za muda mfupi. Mojawapo ya malengo yaliyokubaliwa katika usanifu wa modeli ni kwamba thamani ya forecast error katika upeo huu wa muda isizidi kiwango cha %10 ikilinganishwa na uchunguzi halisi.
Kwa nini haitumiki tu GARCH au ARIMA ya kawaida?
Utafiti unakubali kwamba mbinu za takwimu kama ARCH/GARCH, ARIMA, ANN, Kalman filter na support vector machine hutumiwa sana katika utabiri wa kifedha, lakini unahoji kwamba mikurupuko ya haraka ya bei katika vipindi vifupi vya muda huenda isikamatwe kikamilifu na familia moja ya modeli.
Kwa sababu hiyo, waandishi wanajenga muundo mseto unaofanana na mtazamo wa “physical model + statistical model” na kutumia matokeo ya Numerical Market Prediction kama taarifa ya kuingiza katika Gaussian Process.
Sehemu ya hitimisho la utafiti inasema kwamba mbinu ya GP iliyopendekezwa ilifanya vizuri zaidi kuliko GARCH(1,1) na ARIMA. Hata hivyo, kwa kuwa jedwali kuu za majaribio katika makala iliyopakiwa hazitoi thamani za moja kwa moja za RMSE, MAE au NMAPE kwa GARCH na ARIMA, dai hili haliwezi kuzalishwa upya kwa namna ya kiasi.
Modeli ya Gaussian Process Inafanyaje Kazi?
Gaussian Process (GP) ni mbinu ya Bayesian regression ambayo badala ya kukadiria moja kwa moja kazi moja thabiti, hufafanua usambazaji wa uwezekano juu ya kazi mbalimbali zinazowezekana. Sifa hii huruhusu kutokuwa na uhakika katika data ya kifedha kushughulikiwa si kwa makadirio ya nukta pekee bali pia kwa njia ya uwezekano.
Chanzo kinatumia ifuatayo kwa tatizo la kawaida la regression:
Hapa \(x_i\) huwakilisha vigeu vya kuingiza, \(y_i\) thamani lengwa, na \(\epsilon_i\) huwakilisha sehemu ya Gaussian noise isiyoonekana.
Noise:
hukubaliwa hivyo.
Usambazaji wa pamoja wa data ya training hufafanuliwa kama:
ambapo elementi za kernel matrix hupatikana kwa:
.
Kwa ingizo jipya \(x_*\), wastani wa posterior hutolewa kama:
na variansi ya utabiri kama:
.
Kwa nini Censored Gaussian Process ilitumika?
Katika modeli ya chanzo, stock price ina kikomo cha chini cha sifuri na kikomo cha juu kinachoitwa \(S_{upper}\). Waandishi wanaona kwamba kwa sababu ya mipaka hii, thamani halisi za latent price haziwezi kuonekana moja kwa moja katika baadhi ya hali na badala yake huwakilishwa na thamani za threshold.
Kwa sababu hiyo, badala ya GP ya kawaida hutumiwa Censored Gaussian Process. Censored GP haichukulii moja kwa moja thamani ya threshold iliyoonekana kama thamani halisi ya latent, bali huzingatia ndani ya probabilistic model uwezekano kwamba thamani halisi inaweza kuwa nje ya kikomo cha uchunguzi.
Kulingana na matokeo ya exploratory data analysis ya chanzo, takribani %4,6 ya uchunguzi upo karibu na %5 ya kikomo cha juu. Kwa hiyo waandishi walipendelea kujumuisha moja kwa moja athari ya censoring ndani ya modeli badala ya kufanya standard regression output kisha kuikata kwa threshold baadaye.
Muundo huu wa kikomo cha bei haupaswi kuchukuliwa hapa kama sifa ya jumla ya soko la JSE, bali kama dhana ya modeli iliyotumika katika utafiti.
NMP na Gaussian Process zinaunganishwaje?
Numerical Market Prediction (NMP) hutumika katika utafiti kama sehemu ya utabiri wa bei inayowakilisha mienendo ya soko la kifedha kwa kutumia vigeu vya kihistoria na vya statistical-physics.
Mnyororo mkuu wa hatua uliopendekezwa na waandishi ni huu:
NMP → Standard GP → Corrected Stock Price → Censored GP → Stock Price Volatility / Stock Return
Price prediction inayotolewa na NMP husahihishwa kwanza kwa GP. Kisha corrected stock price, trading volume na viingizo vingine vilivyochaguliwa hupelekwa katika modeli ya Censored GP.
Kuna tofauti gani kati ya GP-Direct na GP-CPrice?
Chanzo kinafafanua njia mbili kuu za uigaji.
GP-Direct hujaribu kukadiria moja kwa moja stock return au volatility kutoka kwa data ya NMP.
GP-CPrice kwanza husahihisha systematic na stochastic bias katika utabiri wa NMP stock-price kwa GP; baadaye hutumia modeli ya pili juu ya corrected stock price ili kutoa utabiri wa return au volatility.
Katika majaribio, kwa ujumla iliripotiwa kwamba njia ya pili ilitoa thamani za forecast error zilizo chini zaidi.
ARD inasaidia nini?
Automatic Relevance Determination (ARD) ilitumika kubaini ni vigeu gani vya kuingiza vinaeleza modeli kwa nguvu zaidi.
| Kigeu | Kipindi cha uigaji 1 | Kipindi cha uigaji 2 |
|---|---|---|
| Stock prices | 0,380 | 0,313 |
| Trading volumes | 0,330 | 0,364 |
| Trade frequency | 0,206 | 0,210 |
| Interest rates | 0,100 | 0,080 |
| Inflation | 0,080 | 0,121 |
| Insider news | 0,270 | 0,290 |
Kulingana na tafsiri ya chanzo, stock price na trading volume ni miongoni mwa viingizo vyenye nguvu zaidi katika usahihi wa utabiri. Kwa upande wa volatiliti, trading volume na insider news vinaonekana kuwa na athari kubwa hasa.
Mbinu na Matokeo
Chanzo cha data
Katika utafiti huu, data za Johannesburg Stock Exchange zilichukuliwa kutoka Januari 2010 hadi Januari 2023.
Chanzo kinasema kwamba:
- data ya mwaka mmoja ilitumika kama training set,
- na data iliyobaki kama independent test set
.
Iliripotiwa kuwa sehemu ya uchunguzi uliokosekana ilikuwa chini ya %30 ya data yote, na rekodi zilizokosekana zilijazwa kwa kutumia mbinu ya K-nearest neighbor.
Mzunguko wa matokeo ya NMP
Kulingana na utafiti, utabiri wa NMP huzalishwa kila siku na hupatikana karibu saa 16:00 CAT wakati shughuli za closing valuation hufanyika katika JSE. Data huwa na taarifa za stock prices, volume na return kwa saa 24 zijazo katika mwonekano wa takribani dakika 30.
Hata hivyo, hesabu za 1–3 saa za forecasting error zilifanywa kwa kutumia hourly data.
Forecast accuracy ilipimwaje?
Vipimo viwili vikuu vya makosa vilitumika.
Forecast error:
Root Mean Square Error:
Mean Absolute Error:
Chanzo kinafafanua accuracy threshold lengwa kama forecast error ya %10 au chini ya hapo.
Utabiri wa volatiliti: implied na estimated
| Mwezi | Implied volatility | Estimated volatility | Tofauti |
|---|---|---|---|
| 1 | 0,280 | 0,279 | 0,001 |
| 3 | 0,296 | 0,283 | 0,013 |
| 6 | 0,337 | 0,320 | 0,017 |
| 8 | 0,490 | 0,480 | 0,010 |
| 10 | 0,600 | 0,600 | 0,000 |
| 12 | 0,800 | 0,798 | 0,003 |
Kwa ulinganisho wa miezi 12 yote, chanzo kinaripoti:
RMSE = 0,012168
.
Waandishi wanafasiri RMSE hii ndogo kama ishara ya ukaribu mkubwa kati ya estimated volatility na implied volatility.
Utabiri wa stock-return
Katika ulinganisho wa actual return na forecasted return, data ya miezi 12 ilitumika.
Chanzo kinaripoti kwa ujumla:
MAE = 0,03584 = %3,58
.
Hata hivyo, makosa ya miezi yote hayako katika kiwango sawa. Hasa katika mwezi wa tisa, actual return ilikuwa 0,713 huku forecasted return ikiwa 0,409, na tofauti ikawa 0,304. Thamani hii ni kubwa dhahiri kuliko makosa ya miezi mingine.
Kwa hiyo, ingawa kosa la wastani ni dogo, inaonekana kwamba katika vipindi binafsi inaweza kutokea forecast error kubwa.
Ulinganisho wa modeli za stock-return
| Modeli | RMSE (%) | MAE (%) | NMAPE (%) |
|---|---|---|---|
| CReturns | 14,59 | 12,79 | 10,45 |
| GP-Direct | 12,40 | 12,09 | 9,53 |
| GP CReturns | 8,36 | 7,29 | 5,73 |
Jina la modeli ya mwisho katika jedwali linaonekana katika chanzo kama “GP CReturns”. Hata hivyo, maelezo ya mbinu yanayoizunguka na sehemu ya matokeo huiita modeli iliyopendekezwa GP-CPrice au GP-Stock Price. Kwa kuwa chanzo hakitatui wazi tofauti hii ya jina, lebo ya safu haikubadilishwa hapa.
Ulinganisho wa modeli za volatiliti
| Modeli | RMSE (%) | MAE (%) | NMAPE (%) |
|---|---|---|---|
| MLP-CPrice | 15,59 | 12,79 | 9,26 |
| GP-Direct | 13,10 | 11,49 | 7,53 |
| GP-CPrice | 9,36 | 8,69 | 4,73 |
Katika vipimo vyote vitatu, GP-CPrice ilitoa thamani ndogo zaidi za forecast error.
Hasa NMAPE iliripotiwa kuwa:
- %9,26 kwa MLP-CPrice,
- %7,53 kwa GP-Direct,
- %4,73 kwa GP-CPrice
.
Kwa nini NMAPE ilitumika?
Utafiti unasema kwamba normalized mean absolute percentage error inafaa hasa kwa kutathmini makosa ya utabiri.
Hapa \(M\) inawakilisha thamani ya normalization inayohusiana na market type katika utafiti.
Ulinganisho wa MLP
Chanzo pia kilitumia modeli ya kulinganisha ya MLP yenye hatua mbili. MLP ya kwanza hutumia NMP stock prices, trading volumes na exchange rates kama viingizo na ina 11-neuron hidden layer. Sehemu ya pili hutumia ingizo la corrected stock price na kwa 8-neuron hidden layer huzalisha utabiri wa mwisho wa return.
Katika sehemu ya matokeo, waandishi wanasema kwamba modeli ya GP-Stock Price iliyopendekezwa ilitoa takribani uboreshaji wa %11 wa usahihi wa utabiri ikilinganishwa na mbinu ya MLP-Stock Price.
Ni nini kinaonekana katika michoro ya bei na volatiliti ya JSE?
Mchoro wa JSE Stock Index Price Evolution katika ukurasa wa 11 wa chanzo unaonyesha mienendo ya bei katika kipindi cha 2010–2023. Katika mfululizo huo, hasa karibu na 2018–2019, kuna mienendo mikubwa ya kiwango na baada yake kushuka kwa wazi.
Katika mchoro wa volatility kwenye ukurasa wa 12, inaonekana kwamba katika kipindi cha 2020–2023 volatiliti ya muda mfupi ilibadilika takribani kati ya 0,01–0,07 na ikaunda makundi kadhaa ya volatiliti.
Katika mchoro wa return kwenye ukurasa huohuo, mapato ya kila siku katika kipindi cha 2010–2023 yanaonekana kukusanyika karibu na sifuri, lakini pia kuna outlier kubwa za chanya na hasi. Chanzo kinaunganisha moja ya kuruka huko kubwa na janga la COVID-19. Huu ni ufafanuzi wa waandishi wenyewe na haujathibitishwa kwa kujitegemea katika tathmini hii ya Verianla.
Uhusiano wa modeli na biashara za masafa ya juu ni upi?
Katika utafiti, usemi wa “high-frequency trading” unategemea uwezo wa modeli kutumika katika upeo mfupi sana wa utabiri. Modeli haifanyi kipimo cha utekelezaji wa order-book wa sekunde kwa sekunde wala kipimo halisi cha exchange latency.
Kwa hiyo mchango mkuu wa utafiti si kuongeza kasi ya upitishaji wa oda katika mfumo wa HFT, bali ni kuzalisha utabiri wa muda mfupi wa volatility na return ambao safu ya maamuzi ya HFT inaweza kutumia.
Hitimisho linaloungwa mkono na utafiti
- Kusahihisha utabiri wa NMP kwa GP kulitoa makosa ya utabiri yaliyo chini zaidi kuliko mbinu ya moja kwa moja ya NMP → output katika modeli zilizojaribiwa.
- Muundo wa GP-CPrice ulitoa RMSE, MAE na NMAPE ndogo zaidi kuliko modeli za MLP-CPrice na GP-Direct katika majaribio ya price-volatility.
- Matokeo ya ARD yanaonyesha kuwa stock prices na trading volumes ni viingizo vyenye nguvu kwa modeli.
- Forecast horizon ya saa 1–3 inaoneshwa kama moja ya maeneo yenye nguvu zaidi ya matumizi ya utafiti.
- Matumizi ya Censored GP yalitekelezwa ili kushughulikia dhana ya kikomo cha bei ndani ya probabilistic model.
Ujumlishaji ambao utafiti hauungi mkono
- Haikupimwa kwamba modeli hii hutoa trading profit kubwa zaidi moja kwa moja katika mfumo halisi wa HFT.
- Order book latency ya moja kwa moja, slippage, exchange queue priority au market impact havikujaribiwa.
- Haijathibitishwa kwamba modeli ingeonyesha usahihi uleule katika masoko mengine kama ulivyoonekana katika JSE.
- Ingawa ulinganisho wa GARCH au ARIMA umetajwa katika sehemu ya matokeo, jedwali kuu zilizopakiwa hazina vipimo vya makosa ya kina kwa modeli hizi.
- Uboreshaji wa takribani %11 dhidi ya MLP haupaswi kuchukuliwa kama uwiano wa jumla kwa forecasting horizons zote.
Dokezo la Chanzo na Mbinu
Kichwa asili: Short-term Volatility Estimation for High Frequency Trades using Gaussian processes (GPs).
Waandishi: Leonard Mushunje, Maxwell Mashasha na Edina Chandiwana.
Taasisi: Midlands State University, Department of Applied Mathematics and Statistics.
Eneo la utafiti: Mfululizo wa muda wa kifedha, utabiri wa volatiliti ya muda mfupi, Gaussian Process regression na msaada wa maamuzi katika biashara za masafa ya juu.
Chanzo cha data: Johannesburg Stock Exchange stock-price databases.
Kipindi cha data: Januari 2010 – Januari 2023.
Data iliyokosekana: Kulingana na chanzo, chini ya %30 ya jumla; ilikamilishwa kwa mbinu ya KNN.
Upeo wa utabiri: Kuanzia saa chache hadi siku moja; kipindi cha saa 1–3 kinasisitizwa hasa.
Mbinu kuu: Numerical Market Prediction + Standard Gaussian Process + Censored Gaussian Process.
Feature selection: Automatic Relevance Determination.
Modeli za kulinganisha: Persistence, MLP-CPrice na GP-Direct; utafiti pia unajadili GARCH na ARIMA katika fasihi na katika tafsiri ya matokeo.
Vipimo vya makosa: RMSE, MAE na NMAPE.
Matokeo ya volatiliti: Kwa GP-CPrice, RMSE %9,36, MAE %8,69 na NMAPE %4,73.
Matokeo ya stock-return: Thamani ndogo zaidi zilizoripotiwa ni RMSE %8,36, MAE %7,29 na NMAPE %5,73; hata hivyo, lebo ya modeli ya safu husika katika chanzo si thabiti kikamilifu kati ya GP CReturns / GP-CPrice.
Implied-estimated volatility RMSE: 0,012168.
Actual-forecasted return MAE: 0,03584, yaani %3,58 kwa maelezo ya chanzo.
Kikomo kikuu cha kisayansi: Utafiti hupima forecasting accuracy; execution latency ya mfumo halisi wa HFT au live trading profitability haijajaribiwa kwa majaribio.
Kikomo cha ndani ya chanzo: Ingawa ubora juu ya GARCH(1,1) na ARIMA umetajwa katika sehemu ya matokeo, jedwali kuu za matokeo hazina metrika za moja kwa moja za makosa ya kulinganisha kwa modeli hizo.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *