

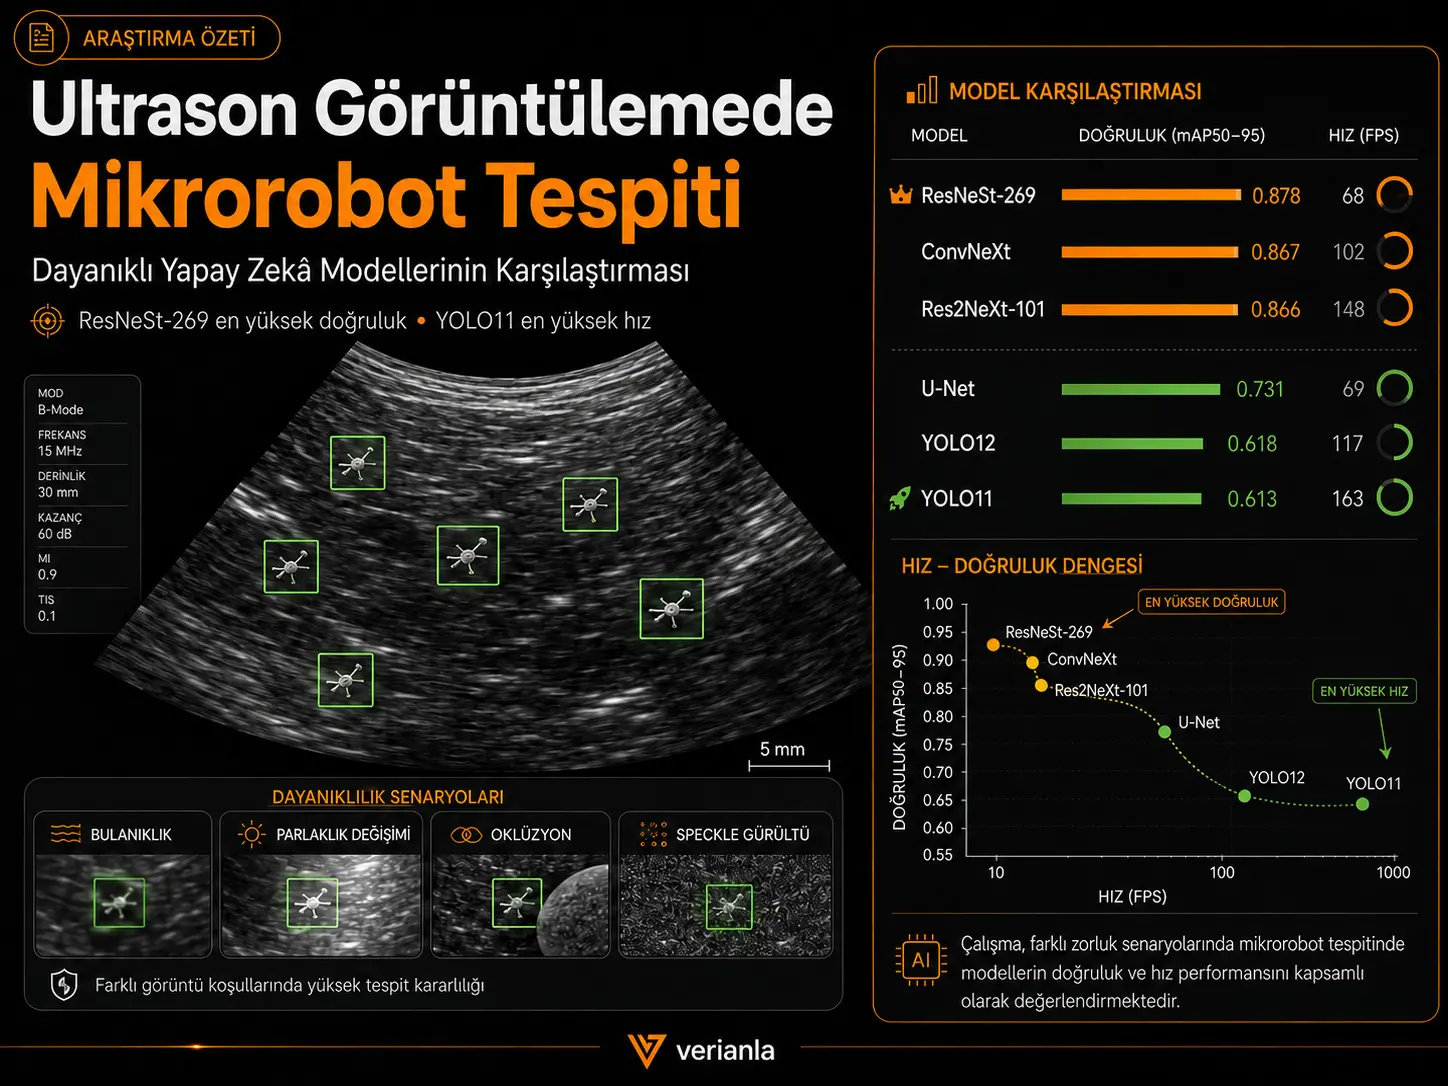
Utafiti huu unalinganisha usahihi, ustahimilivu dhidi ya upotoshaji wa picha na ufanisi wa kihesabu wa miundo sita tofauti katika kutambua mikroroboti kwenye picha za ultrasound kwa kutumia akili bandia. ConvNeXt, Res2NeXt-101, ResNeSt-269, U-Net, YOLO11 na YOLO12 zilitathminiwa kwenye jumla ya picha 32.511 zinazoweza kutumika kutoka Dataset ya USMicroMagSet, ambayo ina aina nane tofauti za mikroroboti za sumaku. Katika Jedwali 4, ResNeSt-269 ilifikia usahihi wa juu zaidi kwa jumla kwa 0,878249645 mAP(50–95), huku ConvNeXt ikiwa na 0,866752148 na Res2NeXt-101 ikiwa na 0,866416454, matokeo yaliyo karibu sana. Kwa upande mwingine, YOLO11 ndiyo modeli ya haraka zaidi ikiwa na latency ya 6,1 ms/picha na 163 FPS. Matokeo yanaonyesha kuwa usanifu wenye usahihi wa juu zaidi wa utambuzi si uleule wenye gharama ya chini zaidi ya kihesabu. Utafiti huu ni benchmark ya Dataset na modeli; haujaonyesha matumizi ya kliniki kwa wagonjwa halisi, mafanikio ya matibabu, au urambazaji salama wa mikroroboti ndani ya mwili wa binadamu aliye hai.
USMicroMagSet ina picha za ultrasound za B-mode zenye pikseli 1920 × 1080. Ingawa Dataset ya chanzo ina zaidi ya fremu 40.000 zilizo na annotations, idadi ya picha zinazoweza kutumika katika utafiti imeripotiwa kuwa 32.511. Kati ya hizo, 21.127 ziko katika muundo wa mafunzo/validation na 11.384 ziko katika folda huru ya test. Katika sehemu ya mafunzo, five-fold cross-validation ilitumika; katika kila fold, %80 ya data ya mafunzo ilitengwa kwa mafunzo na %20 kwa validation. Miundo yote ilitathminiwa kwa mipangilio ya msingi iliyofanana, ikiwemo 30 epoch, 16 batch size, optimization ya AdamW na learning rate ya 0,0001.
Jambo la kuvutia katika matokeo ya utafiti si kujibu tu swali la “ni modeli ipi iliyo sahihi zaidi?”, bali pia kuonyesha kwamba tabia za modeli hutofautiana sana chini ya upotoshaji wa picha za ultrasound unaofanana na hali halisi. Mabadiliko ya mwangaza yalisababisha upotevu wa AP wa %84,85 katika U-Net, %71,10 katika YOLO12 na %60,23 katika YOLO11, ilhali upotevu katika ConvNeXt ulikuwa %14,78. Kwa upande mwingine, miundo ya YOLO inaonekana kustahimili zaidi speckle noise. Kwa hiyo, kipimo kimoja cha usahihi wa jumla pekee hakitoshi kuchagua mfumo wa real-time wa kufuatilia mikroroboti kwa ultrasound.
Kwa mtazamo wa Türkiye: Utafiti haukufanywa nchini Türkiye, na matokeo hayatoi uthibitishaji uliotumiwa moja kwa moja katika hospitali, vifaa vya ultrasound au matumizi ya kliniki nchini Türkiye. Ikiwa mfumo kama huu utaendelezwa nchini Türkiye, uthibitishaji tofauti utahitajika kwa vifaa vya ultrasound vinavyotumika, mipangilio ya probe, tofauti za waendeshaji, ubora wa picha, jiometri ya mikroroboti na miundombinu ya kihesabu iliyopo. Hasa, ukweli kwamba utafiti ulifanywa kwenye GPU yenye nguvu sana kama NVIDIA B200 unamaanisha kuwa haiwezi kudhaniwa kwamba thamani za latency na FPS zilizopatikana zitabaki zilezile kwenye hardware ya ndani yenye uwezo mdogo zaidi.
Swali kuu la utafiti ni lipi?
Ili mikroroboti zielekezwe kwenye eneo lengwa katika matumizi ya kitabibu, haitoshi tu kuweza kuzisogeza; nafasi zao ndani ya mwili lazima ziweze kutambuliwa na kufuatiliwa kwa kutegemewa. Watafiti wanashughulikia tatizo hili kupitia ultrasound imaging na modeli za object detection zinazotegemea deep learning.
Lengo kuu la utafiti ni kulinganisha miundo tofauti ya akili bandia kwa utambuzi wa mikroroboti katika picha za ultrasound ndani ya mfumo mmoja wa benchmark, na kupima si vipimo vya msingi vya usahihi pekee bali pia ustahimilivu dhidi ya upotoshaji wa picha, utegemezi wa vipengele vya kuona na gharama ya kihesabu inayohusiana na matumizi ya real-time.
Kwa nini ultrasound ndiyo kitovu?
Utafiti unajadili mbinu kama magnetic resonance imaging (MRI), computed tomography (CT), optical imaging na ultrasound. Katika mfumo uliowekwa na waandishi, ultrasound ni mgombea anayefaa kwa ufuatiliaji wa mikroroboti wa real-time kwa sababu ya urahisi wa kubebeka, gharama yake ya chini kwa kulinganisha, kutotumia mionzi ya ionizing na temporal resolution ya juu.
Hata hivyo, sifa za picha za ultrasound kama contrast ya chini, spatial resolution yenye kikomo, tissue artifacts na speckle noise hufanya utambuzi wa mikroroboti ndogo kuwa mgumu zaidi. Benchmark ya akili bandia katika utafiti inalenga hasa mazingira haya magumu ya imaging.
Ni mikroroboti zipi zilitumika?
Dataset ya USMicroMagSet ina madarasa nane ya mikroroboti: cube, cylinder, flagella, helical, rollingcube, sheetrobot, sphere1 na sphere3. Kielelezo 5 katika utafiti kinaonyesha kwa kila darasa picha ya ultrasound isiyo na annotation na picha inayolingana iliyowekwa alama kwa bounding box ya kijani, zikiwa kando kwa kando. Hivyo tofauti za umbo, contrast na mipaka ya madarasa katika picha za ultrasound zinaweza kuonekana moja kwa moja.
| Darasa la mikroroboti | Idadi ya mafunzo | Idadi ya test |
|---|---|---|
| cube | 2267 | 1222 |
| cylinder | 1596 | 861 |
| flagella | 1956 | 1054 |
| helical | 3155 | 1699 |
| rollingcube | 1255 | 677 |
| sheetrobot | 3010 | 1622 |
| sphere1 | 5900 | 3178 |
| sphere3 | 1988 | 1071 |
| Jumla | 21.127 | 11.384 |
Usambazaji wa data hauna uwiano. Kwa mfano, darasa la sphere1 lina picha 5900 za mafunzo, huku rollingcube ikiwa na 1255. Waandishi wanakubali kutolingana huku kwa madarasa kama moja ya vikwazo vya utafiti. Hata hivyo, kwa kutegemea matokeo yao wenyewe, wanasisitiza kwamba idadi ghafi ya sampuli pekee haiwezi kueleza mafanikio ya modeli na kwamba sifa za usanifu ni muhimu.
Kwa nini modeli sita zilitathminiwa pamoja?
Benchmark inajumuisha miundo ya ConvNeXt, Res2NeXt-101, ResNeSt-269, U-Net, YOLO11 na YOLO12. Katika utafiti, modeli hizi zilichaguliwa kwa sababu ya tofauti za sifa zao za usanifu. ConvNeXt inawakilisha mbinu ya kisasa ya CNN inayotegemea kernels kubwa na hierarchical feature extraction; ResNeSt-269 inawakilisha split-attention mechanism; Res2NeXt-101 inawakilisha multi-scale feature representation; U-Net inawakilisha muundo wa encoder-decoder na skip connection; na YOLO11 pamoja na YOLO12 zinawakilisha mbinu fupi zaidi ya real-time detection.
Katika Kielelezo 3, watafiti wanaeleza uchaguzi wa modeli si kwa matarajio ya usahihi pekee, bali pia kwa utofauti wa usanifu, kasi, uwezekano wa matumizi ya kliniki na unyeti kwa vihisishi tofauti vya kuona katika picha za ultrasound.
Ni modeli ipi inaongoza katika usahihi wa jumla wa utambuzi?
Kwa mujibu wa thamani sahihi za mAP(50–95) katika Jedwali 4, ResNeSt-269 ilitoa matokeo ya juu zaidi. ConvNeXt na Res2NeXt-101 zilionyesha utendaji uliokaribiana sana. Ingawa muhtasari na hitimisho la chanzo linaweka Res2NeXt-101 katika nafasi ya pili na ConvNeXt katika nafasi ya tatu, thamani za jedwali zinaonyesha kwamba 0,866752148 ya ConvNeXt ni juu kwa tofauti ndogo sana kuliko 0,866416454 ya Res2NeXt-101. Kwa hiyo, hapa thamani sahihi za namba ndizo zimechukuliwa kuwa msingi badala ya tafsiri ya mpangilio.
| Modeli | mAP (50–95) | mAP50 | mAP75 | Usahihi | Recall |
|---|---|---|---|---|---|
| YOLO12 | 0.617824433 | 0.962943476 | 0.670267625 | 0.93580446 | 0.840348152 |
| YOLO11 | 0.613175223 | 0.949897181 | 0.690278055 | 0.962045926 | 0.769022882 |
| ConvNeXt | 0.866752148 | 0.98678273 | 0.916006863 | 0.985324123 | 0.995195712 |
| ResNeSt-269 | 0.878249645 | 0.988578439 | 0.930365086 | 0.986016259 | 0.995728513 |
| Res2NeXt-101 | 0.866416454 | 0.988445342 | 0.919016898 | 0.985829465 | 0.995924184 |
| U-Net | 0.7309196 | 0.875163198 | 0.781938016 | 0.7309196 | 0.880745351 |
Thamani za mAP50 kuwa juu pia katika modeli za YOLO zinaonyesha kwamba katika kiwango cha IoU kisicho kikali sana, modeli hizi zinaweza kupata idadi kubwa ya vitu; kupungua kwa wazi kwa mAP(50–95) kunaonyesha kuwa tofauti ya utendaji huongezeka wakati vigezo vikali zaidi vya localization vinatathminiwa pamoja. Watafiti walitumia mAP(50–95) kama moja ya vipimo vya msingi vya tathmini kwa sababu localization sahihi ni muhimu katika matumizi ya mikroroboti.
Ni madarasa gani ya mikroroboti yaliyo magumu zaidi?
Katika uchambuzi wa pamoja wa madarasa wa modeli sita, madarasa matatu yenye utendaji wa chini zaidi yaliripotiwa kuwa rollingcube, sheetrobot na sphere1. Thamani za pamoja za AP(50–95) zilizotolewa na watafiti ni 0,598, 0,676 na 0,768 mtawalia.
Thamani ya recall ya YOLO11 katika darasa la rollingcube ni 0,002394288 na F1 score ni 0,004777139. Kwa YOLO12, recall ya darasa hilo imeripotiwa kuwa 0 na F1 score 0. Kwa upande mwingine, ConvNeXt, ResNeSt-269 na Res2NeXt-101 zilipata 0,939757824, 0,93028307 na 0,941604495 mAP(50–95), mtawalia, katika darasa la rollingcube. Tofauti hii inaonyesha kuwa mafanikio ya jumla ya modeli yanaweza kuficha tabia yake katika jiometri fulani za mikroroboti.
Blur, mwangaza na occlusion zinaathirije modeli?
Utafiti haukuangalia picha safi za test pekee; blur, mabadiliko ya mwangaza/contrast, occlusion na speckle noise viliongezwa ili kuiga changamoto za imaging zinazofanana na hali halisi. Kielelezo 7 kinaonyesha upotevu wa AP wa modeli katika hali tatu za kwanza za upotoshaji.
Verianla Live: Upotevu wa AP chini ya upotoshaji wa picha
Thamani katika jedwali ni asilimia za upotevu wa AP zilizoandikwa juu ya nguzo katika Kielelezo 7. Upotevu mdogo unamaanisha ustahimilivu mkubwa zaidi katika hali husika ya upotoshaji.
| Modeli | Upotevu wa AP kutokana na blur (%) | Upotevu wa AP kutokana na mwangaza (%) | Upotevu wa AP kutokana na occlusion (%) | Chanzo |
|---|---|---|---|---|
| YOLO12 | 29.79 | 71.10 | 25.84 | Kielelezo 7 |
| YOLO11 | 18.06 | 60.23 | 26.66 | Kielelezo 7 |
| ConvNeXt | 12.53 | 14.78 | 17.33 | Kielelezo 7 |
| ResNeSt-269 | 20.87 | 32.04 | 20.13 | Kielelezo 7 |
| Res2NeXt-101 | 13.73 | 28.14 | 17.81 | Kielelezo 7 |
| U-Net | 79.17 | 84.85 | 47.72 | Kielelezo 7 |
Verianla Live: Taswira hutengenezwa wakati wa runtime kutoka kwenye jedwali la data za kisayansi linaloonekana hapo juu. Muda wa animation hauwakilishi muda wa jaribio la kisayansi.
Ujumbe ulio wazi zaidi wa Kielelezo 7 ni kwamba mabadiliko ya mwangaza ni stress factor kubwa kwa modeli nyingi. Upotevu wa AP unaosababishwa na mwangaza ni %14,78 katika ConvNeXt, %60,23 katika YOLO11, %71,10 katika YOLO12 na %84,85 katika U-Net. Res2NeXt-101 ilionyesha upotevu wa %28,14 na ResNeSt-269 %32,04.
Katika blur, ConvNeXt yenye upotevu wa AP wa %12,53 na Res2NeXt-101 yenye %13,73 ni miongoni mwa matokeo yenye ustahimilivu zaidi. Kwa U-Net, upotevu unaongezeka hadi %79,17. Ingawa occlusion inaathiri modeli zote, U-Net inaonyesha tena kushuka kwa kiwango kikubwa zaidi ikiwa na upotevu wa AP wa %47,72.
Speckle noise inaonyesha taswira tofauti
Kwa kuwa speckle noise ina umuhimu maalumu katika ultrasound imaging, watafiti walitumia variance tano za kelele: 0,02, 0,04, 0,06, 0,08 na 0,1. Katika Kielelezo 8, upotevu wa AP kwa YOLO12 unaonyeshwa kuwa %1,1, %1,2, %1,3, %1,5 na %1,7 mtawalia; kwa YOLO11 ni %1,1, %1,8, %2,3, %3,3 na %4,0.
Thamani zinazoonekana kwa ConvNeXt katika Kielelezo 8 ni %5,3, %8,9, %11,9, %14,0 na %16,2. Hata hivyo, maandishi yanayoeleza kielelezo hicho yanatoa range ya upotevu wa AP kwa ConvNeXt kuwa %5,3–11,2. Kwa sababu ya kutolingana huku kwa namba ndani ya chanzo, taarifa hizi mbili hazijabadilishwa kuwa thamani moja “iliyosahihishwa”.
Katika Kielelezo 8, upotevu wa AP kwa ResNeSt-269 unaongezeka kutoka takriban %29,8 hadi %70,5 kadiri kiwango cha kelele kinavyoongezeka; kwa U-Net unaongezeka kutoka %2,4 hadi %68,2. Maandishi ya chanzo pia yanaeleza kwamba variance inapofikia 0,08, upotevu wa ResNeSt-269 na U-Net huzidi %50. Kauli “strong noise tolerance” inayofuata mara moja haiendani kimantiki na namba hizi, kwa hivyo inapaswa kuchukuliwa kuwa kutolingana kwa simulizi ndani ya chanzo.
Modeli zinategemea zaidi vihisishi gani vya kuona?
Katika utafiti, badala ya mbinu ya kawaida ya Grad-CAM katika kiwango cha pikseli, mchango wa vipengele ulitolewa kutokana na kushuka kwa mAP kulikohusishwa na upotoshaji. Watafiti waliunganisha blur na vipengele vya kingo, mabadiliko ya mwangaza na illumination, occlusion na vipengele vya spatial, na speckle noise na taarifa za texture.
| Modeli | Kingo (%) | Texture (%) | Mwangaza (%) | Spatial (%) |
|---|---|---|---|---|
| YOLO12 | 23.26 | 1.05 | 55.52 | 20.18 |
| YOLO11 | 16.81 | 2.33 | 56.05 | 24.81 |
| ConvNeXt | 22.42 | 20.16 | 26.43 | 31.00 |
| ResNeSt-269 | 16.39 | 42.62 | 25.17 | 15.81 |
| Res2NeXt-101 | 17.15 | 25.47 | 35.14 | 22.24 |
| U-Net | 32.29 | 13.65 | 34.60 | 19.46 |
Katika YOLO11 na YOLO12, sehemu ya mchango wa mwangaza ni takriban %56, huku mchango wa texture ukiwa chini ya %3. Watafiti wanahusisha mwonekano wa giza, wa intensity ya chini na unaotegemea texture wa madarasa ya rollingcube na sheetrobot na utendaji wa chini wa madarasa hayo katika modeli za YOLO.
Katika ResNeSt-269, mchango wa texture wa %42,62 ndio utegemezi wa juu zaidi wa texture katika utafiti. Watafiti wanawasilisha uwezo wa muundo wa split-attention kunasa mabadiliko madogo ya intensity kama maelezo yanayowezekana ya utendaji wake mkubwa, hasa katika jiometri ngumu za mikroroboti.
ConvNeXt inaonyesha wasifu wenye uwiano zaidi: kingo %22,42, texture %20,16, mwangaza %26,43 na kipengele cha spatial %31,00. Matokeo haya ndiyo msingi wa tafsiri ya watafiti kwamba ConvNeXt ni usanifu unaotoa vipengele vinavyoweza ku-generalize zaidi katika hali tofauti za picha.
Je, modeli sahihi zaidi ndiyo pia ya haraka zaidi?
Hapana. Hitimisho kuu la kihandisi la utafiti ni kwamba kuna trade-off wazi kati ya usahihi na gharama ya kihesabu. ResNeSt-269 ina thamani ya juu zaidi ya mAP(50–95), lakini pia ni mojawapo ya modeli kubwa na polepole zaidi. YOLO11, ingawa ina usahihi wa jumla wa chini zaidi, ilifikia thamani ya juu zaidi ya FPS.
| Modeli | Latency (ms/picha) | FPS | Parameters (milioni) | Faili ya modeli (MB) |
|---|---|---|---|---|
| YOLO11 | 6.1 | 163 | 2.58 | 5 |
| Res2NeXt-101 | 6.7 maandishi / 6.8 Kielelezo 10a | 148 | 61.04 | 233 |
| YOLO12 | 8.5 | 117 | 2.56 | 5 |
| ConvNeXt | 9.8 | 102 | 45.08 | 172 |
| U-Net | 14.4 | 69 | 31.04 | 118 |
| ResNeSt-269 | 14.5 | 68 | 126.76 | 485 |
ResNeSt-269 kuwa na takriban parameters milioni 126,76 na faili ya modeli ya 485 MB, ikilinganishwa na YOLO11 yenye parameters milioni 2,58 na ukubwa wa faili wa takriban 5 MB, kunaonyesha kwa nini kipimo cha usahihi pekee hakitoshi katika usanifu wa mfumo wa real-time au embedded.
Ni muhimu kukumbuka kwamba thamani za kasi hapa zilipatikana kwenye NVIDIA B200 GPU. Modeli hizo hizo si lazima zitoe matokeo yale yale ya latency na FPS kwenye GPU, CPU au processor ya embedded yenye uwezo mdogo zaidi.
Vielelezo vinaonyesha vipengele gani vya utafiti?
Kielelezo 1, kinaonyesha maeneo yanayowezekana ya matumizi ya mikroroboti, kama targeted drug delivery, local therapy, minimally invasive interventions, diagnostic imaging na intravascular navigation, kwa mchoro wa mtiririko wa kimawazo. Kielelezo hiki si ushahidi wa matokeo ya kliniki ndani ya utafiti, bali ni mchoro unaoeleza muktadha wa matumizi.
Kielelezo 2, kinaonyesha jinsi waandishi walivyolinganisha MRI, CT na ultrasound kwa ufuatiliaji wa mikroroboti. Ujumbe mkuu wa mchoro ni kwamba ultrasound ndiyo mbinu ya imaging iliyopendelewa na utafiti kwa sababu ya real-time imaging, kutotumia ionizing radiation na urahisi wa kubebeka.
Kielelezo 3, kinafupisha kwa nini modeli sita zilichaguliwa kwa kuzingatia familia ya usanifu, uwiano wa usahihi-ufanisi, umuhimu wa kliniki/kiufundi na sifa zinazokamilishana dhidi ya upotoshaji tofauti.
Kielelezo 4, kinaonyesha kwa mchoro miundombinu ya NVIDIA B200 Blackwell ambako majaribio yaliendeshwa, katika viwango vya HBM3e memory stacks, compute clusters, SM na Tensor Core.
Kielelezo 5, kinaonyesha sampuli za ultrasound zisizo na annotation na zilizo na label za aina nane za mikroroboti kando kwa kando. Taswira hii ni muhimu hasa kuelewa kwa nini tofauti za umbo, intensity na mipaka kati ya madarasa zinaweza kuathiri utendaji wa modeli.
Kielelezo 6, kinaonyesha mchakato wa benchmark kuanzia picha ya ultrasound ya 1920 × 1080, kupitia preprocessing, fixed random seed, mixed precision, modeli sita, five-fold cross-validation, kufundisha upya final model na matawi manne tofauti ya tathmini.
Kielelezo 7 na Kielelezo 8, vinaonyesha matokeo makuu ya namba ya stress tests za upotoshaji; Kielelezo 9 michango ya vipengele vya modeli; Kielelezo 10 kinaonyesha trade-off ya kihandisi kati ya latency, FPS, parameters na ukubwa wa faili.
Matokeo yanayoungwa mkono na utafiti
- Chini ya hali za benchmark za USMicroMagSet, ResNeSt-269 ilifikia thamani ya juu zaidi ya jumla ya mAP(50–95).
- ConvNeXt na Res2NeXt-101 zilitoa matokeo yaliyo karibu na ResNeSt-269 katika usahihi wa jumla wa utambuzi.
- YOLO11 ilionyesha latency ya chini zaidi na FPS ya juu zaidi.
- Mwitikio wa modeli kwa blur, mwangaza, occlusion na speckle noise ulitofautiana kwa kiasi kikubwa.
- Katika madarasa fulani ya mikroroboti, usanifu wa modeli na utegemezi wa vipengele vya kuona vinaweza kutumiwa kueleza tofauti za utendaji.
- Kuna trade-off wazi ya kihandisi kati ya usahihi wa utambuzi na ukubwa/kasi ya modeli.
Matokeo ambayo utafiti hauungi mkono au haujajaribu
- Utafiti huu hauonyeshi mafanikio ya kliniki kwa wagonjwa halisi.
- Haijaonyeshwa kwamba modeli zinaongoza kwa usalama urambazaji wa real-time wa mikroroboti ndani ya mwili wa binadamu.
- Thamani kubwa ya mAP si dhamana ya ufanisi wa matibabu, usalama wa mgonjwa au mafanikio ya uchunguzi.
- Haijaonyeshwa kwamba thamani za FPS kwenye B200 GPU zitabaki zilezile kwenye embedded hardware au hardware ya aina ya hospitali.
- Generalization kwenye vifaa vya ultrasound nje ya USMicroMagSet, anatomia za wagonjwa, mipangilio ya probe na hali tofauti za waendeshaji haijathibitishwa moja kwa moja.
- Utafiti hauthibitishi kwamba teknolojia ya mikroroboti iko tayari kwa matumizi ya kliniki.
Mbinu na Matokeo ya Utafiti
Miundombinu ya majaribio
Majaribio yalifanywa kwenye jukwaa la kibiashara la GPU cloud la RunPod.io. Miundombinu ya kihesabu ilitumia NVIDIA B200 GPU moja yenye usanifu wa Blackwell, 180 GB VRAM, 28 vCPU zinazotegemea AMD EPYC 9555 na 200 GB ya network storage. Mazingira ya programu yalitegemea maktaba za Ultralytics na Torchvision juu ya PyTorch.
| Kigezo | Thamani / Mpangilio | Lengo |
|---|---|---|
| Epoch | 30 | Muda sawa wa mafunzo kati ya miundo |
| Batch size | 16 | Frequency sawa ya gradient updates |
| Dataloader workers | 16 | Muundo sawa wa uhamishaji data |
| Resolution ya ingizo | 1080 × 1920; YOLO imgsz = 1920 | Scale thabiti ya picha |
| Optimization | AdamW | Tabia ya pamoja ya optimization |
| Learning rate | 0.0001 | Dynamics ya pamoja ya kujifunza |
| Mixed precision | AMP imewashwa | FP16/Tensor Core acceleration |
| Model compilation | torch.compile / compile = True | Optimization ya pamoja ya kihesabu |
Five-fold cross-validation
Data ya mafunzo iligawanywa kwa nasibu kuwa %80 mafunzo na %20 validation kwa kila fold. Random seed ilikuwa 42. Wakati wa five-fold cross-validation, patience = 5 ilitumika, na weights bora pamoja na logs zilihifadhiwa kwa kila fold.
Baada ya fold tano kukamilika, final model ilifundishwa upya kwa kutumia data yote ya mafunzo na validation. Katika hatua hii validation na early stopping vilizimwa, na patience = 0 ikawekwa. Folda huru ya test ilitumika katika tathmini ya mwisho.
Jaribio la upotoshaji: Gaussian blur
Kwa blur, kernel ya Gaussian ya 21 × 21 na k = 10 zilitumika; imeripotiwa kwamba OpenCV ilikokotoa σ ≈ 3,5. Watafiti walitumia mchakato huu kuiga hali kama mwendo wa mikroroboti, mwendo wa kifiziolojia au acoustic window dhaifu.
\[ I_b(x,y,c)=(I \ast G_{\sigma})(x,y,c) \]
Hapa \(I\) inawakilisha picha asili, \(G_{\sigma}\) kernel ya Gaussian, \(\ast\) two-dimensional convolution, \(x\) na \(y\) coordinate za pikseli, na \(c\) channel ya rangi.
Jaribio la upotoshaji: mwangaza na contrast
Kwa test ya mwangaza/contrast, α = 1,8 na β = −40 zilitumika. Katika chanzo, α imefafanuliwa kama control ya contrast na β kama control ya mwangaza.
\[ I_{bc}(x,y,c)=clip(\alpha I(x,y,c)+\beta) \]
Transformation hii ilitumika kuiga mabadiliko ya picha yanayotokana na mipangilio ya kifaa cha ultrasound/operator, time gain compensation na signal attenuation.
Jaribio la upotoshaji: occlusion
Visanduku vitano vyeusi viliongezwa kwenye kila picha. Urefu na upana wa kila kisanduku uliwekwa kuwa %15 ya ukubwa wa picha asili.
Katika chanzo, eneo lililofunikwa linaelezwa kwenye maandishi kama O huku katika sharti la mlinganyo herufi 0 imechapishwa. Kutolingana huku kwa notation ndani ya chanzo hakujasahihishwa kimya kimya:
\[ I_{oc}(x,y,c)= \begin{cases} 0, & (x,y)\in 0 \\ (x,y,c), & otherwise \end{cases} \]
Kulingana na maelezo yaliyo mara moja kabla ya mlinganyo, lengo ni kuweka pikseli za eneo lililofunikwa kuwa sifuri na kuacha sehemu iliyobaki ya picha bila kubadilishwa; hata hivyo, uandishi wa O/0 katika formula ya chanzo unapaswa kurekodiwa kama ulivyo kwa uaminifu wa bibliografia.
Jaribio la upotoshaji: speckle noise
Kwa speckle noise, variance za \(\sigma_s^2 = 0.02,\ 0.04,\ 0.06,\ 0.08,\ 0.1\) zilitumika. Multiplicative noise iliyotengenezwa kutoka kwenye normal distribution ilitumika kwa kila pikseli.
\[ n(x,y,c)\sim N(0,\sigma_s^2) \]
\[ I_{sp}(x,y,c)=clip(I(x,y,c)[1+n(x,y,c)]) \]
Kielelezo 8 cha utafiti kinaonyesha kwamba ustahimilivu wa modeli dhidi ya speckle noise unaweza kuwa na mpangilio tofauti na aina nyingine za upotoshaji. Hasa, YOLO11 na YOLO12 zilionyesha upotevu mdogo wa AP katika test hii ya noise licha ya kuwa na thamani za msingi za mAP(50–95) zilizo chini.
Hesabu ya mchango wa vipengele
Watafiti walikokotoa mchango wa uwiano kwa kuoanisha kushuka kwa mAP kunakosababishwa na upotoshaji na vipengele vya kuona vya dhahania kama kingo, texture, mwangaza na taarifa za spatial:
\[ W_f = 100 \cdot \frac{\max(0,d_f)} {\sum_{f'}\max(0,d_{f'})} \]
Hapa \(d_f\) inawakilisha upotevu wa mAP unaoonekana chini ya upotoshaji fulani; \(W_f\) inawakilisha mchango wa uwiano wa kipengele uliotokana na upotevu huo. Uchambuzi huu si kipimo cha moja kwa moja cha feature activation katika kiwango cha pikseli, bali ni uchambuzi wa sensitivity katika kiwango cha modeli uliotokana na mabadiliko ya utendaji dhidi ya upotoshaji.
Confidence intervals za cross-validation
| Modeli | Kikomo cha chini cha %95 CI | Kikomo cha juu cha %95 CI |
|---|---|---|
| YOLO12 | 0.5591 | 0.6126 |
| YOLO11 | 0.3186 | 0.7536 |
| ConvNeXt | 0.7955 | 0.8484 |
| ResNeSt-269 | 0.8219 | 0.8515 |
| Res2NeXt-101 | 0.8211 | 0.8563 |
| U-Net | 0.732 | 0.8141 |
Watafiti wanasisitiza kwamba confidence intervals hizi zinawakilisha variability katika mchakato wa mafunzo/validation wa five-fold, si uncertainty katika final test set. Kwa kuwa final model ilifundishwa upya kwenye data yote ya mafunzo, matokeo ya test katika baadhi ya hali yanaweza kuwa nje ya confidence interval ya cross-validation.
Vikwazo vikuu
- Ingawa Dataset ni kubwa, utofauti wake ni mdogo.
- Usambazaji wa madarasa hauna uwiano.
- Anatomia halisi ya mgonjwa, mipangilio ya probe na mapendeleo ya operator yanaweza kutofautiana kutoka kesi moja hadi nyingine.
- Aina na viwango vya upotoshaji vilivyojaribiwa havijumuishi uwezekano wote wa ulimwengu halisi.
- Mahesabu yalifanywa kwenye miundombinu yenye nguvu ya NVIDIA B200.
- Utendaji uleule wa real-time haujaonyeshwa kwenye hardware yenye rasilimali chache au embedded.
- Utafiti si uthibitishaji wa matumizi ya kliniki au matumizi ya mikroroboti kwa binadamu.
Maelezo ya Chanzo na Mbinu
Jina kamili la utafiti asili: Benchmarking Robust AI for Microrobot Detection with Ultrasound Imaging
Waandishi: Ahmed Almaghthawi, Changyan He, Suhuai Luo, Furqan Alam, Majid Roshanfar, Lingbo Cheng.
Mpangilio wa waandishi: Mpangilio uliotolewa kwenye chanzo umehifadhiwa kama ulivyo.
Mchango sawa / mwandishi wa kwanza sawa: Chanzo hakijataja tamko la mwandishi wa kwanza sawa au mchango sawa.
Waandishi wa mawasiliano: Ahmed Almaghthawi na Changyan He.
Taasisi:
- School of Information and Physical Sciences, University of Newcastle, Newcastle, Australia.
- School of Engineering, University of Newcastle, Newcastle, Australia.
- Department of Computer Science, College of Science & Art at Mahayil, King Khalid University, Abha, Saudi Arabia.
- Faculty of Computing and Information Technology (FoCIT), Sohar University, Sohar, Oman.
- PCIGITI Center, SickKids Hospital, Toronto, Canada.
Aina ya chanzo: Makala ya utafiti iliyopitia peer review; benchmark na uchambuzi wa data wa utambuzi wa mikroroboti unaotegemea akili bandia.
Jarida: Actuators.
Mchapishaji: MDPI.
Taarifa ya bibliografia: Actuators 2026, 15(1), 16.
Namba ya makala: 16.
DOI: 10.3390/act15010016.
Kiungo rasmi cha chapisho:https://doi.org/10.3390/act15010016
Iliwasilishwa: 6 Oktoba 2025.
Marekebisho: 5 Desemba 2025.
Ilikubaliwa: 11 Desemba 2025.
Ilichapishwa mtandaoni: 29 Desemba 2025.
Leseni: Creative Commons Attribution (CC BY).
Ufadhili: Watafiti waliripoti kwamba utafiti haukupokea ufadhili wa nje.
Upatikanaji wa data: Imeelezwa kwamba Dataset ya USMicroMagSet iliyotumiwa katika utafiti inapatikana kwa umma kupitia IEEE DataPort na kwamba chanzo cha utafiti kimetoa rejea yake.
Mgongano wa maslahi: Waandishi waliripoti kwamba hakuna mgongano wa maslahi.
Maadili ya taasisi na ridhaa iliyoarifiwa: Katika chanzo imeandikwa “not applicable”.
Michango ya waandishi: Conceptualization A.A., C.H., F.A. na S.L.; methodology A.A.; software A.A.; validation C.H., S.L. na F.A.; formal analysis na investigation A.A.; resources A.A.; rasimu ya kwanza A.A.; review na editing C.H., F.A., L.C., M.R. na S.L.; visualization A.A., M.R. na L.C.; supervision C.H., S.L. na F.A.; project management C.H. na S.L.; funding acquisition S.L., C.H. na L.C., kama ilivyoripotiwa.
Kikomo cha maudhui ya kisayansi: Mbinu ya kisayansi, data, formula, matokeo ya namba na tafsiri katika makala hii ya Verianla vinategemea tu utafiti wa chanzo uliopitiwa. Hakuna ugunduzi mpya wa kisayansi kutoka vyanzo vya nje ulioongezwa katika maeneo yaliyo nje ya utambulisho wa bibliografia.
Kutolingana muhimu ndani ya chanzo
- Mahali fulani katika maandishi, Jedwali 1 linaelezwa kuwa linaonyesha usambazaji wa madarasa, lakini Jedwali 1 halisi linaonyesha mipangilio ya mafunzo; usambazaji wa madarasa uko katika Jedwali 2.
- Katika sehemu nyingine, Jedwali 2 linaelezwa kuwa ulinganisho wa detectors, ilhali ulinganisho halisi wa detectors uko katika Jedwali 3.
- Ingawa maandishi yanayoeleza kushindwa kwa YOLO katika darasa la rollingcube yanarejelea Jedwali 4, matokeo ya kina ya madarasa yako katika Jedwali 5.
- Muhtasari na hitimisho vinatoa mpangilio wa Res2NeXt-101 na ConvNeXt baada ya ResNeSt-269, ilhali katika Jedwali 4 thamani ya mAP(50–95) ya ConvNeXt ni 0.866752148 na ya Res2NeXt-101 ni 0.866416454.
- Maandishi katika sehemu ya speckle yanatoa upotevu wa AP wa ConvNeXt kuwa %5,3–11,2, ilhali thamani zinazoonekana katika Kielelezo 8 ni %5,3, %8,9, %11,9, %14,0 na %16,2.
- Baada ya kueleza kwamba ResNeSt-269 na U-Net zilipata upotevu wa AP wa zaidi ya %50 katika speckle noise, matumizi ya kauli “strong noise tolerance” katika chanzo yanapingana na matokeo ya namba.
- Latency ya Res2NeXt-101 imeonyeshwa kuwa 6,7 ms katika maandishi na 6,8 ms katika Kielelezo 10a.
- Mara moja kabla ya mlinganyo wa occlusion, eneo lililofunikwa limefafanuliwa kama O, lakini katika mlinganyo alama ya sharti imechapishwa kama 0.
Tofauti hizi hazijabadilishwa kimya kimya kuwa thamani moja “sahihi” katika maandishi ya Verianla; inapowezekana, data inayoonekana moja kwa moja katika jedwali au kielelezo imeelezwa kando na kutolingana ndani ya chanzo kumehifadhiwa wazi.
Matokeo ya utafiti yanahusu utendaji wa kulinganisha wa modeli za utambuzi wa mikroroboti katika picha za ultrasound. Utafiti hauonyeshi matumizi salama ya modeli yoyote kwa wagonjwa halisi, mafanikio ya matibabu ya kliniki, au utendaji wa uwanjani uliothibitishwa wa mfumo huru wa mikroroboti ndani ya mwili wa binadamu.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *