

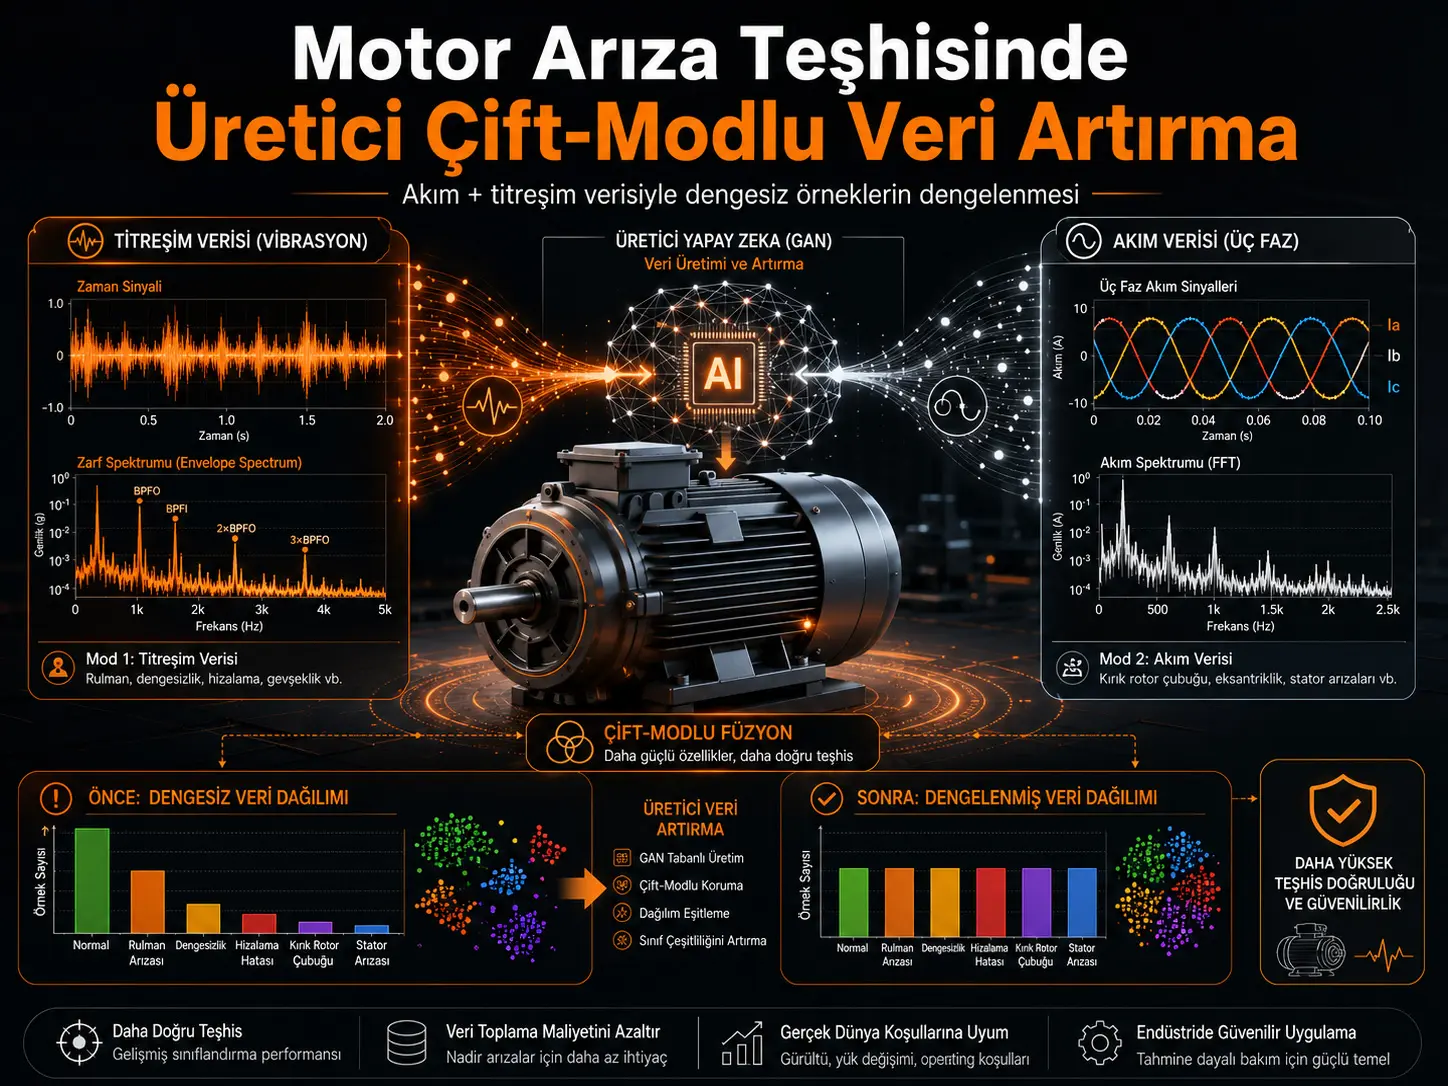
Utafiti huu unalenga tatizo la kutolingana kwa madarasa linalotokea kwa sababu data za hitilafu katika mota za umeme huwa chache sana ikilinganishwa na data za uendeshaji wenye afya. Watafiti wanatengeneza mbinu inayoitwa SWGAN, inayotumia pamoja mkondo wa stator wa awamu tatu na vipimo vya mtetemo na kuzalisha sampuli bandia za kispektramu kwa madarasa ya hitilafu yenye uwakilishi mdogo. SWGAN inaunganisha muundo wa conditional Wasserstein GAN na self-attention ili kunasa uhusiano kati ya vipengele vya masafa vilivyo mbali katika spektramu, pamoja na gradient normalization ili kuongeza uthabiti wa mafunzo ya adversarial.
Mbinu haifanyi uainishaji wa moja kwa moja wa ishara ghafi. Katika njia ya mtetemo, spektramu ya envelope hutolewa kupitia Hilbert transform; katika mkondo wa awamu tatu, spektramu ya ukubwa wa space-vector hutolewa baada ya Clarke transform. SWGAN huongeza sampuli bandia katika nafasi hii ya kispektramu kwa madarasa ya hitilafu yenye sampuli chache. Vipengele halisi na vilivyozalishwa vya mkondo/mtetemo baadaye huchakatwa katika matawi mawili tofauti ya usimbaji, huunganishwa katika kiwango cha vipengele na kupelekwa kwenye kiainishaji kinachotegemea SAE.
Kulingana na matokeo ya kina ya utafiti, katika Dataset ya PMSM ya kasi isiyobadilika yenye kutolingana kwa madarasa kwa kiwango cha kati, SWGAN ilifikia usahihi wa %97,81 ± 0,53 katika Case A. Katika hali ngumu zaidi ya Case B, usahihi ulipungua hadi %93,77 ± 1,12 lakini uliendelea kuwa juu kuliko WCGAN, ACGAN, DCGAN na msingi wa SAE bila kuongeza data. Katika Dataset ya mota ya induction yenye kasi inayobadilika pia, faida ya SWGAN ilionekana wazi zaidi kadiri kutolingana kwa madarasa kulivyopungua; kwenye Kielelezo 24, usahihi wa %81,3, %91,7 na %95,9 uliripotiwa kwa hali za 1:10, 1:5 na 1:2 mtawalia.
Matokeo hayamaanishi kwamba data bandia ni sawa na data halisi katika kila hali. Katika hali kali zaidi za upungufu wa data, tofauti ya utendaji kati ya mbinu za GAN hupungua; yaani, ikiwa kuna sampuli chache tu za hitilafu halisi, taarifa ambayo modeli generative inaweza kujifunza nayo pia hubaki kuwa ndogo. Utafiti pia unatathmini ukaribu wa sampuli bandia na usambazaji halisi kwa kutumia JS divergence, cosine distance, t-SNE na UMAP, lakini hauzalishi tena wala kupima ishara hizo zilizotengenezwa kwenye mota halisi.
Kwa mtazamo wa Türkiye, mbinu hii inaweza kuchunguzwa katika tafiti zinazokabiliwa na uhaba wa data wa madarasa adimu ya hitilafu katika mota za viwandani, mashine za uzalishaji au mifumo ya matengenezo. Hata hivyo, utafiti haukufanywa katika kiwanda, kundi la mota au miundombinu ya matengenezo nchini Türkiye. Kwa matumizi ya ndani, mafunzo upya na uthibitishaji huru vinahitajika kwa kutumia aina halisi za mota, nafasi za sensa, wasifu wa mzigo/kasi na usambazaji wa hitilafu; viwango vya usahihi vya utafiti haviwezi kuchukuliwa moja kwa moja kuwa utendaji wa eneo husika.
Kwa nini kutolingana kwa madarasa ni tatizo katika utambuzi wa hitilafu za mota?
Mota inaweza kufanya kazi kwa muda mrefu katika hali ya kawaida ilhali baadhi ya hitilafu hutokea mara chache. Kwa hiyo, katika hifadhidata kunaweza kuwa na sampuli nyingi za uendeshaji wenye afya, huku sampuli za aina fulani za hitilafu au hitilafu za kiwango cha chini zikiwa chache.
Kiainishaji cha deep learning kinapofundishwa kwa usambazaji huu usio na uwiano, kinaweza kujifunza vipengele vya darasa lenye idadi kubwa vizuri zaidi lakini kisijifunze vya kutosha mipaka ya maamuzi ya madarasa adimu ya hitilafu. Njia ya suluhisho ya utafiti ni kujifunza usambazaji wa data halisi ya darasa lenye uwakilishi mdogo na kuzalisha sampuli mpya bandia badala ya kuinakili tu.
Kwa nini sensa mbili tofauti zinatumika?
Utafiti unatokana na dhana kwamba taarifa za hitilafu za kielektriki na kimakanika zinaweza kukamilishana. Mkondo wa stator huakisi matatizo ya kielektromagnetiki, wakati ishara za mtetemo hubeba mwitikio wa kimakanika na mabadiliko katika muundo.
Kwa hiyo, mbinu hutumia pamoja vipengele vya kispektramu vya mkondo na mtetemo badala ya kutengeneza sampuli kutoka sensa moja pekee. Hata hivyo, chanzo hakijaonyesha kwamba hatua ya generative imefundishwa kwa hasara maalumu ya consistency ya pamoja kati ya modaliti hizi mbili; modaliti zilizozalishwa huunganishwa baadaye katika kiwango cha vipengele.
Ishara ya mtetemo inaandaliwaje?
Ishara ya mtetemo kwanza hupitishwa kwenye kichujio cha band-pass karibu na eneo lililochaguliwa la resonance:
\[ x_f(t)=B\{x(t)\} \]
Kisha ishara analytic hutengenezwa kwa Hilbert transform:
\[ z(t)=x_f(t)+jH[x_f(t)] \]
Amplitude ya envelope:
\[ a(t)= \sqrt{x_f^2(t)+H[x_f(t)]^2} \]
huhesabiwa. Thamani kamili ya Fourier transform yake hutoa spektramu ya envelope ya mtetemo:
\[ E(f)=|\mathcal{F}\{a(t)\}| \]
Utaratibu huu hutumiwa kusisitiza vipengele vya modulation vinavyotokana na mapigo ya kimakanika.
Ni kipengele gani kinachotolewa kutoka mkondo wa awamu tatu?
Mikondo ya awamu tatu inayolingana na awamu U, V na W hubadilishwa kwenda kwenye mfumo wa kuratibu αβ usiobadilika kwa Clarke transform:
\[ \begin{bmatrix} i_\alpha(t) \\ i_\beta(t) \end{bmatrix} = \frac{2}{3} \begin{bmatrix} 1 & -1/2 & -1/2 \\ 0 & \sqrt{3}/2 & -\sqrt{3}/2 \end{bmatrix} \begin{bmatrix} i_a(t)\\ i_b(t)\\ i_c(t) \end{bmatrix} \]
Ukubwa wa space-vector:
\[ i_s(t)= \sqrt{i_\alpha^2(t)+i_\beta^2(t)} \]
hupatikana na kisha:
\[ S(f)=|\mathcal{F}\{i_s(t)\}| \]
hutumika kuunda spektramu ya mkondo. Urefu wa mwisho wa kispektramu unaotumika kwa modaliti zote mbili ni pointi 2400.
SWGAN inabadilisha nini?
Modeli msingi ni conditional Wasserstein GAN. Kelele nasibu na lebo ya darasa la hitilafu hupewa generator kwa lengo la kuzalisha spektramu ya darasa mahususi la hitilafu.
SWGAN ina vipengele viwili vikuu vya ziada:
- Self-attention: Inalenga kuanzisha uhusiano kati ya vipengele vilivyo mbali katika mfuatano wa spektramu lakini ambavyo vinaweza kuwa sehemu ya alama ileile ya hitilafu.
- Gradient normalization: Inalenga kufanya mafunzo ya adversarial yawe thabiti zaidi kwa ku-normalize kiwango cha gradient wakati wa mafunzo ya Discriminator.
Katika chanzo, GN imefafanuliwa kama mbinu ya kuongeza/kupunguza gradient inayotekelezwa katika kiwango cha mafunzo, si kama utaratibu wa spectral normalization unaoweka mipaka kwa uzito wa kila layer. Inadaiwa kuwa, tofauti na gradient penalty, haihitaji sampuli za ziada za interpolation wala coefficient ya penalty inayohitaji kurekebishwa.
Self-attention inafanyaje kazi ndani ya spektramu?
Vipengele vya ingizo hugawanywa katika uwakilishi unaofanana na query, key na value kupitia mabadiliko matatu tofauti. Uhusiano ghafi wa attention kati ya vipengele viwili huundwa kwa:
\[ a_{i,j}=f(x_i)^Tg(x_j) \]
na hubadilishwa kuwa uzito kwa softmax. Vipengele vilivyopimwa uzito baadaye huongezwa kwenye ramani asili ya vipengele kupitia coefficient ya \(\gamma\) inayoweza kujifunzwa:
\[ y_i=\gamma o_i+x_i \]
Kwa njia hii, uwezo wa CNN wa kunasa mifumo ya eneo la karibu na uwezo wa self-attention wa kupima uhusiano wa kispektramu wa masafa marefu huunganishwa ndani ya generator moja.
Data iliyozalishwa inapitishwaje hadi utambuzi?
Spektramu ya mtetemo na ya mkondo kila moja husimbwa kuwa uwakilishi wa kipengele wa vipimo 512. Uwakilishi huo miwili huunganishwa kutengeneza ingizo la vipimo 1024, ambalo hupitishwa kwenye layer ya fusion ya vipimo 512. Kisha, kupitia hidden layers za vipimo 256 na 128 pamoja na SoftMax output, darasa la hitilafu huamuliwa.
Verianla Live: Mnyororo wa utambuzi wa hitilafu za mota kwa SWGAN
Mtiririko huu unatafsiri kwa Kiswahili mpangilio wa hatua uliotolewa katika mbinu ya utafiti na Kielelezo 4. Hakuna hatua ambayo haipo kwenye chanzo iliyoongezwa.
| Hatua | Mchakato | Msingi wa chanzo |
|---|---|---|
| 1. Kipimo kilichosawazishwa kwa wakati | Kuongeza kasi kwa mtetemo wa mota na mikondo ya stator ya awamu tatu hukusanywa. | Sehemu 3.3 |
| 2. Gawa ishara | Vipimo endelevu hugawanywa katika madirisha ya sampuli yanayosogea au yaliyofafanuliwa. | Sehemu 3.3 na 4 |
| 3. Kipengele cha mtetemo | Spektramu ya envelope ya mtetemo hutengenezwa kwa Hilbert envelope na Fourier transform. | Mlinganyo 19–22 |
| 4. Kipengele cha mkondo | Spektramu ya mkondo hutengenezwa kwa Clarke transform, ukubwa wa space-vector na Fourier transform. | Mlinganyo 23–25 |
| 5. Normalization | Vipengele vya kispektramu hu-normalize katika kiwango cha [-1,1]. | Sehemu 3.3 |
| 6. Mafunzo ya SWGAN | Conditional Wasserstein GAN yenye self-attention na gradient normalization hujifunza madarasa yenye uwakilishi mdogo. | Sehemu 3.1–3.3 |
| 7. Uzalishaji wa data bandia | Spektramu za mkondo na mtetemo zinazowekewa sharti la lebo huzalishwa kwa madarasa ya hitilafu yenye uwakilishi mdogo. | Kielelezo 4 |
| 8. Kuunganisha data | Sampuli halisi na bandia hubadilishwa kuwa seti ya mafunzo yenye uwiano wa karibu. | Sehemu 3.3 |
| 9. Fusion ya vipengele vya modaliti nyingi | Baada ya vipengele vya mkondo na mtetemo kusimbwa tofauti, huunganishwa katika kiwango cha vipengele. | Jedwali 1 |
| 10. Uainishaji wa hitilafu | Kiainishaji kinachotegemea SAE huamua hali ya mwisho ya mota. | Sehemu 3.2 |
Verianla Live: Chanzo cha kisayansi cha taswira ni jedwali hili linaloonekana; mnyororo wa mbinu unabaki kusomeka hata JavaScript ikiwa imezimwa.
Matokeo yanayoungwa mkono na utafiti
- SWGAN ilitoa usahihi wa juu wa utambuzi kuliko mbinu nyingi za GAN zilizolinganishwa wakati data za mafunzo zisizo na uwiano zilipoimarishwa kwa spektramu bandia katika Dataset mbili tofauti za mota.
- Sampuli zilizozalishwa na SWGAN zilionyesha usambazaji ulio karibu zaidi na data halisi kuliko DCGAN, ACGAN na WCGAN kulingana na vipimo vya JS divergence na cosine distance vilivyotumiwa katika utafiti.
- Matumizi ya pamoja ya self-attention na gradient normalization yaliongeza utendaji katika majaribio ya ablation, hasa wakati idadi ya kutosha ya sampuli za mwanzo ilipatikana.
- Iliripotiwa kuwa modeli inayotumia gradient normalization ilifikia usawa wa dynamic mapema zaidi kwenye loss curves zilizoonyeshwa na chanzo kuliko kulinganisha kunakotumia GP.
- Matumizi ya pamoja ya taarifa za mkondo na mtetemo yalitoa faida katika baadhi ya hali za kutolingana ikilinganishwa na njia za modaliti moja.
- Mbinu iliweza kutumiwa pia kwenye Dataset ya mota ya induction yenye kasi inayobadilika, pamoja na data za PMSM za kasi isiyobadilika.
Matokeo ambayo utafiti hauungi mkono
- Haijathibitishwa kwamba spektramu bandia zinawakilisha kwa usahihi kila undani ambao mota halisi inaweza kuzalisha kimwili.
- Haijaonyeshwa kwamba SWGAN inafanya kazi mtandaoni kwa wakati halisi kwenye mota ya viwandani halisi.
- Haijaonyeshwa kwamba mbinu itatoa usahihi uleule kwa kila aina ya mota, mfumo wa sensa au familia ya hitilafu.
- Katika uhaba mkali zaidi wa data, ubora wa wazi wa modeli generative haujaonyeshwa; ikiwa kuna sampuli chache tu za hitilafu halisi, mbinu za GAN hutoa matokeo yanayokaribiana.
- Hakuna loss maalumu ya pamoja ya generative au kipimo cha cross-modal consistency kinacholazimisha ulinganifu wa kimwili kati ya modaliti mbili bandia kilichoonyeshwa wazi.
- Viwango vya usahihi katika makala havimaanishi moja kwa moja kupungua kwa gharama ya predictive maintenance, kupungua kwa downtime isiyopangwa au kuongezeka kwa reliability ya viwandani.
Hii ina maana gani kwa matumizi nchini Türkiye?
Kwa biashara nchini Türkiye, eneo kuu linalowezekana la matumizi ya mbinu ni mifumo ya ufuatiliaji wa mota ambayo ina rekodi nyingi za uendeshaji wa kawaida lakini aina fulani za hitilafu huonekana mara chache. Hata hivyo, mota, mpangilio wa sampling ya sensa na usambazaji wa hitilafu katika utafiti haviwakilishi moja kwa moja kituo cha ndani. Kabla ya matumizi, rekodi halisi za hali nzuri na zenye hitilafu kutoka familia husika ya mota zinapaswa kukusanywa, SWGAN ifundishwe upya kwa usambazaji huo, na aina za makosa katika seti huru ya test zipimwe kando kabla na baada ya kuongeza data bandia.
Mbinu na Matokeo ya Utafiti
Muundo wa mtandao wa SWGAN
| Kipengele | Muundo uliotolewa kwenye chanzo |
|---|---|
| Ingizo la Generator | Kelele ya vipimo 2400 + label ya vipimo 8; jumla 2408 |
| Generator Conv 1 | 1 → 64, kernel 3, stride 1, LeakyReLU |
| Generator Conv 2 | 64 → 128, kernel 3, stride 1, LeakyReLU |
| Generator Deconv 1 | 128 → 64, kernel 3, stride 2, LeakyReLU |
| Generator Deconv 2 | 64 → 1, kernel 3, stride 2, LeakyReLU |
| Output ya Generator | Sampuli ya kispektramu ya vipimo 2400 |
| Discriminator | 2408 → 512 → 128 → 32 → 1 |
| Kisimbaji cha mtetemo | 2400 → 512 |
| Kisimbaji cha mkondo | 2400 → 512 |
| Fusion | 1024 → 512 → 256 → 128 → idadi ya madarasa |
Ingawa chanzo kinataja ukubwa wa label kuwa nane, majaribio makuu yanatumia madarasa kumi. Kwa kuwa haijaelezwa jinsi uwakilishi wenye masharti wa vipimo nane unavyolinganishwa na madarasa kumi, undani huu wa usanifu unabaki kuwa na utata kwa upande wa reproducibility.
Usanidi wa mafunzo
| Kigezo | Thamani |
|---|---|
| Lugha ya programu | Python 3.10 |
| Framework | PyTorch 2.11 |
| Optimizer | Adam |
| Learning rate | 1 × 10⁻⁴ |
| Batch size | 100 |
| Epoch | 200 |
| Majaribio yanayorudiwa | 20 |
| CPU | Intel i7-14700KF |
| RAM | 64 GB |
| GPU | NVIDIA 5060Ti, 16 GB |
Thamani hizi zimetolewa kama zilivyoripotiwa kwenye chanzo; matoleo ya programu na vifaa hayajasahihishwa kwa kutumia taarifa za nje.
Dataset A: hitilafu za stator za PMSM yenye kasi isiyobadilika
Dataset ya kwanza ina rekodi za mkondo na mtetemo zilizopatikana kutoka kwa mota tatu za synchronous permanent magnet za awamu tatu. Chanzo cha data kina mota tatu zenye nguvu za 1,0 kW, 1,5 kW na 3,0 kW. Vipimo vilifanywa kwa kasi isiyobadilika ya 3000 rpm. Mtetemo ulisampuliwa kwa 25,6 kHz katika mwelekeo wa axial kwa accelerometer iliyowekwa kwenye bearing ya mota; mikondo ya awamu U, V na W ilisampuliwa kwa 100 kHz kwa current probes.
Hitilafu za short circuit za stator ziliundwa kwa njia ya bandia kwenye awamu U. Short circuit kati ya turns za coil ileile ilimodeliwa kama inter-turn, huku short circuit kati ya coils zilizo jirani ikimodeliwa kama inter-coil. Kadiri bypass resistance inavyopungua, ukali wa short circuit huongezeka:
\[ FaultRatio= \left( \frac{R}{R+R_{\mathrm{bypass}}} \right)\times100 \]
Je, sampuli halisi na bandia zinafanana?
Utafiti hauangalii tu usahihi wa uainishaji. Unatathmini kufanana kwa spektramu halisi na zilizozalishwa kwa kutumia Jensen–Shannon divergence na cosine distance. Kwa vipimo vyote viwili, thamani ya chini humaanisha kufanana zaidi.
Katika violin plots za marudio 20 za sampuli za IT1, IT3 na IC3, usambazaji wa SWGAN umeonyeshwa kujikusanya katika maeneo yenye JS divergence na cosine distance za chini kuliko modeli za DCGAN, ACGAN na WCGAN zilizolinganishwa. Hata hivyo, kwa kuwa chanzo hakijatoa jedwali la namba kamili za wastani kwa grafu hizi, hakuna namba mpya za kukadiria kwa macho zilizoundwa.
Matokeo ya kutolingana kwa madarasa ya PMSM
Katika Case A na Case B zinazoshughulikia kutolingana kwa madarasa halisi, darasa lenye afya lilihifadhiwa na sampuli 200 za mafunzo huku madarasa ya hitilafu yakipunguzwa hadi viwango tofauti. SWGAN na mbinu nyingine za GAN zilitumiwa kuongeza madarasa yenye uwakilishi mdogo hadi uwiano wa mafunzo wa 1:1.
| Mbinu | Usahihi wa Case A (%) | Usahihi wa Case B (%) |
|---|---|---|
| SAE — bila kuongeza data | 65,50 ± 2,20 | 58,78 ± 6,47 |
| DCGAN | 82,32 ± 2,13 | 78,67 ± 3,02 |
| ACGAN | 87,39 ± 1,69 | 81,17 ± 2,05 |
| WCGAN | 94,05 ± 1,24 | 88,76 ± 1,78 |
| SWGAN | 97,81 ± 0,53 | 93,77 ± 1,12 |
Verianla Live: Usahihi wa utambuzi wa PMSM chini ya kutolingana kwa madarasa
Case A ni hali ya kutolingana kwa madarasa kwa kiwango cha kati, na Case B ni hali kali zaidi. Thamani zimetolewa kutoka wastani wa runs 20 huru katika sehemu ya matokeo ya utafiti.
| Mbinu | Case A (%) | Case B (%) | Chanzo |
|---|---|---|---|
| SAE | 65,50 | 58,78 | Sehemu 4.1.4, Kielelezo 12 |
| DCGAN | 82,32 | 78,67 | Sehemu 4.1.4, Kielelezo 12 |
| ACGAN | 87,39 | 81,17 | Sehemu 4.1.4, Kielelezo 12 |
| WCGAN | 94,05 | 88,76 | Sehemu 4.1.4, Kielelezo 12 |
| SWGAN | 97,81 | 93,77 | Sehemu 4.1.4, Kielelezo 12 |
Verianla Live: Jedwali linaloonekana ndilo scientific source-of-truth. Thamani za error zimehifadhiwa katika jedwali kuu tuli; ulinganisho wa Live hutumia wastani wa usahihi.
Katika Case B, mafanikio ya mbinu zote yalipungua. Jambo hili ni muhimu hasa: generative data augmentation haibadilishi kabisa taarifa halisi za hitilafu. Data ya awali ya darasa lenye uwakilishi mdogo ilipopunguzwa zaidi, SWGAN yenyewe pia ilipoteza utendaji.
Dataset B: mota ya induction yenye kasi inayobadilika
Katika Dataset ya pili, kifaa cha majaribio kilijumuisha mota ya induction ya awamu tatu ya 2,2 kW, torque sensor, gearbox sambamba ya hatua mbili na magnetic powder brake. Mtetemo wa axes tatu, mkondo wa awamu tatu, torque na key-phase signals zilikusanywa kwa usawazishaji wa wakati kwa 12,8 kHz.
Utafiti ulichagua hali ya uendeshaji yenye kasi inayobadilika ya 0–1000 rpm chini ya mzigo wa kudumu wa 20 Nm.
| Hitilafu | Kiwango / mpangilio wa kimwili |
|---|---|
| Afya — NC | Hakuna hitilafu |
| Inter-turn IC1 | %5 rated-current shunt |
| Inter-turn IC2 | %10 rated-current shunt |
| Kupinda kwa rotor — RB | Kupinda kwa kudumu kwa 0,2 mm |
| Kutolingana kwa voltage — VU1 | %4 |
| Kutolingana kwa voltage — VU2 | %8 |
| Static eccentricity — SE1 | 0,125 mm radial offset |
| Static eccentricity — SE2 | 0,250 mm radial offset |
| Rotor imbalance — RU | Masi ya ziada ya imbalance |
| Broken rotor bars — RR | Bars 3 mfululizo zimeondolewa, counterweight imeongezwa |
Nini kilitokea data ilipopunguzwa chini ya kasi inayobadilika?
Darasa lenye afya lilihifadhiwa na sampuli 200 za mafunzo, huku madarasa tisa ya hitilafu yakijaribiwa katika viwango vya sampuli 4, 10, 20, 40, 100 na 200. Katika kila darasa, test set ilihifadhiwa kama sampuli 200 halisi.
| Mbinu | 1:50 | 1:20 | 1:10 | 1:5 | 1:2 | 1:1 |
|---|---|---|---|---|---|---|
| SAE | 47,8 | 51,2 | 61,5 | 69,5 | 83,7 | 98,1 |
| DCGAN | 48,6 | 54,9 | 72,3 | 83,9 | 85,4 | 92,7 |
| ACGAN | 49,1 | 58,8 | 78,2 | 85,5 | 91,9 | 94,1 |
| WCGAN | 50,1 | 57,2 | 77,5 | 88,6 | 93,1 | 95,2 |
| SWGAN | 49,9 | 58,2 | 81,3 | 91,7 | 95,9 | 97,9 |
Kuna undani muhimu katika matokeo haya. Katika hali kali zaidi ya 1:50, SWGAN yenye %49,9 si bora kuliko mbinu zote; WCGAN ilitoa %50,1. Katika 1:20 pia ACGAN yenye %58,8 iko juu kidogo ya %58,2 ya SWGAN. Faida dhahiri ya SWGAN inaonekana hasa katika 1:10, 1:5 na 1:2.
Katika hali ya 1:1, SAE bila kuongeza data ina %98,1 na SWGAN ina %97,9. Kwa hiyo, grafu hii haiungi mkono hitimisho kwamba kutumia data bandia kunazidi data halisi wakati data halisi ya kutosha inapatikana.
Jaribio la ablation linasema nini kuhusu self-attention na GN?
Katika jaribio la ziada lenye hali tano, modeli kamili iliyopendekezwa ililinganishwa na variant inayotumia gradient penalty, variant bila self-attention, mbinu ya mtetemo pekee na mbinu ya mkondo pekee.
| Modeli | 1:50 | 1:20 | 1:10 | 1:5 | 1:2 | 1:1 |
|---|---|---|---|---|---|---|
| SA + GN + Base | 62,8 | 64,9 | 76,5 | 86,5 | 94,9 | 97,2 |
| SA + GP + Base | 61,4 | 62,7 | 73,3 | 83,3 | 92,8 | 95,3 |
| GN + Base | 59,6 | 63,1 | 72,7 | 81,7 | 90,1 | 94,5 |
| Mtetemo pekee | 62,6 | 64,2 | 73,6 | 81,6 | 89,1 | 93,3 |
| Mkondo pekee | 63,1 | 66,7 | 74,5 | 84,1 | 93,2 | 96,8 |
Muundo kamili wa SWGAN ulifikia usahihi wa juu zaidi katika jedwali hili kuanzia 1:10. Kinyume chake, katika uhaba uliokithiri wa data kama 1:50 na 1:20, mbinu ya mkondo pekee ilitoa matokeo ya juu zaidi. Hili pia linaonyesha kwamba faida ya vipengele vya modeli inategemea kiasi cha sampuli halisi za mwanzo.
Katika loss curves, modeli kamili inayotumia gradient normalization inasemekana kuingia kwenye usawa wa dynamic baada ya takriban 120 epoch, ilhali variant ya gradient penalty ilikaribia usawa sawa baada ya takriban 160 epoch. Uchunguzi huu ni kiashirio cha uthabiti wa mafunzo; chanzo hakijatoa jaribio tofauti la kitakwimu la convergence kwa hili.
Vikwazo vikuu vya kimetodolojia
- Sampuli zilizozalishwa hazijapimwa tena kimwili kwenye mota halisi.
- SWGAN imetumiwa hasa kwa augmentation ya offline; matumizi ya real-time embedded hayajafanywa.
- Tathmini ya kiainishaji ilifanywa kwa sehemu za test zilizotenganishwa kutoka Dataset zilezile; uthibitishaji kwenye Dataset huru ya eneo la viwanda haujawasilishwa.
- Hakuna kipimo tofauti cha kiasi cha consistency kilichoripotiwa kwa ulinganifu wa kimwili kati ya modaliti katika uzalishaji wa modaliti nyingi.
- Wastani halisi wa usahihi wa Case C na Case D haukutolewa kama jedwali la namba katika matokeo; kwa hiyo hakuna thamani mpya sahihi iliyotolewa kutoka kwenye picha ya grafu.
- Kuna baadhi ya kutokulingana kwa namba na istilahi kati ya muhtasari, majedwali na maelezo ya mbinu katika chanzo.
Maelezo ya Chanzo na Mbinu
Utafiti asili: Generative Dual-Modal Data Augmentation for Motor Fault Diagnosis Under Sample Imbalance.
Waandishi na mpangilio wao: Ganxin Jie; Cailiang Zhang; Junqing Ma; Yang Yang; Chuan Chen.
Mwandishi wa mawasiliano: Cailiang Zhang. Hakuna tamko la waandishi wa kwanza sawa/mchango sawa katika chanzo.
Taasisi: State Key Laboratory of Environmental Adaptability for Industrial Products, China National Electric Apparatus Research Institute Co., Ltd.; Yangjiang Offshore Wind Power Laboratory; School of Software & Internet of Things Engineering, Jiangxi University of Finance and Economics; General Machinery Key Core Components Innovation Center (Anhui) Co., Ltd.; Ocean College, Zhejiang University.
Jarida: Machines. Mchapishaji: MDPI. Juzuu: 14. Makala: 633. Tarehe ya kuchapishwa: 1 Juni 2026. DOI: 10.3390/machines14060633. Kiungo rasmi: https://doi.org/10.3390/machines14060633
Aina ya chanzo na hali ya mapitio ya kitaalamu: Ni makala ya utafiti iliyopitia peer review. Utafiti ulipokelewa 12 Aprili 2026, ukarekebishwa 8 Mei 2026 na kukubaliwa 11 Mei 2026.
Leseni: Leseni ya ufikiaji wazi ya Creative Commons Attribution (CC BY).
Ufadhili: Utafiti uliungwa mkono na State Key Laboratory of Environmental Adaptability for Industrial Products, China National Electric Apparatus Research Institute Co., Ltd. kupitia mradi namba 2025EASKJ-010.
Upatikanaji wa data: Dataset A ilitokana na Dataset ya umma ya hitilafu za stator za PMSM za awamu tatu iliyochapishwa na timu ya utafiti ya KAIST; Dataset B ilitokana na Dataset ya hitilafu za mota ya induction ya awamu tatu chini ya hali za uendeshaji zinazobadilika kutoka timu ya utafiti ya Tsinghua University. Makala imetoa viungo vya Mendeley Data kwa vyanzo vyote viwili.
Mgongano wa maslahi na tamko la mfadhili: Mahusiano ya ajira ya Ganxin Jie, Yang Yang na Chuan Chen na China National Electric Apparatus Research Institute Co., Ltd. pamoja na General Machinery Key Core Components Innovation Center (Anhui) Co., Ltd. yamefichuliwa. Kulingana na chanzo, mfadhili hakushiriki katika muundo wa utafiti, ukusanyaji wa data, uchambuzi, tafsiri, uandishi au uamuzi wa kuchapisha.
Michango ya waandishi: Conceptualization J.M. na C.Z.; methodology J.M.; software J.M.; validation C.Z.; resources C.C.; rasimu ya kwanza J.M.; review na editing C.Z.; supervision G.J.; project management Y.Y.; funding acquisition G.J.
Mbinu ya kisayansi, usanifu, milinganyo, Dataset, matokeo ya utambuzi na vikwazo katika makala hii ya Verianla vinategemea utafiti uliopitiwa pekee. Ukaguzi wa chanzo cha nje ulitumika tu kwa utambulisho wa bibliografia wa chapisho; hakuna matokeo mapya ya utendaji au ugunduzi wa majaribio ulioongezwa kutoka nje.
Baadhi ya kutokulingana muhimu ndani ya chanzo zimehifadhiwa. Baadhi ya viwango vya juu zaidi vya usahihi vilivyotolewa kwenye muhtasari havilingani kikamilifu na viwango vilivyo katika majedwali na grafu za kina. Katika usanifu wa SWGAN, ukubwa wa label umeandikwa kuwa nane ingawa majaribio makuu ya uainishaji yana madarasa kumi. Katika baadhi ya sehemu za Dataset A, istilahi “limited training set” na “imbalance ratio” hazilingani kikamilifu. Thamani ya mota ya 2000 W katika jedwali la Case A/B hailingani na nguvu za mota za 1000, 1500 na 3000 W zilizofafanuliwa awali. Katika sehemu ya ablation, Dataset imeitwa kimakosa “bearing dataset” na ukali wa IT1 umetolewa kwa thamani mbili tofauti. Kutokuwa na uhakika huku hakujasahihishwa kimya kimya.
Thamani kuu ya kisayansi ya utafiti ni kujaribu kwenye Dataset mbili tofauti za mota jinsi modeli generative yenye masharti inayojumuisha self-attention na gradient normalization inaweza kuimarisha madarasa ya hitilafu za mota yenye uwakilishi mdogo kwa spektramu za mkondo na mtetemo. Hata hivyo, matokeo hayatoi ushahidi wa moja kwa moja wa utambuzi wa real-time embedded katika mazingira ya kazi au uhalali wa kimwili wa moja-kwa-moja wa sampuli zilizozalishwa.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *