

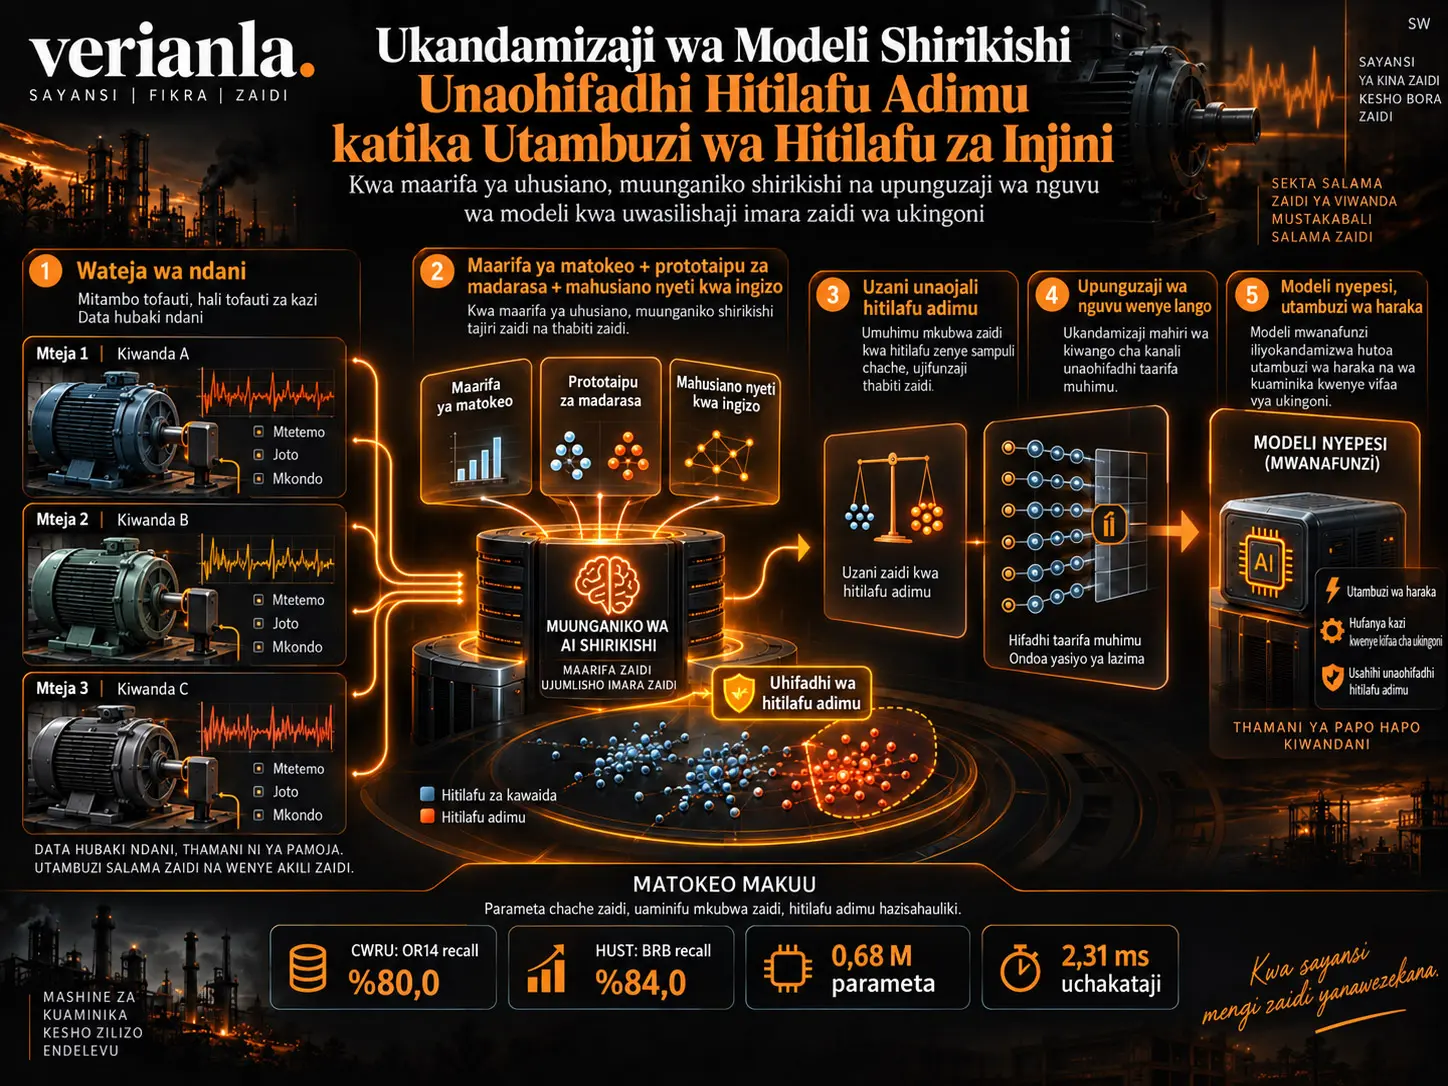
Mbinu ya upunguzaji wa nguvu wa modeli shirikishi unaoongozwa na maarifa ya uhusiano kwa kuhifadhi hitilafu adimu ni mfumo wa ujifunzaji wa mashine unaolenga kufanya utambuzi wa pamoja bila kukusanya data ghafi za ufuatiliaji kutoka kwa injini tofauti katika sehemu moja ya kati, kutopoteza maarifa ya sampuli chache za hitilafu adimu wakati wa ujumuishaji shirikishi, na kupunguza modeli inayopatikana hadi iwe ndogo vya kutosha kuendeshwa kwenye vifaa vya ukingoni. Mbinu hiyo hutoa aina tatu za maarifa kutoka kwa kila mteja wa ndani: maarifa ya kutofautisha matokeo, mahusiano ya darasa-prototipu na mahusiano nyeti kwa ingizo. Kwenye seva, maarifa ya hitilafu adimu hupewa uzani kwa kuzingatia uchache wa sampuli, uaminifu wa matokeo na mtawanyiko ndani ya darasa; kisha modeli ya mwalimu wa kimataifa huhamishiwa kwenye modeli ya mwanafunzi yenye milango chini ya vikwazo vya uhusiano na njia zisizo za lazima hukandamizwa.
Katika hali ya kutokuwa na uwiano iliyounganishwa kwenye mkusanyiko wa data wa bearing wa CWRU, mbinu ilipata usahihi wa wastani wa %84,9, Macro-F1 ya %84,0 na OR14 recall ya %80,0. Katika hali hiyo hiyo, thamani zinazolingana za Fed-KD ni %74,7, %72,0 na %58,0. Katika hali ya hitilafu adimu yenye modaliti iliyogawanyika kwenye mkusanyiko wa data wa injini wa modaliti nyingi wa HUST, mbinu ilifikia usahihi wa wastani wa %88,4, Macro-F1 ya %87,8 na recall ya %84,0 kwa broken rotor bar (BRB). Katika hali ya uendeshaji ya 30 Hz ambayo haikuonekana wakati wa mafunzo, usahihi wa wastani wa %84,3, Macro-F1 ya %83,5 na BRB recall ya %78,0 viliripotiwa.
Ukandamizaji wa modeli haukutekelezwa kama kupunguza idadi ya vigezo pekee. Milango inayoweza kujifunza katika mtandao wa mwanafunzi ilifunzwa pamoja na hasara za uhusiano zinazohifadhi njia muhimu kwa kutenganisha hitilafu adimu. Katika jaribio la HUST, modeli ya mwisho iliripotiwa kuwa na vigezo milioni 0,68, FLOP milioni 1,55, muda wa inference wa sampuli moja wa 2,31 ms na kumbukumbu ya kilele ya inference ya 596,4 MiB. Hata hivyo, matokeo yanahusu majaribio ya non-IID yaliyodhibitiwa yenye wateja watatu na mikusanyiko miwili ya data ya umma; bado hayatoi ushahidi wa moja kwa moja kwa shirikisho la viwanda la kiwango kikubwa katika mazingira halisi. Zaidi ya hayo, kuweka ishara ghafi ndani ya eneo la mteja hufanya mbinu hii kuwa “privacy-aware”, lakini kama waandishi wanavyosema wazi, hakutoi dhamana rasmi ya faragha.
Muktadha wa kihandisi wa tatizo
Katika injini za viwandani, hitilafu kama uharibifu wa bearing, kutokuwa na uwiano wa rotor, kutokaa sawa kwa mhimili, broken rotor bar, short circuit ya winding na kutokuwa na uwiano wa voltage zinaweza kuathiri moja kwa moja mwendelezo wa uzalishaji na gharama za matengenezo. Hata hivyo, katika mazingira halisi ya utambuzi yenye vituo vingi, mashine zote hazina kiasi sawa cha data, sensa sawa au usambazaji sawa wa hitilafu. Katika baadhi ya vituo hitilafu fulani zinaweza kutowahi kuonekana, ilhali kwa mteja mwingine kunaweza kuwa na rekodi chache tu zenye kelele za hitilafu adimu.
Hali hii ni ngumu kwa ujifunzaji shirikishi wa kawaida. Kuweka wastani wa vigezo kwa kuzingatia tu idadi ya sampuli kunaweza kusababisha wateja wenye data nyingi kutawala modeli ya kimataifa. Ikiwa hitilafu adimu inapatikana kwa mteja mdogo pekee, mpaka wa uamuzi wa hitilafu hiyo unaweza kudhoofika ndani ya modeli ya kimataifa. Kwa upande mwingine, kuhifadhi vipengele vinavyojirudia au vinavyotawaliwa na madarasa ya wengi kutoka kwa wateja wote kunaweza pia kusababisha modeli kuwa kubwa bila ulazima.
Kwa Nini Maarifa ya Hitilafu Adimu Yanaweza Kupotea katika Ujifunzaji Shirikishi?
Katika ujifunzaji shirikishi, wakati usambazaji wa data za ndani ni non-IID, wateja wenye mikusanyiko mikubwa na yenye ubora wa juu wanaweza kuwa na ushawishi mkubwa zaidi katika ujumuishaji wa kimataifa; sampuli za hitilafu adimu zinazopatikana kwa wateja wachache tu zinaweza kudhoofishwa ndani ya wastani. Suluhisho la utafiti huu ni kupima mchango wa mteja katika kiwango cha darasa si kwa idadi ya sampuli pekee, bali pia kwa uchache, uaminifu wa matokeo na mtawanyiko ndani ya darasa.
Hatua nne za mfumo uliopendekezwa
Katika ukurasa wa 6 wa chanzo, Kielelezo 1 kinaonyesha mbinu kama michakato minne mfululizo: uchimbaji wa maarifa ya ndani, muunganisho wa maarifa shirikishi, uboreshaji wa modeli ya mwalimu wa kimataifa na upunguzaji wa nguvu wa modeli ya mwanafunzi wenye milango.
Katika mfumo shirikishi, idadi ya wateja huonyeshwa kwa \(K\), idadi ya madarasa kwa \(C\), mkusanyiko wa data wa mteja \(k\) kwa \(D_k\), mkusanyiko wa kalibresheni wenye lebo kwenye seva kwa \(D_a\), modeli ya ndani kwa \(F_k\), mwalimu wa kimataifa kwa \(F_G\) na modeli ya mwanafunzi kwa \(F_S\).
Utabiri wa msingi wa modeli ya ndani
Na kichimbaji cha vipengele cha mteja \(k\) kiwe \(\phi_k(\cdot)\), kiainishaji chake kiwe \(g_k(\cdot)\) na vigezo vyake viwe \(\theta_k\). Mlinganyo (1) wa chanzo ni:
\[ z_{k,i}=g_k\!\left(\phi_k(x_{k,i};\theta_k)\right), \qquad p_{k,i}=\operatorname{softmax}(z_{k,i}) \tag{1} \]
\(z_{k,i}\) huwakilisha logits za uainishaji, na \(p_{k,i}\) huwakilisha uwezekano wa madarasa. Modeli hii hufunzwa kwa data za ndani; ishara ghafi haitumwi kwenye seva.
Hasara inayosawazisha madarasa adimu katika eneo la mteja
Ili kuongeza athari ya madarasa adimu katika mafunzo ya ndani, cross-entropy iliyosawazishwa kwa darasa hutumiwa:
\[ L_k^{ce} = -\frac{1}{n_k} \sum_{i=1}^{n_k} \gamma_{k,y_{k,i}} \log p_{k,i}^{(y_{k,i})} \tag{2} \]
\[ \gamma_{k,c} = \frac{(n_{k,c}+\varepsilon)^{-\eta}} {\sum_{j=1}^{C}(n_{k,j}+\varepsilon)^{-\eta}} \]
\(n_{k,c}\) ni idadi ya sampuli za mteja \(k\) kwa darasa \(c\). \(\varepsilon\) huzuia mgawanyo kwa sifuri; \(\eta\) huamua nguvu ya fidia inayotolewa kwa darasa adimu. Katika majaribio \(\eta=0.5\) na \(\varepsilon=10^{-6}\) zilitumiwa.
Maarifa ya Uhusiano wa Viwango Vingi ni Nini?
Maarifa ya uhusiano wa viwango vingi katika utafiti huu huwakilisha maarifa ya modeli si kwa uwezekano wa mwisho wa darasa pekee, bali katika viwango vitatu vinavyokamilishana: usambazaji laini wa matokeo huelezea mipaka ya maamuzi, prototipu za madarasa huelezea mahusiano ya kimuundo kati ya hitilafu, na mahusiano nyeti kwa ingizo yanayotegemea gradient huelezea unyeti kwa vipengele vya hitilafu adimu vilivyo dhaifu au vilivyo karibu na mpaka wa darasa.
1. Maarifa ya kutofautisha matokeo
Badala ya lebo ngumu ya darasa, usambazaji uliolainishwa kwa joto \(T\) hutumiwa:
\[ q^T_{k,i} = \operatorname{softmax} \left( \frac{z_{k,i}}{T} \right) \tag{3} \]
Katika majaribio \(T=3\). Kwa kuwa uwezekano laini hujumuisha si darasa sahihi pekee bali pia kufanana kwa kiasi kwa madarasa mengine, husaidia hasa kuhamisha mipaka ya maamuzi ya aina za hitilafu zinazofanana kwa karibu.
2. Uhusiano wa darasa-prototipu
Kipengele cha kina hufafanuliwa kama \(h_{k,i}=\phi_k(x_{k,i};\theta_k)\). Prototipu ya darasa ni wastani wa vipengele vilivyosawazishwa:
\[ \pi_{k,c} = \frac{1}{n_{k,c}} \sum_{i:y_{k,i}=c} \frac{h_{k,i}} {\|h_{k,i}\|_2} \tag{4} \]
Uhusiano kati ya madarasa mawili huandikwa kwa cosine similarity:
\[ R^p_k(c,c') = \frac{\pi_{k,c}^{\top}\pi_{k,c'}} {\|\pi_{k,c}\|_2\|\pi_{k,c'}\|_2} \tag{5} \]
Matritsi hii inalenga kuhifadhi, kwa mfano, jinsi hitilafu mbili za outer race zilivyo karibu katika nafasi ya vipengele bila kutegemea uamuzi wa mwisho wa darasa wa modeli pekee.
3. Uhusiano nyeti kwa ingizo
Prototipu ya unyeti wa darasa huzalishwa kutoka gradient ya logit ya darasa husika kwa heshima na kipengele:
\[ s_{k,c} = \frac{1}{n_{k,c}} \sum_{i:y_{k,i}=c} \frac{\nabla_{h_{k,i}}z^{(c)}_{k,i}} {\|\nabla_{h_{k,i}}z^{(c)}_{k,i}\|_2} \tag{6} \]
Kisha uhusiano wa unyeti kati ya madarasa:
\[ R^s_k(c,c') = \frac{s_{k,c}^{\top}s_{k,c'}} {\|s_{k,c}\|_2\|s_{k,c'}\|_2} \tag{7} \]
Lengo la safu hii ni kutopoteza ni njia zipi za vipengele zilizo nyeti kwa sampuli za hitilafu adimu zenye msukumo dhaifu, SNR ya chini au zilizo kwenye mpaka wa darasa. Katika ukurasa wa 18, Kielelezo 8 kinaonyesha kuwa modeli kamili huzalisha majibu ya njia yenye msongamano na uthabiti zaidi yanayohusiana na hitilafu adimu katika sampuli za OR14.
Mawasiliano bila kutuma data ghafi
Kila mteja hutuma majibu ya matokeo, prototipu, matritsi mbili za uhusiano na takwimu za madarasa badala ya ishara ghafi ya mtetemo au akustiki. Chanzo kinatoa mzigo wa mawasiliano kama:
\[ B_{\mathrm{rel}} = b\left( N_aC+Cd+2C^2+3C \right) \]
Kwa uhamishaji wa kawaida wa federated unaotegemea vigezo:
\[ B_{\mathrm{param}}=b|\theta| \]
hutumiwa. \(b\) ni ukubwa wa baiti wa thamani moja ya floating point, \(N_a\) ni idadi ya sampuli za kalibresheni, na \(d\) ni ukubwa wa prototipu. Ulinganisho huu unaonyesha kuwa vielezi vinaweza kuwa vidogo kuliko vigezo vya modeli kamili katika hali nyingi; hata hivyo, faida halisi ya mawasiliano inategemea \(N_a\), \(C\), \(d\) na ukubwa wa modeli.
Mbinu na Matokeo ya Utafiti
Uwekaji Uzani Shirikishi Unaohisi Hitilafu Adimu Hufanyaje Kazi?
Seva hutathmini mchango wa kila jozi ya mteja-darasa kwa kutumia vigezo vitatu: jinsi darasa lilivyo adimu, jinsi matokeo ya modeli yanavyoaminika na jinsi vipengele vya darasa hilo vinavyotawanyika. Uzani wa maarifa ya darasa adimu lenye sampuli chache lakini linaloaminika huongezwa, huku uaminifu mdogo au mtawanyiko mkubwa ukizuia mchango usiongezeke kupita kiasi.
Uaminifu wa matokeo
Kwa darasa \(c\), uaminifu wa maarifa hufafanuliwa katika chanzo kama:
\[ \rho_{k,c} = 1- \frac{1} {n_{k,c}\log C} \sum_{i:y_{k,i}=c} H(q^T_{k,i}) \tag{8} \]
Ikiwa entropy ni ndogo, usambazaji wa matokeo huwa thabiti zaidi na \(\rho_{k,c}\) huongezeka.
Mtawanyiko ndani ya darasa
\[ d_{k,c} = \frac{1}{n_{k,c}} \sum_{i:y_{k,i}=c} \left\| \frac{h_{k,i}}{\|h_{k,i}\|_2} - \pi_{k,c} \right\|_2^2 \tag{9} \]
\(d_{k,c}\) kubwa inaonyesha kuwa vipengele vya darasa moja vimetawanyika zaidi kuzunguka prototipu.
Uzani shirikishi katika kiwango cha darasa
Chanzo katika Mlinganyo (10) kinatoa uzani kwa muundo huu:
\[ \alpha_{k,c} = \frac{ \exp\!\left( \beta_r r_{k,c} + \beta_\rho \rho_{k,c} - \beta_d d_{k,c} \right)} { \sum_{j\in K_c} \exp\!\left( \beta_r r_{j,c} + \beta_\rho \rho_{j,c} - \beta_d d_{j,c} \right)} \tag{10} \]
\[ r_{k,c} = \frac{1}{\log(e+n_{k,c})} \]
Hapa \(r_{k,c}\) huwakilisha uchache wa darasa. Mpangilio uliochaguliwa katika utafiti ni \((\beta_r,\beta_\rho,\beta_d)=(1.0,1.0,0.5)\). Katika uonyeshaji wa fomula wa chanzo, coefficients za kwanza zimechapishwa mahali pamoja kama \(\beta_1,\beta_2,\beta_3\), huku maelezo na majaribio yaliyofuata yakitumia \(\beta_r,\beta_\rho,\beta_d\); hapa, bila kubadilisha maana ya kisayansi, majina ya pili yanayoendana na majaribio yametumiwa na tofauti ya notation ya chanzo imeelezwa katika dokezo la bibliografia.
Ujumuishaji wa kimataifa wa mahusiano
Seva huunganisha prototipu za madarasa na matritsi mbili za uhusiano kwa uzani:
\[ \pi_c = \sum_{k\in K_c} \alpha_{k,c}\pi_{k,c} \tag{11a} \]
\[ R^p(c,c') = \sum_{k\in K_{c,c'}} \alpha_{k,c,c'}R^p_k(c,c'), \qquad R^s(c,c') = \sum_{k\in K_{c,c'}} \alpha_{k,c,c'}R^s_k(c,c') \tag{11b} \]
Uboreshaji wa mwalimu wa kimataifa
Modeli ya mwalimu haifunzwi kwa hasara ya uainishaji pekee, bali kwa kuhifadhi kwa pamoja mahusiano ya matokeo, prototipu na unyeti:
\[ L_G = L^{ce}_0 + \lambda_oT^2 KL(\bar q^T\|q_G^T) + \lambda_p \|R_G^p-R^p\|_F^2 + \lambda_s \|R_G^s-R^s\|_F^2 \tag{12} \]
\[ \theta_G^{t+1} = \theta_G^t - \eta_G\nabla_{\theta_G}L_G \]
\(L_0^{ce}\) ni hasara inayosimamiwa inayohesabiwa kwenye mkusanyiko wa anchor/kalibresheni wenye lebo kwenye seva. Kwa mujibu wa chanzo, ikiwa data ya anchor yenye lebo haipo, neno hili linaweza kuondolewa na mwalimu kusasishwa kwa distillation na vikwazo vya uhusiano pekee.
Upunguzaji wa Nguvu wa Modeli wenye Milango Unajaribuje Kuhifadhi Hitilafu Adimu?
Katika mtandao wa mwanafunzi, kila njia ya kipengele hupewa lango linaloweza kujifunza. Adhabu ya sparsity husukuma njia zenye mchango mdogo kuelekea sifuri, huku hasara za matokeo, darasa-prototipu na uhusiano wa unyeti zikihifadhi njia zinazohitajika kutenganisha hitilafu adimu; seti ya mwisho ya njia pia lazima ipite viwango vya uvumilivu vya usahihi wa jumla na recall ya hitilafu adimu.
Milango ya njia inayoweza kujifunza
\[ m_l=\sigma(a_l), \qquad \tilde h_{S,l}=m_l\odot h_{S,l} \tag{13} \]
\(a_l\) ni kigezo cha lango kinachojifunza, \(\sigma\) ni kazi ya sigmoid na \(m_l\) ni kiwango cha kuhifadhi njia. \(m_l\) ndogo inaonyesha kuwa njia ina mchango mdogo kwa utambuzi unaohifadhi uhusiano.
Hasara ya modeli ya mwanafunzi
\[ \begin{aligned} L_S ={}& L_S^{ce} + \mu_oT^2KL(q_G^T\|q_S^T) + \mu_p\|R_G^p-R_S^p\|_F^2 \\ &+ \mu_s\|R_G^s-R_S^s\|_F^2 + \mu_g\sum_l\|m_l\|_1 + \mu_b\sum_l\|m_l(1-m_l)\|_1 \end{aligned} \tag{14} \]
Katika majaribio \(\mu_o=1.0\), \(\mu_p=\mu_s=0.5\), \(\mu_g=10^{-4}\) na \(\mu_b=10^{-3}\) zilitumiwa. Maneno mawili ya mwisho yanalenga kufanya njia kuwa sparse na kusogeza milango karibu na 0 au 1 badala ya thamani za kati zisizo dhahiri.
Kizingiti cha uteuzi wa njia
\[ M_S^* = \left\{ j\mid \bar m_{l,j}\ge\xi,\ j\in M_S \right\} \tag{15} \]
Kizingiti cha awali cha kuhifadhi ni \(\xi=0.5\). Ikiwa sharti la kuhifadhi utendaji halitimizwi, kizingiti hupunguzwa kwa 0,05 na mwanafunzi hufanyiwa fine-tuning tena.
Sharti la kuzuia ukandamizaji kupita kiasi
\[ Acc(F_S^*) \ge Acc(F_G)-\delta_a \]
\[ Rec_{\mathrm{rare}}(F_S^*) \ge Rec_{\mathrm{rare}}(F_G)-\delta_r \tag{16} \]
Kigezo hiki hutumiwa tu katika uteuzi wa modeli wa nje ya mtandao na hatua ya upunguzaji. Katika inference ya mtandaoni kwenye kifaa cha ukingoni, lebo ya hitilafu adimu haihitajiki.
Usanifu wa majaribio na vigezo vya mafunzo
| Kipengele | Mpangilio |
|---|---|
| Idadi ya wateja | Wateja 3 hushiriki katika kila raundi shirikishi |
| Mafunzo ya ndani | epoch 5 za ndani katika kila raundi |
| Mkusanyiko wa kalibresheni wa CWRU | Sampuli 5 zenye lebo kwa kila darasa |
| Mkusanyiko wa kalibresheni wa HUST | Sampuli 10 zenye lebo kwa kila darasa |
| Usanifu wa mwalimu | vitalu 3 vya Conv–BN–ReLU–Pool katika 1D-CNN |
| Mwanafunzi | 1D-CNN nyembamba zaidi + milango ya njia inayoweza kujifunza baada ya vitalu vya convolution |
| Modeli ya HUST | Matawi mawili sambamba kwa mtetemo na akustiki, kisha fusion |
| Optimizer | Adam |
| Kasi ya kujifunza ya ndani/mwalimu | \(1\times10^{-3}\) |
| Kasi ya kujifunza ya mwanafunzi | \(5\times10^{-4}\) |
| Kasi ya kujifunza ya lango | \(1\times10^{-3}\) |
| Batch size | 64 |
| Raundi shirikishi za juu zaidi | 100 |
| Mafunzo ya mwanafunzi | Hadi epoch 50 |
| Joto | \(T=3\) |
| Kizingiti cha kuhifadhi | \(\xi=0.5\) |
Mkusanyiko wa data wa CWRU na kutokuwa na uwiano kwa pamoja
Katika jaribio la CWRU, data zenye mzigo wa 1 HP, kasi ya mzunguko 1797 r/min na mzunguko wa sampuli wa 48 kHz zilichaguliwa. Katika hali ya kutokuwa na uwiano iliyounganishwa, Client 1 ina sampuli 20 kwa kila darasa katika mfumo wa madarasa 10, lakini data zenye kelele ya 2 dB na darasa adimu OR14; katika Client 2 na Client 3 kuna sampuli 200 kwa kila darasa kwa madarasa tisa na OR14 haipo kabisa.
| Mbinu | Usahihi wa wastani | Macro-F1 | OR14 recall |
|---|---|---|---|
| DNN | %53,0 | %50,6 | %18,0 |
| FedAvg | %64,0 | %60,8 | %34,0 |
| FedProx | %68,8 | %65,2 | %46,0 |
| FedProto | %72,9 | %70,5 | %56,0 |
| Fed-KD | %74,7 | %72,0 | %58,0 |
| Mbinu iliyopendekezwa | %84,9 | %84,0 | %80,0 |
Confusion matrices za chanzo zinaonyesha kuwa OR14 huchanganywa hasa na OR07 na OR21. Katika mbinu iliyopendekezwa, kuchanganywa huku hupungua kwa kiasi kikubwa. Matokeo haya ni muhimu zaidi kuliko ongezeko la usahihi wa wastani pekee; lengo la usanifu wa mbinu ni kuhifadhi moja kwa moja mpaka wa darasa adimu.
Mkusanyiko wa data wa injini wa modaliti nyingi wa HUST
Katika jukwaa la HUST kuna hali sita: hali yenye afya, hitilafu ya bearing, kupinda kwa rotor, broken rotor bar, kutokaa sawa kwa rotor na kutokuwa na uwiano wa voltage. Utafiti hutumia masafa ya uendeshaji ya 5, 10, 20 na 30 Hz na mzunguko wa sampuli wa 25,6 kHz; kila faili ina nukta 163.840 za data.
Modaliti iliyogawanyika na BRB adimu
| Mbinu | Usahihi wa wastani | Macro-F1 | BRB recall |
|---|---|---|---|
| FedAvg | %70,5 | %68,1 | %46,0 |
| FedBN | %75,1 | %73,6 | %52,0 |
| FedProto | %78,3 | %76,9 | %61,0 |
| FedDF | %79,6 | %78,2 | %63,0 |
| Fed-KD | %81,2 | %80,0 | %66,0 |
| FedSlim | %80,5 | %78,7 | %64,0 |
| Mbinu iliyopendekezwa | %88,4 | %87,8 | %84,0 |
Ujumlishaji kwenye hali ya 30 Hz isiyoonekana
Wateja wa mafunzo hutumia hali za 5, 10 na 20 Hz, huku 30 Hz ikitengwa kabisa kwa ajili ya majaribio.
| Mbinu | Usahihi wa wastani | Macro-F1 | BRB recall |
|---|---|---|---|
| Fed-KD | %76,8 | %75,1 | %61,0 |
| FedSlim | %75,0 | %72,8 | %59,0 |
| Mbinu iliyopendekezwa | %84,3 | %83,5 | %78,0 |
Michoro ya t-SNE katika ukurasa wa 23 inaonyesha kuwa katika mbinu iliyopendekezwa, makundi ya ndani ya darasa ni yenye msongamano zaidi na utengano kati ya madarasa unaonekana wazi zaidi. Hili ni jambo la uonyeshaji; t-SNE pekee haipaswi kutafsiriwa kama ushahidi wa kisababishi au jiometri wa uhakika.
Upotevu wa modaliti kwenye kifaa cha ukingoni
Ingawa modeli imeona modaliti mbili wakati wa mafunzo, wakati wa deployment ilijaribiwa kwa mtetemo pekee, akustiki pekee au upotevu wa modaliti kwa nasibu.
| Mbinu | Mtetemo pekee | Akustiki pekee | Upotevu wa modaliti kwa nasibu | BRB recall |
|---|---|---|---|---|
| Fed-KD | %82,5 | %79,0 | %80,8 | %66,0 |
| FedSlim | %81,7 | %78,2 | %79,6 | %64,0 |
| Mbinu iliyopendekezwa | %89,2 | %84,6 | %87,4 | %83,0 |
Ukubwa wa modeli na gharama ya inference iliyopimwa
Vipimo vilifanywa katika mazingira ya NVIDIA RTX 3060Ti GPU, Intel i7 CPU, Python 3.9, PyTorch 1.13 na CUDA 11.7 kwa batch size 1. Kwanza kulifanywa mikimbio 100 ya warm-up, ikifuatiwa na marudio 1000 ya inference.
| Mbinu | Vigezo | FLOPs | Muda wa inference | Kumbukumbu |
|---|---|---|---|---|
| FedAvg | 1,42 M | 3,84 M | 4,26 ms | 965,4 MiB |
| Fed-KD | 1,21 M | 3,10 M | 3,72 ms | 835,6 MiB |
| FedSlim | 0,74 M | 1,82 M | 2,64 ms | 628,2 MiB |
| Mbinu iliyopendekezwa | 0,68 M | 1,55 M | 2,31 ms | 596,4 MiB |
Majaribio ya Ablation Yanaonyesha Vipengele Gani vya Mbinu ni Muhimu?
Katika ablation ya kutokuwa na uwiano iliyounganishwa ya CWRU, kuondoa uzani wa hitilafu adimu kulipunguza OR14 recall kutoka %80 hadi %68 na kusababisha upotevu mkubwa zaidi wa darasa adimu; recall ilikuwa %72 baada ya kuondoa uhusiano wa prototipu na %71 baada ya kuondoa uhusiano nyeti kwa ingizo. Upunguzaji wenye milango ulipoondolewa, utendaji uliongezeka kidogo lakini uwiano wa vigezo ulipanda kutoka 0,48 hadi 1,00; kwa hiyo milango hutumika hasa kusawazisha utendaji na gharama ya deployment.
| Toleo | Usahihi wa wastani | Macro-F1 | OR14 recall | Uwiano wa vigezo |
|---|---|---|---|---|
| Msingi wa Fed-KD | %74,7 | %72,0 | %58,0 | 0,85 |
| Bila maarifa ya matokeo | %82,4 | %81,0 | %74,0 | 0,48 |
| Bila uhusiano wa prototipu | %81,8 | %80,4 | %72,0 | 0,48 |
| Bila uhusiano wa unyeti | %82,1 | %80,7 | %71,0 | 0,48 |
| Bila uzani wa hitilafu adimu | %81,5 | %80,2 | %68,0 | 0,48 |
| Bila upunguzaji wenye milango | %85,8 | %84,9 | %82,0 | 1,00 |
| Mbinu kamili | %84,9 | %84,0 | %80,0 | 0,48 |
Unyeti wa coefficients za uzani
Seti iliyochaguliwa ya coefficients \((1.0,1.0,0.5)\) ilitoa uwiano bora zaidi kati ya chaguo zilizojaribiwa, ikiwa na usahihi wa %84,9, Macro-F1 ya %84,0 na OR14 recall ya %80. Neno la uchache lilipoondolewa OR14 recall ilishuka hadi %72, na neno la uaminifu lilipoondolewa ilishuka hadi %70. Kuongeza adhabu ya mtawanyiko hadi 1,0 pia hupunguza OR14 recall hadi %76; hii inaonyesha hasara ya kukandamiza kupita kiasi maarifa ya darasa adimu yenye sampuli chache lakini yenye manufaa.
Majaribio yaliyorudiwa na umuhimu wa kitakwimu
Majaribio yalirudiwa mara tano kwa mbegu tofauti za nasibu na migawanyo ya wateja iliyoundwa upya. Paired t-test ilitumika kati ya mbinu iliyopendekezwa na msingi mkuu wa distillation wenye nguvu, Fed-KD, na \(p<0.01\) iliripotiwa katika matokeo makuu ya darasa adimu. Kwa mfano, CWRU OR14 recall ni \(58\pm2.6\) kwa Fed-KD na \(80\pm1.8\) kwa mbinu iliyopendekezwa.
Utafiti unasema nini na hausisemi nini
Unaunga mkono: Katika hali za benchmark za CWRU na HUST zilizochunguzwa, mchanganyiko wa maarifa ya uhusiano wa viwango vingi, uzani shirikishi unaohisi hitilafu adimu na upunguzaji wenye milango uliwezesha recall ya juu zaidi kwa madarasa adimu na gharama ya chini zaidi ya deployment ya ukingoni kuliko mbinu za kulinganisha zilizochaguliwa.
Unaunga mkono: Kuchagua njia kwa vikwazo vya kuhifadhi uhusiano badala ya upunguzaji wa kawaida wa njia kulihifadhi vizuri zaidi maarifa ya hitilafu adimu wakati wa ukandamizaji katika hali zilizojaribiwa.
Hauungi mkono: Kutotuma data ghafi si dhamana rasmi ya faragha katika kiwango cha differential privacy au usalama wa kriptografia.
Hauungi mkono: Matokeo yaliyopatikana kwa wateja watatu na usambazaji wa non-IID uliodhibitiwa hayathibitishi kuwa mbinu itapanuka moja kwa moja hadi mamia ya wateja wa viwanda halisi.
Hauungi mkono: Mafanikio kwenye mikusanyiko ya data ya umma hayamaanishi kuwa usahihi au latency hiyo hiyo imehakikishwa katika mazingira halisi ya kiwanda.
Maeneo ya kazi ya baadaye ya waandishi: aggregation inayoweza kupanuka zaidi, uzani unaohisi kutokuwa na uhakika, sasisho linalohisi data drift na uthibitishaji kwenye mikusanyiko halisi ya data ya injini ya wateja wengi ndani ya taasisi/viwanda.
Dokezo la Chanzo na Mbinu
Kichwa cha asili: Relation Knowledge-Guided Federated Model Compression for Rare-Fault Preservation in Motor Fault Diagnosis
Waandishi: Genbao Zhao; Juan Zhang
Mwandishi anayewajibika: Juan Zhang
Uhusiano wa taasisi: Katika PDF ya chanzo umetolewa kama “Automation with the College of Information Science and Engineering, Northeastern University, Shenyang 110000, China”.
Jarida: Machines
Mchapishaji: MDPI, Basel, Switzerland
Juzuu / Toleo / Makala: 14(6), 689
DOI: 10.3390/machines14060689
Tarehe ya kupokelewa: 14 May 2026
Marekebisho: 8 June 2026
Kukubaliwa: 11 June 2026
Kuchapishwa: 15 June 2026
Aina ya chanzo: Makala ya utafiti iliyopitiwa na wenzao.
Leseni: Creative Commons Attribution (CC BY), imethibitishwa kwa PDF ya chanzo na rekodi rasmi ya uchapishaji ya MDPI.
Ufadhili: Waandishi waliripoti kuwa hawakupokea ufadhili wa nje.
Mgongano wa maslahi: Waandishi waliripoti kutokuwa na mgongano wa maslahi.
Upatikanaji wa data: Chanzo kinasema kuwa data zilizotumiwa zinawasilishwa ndani ya makala. Majaribio yalitumia mikusanyiko ya data ya umma ya CWRU na HUST.
Michango ya waandishi: Methodology: G.Z. na J.Z.; writing—original draft: G.Z.; writing—review and editing: J.Z.
Tamko la matumizi ya AI: Waandishi walisema wazi kuwa Vielelezo 1–4 katika makala vilichorwa kwa usaidizi wa ChatGPT 5.5 ili kuboresha usomaji wa mchakato wa utekelezaji wa algoriti.
Dokezo la haki za taswira: Maandishi ya Verianla hayanakili mpangilio wa taswira wa vielelezo vya chanzo. Hasa, kwa kuwa mlolongo wa chanzo wa picha za majukwaa ya majaribio ya CWRU na HUST ni tofauti, picha hizo hazikutumiwa tena moja kwa moja.
Madokezo ya notation/uandishi ndani ya chanzo: Katika Mlinganyo (10), alama za coefficients zimetajwa tofauti kati ya fomula na maelezo; majedwali ya majaribio yanayofuata hutumia notation ya \(\beta_r,\beta_\rho,\beta_d\). Katika ukurasa wa 19, aya inayojadili Kielelezo 9 ina usemi “Figure 8”. Katika maelezo ya confusion matrix ya CWRU, “quantization” imetajwa ingawa hakuna mstari tofauti wa quantization katika jedwali kuu la matokeo husika. Hoja hizi hazijasahihishwa kwa kuunda data mpya.
Vikwazo vikuu vya kimethodolojia: Majaribio yamewekewa kikomo kwa wateja watatu, usambazaji wa non-IID uliodhibitiwa, mikusanyiko miwili tu ya data ya umma, data drift ya mtandaoni haijajaribiwa moja kwa moja na hakuna dhamana rasmi ya faragha.
Mbinu ya uchakataji ya Verianla: Maandishi ya chanzo hayakutafsiriwa mstari kwa mstari au aya kwa aya. Usanifu wa modeli, mlolongo wa milinganyo, hali za majaribio, mikusanyiko ya data, matokeo ya utendaji, ablation, gharama ya deployment na vikwazo viligawanywa katika vipengele tofauti vya kisayansi; kisha viliundwa upya katika muundo huru wa kielimu.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *