

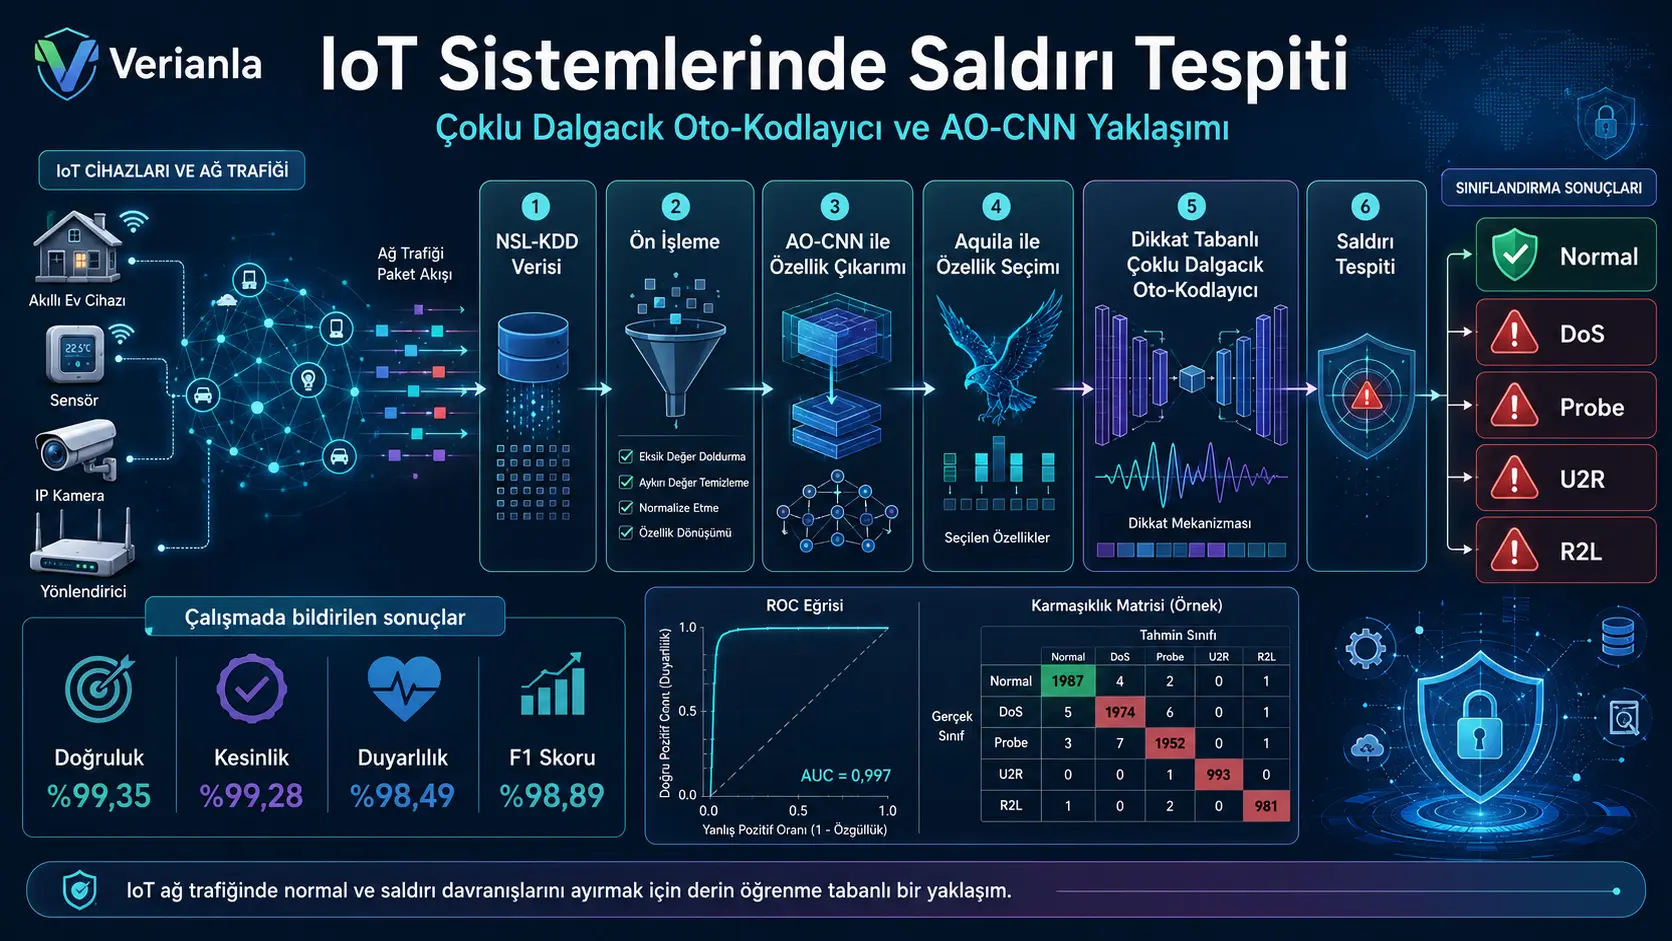
Utafiti huu unapendekeza mbinu ya hatua mbili ya kujifunza kwa kina ili kutenganisha trafiki ya kawaida na trafiki ya mashambulizi katika mitandao ya Internet of Things. Katika hatua ya kwanza, mtandao wa neva wa convolution wa mwelekeo mmoja huchota vipengele kutoka kwenye trafiki ya mtandao; Aquila Optimization Algorithm inalenga kuchagua vipengele vinavyofaa zaidi kwa uainishaji. Katika hatua ya pili, auto-encoder yenye mwelekeo wa multi-wavelet inayoungwa mkono na attention mechanism huainisha trafiki ya kawaida pamoja na mashambulizi ya denial-of-service, scanning na privilege escalation.
Watafiti walitathmini model kwenye NSL-KDD dataset na katika sehemu ya matokeo waliripoti accuracy ya asilimia 99,35, precision ya asilimia 99,28, recall ya asilimia 98,49 na F1 score ya asilimia 98,89. Pia inadaiwa kwamba model ilionyesha inference time fupi zaidi, CPU usage ya chini zaidi na memory consumption iliyo stable kuliko baadhi ya methods zilizolinganishwa.
Hata hivyo, kuna kutokulingana muhimu kati ya numerical results za study. Kati ya samples 10.000 katika binary confusion matrix iliyowasilishwa, 9.989 zimeainishwa kwa usahihi; hii inalingana moja kwa moja na accuracy ya asilimia 99,89 na haiendani na value iliyotolewa ya asilimia 99,35. Katika five-class matrix, kati ya samples 10.000, 9.986 zimeainishwa kwa usahihi na accuracy inayokokotolewa directly ni asilimia 99,86. Katika U2R class yenye samples chache zaidi, only two kati ya three true samples zimeainishwa kwa usahihi; recall inayokokotolewa kutoka matrix kwa class hii ni asilimia 66,67, ingawa text inatoa value ya asilimia 98,3.
Kwa hiyo, study inaonyesha kwamba attention mechanism, CNN, meta-heuristic feature selection na wavelet-based auto-encoders zinaweza kuunganishwa katika architecture moja; lakini kabla inconsistencies kati ya reported performance values, implementation details na mathematical definitions hazijaondolewa, haiwezi kuhitimishwa kwamba method inafanya kazi kwa reliability ya zaidi ya asilimia 99 katika real IoT networks.
Study inashughulikia tatizo gani?
Internet of Things systems zinaundwa na idadi kubwa ya connected devices kama sensors, cameras, smart-home devices, industrial-control components na communication modules. Kutuma data kupitia network na devices hizi kunatengeneza attack surface pana ambayo attackers wanaweza kutumia kufanya denial-of-service, network scanning, unauthorized access na privilege-escalation attacks.
Traditional intrusion-detection systems zinaweza kutumia predefined rules au signatures. Machine-learning-based systems hujaribu kujifunza normal na abnormal behavior kutoka patterns katika network traffic. Hata hivyo, network records zinaweza kuwa high-dimensional, noisy na imbalanced kwa classes. Hasa, rare attacks kuwakilishwa na very few samples kunaweza kusababisha critical attacks kukosekana licha ya high overall accuracy.
Lengo la study ni kuunganisha model inayochota na kuchagua useful features katika network data automatically na auto-encoder inayowakilisha features hizi katika scales tofauti. Architecture iliyopendekezwa ina two main components:
- AO-CNN: Convolutional neural network inayoungwa mkono na Aquila Optimization Algorithm.
- AMV-AE: Attention-based, multi-wavelet-oriented auto-encoder.
Overall processing flow ya model ikoje?
Kulingana na architecture katika Kielelezo 1, process inaendelea kwa order ifuatayo:
- Network-traffic records zinachukuliwa kutoka NSL-KDD dataset.
- Missing data zinakaguliwa na data zikanormalize kwa min–max method.
- Feature maps zinatolewa kwa one-dimensional CNN.
- Aquila Optimization Algorithm inachagua features zinazochukuliwa kuwa optimal.
- Selected features zinapewa attention-based multi-wavelet auto-encoder.
- Model inaainisha traffic record kama normal au attack.
- Katika multiclass evaluation, traffic inapewa moja ya classes Normal, DoS, Probe, U2R na R2L.
Kielelezo 4 kinawasilisha flowchart yenye detail zaidi; data cleaning, normalization, CNN layers, ReLU, pooling, feature selection kwa Aquila, auto-encoder transformation, wavelet scaling functions, loss calculation na performance evaluation zimeonyeshwa kama sequential steps.
Data zilifanyiwa preprocessing vipi?
Watafiti wanasema missing values katika numerical fields zinaweza kujazwa kwa median, na missing values katika categorical fields kwa most frequent value. Kisha data zinabadilishwa kwenda common range kwa min–max normalization.
Standard min–max normalization ni:
\[ S_n = \frac{S-\min(S)}{\max(S)-\min(S)} \]
Hapa S ni original value, Sn ni normalized value, min(S) ni minimum ya feature na max(S) ni maximum yake.
Katika article, matumizi ya parentheses katika Equation 1 hayako clear na expression ime-typeset kwa namna inayoweza kusomeka kama:
\[ S_n = S-\frac{\min(S)}{\max(S)}-\min(S) \]
Ingawa explanation ya text inaonyesha standard min–max normalization, haijaonyeshwa ni expression ipi iliyocoded katika implementation.
Convolutional neural network inatekeleza kazi gani?
AO-CNN component inatumia one-dimensional convolution layers kujifunza local feature relationships katika preprocessed network records. Intermediate value katika convolution layer imeelezwa katika study kwa general structure ifuatayo:
\[ I_p = \sum_{k=1}^{M} O_k v_{kp} + bias_p \]
\[ U_p = fun(I_p) \]
Hapa Ok inaonyesha values kutoka previous layer, vkp convolution-kernel weights, biasp bias term na Up activated output.
ReLU activation function imetolewa kama:
\[ fun(I_p)=\max(0,I_p) \]
Maximum-pooling layer hupunguza dimension ya feature map kwa kuchagua maximum value katika region fulani:
\[ G_p=\max_{k\in\mathcal{R}} U_p \]
Katika final stages za model, sigmoid imeelezwa kwa binary classification na softmax kwa multiclass classification:
\[ \sigma(I)=\frac{1}{1+e^{-I}} \]
\[ Softmax(I_k)=\frac{e^{I_k}}{\sum_{q=1}^{P}e^{I_q}} \]
Hyperparameter table inaeleza kwamba kuna convolution layers nane na pooling layers sita. Hata hivyo, filter counts, kernel sizes, stride values, feature-map dimensions na full layer order hazijatolewa. Kwa hiyo, architecture haiwezi kureconstructiwa independently bila code.
Aquila Optimization Algorithm inatumikwaje?
Aquila Optimization Algorithm ni meta-heuristic optimization method iliyohamasishwa na behavior ya tai wakati wa kutafuta na kukaribia prey. Katika study, algorithm inatumika kuchagua optimal subset ya features zilizotolewa na CNN kwa ajili ya classification.
Algorithm huanza kwa kutengeneza random candidate population ndani ya bounds:
\[ U_{pq}=j_1(UpB_q-LoB_q)+LoB_q \]
Hapa LoB na UpB zinawakilisha lower na upper bounds za search space, huku j1 ikiwa random value katika range ya 0–1.
Aquila method hubadilika kati ya exploration na exploitation stages wakati wa search. New solutions zinaundwa kwa kutumia best candidate, mean candidate, randomly selected candidate, Lévy flight na spiral-motion terms.
Hata hivyo, article haielezi kikamilifu ni variables zipi zinazoboreshwa na Aquila algorithm. Points zinazobaki unclear ni:
- Kama candidate solution ni binary feature mask au continuous weight vector.
- Kama fitness function inatumia accuracy, number of features au metric nyingine.
- Population size na number of generations.
- Ni features ngapi zilizochaguliwa mwishoni.
- Kama feature selection ilifanywa only kwenye training data.
- Jinsi random initializations na repetitions zilivyodhibitiwa.
Kwa kuwa details hizi hazijatolewa, haiwezekani kutathmini contribution ya AO-CNN kwa performance au kama kuna information leakage kwenda test data.
Auto-encoder inafanyaje kazi?
Auto-encoder ina encoder inayobadilisha input data kuwa lower-dimensional latent representation na decoder inayojaribu kureconstruct original input kutoka representation hiyo.
Main transformations katika study ni:
\[ g=f_t(u^{(1)}y+biases^{(1)}) \]
\[ r=f_n(u^{(2)}g+biases^{(2)}) \]
Hapa y ni input vector, g ni latent feature representation na r ni reconstructed output.
Tofauti na traditional auto-encoder, multi-wavelet scaling functions zinatumika katika hidden units badala ya ordinary sigmoid au ReLU. Watafiti wanadai kwamba hii inaweza kukamata patterns katika different scales kwa non-stationary signals.
Multi-wavelet component inafanya nini?
Study inatumia two-part scaling function. Function ya kwanza:
\[ \varphi_1(s)= \begin{cases} -2s^3+3s^2, & s\in[0,1)\\ (2-s)^2(2s-1), & s\in[1,2]\\ 0, & \text{diğer} \end{cases} \]
imetolewa. Function ya pili inatarajiwa kuwa:
\[ \varphi_2(s)= \begin{cases} -s^2(3s-3), & s\in[0,1)\\ -(2-s)^2(3s-3), & s\in[1,2]\\ 0, & \text{diğer} \end{cases} \]
Inatarajiwa kuwa katika muundo huu.
Katika article, Equation 22 na Equation 23 zote zime-labeliwa kama φ1. Equations zinazofuata na Kielelezo 3 zinaonyesha kwamba function ya pili inapaswa kuwa φ2. Hili ni clear notation error katika methods section.
Kielelezo 3 kinaonyesha scaling functions mbili kwa kila hidden unit na weighted combination yake. Output ya hidden unit inakokotolewa kama:
\[ k_i^{out}=D_{ji-1}k_i^{out1}+D_{ji-2}k_i^{out2} \]
kisha tanh function hutumika kwa reconstruction:
\[ r_j=\tanh\left(\sum_{i=1}^{W} (D_{ji-1}k_i^{out1}+D_{ji-2}k_i^{out2})\right) \]
Methods section inaeleza scaling functions za Strela na Plonka multi-wavelets, huku hyperparameter table ikisema wavelet iliyotumika ni “Haar”. Haijaelezwa jinsi Haar wavelet inavyohusiana na piecewise polynomial functions zilizotolewa katika implementation ileile. Kwa hiyo, haiko clear ni wavelet family ipi iliyotumika kweli.
Attention mechanism ina kazi gani?
Soft-attention module hutoa weights kubwa zaidi kwa regions ambazo zimejifunza kuwa useful zaidi kwa classification badala ya kutoa umuhimu sawa kwa sehemu zote za feature map.
Katika study, attention calculation imetolewa kwa ujumla kama:
\[ F_g=\gamma k\sum_{c=1}^{C}Softmax(We_{ck}^{*}) \]
k inawakilisha feature tensor iliyoundwa na CNN, We trainable attention weights na γ trainable scaling coefficient.
Watafiti wanasema memory na computational cost zinaweza kupunguzwa kwa kupunguza effect ya low-weight features. Hata hivyo, size ya attention layer, exact location yake katika model, number of heads na parameter count hazijaelezwa.
Dataset gani ilitumika?
Model ilitathminiwa kwenye NSL-KDD dataset. Study inaeleza kwamba kuna attack types 21 katika training section na attack types 37 katika test section, na zimegawanywa katika four main attack groups:
- DoS: Denial-of-service attacks.
- Probe: Network na service scanning attacks.
- U2R: Attempts za kupandisha privilege kutoka user kwenda administrator.
- R2L: Attacks zinazolenga kupata local-user access kutoka remote system.
Pamoja na normal traffic, total ya five classes ilitathminiwa. Hata hivyo, exact training na test file names, sample counts, data-splitting method na kama full dataset au subset ilitumika hazijaelezwa.
Confusion matrices zina total ya test records 10.000. Haijaelezwa jinsi number hii ilivyochaguliwa kutoka dataset, kama random sampling ilitumika na kama class ratios zilibadilishwa kutoka original dataset.
Experimental environment ikoje?
| Component | Specification reported katika study |
|---|---|
| Processor | Intel Core i7-4770, 3,40 GHz |
| Memory | 16 GB; 15,9 GB usable |
| System | 64 bit operating system na x64-based processor |
| Programming language | Python |
| Development environment | Spyder |
| Convolution layers | 8 |
| Pooling layers | 6 |
| Activation | ReLU |
| Loss function | Categorical cross-entropy |
| Wavelet | Imeelezwa kuwa Haar |
Ingawa model inadaiwa kuwa low-resource kwa IoT devices, tests hazikufanywa kwenye microcontroller, gateway, mobile processor au edge-computing board. CPU na memory values zilizopatikana kwenye Intel desktop processor hazionyeshi directly consumption kwenye real resource-constrained IoT hardware.
Reported main performance values ni zipi?
| Metric | Value reported katika results section |
|---|---|
| Accuracy | %99,35 |
| Precision | %99,28 |
| Recall | %98,49 |
| F1 score | %98,89 |
| ROC–AUC | 0,99 au 1,00 kulingana na class |
Values hizi zinabadilika katika sections tofauti za text. Kwa mfano, katika explanation ya result graphs, mean accuracy imetolewa kama asilimia 99,3, precision asilimia 99,2 na recall asilimia 98,4, huku katika discussion section order tofauti ikitumika: F measure asilimia 99,3, precision asilimia 99,28, accuracy asilimia 98,4 na recall asilimia 98,89.
Je, equations za performance metrics ni sahihi?
Katika article, accuracy equation imetolewa kwa usahihi:
\[ Accuracy=\frac{TP+TN}{TP+TN+FP+FN} \]
Hata hivyo, kwa precision article imeandika:
\[ Precision=\frac{TP}{TP+TN} \]
na kwa recall tena:
\[ Recall=\frac{TP}{TP+TN} \]
Expressions hizi mbili hazilingani na standard classification definitions. Equations sahihi ni:
\[ Precision=\frac{TP}{TP+FP} \]
\[ Recall=\frac{TP}{TP+FN} \]
zinapaswa kuwa.
Katika article, F1 score imechapishwa kama:
\[ F1=\frac{2\times Precision\times Recall}{Precision\times Recall} \]
Expression hii hutoa result ya 2 katika kila case isiyo zero. Standard F1 equation ni:
\[ F1=\frac{2\times Precision\times Recall}{Precision+Recall} \]
.
Haijaelezwa kama errors hizi ziko tu kwenye typesetting ya article au same formulas zilitumika pia katika software code. Kwa kuwa code haijashirikiwa, jinsi reported metrics zilivyokokotolewa haiwezi kuthibitishwa independently.
Confusion matrices zinaonyesha nini?
Binary normal–attack matrix
Cells katika Kielelezo 12(a) ni hizi:
| Actual class | Predicted normal | Predicted attack |
|---|---|---|
| Normal | 5.302 | 6 |
| Attack | 5 | 4.687 |
Accuracy inayokokotolewa directly kutoka matrix hii ni:
\[ \frac{5302+4687}{5302+6+5+4687} =\frac{9989}{10000}=0{,}9989 \]
yaani asilimia 99,89. Value hii haiendani na asilimia 99,35 katika results section.
Attack ikichukuliwa kama positive class na rows zikionyesha actual classes:
\[ Precision=\frac{4687}{4687+6}\approx99{,}87\% \]
\[ Recall=\frac{4687}{4687+5}\approx99{,}89\% \]
zinapatikana. Hizi pia zinatofautiana na reported precision ya asilimia 99,28 na recall ya asilimia 98,49.
Five-class matrix
| Actual class | Correctly classified | Total actual samples | Class recall calculated from matrix |
|---|---|---|---|
| Normal | 5.302 | 5.306 | Takribani %99,92 |
| DoS | 3.689 | 3.694 | Takribani %99,86 |
| Probe | 923 | 924 | Takribani %99,89 |
| U2R | 2 | 3 | %66,67 |
| R2L | 70 | 73 | Takribani %95,89 |
Katika diagonal ya five-class matrix kuna total ya correct predictions 9.986:
\[ \frac{9986}{10000}=99{,}86\% \]
Value hii pia haiendani na reported overall accuracy ya asilimia 99,35.
Hasa, kuwa na only three actual samples katika U2R class kunaonyesha serious class-imbalance problem. Samples mbili zimeainishwa correctly na sample moja incorrectly. Licha ya hili, text inaripoti recall ya asilimia 98,3 kwa U2R. Ikiwa matrix na text zinawakilisha same experiment result, values hizi mbili haziwezi kuwa sahihi simultaneously.
CPU, memory na inference-time results zinaonyesha nini?
Katika CPU graph, usage inaonekana kubadilika kati ya takribani asilimia 1,1 na asilimia 2,1. Memory usage imewasilishwa kama line stable karibu na asilimia 3,37. Haijaelezwa kama measurements zinaonyesha whole-system usage au Python process pekee, wala zilichukuliwa juu ya sample count gani.
Katika inference-time graph, proposed model inalinganishwa na IRNN, TIKI-TAKA, CSE-IDS na DL-IDS methods. Kadiri feature-pruning ratio inavyoongezeka, proposed method inaonekana kuonyesha shorter time. Hata hivyo:
- Exact inference times hazijatolewa katika table.
- Haijaelezwa kama compared models ziliimplementiwa upya kwenye computer ileile.
- Hakuna mean, median, repetition count wala error bar.
- Caption ya Kielelezo 10 imetumia kimakosa term “accuracy”.
- Haijatolewa kwa detail ni asilimia ngapi ya features na features ngapi zilipruniwa.
Kwa hiyo, claim ya short inference time inaonyesha visual trend lakini haitoi reproducible timing measurement.
Friedman test inaonyesha nini?
Study inaeleza kwamba Friedman test ilitumika kulinganisha accuracy, specificity, false positive rate na AUC results za classifiers. Katika Jedwali 6, p values zimetolewa hivi:
| Metric | F statistic | p value |
|---|---|---|
| Accuracy | 6,52132 | 0,0005 |
| Specificity | 7,017454 | 0,00032 |
| False positive rate | 7,576122 | 0,0002 |
| AUC | 4,94556 | 0,00412 |
Waandishi wanasema null hypothesis ilikataliwa. Hata hivyo, haiko clear blocks katika Friedman test ni nini. Ingawa study inatumia NSL-KDD dataset pekee, inaeleza kwamba kuna data groups nne na algorithms saba. Kwa kuwa repeated experiments, data splits au independent datasets hazijaelezwa, test ilifanywa juu ya observations zipi haiwezi kureconstructiwa.
Katika alpha rows za Jedwali 6 kuna values tofauti 0,11, 0,0022, 0,00021 na 0,0052; katika row inayofuata, hypotheses zote zimeonyeshwa rejected kwa expression “α=0,1”. Table headings na values hizi haziko clear vya kutosha kwa statistical interpretation.
Strengths za study ni zipi?
- Inaunganisha CNN-based feature extraction, meta-heuristic feature selection, multi-wavelet transformation na attention mechanism katika architecture moja.
- Inatathmini binary na multiclass intrusion detection katika study ileile.
- Mbali na accuracy, inazingatia metrics mbalimbali kama precision, recall, F1, ROC, inference time, CPU na memory usage.
- Inawasilisha confusion matrices na kuruhusu class-based results kuchunguzwa.
- Inajaribu kueleza mathematical components za model kwa equations na flowcharts.
- Inajumuisha rare attack classes katika classification problem.
- Ni experimental research iliyochapishwa katika peer-reviewed telecommunications journal.
Main limitations za study ni zipi?
- Precision, recall na F1 score equations zimechapishwa kimakosa.
- Accuracy values zinazokokotolewa kutoka binary na multiclass confusion matrices hazilingani na reported overall accuracy.
- Kwa U2R class, recall inayokokotolewa kutoka matrix ni asilimia 66,67, huku text ikitoa asilimia 98,3.
- Katika sections tofauti za text, accuracy, precision, recall na F1 values zimewasilishwa kwa orders na percentages tofauti.
- Exact training–test split ya dataset na jinsi 10.000-sample test subset ilivyoundwa haijaelezwa.
- Feature encoding, categorical transformation na class-balancing steps hazijaelezwa.
- Fitness function, population size, generation count na selected-feature count za Aquila algorithm hazijatolewa.
- CNN filter counts, kernel sizes, layer dimensions na full architecture hazijaelezwa.
- Training epochs, batch size, learning rate, validation split, early stopping na random-seed information hazijatolewa.
- Methods section inaeleza Strela–Plonka multi-wavelets huku hyperparameter table ikiandika Haar wavelet.
- Second scaling function ime-labeliwa kimakosa tena kama φ1.
- Katika auto-encoder loss equations, square ya reconstruction error haionekani; haijaelezwa kama hii ni typesetting error.
- Model haijaendeshwa kwenye resource-constrained IoT au edge-computing device.
- Ingawa energy efficiency inadaiwa, energy consumption au power measurement haikufanywa.
- Kwa CPU na memory graphs, measurement method, repetition count na uncertainty values hazijatolewa.
- Studies katika comparison table zinatumia datasets na experimental conditions tofauti; kwa hiyo percentages si controlled benchmark.
- Haijaonyeshwa kwa separate experiment kwamba new au previously unseen attacks zimetambuliwa.
- Source code, trained model, selected feature list na experiment scripts hazijashirikiwa.
- Ingawa data-availability statement inasema no new data were created or analyzed, study inafanya analysis juu ya NSL-KDD.
Study ina-support nini?
Study ina-support kwamba network-traffic features zilizotolewa kwa one-dimensional CNN zinaweza kuchaguliwa kwa meta-heuristic algorithm na kuhamishwa kwenda auto-encoder yenye attention na multi-wavelet components. Graphs na matrices zilizowasilishwa zinaonyesha kwamba model iliainisha correctly sehemu kubwa ya test samples zilizotumika.
Pia inaonyesha kwamba different attack classes zinaweza kuainishwa ndani ya architecture ileile na feature selection ina potential ya kupunguza inference time.
Study haithibitishi nini?
- Haithibitishi kwamba model inafanya kazi kwa accuracy ya asilimia 99,35 katika real IoT network.
- Haionyeshi kwa separate experiment kwamba method inatambua previously unseen attacks kwa reliability.
- Haionyeshi kwamba model inageneralize kwa modern au different IoT traffic datasets.
- Haithibitishi kwamba inaweza kufanya kazi real time kwenye resource-constrained IoT device.
- Haionyeshi kwamba inatumia less energy kuliko methods nyingine.
- Haionyeshi contribution ya kila moja kati ya Aquila optimization, attention module na multi-wavelet component kwa performance.
- Haionyeshi kwamba high overall accuracy inamaanisha same success katika rare U2R na R2L attacks.
- Haionyeshi kwamba all compared methods zilipimwa katika same data split, hardware na code environment.
- Haionyeshi kwamba reported metrics zina mathematical consistency na confusion matrices.
Inawezaje kutathminiwa kwa mtazamo wa Uturuki?
Nchini Uturuki, kuenea kwa smart manufacturing, energy systems, urban infrastructures, communication networks na connected devices kunafanya automatic network-traffic monitoring kuwa muhimu. Architecture iliyopendekezwa katika study inaweza kutathminiwa kama starting model katika universities na research laboratories kwa kuchunguza jinsi feature selection, deep learning na attention mechanisms zinavyoweza kutumika katika intrusion detection.
Ili kuhamia kwenye deployment, model inapaswa kufundishwa upya kwa real network protocols zinazotumika Uturuki, institutional networks, industrial IoT traffic na current attack examples. Pia class imbalance, model explainability, false-alarm rate, online updating, data privacy na edge-device resource consumption zinapaswa kupimwa kwa separate experiments.
Mbinu na Matokeo ya Utafiti
Method summary
| Stage | Applied method | Purpose |
|---|---|---|
| Data source | NSL-KDD | Kutoa normal na attack traffic records |
| Cleaning | Missing-value check; proposal ya kujaza kwa median au mode | Kupunguza effect ya missing records |
| Scaling | Min–max normalization | Kuhamisha features kwenda common numerical range |
| Feature extraction | 1D CNN, ReLU na maximum pooling | Kutoa local traffic patterns |
| Feature selection | Aquila Optimization Algorithm | Kuchagua more relevant features |
| Representation learning | Multi-wavelet-oriented auto-encoder | Kuwakilisha data katika scales tofauti |
| Attention | Soft-attention module | Kutoa higher weight kwa important features |
| Classification | Sigmoid au softmax output | Binary au multiclass attack prediction |
Comparison ya classification results
| Result source | Accuracy | Precision | Recall | F1 |
|---|---|---|---|---|
| Abstract na results section | %99,35 | %99,28 | %98,49 | %98,89 |
| Performance descriptions | Takribani %99,3 | Takribani %99,2 | Takribani %98,4 | %98,89 |
| Direct calculation kutoka binary matrix | %99,89 | Takribani %99,87 | Takribani %99,89 | Takribani %99,88 |
| Overall accuracy kutoka five-class matrix | %99,86 | Inahitaji class-based calculation | ||
Values hizi zikichukuliwa kuwa zinatokana na same experiment section, kuna mathematical inconsistency kati yao. Kwa kuwa study haijashiriki raw prediction files, haiwezekani kuamua ni result ipi ni final na sahihi.
Class-based findings
| Class | Actual samples katika matrix | Correct prediction | Incorrect prediction | Recall calculated from matrix |
|---|---|---|---|---|
| Normal | 5.306 | 5.302 | 4 | %99,92 |
| DoS | 3.694 | 3.689 | 5 | %99,86 |
| Probe | 924 | 923 | 1 | %99,89 |
| U2R | 3 | 2 | 1 | %66,67 |
| R2L | 73 | 70 | 3 | %95,89 |
Ingawa overall accuracy inaonekana very high, takribani asilimia 90 ya test data inaundwa na Normal na DoS classes. Kwa kuwa U2R class ina only three samples, one incorrect prediction inapunguza recall kwa asilimia 33,33. Hali hii inaonyesha kwamba kuangalia overall accuracy pekee kunaweza kuficha weakness katika rare attacks.
Compared methods
AMV-AE model iliyopendekezwa katika study imelinganishwa na RNN, CNN-LSTM, traditional auto-encoder, B-stacking, PCA–IHHO–KNN–SVM, LSTM-MAC, federated learning, SS-Deep-ID na other intrusion-detection methods.
| Method | Accuracy quoted katika study |
|---|---|
| PCA, IHHO, KNN na SVM | %95,01 |
| LSTM-MAC, SHA-3, Twofish na GAN | %95,00 |
| MV-FLID | %94,175 |
| SS-Deep-ID na traffic attention | %98,71 |
| Ensemble-based classifier | %97,00 |
| RNN-based method | %92,42 |
| PCO na DNN | %98,40 |
| Passban IDS | %99,00 |
| Regression na ensemble learning | %99,10 |
| Proposed AMV-AE | %99,35 |
Table hii inaunganisha results kutoka publications tofauti. Haijaonyeshwa kwamba methods zote zilirun upya kwenye same training–test split, same preprocessing, same hardware na same class distribution. Kwa hiyo, small percentage differences hazipaswi kutafsiriwa directly kama method superiority.
Missing information kwa reproducibility ya method
| Required information | Status katika study |
|---|---|
| Exact training na test sample counts | Haijaelezwa |
| Categorical-feature encoding | Haijaelezwa |
| Normalization based only on training data | Haijaelezwa |
| Class-balancing method | Haijaelezwa |
| CNN filter na kernel sizes | Haijaelezwa |
| Batch size na training epochs | Haijaelezwa |
| Learning rate na update algorithm | Haijaelezwa |
| Aquila fitness function | Haijaelezwa |
| Selected feature count | Haijaelezwa |
| Random seed na repetition count | Haijaelezwa |
| Exact implementation ya wavelet family | Haar na Strela–Plonka statements hazipatani |
| Source code na trained model | Hazijashirikiwa |
Reliable interpretation limit ya results
Confusion matrices zilizowasilishwa zinaonyesha kwamba model ilitoa idadi kubwa ya correct predictions katika samples zilizochunguzwa. Hata hivyo, kutokulingana kwa values zinazokokotolewa kutoka matrices na summary results katika article kunafanya performance evaluation ihitaji revalidation.
Hasa kwa rare attack classes, macro-average recall, balanced accuracy, class-based precision na confidence intervals zinapaswa kuripotiwa. Kurun model tena chini ya different data splits na random initializations kutaonyesha kama high results zinategemea split moja pekee.
Maelezo ya Chanzo na Mbinu
Jina la asili la study: A Novel Multi-Wavelet Oriented Auto-Encoder for Intrusion Detection in IoT System
Waandishi: Kuruba Madhusudhan; Aravind Kumar Madam.
Author order: Imehifadhiwa jinsi ilivyo katika published article.
Equal contribution au equal first authorship: Haijaelezwa.
Corresponding author: Kuruba Madhusudhan.
Taasisi: Bharatiya Engineering Science and Technology Innovation University, Gorantla, Andhra Pradesh, India; Department of ECE, West Godavari Institute of Science and Engineering, Nallacherla Mandal, Andhra Pradesh, India.
Official publication link:Wiley Online Library article page
Journal: Transactions on Emerging Telecommunications Technologies.
Volume, issue na article number: Volume 36, Issue 7, e70202.
Publication year: 2025.
Source type: Research article inayotengeneza deep-learning-based network intrusion-detection model.
Peer-review status: Ni peer-reviewed journal article.
Submission process: Ilipokelewa 18 May 2024, ikarekebishwa 25 October 2024 na ikakubaliwa 5 January 2025.
Original publisher: John Wiley & Sons Ltd.
Dataset: NSL-KDD.
Funding: Hakuna separate funding statement katika article.
Data availability: Article inasema kwamba no new data were created or analyzed. Hata hivyo, kwa kuwa study inaripoti model training na performance analysis kwenye NSL-KDD dataset, statement hii haiendani waziwazi na method ya study.
Code na model access: Hakuna open link iliyotolewa kwa source code, trained model weights, feature-selection results au experimental configuration files.
Maelezo haya ya Kituruki yameandaliwa kwa kuchunguza text ya study, mathematical equations, tables, architecture diagrams, flowcharts, performance graphs, ROC curves, resource-usage measurements, confusion matrices na statistical analyses. External sources zilitumika only kuthibitisha bibliographic identity information kama DOI, journal, volume, issue, publication date na publisher; scientific performance results ambazo hazikuwepo katika study hazikuongezwa.
Percentage calculations zilizofanywa kwa kutumia confusion matrices katika article ni direct mathematical evaluation ya cell values zilizowasilishwa na study. Calculations hizi zinaonyesha kwamba reported accuracy, precision na recall values hazipatani na matrices. Pia kuna fundamental definition errors katika printed version ya precision, recall na F1 equations. Kwa hiyo, performance claims hazipaswi kuchukuliwa kama finalized application success mpaka code na raw predictions zishirikishwe.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *