

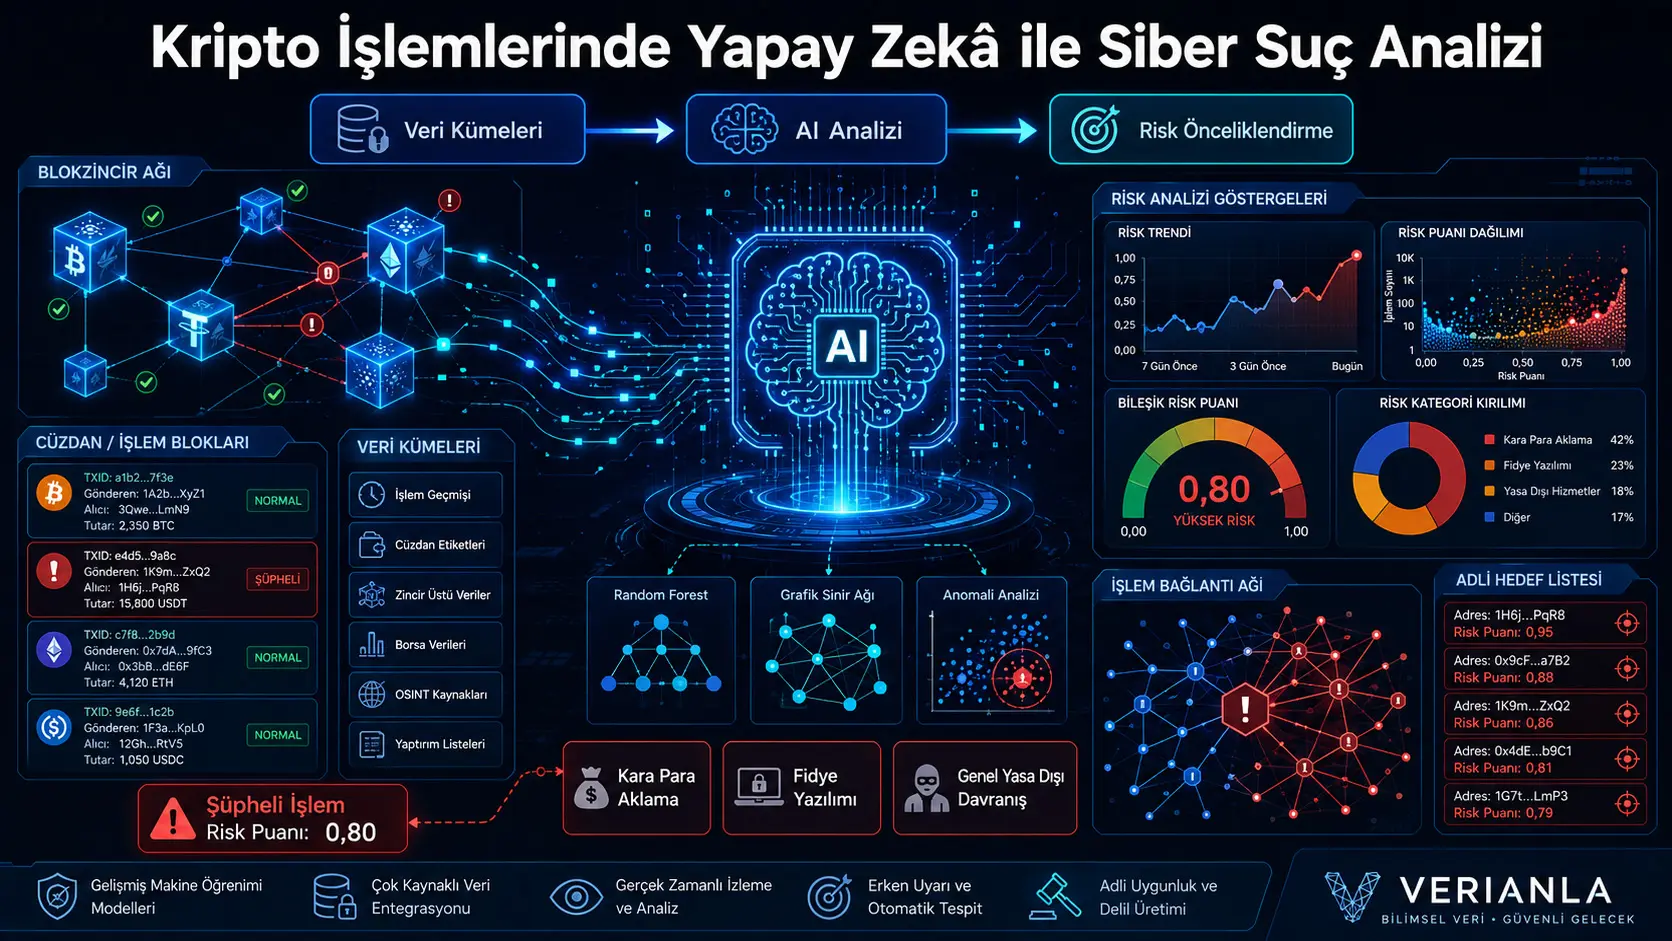
Utafiti huu unaunganisha mbinu tofauti za akili bandia katika mkondo mmoja wa uchambuzi kwa lengo la kubaini mifumo ya kutiliwa shaka katika data ya miamala ya Bitcoin na kuunda orodha ya miamala iliyopangwa kwa kipaumbele inayoweza kutumika katika uchunguzi wa kidijitali wa kiforensiki. Mfumo uliopendekezwa unajumuisha supervised binary classification, semi-supervised graph deep learning, behavioral anomaly analysis na network-based examination ya transaction connections.
Kama chanzo kikuu cha data, Elliptic Bitcoin Dataset yenye miamala 203.769, directed connections 234.355 na features 166 kwa kila transaction ilitumika. Kati ya miamala hii, 42.019 iliwekewa label ya legitimate, 4.545 illicit na 157.205 unknown. BitcoinHeist Ransomware Dataset ilitumika kama chanzo cha ziada kuwakilisha ransomware behaviors, huku IBM AMLSim dataset ikitumiwa kuwakilisha money-distribution na layering patterns.
Katika binary classification, Random Forest yenye decision trees 100 ililinganishwa na K-Nearest Neighbors model. Watafiti waliripoti accuracy ya %98,92, ROC-AUC ya 0,9962 na PR-AUC ya 0,9817 kwa Random Forest. Hata hivyo, confusion matrix ya utafiti yenye legitimate predictions sahihi 8.401, illicit predictions sahihi 796, false positives 3 na false negatives 113 inatoa overall accuracy ya takriban %98,75. Kuna tofauti ndogo lakini isiyoelezwa kati ya %98,92 iliyoripotiwa kwenye maandishi na matrix iliyo kwenye visual.
Graph Convolutional Network ilitumika kuhamisha taarifa iliyojifunzwa kutoka labeled transactions hadi unknown transactions kupitia transaction connections na kuainisha transactions kama legitimate, ransomware-like, money-laundering-like au general illicit behavior. Watafiti waliripoti overall accuracy ya %96 kwa four-class model. Hata hivyo, ransomware na money-laundering classes hazikuundwa kutoka verified forensic-case labels. Ransomware label ilitegemea transaction weight fulani kuwa juu ya median, huku money-laundering label ikitegemea fan-out value kuwa juu ya median. Kwa hiyo, performance ya model katika classes hizi inaonyesha kwa kiasi kikubwa uwezo wake wa kujifunza upya heuristic labels zilizoundwa na watafiti.
Random Forest probability, illicit-transaction probability kutoka graph network na Isolation Forest anomaly score ziliunganishwa kuunda Composite Risk Score kati ya 0 na 1. Watafiti waliweka transactions 10.188 kama high risk; wakazigawa kuwa ransomware-like 4.893, money-laundering-like 3.627 na general illicit transaction candidates 1.668. Nambari hizi haziwakilishi confirmed criminal transactions, bali records zilizopangwa na model kama investigation candidates.
Kwa mtazamo wa Uturuki: Architecture ya utafiti inaweza kutathminiwa kama research prototype kwa transaction-monitoring systems za crypto-asset service providers, financial-crime investigations, cyber-incident examinations na digital-evidence prioritization nchini Uturuki. Hata hivyo, kabla ya matumizi lazima ifanyiwe retraining na independent testing kwa legally verified local data inayowakilisha transaction structure na current crime types za Uturuki. False-positive rates za risk scores, stability yake kwa muda, explainability na compatibility na chain of custody vinapaswa kutathminiwa. Ingawa mfumo huu unategemea moja kwa moja on-chain numerical data tofauti na French au English text classification, haiwezekani kutoa hitimisho la moja kwa moja kuhusu current transactions za Uturuki, blockchains nyingine au watu fulani kutokana na historical Bitcoin patterns za Elliptic dataset. Model outputs hazipaswi kutumika peke yake kwa account freezing, criminal allegation au personal-identity attribution.
Lengo kuu la utafiti ni nini?
Utafiti unalenga kubadilisha public blockchain records kuwa structured risk information ambayo investigators wanaweza kutumia. Ingawa transactions zinaonekana kwenye blockchain, wallet na transaction identifiers hazionyeshi watu halisi moja kwa moja. Manual examination ya transaction networks zenye millions of nodes na connections pia haiwezekani kwa vitendo.
Watafiti wanahoji kwamba traditional fixed rules zinaweza kushindwa kuadapt kwa new fund-hiding, address-changing na transaction-layering behaviors. Framework iliyopendekezwa inashughulikia tatizo hili kwa kuunganisha analytical perspectives nne tofauti:
- Supervised classification inayotenganisha legitimate na illicit kupitia labeled transactions,
- Semi-supervised graph learning inayotumia connections kati ya transactions,
- Anomaly analysis inayotafuta unusual behaviors bila kuhitaji preassigned labels,
- Network examination inayoonyesha direct na indirect connections kuzunguka suspicious transaction.
End-to-end pipeline iliyopendekezwa
Kielelezo 2 kwenye ukurasa wa 7 wa utafiti kinaonyesha components zote za mfumo ndani ya flow moja. Datasets tatu kwanza zinaingia katika data preprocessing na feature engineering. Processed data kisha inagawanywa katika branches tatu za parallel:
- Supervised classification kwa Random Forest na KNN,
- Graph-based classification kwa two-layer Graph Convolutional Network,
- Unsupervised examination kwa t-SNE, anomaly scoring na k-hop connection analysis.
Results kutoka branches hizi tatu zinaunganishwa katika forensic similarity au risk score, transactions zinapangwa kwa risk, na probable behavior type pamoja na automated explanation hutengenezwa kwa kila transaction. Katika stage ya mwisho, output ya mfumo inaonyeshwa kama review list ambayo law-enforcement au financial-crime investigators wanaweza kutathmini.
Schema hii inatoa integrated architecture kimawazo. Hata hivyo, haipaswi kudhaniwa kwamba components tofauti zinatoa completely independent evidence juu ya data ile ile. Random Forest na graph network hutumia Elliptic features zile zile, na baadhi ya crime-type labels huundwa pia kutoka thresholds zinazotumika kwenye features hizi. Kwa hiyo, high agreement kati ya components inaweza kutokana kwa sehemu na common data na common label-generation process.
Ni datasets zipi zilitumika?
| Dataset | Scope katika utafiti | Jukumu katika utafiti |
|---|---|---|
| Elliptic Bitcoin Dataset | Transactions 203.769, directed connections 234.355, features 166 na time steps 49 | Main data source kwa binary classification na graph network |
| BitcoinHeist Ransomware Dataset | Bitcoin addresses zinazohusishwa na ransomware | Kusaidia behavior features zinazofanana na ransomware |
| IBM AMLSim | Synthetic money-laundering transactions | Kusaidia fund-distribution na fan-out-based behavior features |
Katika Elliptic dataset, transactions zinawakilishwa kama directed graph. Kila node ni Bitcoin transaction na kila edge inaonyesha fund flow kati ya transactions. Katika baadhi ya sehemu za utafiti nodes zinaelezwa kama “wallet addresses”, wakati katika methods na data description nodes ni transactions. Kutumia dhana za transaction node na wallet address kwa kubadilishana katika baadhi ya sehemu kunafanya entity level ambayo mfumo unatoa matokeo kuwa isiyo wazi.
Data classes hazina balance kwa kiwango gani?
| Class | Transaction count | Approximate share ya total |
|---|---|---|
| Unknown | 157.205 | %77,15 |
| Legitimate | 42.019 | %20,62 |
| Illicit | 4.545 | %2,23 |
Kielelezo 1 kwenye ukurasa wa 5 wa utafiti kinaonyesha imbalance hii kubwa wazi. Unknown transactions ndilo kundi kubwa zaidi, huku illicit transactions zikiwa minority ndogo sana. Wakati supervised models zilipofundishwa, unknown class iliondolewa na labeled transactions 46.564 zilizobaki zilitumika.
Kwa kuwa legitimate transactions ni takriban mara tisa zaidi ya illicit transactions, kuangalia overall accuracy pekee kunaweza kupotosha. Watafiti walijaribu kupunguza tatizo hili kwa kutumia stratified sampling katika training na test sets na kuweka class weight ya Random Forest kuwa “balanced”.
Preprocessing na feature engineering zilifanywaje?
Elliptic data ilipakiwa kutoka files tatu: feature table, class table na directed edge list. Kwa supervised classification, unknown transactions ziliondolewa na numerical features zikascalewa kwa StandardScaler ili ziwe na mean ya zero na standard deviation ya one.
Watafiti waliunda network-based features walizoziita “Behavioral Bridge”. Muhimu zaidi ni Bitcoin fan-out value. Fan-out inaonyesha source transaction imeunganishwa na destination transactions ngapi tofauti. Ilidhaniwa kwamba funds zinazosambazwa kwa destinations nyingi zinaweza kufanana na layering behavior katika money laundering.
Hata hivyo, high fan-out haionekani katika illicit behavior pekee. Utafiti wenyewe unakubali kwamba heavily active legitimate exchange transactions zinaweza pia kutoa high fan-out. Kwa hiyo, fan-out peke yake si proof ya money laundering wala reliable crime-type label.
Random Forest na KNN models ziliundwaje?
Random Forest model iliundwa kwa decision trees 100. Sababu za kuichagua zilikuwa uwezo wa kufanya kazi na high-dimensional data, kujifunza nonlinear patterns, kuwa resistant zaidi kwa overfitting kuliko single decision tree na kutoa feature-importance values.
K-Nearest Neighbors ilitumika kama comparison model. Data iligawanywa kwa stratified split ya %80 training na %20 test. Utafiti unaeleza kwamba split hii ilifanywa kwa class proportions, si kwa time steps.
Kwa sababu Elliptic dataset ina time steps 49, random na stratified split inaweza kuruhusu similar transactions kutoka periods zile zile kuenea katika training na test sets. Utafiti hautoi separate forward-time test iliyofundishwa kwenye past time steps na kujaribiwa kwenye later time steps. Kwa hiyo haijaonyeshwa model itageneralize kwa kiwango gani kwenye future transaction behaviors.
Graph Convolutional Network inafanyaje kazi?
Wakati Random Forest inatathmini kila transaction record hasa kupitia independent features, Graph Convolutional Network hutumia pia taarifa za neighbors ambazo transaction imeunganishwa nazo. Graph layer ya kwanza hubadilisha transaction features za dimensions 166 kuwa hidden representation ya dimensions 64:
\[ 166 \longrightarrow 64 \]
Baada ya transformation hii, ReLU nonlinear function hutumika. Layer ya pili hubadilisha representation ya dimensions 64 kuwa output classes:
\[ 64 \longrightarrow C \]
Hapa kwa binary model \(C=2\), na kwa multiclass model \(C=4\). Log-softmax ilitumika kwenye output. Model huhesabu loss kwa labeled training nodes pekee, lakini kupitia graph connections hutumia pia neighborhood structure ya unknown nodes.
Binary GCN ilifundishwa kwa epochs 100 na multiclass GCN kwa epochs 50. Adam optimizer na learning rate ya 0,01 zilitumika; negative log-likelihood ilitumika kama loss function.
Crime-type labels nne ziliundwaje?
Classes nne ni:
- Legitimate transaction,
- Ransomware-like transaction,
- Money-laundering-like transaction,
- General illicit transaction.
Basic legitimate-versus-illicit separation inategemea labels za Elliptic dataset. Hata hivyo, subtypes za illicit class hazikutolewa kutoka verified incident records. Watafiti waliunda subclasses kwa rules hizi:
- Ransomware-like: Ikiwa normalized transaction weight inayoitwa feat_0 katika Elliptic dataset iko juu ya median ya illicit transactions,
- Money-laundering-like: Ikiwa fan-out value iko juu ya median ya illicit transactions,
- General illicit: Illicit transactions nyingine zisizoingia katika rules mbili zilizotangulia.
Mbinu hii ina maana kwamba model haikujifunza real na independent crime-type labels. GCN kwanza ilifundishwa kwa labels zilizotokana na threshold rules zilizowekwa na watafiti, kisha ikatabiri labels hizi kwa kutumia features za aina hiyo hiyo. Critical evaluation section kwenye ukurasa wa 15 wa utafiti inakubali circularity hii wazi.
Unsupervised behavioral analysis ilifanywaje?
High-dimensional transaction features zilipunguzwa kuwa two-dimensional plane kwa t-SNE. t-SNE ni dimensionality-reduction method inayoweza kufanya records zinazofanana kuonekana karibu katika two-dimensional visual. Utafiti unaita hili “behavioral clustering”; hata hivyo, hakuna separate clustering algorithm, cluster-count selection au quantitative cluster-validity metric kama silhouette score iliyoripotiwa.
Kwa hiyo, separations katika t-SNE visuals hazipaswi kutafsiriwa kama independently verified natural crime clusters. t-SNE settings, random initialization na local-neighborhood structure vinaweza kuathiri visual shape.
Isolation Forest anomaly score ni nini?
Isolation Forest ilitumika kubaini transactions zinazotofautiana na nyingine bila kutegemea label. Model iliundwa kwa trees 100 na contamination ikawekwa %5. Threshold ya 0,413 ilichaguliwa kulingana na percentile ya %95 ya score distribution.
Kuweka contamination kuwa %5 kunamaanisha kwamba karibu %5 ya data imeamuliwa mapema katika method design kukubaliwa kama anomaly. Ratio hii haionyeshi kwamba %5 ya real transactions imehusishwa na crime.
Composite Risk Score inahesabiwaje?
Utafiti unaunganisha outputs tatu za model kwa weighted formula ifuatayo:
\[ CRS(v) = 0{,}4\,RF_{\mathrm{prob}}(v) + 0{,}4\,GCN_{\mathrm{illicit}}(v) + 0{,}2\,BEH_{\mathrm{score}}(v) \]
Hapa:
- \(RF_{\mathrm{prob}}\) inaonyesha illicit-class probability ya Random Forest,
- \(GCN_{\mathrm{illicit}}\) inaonyesha illicit-class probability ya graph network,
- \(BEH_{\mathrm{score}}\) inaonyesha Isolation-Forest-based behavioral anomaly score.
Risk levels zimefafanuliwa kwa thresholds hizi:
| Risk level | Threshold iliyotumika katika utafiti |
|---|---|
| Low risk | CRS < 0,30 |
| Elevated risk | 0,30 ≤ CRS < 0,65 |
| High risk | CRS ≥ 0,65 |
Weights za %40, %40 na %20 ni design choices za watafiti. Utafiti hauonyeshi kwamba weights hizi zilikuwa optimized kwenye independent validation set, zilinganishwa na weights tofauti au probability calibration ilifanywa. Hali hiyo hiyo inatumika kwa risk thresholds za 0,30 na 0,65.
Hidden connection analysis inafanywaje?
Nodes kuzunguka transaction iliyochukuliwa kuwa suspicious zilibainishwa kwa PyTorch Geometric k-hop subgraph extraction function. Subgraph ilibadilishwa kuwa NetworkX structure kwa lengo la kuhesabu network metrics kama node degree, betweenness centrality na PageRank.
Kielelezo 9 kwenye ukurasa wa 14 wa utafiti kinaonyesha transaction network kuzunguka labeled illicit nodes sita. Red nodes zinaonyesha illicit, green nodes legitimate na gray nodes unknown. Visual inaonyesha kwamba suspicious nodes zimeunganishwa si tu na suspicious nodes nyingine, bali pia na legitimate na unknown nodes.
Legitimate node kuunganishwa na illicit-labeled node hakumaanishi kwamba node hiyo au mtu anayehusishwa nayo amefanya crime. Exchanges, payment services, intermediary addresses au ordinary counterparties zinaweza kuonekana katika network hiyo hiyo.
“Live inference” ina maana gani?
Live inference function katika utafiti hutoa class, risk score, probable typology na explanation kwa kuingiza transaction ID na 166-dimensional feature vector katika trained model. Hii inaonyesha kwamba instant prediction inaweza kufanywa ndani ya software function moja.
Hata hivyo, utafiti hautoi continuous monitoring service iliyounganishwa na real blockchain stream, transaction throughput kwa second, end-to-end latency, network-outage behavior au production-environment test. Kwa hiyo, “real-time” inapaswa kueleweka kama functioning prototype function, si measured operational-system performance.
Nguvu za utafiti ni zipi?
- Unaunganisha analytical approaches tatu tofauti katika processing pipeline moja.
- Unatumia network connections pamoja na transaction features.
- Unatoa numerical testing kwenye large na public Bitcoin dataset.
- Unaripoti precision, recall, F1, ROC-AUC na PR-AUC pamoja na overall accuracy.
- Unafanya model behavior ionekane kwa sehemu kupitia confusion matrix na feature-importance graph.
- Unalenga kutathmini unlabeled transactions kupitia graph connections.
- Unashiriki source code na links za datasets zilizotumika.
- Unakubali wazi katika limitations section kwamba crime-type labels zake si verified real reference.
Utafiti hauthibitishi nini?
- Hauthibitishi kwamba transactions zilizowekwa high risk na model ni criminal transactions kweli.
- Hauunganishi transaction na mtu halisi au organization fulani.
- Haionyeshi kwamba ransomware na money-laundering typologies zimetambuliwa kwa independent verified forensic labels.
- Haionyeshi kwamba model itafikia accuracy ile ile kwenye current Bitcoin transactions au blockchains nyingine.
- Haithibitishi kwamba multiclass performance ya %96 inawakilisha separation ya real crime types.
- Haionyeshi kwamba risk scores zinatimiza legal-evidence standard.
- Haitoi measured real-time performance katika live blockchain monitoring system.
- Haitathmini consequences za false positives kwa real people au organizations.
- Haionyeshi kwamba model ni robust kwa transaction patterns zilizobadilishwa au kufichwa kwa makusudi.
Mbinu na Matokeo ya Utafiti
Data na experiment configuration
| Method component | Configuration iliyoripotiwa katika utafiti |
|---|---|
| Main dataset | Elliptic Bitcoin Dataset |
| Transaction count | 203.769 |
| Graph connection | 234.355 directed edges |
| Feature count | 166 |
| Time step | 49 |
| Labeled transactions | 46.564 |
| Unknown transactions | 157.205 |
| Training-test split | %80 / %20, stratified |
| Scaling | StandardScaler |
| Execution environment | Google Colaboratory na GPU acceleration |
Random Forest na KNN results
| Metric | Random Forest | KNN |
|---|---|---|
| Overall accuracy iliyoripotiwa kwenye maandishi | %98,92 | %97,75 |
| Illicit-class precision | 1,000 | 0,890 |
| Illicit-class recall | 0,876 | 0,878 |
| Illicit-class F1 score | 0,934 | 0,884 |
| Micro-F1 | 0,989 | 0,978 |
| ROC-AUC | 0,996 | 0,964 |
| PR-AUC | 0,9817 | Haijaripotiwa katika utafiti. |
Random Forest ilitoa results za juu kuliko KNN katika comparison metrics zote za utafiti. Hasa, illicit-class precision kuripotiwa kuwa 1,000 kunahusishwa na false positives chache sana katika test set. Hata hivyo, recall ni 0,876; yaani sehemu ya transactions zilizo labeled illicit ziliainishwa kuwa legitimate.
Confusion matrix inaonyesha nini?
| Actual class | Legitimate prediction | Illicit prediction |
|---|---|---|
| Legitimate | 8.401 | 3 |
| Illicit | 113 | 796 |
Kulingana na matrix hii, kati ya test samples 9.313, 9.197 ziliainishwa kwa usahihi:
\[ \mathrm{Doğruluk} = \frac{8401+796}{8401+3+113+796} \approx 0{,}9875 \]
Value hii ni takriban %98,75. %98,92 iliyotajwa katika maandishi ya utafiti si sawa na value inayohesabiwa kutoka matrix. Haijaelezwa kama tofauti inatokana na separate experimental run, rounding au visual kuwa ya result set tofauti.
Approximate values zinazohesabiwa kutoka matrix kwa illicit class ni:
\[ \mathrm{Kesinlik} = \frac{796}{796+3} \approx 0{,}996 \]
\[ \mathrm{Duyarlılık} = \frac{796}{796+113} \approx 0{,}876 \]
\[ F1 \approx 0{,}932 \]
Hizi ziko karibu na 1,000 precision, 0,876 recall na 0,934 F1 zilizotolewa kwenye table ya utafiti; tofauti ndogo zinaweza kutoka rounding au separate runs.
ROC na precision-recall graphs
Kielelezo 3 kwenye ukurasa wa 9 wa utafiti kinaonyesha ROC curve ikisogea karibu na upper-left corner na AUC ya 0,9962. Precision-recall curve pia inaonyesha high precision katika wide recall range na area ya 0,9817.
Results hizi zinaonyesha kwamba model ilitenganisha legitimate na illicit Elliptic labels kwa nguvu katika test split iliyotumika. Hata hivyo, high performance iliyopatikana kwenye records zilizogawanywa randomly kutoka periods zile zile haihakikishi same success kwenye future time steps au new crime methods.
Feature importance graph
Kielelezo 5 kwenye ukurasa wa 11 kinaonyesha features 15 zenye athari kubwa zaidi katika Random Forest. Highest importance values ni za feat_52 na feat_89, zikifuatiwa na feat_42 na feat_40.
Hata hivyo, kwa sababu baadhi ya features katika Elliptic dataset zinawasilishwa kwa anonymized names, direct real-world meaning yake haijaelezwa kwa kina katika utafiti. High feature-importance value peke yake haitoi causal relationship wala forensic explanation.
Four-class GCN results
| Class | F1 score iliyoripotiwa |
|---|---|
| Legitimate | %97,2 |
| Ransomware-like | %93,4 |
| Money-laundering-like | %91,8 |
| General illicit | %94,2 |
| Overall accuracy | %96 |
Ratios hizi zinaonyesha kwamba graph network iliweza kutenganisha labels nne zilizoundwa. Lakini kwa sababu illicit subtypes tatu zilitolewa kutoka feature thresholds badala ya verified real references, results hazipaswi kuwasilishwa kama success ya real crime-type recognition.
Forensic intelligence map
Kielelezo 6 kwenye ukurasa wa 12 kinaonyesha ransomware na money-laundering regions kwa colored boundaries katika t-SNE-like two-dimensional behavioral space. Transactions zenye confidence score ya zaidi ya %70 zinaonyeshwa kwa markers kubwa zaidi.
Map inaweza kutoa visual prioritization; hata hivyo, region boundaries zilizochorwa hazitegemei independent forensic validation. Points zinazoonekana tofauti katika visual zinaathiriwa na placement iliyoundwa na two-dimensional reduction method.
Inconsistency katika temporal analysis
Kielelezo 8 kwenye ukurasa wa 13 kinaonyesha idadi ya unknown transactions zilizowekwa suspicious katika time steps 49. Figure title na text zinasema kuna peaks za takriban transactions 1.750 katika time steps 19–21 na takriban 1.470 katika time step 33.
Kinyume chake, vertical axis na plotted points za graph zinaonyesha takriban 2.300–2.800 katika time steps 20–22 na takriban 3.200 katika time step 33. Nambari za graph na figure description hazilingani kwa kiasi kikubwa.
Zaidi ya hayo, watafiti wanasema periods hizi zinaweza kuwa “high criminal activity au coordinated attack campaigns”. Hata hivyo, time steps hazijamapishwa na real event records. Kwa hiyo, data ya utafiti haithibitishi kwamba increases kwenye graph zinahusiana na specific crime campaigns.
Connection-network results
| Network finding | Value iliyoripotiwa |
|---|---|
| Connections kutoka illicit nodes kwenda unknown nodes | 1.458 |
| Connections kutoka illicit nodes kwenda legitimate nodes | 915 |
| Direct connections za highest-risk transaction hub | 672 |
Watafiti wanahusisha network structure hii na multi-step fund transfer na matumizi ya intermediary addresses. Hata hivyo, connection count peke yake haithibitishi money-laundering behavior. Hasa, high-volume services na exchanges zinaweza naturally kuunda legitimate connections nyingi.
High-risk transaction list
| Category iliyotolewa na model | Transaction count |
|---|---|
| Ransomware-like | 4.893 |
| Money-laundering-like | 3.627 |
| General illicit | 1.668 |
| Total high risk | 10.188 |
Kielelezo 10 kwenye ukurasa wa 15 kinaonyesha sample list ya transactions zenye highest scores. Kila row ina transaction ID, risk score, suspicious status, probable typology na short automated rationale.
High-risk transaction count ni kubwa kuliko verified illicit labels 4.545 katika dataset. Sababu ni kwamba model pia inaweka unknown transactions kuwa risk. Hata hivyo, unknown transaction kuonekana high risk kwa model hakumaanishi kwamba real reference label imepatikana.
Reproducibility na taarifa zinazokosekana
Utafiti unashiriki code repository, main datasets na implementation notebook. Hii inarahisisha review na rerunning ya method.
Hata hivyo, details zifuatazo hazijaripotiwa kikamilifu katika main text:
- Number of neighbors na distance metric iliyotumika kwa KNN,
- Maximum depth na tree parameters nyingine za Random Forest,
- Random seeds,
- Mean na standard deviations across multiple runs,
- Regularization, dropout na weight-loss details kwa GCN,
- t-SNE perplexity, learning rate na random initialization settings,
- Probability-calibration method ya model,
- Sensitivity analysis ya Composite-score weights,
- Latency na throughput ya live inference,
- Independent external validation kwenye dataset nyingine.
General scientific assessment
Result yenye nguvu zaidi katika utafiti ni high binary-classification performance ya Random Forest kwenye labeled test partition ya Elliptic dataset. Kuongeza graph structure, anomaly score na network visualization katika pipeline hiyo hiyo pia kunatoa practical prototype approach kwa investigation prioritization.
Limitation kubwa zaidi ni kwamba crime types ziliundwa kutoka feature thresholds za watafiti badala ya verified real references. Hii inazuia result ya %96 ya four-class GCN kutafsiriwa kama independent success ya kutenganisha real ransomware, money laundering na other illicit transactions.
Limitation muhimu ya pili ni matumizi ya random na stratified training-test split kwa data yenye time-series nature. Generalization kwa future periods inapaswa kuonyeshwa kwa time-based evaluation inayofundishwa kwenye past time steps na kujaribiwa kwenye later steps.
Tatu, weights na thresholds katika composite risk score hazijawekwa kulingana na validated operational costs. Possible impact ya false-positive marking kwenye investigation resources, customer accounts na real people haijatathminiwa.
Kwa hiyo, mfumo unapaswa kutathminiwa si kama automatic crime-detection tool, bali kama experimental decision-support prototype inayopanga transactions kwa review ya human expert.
Dokezo la Chanzo na Mbinu
| Source identity field | Taarifa iliyothibitishwa |
|---|---|
| Jina kamili la awali la utafiti | AI-Driven Cryptocurrency Transaction Analysis for Cybercrime Intelligence |
| Waandishi na mpangilio | 1. Norah Rashed Alshamri; 2. Seokhee Lee |
| Co-first author | Hakuna equal-contribution au co-first-authorship statement. |
| Corresponding author | Seokhee Lee |
| Institution | Department of Cybersecurity and Digital Forensics, Center for Cybercrime and Economic Crime, Naif Arab University for Security Sciences, Riyadh, Saudi Arabia |
| Norah Rashed Alshamri ORCID | 0009-0004-5967-4015 |
| Seokhee Lee ORCID | 0009-0007-6142-7891 |
| DOI | 10.2139/ssrn.7004983 |
| Journal | Hakuna taarifa kwamba imechapishwa katika peer-reviewed journal fulani. |
| Publisher | Hakuna peer-reviewed journal publisher information. Faili ina kauli “Preprint submitted to Elsevier”. |
| Publication platform | SSRN |
| Publication year | 2026 |
| SSRN upload date | 26 Juni 2026 |
| Page count | 17 |
| Source type | Experimental research preprint yenye machine learning, graph neural network na behavioral analysis |
| Peer-review status | Haijapitia peer review. |
| Official study link | Ukurasa rasmi wa utafiti wa SSRN |
| Implementation code | GitHub source-code repository |
| Conflict of interest | Waandishi wamesema hakuna known financial conflict of interest au personal relationship. |
| Institutional support | Waandishi wameishukuru NAUSS kwa institutional support; hakuna separate funding source iliyotajwa. |
Utafiti huu ni preprint ambayo haijapitia peer review. DOI inatambulisha SSRN study record na haipaswi kuwasilishwa kama DOI ya peer-reviewed journal article. Kuandaliwa kwa Elsevier format au kuwasilishwa kwa Elsevier hakumaanishi acceptance au peer-reviewed publication.
Scientific content ya makala hii ya Verianla imeandaliwa kwa msingi wa utafiti uliopakiwa pekee. External sources zilitumiwa tu kwa bibliographic verification ya author order, corresponding author, institution, DOI, SSRN upload date, official study page na code repository. Hakuna additional experimental result au external performance finding ambayo haipo katika utafiti iliyoongezwa.
Results za utafiti hazionyeshi kwamba transactions zenye high risk score ni criminal activity au kwamba real person yeyote amefanya crime. Model outputs ni probabilistic na experimental review priorities. Legal assessment ya transaction inahitaji independent sources, verified wallet attribution, exchange records, evidence integrity na authorized human review.
Main methodological limitations ni: crime-type labels zimetengenezwa kutoka heuristic thresholds badala ya verified real reference; random training-test split haionyeshi temporal generalization; risk weights na thresholds hazijathibitishwa; t-SNE visuals hazina quantitative cluster validation; live-system latency haijapimwa; na results zinategemea historical Bitcoin dataset moja.
Kuna unexplained difference kati ya overall accuracy ya %98,92 iliyoripotiwa kwa Random Forest na approximate accuracy ya %98,75 inayohesabiwa kutoka confusion matrix iliyowasilishwa. Values katika temporal suspicious-transaction graph pia hazilingani na peak counts zilizotajwa katika figure description. Inconsistencies hizi zinapaswa kuzingatiwa wakati wa kutafsiri results.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *