

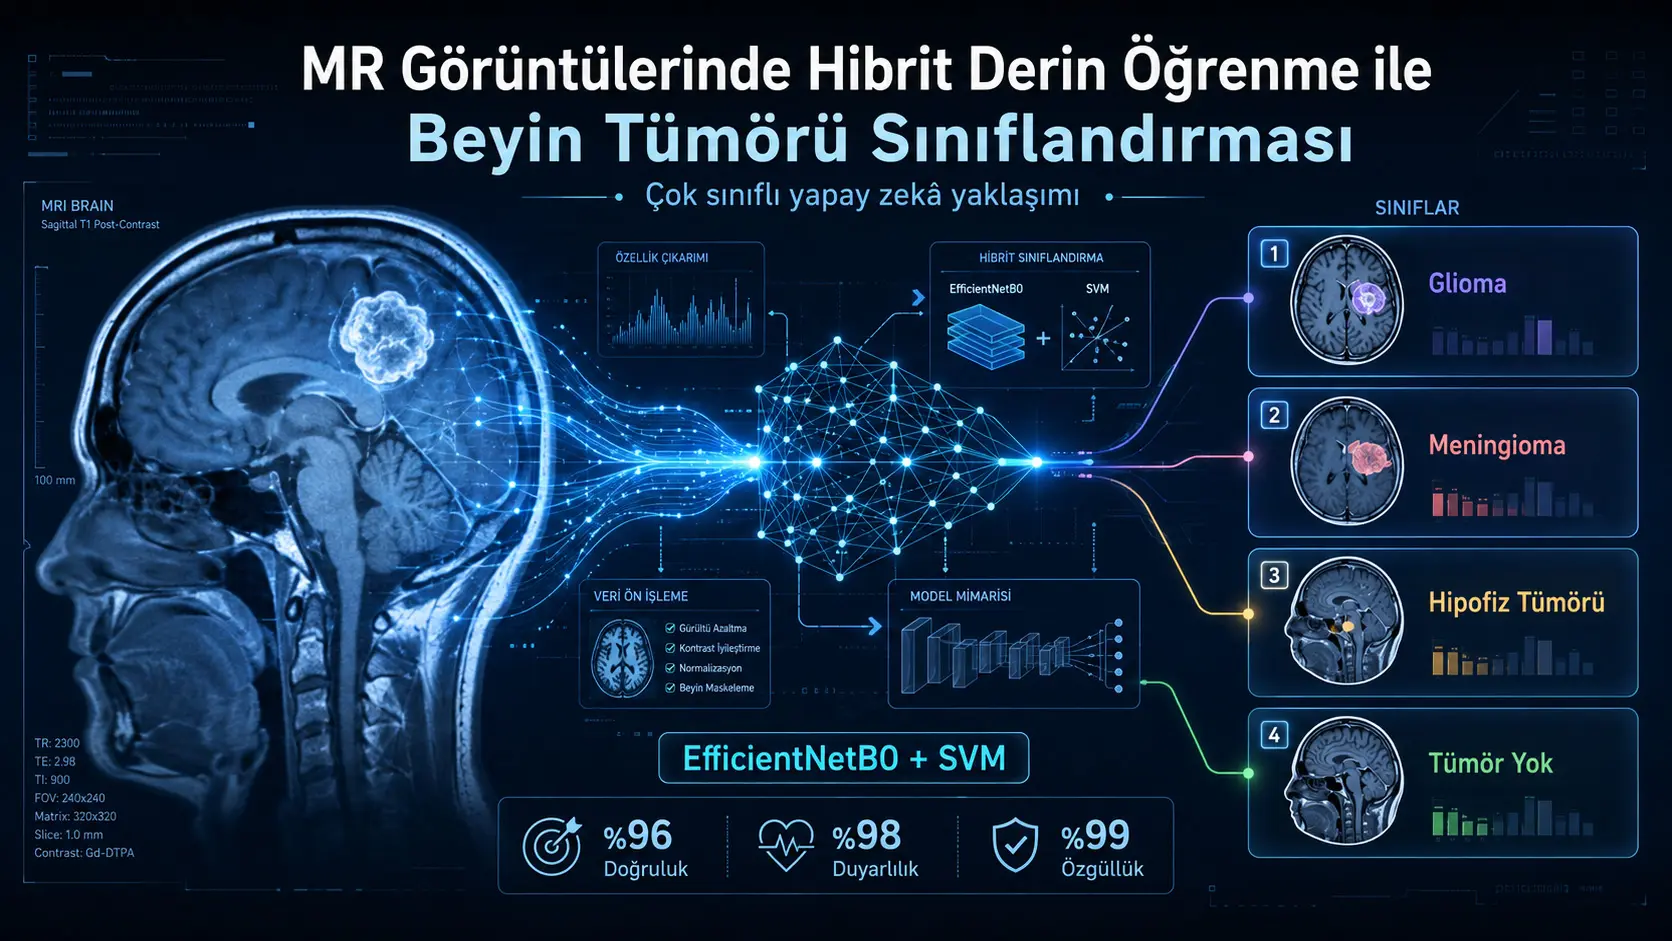
Utafiti huu ulilinganisha modeli za ujifunzaji wa kina zinazotegemea EfficientNetB0 na modeli mseto za ujifunzaji wa mashine kwa ajili ya kuainisha picha za miale ya sumaku ya ubongo katika madarasa manne: glioma, meningioma, uvimbe wa pituitari na picha zisizo na uvimbe. Jumla ya picha 7.023 za MRI zilizokusanywa kutoka vyanzo vya data huria vya Figshare, SARTAJ na BR35H zilitumika. Watafiti walilinganisha modeli huru ya EfficientNetB0 iliyoboreshwa kwa fine-tuning na modeli nne mseto zinazohamisha sifa za kina zilizotolewa na EfficientNetB0 kwenda kwa waainishaji wa Support Vector Machine, K-Nearest Neighbours, Random Forest na Multilayer Perceptron.
Kulingana na jedwali kuu la utendaji, modeli huru ya EfficientNetB0 ilipata usahihi wa %95, unyeti wa %98 na umaalumu wa %99. Usahihi wa juu zaidi kwa ujumla ulionekana katika modeli mseto inayounganisha kitoa sifa cha EfficientNetB0 na mwainishaji wa Support Vector Machine; kwa modeli hii, usahihi wa %96, unyeti wa %98 na umaalumu wa %99 uliripotiwa. Modeli ya EfficientNetB0+MLP ilipata usahihi wa %94, modeli ya EfficientNetB0+KNN %93 na modeli ya EfficientNetB0+Random Forest %88.
Matokeo yanaonyesha kuwa kuainisha sifa za picha zilizojifunzwa na EfficientNetB0 kwa kutumia SVM kunaweza kuongeza usahihi wa jumla kwa takriban nukta moja ya asilimia ikilinganishwa na modeli huru. Hata hivyo, kuna thamani zisizolingana kati ya jedwali kuu la utendaji, jedwali la matokeo kwa kila darasa na jedwali la uwezo wa kupanuka katika makala. Aidha, idadi za uongezaji data, mgawanyo wa modeli na hatua zinazojumuishwa katika muda wa uchakataji hazijaelezwa kikamilifu.
Utafiti huu si jaribio la utambuzi wa kliniki. Data zilizotumika ni za nyuma-kihistoria na zimetolewa kutoka seti za data huria; hakukufanyika uthibitishaji wa nje kutoka hospitali huru, utafiti wa kliniki wa mbele, ulinganisho na wataalamu wa radiolojia, wala tathmini katika mtiririko halisi wa kazi wa mgonjwa. Modeli haiamui daraja la uvimbe, hatua ya saratani, aina ndogo ya molekuli, mwitikio wa matibabu au ubashiri wa mgonjwa. Inaweka tu picha iliyowasilishwa katika mojawapo ya madarasa manne ya picha.
Umuhimu unaowezekana kwa mtazamo wa Uturuki
Katika utafiti huu hakukutumika data za mgonjwa, hospitali au kifaa cha MRI kutoka Uturuki. Hata hivyo, mbinu hii inatoa mfano unaoweza kubadilishwa kwa tafiti za uchanganuzi wa picha unaosaidiwa na kompyuta ambazo zinaweza kufanywa nchini Uturuki katika radiolojia, upasuaji wa neva, neuro-onkolojia, uhandisi wa kibayomedikali na informatikia ya afya. Hasa, kutumia modeli ya ujifunzaji wa kina kama kitoa sifa na algoriti ya jadi zaidi kama mwainishaji wa mwisho ni mkabala wa usanifu unaostahili kuchunguzwa katika mazingira ya utafiti yenye miundombinu midogo ya kompyuta.
Kwa matumizi ya kuaminika nchini Uturuki, uthibitishaji wa nje unapaswa kufanywa kwa data za kiwango cha mgonjwa kutoka miji na hospitali tofauti, vifaa tofauti vya MRI na itifaki tofauti za upigaji picha. Mgawanyo unaotegemea mgonjwa unapaswa kutumika ili kuzuia picha za mgonjwa mmoja kusambaa katika seti za mafunzo na majaribio; matokeo ya modeli yanapaswa kulinganishwa na tathmini za wataalamu wa radiolojia; na athari za kliniki za matokeo hasi ya uongo na chanya ya uongo zinapaswa kuchunguzwa kando. Utafiti huu hauwasilishi mfumo ulio tayari kutumika katika hospitali yoyote ya Uturuki, ulioidhinishwa, au unaoweza kuchukua nafasi ya utambuzi wa kliniki.
Tatizo kuu la utafiti ni nini?
Kutathmini uvimbe wa ubongo kutoka picha za MRI ni tatizo gumu la uainishaji kwa sababu sifa za picha zinaweza kufanana, uvimbe unaweza kujitokeza katika ukubwa na maeneo tofauti, na itifaki za upigaji picha zinaweza kutofautiana. Tathmini ya mikono inahitaji utaalamu na, kwa mujibu wa watafiti, inaweza kuwa wazi kwa tofauti kati ya watu wanaotafsiri picha.
Lengo la utafiti ni kutathmini kama modeli ya EfficientNetB0, iliyofunzwa awali kwenye seti kubwa ya data za picha asilia, inaweza kujifunza sifa bainifu kutoka picha za MRI na kama kuunganisha sifa hizi na waainishaji wa jadi wa ujifunzaji wa mashine kunaongeza utendaji.
Mbinu mbili kuu zililinganishwa katika utafiti:
- Modeli huru ya ujifunzaji wa kina: EfficientNetB0 huchakata picha kutoka mwanzo hadi mwisho na kutoa moja kwa moja mojawapo ya madarasa manne.
- Mkabala mseto: EfficientNetB0 hutoa vekta ya sifa za kina kutoka kwenye picha, na uainishaji wa mwisho hufanywa kwa SVM, KNN, Random Forest au MLP.
Utafiti huu kwa hakika unaainisha nini?
Modeli hutofautisha kati ya lebo nne za picha:
- Glioma
- Meningioma
- Uvimbe wa pituitari
- Hakuna uvimbe
Madarasa haya hayaonyeshi hatua au daraja la uvimbe. Seti ya data haina lebo za hatua ya saratani kama Hatua I, Hatua II, Hatua III au Hatua IV; madaraja ya kihistolojia kama daraja la chini au la juu; wala sifa za molekuli kama IDH, 1p/19q au MGMT. Kwa hiyo, kauli ya “uainishaji wa hatua za saratani” inayotumika katika baadhi ya sehemu za utafiti haiendani na muundo wa data ulioelezwa.
Modeli pia haichori mpaka wa uvimbe kwenye picha, haipimi ujazo wake, wala haionyeshi ni eneo gani la pikseli lililoathiri uamuzi. Utafiti huu si wa segmentesheni, bali ni wa uainishaji katika kiwango cha picha.
Seti ya data iliundwaje?
Jumla ya picha 7.023 za MRI zilikusanywa kutoka vyanzo vitatu huria:
- Seti ya data ya uvimbe wa ubongo ya Figshare
- Seti ya data ya SARTAJ Brain Tumor Classification MRI
- Seti ya data ya BR35H Brain Tumor Detection
Picha za darasa la “Hakuna uvimbe” zilichukuliwa kutoka chanzo cha BR35H. Watafiti waliripoti kuwa walibaini kutokulingana katika uainishaji wa picha za glioma kwenye seti ya data ya SARTAJ na walibadilisha picha hizo kwa picha za glioma kutoka chanzo cha Figshare.
| Darasa | Idadi ya picha asili | Uwiano katika jumla |
|---|---|---|
| Glioma | 1.621 | %23,1 |
| Meningioma | 1.645 | %23,4 |
| Uvimbe wa pituitari | 1.757 | %25,0 |
| Hakuna uvimbe | 2.000 | %28,5 |
| Jumla | 7.023 | %100 |
Madarasa hayajasawazishwa kikamilifu; hata hivyo, tofauti kati ya darasa dogo zaidi na kubwa zaidi ni picha 379. Utafiti ulilenga kusawazisha madarasa katika hatua ya mafunzo kupitia uongezaji data.
Hatua za uchakataji wa awali wa data
Picha asili zina ukubwa wa pikseli 512×512. Picha zote zilibadilishwa ukubwa hadi pikseli 299×299 ili kuingizwa katika modeli ya EfficientNetB0. Kisha marekebisho ya mwangaza na kontrasti yalitumika, na thamani za pikseli zilisawazishwa kwa viwango.
Katika maandishi, mchakato wa unormalishaji umeelezwa kama kutoa wastani kutoka kila chaneli ya picha na kugawanya kwa mkengeuko wa kawaida ili kupata mgawanyo wenye wastani wa sifuri na mkengeuko wa kawaida wa moja.
Hatua za uongezaji data ni hizi:
- Mzunguko wa nasibu wa takriban kati ya −25° na +25°
- Geuza mlalo
- Kuongeza kila picha kwa lengo la kuzalisha mifano ya ziada
Katika sehemu moja utafiti unaripoti kuwa kila picha iliongezwa “mara mbili”, huku katika Jedwali 1 lengo la mafunzo kwa kila darasa likitajwa kuwa picha 3.000. Kama kila moja ya madarasa manne lingeongezwa hadi picha 3.000, jumla ya hazina ya mafunzo iliyoongezwa ingekuwa picha 12.000. Hata hivyo, jedwali hilo hilo linatoa jumla ya seti ya mafunzo kuwa picha 5.712. Haijaelezwa ni picha zipi ziliongezwa, picha zilizoongezwa ziliundwa lini, wala jinsi lengo la picha 3.000 kwa darasa lilivyolinganishwa na picha 5.712 za mafunzo.
Mgawanyo wa mafunzo na majaribio
Kati ya jumla ya picha 7.023, picha 5.712 zilitengwa kwa mafunzo na 1.311 kwa majaribio. Mgawanyo huu unalingana na takriban %81 ya mafunzo na %19 ya majaribio.
| Sehemu ya data | Idadi ya picha | Uwiano wa takriban |
|---|---|---|
| Mafunzo | 5.712 | %81,3 |
| Majaribio | 1.311 | %18,7 |
Kwa modeli mseto, mgawanyo wa ziada wa %80 kwa mafunzo na uthibitishaji na %20 kwa majaribio pia umeripotiwa. Hata hivyo, haijaelezwa kama mgawanyo huu ni sawa na mgawanyo wa 5.712–1.311, kama sampuli zilezile za nasibu zilitumika kwa kila modeli, au kama seti tofauti za majaribio ziliundwa.
Haijaelezwa pia kama mgawanyo wa data ulifanywa katika kiwango cha mgonjwa au kiwango cha picha. Ikiwa kuna vipande vingi au picha zinazofanana kutoka kwa mgonjwa mmoja, mgawanyo usiotegemea mgonjwa unaweza kuunda kufanana kwa taarifa kati ya seti za mafunzo na majaribio. Utafiti haujawasilisha kitambulisho cha mgonjwa, mgawanyo wa vikundi au ukaguzi wa picha zilizorudiwa kuthibitisha kuwa uwezekano huu ulizuiwa.
Aidha, haijulikani kama uongezaji data ulitumika kabla au baada ya mgawanyo wa majaribio. Katika tathmini ya kuaminika, inapaswa kuonyeshwa wazi kuwa nakala zilizoongezwa ziliundwa tu katika sehemu ya mafunzo.
Usanifu wa EfficientNetB0
Katika utafiti, EfficientNetB0 imefafanuliwa kama mtandao wa neva wa konvolusheni wenye takriban vigezo milioni 5,3 na takriban tabaka 82. Vipengele vikuu vya mtandao ni hivi:
- Bloku ya mzizi yenye tabaka la awali la konvolusheni, unormalishaji wa batch na uamilishaji wa Swish
- Bloku za Mobile Inverted Bottleneck Convolution
- Konvolusheni zinazotenganishwa kwa kina
- Bloku za Squeeze-and-Excitation
- Miunganisho ya mabaki
- Global average pooling
- Tabaka la uainishaji linalotoa uwezekano wa mwisho wa madarasa
Konvolusheni inayotenganishwa kwa kina inalenga kupunguza idadi ya operesheni kwa kugawanya konvolusheni ya kawaida katika hatua za konvolusheni kwa kila chaneli na konvolusheni ya nukta 1×1. Bloku za Squeeze-and-Excitation, kwa upande mwingine, hulenga kujifunza umuhimu wa chaneli na kuongeza uzito wa sifa zenye manufaa.
| Kipengele | Muundo uliotolewa katika utafiti |
|---|---|
| Bloku ya mzizi | Vichujio 32, kiini 3×3 |
| Hatua ya MBConv | Vichujio 16, kiini cha kina 3×3 |
| Hatua ya MBConv | Vichujio 24, kiini cha kina 3×3 |
| Hatua ya MBConv | Vichujio 40, kiini cha kina 3×3 |
| Hatua ya MBConv | Vichujio 80, kiini cha kina 5×5 |
| Hatua ya MBConv | Vichujio 112, kiini cha kina 5×5 |
| Hatua ya MBConv | Vichujio 192, kiini cha kina 5×5 |
| Hatua ya MBConv | Vichujio 320, kiini cha kina 5×5 |
| Global average pooling | Matokeo ya vekta |
Ujifunzaji wa uhamisho na fine-tuning
Watafiti walitumia uzito wa EfficientNetB0 uliofunzwa awali kwenye ImageNet kama hatua ya kuanzia. Tabaka zilizofunzwa awali baadaye zilifunguliwa na kurekebishwa upya kwenye seti ya data ya MRI.
| Kigezo cha mafunzo | Thamani |
|---|---|
| Modeli msingi | EfficientNetB0 |
| Idadi ya takriban ya tabaka | 82 |
| Idadi ya takriban ya vigezo | milioni 5,3 |
| Algoriti ya uboreshaji | Adam |
| Ukubwa wa batch | 16 |
| Kipindi cha mafunzo | 10 epoch |
| Kiwango cha awali cha ujifunzaji | 0,001 |
Haijabainishwa kazi ya hasara, kipangaji cha kiwango cha ujifunzaji, kigezo cha kusitisha mapema, weight decay, random seed ya kuanzia, wala kipimo gani cha uthibitishaji kilitumika kuchagua modeli bora zaidi.
Mazingira ya utekelezaji
Utafiti uliripotiwa kufanywa kwenye Google Colab Pro+ kwa kutumia 52 GB RAM na V2-8 TPU. Maktaba za Python, Pandas, PyTorch na Scikit-Learn zilitumika. Hata hivyo, katika Jedwali 2 mazingira ya utekelezaji yameandikwa kama “GPU”. Haijaelezwa kama maneno TPU na GPU yanahusu majaribio tofauti.
Matoleo ya Python, PyTorch na Scikit-Learn; njia ya kutumia TPU; kama modeli ilifunzwa kwa mfumo uliosambazwa au kwenye kifaa kimoja; na jinsi muda wa uchakataji ulivyohusiana na matumizi ya maunzi hayajaelezwa.
Modeli mseto iliundwaje?
Katika mkabala mseto, tabaka la mwisho la uainishaji la modeli ya EfficientNetB0 iliyofanyiwa fine-tuning halikutumiwa; vekta ilitolewa kutoka matokeo ya global average pooling, na iliripotiwa kuwa na sifa 9.216 kwa kila picha. Vekta hizi zilipewa algoriti nne tofauti za ujifunzaji wa mashine.
Umbo kamili la tensor la vekta ya sifa, tabaka ilikotolewa, kama ilifanyiwa scaling au la, au kama upunguzaji wa vipimo ulitumika, havijaonyeshwa kwa undani. Utafiti hauna matokeo ya tabaka au kipande cha msimbo kinachoonyesha uhusiano kati ya global average pooling na sifa 9.216.
Support Vector Machine
SVM ni mwainishaji unaosimamiwa unaojaribu kupata mpaka bora wa uamuzi kati ya madarasa katika nafasi ya sifa yenye vipimo vingi. Katika utafiti, matokeo bora zaidi kwa ujumla yalipatikana kwa SVM. Hata hivyo, haijaelezwa ni kernel ipi ilitumika kati ya linear, polynomial au radial; wala \(C\), \(\gamma\), uzito wa madarasa na mkakati wa uamuzi wa madarasa mengi haujabainishwa.
K-Nearest Neighbours
KNN huweka mfano mpya katika darasa kulingana na madarasa ya majirani wake wa karibu zaidi katika nafasi ya sifa. Katika utafiti, ilitoa muda mfupi zaidi wa uchakataji kwa upande wa uwezo wa kupanuka. Hakuna taarifa iliyotolewa kuhusu idadi ya majirani iliyotumika, kipimo cha umbali, uzani wa majirani na usawazishaji wa sifa.
Random Forest
Random Forest hutegemea kura ya wengi ya idadi kubwa ya miti ya maamuzi iliyofunzwa kwa vijisehemu tofauti vya data na sifa. Miongoni mwa modeli zilizochunguzwa, usahihi wa msingi wa chini zaidi ulionekana katika modeli hii. Idadi ya miti, kina cha juu zaidi, kigezo cha mgawanyo na idadi ya sifa zinazotumika katika kila nodi hazijaripotiwa.
Multilayer Perceptron
MLP ni mtandao wa neva wa feed-forward unaojumuisha tabaka moja au zaidi zilizofichwa. Katika jedwali la uwezo wa kupanuka, MLP ilitoa muda wa juu zaidi wa uchakataji. Idadi ya tabaka zilizofichwa, idadi ya neuroni, kazi za uamilishaji, regularization, mbinu ya uboreshaji na kipindi cha mafunzo havijaelezwa.
Vipimo vya tathmini
Utafiti ulitumia usahihi, unyeti na umaalumu. Katika maandishi, mlinganyo wa usahihi umechapishwa kwa namna ifuatayo:
\[ \mathrm{Accuracy}= \frac{TP+TN} {TP+TB+FP+FN}\times100 \]
Katika mlinganyo huu, \(TB\) katika denominator haijafafanuliwa. Kwa kuwa maelezo yanayofuata yanafafanua \(TP\), \(TN\), \(FP\) na \(FN\), usemi wa \(TB\) huenda ni kosa la uchapaji. Katika muundo wa kawaida, denominator inayowakilisha jumla ya idadi ya mifano ni:
\[ TP+TN+FP+FN \]
inapaswa kuwa hivyo. Hata hivyo, kosa katika maandishi asilia halijasahihishwa kimya kimya.
Mlinganyo wa unyeti:
\[ \mathrm{Sensitivity}= \frac{TP}{TP+FN}\times100 \]
Mlinganyo wa umaalumu:
\[ \mathrm{Specificity}= \frac{TN}{TN+FP}\times100 \]
ndivyo ulivyo. Katika tatizo la madarasa mengi, haijaelezwa kama unyeti na umaalumu vilihesabiwa kwa macro average, weighted average au mbinu ya one-versus-rest.
Utafiti haujawasilisha precision, alama ya F1, mkunjo wa receiver operating characteristic, eneo chini ya mkunjo, urekebishaji wa uwezekano wa utabiri au uchanganuzi wa kizingiti cha uamuzi.
Matokeo ya jumla ya modeli
| Modeli | Usahihi | Unyeti | Umaalumu |
|---|---|---|---|
| EfficientNetB0 | %95 | %98 | %99 |
| EfficientNetB0 + SVM | %96 | %98 | %99 |
| EfficientNetB0 + MLP | %94 | %97 | %99 |
| EfficientNetB0 + KNN | %93 | %96 | %99 |
| EfficientNetB0 + Random Forest | %88 | %94 | %98 |
Kulingana na jedwali kuu, modeli mseto ya SVM ilitoa usahihi ulio juu kwa nukta moja tu ya asilimia kuliko EfficientNetB0 huru. Thamani za unyeti na umaalumu ni sawa katika modeli zote mbili. Kwa hiyo, uboreshaji ulioripotiwa kimsingi unaishia kwenye tofauti ndogo katika kiwango cha jumla cha uainishaji sahihi.
Umaalumu wa SVM umeonyeshwa kama %99 katika jedwali kuu. Dokezo chini ya jedwali linasema kuwa kuna thamani ya %100 katika jedwali jingine; hata hivyo, Jedwali 2 linalorejelewa lina usanifu wa modeli na vigezo vya mafunzo, si matokeo ya umaalumu.
Matokeo kwa kila darasa
| Modeli | Glioma | Meningioma | Hakuna uvimbe | Uvimbe wa pituitari |
|---|---|---|---|---|
| EfficientNetB0 | %95 | %92 | %96 | %98 |
| EfficientNetB0 + SVM | %94 | %93 | %97 | %97 |
| EfficientNetB0 + MLP | %92 | %89 | %97 | %97 |
| EfficientNetB0 + KNN | %93 | %89 | %96 | %95 |
| EfficientNetB0 + Random Forest | %84 | %81 | %94 | %94 |
Kulingana na jedwali hili, EfficientNetB0 huru ilitoa matokeo ya juu kuliko modeli mseto ya SVM katika glioma na uvimbe wa pituitari; modeli mseto ya SVM ilikuwa juu kidogo katika meningioma na picha zisizo na uvimbe.
Hata hivyo, katika muhtasari na maelezo ya matokeo, thamani za SVM zimetolewa kama meningioma %93, hakuna uvimbe %99 na uvimbe wa pituitari %98. Katika Jedwali 5, %97 imeandikwa kwa hakuna uvimbe na uvimbe wa pituitari. Haijulikani ni thamani zipi ni matokeo ya mwisho.
Haijafafanuliwa kama kipimo cha “usahihi wa darasa” kinachotumika katika jedwali ni unyeti wa kila darasa, uwiano wa utabiri sahihi ndani ya darasa, au thamani iliyohesabiwa kwa mbinu nyingine kutoka kwenye matriksi ya mkanganyiko.
Matriksi za mkanganyiko
Watafiti wanaeleza kuwa matriksi ya mkanganyiko iliundwa kwa kila modeli. Hata hivyo, katika toleo la kurasa 18 lililochunguzwa, hakuna majedwali ya nambari au vielelezo vya matriksi hizi. Kwa hiyo, haiwezekani kutathmini moja kwa moja glioma zilichanganywa zaidi na darasa gani au meningioma zilichanganywa zaidi na darasa gani.
Kutokuwepo kwa matriksi za mkanganyiko kunazuia uchunguzi wa makosa hasi ya uongo na chanya ya uongo kwa kila darasa, ambayo ni muhimu hasa katika uainishaji wa kitabibu.
Tathmini ya uwezo wa kupanuka
Modeli mseto zilitathminiwa katika raundi nne za majaribio zenye picha 1.311, 3.200, 4.000 na 6.000. Utafiti uliripoti usahihi, muda wa jumla wa uchakataji, muda wa wastani kwa kila picha, ukingo wa kosa na vipindi vya kujiamini vya %95.
| Modeli | Idadi ya picha | Usahihi | Muda wa uchakataji | Muda kwa kila mfano |
|---|---|---|---|---|
| KNN | 1.311 | 0,9642 | 32,6658 s | 0,02492 s |
| KNN | 6.000 | 0,9327 | 51,3118 s | 0,00855 s |
| MLP | 1.311 | 0,9565 | 2.052,3229 s | 1,5655 s |
| MLP | 6.000 | 0,9390 | 2.166,2805 s | 0,36105 s |
| Random Forest | 1.311 | 0,9370 | 243,8284 s | 0,1860 s |
| Random Forest | 6.000 | 0,9093 | 245,7511 s | 0,04096 s |
| SVC | 1.311 | 0,9793 | 517,7063 s | 0,3950 s |
| SVC | 6.000 | 0,9580 | 759,8883 s | 0,12665 s |
SVC ilidumisha usahihi wa juu zaidi wa 0,9580 katika picha 6.000. Kipindi cha kujiamini cha %95 cha matokeo haya kilitolewa kama 0,9529–0,9631. KNN ilitoa muda mfupi zaidi wa uchakataji, lakini usahihi wake ulipungua hadi 0,9327 katika picha 6.000. Ingawa MLP iliendelea kuwa na usahihi wa juu, ilikuwa modeli yenye gharama kubwa zaidi kwa muda wa uchakataji uliozidi sekunde 2.166. Random Forest ilikuwa chini zaidi kwa usahihi na pia ilionyesha upotevu wa utendaji ulio wazi zaidi kadiri data zilivyoongezeka.
Kutokulingana katika matokeo ya uwezo wa kupanuka
Katika jedwali kuu la utendaji, usahihi wa KNN umepewa kama %93, MLP %94, Random Forest %88 na SVM %96. Katika raundi ya kwanza ya jedwali la uwezo wa kupanuka yenye picha 1.311, modeli hizo hizo ziliweka usahihi wa %96,42, %95,65, %93,70 na %97,93 mtawalia.
Haijaelezwa kwa nini matokeo tofauti kiasi hiki yalitokea katika seti ya majaribio yenye picha 1.311 ambayo inaonekana kuwa na ukubwa uleule. Huenda seti tofauti za mafunzo, migawanyo tofauti ya nasibu au hali tofauti za majaribio zilitumika; lakini utafiti haujabainisha hilo.
Katika sehemu ya majadiliano, raundi ya kwanza ya SVM imeelezwa kama “0,9797 katika picha 1.911”. Katika Jedwali 6, imeandikwa “0,9793 katika picha 1.311”. Kwa hiyo, wakati wa kutafsiri matokeo ya uwezo wa kupanuka, inapaswa kuzingatiwa kuwa thamani za jedwali hazilingani kikamilifu na maandishi.
Dai kuhusu gharama ya kompyuta
Utafiti unapendekeza kuwa mkabala mseto unaweza kutoa gharama ndogo ya kompyuta na muda mfupi wa mafunzo katika hatua ya mwisho ya uainishaji. Katika mkabala huu, baada ya EfficientNetB0 kutumika mara moja kama kitoa sifa, waainishaji wa jadi hufanya kazi kwenye vekta za sifa.
Hata hivyo, haijulikani kama muda wa uchakataji ulioripotiwa unajumuisha hatua ya kutoa sifa kwa EfficientNetB0. Muda wa mafunzo, muda wa majaribio, muda wa inference kwa kila mfano, matumizi ya nishati au matumizi ya kumbukumbu ya modeli huru ya EfficientNetB0 pia hayajatolewa katika jedwali hilo hilo.
Kwa hiyo, ukubwa wa kiasi wa hitimisho kwamba “modeli mseto inahitaji kompyuta kidogo kuliko modeli huru ya ujifunzaji wa kina” hauwezi kuhesabiwa kutoka data zilizopo. Jedwali linaonyesha tu tofauti za muda kati ya waainishaji mseto wenyewe.
Nguvu za utafiti
- Hazina kubwa kiasi ya picha 7.023 iliyounganisha vyanzo vitatu huria ilitumika.
- Madarasa matatu ya uvimbe na picha zisizo na uvimbe yalitathminiwa ndani ya tatizo lilelile la madarasa manne.
- Modeli huru ya EfficientNetB0 ililinganishwa moja kwa moja na usanifu mseto minne.
- Ujifunzaji wa uhamisho na uongezaji data vilitumika pamoja kushughulikia tatizo la data chache za picha za kitabibu.
- Mbali na usahihi wa jumla, unyeti na umaalumu viliripotiwa.
- Uchanganuzi wa muda wa uchakataji na kipindi cha kujiamini ulifanywa katika ukubwa tofauti wa data.
- Vyanzo vya data huria na rejea ya bodi ya maadili vilitolewa.
- Utafiti ulikubali wazi mipaka yake kuhusu uthibitishaji wa nje, tofauti za sekvensi za MRI na uelezekaji.
Mapungufu ya utafiti
- Utafiti ni preprint ambayo haijapitia mapitio ya rika.
- Idadi za madarasa baada ya uongezaji data hazilingani na jumla ya idadi ya mafunzo.
- Uwiano wa mgawanyo wa data uliotolewa kwa modeli kuu na modeli mseto si sawa kikamilifu.
- Haijabainishwa kama mgawanyo wa kiwango cha mgonjwa ulifanywa.
- Haijaonyeshwa kuwa uongezaji data ulitumika baada ya mgawanyo wa majaribio.
- Muundo wa picha, sekvensi za MRI na sifa za wagonjwa katika seti tofauti za data huria hazijaandikwa kikamilifu.
- Haijatathminiwa kama modeli ilijifunza alama za kuona zinazotokana na taasisi au kifaa kilekile.
- Hyperparameters za SVM, KNN, Random Forest na MLP hazijatolewa.
- Kazi ya hasara, kusitisha mapema, uteuzi wa modeli na mipangilio ya random initialization hazijaelezwa.
- Matriksi za mkanganyiko zimetajwa katika maandishi lakini hazijawasilishwa.
- Cross-validation au majaribio yaliyorudiwa hayajaripotiwa kwa matokeo makuu.
- Thamani za usahihi katika majedwali tofauti hazilingani.
- Thamani za SVM kwa kila darasa hubadilika kati ya muhtasari, maelezo na jedwali.
- Hakukufanyika uthibitishaji kwa seti huru ya data ya hospitali ya nje.
- Hakuna utafiti wa kliniki wa mbele wala ulinganisho na wataalamu wa radiolojia.
- Hakuna heatmap, saliency au matokeo mengine ya XAI yanayoeleza maamuzi ya modeli yaliyowasilishwa.
- Urekebishaji wa uwezekano wa modeli na vizingiti vya maamuzi ya kliniki havijatathminiwa.
- Hakuna kiungo cha hifadhi huria kilichotolewa kwa msimbo chanzo, usanidi wa mafunzo au uzito wa modeli.
Hitimisho zinazoungwa mkono na utafiti
- EfficientNetB0 iliweza kutenganisha madarasa manne ya picha kwa usahihi wa juu kwa ujumla katika mpangilio wa majaribio uliotumika.
- Katika jedwali kuu la utendaji, modeli mseto ya EfficientNetB0+SVM ilitoa usahihi wa juu zaidi kwa ujumla.
- Modeli mseto ya SVM ilionyesha usahihi wa juu kwa takriban nukta moja ya asilimia kuliko EfficientNetB0 huru.
- Random Forest ilionyesha utendaji wa chini kuliko waainishaji wengine mseto katika matokeo makuu.
- KNN ilitoa muda mfupi zaidi wa uchakataji katika jedwali la uwezo wa kupanuka.
- SVC ilidumisha usahihi wa juu zaidi katika jaribio la uwezo wa kupanuka lenye picha 6.000.
- Kadiri idadi ya mifano ilivyoongezeka, ukingo wa kosa ulioripotiwa ulipungua na vipindi vya kujiamini vilibana.
Hitimisho ambazo utafiti haujathibitisha
- Modeli haiainishi hatua ya saratani ya ubongo.
- Modeli haiamui kwa uhakika kama uvimbe ni benign au malignant.
- Modeli haitabiri daraja la uvimbe, aina ndogo ya molekuli au uchaguzi wa matibabu.
- Utafiti haufanyi utambuzi wa kweli wa ugonjwa katika hatua ya mapema.
- Modeli haigawanyi eneo la uvimbe kwa segmentesheni wala kupima ujazo wake.
- Usahihi wa %96 hauonyeshi kuwa utendaji uleule utapatikana katika hospitali zote na vifaa vyote vya MRI.
- Matokeo hayathibitishi ubora dhidi ya utendaji wa wataalamu wa radiolojia.
- Modeli haijathibitishwa kama kifaa cha kitabibu kinachoweza kuchukua nafasi ya utambuzi wa kliniki.
- Usahihi wa juu katika kiwango cha picha hauthibitishi kuwa usahihi uleule utapatikana katika kiwango cha mgonjwa.
- Haijaonyeshwa kwa kiasi kwamba gharama ya jumla ya kompyuta ya end-to-end ya modeli mseto ni ndogo kuliko ya EfficientNetB0 huru.
- Utafiti hauonyeshi kuwa matumizi ya modeli yanaboresha uhai wa mgonjwa au matokeo ya matibabu.
Mbinu na Matokeo ya Utafiti
Mtiririko wa kazi wa nambari
- Picha 7.023 za MRI kutoka vyanzo vya Figshare, SARTAJ na BR35H ziliunganishwa.
- Kwa sababu ya matatizo ya uainishaji yaliyobainishwa katika picha za glioma kutoka chanzo cha SARTAJ, darasa la glioma lilibadilishwa kwa picha za Figshare.
- Picha zilibadilishwa ukubwa kutoka pikseli 512×512 hadi 299×299.
- Mwangaza, kontrasti na unormalishaji wa pikseli vilitumika.
- Uongezaji data ulifanywa kwa mzunguko wa nasibu na geuza mlalo.
- Picha 5.712 zilitengwa kwa mafunzo na picha 1.311 kwa majaribio.
- Tabaka za EfficientNetB0 zilizofunzwa awali kwenye ImageNet zilifanyiwa fine-tuning kwa data za MRI.
- Modeli huru ya EfficientNetB0 ilitathminiwa kama mwainishaji wa end-to-end wa madarasa manne.
- Iliripotiwa kuwa sifa 9.216 kwa kila picha zilitolewa kutoka EfficientNetB0.
- Modeli za SVM, KNN, Random Forest na MLP zilifunzwa kwa sifa hizi.
- Modeli zililinganishwa kwa usahihi, unyeti na umaalumu.
- Modeli mseto ziliingizwa katika majaribio ya uwezo wa kupanuka katika kiwango cha picha 1.311–6.000.
Usanidi wa modeli kuu
| Kipengele cha mbinu | Thamani iliyoripotiwa katika utafiti |
|---|---|
| Aina ya picha | Picha ya MRI ya ubongo |
| Idadi ya madarasa | 4 |
| Jumla ya picha asili | 7.023 |
| Picha za mafunzo | 5.712 |
| Picha za majaribio | 1.311 |
| Azimio la kuingiza | pikseli 299×299 |
| Mafunzo ya awali | ImageNet |
| Usanifu msingi | EfficientNetB0 |
| Vigezo vya takriban | milioni 5,3 |
| Tabaka za takriban | 82 |
| Uboreshaji | Adam |
| Kiwango cha ujifunzaji | 0,001 |
| Batch | 16 |
| Kipindi cha mafunzo | 10 epoch |
| Idadi ya sifa za kina | 9.216 |
| Waainishaji mseto | SVM/SVC, KNN, Random Forest, MLP |
| Mazingira ya programu | Python, PyTorch, Scikit-Learn, Pandas |
| Taarifa ya maunzi | Google Colab Pro+, 52 GB RAM, V2-8 TPU; jedwali pia lina GPU |
Mpangilio wa modeli
| Nafasi | Modeli | Usahihi katika jedwali kuu | Tathmini kuu |
|---|---|---|---|
| 1 | EfficientNetB0 + SVM | %96 | Usahihi wa juu zaidi kwa ujumla |
| 2 | EfficientNetB0 | %95 | Matokeo msingi yenye nguvu bila mseto |
| 3 | EfficientNetB0 + MLP | %94 | Chini kuliko SVM na muda mkubwa wa uchakataji |
| 4 | EfficientNetB0 + KNN | %93 | Haraka katika uchanganuzi wa uwezo wa kupanuka |
| 5 | EfficientNetB0 + Random Forest | %88 | Usahihi wa msingi wa chini zaidi |
Maoni kwa kila modeli
EfficientNetB0: Modeli huru ilifikia usahihi wa jumla wa %95. Kwa kila darasa, ilitoa matokeo ya juu zaidi ya %98 katika uvimbe wa pituitari na ya chini zaidi ya %92 katika meningioma.
EfficientNetB0+SVM: Kulingana na jedwali kuu, ilitoa usahihi wa juu zaidi kwa ujumla wa %96. Hata hivyo, thamani za kila darasa zinabadilika katika sehemu tofauti za makala. Kutolewa kwa thamani ya %97,93 kwa picha 1.311 katika jedwali la uwezo wa kupanuka pia hakulingani na jedwali kuu.
EfficientNetB0+MLP: Ilionyesha usahihi wa %94 katika jedwali kuu. Ingawa ilidumisha kwa kiasi kikubwa usahihi wake wa juu katika jaribio la uwezo wa kupanuka, ilikuwa modeli mseto iliyohitaji muda mwingi zaidi wa kompyuta kwa muda uliozidi sekunde 2.000.
EfficientNetB0+KNN: Ilitoa usahihi wa %93 katika jedwali kuu. Usahihi wake ulipungua data zilipoongezeka, lakini ilibaki kuwa ya haraka zaidi kwa kiasi kikubwa kuliko modeli nyingine mseto kwa muda wa uchakataji.
EfficientNetB0+Random Forest: Ilitoa matokeo ya chini zaidi kwa usahihi wa %88 katika jedwali kuu. Hasa katika madarasa ya glioma na meningioma, ilipata thamani za chini kuliko modeli nyingine.
Taarifa inayotolewa na Kielelezo 1
Grafu pekee yenye sehemu nyingi katika utafiti inaonyesha usahihi wa modeli za KNN, MLP, Random Forest na SVC katika ukubwa manne wa data. Mistari myeusi inawakilisha usahihi wa modeli, na mistari myepesi inawakilisha mipaka ya chini na ya juu ya kipindi cha kujiamini cha %95.
Katika grafu zote nne, inaonekana kwamba usahihi hupungua kidogo data zinapoongezeka. Wakati huo huo, vipindi vya kujiamini hubana kadiri idadi ya mifano inavyoongezeka. SVC ilitoa mkunjo wa juu zaidi wa usahihi, na Random Forest mkunjo wa chini zaidi.
Grafu zinaonyesha usahihi wa modeli, lakini hazijumuishi muda wa uchakataji wa kulinganisha au mkunjo wa uwezo wa kupanuka wa modeli huru ya EfficientNetB0.
Kikomo cha tathmini ya takwimu
Katika jedwali la uwezo wa kupanuka, ukingo wa makosa unaofanana na uwiano wa binomial na vipindi vya kujiamini vya %95 vimetolewa. Hata hivyo, vipindi hivyo vya kujiamini havijawasilishwa kwa matokeo makuu ya usahihi wa %95 na %96. Hakukufanyika jaribio lililooanishwa au uchanganuzi wa resampling ili kutathmini kama tofauti ya nukta moja ya asilimia kati ya modeli ina umuhimu wa kitakwimu.
Hata kama SVM na EfficientNetB0 huru zilitathminiwa kwenye picha zilezile, haiwezekani kuhitimisha kwa kutegemewa kwamba modeli moja ni bora kuliko nyingine kwa kuangalia tu thamani za usahihi zilizozungushwa. Hilo linahitaji mgawanyo wa makosa kwa kila mfano na majaribio yaliyorudiwa; utafiti haujawasilisha taarifa hizo.
Tathmini ya uwezo wa kujumuisha
Ingawa data ziliunganishwa kutoka vyanzo vitatu huria, uthibitishaji wa nje haukufanywa kwa seti huru ya data ya hospitali ambayo haikutumika kabisa katika mchakato wa mafunzo. Vyanzo vilivyounganishwa vinaweza kuwa na miundo tofauti ya picha, kontrasti, azimio au nafasi za pembeni. Haijajaribiwa kama modeli ilijifunza vihisishi vya kuona vinavyotokana na chanzo cha data badala ya sifa za uvimbe.
Utafiti unaeleza kuwa data za Figshare zina picha zenye kontrasti zilizopimwa kwa T1; hata hivyo, haijaelezwa kama sekvensi katika seti yote iliyounganishwa ya data ni sawa. Ikiwa picha za T1, T2, FLAIR au zenye kontrasti zimechanganywa, uwezo halisi wa modeli kujumuisha katika mazingira ya kliniki unapaswa kutathminiwa kando.
Tathmini kuhusu matumizi ya kliniki
Watafiti wanauona mfumo kama chombo cha maoni ya pili au msaada wa maamuzi kwa wataalamu wa radiolojia na neuro-onkolojia. Hata hivyo, utafiti haukufanya jaribio la msomaji mtaalamu, jaribio la mtiririko wa kazi wa kliniki, ulinganisho wa muda wa utambuzi au uchanganuzi wa imani ya mtumiaji.
Utabiri wa modeli hauchukui nafasi ya uchunguzi wa histopatholojia au tathmini ya kliniki. Utambuzi wa glioma, meningioma na uvimbe wa pituitari hauwezi kuthibitishwa kwa kutegemea uainishaji wa picha moja ya pande mbili pekee. Utafiti wa sasa ni tathmini ya awali ya kiufundi ya utendaji wa algoriti.
Tathmini ya jumla ya kisayansi
Ugunduzi mkuu wa utafiti ni kwamba kuainisha sifa za kina za picha zilizotolewa kutoka EfficientNetB0 kwa kutumia SVM kunaweza kutoa matokeo yenye nguvu katika mpangilio wa data uliotumika. Modeli mseto ya SVM ilitoa ongezeko dogo la usahihi ikilinganishwa na modeli huru katika jedwali kuu.
Hata hivyo, suala kuu linalopunguza kuaminika kwa matokeo ni kwamba majedwali tofauti yanaripoti usahihi tofauti kwa modeli zilezile. Kutokulingana kati ya idadi za uongezaji data na idadi ya seti ya mafunzo pia kunafanya jaribio kuwa gumu kurudiwa.
Utafiti unapaswa kuchukuliwa kama utafiti wa awali wa kulinganisha waainishaji tofauti kwa kutumia sifa za EfficientNetB0, badala ya uthibitisho wa mfumo wa utambuzi ulio tayari kwa matumizi ya kliniki. Thamani halisi ya mbinu inaweza kubainishwa inapojaribiwa tena kwa mgawanyo unaotegemea mgonjwa, seti ileile ya majaribio, hyperparameters kamili, msimbo huria, uthibitishaji wa nje na majaribio ya kliniki ya mbele.
Maelezo ya Chanzo na Mbinu
Jina kamili asilia la utafiti: Hybrid Deep Learning Using MRI Scans for Advancements of Brain Tumours Multi-Classifications
Waandishi na mpangilio wao: Amirparsa Rouhi; Fatemeh Parsakordasiabi; Timothy Albiges; Zoheir Sabeur.
Mwandishi mwenza wa kwanza: Utafiti hauna tamko la mchango sawa au uandishi mwenza wa kwanza. Alama ya nyota katika majina ya waandishi inaelekeza kwenye tanbihi ya pamoja ya taasisi.
Mwandishi wa mawasiliano: Zoheir Sabeur. Anwani ya mawasiliano imetolewa kama zsabeur@bournemouth.ac.uk katika utafiti.
Taasisi: Kwa waandishi wote, taarifa imetolewa kama Bournemouth University, Poole, Dorset, BH15 5BB, United Kingdom. Msimbo wa posta wa taasisi umehifadhiwa kama ulivyoandikwa katika utafiti; msimbo tofauti wa posta kutoka rekodi huru ya taasisi haujaingizwa kimya kimya kwenye maandishi.
Anwani za barua pepe za waandishi:
- Amirparsa Rouhi: s5643275@bournemouth.ac.uk
- Fatemeh Parsakordasiabi: s5643276@bournemouth.ac.uk
- Timothy Albiges: talbiges@bournemouth.ac.uk
- Zoheir Sabeur: zsabeur@bournemouth.ac.uk
DOI: Hakuna taarifa wazi ya DOI katika maandishi ya PDF ya utafiti, na DOI haikuweza kuthibitishwa kwa kujitegemea.
Nambari ya muhtasari ya SSRN: 7181697.
Aina ya chanzo: Makala ya utafiti ya preprint kuhusu uainishaji wa picha za kitabibu, ujifunzaji wa kina na ujifunzaji wa mashine.
Jukwaa la uchapishaji: SSRN.
Jarida: Jina la jarida lililopitiwa na rika au toleo lililochapishwa la jarida halijabainishwa katika utafiti.
Mchapishaji: Hakuna taarifa tofauti ya mchapishaji wa jarida iliyotolewa.
Mwaka: Metadata za faili zinaonyesha mwaka 2026; tarehe wazi ya uchapishaji haijatolewa kando katika maandishi makuu.
Hali ya mapitio ya rika: Utafiti haujapitia mapitio ya rika. Kila ukurasa una onyo “Preprint not peer reviewed”.
Kiungo rasmi cha rekodi:https://papers.ssrn.com/sol3/papers.cfm?abstract_id=7181697
Tathmini ya maadili: Utafiti ulitathminiwa na Bournemouth University Ethics Board kwa nambari ya kumbukumbu 66271. Ilielezwa kuwa ridhaa ya ziada ya mgonjwa haikuhitajika kwa sababu hifadhidata za nyuma-kihistoria, huria na zilizofichwa utambulisho pekee ndizo zilizotumika.
Ufadhili: Watafiti waliripoti kuwa hawakupokea ruzuku maalum kutoka mashirika ya ufadhili ya umma, kibiashara au yasiyo ya faida.
Mgongano wa maslahi: Waandishi walitangaza kuwa hakuna maslahi ya kifedha yanayojulikana au uhusiano wa kibinafsi ambao ungeweza kuathiri utafiti.
Vyanzo vya data huria:
Upatikanaji wa msimbo na modeli: Hakuna kiungo cha hifadhi huria kilichotolewa kwa msimbo chanzo, hati za mafunzo, uzito wa modeli iliyofunzwa au usanidi wa majaribio.
Michango ya waandishi:
- Amirparsa Rouhi: Uundaji wa dhana, mbinu, programu, uthibitishaji, uchanganuzi rasmi, utafiti na mapitio-uhariri.
- Fatemeh Parsakordasiabi: Uundaji wa dhana, mbinu, programu, uthibitishaji, uchanganuzi rasmi, utafiti, rasimu ya kwanza na mapitio-uhariri.
- Timothy Albiges: Uchanganuzi rasmi, uwasilishaji wa kuona, ushauri na mapitio-uhariri.
- Zoheir Sabeur: Uchanganuzi rasmi, ushauri na mapitio-uhariri.
Maudhui haya ya Kituruki yaliandaliwa baada ya kuchunguza utafiti wa kurasa 18 uliopakiwa kuanzia mwanzo hadi mwisho. Mbinu ya kisayansi, idadi za data, vigezo vya modeli, vipimo vya utendaji, majedwali, grafu na mapungufu vinategemea tu taarifa zilizowasilishwa katika utafiti. Vyanzo vya nje vilitumika tu kwa madhumuni ya kukagua utambulisho wa kibibliografia wa taasisi na waandishi.
Kutokulingana kwa nambari na uhariri kunakoonekana katika utafiti hakukusahihishwa kimya kimya. Haya yanajumuisha kutokulingana kwa malengo ya darasa yaliyoripotiwa kama picha 3.000 na seti ya mafunzo yenye picha 5.712, migawanyo miwili tofauti ya data, thamani tofauti za usahihi katika majedwali makuu na ya uwezo wa kupanuka, mabadiliko katika matokeo ya darasa ya SVM, marejeo yasiyo sahihi ya majedwali, kutokulingana kwa picha 1.311–1.911 na neno “TB” lisilofafanuliwa katika mlinganyo wa usahihi.
Mapungufu muhimu zaidi ya kisayansi ya utafiti ni kutokuonyeshwa kwa mgawanyo wa data unaotegemea mgonjwa, kutokuwepo kwa uthibitishaji huru wa nje, kutokuwa na kiwango kimoja kwa sekvensi za MRI katika seti yote ya data, upungufu wa hyperparameters za modeli, kutowasilishwa kwa matokeo ya uelezekaji, kutochapishwa kwa matriksi za mkanganyiko na kutofanyika kwa tathmini ya kliniki. Usahihi ulioripotiwa wa %96 ni matokeo ya jaribio la kiwango cha picha lililofanywa chini ya mapungufu haya na haupaswi kutafsiriwa kama mafanikio ya utambuzi wa kliniki.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *