

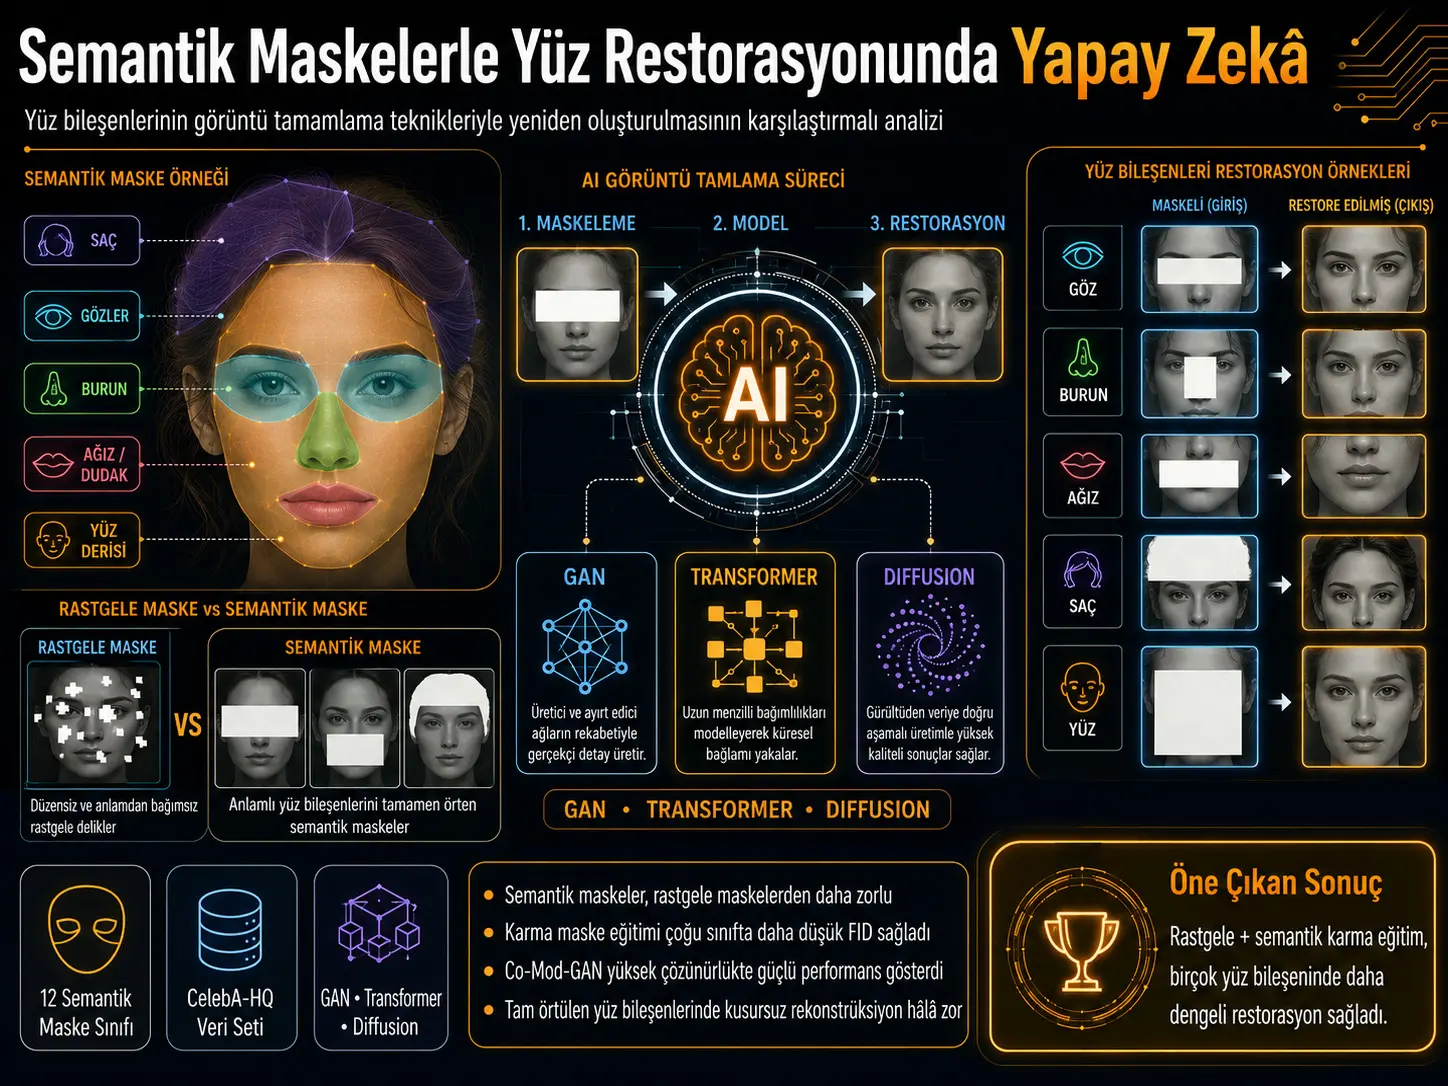
Utafiti huu unalinganisha ni kwa kiwango gani mbinu za kisasa za ujazaji wa picha (image inpainting) zinazotegemea akili bandia zinaweza kuunda upya eneo linalokosekana wakati kipengele cha uso kama jicho, pua, mdomo, nywele au ngozi ya uso kimefichwa kabisa kwa maski ya kisemantiki. Kwa kutumia picha za uso za CelebA-HQ/CelebAMask-HQ na madarasa 12 tofauti ya maski za kisemantiki, familia tofauti za usanifu kama MI-GAN, Latent-based, CMT, MAT, LaMa, Co-Mod-GAN, MADF na kwa kiwango kidogo RePaint zilitathminiwa. Katika hatua ya pili ya utafiti, modeli ya MAT ilifundishwa upya kutoka mwanzo kwa picha 24.000 za mafunzo chini ya mikakati ya maski za nasibu, kisemantiki na mchanganyiko wa aina hizi mbili, na ikajaribiwa kwenye picha 6000. Mafunzo ya maski mchanganyiko yalitoa thamani ya chini zaidi ya FID katika madarasa 10 kati ya 12 ya maski za kisemantiki; katika darasa moja yalitoa matokeo sawa na maski ya nasibu, lakini yalifanya vibaya zaidi katika darasa pana zaidi la maski iliyounganishwa. Hata hivyo, utafiti hauonyeshi kwamba vipengele vya uso vilivyofunikwa kabisa vinaweza kurejeshwa bila kosa au kwa usahihi wa utambulisho wa mtu asilia.
Changamoto kuu ya utafiti ni tofauti ya taarifa kati ya maski za nasibu na maski za kisemantiki. Maski ya nasibu inaweza kufunika sehemu tu ya jicho, mdomo au eneo la nywele na modeli inaweza kutumia muundo wa pikseli uliobaki. Maski ya kisemantiki huondoa kipengele chote lengwa na kufuta vidokezo vya kimuundo vya eneo. Katika hali hii, modeli hulazimika kukadiria eneo lisiloonekana kwa kutumia tu jiometri ya uso wa mazingira, texture, symmetry na mahusiano ya takwimu iliyojifunza wakati wa mafunzo.
Majaribio ya kuona ya utafiti yanaonyesha kwamba tofauti hii inaonekana si katika metriki pekee bali pia katika nyuso zinazozalishwa. Miundo inaweza kutengeneza kope nene au nyeusi, mboni za macho zisizolingana, midomo na meno yaliyoungana, mipaka ya maski inayoonekana, rangi za ngozi zilizobadilika, mtiririko wa nywele usio wa kawaida, masikio yaliyokosekana au katika baadhi ya hali jicho la ziada. Kwa hiyo, FID ya chini peke yake haimaanishi rekonstruksi ya anatomia au utambulisho iliyo kamilifu.
| Kipengele cha jaribio | Muundo uliotumika katika utafiti | Kikomo cha tafsiri |
|---|---|---|
| Seti kuu ya data | Takriban picha 30.000 za uso za CelebA-HQ, 1024 × 1024 | Si seti ya data ya wagonjwa wa kliniki au majeraha. |
| Darasa la maski ya kisemantiki | Madarasa 12 (A–L) | Vipengele maalum vya uso hufichwa kabisa. |
| Maazimio yaliyotathminiwa | 256, 512 na 1024 | Si kila modeli ilitathminiwa katika maazimio yote. |
| Metriki kuu | FID, P-IDS, U-IDS | Kuna kutokuwiana kwa ufafanuzi–tafsiri katika chanzo kuhusu mwelekeo wa P-IDS/U-IDS. |
| Mafunzo upya ya MAT | Picha 24.000 za mafunzo + 6000 za test | Yalifanywa katika azimio la 512 × 512. |
| Mikakati ya mafunzo ya maski | Nasibu, kisemantiki, mchanganyiko | Mbinu ya mchanganyiko ni bora katika madarasa mengi lakini si yote ya maski. |
Kwa nini tatizo la ujazaji wa picha huwa gumu zaidi kwa maski za kisemantiki?
Ujazaji wa picha ni kuunda upya kwa njia ya bandia sehemu ya picha iliyokosekana au kufichwa kwa kutumia taarifa ya maeneo yanayoizunguka. Katika nyuso za binadamu kazi hii ni ngumu hasa; kwa sababu kuna vipengele vingi vinavyohusiana kama nafasi ya macho kwa kila mmoja, jiometri ya pua–mdomo, muundo wa taya, mtiririko wa nywele, rangi ya ngozi na usawaziko wa uso.
Maski za kisemantiki zinazotumika katika utafiti ni tofauti na mapengo yenye maumbo ya nasibu. Maski hutumia lebo ya segmentation ya kipengele fulani cha anatomia/kimuonekano kuficha kipengele hicho chote. Kwa mfano, maski ya macho hufunika macho pamoja na nyusi; madarasa ya mdomo hufunika mchanganyiko tofauti wa mdomo wa juu, mdomo wa chini na eneo la mdomo; maski ya nywele hufunika nywele zote; maski ya “face” hufunika ngozi ya uso isipokuwa shingo, macho, pua, mdomo na masikio.
Kwa kuwa hatua hii haiachi jicho au mdomo unaoonekana kwa sehemu, tatizo la rekonstruksi huwa na utata. Kuna maumbo mengi yanayowezekana ya macho, midomo au nywele yanayoweza kufaa eneo lilelile la uso linaloonekana. Kwa hiyo, picha inayozalishwa kuonekana ya kuaminika haimaanishi kwamba kipengele cha asili kilichofichwa kimerejeshwa kweli sawa.
Ni modeli zipi za akili bandia zilichunguzwa?
Watafiti walichagua mbinu kutoka katika fasihi ya awali ya image inpainting zinazowakilisha familia tofauti za usanifu. Hizi ni pamoja na mifumo ya GAN-based, Transformer-based, inayotegemea latent representation na diffusion-based.
| Modeli | Taarifa kuu ya azimio | Jukumu lake katika utafiti |
|---|---|---|
| MI-GAN | 256 | Modeli nyepesi ya ujazaji wa picha iliyoundwa kwa vifaa vya mkononi. |
| Latent-based | 256 | Mbinu ya pluralistic image inpainting inayotegemea discrete latent codes. |
| CMT | 256 | Mbinu ya Continuous-Mask-Aware Transformer. |
| MAT | 256 na 512 | Mask-Aware Transformer; modeli za CelebA na FFHQ zilitathminiwa. |
| LaMa | 256, 512 na 1024 katika majedwali ya chanzo | Mbinu ya inpainting yenye maski pana inayotumia Fourier convolutions. |
| Co-Mod-GAN | 512 na 1024 | Ilitathminiwa katika ujazaji wa picha wa azimio la juu. |
| MADF | 512 | Mbinu ya mask-aware cascaded refinement. |
| RePaint | 256 katika jedwali la modeli la chanzo | Mbinu ya diffusion-based; ilitathminiwa kwa sampuli chache kutokana na gharama kubwa ya ukokotoaji. |
Upeo wa RePaint ni tofauti kwa wazi na modeli nyingine. Watafiti waliripoti kwamba kujaza picha moja kwa darasa moja la maski ya kisemantiki huchukua takriban dakika tano; tathmini ya picha 10 kwa madarasa 12 huhitaji takriban saa 10. Kwa hiyo RePaint ilijaribiwa katika picha 10 pekee na haikujumuishwa katika ulinganisho wa kiasi wa kiwango sawa na mbinu nyingine.
Seti ya data na segmentation ya kisemantiki zilitumikaje?
Katika utafiti zilitumika takriban picha 30.000 za uso zenye ubora wa juu zinazotegemea CelebA-HQ. Picha asilia zina azimio la 1024 × 1024 na zilibadilishwa ukubwa kulingana na mahitaji ya modeli. Muundo wa madarasa 19 ulitumika kama msingi wa segmentation ya kisemantiki ya uso.
Kielelezo 1 cha utafiti kinaonyesha, pembeni ya picha asilia ya uso, mwonekano wa uso uliogawanywa katika sehemu za kisemantiki. Nywele, ngozi ya uso, macho/nyusi, pua, masikio, mdomo wa juu, mdomo wa chini na mdomo vilikodiwa kama maeneo tofauti. Hivyo iliwezekana kuunda maski zinazofuata mipaka ya kipengele halisi cha uso badala ya maski za mstatili wa nasibu au alama ya brashi.
| Maski | Kipengele kikuu kinachofichwa |
|---|---|
| A | Macho na nyusi |
| B | Pua |
| C | Mdomo wa juu + mdomo wa chini + mdomo |
| D | Mdomo wa chini |
| E | Mdomo wa juu |
| F | Mdomo |
| G | Nywele |
| H | Masikio/eneo husika la hereni |
| I | Ngozi ya uso |
| J | Pua + mdomo wa juu + mdomo wa chini + mdomo |
| K | Macho + pua + midomo + mdomo |
| L | Ngozi ya uso + nywele + masikio |
Verianla Live: Mtiririko mkuu wa jaribio
| Hatua | Operesheni katika utafiti |
|---|---|
| 1. Picha za uso | Picha za CelebA-HQ/CelebAMask-HQ zilitumika. |
| 2. Segmentation ya kisemantiki | Vipengele lengwa vilitolewa kutoka segmentation ya uso ya madarasa 19. |
| 3. Kuunda maski | Madarasa 12 ya maski za kisemantiki yalifafanuliwa kati ya A–L. |
| 4. Ulinganisho wa modeli zilizofundishwa kabla | Miundo tofauti ya GAN, Transformer, latent na diffusion-based ilitathminiwa. |
| 5. Ulinganisho wa azimio | Maazimio ya 256, 512 na 1024 yalichunguzwa kulingana na msaada wa modeli. |
| 6. Mafunzo upya ya MAT | Mafunzo matatu tofauti yalifanywa kwa maski za nasibu, kisemantiki na mchanganyiko. |
| 7. Uthibitishaji wa takwimu | Tofauti za FID zilijaribiwa kwa bootstrap subsamples zilizoundwa kutoka picha 6000. |
FID, P-IDS na U-IDS zinapima nini?
Watafiti walipendelea metriki za perceptual zinazotegemea Inception feature space badala ya PSNR na SSIM za kiwango cha pikseli. Kipimo kikuu ni Fréchet Inception Distance (FID). FID inalinganisha tofauti ya distributions za picha halisi na zilizozalishwa katika feature space, na katika utafiti FID ya chini ilitathminiwa kuwa matokeo bora:
\[ FID(p_r,p_g)=\|\mu_r-\mu_g\|_2^2+ Tr\left(\Sigma_r+\Sigma_g-2(\Sigma_r\Sigma_g)^{1/2}\right) \]
Hapa \(\mu_r\) na \(\mu_g\) zinawakilisha wastani wa features za picha halisi na zinazozalishwa; \(\Sigma_r\) na \(\Sigma_g\) zinawakilisha covariance matrices.
Makala pia inatumia vipimo vya P-IDS na U-IDS. Hata hivyo, kuna kutokuwiana muhimu kwa kimetodolojia katika chanzo. Equations zilizotolewa zinaandika vipimo hivi kama wastani wa squared distances kati ya features za picha halisi na zinazozalishwa:
\[ P\text{-}IDS=\frac{1}{N}\sum_{i=1}^{N}\|f(x_i)-f(x'_i)\|_2^2 \]
\[ U\text{-}IDS=\frac{1}{N}\sum_{i=1}^{N}\|f_u(x_i)-f_u(x'_i)\|_2^2 \]
Katika umbo hili la equation, distance ndogo ina maana ya feature match iliyo karibu zaidi. Hata hivyo, maelezo ya Jedwali 4 na tafsiri za matokeo za utafiti zinapanga thamani kubwa zaidi kama utendaji bora kwa P-IDS/U-IDS. Kwa kuwa chanzo hakielezi tofauti hii ya mwelekeo, matokeo ya P-IDS na U-IDS yatawasilishwa hapa kama yalivyoripotiwa na waandishi, lakini mwelekeo wa metriki hautahitimishwa kwa uhakika kwa kujitegemea.
Ni modeli zipi zilijitokeza katika azimio la 256?
Katika azimio la 256 × 256, kwa FID, MI-GAN iliingia katika modeli tatu bora katika madarasa 10 kati ya 12 ya maski za kisemantiki na kutoa thamani bora katika madarasa manne. Modeli ya Latent-based iliingia katika tatu bora katika madarasa tisa na kutoa FID bora katika madarasa sita. MAT iliingia katika tatu bora katika madarasa manane ya maski.
Kulingana na tafsiri ya P-IDS ya utafiti wenyewe, MI-GAN ilitoa P-IDS ya juu zaidi katika madarasa yote ya maski; katika U-IDS ilitoa matokeo ya juu zaidi katika madarasa 10. Hata hivyo, kwa sababu ya kutokuwiana kwa equation–tafsiri kuhusu mwelekeo wa P-IDS/U-IDS uliotajwa hapo juu, mpangilio huu haupaswi kutafsiriwa kwa uhakika uleule kama matokeo ya FID.
Makosa ya kuona yalikuwa yapi katika azimio la 512?
Katika ulinganisho wa 512 × 512, modeli ya FFHQ ya MAT iliingia katika modeli tatu bora katika madarasa yote 12 ya maski kwa FID na kutoa thamani bora ya FID katika madarasa saba. Modeli ya MAT inayotegemea CelebA iliingia katika tatu bora katika madarasa 11.
Hata hivyo, mifano ya kuona katika Kielelezo 2 cha utafiti inaonyesha kwamba alama za kiasi peke yake hazitoshi. Watafiti waliripoti kwamba LaMa na MADF zinaweza kuzalisha macho yaliyofifia au yaliyochanganyika katika urejeshaji wa macho; LaMa inaweza kutengeneza pua ndogo na muundo kama mdomo mara mbili katika baadhi ya maski za pua; MAT inaweza kufanya kope kuwa nene katika baadhi ya maski za uso; Co-Mod-GAN inaweza kuacha mipaka inayoonekana kuzunguka pua; na MADF inaweza katika baadhi ya mifano kuzalisha jicho la ziada au meno yanayovuka juu ya midomo.
Tofauti kati ya Co-Mod-GAN na LaMa katika azimio la 1024
Katika tathmini ya 1024 × 1024, Co-Mod-GAN na LaMa pekee zililinganishwa. Kwa FID, Co-Mod-GAN ilipata thamani ya chini kuliko LaMa katika madarasa 11 kati ya 12 ya maski za kisemantiki. Isipokuwa pekee ni maski E ya mdomo wa juu; hapa FID ya LaMa ni 0,37 na ya Co-Mod-GAN ni 0,72.
Verianla Live: FID katika maski ngumu zilizochaguliwa katika azimio la 1024
FID ya chini inaonyesha kufanana bora kwa distribution. Uwasilishaji huu unaonyesha hasa maeneo makubwa au yenye ugumu wa kimuundo wa kisemantiki.
| Darasa la maski | Co-Mod-GAN FID | LaMa FID |
|---|---|---|
| G — Nywele | 11,60 | 41,85 |
| I — Uso | 11,24 | 33,61 |
| J — Pua + eneo la mdomo | 3,93 | 9,20 |
| K — Jicho + pua + eneo la mdomo | 6,23 | 18,58 |
| L — Uso + nywele + masikio | 65,73 | 206,07 |
Kielelezo 3 kinaonyesha mifano ya LaMa katika maazimio ya 256, 512 na 1024 pembeni kwa pembeni, na kadiri azimio linavyoongezeka, uharibifu unaoonekana unaweza kutokea katika baadhi ya vipengele vya uso. Katika Kielelezo 4, matokeo ya Co-Mod-GAN katika 512 na 1024 yanaonekana kuwa karibu zaidi kwa kila mmoja. Uchunguzi huu ndio msingi wa waandishi wa chanzo kuitathmini Co-Mod-GAN kama modeli yenye ufanisi zaidi kwa azimio la juu.
Hata hivyo, ingawa katika matini ya mbinu kuna kauli yenye maana kwamba “LaMa ilitathminiwa katika 512 na 256 kwa sababu ilionekana kutofanya kazi katika azimio la juu”, sehemu inayofuata, Jedwali 5 na Kielelezo 3 zinaonyesha wazi matokeo ya LaMa ya 1024. Mkanganyiko huu wa ndani ya chanzo unapaswa kuhifadhiwa bila kutatuliwa.
Ni vipengele gani vya uso vilikuwa na matatizo zaidi kwa modeli?
Matokeo yanaonyesha kwamba hakuna modeli moja iliyoonyesha ubora wa kuaminika katika maeneo yote ya uso. Katika ukaguzi wa kuona wa utafiti chanzi kulingana na modeli, aina zifuatazo za makosa ziliripotiwa:
- Jicho: kope nene kupita kiasi, jicho jeusi, kutolingana kwa nafasi au rangi ya mboni, muundo wa jicho uliopauka au kuchanganyika.
- Mdomo na midomo: midomo kuungana, meno yasiyo ya kawaida au yaliyopasuka, meno kupita juu ya mdomo, matatizo ya nafasi na rangi ya mdomo wa chini.
- Ngozi ya uso: kuonekana kwa mipaka ya maski, tofauti ya rangi ya ngozi, uso kufupika/kukonda, miundo inayofanana na reflection.
- Nywele: mtiririko usio wa kawaida, kupotea kwa mwendelezo wa rangi, uzalishaji wa nywele kwa vipande au baadhi ya maeneo ya maski kujazwa na background/sikio.
- Sikio: sikio kukosekana au eneo la sikio kubadilishwa na nywele.
- Pua: ingawa mara nyingi ina mafanikio kiasi katika modeli nyingi, katika baadhi ya hali rekonstruksi inaweza kuwa pungufu, ndogo au yenye mipaka inayoonekana.
Kielelezo cha ziada A1 kinalinganisha sehemu zilizokuzwa za macho, mdomo/midomo, uso na mchanganyiko wa pua+mdomo kulingana na modeli. Mwonekano huu wa karibu unaonyesha kwa uwazi zaidi kasoro kama unene wa kope, kuungana kwa mdomo–meno na mabadiliko ya rangi ambazo ni ngumu kugundua katika picha kamili.
Mbinu na Matokeo ya Utafiti
Vifaa vya jaribio
| Kipengele | Sifa iliyoripotiwa katika utafiti |
|---|---|
| GPU | 2 × NVIDIA A800 Active |
| Kumbukumbu ya GPU | 40 GB kwa kila GPU |
| CUDA | 12.0 |
| CPU | Intel Xeon w9-3495X |
| Core za CPU | Core 56, 1,9–4,8 GHz |
| RAM | 256 GB |
| Matumizi ya hifadhi | 286 GB |
Muda wa uendeshaji wa modeli
Utafiti unaeleza kwamba mbinu zote isipokuwa RePaint zinaweza kukamilisha picha moja kwa chini ya sekunde 0,3. Kulingana na Jedwali 6, muda wa kuchakata picha 2000 ni kama ifuatavyo:
| Modeli | Muda ulioripotiwa katika Jedwali 6 la chanzo |
|---|---|
| MAT | 256: dakika 3; 512: dakika 5 |
| Co-Mod-GAN | 512: dakika 1; 1024: dakika 2 |
| MADF | Dakika 6 katika safu ya 512 |
| CMT | Dakika 1 katika safu ya 512 |
| Latent-based | Dakika 10 katika safu ya 512 |
| MI-GAN | Dakika 2 katika safu ya 512 |
| LaMa | 256: dakika 0,5–1; 512: dakika 1,5; 1024: dakika 5 |
| RePaint | Takriban dakika 5/picha katika safu ya 512 |
Hapa kuna kutokuwiana kwa azimio ndani ya chanzo. Jedwali 1 la uchaguzi wa modeli linaeleza azimio la 256 kwa CMT, Latent-based, MI-GAN na RePaint, huku Jedwali 6 la muda wa ukokotoaji likiweka muda wa modeli hizi katika safu ya 512 × 512. Makala haielezi sababu yake; kwa hiyo jedwali la muda limewasilishwa hapo juu kama linavyoonekana katika chanzo.
Kwa nini MAT ilifundishwa upya?
MAT, ambayo ilitoa matokeo mazuri katika ulinganisho wa azimio la 512, ilitumika kulinganisha mikakati mitatu tofauti ya mafunzo kwa tatizo la maski za kisemantiki:
- Mafunzo kwa maski za nasibu pekee,
- Mafunzo kwa maski za kisemantiki pekee,
- Mafunzo mchanganyiko ambapo maski za nasibu na kisemantiki hutumika pamoja.
Modeli ya MAT ilianzishwa kutoka mwanzo katika kila jaribio. Picha 24.000 zilitumika katika mafunzo na picha 6000 katika test. Learning rate ya Adam optimizer iliwekwa kuwa \(1\times10^{-4}\), \(\beta_1=0.9\) na \(\beta_2=0.999\); batch size 8 na muda wa mafunzo 100 epoch vilitumika. Batch size ilipunguzwa hadi 8 kutokana na kikomo cha 40 GB cha kumbukumbu kinachopatikana kwa kila GPU.
Kama standard data augmentation, random horizontal flipping na rotation zilitumika, bila color jitter ya ziada au geometric transformation nyingine. Kila session ya mafunzo iliripotiwa kuchukua takriban siku 7 saa 13.
Kwa nini maski ya nasibu ilifanya vizuri kuliko maski ya kisemantiki pekee?
Katika matokeo ya kwanza ya mafunzo upya, licha ya test kufanywa kwa maski za kisemantiki, modeli ya MAT iliyofundishwa kwa maski za nasibu pekee kwa ujumla ilitoa FID ya chini kuliko MAT iliyofundishwa kwa maski za kisemantiki pekee. Waandishi wanaeleza hili kwa kusema maski za nasibu huunda maeneo yaliyokosekana yenye utofauti mkubwa zaidi na kulazimisha modeli kujifunza mahusiano ya muktadha katika picha nzima.
Maelezo haya ni tafsiri iliyopendekezwa na utafiti. Utafiti haukupima moja kwa moja mekanizimu ya overfitting kwa majaribio tofauti; kwa hiyo generalization ya kisababishi kwamba “maski ya nasibu bila shaka hupunguza overfitting” haipaswi kufanywa.
Matokeo ya FID ya mkakati wa maski mchanganyiko
| Maski | FID ya mafunzo ya nasibu | FID ya mafunzo ya kisemantiki | FID ya mafunzo mchanganyiko |
|---|---|---|---|
| A | 1,46 | 1,78 | 1,25 |
| B | 0,93 | 0,95 | 0,93 |
| C | 2,01 | 3,73 | 1,59 |
| D | 0,75 | 1,20 | 0,71 |
| E | 0,74 | 1,40 | 0,56 |
| F | 2,36 | 2,05 | 1,24 |
| G — Nywele | 12,51 | 17,38 | 7,10 |
| H | 3,90 | 3,91 | 3,33 |
| I — Uso | 8,16 | 9,25 | 5,69 |
| J | 2,46 | 4,00 | 2,20 |
| K | 3,56 | 5,00 | 3,03 |
| L — Uso + nywele + masikio | 115,51 | 114,35 | 130,82 |
Mafunzo mchanganyiko yalitoa FID ya chini kuliko mikakati yote miwili ya pekee katika madarasa A, C, D, E, F, G, H, I, J na K. Katika darasa B, thamani sawa ya FID ya 0,93 kama mafunzo ya nasibu ilipatikana. Katika darasa L, ambalo ni maski pana zaidi, FID ya mafunzo mchanganyiko ilipanda hadi 130,82 na ilikuwa mbaya kuliko mafunzo ya nasibu na kisemantiki. Kwa hiyo, matokeo hayawezi kujumlishwa kama “mbinu mchanganyiko ni bora katika kila hali”.
Uthibitishaji wa bootstrap ulionyesha nini?
Watafiti walifanya bootstrap analysis kutoka seti ya test ya picha 6000 ili kuchunguza kama tofauti za FID zilitokana tu na sampuli fulani za test. Katika kila tathmini, picha 1000 za kipekee zilichaguliwa na mchakato ukarudiwa mara 100. Picha ileile haikurudiwa ndani ya bootstrap sample moja, lakini ingeweza kuonekana tena katika bootstrap samples tofauti.
Katika Jedwali la Ziada A2, mafunzo ya maski mchanganyiko yaliashiriwa kutoa FID ya chini kuliko mafunzo ya nasibu na kisemantiki katika madarasa A, C, D, E, F, G, I, J na K, na tofauti zilikuwa statistically significant katika kiwango cha p<0,01. Kwa B na H, significance hii ya pande zote mbili haikuonyeshwa; katika darasa L, mbinu mchanganyiko ilitoa FID mbaya zaidi.
| Maski iliyochaguliwa | FID ya nasibu, wastani ± SS | FID ya kisemantiki, wastani ± SS | FID ya mchanganyiko, wastani ± SS | Matokeo ya chanzo |
|---|---|---|---|---|
| C — Mdomo/midomo yote | 2,03 ± 0,05 | 3,76 ± 0,09 | 1,60 ± 0,04 | Mchanganyiko, chini kuliko zote mbili kwa p<0,01. |
| G — Nywele | 12,66 ± 0,33 | 17,43 ± 0,42 | 7,15 ± 0,21 | Mchanganyiko, chini kuliko zote mbili kwa p<0,01. |
| I — Uso | 8,22 ± 0,21 | 9,30 ± 0,24 | 5,71 ± 0,15 | Mchanganyiko, chini kuliko zote mbili kwa p<0,01. |
| L — Uso + nywele + sikio | 116,10 ± 3,23 | 114,90 ± 3,19 | 131,45 ± 3,51 | Mbinu mchanganyiko si bora. |
Mifano ya kuona inaonyeshaje mbinu mchanganyiko?
Katika Kielelezo 5, urejeshaji wa uso, nywele na mdomo/midomo yote wa modeli za MAT zilizofundishwa kwa maski za nasibu, kisemantiki na mchanganyiko unaonyeshwa pembeni kwa pembeni. Kulingana na tathmini ya kuona ya waandishi, modeli iliyofundishwa kwa maski za nasibu inaweza kuchanganya rangi ya uso vizuri zaidi na mazingira, lakini jiometri ya uso inaweza kuonekana fupi na isiyolingana. Mafunzo ya kisemantiki yanaweza kukaribia zaidi umbo la uso, lakini rangi ya ngozi inaweza kutolingana na mazingira. Mafunzo mchanganyiko yalitoa matokeo yenye uwiano zaidi kati ya aina hizi mbili za makosa.
Kwa nywele, mafunzo ya nasibu yanaweza kuwa na tatizo la mtiririko wa nywele, na mafunzo ya kisemantiki ya mwendelezo wa rangi, huku mkakati mchanganyiko ukiweka uwiano bora wa vipengele vyote viwili. Katika mfano wa mdomo pia, mafunzo mchanganyiko yaliwasilishwa kwa kuona kuwa bora kuliko mikakati mingine miwili. Hata hivyo, hizi ni mifano ya kuona iliyochaguliwa; utafiti hauripoti perceptual user study iliyopofushwa yenye watathmini huru wa kibinadamu.
Mapungufu ya kimuundo yaliyotambuliwa na utafiti
Watafiti wanahoji kwamba kubadilisha data ya mafunzo pekee hakuwezi kutatua tatizo kabisa na kwamba architectures zilizopo zina mipaka ya kimuundo:
- Local receptive field na convolutional bias: Maski kamili ya kisemantiki inaweza kuondoa kabisa vidokezo vya eneo ambavyo modeli za CNN/GAN zinaweza kutumia.
- Global na semantic reasoning dhaifu: Modeli za Transformer na diffusion zinaweza kuwakilisha muktadha mpana, lakini haziwezi kila mara kuhifadhi uhusiano sahihi wa kimuundo kati ya vipengele vya anatomia katika picha.
- Structural priors chache: Miundo haijui anatomia ya uso kwa namna ya sheria wazi; hasa hujifunza mahusiano ya takwimu katika data ya mafunzo.
- Kutokuwa na uhakika: Kwa kipengele kisichoonekana kabisa, kunaweza kuwa na suluhisho kadhaa zinazokubalika kwa kuona.
Waandishi wanapendekeza kwamba katika siku zijazo zichunguzwe architectures zinazomodeli wazi vipengele vya uso, kuzingatia jiometri ya uso na utegemezi wa vipengele; mafunzo ya maski adaptive na loss functions maalum kwa kila kipengele.
Utafiti hauthibitishi nini?
- Haithibitishi kwamba jicho, mdomo, pua au nywele asilia zilizo chini ya maski zinaweza kurejeshwa kwa usahihi wa utambulisho.
- Haithibitishi kwamba vipengele vya uso vinavyozalishwa ni vya kuaminika anatomically kwa rekonstruksi ya kitabibu.
- Utafiti hautumii data ya wagonjwa halisi, majeraha, kuungua au rekonstruksi ya uso ya upasuaji.
- Haupimi mafanikio ya kuhifadhi utambulisho halisi katika mifumo ya ulinzi wa faragha au utambuzi wa uso.
- Hauonyeshi kwamba mbinu ya maski mchanganyiko ni bora katika maski zote au architectures zote za inpainting.
- Hauonyeshi kwamba FID ya chini inamaanisha matokeo kamilifu kwa jicho la binadamu au kwa kuhifadhi utambulisho.
- Kwa kuwa RePaint haikulinganishwa na modeli nyingine kwa idadi sawa ya sampuli na budget sawa ya ukokotoaji, hauungi mkono hitimisho kwamba diffusion models kwa ujumla ni mbaya zaidi.
Maelezo ya Chanzo na Mbinu
| Jina kamili la utafiti asilia | Evaluating AI-Based Image Inpainting Techniques for Facial Components Restoration Using Semantic Masks |
|---|---|
| Waandishi | Hussein Sharadga; Abdullah Hayajneh; Erchin Serpedin |
| Mchango sawa | Hakuna taarifa ya mwandishi wa kwanza sawa/mchango sawa iliyotolewa katika chanzo. |
| Mwandishi wa mawasiliano | Hussein Sharadga |
| Taasisi | School of Engineering, Texas A&M International University, Marekani; King Abdullah II School of Engineering, Princess Sumaya University for Technology, Jordan; Department of Electrical and Computer Engineering, Texas A&M University, Marekani. |
| Aina ya chanzo | Makala ya utafiti iliyopitiwa na rika; utafiti wa kulinganisha benchmark na mafunzo upya wa akili bandia/uchakataji wa picha. |
| Hali ya mapitio | Makala iliyochapishwa katika jarida lililopitiwa na rika; si preprint. |
| Jarida | AI |
| Mchapishaji | MDPI |
| Juzuu / toleo / makala | 2026, 7(4), 119 |
| DOI | 10.3390/ai7040119 |
| Kupokelewa / marekebisho / kukubaliwa / kuchapishwa | 8 Februari 2026 / 12 Machi 2026 / 23 Machi 2026 / 30 Machi 2026 |
| Kiungo rasmi | https://doi.org/10.3390/ai7040119 |
| Leseni | Creative Commons Attribution (CC BY). |
Ufadhili, data na mgongano wa maslahi
Waandishi wameripoti kwamba utafiti haukupokea ufadhili wa nje. Imeelezwa kwamba ada ya uchakataji wa makala ililipwa na Texas A&M International University. Waandishi wametangaza kwamba hakuna mgongano wa maslahi.
Picha za uso zilizotumika katika utafiti zilitolewa kutoka seti ya data ya umma CelebAMask-HQ na utafiti chanzi unaeleza kwamba seti hii ilitumika kwa madhumuni ya utafiti yasiyo ya kibiashara pekee. Waandishi wanaeleza kwamba hawana ruhusa ya kusambaza upya picha ghafi za uso.
Taarifa ya matumizi ya akili bandia generative
Katika sehemu ya shukrani ya utafiti chanzi, waandishi wameripoti kwamba walitumia toleo la “GPT-5 mini, free version” la ChatGPT kwa madhumuni ya kuboresha usomekaji wa makala; baadaye walikagua na kuhariri maudhui wenyewe na kukubali kuwajibika kwa matini iliyochapishwa. Taarifa hii haimaanishi kwamba matokeo ya majaribio ya image inpainting ya utafiti yalizalishwa na ChatGPT.
Michango ya waandishi
Waandishi wote watatu walichangia conceptualization. Methodology, software, data curation na project management zilifanywa na Hussein Sharadga na Abdullah Hayajneh; waandishi wote watatu walishiriki katika validation na investigation. Draft asilia iliandaliwa na Hussein Sharadga na Abdullah Hayajneh; waandishi wote watatu walichangia review na editing.
Rekodi ya kutokuwiana ndani ya chanzo
- Ingawa equations za P-IDS na U-IDS zinafafanuliwa kama kipimo cha distance, majedwali na matini hutafsiri thamani ya juu kuwa utendaji bora. Chanzo hakielezi tofauti hii.
- Matini ya mbinu inasema LaMa ilitathminiwa katika 256 na 512 kwa sababu ilionekana kutofanya kazi katika azimio la juu, lakini baadaye matokeo ya LaMa ya 1024 yanaripotiwa.
- Jedwali 1 la modeli linaripoti azimio la 256 kwa CMT, Latent-based, MI-GAN na RePaint, huku Jedwali 6 la muda wa ukokotoaji likionyesha muda wa modeli hizi katika safu ya 512 × 512.
Mapungufu makuu
- Matokeo yanategemea familia moja kuu ya seti ya data ya uso.
- Hakuna seti ya data ya rekonstruksi ya uso ya kliniki au majeraha iliyotumika.
- Si kila modeli ilijaribiwa katika maazimio sawa na budget sawa ya ukokotoaji.
- RePaint ilitathminiwa kwa kiwango kidogo katika picha 10 pekee.
- Hakuna utafiti wa watathmini huru wa kibinadamu uliopofushwa uliotolewa kwa tathmini ya ubora wa kuona.
- FID ni kipimo cha perceptual similarity cha distribution; haithibitishi kwamba kipengele halisi cha uso kilichopotea cha mtu asilia kimeundwa upya.
- Katika darasa pana zaidi la maski L, mafunzo mchanganyiko yalizalisha FID mbaya zaidi.
- Kuna kutokuwiana kwa ufafanuzi na tafsiri kuhusu mwelekeo wa metriki za P-IDS/U-IDS katika chanzo.
Matokeo yenye nguvu zaidi ya utafiti ni kwamba vipengele vya uso vya kisemantiki vilivyofichwa kabisa bado ni tatizo gumu kwa modeli zilizopo za image inpainting, na utofauti wa maski unaweza kuathiri kwa kiasi kikubwa utendaji wa mafunzo. Ingawa mkakati wa mafunzo mchanganyiko wa nasibu–kisemantiki umeboresha FID katika vipengele vingi vya uso, utafiti hauonyeshi kwamba rekonstruksi kamilifu ya uso imefikiwa; kinyume chake, unaonyesha kwamba hili bado ni tatizo wazi la utafiti.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *