

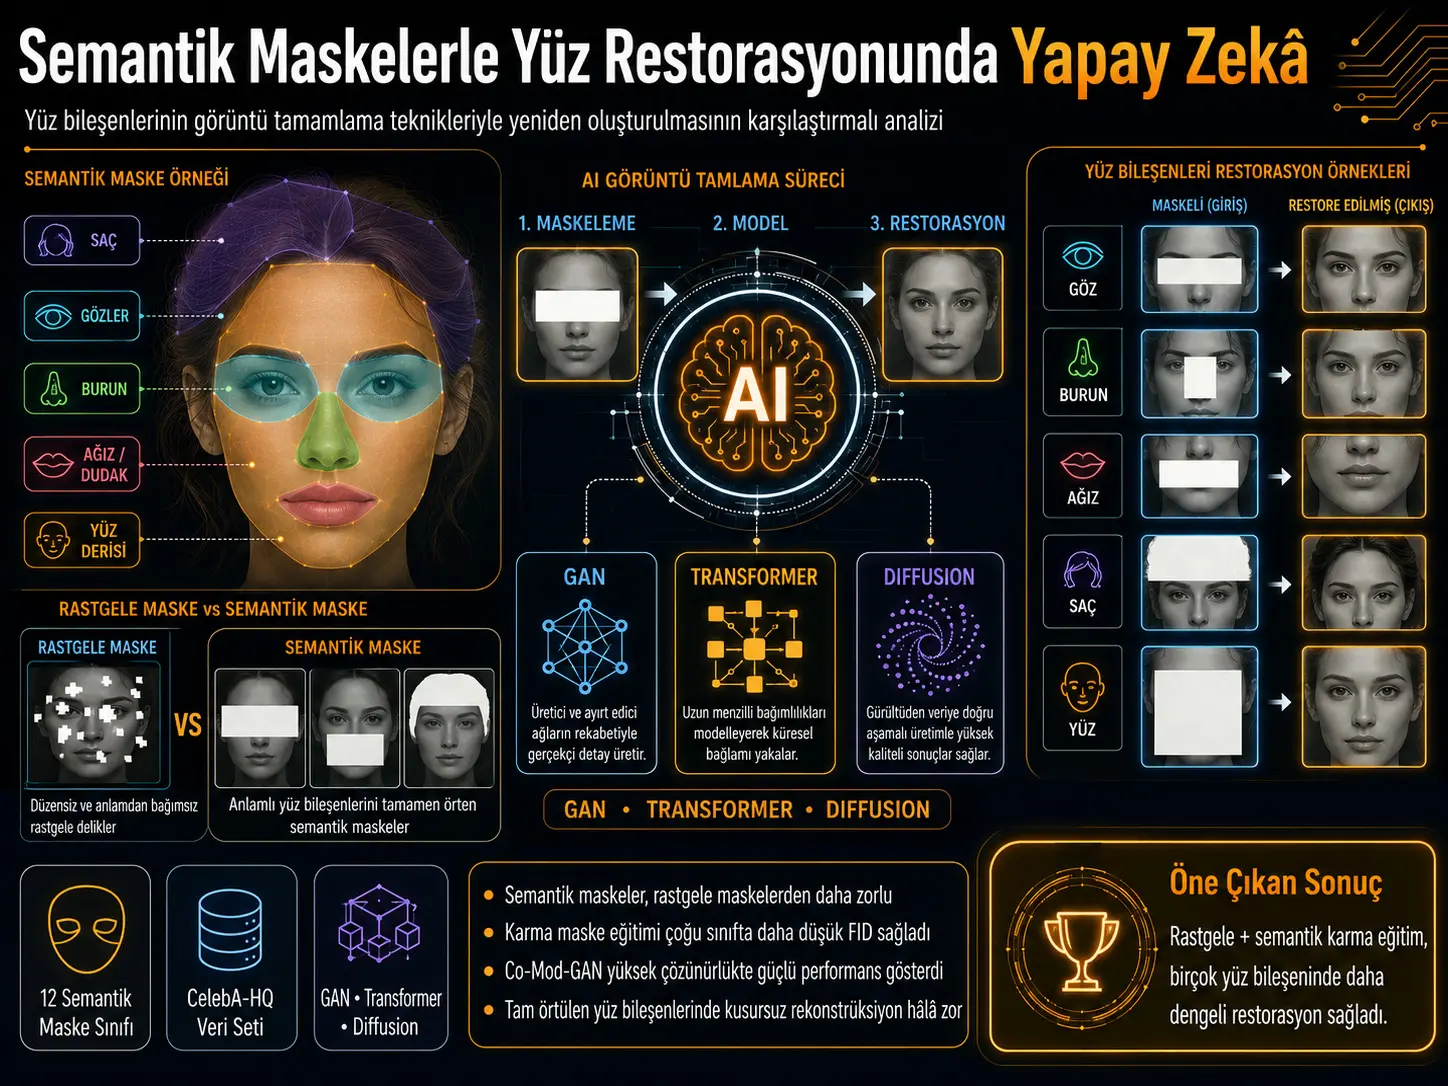
Bu araşdırma göz, burun, ağız, saç və ya üz dərisi kimi üz komponenti semantik maska ilə tamamilə gizlədildikdə müasir süni intellekt əsaslı görüntü tamamlama (image inpainting) üsullarının çatışmayan sahəni nə dərəcədə yenidən yarada bildiyini müqayisə edir. CelebA-HQ/CelebAMask-HQ üz təsvirləri və 12 müxtəlif semantik maska sinfindən istifadə etməklə MI-GAN, Latent-based, CMT, MAT, LaMa, Co-Mod-GAN, MADF və məhdud miqyasda RePaint kimi fərqli arxitektura ailələri qiymətləndirilib. Tədqiqatın ikinci mərhələsində MAT modeli 24.000 təlim görüntüsü ilə təsadüfi, semantik və bu iki maska tipini birləşdirən qarışıq strategiyalar altında sıfırdan yenidən öyrədilib və 6000 görüntü üzərində sınaqdan keçirilib. Qarışıq maska təlimi FID baxımından 12 semantik maska sinfinin 10-da ən aşağı dəyəri verib; bir sinifdə təsadüfi maska ilə eyni nəticə əldə edib, ən geniş birləşik maska sinfində isə daha zəif performans göstərib. Buna baxmayaraq tədqiqat tamamilə örtülmüş üz komponentlərinin qüsursuz və ya orijinal şəxsə identiklik baxımından düzgün şəkildə bərpa edilə bildiyini göstərmir.
Araşdırmanın əsas çətinliyi təsadüfi maskalarla semantik maskalar arasındakı informasiya fərqidir. Təsadüfi maska gözün, dodağın və ya saç bölgəsinin yalnız bir hissəsini örtə bilər və model qalan piksel quruluşundan faydalana bilər. Semantik maska isə hədəf komponentin tamamını aradan qaldıraraq lokal struktur ipuclarını yox edir. Bu halda model görünməyən sahəni yalnız ətrafdakı üz həndəsəsi, tekstura, simmetriya və təlim zamanı öyrəndiyi statistik əlaqələr əsasında proqnozlaşdırmaq məcburiyyətində qalır.
Tədqiqatın vizual təcrübələri bu fərqin yalnız metriklərdə deyil, yaradılmış üzlərdə də ortaya çıxdığını göstərir. Modellər qalın və ya qara kirpiklər, yanlış hizalanmış göz bəbəkləri, birləşmiş dodaq və dişlər, nəzərə çarpan maska sərhədləri, dəyişən dəri tonları, qeyri-real saç axını, çatışmayan qulaqlar və ya bəzi hallarda əlavə göz kimi struktur xətaları yarada bilər. Buna görə aşağı FID dəyəri təkbaşına anatomik və ya identiklik baxımından qüsursuz rekonstruksiya demək deyil.
| Təcrübə elementi | Tədqiqatda istifadə olunan quruluş | Şərh sərhədi |
|---|---|---|
| Əsas məlumat dəsti | Təxminən 30.000 CelebA-HQ üz görüntüsü, 1024 × 1024 | Klinik xəstə və ya travma məlumat dəsti deyil. |
| Semantik maska sinfi | 12 sinif (A–L) | Müəyyən edilmiş üz komponentləri tamamilə gizlədilir. |
| Qiymətləndirilən çözünürlüklər | 256, 512 və 1024 | Hər model bütün çözünürlüklərdə qiymətləndirilməyib. |
| Əsas metriklər | FID, P-IDS, U-IDS | P-IDS/U-IDS istiqaməti barədə mənbədə tərif–şərh uyğunsuzluğu var. |
| MAT yenidən təlimi | 24.000 təlim + 6000 test görüntüsü | 512 × 512 çözünürlükdə həyata keçirilib. |
| Maska təlim strategiyaları | Təsadüfi, semantik, qarışıq | Qarışıq yanaşma əksər, lakin bütün maska siniflərində üstün deyil. |
Görüntü tamamlama problemi niyə semantik maskalarda çətinləşir?
Görüntü tamamlama təsvirin çatışmayan və ya gizlənmiş sahəsinin ətrafdakı məlumatdan istifadə etməklə süni şəkildə yenidən qurulmasıdır. İnsan üzlərində bu vəzifə xüsusilə çətindir; çünki gözlərin bir-birinə nisbətən mövqeyi, burun–ağız həndəsəsi, çənə quruluşu, saç axını, dəri tonu və üz simmetriyası kimi çoxsaylı əlaqəli xüsusiyyətlər var.
Tədqiqatda istifadə edilən semantik maskalar təsadüfi formalı boşluqlardan fərqlənir. Maskalar müəyyən anatomik/vizual komponentin segmentasiya etiketindən istifadə etməklə həmin komponentin tamamını gizlədir. Məsələn, göz maskası gözlərlə birlikdə qaşları; ağız sinifləri üst dodaq, alt dodaq və ağız sahəsinin müxtəlif kombinasiyalarını; saç maskası saçın tamamını; “face” maskası isə boyun, göz, burun, ağız və qulaqlar istisna olmaqla üz dərisini örtür.
Bu əməliyyat modelə qismən görünən göz və ya dodaq saxlamadığı üçün rekonstruksiya problemi qeyri-müəyyənləşir. Eyni görünən üz ətrafına uyğun ola biləcək çoxsaylı mümkün göz, dodaq və ya saç forması mövcuddur. Buna görə yaradılan təsvirin vizual baxımdan inandırıcı olması gizlədilən orijinal komponentin həqiqətən eynisinin geri gətirildiyi demək deyil.
Hansı süni intellekt modelləri araşdırılıb?
Araşdırmaçılar əvvəlki görüntü tamamlama ədəbiyyatından fərqli arxitektura ailələrini təmsil edən üsulları seçiblər. Bunlara GAN əsaslı, Transformer əsaslı, latent təsvirə söykənən və diffuziya əsaslı sistemlər daxildir.
| Model | Əsas çözünürlük məlumatı | Tədqiqatdakı rolu |
|---|---|---|
| MI-GAN | 256 | Mobil cihazlar üçün hazırlanmış yüngül görüntü tamamlama modeli. |
| Latent-based | 256 | Diskret latent kodlara əsaslanan plüralist görüntü tamamlama yanaşması. |
| CMT | 256 | Continuous-Mask-Aware Transformer yanaşması. |
| MAT | 256 və 512 | Mask-Aware Transformer; CelebA və FFHQ modelləri qiymətləndirildi. |
| LaMa | 256, 512 və mənbə cədvəllərində 1024 | Fourier convolutions istifadə edən geniş maskalı inpainting yanaşması. |
| Co-Mod-GAN | 512 və 1024 | Yüksək çözünürlüklü görüntü tamamlamada qiymətləndirildi. |
| MADF | 512 | Mask-aware cascaded refinement yanaşması. |
| RePaint | Mənbə model cədvəlində 256 | Diffuziya əsaslı üsul; yüksək hesablama xərci səbəbilə yalnız məhdud nümunə ilə qiymətləndirildi. |
RePaint-in əhatəsi digər modellərdən açıq şəkildə fərqlənir. Araşdırmaçılar bir görüntünü bir semantik maska sinfi ilə tamamlamağın təxminən beş dəqiqə çəkdiyini; 10 görüntünün 12 sinif üzrə qiymətləndirilməsinin təxminən 10 saat tələb etdiyini bildiriblər. Buna görə RePaint yalnız 10 görüntü üzərində sınaqdan keçirilib və digər üsullarla eyni miqyaslı kəmiyyət müqayisəsinə daxil edilməyib.
Məlumat dəsti və semantik segmentasiya necə istifadə edildi?
Araşdırmada CelebA-HQ əsaslı təxminən 30.000 yüksək keyfiyyətli üz görüntüsündən istifadə edilib. Orijinal görüntülər 1024 × 1024 çözünürlükdədir və model tələblərinə uyğun olaraq yenidən ölçüləndirilib. Üz semantik segmentasiyasında 19 sinifli quruluş əsas götürülüb.
Tədqiqatın Şəkil 1-i orijinal üz görüntüsünün yanında üzün semantik olaraq hissələrə bölündüyü görünüşü göstərir. Saç, üz dərisi, gözlər/qaşlar, burun, qulaqlar, üst dodaq, alt dodaq və ağız fərqli sahələr kimi kodlanıb. Beləliklə təsadüfi düzbucaqlı və ya fırça izi formalı maskalar əvəzinə real üz komponentinin sərhədlərini izləyən maskalar yaradıla bilib.
| Maska | Gizlədilən əsas komponent |
|---|---|
| A | Gözlər və qaşlar |
| B | Burun |
| C | Üst dodaq + alt dodaq + ağız |
| D | Alt dodaq |
| E | Üst dodaq |
| F | Ağız |
| G | Saç |
| H | Qulaqlar/əlaqəli sırğa sahəsi |
| I | Üz dərisi |
| J | Burun + üst dodaq + alt dodaq + ağız |
| K | Gözlər + burun + dodaqlar + ağız |
| L | Üz dərisi + saç + qulaqlar |
Verianla Live: Təcrübənin əsas axını
| Mərhələ | Tədqiqatdakı əməliyyat |
|---|---|
| 1. Üz görüntüləri | CelebA-HQ/CelebAMask-HQ görüntüləri istifadə edildi. |
| 2. Semantik segmentasiya | 19 sinifli üz segmentasiyasından hədəf komponentlər çıxarıldı. |
| 3. Maska yaratma | A–L arasında 12 semantik maska sinfi müəyyən edildi. |
| 4. Əvvəlcədən öyrədilmiş model müqayisəsi | Fərqli GAN, Transformer, latent və diffuziya əsaslı modellər qiymətləndirildi. |
| 5. Çözünürlük müqayisəsi | Model dəstəyinə görə 256, 512 və 1024 çözünürlüklər araşdırıldı. |
| 6. MAT yenidən təlimi | Təsadüfi, semantik və qarışıq maskalarla üç ayrı təlim həyata keçirildi. |
| 7. Statistik doğrulama | 6000 görüntüdən yaradılan bootstrap alt nümunələri ilə FID fərqləri sınaqdan keçirildi. |
FID, P-IDS və U-IDS nəyi ölçür?
Araşdırmaçılar piksel səviyyəli PSNR və SSIM əvəzinə Inception xüsusiyyət fəzasına əsaslanan qavrayış metriklərinə üstünlük veriblər. Əsas ölçü Fréchet Inception Distance (FID) dəyəridir. FID real və yaradılmış görüntü paylanmalarının xüsusiyyət fəzasındakı fərqini müqayisə edir və tədqiqatda daha aşağı FID daha yaxşı nəticə hesab edilir:
\[ FID(p_r,p_g)=\|\mu_r-\mu_g\|_2^2+ Tr\left(\Sigma_r+\Sigma_g-2(\Sigma_r\Sigma_g)^{1/2}\right) \]
Burada \(\mu_r\) və \(\mu_g\) real və yaradılmış görüntü xüsusiyyətlərinin ortalamalarını; \(\Sigma_r\) və \(\Sigma_g\) isə kovariasiya matrislərini təmsil edir.
Məqalə həmçinin P-IDS və U-IDS ölçülərindən istifadə edir. Bununla belə mənbədə mühüm metodoloji uyğunsuzluq var. Verilən tənliklər bu ölçüləri real və yaradılmış görüntü xüsusiyyətləri arasındakı kvadratik məsafələrin ortalaması kimi yazır:
\[ P\text{-}IDS=\frac{1}{N}\sum_{i=1}^{N}\|f(x_i)-f(x'_i)\|_2^2 \]
\[ U\text{-}IDS=\frac{1}{N}\sum_{i=1}^{N}\|f_u(x_i)-f_u(x'_i)\|_2^2 \]
Bu tənlik formasında daha kiçik məsafə daha yaxın xüsusiyyət uyğunluğu deməkdir. Lakin tədqiqatın Cədvəl 4 izahı və nəticə şərhləri P-IDS/U-IDS üçün daha yüksək dəyərləri ən yaxşı performans kimi sıralayır. Mənbə bu istiqamət fərqini izah etmədiyi üçün burada P-IDS və U-IDS nəticələri müəlliflərin hesabat verdiyi şəkildə təqdim ediləcək, lakin metrik istiqaməti müstəqil olaraq qəti şəkildə müəyyən edilməyəcək.
256 çözünürlükdə hansı modellər önə çıxdı?
256 × 256 çözünürlükdə FID baxımından MI-GAN 12 semantik maska sinfinin 10-da ilk üçlüyə daxil olub və dörd sinifdə ən yaxşı dəyəri verib. Latent-based model doqquz sinifdə ilk üçə daxil olub və altı sinifdə ən yaxşı FID dəyərini verib. MAT isə səkkiz maska sinfində ilk üç arasında yer alıb.
Tədqiqatın öz P-IDS şərhinə görə MI-GAN bütün maska siniflərində ən yüksək P-IDS dəyərini verib; U-IDS-də isə 10 sinifdə ən yüksək nəticəni göstərib. Bununla belə yuxarıda qeyd edilən P-IDS/U-IDS istiqaməti üzrə tənlik–şərh uyğunsuzluğu səbəbindən bu sıralama FID nəticələri ilə eyni qətiyyətlə şərh edilməməlidir.
512 çözünürlükdə vizual xətalar nələr idi?
512 × 512 müqayisəsində MAT-ın FFHQ modeli FID baxımından 12 maska sinfinin hamısında ilk üç model arasında yer alıb və yeddi sinifdə ən yaxşı FID dəyərini verib. CelebA əsaslı MAT modeli 11 sinifdə ilk üçlüyə daxil olub.
Lakin tədqiqatın Şəkil 2-dəki vizual nümunələri kəmiyyət skorlarının təkbaşına kifayət etmədiyini göstərir. Araşdırmaçılar LaMa və MADF-nin göz bərpalarında bulanıq və ya bir-birinə qarışmış gözlər yarada bildiyini; LaMa-nın bəzi burun maskalarında kiçik burun və ikiqat ağıza bənzər quruluş yarada bildiyini; MAT-ın bəzi üz maskalarında kirpikləri qalınlaşdırdığını; Co-Mod-GAN-ın burun ətrafında görünən sərhədlər buraxa bildiyini; MADF-nin isə bəzi nümunələrdə əlavə göz və ya dodaqların üzərinə daşan dişlər yarada bildiyini bildiriblər.
1024 çözünürlükdə Co-Mod-GAN ilə LaMa arasındakı fərq
1024 × 1024 qiymətləndirməsində yalnız Co-Mod-GAN və LaMa müqayisə edilib. FID baxımından Co-Mod-GAN 12 semantik maska sinfinin 11-də LaMa-dan daha aşağı dəyər əldə edib. Yeganə istisna üst dodaq maskası E-dir; burada LaMa-nın FID dəyəri 0,37, Co-Mod-GAN-ın dəyəri 0,72-dir.
Verianla Live: 1024 çözünürlükdə seçilmiş çətin maskalarda FID
Daha aşağı FID daha yaxşı paylanma oxşarlığını ifadə edir. Bu vizuallaşdırma xüsusilə böyük və ya struktur baxımdan çətin semantik sahələri göstərir.
| Maska sinfi | Co-Mod-GAN FID | LaMa FID |
|---|---|---|
| G — Saç | 11,60 | 41,85 |
| I — Üz | 11,24 | 33,61 |
| J — Burun + ağız sahəsi | 3,93 | 9,20 |
| K — Göz + burun + ağız sahəsi | 6,23 | 18,58 |
| L — Üz + saç + qulaqlar | 65,73 | 206,07 |
Şəkil 3-də LaMa-nın 256, 512 və 1024 çözünürlükdəki nümunələri yanaşı göstərilir və çözünürlük artdıqca bəzi üz komponentlərində nəzərəçarpacaq pozuntular görünə bilir. Şəkil 4-də isə Co-Mod-GAN-ın 512 və 1024 çıxışları bir-birinə daha yaxın görünür. Bu müşahidə mənbə müəlliflərinin Co-Mod-GAN-ı yüksək çözünürlük üçün daha effektiv model kimi qiymətləndirməsinə əsas verir.
Bununla belə metod mətnində “LaMa yüksək çözünürlükdə təsirsiz tapıldığı üçün 512 və 256-da qiymətləndirildi” mənasına gələn ifadə olmasına baxmayaraq, sonrakı bölmə, Cədvəl 5 və Şəkil 3 açıq şəkildə 1024 LaMa nəticələri təqdim edir. Bu mənbədaxili ziddiyyət həll edilmədən qorunmalıdır.
Hansı üz komponentləri modellər üçün daha problemli idi?
Nəticələr vahid modelin bütün üz sahələrində etibarlı üstünlük göstərmədiyini ortaya qoyur. Mənbə tədqiqatın model əsaslı vizual təhlilində aşağıdakı xəta növləri bildirilib:
- Göz: həddindən artıq qalın kirpik, qara göz, göz bəbəyi hizası və ya rəng uyğunsuzluğu, bulanıq və ya qarışmış göz quruluşu.
- Ağız və dodaq: dodaqların birləşməsi, qeyri-real və ya çatlamış dişlər, dişlərin dodağın üzərinə daşması, alt dodaq hizası və rəng problemləri.
- Üz dərisi: maska sərhədlərinin görünməsi, dəri tonu fərqi, üzün qısalması/incəlməsi, əks olunma bənzəri quruluşlar.
- Saç: qeyri-təbii axın, rəng davamlılığının itməsi, hissə-hissə saç yaradılması və ya maskadakı bəzi sahələrin fon/qulaqla doldurulması.
- Qulaq: çatışmayan qulaq və ya qulaq sahəsinin saçla əvəz olunması.
- Burun: bir çox modeldə nisbətən uğurlu olsa da bəzi hallarda çatışmayan, kiçik və ya sərhədləri görünən rekonstruksiya.
Əlavə Şəkil A1 göz, ağız/dodaq, üz və burun+ağız kombinasiyalarının yaxınlaşdırılmış kəsiklərini model əsasında müqayisə edir. Bu yaxın görünüş tam görüntüdə fərq edilməsi çətin olan kirpik qalınlığı, dodaq–diş birləşməsi və rəng keçidi kimi qüsurları daha aydın göstərir.
Tədqiqatın Metodu və Nəticələri
Təcrübə avadanlığı
| Komponent | Tədqiqatda bildirilən xüsusiyyət |
|---|---|
| GPU | 2 × NVIDIA A800 Active |
| GPU yaddaşı | GPU başına 40 GB |
| CUDA | 12.0 |
| CPU | Intel Xeon w9-3495X |
| CPU nüvəsi | 56 nüvə, 1,9–4,8 GHz |
| RAM | 256 GB |
| Yaddaş istifadəsi | 286 GB |
Model işləmə müddətləri
Tədqiqat RePaint istisna olmaqla üsulların bir görüntünü 0,3 saniyədən az müddətdə tamamlaya bildiyini bildirir. Cədvəl 6-ya görə 2000 görüntünün emal müddətləri aşağıdakı kimidir:
| Model | Mənbə Cədvəl 6-da bildirilən müddət |
|---|---|
| MAT | 256: 3 dəq; 512: 5 dəq |
| Co-Mod-GAN | 512: 1 dəq; 1024: 2 dəq |
| MADF | 512 sütununda 6 dəq |
| CMT | 512 sütununda 1 dəq |
| Latent-based | 512 sütununda 10 dəq |
| MI-GAN | 512 sütununda 2 dəq |
| LaMa | 256: 0,5–1 dəq; 512: 1,5 dəq; 1024: 5 dəq |
| RePaint | 512 sütununda təxminən 5 dəq/görüntü |
Burada mənbədaxili çözünürlük uyğunsuzluğu var. Model seçimi Cədvəl 1 CMT, Latent-based, MI-GAN və RePaint üçün 256 çözünürlük göstərdiyi halda hesablama müddəti Cədvəl 6 bu modellərin müddətlərini 512 × 512 sütununa yerləşdirir. Məqalə bunun səbəbini açıqlamır; buna görə müddət cədvəli yuxarıda mənbədə göründüyü kimi təqdim edilib.
MAT niyə yenidən öyrədildi?
512 çözünürlük müqayisələrində güclü nəticə verən MAT semantik maska problemi üçün üç ayrı təlim strategiyasının müqayisəsində istifadə edilib:
- Yalnız təsadüfi maskalarla təlim,
- Yalnız semantik maskalarla təlim,
- Təsadüfi və semantik maskaların birlikdə istifadə edildiyi qarışıq təlim.
MAT modeli hər təcrübədə sıfırdan başladılıb. Təlimdə 24.000 görüntü, testdə 6000 görüntü istifadə edilib. Adam optimizer-in öyrənmə sürəti \(1\times10^{-4}\), \(\beta_1=0.9\) və \(\beta_2=0.999\) olaraq müəyyən edilib; batch size 8 və təlim müddəti 100 epoch tətbiq edilib. Batch ölçüsü GPU başına mövcud 40 GB yaddaş məhdudiyyətinə görə 8 ilə məhdudlaşdırılıb.
Standart məlumat artırma kimi təsadüfi üfüqi çevirmə və döndürmə istifadə edilib, əlavə rəng jitter və başqa həndəsi transformasiya tətbiq edilməyib. Hər təlim sessiyasının təxminən 7 gün 13 saat davam etdiyi bildirilib.
Təsadüfi maska niyə yalnız semantik maskadan daha yaxşı nəticə verdi?
İlk yenidən təlim nəticəsində semantik maskalarla test aparılmasına baxmayaraq yalnız təsadüfi maskalarla öyrədilmiş MAT modeli yalnız semantik maskalarla öyrədilmiş MAT-dan ümumilikdə daha aşağı FID verib. Müəlliflər bunu təsadüfi maskaların daha müxtəlif itkin sahələr yaratması və modeli görüntünün bütünündəki kontekstual əlaqələri öyrənməyə məcbur etməsi ilə izah edirlər.
Bu izah tədqiqat tərəfindən təklif olunan şərhdir. Araşdırma overfitting mexanizmini ayrıca təcrübələrlə birbaşa ölçməyib; buna görə “təsadüfi maska mütləq overfitting-i azaldır” kimi səbəb-nəticə ümumiləşdirməsi aparılmamalıdır.
Qarışıq maska strategiyasının FID nəticələri
| Maska | Təsadüfi təlim FID | Semantik təlim FID | Qarışıq təlim FID |
|---|---|---|---|
| A | 1,46 | 1,78 | 1,25 |
| B | 0,93 | 0,95 | 0,93 |
| C | 2,01 | 3,73 | 1,59 |
| D | 0,75 | 1,20 | 0,71 |
| E | 0,74 | 1,40 | 0,56 |
| F | 2,36 | 2,05 | 1,24 |
| G — Saç | 12,51 | 17,38 | 7,10 |
| H | 3,90 | 3,91 | 3,33 |
| I — Üz | 8,16 | 9,25 | 5,69 |
| J | 2,46 | 4,00 | 2,20 |
| K | 3,56 | 5,00 | 3,03 |
| L — Üz + saç + qulaqlar | 115,51 | 114,35 | 130,82 |
Qarışıq təlim A, C, D, E, F, G, H, I, J və K siniflərində hər iki tək strategiyadan daha aşağı FID verib. B sinfində təsadüfi təlimlə eyni FID dəyəri olan 0,93 əldə edilib. Ən geniş maska L sinfində isə qarışıq təlimin FID-si 130,82-yə yüksəlib və həm təsadüfi, həm də semantik təlimdən daha pis olub. Buna görə nəticə “qarışıq üsul bütün hallarda üstündür” kimi ümumiləşdirilə bilməz.
Bootstrap doğrulaması nə göstərdi?
Araşdırmaçılar FID fərqlərinin yalnız müəyyən test nümunələrindən qaynaqlanıb-qaynaqlanmadığını yoxlamaq üçün 6000 görüntülük test dəstindən bootstrap analizi aparıblar. Hər qiymətləndirmədə 1000 unikal görüntü seçilib və proses 100 dəfə təkrarlanıb. Eyni görüntü bir bootstrap nümunəsində təkrarlanmayıb, lakin müxtəlif bootstrap nümunələrində yenidən yer ala bilib.
Əlavə Cədvəl A2-də qarışıq maska təliminin A, C, D, E, F, G, I, J və K maska siniflərində həm təsadüfi, həm semantik təlimdən daha aşağı FID verdiyi və fərqlərin p<0,01 səviyyəsində statistik olaraq əhəmiyyətli olduğu işarələnib. B və H üçün bu ikitərəfli əhəmiyyət işarələnməyib; L sinfində qarışıq yanaşma daha pis FID verib.
| Seçilmiş maska | Təsadüfi FID, orta ± SS | Semantik FID, orta ± SS | Qarışıq FID, orta ± SS | Mənbə nəticəsi |
|---|---|---|---|---|
| C — Tam ağız/dodaq | 2,03 ± 0,05 | 3,76 ± 0,09 | 1,60 ± 0,04 | Qarışıq, hər ikisindən p<0,01 daha aşağı. |
| G — Saç | 12,66 ± 0,33 | 17,43 ± 0,42 | 7,15 ± 0,21 | Qarışıq, hər ikisindən p<0,01 daha aşağı. |
| I — Üz | 8,22 ± 0,21 | 9,30 ± 0,24 | 5,71 ± 0,15 | Qarışıq, hər ikisindən p<0,01 daha aşağı. |
| L — Üz + saç + qulaq | 116,10 ± 3,23 | 114,90 ± 3,19 | 131,45 ± 3,51 | Qarışıq yanaşma üstün deyil. |
Vizual nümunələr qarışıq yanaşmanı necə göstərir?
Şəkil 5-də təsadüfi, semantik və qarışıq maska ilə öyrədilmiş MAT modellərinin üz, saç və tam ağız/dodaq bərpaları yanaşı göstərilib. Müəlliflərin vizual qiymətləndirməsinə görə təsadüfi maska ilə öyrədilmiş model üz rəngini ətrafa daha yaxşı qarışdıra bilsə də üz həndəsəsi qısa və uyğunsuz görünə bilər. Semantik təlim üz formasına daha çox yaxınlaşa bilər, lakin dəri tonu ətrafla uyğun gəlməyə bilər. Qarışıq təlim bu iki xəta tipi arasında daha balanslı nəticə yaradıb.
Saçda təsadüfi təlim saç axınında, semantik təlim isə rəng davamlılığında problem yaşaya bilərkən, qarışıq strategiya hər iki xüsusiyyəti daha yaxşı balanslaşdırıb. Ağız nümunəsində də qarışıq təlim vizual olaraq digər iki strategiyadan daha yaxşı təqdim edilib. Lakin bunlar seçilmiş vizual nümunələrdir; tədqiqat müstəqil insan qiymətləndiricilərlə korlaşdırılmış qavrayış istifadəçi araşdırması hesabat vermir.
Tədqiqatın müəyyən etdiyi struktur məhdudiyyətləri
Araşdırmaçılar yalnız təlim məlumatını dəyişməklə problemin tam həll edilə bilməyəcəyini və mövcud arxitekturaların struktur limitləri olduğunu müdafiə edirlər:
- Lokal receptive field və convolutional bias: Tam semantik maska CNN/GAN modellərinin istifadə edə biləcəyi lokal ipuclarını tamamilə yox edə bilər.
- Zəif qlobal və semantik mühakimə: Transformer və diffuziya modelləri geniş konteksti modelləşdirə bilsə də görüntüdəki anatomik komponentlər arasındakı dəqiq struktur əlaqəni həmişə qoruya bilmir.
- Məhdud struktur öncüllər: Modellər üz anatomiyasını açıq qaydalar şəklində bilmir; əsasən təlim məlumatındakı statistik əlaqələri öyrənir.
- Qeyri-müəyyənlik: Tamamilə görünməyən komponent üçün birdən çox vizual cəhətdən məqbul həll ola bilər.
Müəlliflər gələcəkdə üz komponentlərini açıq şəkildə modelləşdirən, üz həndəsəsini və komponent asılılıqlarını nəzərə alan arxitekturaların; adaptiv maska təlimlərinin və komponentə xas itki funksiyalarının araşdırılmasını tövsiyə edirlər.
Tədqiqat nəyi sübut etmir?
- Maskanın altında olan orijinal göz, ağız, burun və ya saçın identiklik baxımından düzgün şəkildə bərpa edilə bildiyini sübut etmir.
- Yaradılmış üz komponentlərinin anatomik olaraq tibbi rekonstruksiya üçün etibarlı olduğunu sübut etmir.
- Tədqiqat real xəstə, travma, yanıq və ya cərrahi üz rekonstruksiyası məlumatından istifadə etmir.
- Məxfilik qorunması və ya üz tanıma sistemlərində real identikliyin qorunması uğurunu ölçmür.
- Qarışıq maska yanaşmasının bütün maskalarda və ya bütün inpainting arxitekturalarında üstün olduğunu göstərmir.
- Aşağı FID-in insan gözü və ya identikliyin qorunması baxımından qüsursuz nəticə demək olduğunu göstərmir.
- RePaint digər modellərlə eyni nümunə sayı və hesablama büdcəsi altında müqayisə edilmədiyi üçün diffuziya modellərinin ümumilikdə daha pis olduğu nəticəsini dəstəkləmir.
Mənbə və Metod Qeydi
| Tam orijinal tədqiqat adı | Evaluating AI-Based Image Inpainting Techniques for Facial Components Restoration Using Semantic Masks |
|---|---|
| Müəlliflər | Hussein Sharadga; Abdullah Hayajneh; Erchin Serpedin |
| Bərabər töhfə | Mənbədə bərabər birinci/bərabər töhfə bəyanı göstərilməyib. |
| Məsul müəllif | Hussein Sharadga |
| Qurumlar | School of Engineering, Texas A&M International University, ABŞ; King Abdullah II School of Engineering, Princess Sumaya University for Technology, İordaniya; Department of Electrical and Computer Engineering, Texas A&M University, ABŞ. |
| Mənbə növü | Rəyli tədqiqat məqaləsi; müqayisəli süni intellekt/görüntü emalı benchmark və yenidən təlim tədqiqatı. |
| Rəyləndirmə statusu | Rəyli jurnalda dərc edilmiş məqalə; preprint deyil. |
| Jurnal | AI |
| Nəşriyyat | MDPI |
| Cild / say / məqalə | 2026, 7(4), 119 |
| DOI | 10.3390/ai7040119 |
| Alınma / reviziya / qəbul / nəşr | 8 fevral 2026 / 12 mart 2026 / 23 mart 2026 / 30 mart 2026 |
| Rəsmi keçid | https://doi.org/10.3390/ai7040119 |
| Lisenziya | Creative Commons Attribution (CC BY). |
Maliyyələşdirmə, məlumat və maraqlar toqquşması
Müəlliflər tədqiqatın xarici maliyyələşdirmə almadığını bildiriblər. Məqalə emal haqqının Texas A&M International University tərəfindən ödənildiyi qeyd olunub. Müəlliflər maraqlar toqquşması olmadığını bəyan ediblər.
Tədqiqatda istifadə edilən üz görüntüləri ictimaiyyətə açıq CelebAMask-HQ məlumat dəstindən alınıb və mənbə tədqiqat bu məlumat dəstinin yalnız qeyri-kommersiya tədqiqat məqsədilə istifadə olunduğunu bildirir. Müəlliflər xam üz görüntülərini yenidən yaymaq icazəsinə sahib olmadıqlarını deyirlər.
Generativ süni intellekt istifadəsi bəyanatı
Mənbə tədqiqatın təşəkkür bölməsində müəlliflər məqalənin oxunaqlığını yaxşılaşdırmaq məqsədilə ChatGPT-nin “GPT-5 mini, free version” versiyasından istifadə etdiklərini; daha sonra məzmunu özlərinin nəzərdən keçirib redaktə etdiklərini və yayımlanan mətnin məsuliyyətini üzərlərinə götürdüklərini bildiriblər. Bu bəyan tədqiqatın eksperimental görüntü tamamlama nəticələrinin ChatGPT tərəfindən yaradıldığı demək deyil.
Müəllif töhfələri
Konseptuallaşdırmaya hər üç müəllif töhfə verib. Metodologiya, proqram təminatı, məlumat kurasiyası və layihə idarəçiliyi Hussein Sharadga və Abdullah Hayajneh tərəfindən aparılıb; doğrulama və araşdırma işlərində hər üç müəllif iştirak edib. Orijinal layihə Hussein Sharadga və Abdullah Hayajneh tərəfindən hazırlanıb; hər üç müəllif nəzərdən keçirmə və redaktə prosesinə töhfə verib.
Mənbədaxili uyğunsuzluqların qeydi
- P-IDS və U-IDS tənlikləri məsafə ölçüsü şəklində müəyyən edilərkən cədvəllər və mətn daha yüksək dəyəri daha yaxşı performans kimi şərh edir. Mənbə bu fərqi açıqlamır.
- Metod mətni LaMa-nın yüksək çözünürlükdə təsirsiz tapıldığı üçün 256 və 512-də qiymətləndirildiyini deyərkən daha sonra 1024 LaMa nəticələri hesabat verilir.
- Model Cədvəl 1 CMT, Latent-based, MI-GAN və RePaint üçün 256 çözünürlük bildirdiyi halda hesablama müddəti Cədvəl 6 bu modellərin müddətlərini 512 × 512 sütununda göstərir.
Əsas məhdudiyyətlər
- Nəticələr bir əsas üz məlumat dəsti ailəsinə əsaslanır.
- Klinik və ya travmatik üz rekonstruksiyası məlumat dəsti istifadə edilməyib.
- Hər model eyni çözünürlüklərdə və eyni hesablama büdcəsi ilə sınaqdan keçirilməyib.
- RePaint yalnız 10 görüntü üzərində məhdud şəkildə qiymətləndirilib.
- Vizual keyfiyyət qiymətləndirmələri üçün müstəqil, korlaşdırılmış insan qiymətləndirici araşdırması təqdim edilməyib.
- FID paylanma əsaslı qavrayış oxşarlığı ölçüsüdür; orijinal şəxsin həqiqi itkin üz komponentinin yenidən yaradıldığını sübut etmir.
- Ən geniş L semantik maska sinfində qarışıq təlim daha pis FID yaradıb.
- Mənbədə P-IDS/U-IDS metrik istiqaməti ilə bağlı tərif və şərh uyğunsuzluğu var.
Tədqiqatın ən güclü nəticəsi tamamilə gizlədilmiş semantik üz komponentlərinin mövcud görüntü tamamlama modelləri üçün hələ də çətin problem olması və maska müxtəlifliyinin təlim performansına əhəmiyyətli təsir göstərə bilməsidir. Qarışıq təsadüfi–semantik təlim strategiyası bir çox üz komponentində FID-i yaxşılaşdırsa da, tədqiqat qüsursuz üz rekonstruksiyasına çatıldığını deyil, əksinə bunun hələ də açıq araşdırma problemi olduğunu göstərir.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib