

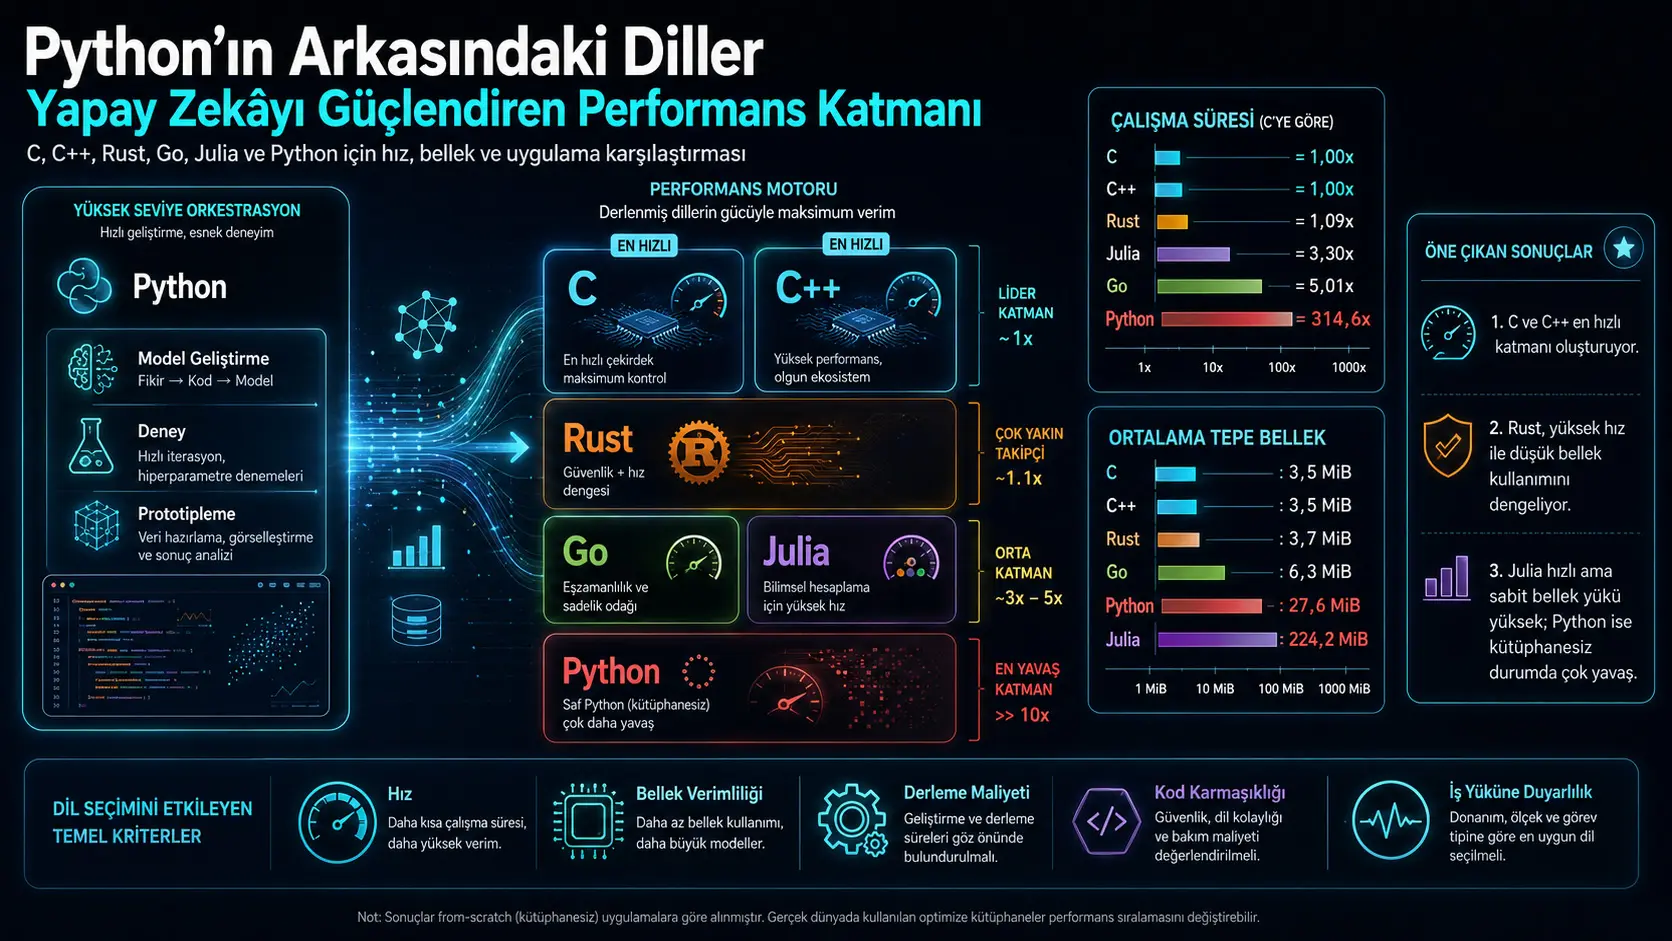
Utafiti huu ulilinganisha execution time, peak memory consumption, executable-file size, lines of code na compilation time kwa kutekeleza k-means, k-nearest neighbors, multilayer perceptron, genetic algorithm na Mamdani fuzzy-inference system kutoka mwanzo katika Python, C, C++, Rust, Go na Julia bila kutumia external numerical libraries. Katika experiments kwenye Apple M1 Pro, C na C++ zilikuwa karibu sawa kwa speed, huku Rust ikiwa %9 slower kuliko C kwa geometric mean. Julia ilionyesha execution time mara 3,30 ya C, Go mara 5,01 na Python mara 314,6. Hata hivyo, kwa kuwa results zinategemea single hardware na operating system, small classical AI algorithms na library-free implementations, haziwezi kugeneralizeiwa moja kwa moja kwa modern GPU models au real Python applications zinazotumia NumPy na PyTorch.
Memory results zilitoa picha tofauti na execution-time ranking. C, C++ na Rust zilibaki chini ya 6 MiB katika tests zote, wakati Go ilitumia average 6,3 MiB, Python 27,6 MiB na Julia 224,2 MiB peak resident memory. High value ya Julia inaonyesha runtime na just-in-time compilation overhead inayoonekana kuwa largely independent of test data. Pia ilionyeshwa kwamba language rankings zinategemea workload: slowdown ya Go relative to C ilikuwa takriban mara 2,6 katika k-NN, lakini iliongezeka hadi takriban mara 8 katika k-means test.
Kwa mtazamo wa Uturuki: Findings zina umuhimu kwa teams nchini Uturuki zinazotengeneza AI infrastructure, embedded systems, industrial automation, robotics, local inference services na resource-constrained edge devices. Utafiti unaonyesha kwamba language choice inaweza kuleta difference kubwa katika time na memory wakati algorithm lazima iimplementiwe moja kwa moja na bila libraries. Kabla ya technology decision nchini Uturuki, benchmarks hizi zinapaswa kurudiwa kwenye target x86-64 au ARM processors, Linux na Windows environments, real datasets, local au enterprise software stack na, inapohitajika, GPU acceleration. Kutokana na utafiti huu haiwezi kuhitimishwa kwamba C++ au Rust lazima ziwe best choice katika AI projects zote nchini Uturuki au kwamba Python itafanya kazi mara mia nyingi slower katika real applications.
Swali kuu la utafiti ni nini?
Utafiti unachunguza programming language gani AI developer anapaswa kuchagua pale ambapo ready-made library haiwezi kutumika. Hali kama hii inaweza kutokea wakati algorithm husika bado haina library implementation, target device ina limited resources, au basic components za new AI infrastructure zinatengenezwa.
Starting point ya utafiti ni kwamba language inayoonekana katika AI application na language inayofanya heavy computation mara nyingi si ile ile. Ingawa Python hutumika kwa experiment design, data flow na model calls, NumPy, PyTorch na similar frameworks mara nyingi huhamisha performance-critical computations kwenda compiled native code. Kwa hiyo speed ya library inayotumiwa kupitia Python haiwakilishi speed ya Python interpreter pekee.
Ili kuondoa confusion hii, watafiti waliimplement algorithms zote kutoka mwanzo katika Python, C, C++, Rust, Go na Julia bila external machine-learning au numerical-computing libraries. Lengo lilikuwa kuhakikisha observed differences zinatokana kadiri iwezekanavyo na language implementations, compilers na runtime systems, si third-party libraries.
Ni gap gani katika literature iliyolengwa?
Programming languages zimewahi kulinganishwa kwa execution time, energy consumption, memory use na code-development cost. Hata hivyo, traditional language benchmarks mara nyingi hutumia general-purpose workloads kama sorting, recursion, tree processing au small numerical kernels. Workloads hizi haziwezi kuwakilisha kwa pamoja iterative optimization, dense floating-point computation, population-based search na rule-based inference patterns zinazoonekana katika AI algorithms.
Kwa upande mwingine, language comparisons nyingi katika AI context hutumia ready-made na highly optimized libraries. Katika test ambako Python na Julia programs zinaita same native numerical kernel, measured time inaweza kupima zaidi underlying C, C++, Rust au GPU implementation kuliko high-level languages. Utafiti ulilenga kujaza gap kati ya aina hizi mbili za comparison kwa library-free na algorithmically matched implementations.
Ni languages na toolchains zipi zililinganishwa?
| Programming language | Compiler au runtime | Setting iliyotumika katika utafiti | Execution model |
|---|---|---|---|
| Python | CPython 3.14.3 | Hakuna additional flag iliyotumika. | Interpreted runtime |
| C | Apple Clang 17.0.0 | -O3 -march=native | Ahead-of-time compiled native code |
| C++ | Apple Clang 17.0.0 | -O3 -march=native -std=c++17 | Ahead-of-time compiled native code |
| Rust | rustc 1.93.0 | opt-level=3, lto=true, codegen-units=1 | Ahead-of-time compiled native code |
| Go | gc 1.26.3 | Default go build | Ahead-of-time compiled, managed runtime |
| Julia | Julia 1.9.2 | Default JIT settings | Just-in-time compilation |
Experiments zilifanywa kwenye MacBook yenye Apple M1 Pro processor yenye six performance na two efficiency cores, 16 GB unified memory na macOS. SIMD intrinsics, manual vectorization na external numerical libraries hazikutumika.
Kwa nini AI algorithms tano zilichaguliwa?
Algorithms hazikuchaguliwa kuwakilisha state-of-the-art modern AI models, bali kujaribu different computational patterns kwa controlled na reproducible manner. Algorithms tano zinawakilisha data mining, instance-based learning, neural-network training, evolutionary computation na fuzzy logic.
| Algorithm | Area inayowakilishwa | Main experimental parameters | Compute-heavy characteristic |
|---|---|---|---|
| k-means | Data mining | 100.000 points, 4 dimensions, 10 clusters, 1.000 fixed iterations | Dense distance calculation na iterative center update |
| k-NN | Machine learning | 50.000 training points, 10.000 queries, 8 dimensions, k=15, 3 classes | Distance, comparison na indexing |
| MLP | Neural networks | 16→64→4 architecture, 10.000 samples, 150 epochs, learning rate 0,01 | Dense floating-point operations na backpropagation |
| Genetic algorithm | Computational intelligence | 30 dimensions, 5.000 individuals, 1.200 generations, tournament size 3 | Branching, population-based search na random operations |
| Mamdani system | Fuzzy systems | 2 inputs, 3 membership functions per input, 9 rules, 2 million inferences | Rule evaluation, min–max operations na centroid calculation |
Same computation ilihakikishwaje kati ya languages?
Watafiti walitumia same algorithm specifications, initial conditions, tie-breaking rules na stopping criteria katika languages zote. Ili kulinganisha random inputs, same 64-bit linear congruential generator iliimplementiwa katika kila language.
\[ s_{i+1} = (a s_i + c) \bmod 2^{64} \]
Katika equation hii si inawakilisha 64-bit internal state katika i-th step; a ni multiplier na c ni increment constant. Katika utafiti:
- a = 6364136223846793005
- c = 1442695040888963407
- initial seed s0 = 42
ziliwekwa.
\[ u_i = \frac{s_i \gg 33}{2^{31}} \]
Operation ya >> 33 hapa inamaanisha ku-right-shift 64-bit state kwa 33 bits. Integer inayopatikana hugawanywa kwa 231 ili kuunda dimensionless pseudo-random number. Kutumia numbers kwa same order katika kila language kulihakikisha experimental inputs zinalingana.
Ili kuzuia differences kati ya math libraries za languages, transcendental functions kama square root, exponential, logarithm na cosine ziliepukwa. Katika k-NN na k-means tests, squared Euclidean distance ilitumika badala ya square root. Katika MLP, ReLU na mean squared error zilitumika badala ya sigmoid au softmax. Katika genetic algorithm, polynomial Rosenbrock function ilichaguliwa badala ya cosine-containing Rastrigin function.
Kila program ilitoa integer na floating-point output fingerprint. Integer fingerprints zililingana kabisa katika languages sita, na floating-point summaries zilikuwa identical hadi decimal places sita. Kwa kuwa compilers zinaweza kutumia fused multiply-add, utafiti hauonyeshi kwamba intermediate floating-point results zote ni absolutely bitwise identical.
Time na memory zilipimwaje?
Kila language–algorithm pair ilipimwa mara ten baada ya three warm-up runs. Wall-clock time ilipimwa kwa hyperfine, na peak resident memory use kwa /usr/bin/time -l pamoja na ru_maxrss kwenye macOS. Standard output ilielekezwa kwenye /dev/null, lakini programs bado zilihesabu na kuprint fingerprints ili kuzuia dead-code elimination.
Mbali na runtime na memory, compiled-file size, total lines of code kwa implementations tano na cold compile time baada ya kusafisha cache pia zilipimwa. Slowdown ratios katika different algorithms zilinormalizeiwa relative to C kisha kuunganishwa kwa geometric mean.
Execution-time results zinaonyesha nini?
Fastest performance tier iliundwa na C, C++ na Rust. Differences kati ya C na C++ zilibaki chini ya %2 katika tests zote tano. C++ ilikuwa mbele kwa margins ndogo katika k-means, k-NN, MLP na genetic-algorithm tests, huku C ikitoa lower time katika fuzzy-inference test. Geometric-mean slowdown ratio ya Rust relative to C ilikuwa 1,09.
| Language | k-means (s) | k-NN (s) | MLP (s) | Genetic algorithm (s) | Fuzzy system (s) | Geometric ratio relative to C |
|---|---|---|---|---|---|---|
| C | 0,717 | 0,748 | 0,678 | 0,728 | 0,369 | 1,00 |
| C++ | 0,706 | 0,746 | 0,675 | 0,722 | 0,372 | 1,00 |
| Rust | 0,769 | 0,861 | 0,774 | 0,772 | 0,375 | 1,09 |
| Julia | 3,062 | 2,200 | 3,113 | 1,074 | 1,698 | 3,30 |
| Go | 5,710 | 1,969 | 4,174 | 2,688 | 2,451 | 5,01 |
| Python | 332,0 | 261,2 | 220,4 | 108,7 | 144,7 | 314,6 |
Logarithmic graph kwenye ukurasa wa 9 inatenganisha visually performance tiers tatu kwa wazi. Bars za C, C++ na Rust zinaonekana karibu sana katika lower part ya graph, huku Julia na Go zikiwa katika middle region. Python bars ziko juu sana kuliko languages nyingine katika algorithms zote.
Difference ya Python relative to C ilibadilika kulingana na algorithm. Lowest ratio ilikuwa takriban mara 149 katika branching-heavy genetic algorithm, na highest ratio takriban mara 463 katika arithmetic-intensive k-means test. Result hii inaonyesha kwamba Python si slow kwa fixed ratio moja katika workloads zote.
Result ya mara 315 kwa Python inapaswa kutafsiriwaje?
Value ya mara 314,6 haimaanishi kwamba AI applications zote zilizoandikwa kwa Python ni slower kuliko C kwa ratio hiyo. Utafiti uliendesha Python code bila NumPy, PyTorch, Numba, Cython, JAX au native computing library nyingine, kwa explicit loops na scalar operations.
Main advantage ya Python katika real AI development ni wide software ecosystem inayoweza kuhamisha numerical operations kwenda optimized native kernels. Result ya utafiti inaonyesha kwamba Python inapokosa libraries hizi, language-level interpretation cost inaonekana wazi. Result haionyeshi kwamba model iliyotrainiwa kwa PyTorch itakuwa slower mara 315 kuliko same C++ model.
Ni language ipi ilijitokeza katika memory use?
C na C++ zilitumia average 3,5 MiB, na Rust 3,7 MiB peak resident memory. Average ya Go ilipimwa kuwa 6,3 MiB, Python 27,6 MiB na Julia 224,2 MiB.
| Language | k-means (MiB) | k-NN (MiB) | MLP (MiB) | Genetic algorithm (MiB) | Fuzzy system (MiB) | Average (MiB) |
|---|---|---|---|---|---|---|
| C | 4,7 | 5,1 | 2,8 | 3,6 | 1,2 | 3,5 |
| C++ | 4,8 | 5,2 | 2,8 | 3,6 | 1,3 | 3,5 |
| Rust | 5,2 | 5,4 | 2,9 | 3,7 | 1,3 | 3,7 |
| Go | 8,1 | 8,4 | 5,3 | 6,1 | 3,8 | 6,3 |
| Python | 37,6 | 38,1 | 24,2 | 23,2 | 14,7 | 27,6 |
| Julia | 228,7 | 216,2 | 234,3 | 225,3 | 216,5 | 224,2 |
Katika logarithmic memory graph kwenye ukurasa wa 11, bars za Julia zinaonekana karibu same height katika workloads zote na ziko clearly above languages nyingine. Hali hii inaunga mkono interpretation kwamba Julia ina fixed startup cost kwa JIT compiler na runtime. Katika long-running applications zinazochakata large data, relative importance ya fixed cost hii inaweza kupungua; lakini inaweza kuwa muhimu katika small short-lived tasks au low-memory devices.
Je, code length kweli inapima productivity?
Total lines of code katika algorithms tano ziliripotiwa kuwa 397 kwa C++, 406 kwa C na Python, 474 kwa Rust, 514 kwa Julia na 541 kwa Go. Python kutokuwa shorter kuliko C ni mojawapo ya findings zinazovutia zaidi katika utafiti.
Hata hivyo, lines of code si sawa na development time, maintainability, defect rate, readability au developer experience. Utafiti haukupima actual time iliyotumiwa na developers kuandika algorithms wala debugging cost. Kwa hiyo line count ni limited indicator ya implementation complexity pekee.
| Language | Executable file size | Total lines of code | Cold compile time |
|---|---|---|---|
| C | 33,6 KB | 406 | Sekunde 0,93 |
| C++ | 33,7 KB | 397 | Sekunde 1,13 |
| Rust | 373,1 KB | 474 | Sekunde 8,73 |
| Go | 2.509,4 KB | 541 | Sekunde 3,30 |
| Python | Not applicable | 406 | Not applicable |
| Julia | Not applicable | 514 | Not applicable |
Longer compile time ya Rust inapaswa kutathminiwa pamoja na aggressive optimization settings zilizotumika katika utafiti, kama link-time optimization na single code-generation unit. File ya Go ya takriban 2,5 MB ilihusishwa na runtime na garbage collector kuingizwa ndani ya executable.
Radar graph kwenye ukurasa wa 12 inaonyesha nini?
Radar graph inanormalize speed, memory, binary-file size, compilation na lines-of-code metrics kwa namna ambayo higher value ni better. Lines za C na C++ zinaoverlap karibu kabisa. Rust inakaribia languages hizi mbili kwenye speed na memory axes, lakini iko nyuma kwenye compilation na file-size axes.
Julia na Python zinaonyesha improvement kiasi kwenye lines-of-code axis, lakini zina lower values kwenye runtime na memory axes. Hata hivyo, kunormalize heterogeneous metrics ndani ya single graph hakumaanishi kwamba language moja ni generally superior kwa projects zote. Ni lazima iamuliwe separately ni axis gani project inaipa priority zaidi.
Kwa nini language ranking hubadilika kulingana na workload?
Slowdown ratio ya Go relative to C ni takriban mara 2,6 katika k-NN na takriban mara 8 katika k-means test. k-means, MLP na fuzzy-inference tests zina dense floating-point computations na reductions, huku k-NN ikiwa more comparison- na indexing-heavy. Compiler optimizations, bounds checks, memory layout na runtime behavior zinaweza kuathiri operation types hizi kwa namna tofauti.
Julia ilitoa strongest relative result katika genetic algorithm. Watafiti wanaunganisha hii na branching-heavy structure ya genetic algorithm ambayo inaweza kupunguza baadhi ya advantages za aggressively optimized systems languages. Explanation hii imetolewa kama reasonable interpretation; haijajaribiwa moja kwa moja kwa hardware counters au low-level processor profiles.
Ni conclusions zipi zinaungwa mkono na utafiti?
- Katika library-free classical AI algorithms zilizoandikwa kutoka mwanzo, C na C++ ziliunda strongest tier kwa runtime na memory.
- Rust ilikuwa average %9 nyuma ya C kwa geometric mean chini ya optimization settings zilizotumika na ilionyesha similar memory consumption.
- Julia ilikuwa faster kuliko Go katika runtime kwenye tests nyingi lakini ilikuwa na fixed memory overhead kubwa zaidi.
- Relative performance ya Go ilibadilika kwa kiasi kikubwa kulingana na computational structure ya algorithm.
- Python ilitoa results slower sana kuliko languages nyingine ilipoendeshwa kwa explicit loops bila optimized native libraries.
- Language choice inapaswa kutathminiwa si kwa runtime pekee, bali pamoja na memory, file size, compile time, safety na target runtime environment.
Utafiti hauthibitishi nini?
- Hauthibitishi kwamba AI applications zote zilizotengenezwa kwa Python ni slower mara 315 kuliko C.
- Haucompare real performance ya PyTorch, TensorFlow, NumPy, JAX au GPU libraries.
- Haionyeshi kwamba C++ au Rust ndiyo best language katika hardware, operating systems na algorithms zote.
- Hauthibitishi kwamba lines of code zinawakilisha actual development time au programmer productivity.
- Haupimi energy consumption, parallel scalability, GPU performance, network latency au distributed-system behavior.
- Hauwakilishi moja kwa moja computational structure ya modern transformer, large language model au large-scale deep-learning training.
Ni strengths zipi za utafiti?
- Same five algorithms ziliimplementiwa kutoka mwanzo katika languages sita.
- Inputs zilimatchiwa kwa common pseudo-random number generator.
- Initialization, tie-breaking na stopping rules zilifafanuliwa wazi.
- Computational equivalence ilikaguliwa kwa output fingerprints.
- Kila timing measurement ilifanywa kwa three warm-ups na ten measurement runs.
- Mbali na runtime, memory, file size, lines of code na compilation cost pia zilitathminiwa.
- Algorithms tano zenye different computational patterns zilitumika kuonyesha workload-dependent variation.
Main limitations za utafiti ni zipi?
Measurements zote zilifanywa kwenye single Apple M1 Pro computer na macOS. Hakuna guarantee kwamba same code itatoa same ratios kwenye x86-64 processors, Linux au Windows, other compilers na different memory architectures.
Julia measurements zinajumuisha startup na JIT compilation cost. Katika short tests, cost hii inaweza kuwa sehemu muhimu ya total time; katika long-running applications inaweza kuamortizeiwa katika operations nyingi. Kwa hiyo Julia results zina maana tofauti kwa persistent service dhidi ya one-shot command-line task.
Kuondoa external libraries, SIMD, manual vectorization na GPU kulirahisisha kuchunguza basic language execution model, lakini kulipunguza uwezo wa kuwakilisha real AI software performance. Katika modern systems, heavy matrix operations kawaida huendeshwa katika BLAS, CUDA, Metal au other native kernels.
Kwa numerical matching, exponential, logarithmic, square-root na trigonometric functions ziliepukwa, hivyo baadhi ya important operation types za real machine-learning workloads zilibaki nje ya scope. MLP model pia inapaswa kutathminiwa kama controlled dense-compute kernel kuliko modern deep network.
Mbinu na Matokeo ya Utafiti
Technical summary ya experimental setup
| Experimental component | Applied method | Interpretation limit |
|---|---|---|
| Hardware | Apple M1 Pro, 6 performance na 2 efficiency cores, 16 GB unified memory | Other processor architectures hazijajaribiwa. |
| Operating system | macOS | Hakuna Linux na Windows results. |
| Implementation approach | From scratch katika languages sita bila external numerical libraries | Haiwakilishi speed ya real AI frameworks. |
| Randomness | 64-bit LCG, initial seed 42 | Different generators katika real applications hazijalinganishwa. |
| Numerical operations | Basic IEEE 754 addition, subtraction, multiplication, division na min–max operations | Transcendental functions ziliondolewa intentionally. |
| Timing | 3 warm-ups followed by 10 measurement runs | Very long-running service behavior haijachunguzwa. |
| Memory measurement | Peak resident-set size kupitia ru_maxrss | Total allocation au energy consumption haikupimwa. |
| Stability | Relative standard deviation chini ya %4 katika all language–test pairs | Confidence interval au p-value haijatolewa kwa comparisons nyingi. |
Three main performance tiers
- High-performance tier: C, C++ na Rust. C na C++ ziko practically same level, Rust iko %9 nyuma kwa geometric mean.
- Middle tier: Julia na Go. Julia ilionyesha runtime mara 3,30 ya C, Go mara 5,01.
- Interpreter tier: Library-free Python ilifikia geometric-mean time mara 314,6 ya C.
Speed na memory zikitathminiwa pamoja
C na C++ zilitoa lowest values kwa runtime na memory. Rust ilibaki karibu na hizo mbili kwa very small memory difference. Katika tests nyingi ambapo Julia ilikuwa faster kuliko Go, ilikuwa na fixed memory overhead ya takriban 224 MiB, huku Go ikibaki chini ya 10 MiB. Kwa hiyo choice kati ya Julia na Go haiwezi kufanywa kwa speed pekee.
Katika resource-constrained short-lived edge application, fixed runtime cost ya Julia inaweza kuwa muhimu. Kwa long-running service yenye computations nyingi, same cost inaweza kuamortizeiwa katika operations. Ingawa Go hutengeneza larger executable file, runtime memory use ilibaki chini ya Julia na Python.
Practical framework ya kuchagua implementation language kutoka utafiti
| Project priority | Evaluation supported by study | Important limitation |
|---|---|---|
| Lowest runtime | C na C++ zilitoa strongest results. | Safety, maintenance na development cost hazikupimwa. |
| Memory safety near native speed | Rust iko average %9 nyuma ya C na similar memory level. | Compile time ni longer. |
| High-level numerical code with JIT | Julia ni faster kuliko Go katika workloads nyingi. | Ina fixed memory cost ya takriban 224 MiB. |
| Low runtime memory na easy distribution | Go ilitumia less memory kuliko Julia na Python. | Slowdown ilikuwa high katika arithmetic-intensive tests. |
| Ready AI ecosystem | Utafiti unaonyesha indirect value ya Python ecosystem. | Ready libraries ziliondolewa intentionally. |
Njia sahihi ya kutumia results
Utafiti hautoi universal ranking ya “best AI language”. Results ni controlled comparison ya library-free classical algorithms kwenye single-core au limited-parallel CPU implementations. Wakati wa language choice, actual algorithm, target processor, memory limit, operating system, safety requirements, team experience, libraries zinazotumika na muda ambao software itaendelea kufanya kazi vinapaswa kutathminiwa pamoja.
Dokezo la Chanzo na Mbinu
Jina kamili la awali la utafiti: Behind Python: The Languages That Power AI
Waandishi: Juan P. Licona-Luque, Beatriz A. Bosques-Palomo, Nezih Nieto-Gutiérrez, Gustavo de los Ríos-Alatorre na Luis A. Muñoz-Ubando
Mpangilio wa waandishi: Orodha hapo juu inahifadhi original author order ya utafiti.
Co-first-author information: Hakuna equal-contribution au co-first-authorship information katika utafiti.
Corresponding-author information: Utafiti hauna explicit corresponding-author statement. arXiv submission ilifanywa na Juan P. Licona-Luque; information hii haikutafsiriwa kama corresponding authorship.
Institution: Tecnológico de Monterrey, Monterrey, Nuevo León, Meksika
Journal: Utafiti haujachapishwa katika journal.
Original publisher: Hakuna original journal publisher information.
Publication platform: arXiv
arXiv identifier: arXiv:2606.18141 [cs.PL]
Publication year: 2026
Source type: Preprint yenye controlled experimental performance benchmarking
Peer-review status: Utafiti huu ni preprint ambayo haijathibitishwa kuwa imepitia peer review; results zinapaswa kusomwa kwa kuzingatia limitation hii.
Official link:arXiv study page
Makala hii ya Kiswahili imeandaliwa baada ya kupitia full text, formula, tables na graphs za uploaded study yenye kurasa 17. Performance values, memory consumption, toolchains na algorithm parameters zimehamishwa tu kutoka information iliyotolewa katika utafiti. External sources zilitumika tu kwa bibliographic verification ya title, authors, DOI, platform, date na publication status.
Main limitations za utafiti ni kutumia single hardware na operating system, kuondoa external libraries na GPU, kujumuisha Julia startup na JIT cost katika measurements, kutotest modern deep-learning kernels na ukweli kwamba lines of code si direct measure ya development productivity. Results hizi hazipaswi kutafsiriwa kama general performance comparison ya modern AI frameworks, large language models au GPU training.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *