

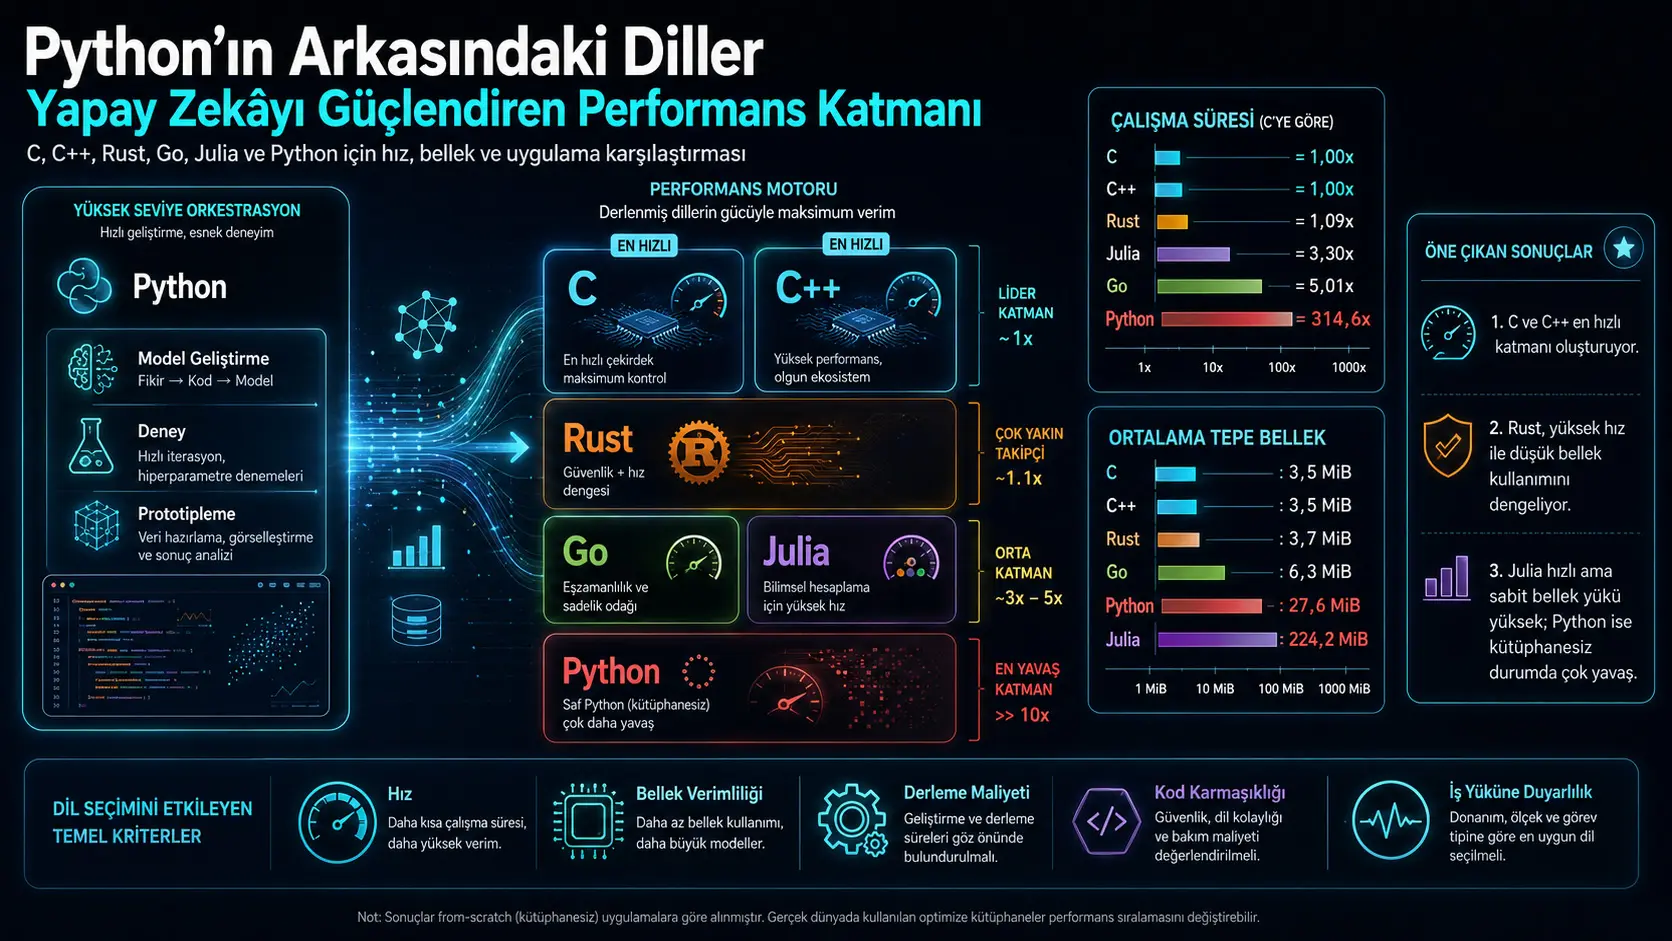
Bu çalışma, k-means, k-en yakın komşu, çok katmanlı algılayıcı, genetik algoritma ve Mamdani bulanık çıkarım sistemini Python, C, C++, Rust, Go ve Julia dillerinde harici sayısal kütüphane kullanmadan sıfırdan uygulayarak çalışma süresi, tepe bellek tüketimi, çalıştırılabilir dosya büyüklüğü, kod satırı sayısı ve derleme süresini karşılaştırmıştır. Apple M1 Pro üzerinde yapılan deneylerde C ve C++ hemen hemen aynı hız düzeyinde yer almış, Rust geometrik ortalamada C’den %9 daha yavaş kalmıştır. Julia C’nin 3,30 katı, Go 5,01 katı ve Python 314,6 katı çalışma süresi göstermiştir. Ancak sonuçlar tek bir donanım ve işletim sistemine, küçük ve klasik yapay zekâ algoritmalarına ve kütüphanesiz uygulamalara dayandığından modern GPU modellerine veya NumPy ve PyTorch kullanan gerçek Python uygulamalarına doğrudan genellenemez.
Bellek sonuçları çalışma süresi sıralamasından farklı bir görünüm sunmuştur. C, C++ ve Rust bütün testlerde 6 MiB’ın altında kalırken Go ortalama 6,3 MiB, Python 27,6 MiB ve Julia 224,2 MiB tepe yerleşik bellek kullanmıştır. Julia’nın yüksek değeri, test verisinden büyük ölçüde bağımsız görünen çalışma zamanı ve tam zamanında derleme yükünü yansıtmaktadır. Dil sıralamalarının iş yüküne bağlı olduğu da gösterilmiştir: Go’nun C’ye göre yavaşlama oranı k-NN’de yaklaşık 2,6 kat iken k-means testinde yaklaşık 8 kata çıkmıştır.
Türkiye açısından değerlendirme: Bulgular Türkiye’de yapay zekâ altyapısı, gömülü sistemler, endüstriyel otomasyon, robotik, yerel çıkarım servisleri ve kaynakları sınırlı uç cihazlar geliştiren ekipler açısından önem taşımaktadır. Çalışma, algoritmanın doğrudan ve kütüphanesiz uygulanması gereken durumlarda dil seçiminin süre ve bellek üzerinde büyük fark oluşturabileceğini göstermektedir. Türkiye’de kullanılacak bir teknoloji kararı öncesinde aynı kıyaslamaların hedeflenen x86-64 veya ARM işlemcilerde, Linux ve Windows ortamlarında, gerçek veri kümeleriyle, kullanılan yerli veya kurumsal yazılım yığınıyla ve gerektiğinde GPU hızlandırmasıyla tekrarlanması gerekir. Çalışmadan Türkiye’deki bütün yapay zekâ projelerinde C++ veya Rust’ın zorunlu olarak en iyi seçim olduğu ya da Python’ın gerçek uygulamalarda yüzlerce kat yavaş çalışacağı sonucu çıkarılamaz.
Araştırmanın temel sorusu nedir?
Araştırma, yapay zekâ geliştiricisinin hazır bir kütüphaneye başvuramadığı durumda hangi programlama dilini seçmesi gerektiğini incelemektedir. Böyle bir durum, ilgili algoritmanın henüz bir kütüphane uygulamasının bulunmaması, hedef cihazın kaynaklarının sınırlı olması veya yeni bir yapay zekâ altyapısının temel bileşenlerinin geliştirilmesi sırasında ortaya çıkabilir.
Çalışmanın çıkış noktası, yapay zekâ uygulamalarında görünen dil ile ağır hesaplamayı yapan dilin çoğu zaman aynı olmamasıdır. Python; deney tasarımı, veri akışı ve model çağrıları için kullanılsa da NumPy, PyTorch ve benzeri yapıların performans açısından kritik hesaplamaları çoğunlukla derlenmiş yerel kodlara aktarılır. Dolayısıyla Python ile çalışan bir kütüphanenin hızı, yalnızca Python yorumlayıcısının hızını temsil etmez.
Araştırmacılar bu karışıklığı ortadan kaldırmak için bütün algoritmaları Python, C, C++, Rust, Go ve Julia dillerinde harici makine öğrenmesi veya sayısal hesaplama kütüphaneleri olmadan sıfırdan uygulamıştır. Böylece gözlenen farkların mümkün olduğunca üçüncü taraf kütüphanelerden değil, dil uygulamalarından, derleyicilerden ve çalışma zamanı sistemlerinden kaynaklanması amaçlanmıştır.
Literatürde hangi boşluk hedeflenmiştir?
Programlama dilleri daha önce çalışma süresi, enerji tüketimi, bellek kullanımı ve kod geliştirme maliyeti bakımından karşılaştırılmıştır. Ancak geleneksel dil kıyaslamaları çoğunlukla sıralama, özyineleme, ağaç işleme veya küçük sayısal çekirdekler gibi genel amaçlı iş yüklerini kullanmaktadır. Bu iş yükleri, yapay zekâ algoritmalarında görülen iteratif optimizasyon, yoğun kayan nokta hesaplaması, nüfus tabanlı arama ve kural tabanlı çıkarım biçimlerini aynı anda temsil etmeyebilir.
Diğer taraftan yapay zekâ bağlamındaki birçok dil karşılaştırması, hazır ve yüksek düzeyde optimize edilmiş kütüphaneleri kullanmaktadır. Python ve Julia programlarının aynı yerel sayısal çekirdeği çağırdığı bir testte elde edilen süre, üst düzey dillerden çok alttaki C, C++, Rust veya GPU uygulamasını ölçebilir. Çalışma, bu iki karşılaştırma türü arasındaki boşluğu kütüphanesiz ve algoritmik olarak eşleştirilmiş uygulamalarla doldurmayı hedeflemiştir.
Hangi diller ve araç zincirleri karşılaştırılmıştır?
| Programlama dili | Derleyici veya çalışma zamanı | Çalışmada kullanılan ayar | Yürütme modeli |
|---|---|---|---|
| Python | CPython 3.14.3 | Ek bayrak kullanılmamıştır. | Yorumlanan çalışma zamanı |
| C | Apple Clang 17.0.0 | -O3 -march=native | Önceden derlenen yerel kod |
| C++ | Apple Clang 17.0.0 | -O3 -march=native -std=c++17 | Önceden derlenen yerel kod |
| Rust | rustc 1.93.0 | opt-level=3, lto=true, codegen-units=1 | Önceden derlenen yerel kod |
| Go | gc 1.26.3 | Varsayılan go build | Önceden derlenen, yönetilen çalışma zamanı |
| Julia | Julia 1.9.2 | Varsayılan JIT ayarları | Tam zamanında derleme |
Deneyler altı performans ve iki verimlilik çekirdeğine sahip Apple M1 Pro işlemcili, 16 GB birleşik bellekli bir MacBook üzerinde ve macOS işletim sisteminde yürütülmüştür. SIMD içsel işlevleri, elle vektörleştirme ve harici sayısal kütüphaneler kullanılmamıştır.
Beş yapay zekâ algoritması neden seçilmiştir?
Algoritmalar güncel yapay zekânın en ileri modellerini temsil etmek için değil, farklı hesaplama biçimlerini kontrollü ve tekrar üretilebilir şekilde sınamak için seçilmiştir. Beş algoritma veri madenciliği, örnek tabanlı öğrenme, sinir ağı eğitimi, evrimsel hesaplama ve bulanık mantık alanlarını kapsamaktadır.
| Algoritma | Temsil ettiği alan | Temel deney parametreleri | Ağırlıklı hesaplama özelliği |
|---|---|---|---|
| k-means | Veri madenciliği | 100.000 nokta, 4 boyut, 10 küme, 1.000 sabit yineleme | Yoğun uzaklık hesabı ve iteratif merkez güncellemesi |
| k-NN | Makine öğrenmesi | 50.000 eğitim noktası, 10.000 sorgu, 8 boyut, k=15, 3 sınıf | Uzaklık, karşılaştırma ve indeksleme |
| MLP | Sinir ağları | 16→64→4 mimarisi, 10.000 örnek, 150 dönem, öğrenme oranı 0,01 | Yoğun kayan nokta işlemleri ve geri yayılım |
| Genetik algoritma | Hesaplamalı zekâ | 30 boyut, 5.000 birey, 1.200 nesil, turnuva büyüklüğü 3 | Dallanma, nüfus tabanlı arama ve rastgele işlemler |
| Mamdani sistemi | Bulanık sistemler | 2 giriş, giriş başına 3 üyelik fonksiyonu, 9 kural, 2 milyon çıkarım | Kural değerlendirme, min–max işlemleri ve ağırlık merkezi hesabı |
Diller arasında aynı hesaplama nasıl sağlanmıştır?
Araştırmacılar bütün dillerde aynı algoritma özelliklerini, başlangıç koşullarını, eşitlik bozma kurallarını ve durdurma ölçütlerini kullanmıştır. Rastgele girdilerin eşlenmesi için her dilde aynı 64 bitlik doğrusal eşlenik üreteç uygulanmıştır.
\[ s_{i+1} = (a s_i + c) \bmod 2^{64} \]
Bu eşitlikte si, i’inci adımdaki 64 bitlik iç durumu; a çarpanı ve c artış sabitini göstermektedir. Çalışmada:
- a = 6364136223846793005
- c = 1442695040888963407
- başlangıç tohumu s0 = 42
olarak belirlenmiştir.
\[ u_i = \frac{s_i \gg 33}{2^{31}} \]
Buradaki >> 33 işlemi, 64 bitlik durumun 33 bit sağa kaydırılmasını ifade eder. Elde edilen tamsayı 231 değerine bölünerek boyutsuz bir sözde rastgele sayı oluşturulur. Her dilde sayıların aynı sırayla tüketilmesi, deney girdilerinin eşlenmesini sağlamıştır.
Dillerin matematik kütüphaneleri arasında fark oluşmaması için karekök, üstel, logaritma ve kosinüs gibi aşkın fonksiyonlardan kaçınılmıştır. k-NN ve k-means testlerinde karekök yerine karesi alınmış Öklid uzaklığı kullanılmıştır. MLP’de sigmoid veya softmax yerine ReLU ve ortalama karesel hata uygulanmıştır. Genetik algoritmada kosinüs içeren Rastrigin fonksiyonu yerine polinom biçimindeki Rosenbrock fonksiyonu seçilmiştir.
Her program tamsayı ve kayan noktalı bir çıktı parmak izi üretmiştir. Tamsayı parmak izleri altı dilde tamamen eşleşmiş, kayan noktalı özetler altı ondalık basamağa kadar aynı bulunmuştur. Derleyicilerin birleşik çarpma-toplama işlemi uygulayabilmesi nedeniyle çalışma, bütün kayan noktalı ara sonuçların mutlak biçimde bit düzeyinde eşit olduğunu göstermemektedir.
Süre ve bellek nasıl ölçülmüştür?
Her dil–algoritma çifti üç ısınma çalıştırmasının ardından on kez ölçülmüştür. Duvar saati süresi hyperfine, tepe yerleşik bellek kullanımı ise macOS üzerindeki /usr/bin/time -l ve ru_maxrss değeriyle belirlenmiştir. Standart çıktı /dev/null hedefine yönlendirilmiş, ancak ölü kod elemesini engellemek için programlar parmak izlerini yine de hesaplayıp yazdırmıştır.
Çalışma süresi ve bellek dışında derlenmiş dosyanın büyüklüğü, beş uygulamanın toplam kod satırı sayısı ve önbellek temizlendikten sonraki soğuk derleme süresi de ölçülmüştür. Farklı algoritmalardaki yavaşlama oranları, C diline göre normalize edildikten sonra geometrik ortalamayla birleştirilmiştir.
Çalışma süresi sonuçları ne göstermektedir?
En hızlı performans katmanını C, C++ ve Rust oluşturmuştur. C ile C++ arasındaki farklar beş testte de %2’nin altında kalmıştır. C++ k-means, k-NN, MLP ve genetik algoritma testlerinde küçük farklarla öne çıkarken C, bulanık çıkarım testinde daha düşük süre vermiştir. Rust’ın C’ye göre geometrik ortalama yavaşlama oranı 1,09’dur.
| Dil | k-means (s) | k-NN (s) | MLP (s) | Genetik algoritma (s) | Bulanık sistem (s) | C’ye göre geometrik oran |
|---|---|---|---|---|---|---|
| C | 0,717 | 0,748 | 0,678 | 0,728 | 0,369 | 1,00 |
| C++ | 0,706 | 0,746 | 0,675 | 0,722 | 0,372 | 1,00 |
| Rust | 0,769 | 0,861 | 0,774 | 0,772 | 0,375 | 1,09 |
| Julia | 3,062 | 2,200 | 3,113 | 1,074 | 1,698 | 3,30 |
| Go | 5,710 | 1,969 | 4,174 | 2,688 | 2,451 | 5,01 |
| Python | 332,0 | 261,2 | 220,4 | 108,7 | 144,7 | 314,6 |
Çalışmanın 9. sayfasındaki logaritmik grafik, üç performans katmanını görsel olarak açık biçimde ayırmaktadır. C, C++ ve Rust sütunları grafiğin alt bölümünde birbirine çok yakın görünürken Julia ve Go orta bölgede yer almaktadır. Python sütunları bütün algoritmalarda diğer dillerin çok üzerinde bulunmaktadır.
Python’ın C’ye göre farkı algoritmaya bağlı olarak değişmiştir. En düşük oran dallanma ağırlıklı genetik algoritmada yaklaşık 149 kat, en yüksek oran ise yoğun aritmetik içeren k-means testinde yaklaşık 463 kattır. Bu sonuç, Python’ın bütün iş yüklerinde tek bir sabit oranda yavaş olmadığını göstermektedir.
Python için 315 kat sonucu nasıl yorumlanmalıdır?
314,6 katlık değer, Python’da yazılmış bütün yapay zekâ uygulamalarının C’den bu oranda yavaş olduğu anlamına gelmemektedir. Çalışma Python kodunu NumPy, PyTorch, Numba, Cython, JAX veya başka bir yerel hesaplama kütüphanesi olmadan, açık döngüler ve skaler işlemlerle çalıştırmıştır.
Python’ın gerçek yapay zekâ geliştirmedeki başlıca avantajı, sayısal işlemleri optimize edilmiş yerel çekirdeklere aktarabilen geniş yazılım ekosistemidir. Araştırmanın sonucu, Python’ın bu kütüphanelerden yoksun kaldığında dil düzeyindeki yorumlama maliyetinin belirginleştiğini göstermektedir. Sonuç, PyTorch ile eğitilen bir modelin aynı C++ modelinden 315 kat yavaş olacağını göstermemektedir.
Bellek kullanımında hangi dil öne çıkmıştır?
C ve C++ ortalama 3,5 MiB, Rust 3,7 MiB tepe yerleşik bellek kullanmıştır. Go’nun ortalaması 6,3 MiB, Python’ın 27,6 MiB ve Julia’nın 224,2 MiB olarak ölçülmüştür.
| Dil | k-means (MiB) | k-NN (MiB) | MLP (MiB) | Genetik algoritma (MiB) | Bulanık sistem (MiB) | Ortalama (MiB) |
|---|---|---|---|---|---|---|
| C | 4,7 | 5,1 | 2,8 | 3,6 | 1,2 | 3,5 |
| C++ | 4,8 | 5,2 | 2,8 | 3,6 | 1,3 | 3,5 |
| Rust | 5,2 | 5,4 | 2,9 | 3,7 | 1,3 | 3,7 |
| Go | 8,1 | 8,4 | 5,3 | 6,1 | 3,8 | 6,3 |
| Python | 37,6 | 38,1 | 24,2 | 23,2 | 14,7 | 27,6 |
| Julia | 228,7 | 216,2 | 234,3 | 225,3 | 216,5 | 224,2 |
11. sayfadaki logaritmik bellek grafiğinde Julia’nın sütunları bütün iş yüklerinde yaklaşık aynı yükseklikte ve diğer dillerin belirgin biçimde üzerinde görünmektedir. Bu durum, Julia’nın JIT derleyicisi ve çalışma zamanı için sabit bir başlangıç maliyeti taşıdığı yorumunu desteklemektedir. Uzun süre çalışan ve büyük veri işleyen uygulamalarda bu sabit maliyetin göreli önemi azalabilir; ancak küçük ve kısa süreli işlemlerde veya düşük bellekli cihazlarda önemli olabilir.
Kod uzunluğu gerçekten üretkenliği ölçüyor mu?
Beş algoritmadaki toplam kod satırı sayısı C++ için 397, C ve Python için 406, Rust için 474, Julia için 514 ve Go için 541 olarak bildirilmiştir. Python’ın C’den daha kısa olmaması, çalışmanın en dikkat çekici bulgularından biridir.
Ancak kod satırı sayısı geliştirme süresi, bakım kolaylığı, hata oranı, okunabilirlik veya geliştirici deneyimiyle aynı şey değildir. Çalışma geliştiricilerin algoritmaları yazmak için harcadığı gerçek zamanı ya da hata ayıklama maliyetini ölçmemiştir. Bu nedenle satır sayısı yalnızca sınırlı bir uygulama karmaşıklığı göstergesidir.
| Dil | Çalıştırılabilir dosya büyüklüğü | Toplam kod satırı | Soğuk derleme süresi |
|---|---|---|---|
| C | 33,6 KB | 406 | 0,93 saniye |
| C++ | 33,7 KB | 397 | 1,13 saniye |
| Rust | 373,1 KB | 474 | 8,73 saniye |
| Go | 2.509,4 KB | 541 | 3,30 saniye |
| Python | Uygulanamaz | 406 | Uygulanamaz |
| Julia | Uygulanamaz | 514 | Uygulanamaz |
Rust’ın daha uzun derleme süresi, çalışmada bağlantı zamanı optimizasyonu ve tek kod üretim birimi gibi yoğun optimizasyon ayarlarıyla birlikte değerlendirilmelidir. Go’nun yaklaşık 2,5 MB büyüklüğündeki dosyası ise çalışma zamanı ve çöp toplayıcının çalıştırılabilir dosyaya dâhil edilmesiyle ilişkilendirilmiştir.
12. sayfadaki radar grafik ne göstermektedir?
Radar grafik hız, bellek, ikili dosya büyüklüğü, derleme ve kod satırı ölçütlerini daha yüksek değer daha iyi olacak şekilde normalize etmektedir. C ile C++ çizgileri neredeyse tamamen örtüşmektedir. Rust hız ve bellek eksenlerinde bu iki dile yaklaşırken derleme ve dosya büyüklüğünde geride kalmaktadır.
Julia ile Python kod satırı ekseninde bir ölçüde toparlanırken çalışma zamanı ve bellek eksenlerinde daha düşük değer almaktadır. Ancak farklı nitelikteki ölçütlerin tek bir grafikte normalize edilmesi, bir dilin bütün projeler için genel olarak üstün olduğu anlamına gelmez. Projenin hangi eksene daha fazla önem verdiği ayrıca belirlenmelidir.
Dil sıralaması iş yüküne göre neden değişmektedir?
Go’nun C’ye göre yavaşlama oranı k-NN’de yaklaşık 2,6 kat, k-means testinde yaklaşık 8 kattır. k-means, MLP ve bulanık çıkarım testleri yoğun kayan nokta hesaplamaları ve indirgemeler içerirken k-NN karşılaştırma ve indekslemeye daha fazla ağırlık vermektedir. Derleyici optimizasyonları, sınır denetimleri, bellek yerleşimi ve çalışma zamanı davranışı bu işlem türlerinde farklı etkiler gösterebilir.
Julia en güçlü göreli sonucunu genetik algoritmada vermiştir. Araştırmacılar bunu genetik algoritmanın dallanma ağırlıklı yapısının agresif biçimde optimize edilen sistem dillerinin bazı avantajlarını azaltmasıyla ilişkilendirmektedir. Bu açıklama makul bir yorum olarak sunulmuştur; ancak donanım sayaçları veya düşük seviyeli işlemci profilleriyle doğrudan sınanmamıştır.
Çalışmanın desteklediği sonuçlar nelerdir?
- Kütüphanesiz ve sıfırdan yazılmış klasik yapay zekâ algoritmalarında C ve C++ çalışma süresi ile bellek bakımından en güçlü katmanı oluşturmuştur.
- Rust, kullanılan optimizasyon ayarları altında C’nin geometrik ortalama olarak %9 gerisinde kalmış ve benzer bellek tüketimi göstermiştir.
- Julia, çalışma süresinde çoğu testte Go’dan daha hızlı olmakla birlikte çok daha yüksek sabit bellek yükü taşımıştır.
- Go’nun göreli başarımı algoritmanın hesaplama yapısına göre önemli ölçüde değişmiştir.
- Python, optimize edilmiş yerel kütüphaneler olmadan açık döngülerle çalıştırıldığında diğer dillerden çok daha yavaş sonuç vermiştir.
- Dil seçimi yalnızca çalışma süresiyle değil, bellek, dosya büyüklüğü, derleme süresi, güvenlik ve hedef çalışma ortamıyla birlikte değerlendirilmelidir.
Çalışma neyi kanıtlamamaktadır?
- Python ile geliştirilen bütün yapay zekâ uygulamalarının C’den 315 kat yavaş olduğunu kanıtlamamaktadır.
- PyTorch, TensorFlow, NumPy, JAX veya GPU kütüphanelerinin gerçek performansını karşılaştırmamaktadır.
- C++ veya Rust’ın bütün donanım, işletim sistemi ve algoritmalarda en iyi dil olduğunu göstermemektedir.
- Kod satırı sayısının gerçek geliştirme süresini veya programcı üretkenliğini temsil ettiğini kanıtlamamaktadır.
- Enerji tüketimini, paralel ölçeklenebilirliği, GPU başarımını, ağ gecikmesini veya dağıtık sistem davranışını ölçmemektedir.
- Modern transformer, büyük dil modeli veya büyük ölçekli derin öğrenme eğitiminin işlem yapısını doğrudan temsil etmemektedir.
Çalışmanın güçlü yönleri nelerdir?
- Altı dilde aynı beş algoritma sıfırdan uygulanmıştır.
- Girdiler ortak bir sözde rastgele sayı üreteciyle eşlenmiştir.
- Başlangıç, eşitlik bozma ve durdurma kuralları açıkça tanımlanmıştır.
- Çıktı parmak izleriyle hesaplamaların eşdeğerliği denetlenmiştir.
- Her süre ölçümü üç ısınma ve on ölçüm çalıştırmasıyla yapılmıştır.
- Süre dışında bellek, dosya büyüklüğü, kod satırı ve derleme maliyeti de değerlendirilmiştir.
- Farklı hesaplama biçimlerine sahip beş algoritma kullanılarak iş yüküne bağlı değişim gösterilmiştir.
Çalışmanın temel sınırlılıkları nelerdir?
Bütün ölçümler tek bir Apple M1 Pro bilgisayarda ve macOS üzerinde yapılmıştır. Aynı kodların x86-64 işlemcilerde, Linux veya Windows üzerinde, başka derleyicilerle ve farklı bellek mimarilerinde aynı oranları vermesi garanti değildir.
Julia ölçümleri başlangıç ve JIT derleme maliyetini içermektedir. Kısa süreli testlerde bu maliyet toplam sürenin önemli bölümünü oluşturabilir; uzun süre çalışan uygulamalarda ise çok sayıda işlem arasında paylaştırılabilir. Bu nedenle Julia’nın sonuçları kalıcı bir servis ile tek seferlik bir komut satırı işlemi için farklı anlam taşır.
Harici kütüphaneler, SIMD, elle vektörleştirme ve GPU kullanılmaması dilin temel çalışma biçimini incelemeyi kolaylaştırmıştır; ancak gerçek yapay zekâ yazılımlarının performansını temsil etme gücünü azaltmıştır. Modern sistemlerde ağır matris işlemleri genellikle BLAS, CUDA, Metal veya başka yerel çekirdeklerde yürütülmektedir.
Sayısal eşlenebilirlik amacıyla üstel, logaritmik, karekök ve trigonometrik fonksiyonlardan kaçınılması, gerçek makine öğrenmesi iş yüklerinin bazı önemli işlem türlerini kapsam dışında bırakmıştır. MLP modeli de güncel derin ağlardan çok, kontrollü bir yoğun hesaplama çekirdeği olarak değerlendirilmelidir.
Çalışmanın Yöntemi ve Bulguları
Deney düzeninin teknik özeti
| Deney bileşeni | Uygulanan yöntem | Yorum sınırı |
|---|---|---|
| Donanım | Apple M1 Pro, 6 performans ve 2 verimlilik çekirdeği, 16 GB birleşik bellek | Başka işlemci mimarileri sınanmamıştır. |
| İşletim sistemi | macOS | Linux ve Windows sonuçları bulunmamaktadır. |
| Uygulama yaklaşımı | Altı dilde sıfırdan ve harici sayısal kütüphane olmadan | Gerçek yapay zekâ çerçevelerinin hızını temsil etmez. |
| Rastgelelik | 64 bit LCG, başlangıç tohumu 42 | Gerçek uygulamalardaki farklı üreticiler karşılaştırılmamıştır. |
| Sayısal işlemler | Temel IEEE 754 toplama, çıkarma, çarpma, bölme ve min–max işlemleri | Aşkın fonksiyonlar bilinçli olarak çıkarılmıştır. |
| Süre ölçümü | 3 ısınma ve ardından 10 ölçüm çalıştırması | Çok uzun süreli servis davranışı incelenmemiştir. |
| Bellek ölçümü | ru_maxrss ile tepe yerleşik küme büyüklüğü | Toplam tahsis veya enerji tüketimi ölçülmemiştir. |
| Kararlılık | Bütün dil–test çiftlerinde bağıl standart sapma %4’ün altında | Çoğu karşılaştırma için güven aralığı veya p değeri verilmemiştir. |
Üç temel performans katmanı
- Yüksek performans katmanı: C, C++ ve Rust. C ile C++ pratik olarak aynı düzeyde, Rust ise geometrik ortalamada %9 geridedir.
- Orta katman: Julia ve Go. Julia C’den 3,30 kat, Go 5,01 kat daha uzun çalışma süresi göstermiştir.
- Yorumlayıcı katman: Kütüphanesiz Python, C’nin 314,6 katı geometrik ortalama süreye ulaşmıştır.
Hız ve bellek birlikte değerlendirildiğinde
C ve C++ hem süre hem bellek bakımından en düşük değerleri sağlamıştır. Rust, çok küçük bir bellek farkıyla bu ikiliye yakın kalmıştır. Julia’nın Go’dan daha hızlı olduğu çoğu testte yaklaşık 224 MiB sabit bellek yükü bulunurken Go 10 MiB’ın altında kalmıştır. Bu nedenle Julia ile Go arasındaki tercih yalnızca süreye göre yapılamaz.
Kaynakları sınırlı ve kısa süreli bir uç uygulamada Julia’nın sabit çalışma zamanı maliyeti önemli olabilir. Uzun süre açık kalan, çok sayıda hesaplama yürüten bir servis için aynı maliyet işlemler arasında paylaştırılabilir. Go daha büyük çalıştırılabilir dosya üretmesine rağmen çalışma sırasındaki bellek tüketimi Julia ve Python’dan düşük kalmıştır.
Uygulama dili seçimi için çalışmadan çıkarılabilecek pratik çerçeve
| Proje önceliği | Çalışmanın desteklediği değerlendirme | Dikkat edilmesi gereken sınır |
|---|---|---|
| En düşük çalışma süresi | C ve C++ en güçlü sonuçları vermiştir. | Güvenlik, bakım ve geliştirme maliyeti ölçülmemiştir. |
| Yerel hıza yakın bellek güvenliği | Rust, C’nin ortalama %9 gerisinde ve benzer bellek düzeyindedir. | Derleme süresi daha uzundur. |
| JIT ile yüksek düzeyli sayısal kod | Julia, çoğu iş yükünde Go’dan hızlıdır. | Yaklaşık 224 MiB sabit bellek maliyeti vardır. |
| Düşük çalışma belleği ve kolay dağıtım | Go, Julia ve Python’dan daha az bellek kullanmıştır. | Yoğun aritmetik testlerde yavaşlama yüksek olmuştur. |
| Hazır yapay zekâ ekosistemi | Çalışma Python ekosisteminin değerini dolaylı olarak göstermektedir. | Hazır kütüphaneler deneyden bilinçli olarak çıkarılmıştır. |
Sonuçların doğru kullanım biçimi
Çalışma, “en iyi yapay zekâ dili” için evrensel bir sıralama sunmamaktadır. Sonuçlar, kütüphanesiz klasik algoritmaların tek çekirdekli veya sınırlı paralellikteki CPU uygulamalarına ilişkin kontrollü bir karşılaştırmadır. Bir dil seçimi yapılırken gerçek algoritma, hedef işlemci, bellek sınırı, işletim sistemi, güvenlik gereksinimi, ekip deneyimi, kullanılacak kütüphaneler ve yazılımın ne kadar süre çalışacağı birlikte değerlendirilmelidir.
Kaynak ve Yöntem Notu
Çalışmanın tam özgün adı: Behind Python: The Languages That Power AI
Yazarlar: Juan P. Licona-Luque, Beatriz A. Bosques-Palomo, Nezih Nieto-Gutiérrez, Gustavo de los Ríos-Alatorre ve Luis A. Muñoz-Ubando
Yazar sıralaması: Yukarıdaki liste çalışmadaki özgün yazar sıralamasını korumaktadır.
Eş birinci yazar bilgisi: Çalışmada eşit katkı veya eş birinci yazarlık bilgisi yer almamaktadır.
Sorumlu yazar bilgisi: Çalışmada açık bir sorumlu yazar beyanı bulunmamaktadır. arXiv başvurusu Juan P. Licona-Luque tarafından yapılmıştır; bu bilgi sorumlu yazarlık olarak yorumlanmamıştır.
Kurum: Tecnológico de Monterrey, Monterrey, Nuevo León, Meksika
Dergi: Çalışma bir dergide yayımlanmamıştır.
Özgün yayınevi: Özgün bir dergi yayınevi bilgisi bulunmamaktadır.
Yayın platformu: arXiv
arXiv kimliği: arXiv:2606.18141 [cs.PL]
Yayın yılı: 2026
Kaynak türü: Kontrollü deneysel performans kıyaslaması niteliğinde preprint
Hakemlik durumu: Bu çalışma hakem değerlendirmesinden geçtiği doğrulanmamış bir preprinttir; sonuçları bu sınırlılık dikkate alınarak okunmalıdır.
Resmî bağlantı:arXiv çalışma sayfası
Bu Türkçe makale, yüklenen 17 sayfalık çalışmanın metni, formülü, tabloları ve grafiklerinin tamamı incelenerek hazırlanmıştır. Performans değerleri, bellek tüketimleri, araç zincirleri ve algoritma parametreleri yalnızca çalışmada bildirilen bilgilerden aktarılmıştır. Dış kaynaklar yalnızca başlık, yazarlar, DOI, platform, tarih ve yayın durumunun bibliyografik doğrulaması için kullanılmıştır.
Çalışmanın temel sınırlılıkları tek donanım ve işletim sistemi kullanılması, harici kütüphanelerin ve GPU’nun dışarıda bırakılması, Julia’nın başlangıç ve JIT maliyetinin ölçümlere dâhil edilmesi, modern derin öğrenme çekirdeklerinin sınanmaması ve kod satırı sayısının geliştirme üretkenliğinin doğrudan ölçüsü olmamasıdır. Bu sonuçlar modern yapay zekâ çerçevelerinin, büyük dil modellerinin veya GPU eğitimlerinin genel performans karşılaştırması olarak yorumlanmamalıdır.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir