

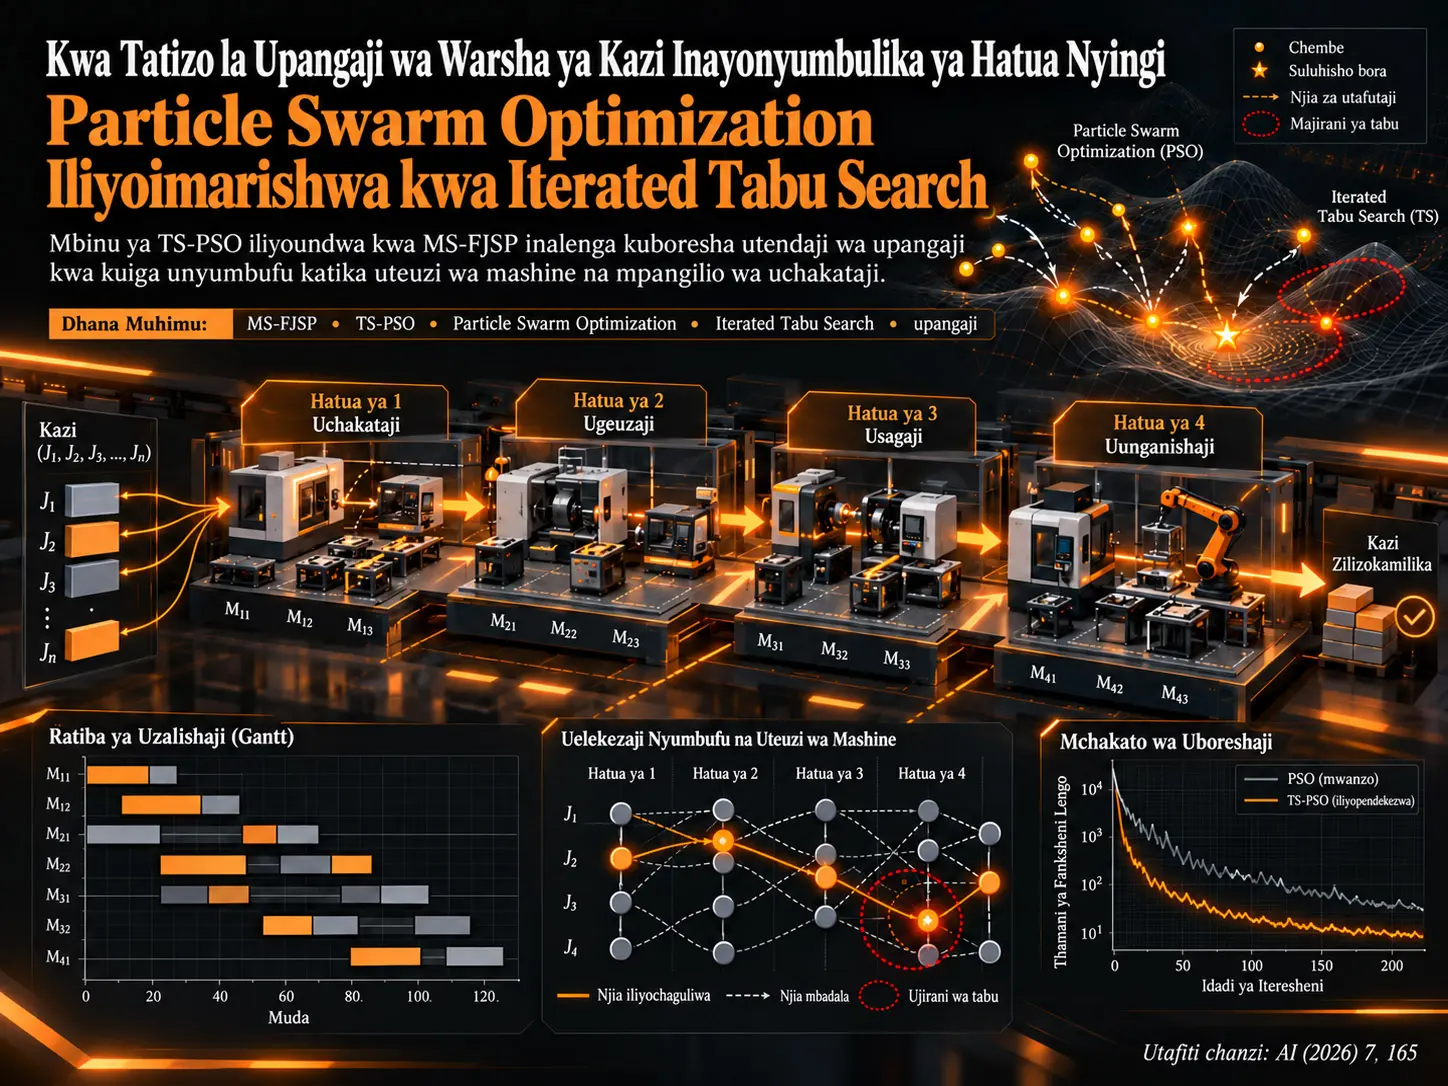
Tatizo la Upangaji wa Warsha ya Kazi Inayonyumbulika ya Hatua Nyingi (Multi-Stage Flexible Job Shop Scheduling Problem, MS-FJSP) ni modeli ya upangaji wa kikombinatoria inayogawa kazi katika hatua za uzalishaji, kuruhusu kuchaguliwa kwa mashine zaidi ya moja zinazofaa katika hatua moja, na kuruhusu mpangilio wa uchakataji wa mashine zilizochaguliwa kubadilishwa. Utafiti huu unapanua dhana za uchaguaji wa mashine moja na njia ngumu zaidi za uchakataji katika upangaji wa kawaida wa warsha ya kazi inayonyumbulika; kwa ajili ya suluhisho, unapendekeza algoriti ya TS-PSO inayounganisha particle swarm optimization na tabu search yenye ujirani mbili. Lengo kuu la uboreshaji wa modeli si kupunguza moja kwa moja muda wa kukamilika kwa uzalishaji, bali kupunguza tofauti ya muda ya mahitaji kwa kila aina ya mashine katika upeo uliowekwa wa upangaji, ili idadi ya mashine zinazohitajika iweze kusambazwa kwa usawa zaidi.
Katika TS-PSO, particle swarm optimization (PSO) hutumiwa kuunda muundo wa suluhisho la awali katika nafasi kubwa ya suluhisho na kubainisha makadirio ya mgawanyo wa mahitaji ya mashine. Kisha tabu search hufanya uboreshaji wa ndani katika ujirani mbili tofauti zilizoundwa kulingana na unyumbufu wa uteuzi wa mashine na mpangilio katika MS-FJSP. Watafiti waliilinganisha mbinu hiyo na Simulated Annealing (SA), Ant Colony Optimization (ACO) na Genetic Algorithm (GA) katika jumla ya sampuli 12.000 za MS-FJSP zilizotengenezwa na kusambazwa katika viwango 120 tofauti vya tatizo; pia walichunguza vipengele vya algoriti kwa majaribio ya ablation.
Katika tathmini ya sampuli za matatizo yaliyotengenezwa, ambapo thamani ya chini ya objective function ina maana ya mahitaji ya mashine yaliyo sawia zaidi, TS-PSO ilipata thamani za objective function zilizo chini ya mbinu tatu za msingi katika viwango vyote vikuu vya ulinganisho. Kulingana na hesabu ya jumla ya chanzo, tofauti ya wastani ya SA dhidi ya TS-PSO ni takribani %1,21, ya GA takribani %3,22 na ya ACO takribani %4,04. Ongezeko hili la ubora lilipatikana katika baadhi ya sampuli kwa gharama ya muda wa kukokotoa ulio juu kidogo; kwa ujumla, muda ulibaki katika kiwango sawa cha ukubwa na algoriti zilizolinganishwa.
Kwa uhusiano na mazingira halisi, tatizo la upangaji wa wafanyakazi la mwaka 2024 katika First Bethune Hospital of Jilin University lilimodelishwa kama MS-FJSP. Katika mfano huu, idara 72 zinawakilisha aina za mashine, historia 26 za kitaaluma zinawakilisha vikundi vya kazi, wafanyakazi 491 wanawakilisha kazi, na wastani wa idara 13 zinazofaa unawakilisha ulinganifu wa mashine. Chanzo kinaripoti nafasi ya suluhisho ya modeli hii kama \(1\times10^{5194}\). TS-PSO pia ilizalisha thamani za variance zilizo chini kuliko mbinu zilizolinganishwa. Hata hivyo, matokeo haya ni uthibitishaji wa uundaji wa modeli ya kialgoriti na majaribio ya kihesabu; si jaribio la uwanjani linalopima matokeo ya kiutendaji ya kutumia ratiba katika taasisi halisi.
MS-FJSP ni nini?
MS-FJSP ni tatizo la upangaji wa warsha ya kazi inayonyumbulika ambapo kazi zina njia za uchakataji za hatua kwa hatua, na uteuzi pamoja na mpangilio wa aina za mashine zinazohitajika katika kila hatua huwekwa kwa unyumbufu chini ya vizuizi fulani. Tofauti kuu na FJSP ya kawaida ni kwamba sharti la kuhusisha operesheni na mashine moja tu inayofaa hulegezwa, hivyo kuruhusu aina kadhaa za mashine kutumiwa katika hatua moja na mpangilio wa uchakataji wa mashine hizo kubadilishwa.
Inatofautianaje na FJSP ya kawaida?
Flexible Job Shop Scheduling Problem (FJSP) ya kawaida hushughulikia maamuzi mawili ya msingi kwa pamoja: kazi zitatekelezwa kwa mpangilio gani, na kila operesheni itafanywa kwenye mashine ipi inayofaa. Katika utafiti unaochunguzwa, muundo huu unapanuliwa kwa njia mbili. Kwanza, operesheni hupangwa kama hatua za uzalishaji, na hatua inayofuata inaweza kuanza tu baada ya hatua iliyotangulia kukamilika. Pili, badala ya kuchagua mashine moja katika hatua, idadi inayohitajika ya aina za mashine inaweza kuchaguliwa, na mpangilio wa uchakataji kati ya mashine zilizochaguliwa unaweza kubadilishwa.
Modeli pia hupanga kazi katika vikundi kulingana na njia za uchakataji. Kazi zilizo katika kundi moja la kazi hufuata mpangilio mmoja wa uchakataji. Uwekaji huu katika vikundi si sawa na wazo la Flexible Group Shop Scheduling Problem la kukusanya njia zinazofanana ili kupunguza muda wa setup. Lengo la uwekaji katika vikundi katika MS-FJSP ni kumodeli uzalishaji unaorudiwa wa aina ileile ya kazi na kuwepo kwa kazi nyingi ndani ya mpangilio mmoja.
Kwa nini dhana ya hatua ni muhimu?
Muundo wa hatua hugawa maamuzi katika vitalu vya uchakataji vinavyofuatana lakini vinavyonyumbulika ndani yake, badala ya kubana chaguo zote za mchakato wa uzalishaji au upangaji katika njia moja ya mstari ya mashine. Kwa kundi la kazi \(i\), idadi ya hatua huonyeshwa kwa \(kn_i\). Seti ya aina za mashine zinazoweza kutumika katika hatua ya \(k\) huonyeshwa kwa \(LM_{i,k}\), idadi ya aina za mashine zinazopatikana kwa \(NT_{i,k}\), na idadi ya aina za mashine zinazohitajika kwa kweli kwa \(N_{i,k}\).
Mgawanyo huu huongeza nafasi ya suluhisho kwa kasi. Katika hatua moja, si tu mashine zipi zitachaguliwa, bali pia mashine zilizochaguliwa zitatumiwa kwa mpangilio gani ni sehemu ya uamuzi. Kwa hiyo, kadiri chaguo za mashine na idadi ya hatua zinavyoongezeka, tatizo hutengeneza nafasi kubwa zaidi sana ya utafutaji wa kikombinatoria kuliko miundo ya kawaida yenye uteuzi mmoja.
Uwakilishi wa muda na mahitaji ya mashine katika modeli
Utafiti hutumia matriksi mbili kuu. \(RM\) ni matriksi ya upangaji wa mashine na katika muundo wa kazi × muda huwakilisha ni kazi ipi inachakatwa kwenye aina gani ya mashine katika hatua ipi ya muda. \(RN\) ni matriksi ya mahitaji ya mashine; katika muundo wa aina ya mashine × muda huonyesha ni mashine ngapi za aina fulani zinahitajika katika kila hatua ya muda.
| Alama | Maana |
|---|---|
| \(jn\) | Jumla ya idadi ya kazi |
| \(J_{i,j}\) | Katika kundi la kazi \(i\), kazi ya \(j\) |
| \(gn\) | Jumla ya idadi ya vikundi vya kazi |
| \(gn_i\) | Idadi ya kazi katika kundi la kazi \(i\) |
| \(kn_i\) | Idadi ya hatua za uchakataji za kundi la kazi \(i\) |
| \(mn\) | Jumla ya idadi ya aina za mashine |
| \(M_l\) | Aina ya mashine ya \(l\) |
| \(M_0\) | Mashine pepe inayoashiria kuwa operesheni zote zimekamilika |
| \(T_{\max}\) | Jumla ya muda wa upangaji / upeo wa muda |
| \(pt_{i,k,l}\) | Muda wa uchakataji wa kundi \(i\) katika hatua ya \(k\) kwenye \(M_l\) |
| \(bt_{i,j,k}\) | Muda wa kuanza kwa kazi \(J_{i,j}\) katika hatua ya \(k\) |
| \(et_{i,j,k}\) | Muda wa kukamilika kwa kazi \(J_{i,j}\) katika hatua ya \(k\) |
| \(LM_{i,k}\) | Indeksi za mashine ambazo kundi \(i\) linaweza kutumia katika hatua ya \(k\) |
| \(NM_{i,j,k}\) | Indeksi za mashine ambazo kazi \(J_{i,j}\) hutumia kwa kweli katika hatua ya \(k\) |
| \(O_{i,k,n}\) | Operesheni ya kundi \(i\) inayohitaji mashine \(n\) katika hatua ya \(k\) |
| \(N_{i,k}\) | Idadi ya aina za mashine ambazo kundi \(i\) linahitaji katika hatua ya \(k\) |
| \(NT_{i,k}\) | Idadi ya aina za mashine zinazopatikana kwa kundi \(i\) katika hatua ya \(k\) |
| \(RM\) | Matriksi ya upangaji wa mashine: kazi × muda |
| \(RN\) | Matriksi ya mahitaji ya mashine: aina ya mashine × muda |
| \(\mu_{i,j,t,l}\) | Ikiwa kazi \(J_{i,j}\) wakati \(t\) inachakatwa kwenye \(M_l\), 1; vinginevyo 0 |
| \(\phi_{i,j,k,l}\) | Ikiwa kazi \(J_{i,j}\) katika hatua ya \(k\) inatumia \(M_l\), 1; vinginevyo 0 |
| \(\xi_{i,k,l}\) | Ikiwa kundi \(i\) katika hatua ya \(k\) linaweza kutumia \(M_l\), 1; vinginevyo 0 |
Objective function inaboresha nini?
Objective function ya MS-FJSP katika utafiti huu hujumlisha variance za kiasi cha mahitaji kwa kila aina ya mashine katika muda na kupunguza jumla hiyo; hivyo thamani ya chini ina maana kwamba hitaji la mashine limesambazwa kwa usawa zaidi katika muda ndani ya upeo uleule wa upangaji. Jambo hili ni muhimu kwa sababu, tofauti na tafiti nyingi za kawaida za FJSP zinazolenga tu kupunguza makespan, utafiti huu hufanya ulaini wa ugawaji wa idadi ya mashine kuwa lengo la moja kwa moja la uboreshaji.
Objective function ya msingi, inayotegemea mraba wa mikengeuko kutoka wastani wa muda kwa kila aina ya mashine, imefafanuliwa katika chanzo kama ifuatavyo:
\[ f(RN)= \sum_{x=1}^{mn} \sum_{y=1}^{T_{\max}} \frac{ \left( RN_{x,y}- \frac{\sum_{y'=1}^{T_{\max}}RN_{x,y'}}{T_{\max}} \right)^2 }{ T_{\max} }. \]
Hapa \(RN_{x,y}\) inaonyesha mahitaji ya aina ya mashine \(x\) katika hatua ya muda \(y\); kipengele cha pili ndani ya mabano kinaonyesha wastani wa mahitaji ya aina hiyo ya mashine katika upeo wote wa upangaji. Kwa hiyo, function huadhibu mtawanyiko wa mkondo wa mahitaji kuzunguka wastani.
Kwa nini nafasi ya suluhisho hukua kwa kasi sana?
Ikiwa kwa kundi la kazi \(i\), katika hatua ya \(k\), kutoka miongoni mwa aina \(NT_{i,k}\) za mashine zinazopatikana, mashine \(N_{i,k}\) zinaweza kuchaguliwa kwa mpangilio, chanzo hufafanua idadi ya chaguo na mipangilio inayowezekana kama:
\[ p_{i,k}=\frac{NT_{i,k}!}{(NT_{i,k}-N_{i,k})!}. \]
Idadi ya njia katika hatua zote za kazi moja:
\[ P_i=\prod_{k=1}^{kn_i}p_{i,k}. \]
Ikiwa kazi katika kundi moja hazitofautishwi, jumla ya uwezekano wa upangaji hutolewa katika chanzo kama:
\[ P= \prod_{i=1}^{gn} \frac{(P_i+gn_i-1)!}{gn_i!\,(P_i-1)!} \]
na ikiwa kazi zinatofautishwa:
\[ P= \prod_{i=1}^{gn}P_i^{gn_i} \]
hutolewa. Maelezo haya yanaonyesha kwa nini, kadiri idadi ya mashine na chaguo za hatua zinavyoongezeka, kuchunguza suluhisho zote kwa brute force kunakuwa si jambo la vitendo.
Kwa nini TS-PSO inaunganisha mifumo miwili ya utafutaji?
TS-PSO inaunganisha uwezo wa PSO wa kuunda kwa haraka muundo mzuri wa awali katika nafasi kubwa ya suluhisho na uwezo wa tabu search wa kufanya utafutaji wa kina wa ndani karibu na suluhisho zuri lililopo. Mgawanyo wa kazi katika utafiti unaweza kufupishwa takribani kama “tumia PSO kukadiria muundo wa awali na mgawanyo wa mahitaji, kisha boresha kwa tabu search katika ujirani mbili mahususi kwa MS-FJSP”.
Tabaka la PSO: usimbaji, utatuzi na muundo wa awali
Katika hatua ya PSO, matriksi ya data ya DM huundwa kwa kila aina ya mashine. Safu za matriksi zinawakilisha hatua za uchakataji ambamo aina husika ya mashine inahusika, huku nguzo zikibeba taarifa kama ukubwa wa kundi la kazi, muda wa uchakataji na kipindi husika cha muda. Chembe moja huwakilishwa na matriksi \(RC\in\mathbb{R}^{cn\times T_{\max}}\). Mwanzoni, nambari kamili zisizo hasi husambazwa katika kipindi husika cha muda kwa namna ambayo jumla yake ni sawa na idadi ya kazi katika kundi hilo.
Kila chembe pia hupewa matriksi ya kumbukumbu \(RCR\) inayohifadhi hali bora zaidi iliyofikiwa na chembe hiyo. Chembe zilizosimbwa zinapopanuliwa kulingana na muda wa uchakataji, safu ya mahitaji yenye umbo \(res\in\mathbb{R}^{1\times T_{\max}}\) hupatikana. Chanzo hutoa fitness function ya PSO inayotegemea variance ya muda ya safu hiyo kama ifuatavyo:
\[ f_{res}= \frac{ \sum_{i=0}^{T_{\max}-1} \left( res[i]- \frac{\sum_{i'=0}^{T_{\max}-1}res[i']}{T_{\max}} \right)^2 }{ T_{\max} }. \]
Nafasi lengwa ya chembe ya PSO huundwa kwa kutumia chembe bora zaidi iliyopatikana duniani \(RC_{best}\) pamoja na matriksi ya kumbukumbu \(RCR\) ya chembe husika. Katika utafiti, coefficients za ujifunzaji zinatimiza sharti \(c_1+c_2=1\), na katika majaribio \(c_1=0{,}3\), \(c_2=0{,}7\) zilitumiwa.
Uwiano wa harakati na suala la uwasilishaji linalopaswa kuhifadhiwa kutoka chanzo
Chanzo hutoa Equation (23) kwa uwiano wa harakati katika umbo lifuatalo na kuueleza kama mkakati wa Linearly Decreasing Weight:
\[ r= r_{ini}- \frac{(r_{ini}-r_{end})(G_k-g)}{G_k} +r_{end}. \]
Equation hii imehifadhiwa hapa katika umbo lililochapishwa katika chanzo. Kuna haja ya ufafanuzi kati ya tafsiri ya kawaida ya kialjebra ya formula iliyoandikwa na maelezo ya “kupungua kwa mstari” katika maandishi; kwa hiyo maandishi ya Verianla hayabadilishi formula kimyakimya kuwa formula nyingine ya kawaida ya LDW. Vivyo hivyo, katika sehemu moja ya maelezo ya Figure 1, chanzo hutumia alama \(\gamma\) kinapozungumzia uwiano wa harakati; katika maelezo makuu ya mbinu, variable ni \(r\).
Tabu search yenye ujirani mbili
Baada ya suluhisho la awali kupatikana kutoka PSO, tabu search hufanya kazi katika eneo la karibu la suluhisho la sasa. Chanzo hufafanua ujirani mbili:
- Ujirani wa Swap: huzalisha wagombea wapya kwa kubadilisha mpangilio wa mashine zilizochaguliwa.
- Ujirani wa Replacement: huzalisha wagombea wapya kwa kubadilisha mashine iliyochaguliwa na mashine nyingine inayopatikana lakini haikuchaguliwa.
Katika chanzo, idadi ya vipengele vya ujirani imetolewa kama:
\[ sn=\frac{1}{2}\left(N_{i,k}^{2}-N_{i,k}\right) =\frac{N_{i,k}(N_{i,k}-1)}{2} \]
na
\[ rn=(NT_{i,k}-N_{i,k})N_{i,k} \]
Usemi wa kwanza unawakilisha kihisabati idadi ya michanganyiko ya kubadilishana kwa jozi miongoni mwa mashine \(N_{i,k}\) zilizochaguliwa, huku usemi wa pili ukiwakilisha idadi ya chaguo za kubadilisha kati ya mashine iliyochaguliwa na mashine inayopatikana lakini haikuchaguliwa.
Dokezo la uwasilishaji ndani ya chanzo: Kauli “swap neighborhood is valid if \(N_{i,k}<NT_{i,k}\)” na “replacement neighborhood is valid if \(N_{i,k}\geq2\)” katika maandishi zinaonekana kutolingana kwa kiwango cha majina na Equation (25)–(26) pamoja na maana ya kuona ya operators katika Figure 2 ya chanzo. Ili idadi ya swap katika Equation (25) iwe chanya, angalau mashine mbili zilizochaguliwa zinahitajika, ilhali operesheni ya replacement katika Equation (26) inahitaji kuwepo kwa chaguo jingine ambalo halikuchaguliwa. Kwa hiyo formula za chanzo zimehifadhiwa hapa, na masharti katika maandishi hayajachukuliwa kuwa “yamesahihishwa” kimyakimya.
Chanzo pia hutoa kwa kiasi cha skani ya DNTS:
\[ d=mn\times\left\lceil\frac{T_{\max}}{sn}\right\rceil \]
Tabu list huzuia mabadiliko yaliyofanywa awali kuchaguliwa tena kwa kipindi fulani; katika kila iteration, mgombea mwenye fitness bora zaidi huchaguliwa miongoni mwa majirani ambao si tabu, na ikiwa suluhisho bora zaidi la kimataifa la sasa linaweza kuboreshwa, husasishwa.
Dhana za msingi za modeli
Katika kutafsiri modeli ya kihisabati, dhana zifuatazo ni muhimu:
- Blocking au muda wa setup wa mashine hauzingatiwi katika kazi.
- Mashine ikishapangiwa kazi, operesheni husika haikatizwi.
- Kila mashine huchakata kazi moja tu katika kitengo kimoja cha muda.
- Muda wa mashine kupokea kazi na kuihamisha kwenda sehemu nyingine hupuuzwa.
- Kazi katika kundi moja la kazi hutumia mpangilio mmoja wa uchakataji.
- Inachukuliwa kuwa hata njia ikibadilika ndani ya mpangilio mmoja, jumla ya muda wa uchakataji hubaki sawa.
- Hatua inayofuata ya kazi huanza tu baada ya hatua iliyotangulia kukamilika.
- Mpangilio wa matumizi ya mashine kadhaa zilizochaguliwa katika hatua moja ni huru.
- Katika modeli, hakuna kikomo cha juu kilichowekwa kwa idadi ya kila aina ya mashine; hitaji huhesabiwa kupitia \(RN\).
Dhana hizi hufafanua uwezekano wa kukokotoa modeli na swali la utafiti; pia zinaonyesha kwamba wakati wa kuhamishia modeli katika mfumo halisi wa uzalishaji, huenda ikahitajika kumodeli kwa tofauti setup, usafirishaji, zamu, matengenezo, uwezo halisi wa mashine na vizuizi vingine vya eneo.
Mbinu na Matokeo ya Utafiti
Mfumo wa vizuizi vya kihisabati
Tatizo kuu la uboreshaji linafafanuliwa katika chanzo kama:
\[ F=\min f(RN) \]
Equations zilizobaki hubainisha masharti ambayo ratiba inayowezekana lazima itimize.
| Equation | Muundo wa kihisabati wa chanzo | Jukumu la kisayansi |
|---|---|---|
| (8) | \(bt_{i,j,1}=1\) | Huweka dhana kwamba kazi zote huingia hatua ya kwanza katika muda uleule wa kuanza. |
| (9) | \(0\le RM_{x,y}\le mn\) | Huhakikisha matriksi ya upangaji wa mashine inabaki ndani ya masafa halali ya indeksi za mashine. |
| (10) | \(\sum_{l=1}^{mn}\mu_{i,j,t,l}=1\) | Huhakikisha kazi inachakatwa kwenye mashine moja tu wakati wowote. |
| (11) | \(bt_{i,j,k+1}=et_{i,j,k}+1\) | Hulazimisha hatua kutekelezwa kwa mfululizo. |
| (12) | \(NT_{i,k}\ge N_{i,k}\ge1\) | Huzuia idadi ya mashine zinazohitajika kuzidi chaguo za mashine zinazopatikana. |
| (13) | \(pt_{i,k,l}=pt_{i,k,l'}\), \(et_{i,j,k}=bt_{i,j,k}+pt_{i,k,l}N_{i,k}\) | Husimba dhana ya chanzo kwamba muda wa uchakataji huchukuliwa kuwa sawa hata kama njia inabadilika ndani ya mpangilio mmoja. |
| (14) | \(T_{\max}\) ni sawa na jumla ya muda wa kazi mrefu zaidi. | Huhakikisha upeo wa upangaji unaamuliwa na kazi inayochukua muda mrefu zaidi. |
| (15) | \(0\le RN_{x,y}\le h\) | Huhakikisha kiasi cha mahitaji ya mashine si hasi na kinaonyeshwa ndani ya kikomo kikubwa chanya. |
| (16) | \(\sum_{t=bt_{i,j,k}}^{et_{i,j,k}}\mu_{i,j,t,l}=pt_{i,k,l}\) | Huunganisha matumizi ya mashine iliyochaguliwa kwa muda wote wa uchakataji unaohitajika. |
| (17) | \(\sum_{t'=t}^{t+pt_{i,k,l}-1}\mu_{i,j,t',l}=pt_{i,k,l}\) | Huhakikisha uchakataji wa kazi kwenye mashine iliyochaguliwa unatokea katika kizuizi cha muda kisichokatika. |
Mpangilio wa majaribio
Majaribio yalifanywa kwenye jukwaa lenye processor ya Intel Xeon Gold 6254 yenye cores 72 na kumbukumbu ya 256 GB. Kwa TS-PSO, population ya chembe iliwekwa kuwa 30, learning weights \(c_1=0{,}3\) na \(c_2=0{,}7\), na uwiano wa awali wa harakati \(r=0{,}9\).
| Algoriti | Vigezo vikuu vya majaribio |
|---|---|
| TS-PSO | Chembe 30; \(c_1=0{,}3\); \(c_2=0{,}7\); mwanzo \(r=0{,}9\) |
| SA | \(T_0=100\); cooling coefficient \(\alpha=0{,}95\); \(T_{end}=0{,}001\); ujirani wa random perturbation |
| ACO | Mchwa 50; \(\rho=0{,}1\); \(\alpha=1{,}0\); \(\beta=2{,}0\); \(\tau_0=0{,}1\) |
| GA | Population 100; roulette wheel selection; \(P_c=0{,}8\); \(P_m=0{,}01\) |
Benchmark yenye sampuli 12.000 iliundwaje?
Benchmark ina jumla ya viwango 120 vya tatizo, na kwa kila kiwango sampuli 100 zilitengenezwa, hivyo kufikia jumla ya sampuli 12.000 za MS-FJSP. Vigezo vya kiwango ni:
| Kigezo | Thamani |
|---|---|
| Idadi ya aina za mashine \(M\) | \(\{15,30\}\) |
| Idadi ya vikundi vya kazi \(G\) | \(\{10,25\}\) |
| Idadi ya kazi \(J\) | \(\{100,200,300,400,500\}\) |
| Wastani wa idadi ya mashine zinazofaa \(\bar M\) | \(\{3,5,7,9,12,15\}\) |
| Idadi ya hatua \(K\) | Nasibu kutoka seti \(\{2,3,4,5\}\) |
| Muda wa uchakataji \(P\) | Nasibu kutoka uniform distribution \(U(2,10)\) |
Ulinganisho ulifanywa kwa runs 30 huru na mwanzo tofauti wa nasibu. Chanzo huhesabu tofauti ya utendaji kama:
\[ Gap=\frac{v-v_{our}}{v_{our}}\times100\% \]
Hapa \(v\) ni objective value ya algoriti inayolinganishwa, huku \(v_{our}\) ikiwa objective value ya TS-PSO; kwa hiyo thamani chanya ya Gap inaonyesha kuwa mbinu inayolinganishwa imezalisha objective value iliyo juu kuliko TS-PSO, yaani mbaya zaidi kwa tatizo hili la minimization.
Matokeo makuu katika seti ya data iliyotengenezwa
Hitimisho kuu la Table 2 katika chanzo ni thabiti: katika matokeo yaliyojumlishwa ya michanganyiko yote iliyochunguzwa ya \(M\), \(G\) na \(J\), TS-PSO hutoa thamani ya chini zaidi ya variance. Jedwali lifuatalo linaonyesha sampuli zilizochaguliwa kutoka data ya chanzo ili kuwakilisha viwango tofauti kwa mpangilio wa Verianla.
| Kiwango \(M,G,J\) | TS-PSO Var | Muda wa TS-PSO (s) | SA Gap | ACO Gap | GA Gap |
|---|---|---|---|---|---|
| 15, 10, 100 | 1090,72 | 630,41 | %1,71 | %6,42 | %4,55 |
| 15, 25, 200 | 1833,28 | 690,26 | %1,12 | %4,37 | %2,96 |
| 15, 25, 500 | 3961,42 | 762,49 | %0,75 | %2,16 | %2,26 |
| 30, 10, 300 | 1462,92 | 835,82 | %1,04 | %4,87 | %3,79 |
| 30, 25, 400 | 3062,53 | 865,88 | %0,42 | %2,92 | %2,31 |
| 30, 25, 500 | 4162,57 | 899,62 | %0,90 | %2,20 | %2,21 |
Katika hesabu ya jumla ya chanzo kwa viwango mbalimbali, SA ndiyo mbinu ya msingi iliyo karibu zaidi na TS-PSO na tofauti ya wastani ni takribani %1,21. Kwa GA, tofauti ya wastani imetolewa kama takribani %3,22, na kwa ACO takribani %4,04. Matokeo haya yanaunga mkono kuwa, kwa kipimo cha variance ya mahitaji ya mashine kilicholengwa na utafiti, TS-PSO hutoa matokeo bora kuliko mbinu tatu za metaheuristic zilizolinganishwa.
Uthabiti na convergence
Katika Figure 3, chanzo hutoa box plots za runs 30 huru kwa viwango nane tofauti vya tatizo. Katika ulinganisho wa kuona, distributions za TS-PSO hujikusanya katika eneo la objective function lenye thamani ya chini katika kila sampuli. Matokeo haya yametumiwa kuonyesha kwamba si mwanzo mmoja tu wa nasibu uliofanikiwa, bali mwelekeo sawa wa utendaji ulipatikana pia katika runs zinazojirudia.
Katika jaribio la convergence, sampuli za MS-FJSP katika kiwango cha \(15\times10\) zilifuatiliwa kwa iterations 1000. Chanzo kinaripoti objective value ya TS-PSO kuwa 1405,78 katika iteration ya 100. Mwishoni mwa iteration ya 500, objective value ya suluhisho la TS-PSO iliripotiwa kuwa chini kwa %18,14, %27,22 na %23,53 ikilinganishwa na SA, ACO na GA mtawalia. Kulingana na tafsiri ya waandishi, sehemu kubwa ya uboreshaji mkuu hutokea katika takribani iterations 500 za kwanza, na kati ya iterations 800–1000 curve huwa tambarare kwa kiasi kikubwa.
Gharama ya kukokotoa
Chanzo huonyesha time complexity ya jumla ya TS-PSO kama:
\[ O(G\times N\times S) \]
ambapo katika muktadha huu \(G\) inawakilisha idadi ya juu ya iterations, \(N\) population ya chembe na \(S\) kiwango cha tatizo. Kwa sababu \(G\) katika uwasilishaji huu wa complexity ni herufi ileile inayotumiwa kwa maana tofauti kama “idadi ya vikundi vya kazi” katika maelezo ya seti ya data ya MS-FJSP, lazima isomwe kulingana na muktadha.
Muda wa majaribio uliongezeka katika mbinu zote kadiri kiwango cha tatizo kilivyoongezeka. Chanzo kinaripoti ongezeko la muda wa kukokotoa kutoka kiwango kidogo hadi kikubwa kuwa %42,32 kwa TS-PSO, %44,28 kwa GA, %43,53 kwa ACO na %39,17 kwa SA. Ingawa TS-PSO ilitumia muda mrefu kidogo kuliko washindani wake katika baadhi ya viwango, muda ulibaki katika kiwango kilekile cha ukubwa. Kwa hiyo, matokeo ya chanzo yanaelekea zaidi kuonyesha kuwa objective function ya chini na convergence yenye nguvu zaidi zilipatikana kwa gharama ya muda wa ziada, badala ya kudai kuwa ni “algoriti ya haraka zaidi”.
Utafiti wa ablation: mchango tofauti wa PSO na tabu search
Ili kuona kama faida ya TS-PSO inatokana na kipengele kimoja tu, watafiti walitumia variants mbili: w/o TS ni toleo lililoondoa tabu search, huku w/o PSO likiwa toleo lililoondoa PSO.
| \(M\) | \(G\) | \(J\) | TS-PSO | w/o TS | w/o PSO |
|---|---|---|---|---|---|
| 15 | 10 | 100 | 1090,26 | 1145,32 | 1102,18 |
| 15 | 25 | 500 | 3961,01 | 4032,78 | 3984,26 |
| 30 | 10 | 300 | 1462,69 | 1523,76 | 1476,29 |
| 30 | 25 | 500 | 4162,21 | 4258,73 | 4187,96 |
TS-PSO inayotumia vipengele vyote viwili kwa pamoja ilitoa thamani ya chini zaidi katika sampuli hizi zote. Ukweli kwamba hasara ya utendaji ni kubwa zaidi tabu search inapoondolewa kuliko PSO inapoondolewa ndio msingi wa waandishi wa chanzo kutafsiri tabu search yenye ujirani mbili kama kipengele muhimu cha uboreshaji wa mwisho wa ndani. PSO, kwa upande wake, huchangia kuongoza utafutaji kwa kuipa tabu search muundo bora zaidi wa awali/ujirani.
Upangaji wa wafanyakazi wa hospitali uligeuzwaje kuwa MS-FJSP?
Mfano wa mazingira halisi wa utafiti ni tatizo la upangaji la mwaka 2024 la kuwagawa wafanyakazi wapya walioajiriwa katika idara za First Bethune Hospital of Jilin University. Ulinganishaji wa modeli ni kama ifuatavyo:
| Kipengele cha tatizo halisi | Kinacholingana katika MS-FJSP |
|---|---|
| Idara za hospitali | Aina za mashine |
| Historia za kitaaluma za wafanyakazi | Vikundi vya kazi |
| Wafanyakazi | Kazi |
| Idara zinazolingana na historia fulani ya kitaaluma | Chaguo za mashine zinazofaa |
Chanzo hufafanua mfano huu wa tatizo kama \(M=72\), \(G=26\), \(J=491\) na \(\bar M=13\), na hutoa nafasi ya suluhisho kama \(1\times10^{5194}\).
| Iteration | Metric | TS-PSO | SA | ACO | GA |
|---|---|---|---|---|---|
| 100 | Var | 2010,08 | 2052,12 | 2114,98 | 2087,49 |
| 100 | Gap | — | %2,09 | %5,22 | %3,85 |
| 100 | Muda (s) | 853,12 | 846,24 | 847,12 | 846,49 |
| 1000 | Var | 1215,27 | 1426,53 | 1758,21 | 1533,29 |
| 1000 | Gap | — | %17,38 | %44,67 | %26,17 |
| 1000 | Muda (s) | 8937,41 | 8695,87 | 8818,43 | 8734,25 |
Katika iterations 100, TS-PSO ilizalisha objective values zilizo chini kwa kiwango kidogo tu kuliko mbinu nyingine, lakini katika iterations 1000 tofauti iliongezeka wazi. Kwa upande mwingine, muda wa kukokotoa wa TS-PSO pia ulikuwa juu kidogo. Kulingana na tathmini ya chanzo, matokeo haya yanaonyesha kuwa katika nafasi kubwa sana ya suluhisho, faida ya utafutaji wa ndani wenye ujirani mbili huongezeka unapopewa iterations zaidi.
Matokeo yanayoungwa mkono na utafiti
Utafiti unaunga mkono kuwa, chini ya modeli ya kihisabati ya MS-FJSP iliyofafanuliwa, TS-PSO ilipata thamani za chini za variance ya mahitaji ya mashine kuliko SA, ACO na GA katika sampuli 12.000 za benchmark zilizoundwa na watafiti. Matokeo ya ablation yanaonyesha kuwa kutumia PSO na tabu search kwa pamoja hutoa matokeo bora kuliko variants zenye kipengele kimoja. Mfano ulioundwa kutoka data ya hospitali pia unaonyesha kuwa MS-FJSP inaweza kubadilishwa kihisabati kwa matatizo changamano ya ugawaji wa rasilimali nje ya uzalishaji.
Matokeo yasiyoungwa mkono na utafiti
Utafiti huu hauthibitishi kuwa TS-PSO inahakikisha global optimum katika sampuli zote za FJSP/MS-FJSP. Matokeo ya benchmark yanategemea utaratibu wa kutengeneza tatizo, masafa ya vigezo, mbinu za ulinganisho na hali za hardware zilizochunguzwa. Mfano wa hospitali ni mfano wa optimization uliomodelishwa kutoka data halisi; utekelezaji wa ratiba iliyopendekezwa katika operesheni halisi ya hospitali na upimaji wa matokeo ya kliniki, rasilimali watu au operesheni ya muda mrefu si sehemu ya muundo wa majaribio wa utafiti huu.
Zaidi ya hayo, modeli haizingatii katika formulation yake kuu muda wa setup, muda wa usafirishaji, interruptions, akiba ndogo ya mashine halisi na uwezekano wa njia tofauti kubadilisha muda wa uchakataji. Kwa hiyo, ikiwa mbinu itatumika katika mfumo mwingine wa uzalishaji au mazingira ya upangaji wa taasisi, vizuizi vya mchakato wa eneo lazima viongezwe kwenye modeli kando na utendaji uthibitishwe tena.
Equation (23) katika chanzo, namna ya kutaja masharti ya ujirani ya DNTS na baadhi ya chaguo za variables katika Algorithm 1 vinapaswa kuchunguzwa kando katika utekelezaji wa kurudia unaolenga matumizi. Hoja hizi hazipaswi kutathminiwa kama hukumu zinazobatilisha matokeo ya utafiti kiotomatiki, bali kama maelezo ya reproducibility yanayohitaji uangalifu katika uwasilishaji uliochapishwa wa chanzo.
Maelezo ya Chanzo na Mbinu
Utafiti asili: Iterated Tabu Search Enhanced Particle Swarm Optimization for the Multi-Stage Flexible Job Shop Scheduling Problem
Waandishi: Chunyang Jiang; Hengyu Song; Baotong Ma; Shiwen Wang; Chulei Zhang; Peng Zhao; You Zhou.
Waandishi wanaowajibika: Chunyang Jiang na You Zhou.
Taasisi: College of Computer Science and Technology, Jilin University; School of Artificial Intelligence, Jilin University; The First Hospital of Jilin University; Key Laboratory of Symbolic Computation and Knowledge Engineering of Ministry of Education, Jilin University, China.
Jarida: AI.
Mchapishaji: MDPI.
Taarifa ya uchapishaji: 2026, juzuu 7, toleo 5, makala 165.
Tarehe ya uchapishaji: 9 May 2026. Chanzo kinaonyesha kuwasilishwa tarehe 1 April 2026, marekebisho 23 April 2026 na kukubaliwa 24 April 2026.
DOI: 10.3390/ai7050165
Aina ya chanzo na peer review: Makala ya utafiti iliyochapishwa katika jarida la kisayansi lililopitiwa na wataalamu.
Leseni: Creative Commons Attribution 4.0 International (CC BY 4.0). Hakimiliki inabaki kwa waandishi, huku MDPI ikitajwa kama mwenye leseni/mchapishaji.
Ufadhili: Jilin Provincial Department of Science and Technology Project, Grant 20230201083GX.
Upatikanaji wa data: Waandishi wanaeleza kuwa data iliyotengenezwa au kuchambuliwa katika utafiti imo katika makala na kwamba hakuna data ya ziada ya nje inayohitajika.
Mgongano wa maslahi: Waandishi wameripoti kuwa hakuna mgongano wa maslahi.
Taarifa za maadili: Sehemu za Institutional Review Board na informed consent zimeonyeshwa katika chanzo kama “not applicable”.
Michango ya waandishi: Uundaji wa dhana Chunyang Jiang na Peng Zhao; metodolojia Chunyang Jiang; programu Chunyang Jiang na Peng Zhao; uthibitishaji, uchambuzi rasmi, uchunguzi na rasilimali Chunyang Jiang; usimamizi wa data Chunyang Jiang na Hengyu Song; rasimu ya kwanza Chunyang Jiang; mapitio na uhariri Chunyang Jiang; uonyeshaji Chunyang Jiang na Shiwen Wang; usimamizi Chunyang Jiang na Baotong Ma; usimamizi wa mradi Chunyang Jiang na Chulei Zhang; upatikanaji wa ufadhili ulifanywa na Chunyang Jiang na You Zhou.
Dokezo la mbinu la Verianla: Maudhui haya si tafsiri ya sentensi kwa sentensi wala uandishi upya wa aya kwa aya wa makala ya chanzo. Modeli ya kihisabati, hatua za mbinu, vigezo vya majaribio, matokeo ya nambari, ujumbe wa kisayansi wa vielelezo na mipaka ya utafiti zimetolewa kutoka katika utafiti wa chanzo; maelezo yamejengwa upya katika muundo huru wa kufundishia kwa Verianla. Picha za skrini za vielelezo vya chanzo au mpangilio wa asili wa michoro haukutumiwa.
Kikomo cha tafsiri: TS-PSO ni mbinu ya metaheuristic optimization. Objective values bora zaidi zilizoripotiwa na utafiti ni ushahidi wa utendaji wa kihesabu kwa benchmark zilizochunguzwa na mfano wa mazingira halisi uliomodelishwa; si dhamana ya global optimum iliyothibitishwa kihisabati katika sampuli zote za tatizo. Baadhi ya uwasilishaji wa formula/pseudocode katika chanzo unaweza kuhitaji kufafanuliwa katika utekelezaji huru wa kurudia.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *