

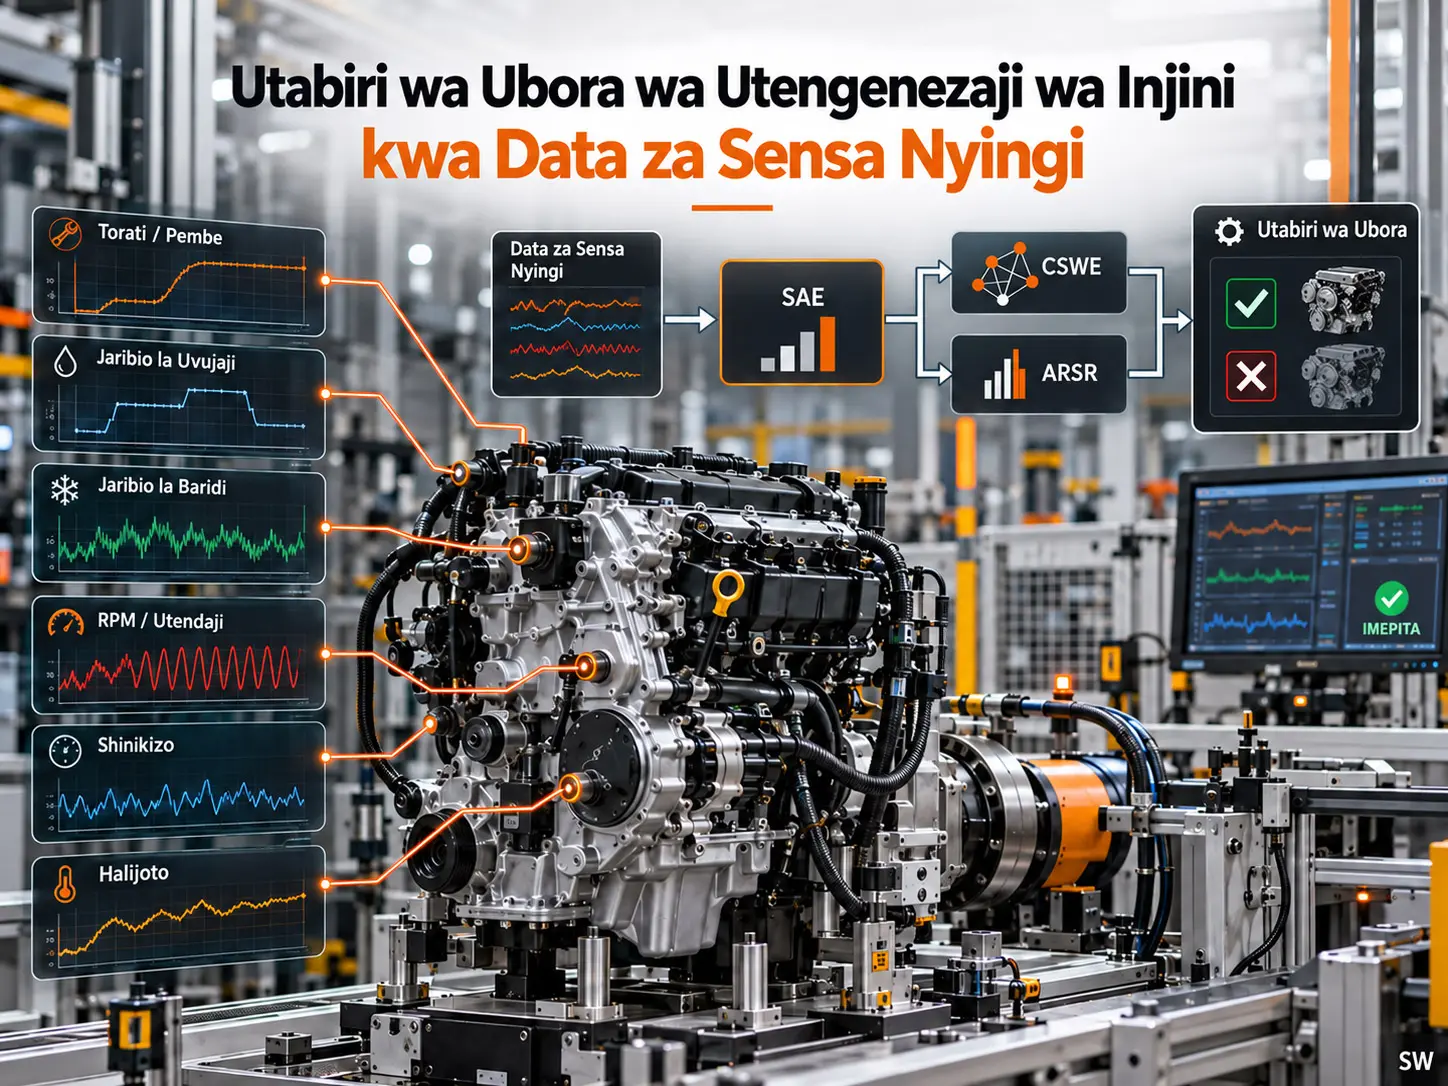
Mfumo wa utabiri wa ubora wa utengenezaji wa injini uliopendekezwa katika utafiti ni mfumo jumuishi wa ujifunzaji wa mashine unaoweza kufanya kazi kwenye vifaa vya edge, ulioundwa kwa ajili ya kuainisha injini zenye kasoro na kutabiri kwa kuendelea utendaji wa injini kwa kuchakata zaidi ya vigezo 12.000 vinavyotoka kwenye sensa mbalimbali za uzalishaji. Muundo huu hutumia vipengele vitatu vya msingi: Sparse Autoencoder (SAE) inayobana data za sensa zenye vipimo vingi na kelele, Class-Specific Weighted Ensemble (CSWE) inayolenga kutambua kwa ufanisi zaidi idadi ndogo ya sampuli zenye kasoro, na Adaptive Regime-Switching Regression (ARSR) inayotumia wataalamu tofauti wa regresha kwa hali tofauti za uendeshaji wa injini. Mfumo ulitathminiwa kwenye seti tatu za data za umma na katika laini halisi ya kuunganisha injini ya H4. Katika matumizi ya viwandani, Recall ya kugundua kasoro iliongezeka kutoka %69,20 hadi %76,92, ucheleweshaji wa wastani wa inference ulikuwa 80 ± 3 ms, na katika kipindi cha majaribio cha miezi mitatu iliripotiwa kupungua kwa %7,2 kwa kiwango cha ukarabati/urekebishaji upya wa injini. Hata hivyo, Recall ya %76,92 iko chini ya lengo la >%95 ambalo waandishi walilitaja kuwa bora kwa uhakikisho wa ubora; aidha, data za sensa za jedwali za modali moja haziwezi kunasa kikamilifu hitilafu ndogo za kimuundo.
Tatizo kuu la kihandisi katika utafiti ni kwamba data za sensa katika laini za kuunganisha injini za magari si nyingi kwa ujazo pekee, bali pia ni tofauti kifizikia. Vipimo kama torati, pembe ya mzunguko, kasi ya mzunguko wa injini, halijoto, shinikizo na uvujaji hupimwa katika mizani tofauti; sensa zinaweza kuwa na mwingiliano wa sumakuumeme, data zinazokosekana, uhusiano mkubwa na mabadiliko ya kitakwimu yanayotegemea awamu za uendeshaji. Zaidi ya hayo, idadi ya injini zenye kasoro ni ndogo sana ikilinganishwa na injini za kawaida. Hali hizi zinaweza kutoa modeli zenye usahihi wa jumla wa juu lakini zikakosa sehemu muhimu ya kasoro halisi.
Badala ya kutatua matatizo haya kwa modeli moja nzito ya ujifunzaji wa kina, utafiti unatenganisha majukumu. Katika hatua ya kwanza, SAE hutengeneza nafasi ya pamoja ya sifa fiche. Kisha katika kazi ya uainishaji, CSWE hutumia upigaji kura wenye uzani kulingana na umahiri wa kila kiainishaji msingi katika madarasa maalumu ya kasoro. Katika kazi ya regresha, ARSR hutumia wataalamu wa ndani wanaofaa kwa hali tofauti za uendeshaji badala ya kazi moja ya regresha ya kimataifa. Katika benchmark za umma, hali hutambuliwa kwa K-Means kwenye sifa fiche za SAE, huku katika toleo la edge la laini halisi ya uzalishaji, hali za Start-up, High-speed na Idle zikielekezwa moja kwa moja kwa mipaka ya RPM ili kupunguza gharama ya ukokotoaji.
Kwa nini ni vigumu kutabiri ubora wa utengenezaji wa injini?
Katika laini ya kisasa ya kuunganisha injini, taarifa za ubora hazitoki kwenye sensa moja. Katika vituo tofauti vya uzalishaji huzalishwa maelfu ya vigezo kama torati ya kukaza bolti, pembe ya mzunguko, mapengo ya kijiometri, uthabiti wa kuziba, shinikizo, mtiririko, kasi ya mzunguko wa injini, halijoto na vigezo vya ECU. Hifadhidata ya viwandani katika utafiti wa chanzo ilipangwa katika maeneo matatu makuu ya data za kimwili yanayofunika vituo vya uzalishaji kutoka OP10 hadi OP130: data za mchakato, data za ubora na data za utendaji.
| Eneo la data | Kategoria | Idadi ya vigezo | Mfano wa maudhui ya kimwili |
|---|---|---|---|
| Data za mchakato | Data za msingi | 54 | Mapengo ya fani za connecting rod, usawa, kina, mapengo ya camshaft |
| Data za mchakato | Data za torati ya kukaza | 11.381 | Torati ya mwisho, pembe ya mzunguko, uwiano wa torati/pembe |
| Data za mchakato | Data za matumizi ya scaling | 261 | Upana/ofseti kwa lower block, spark plug, front cover na oil pan |
| Data za ubora | Cold test | 1027 | Ishara za cold test fupi na ndefu |
| Data za ubora | Leak test | 150 | Matokeo ya leak test |
| Data za utendaji | Vigezo vya utendaji | 29 | Mzunguko, halijoto, shinikizo na vigezo vya ECU |
Ishara za kimekanika katika vituo vya kukaza zilirekodiwa kwa masafa ya sampuli ya 5 Hz. Data kutoka benchi la utendaji la EOL hujumuisha vigezo kama kasi ya mzunguko na torati vinavyowakilisha hali ya kiutendaji ya injini. Engine ID ndiyo ufunguo mkuu unaounganisha rekodi zote kutoka vituo tofauti na injini hiyo hiyo ya kimwili.
Mfululizo wa muda wa data ulijengwaje upya?
Rekodi ghafi zilipangwa kwa muundo wa Engine ID → Category/Workstation → Inspection Time. Kwa njia hii, vipimo vya sensa kutoka vituo tofauti vya uzalishaji vya injini hiyo hiyo vilibadilishwa kuwa mfuatano wa kihistoria wa kuunganisha.
Lebo za Pass/Fail katika uainishaji wa kasoro na malengo ya RPM/Torque yaliyotumika kwa regresha yalichukuliwa kutoka benchi la majaribio la EOL lililoidhinishwa. Baadhi ya sampuli zilizo karibu na mpaka wa uamuzi pia zilipitiwa upya kwa mkono na wahandisi waandamizi wa ubora.
Data zinazokosekana na zenye kelele zilichakatwaje?
Uchakataji wa awali ulihusisha operesheni nne kwa wakati mmoja:
- Kuondoa thamani zilizopotoka,
- Kujaza thamani zinazokosekana kwa interpolishaji ya namba,
- Kupunguza kelele kwa vichujio vya kulainisha,
- Kusawazisha mizani ya kimwili.
Wakati uwiano wa data zinazokosekana katika chaneli ya sensa au sampuli ulipozidi %30, data husika ziliondolewa. Kizingiti hiki hakikuachwa tu kama kichujio cha kimaabara, bali kilijadiliwa pia kwa msingi wa kimwili ndani ya utafiti. Kwa sampuli ya 5 Hz, pointi zinazofuatana ziko takribani 0,2 s kutoka moja hadi nyingine. Upotevu wa zaidi ya %30 unaweza kuunda maeneo yasiyoonekana ya takribani 0,8-1,0 s katika baadhi ya madirisha ya uendeshaji. Kwa kuzingatia kwamba mabadiliko muhimu ya kimekanika yanaweza kutokea katika madirisha mafupi ya takribani 1,5-2,0 s, upotevu kama huu unaweza kufuta alama halisi ya mienendo.
Waandishi wanaeleza kwamba kizingiti kikifanywa kikali zaidi, kwa mfano <%10, zaidi ya %40 ya sampuli zilizokusanywa katika mazingira magumu ya viwandani zinaweza kutupwa. Uchujaji wa aina hii haupunguzi tu ukubwa wa data za mafunzo, bali unaweza pia kufanya modeli ionyeshwe tu hali bora za sensa na ishindwe kujifunza sampuli zenye kasoro na kelele zinazopatikana katika uzalishaji halisi.
Sparse Autoencoder Inafanya Kazi Gani Katika Utafiti Huu?
Sparse Autoencoder (SAE) ni kipengele kisicho cha mstari cha uchimbaji wa sifa kinachotumiwa kubana data za sensa zenye zaidi ya vigezo 12.000 na mizani tofauti kuwa uwakilishi fiche wa vipimo vichache, huku kikipunguza kelele za sensa zisizo endelevu au zisizobeba taarifa kupitia adhabu ya sparsity.
PCA Whitening na usanifishaji
Kwa kuwa katika data za sensa za viwandani kunaweza kuwa na multicollinearity kubwa kati ya vigezo kama torati na shinikizo, utafiti ulitumia PCA Whitening kwa data za viwandani:
\[ X_{\mathrm{white}}=(X-\mu)U(\Lambda+\epsilon I)^{-1/2} \]
Hapa \(X\) ni matriki ya ingizo, \(\mu\) ni wastani uliokokotolewa kutoka data za mafunzo, \(U\) ni matriki ya eigenvectors, \(\Lambda\) ni matriki ya eigenvalues, \(I\) ni matriki ya utambulisho, na \(\epsilon\) ni neno la uthabiti wa namba. Mabadiliko haya yanalenga kutenganisha muundo wa korrelasheni huku yakisawazisha tofauti za vigezo.
Kwa data za benchmark zenye vipimo vya chini zaidi kama AI4I, SECOM na C-MAPSS, Z-Score au Min-Max scaling ilitumika kulingana na muundo wa data. Hatua muhimu zaidi ya kuzuia data leakage ilikuwa kujifunza takwimu za usanifishaji na uzani za SAE kwa kutumia tu data za mafunzo zisizo na lebo; kisha kutumia mabadiliko hayo hayo yaliyogandishwa kwa sampuli za uthibitishaji na majaribio.
Kazi ya upotevu ya SAE
Kazi jumuishi ya lengo la SAE iliyotolewa katika chanzo ni:
\[ J_{\mathrm{sparse}}(W,b) = \frac{1}{m}\sum_{i=1}^{m} \frac{1}{2} \left\| h_{W,b}(x^{(i)})-x^{(i)} \right\|^2 + \frac{\lambda}{2} \sum_{l=1}^{2} \left\| W^{(l)} \right\|_F^2 + \beta \sum_{j=1}^{s} KL(\rho\|\hat{\rho}_j) \]
Neno la kwanza ni kosa la kujenga upya ishara ya ingizo na linalenga kuhifadhi taarifa ya msingi. Neno la pili ni adhabu ya uzani ya L2 iliyowekewa uzito wa \(\lambda\) na huzuia ugumu wa modeli. Neno la tatu ni adhabu ya sparsity iliyowekewa uzito wa \(\beta\). \(KL(\rho\|\hat{\rho}_j)\) husogeza shughuli ya wastani ya kitengo fiche \(\hat{\rho}_j\) kuelekea shughuli ya chini inayolengwa \(\rho\).
Muundo huu unawezesha SAE si kupunguza vipimo pekee, bali pia kukandamiza sifa fiche ambazo hazifanyi kazi mara kwa mara au hazibebi taarifa. Utafiti ulioptimiza vigezo vya mtandao kwa kutumia algoritimu ya L-BFGS (Limited-memory Broyden-Fletcher-Goldfarb-Shanno).
Noise-Aware Residual Fusion
Kwa sababu ubano wa kina unaweza pia kupoteza sehemu ya maelezo halisi ya kimwili yenye masafa ya juu, chanzo kilitumia muunganisho wa mabaki wa ishara ghafi wenye masharti:
\[ X_{\mathrm{hybrid}}= \operatorname{Concat} (\gamma X_{\mathrm{std}},X_{\mathrm{sae}}) \]
\(\gamma\in\{0,1\}\) huchagua hali mbili za uendeshaji.
- Mode I, \(\gamma=0\): Katika data za viwandani zenye vipimo vingi sana na kelele, sifa fiche za SAE pekee hutumika. Lengo ni kupunguza vipimo na kelele kadiri iwezekanavyo.
- Mode II, \(\gamma=1\): Katika data za benchmark zenye vipimo vichache na zilizo safi zaidi, sifa ghafi zilizosanifishwa na sifa za SAE hutumika pamoja.
Chanzo kinahusisha uamuzi huu na athari ya pamoja ya uwiano wa ishara-kwa-kelele na ukubwa wa ingizo. Kwa kuwa katika mfumo wa viwandani \(N_{in}\) iko takribani 10.000 au zaidi, edge deployment halisi iliendeshwa katika hali ya \(\gamma=0\).
Kutenganisha hali za uendeshaji wa injini
Mzunguko wa majaribio ya EOL wa injini uligawanywa katika hali tatu za kimwili:
- Start-up Phase (SUP): kuongeza kasi kwa haraka na karibu kwa mstari,
- High-Speed Phase (HSP): mienendo ya masafa ya juu na isiyo ya mstari zaidi,
- Idle Phase (IP): uendeshaji thabiti wa amplitudo ndogo.
Maeneo ya mpito kati ya awamu hizi yaliondolewa katika tathmini ili kuzuia kelele kubwa za mpito zinazozalishwa kwa pamoja na benchi la majaribio na injini kuharibu alama ya ubora. Kielelezo 5 katika ukurasa wa 11 wa chanzo kinaonyesha wazi profaili endelevu ya kasi ya mzunguko na mipaka ya SUP-HSP-IP.
Kwa Nini ARSR Hutumia Wataalamu Wengi Badala ya Modeli Moja ya Regresha?
Adaptive Regime-Switching Regression (ARSR) imeundwa kuchagua mtaalamu wa regresha wa ndani mwenye kosa la chini zaidi la uthibitishaji kwa kila hali, badala ya kulazimisha hali za injini zenye miundo tofauti ya kitakwimu kama Start-up, High-speed na Idle kutoshea kwenye kazi moja ya regresha ya kimataifa.
Muundo wa jumla wa ARSR
Katika benchmark za umma, ARSR hutumia K-Means katika nafasi fiche ya SAE kugundua hali bila lebo:
\[ \mathcal{R}=\{C_1,C_2,\ldots,C_K\} \]
Kwa kila kundi, huundwa bwawa la wataalamu kutoka modeli zenye upendeleo tofauti wa kiinduktivu kama LR, SVR, XGBoost na GBR. Modeli inayochaguliwa kwa hali \(C_k\) ni:
\[ f_k^* = \operatorname*{arg\,min}_{f\in\mathcal{H}_{pool}} L_{val}(f,D_{C_k}) \]
Kwa hiyo jina la algoritimu halijawekwa mapema; modeli yoyote miongoni mwa wagombea inayopunguza zaidi kosa la uthibitishaji katika hali husika ndiyo hutumika kama mtaalamu.
Kwa nini K-Means haikutumika katika kiwanda halisi?
Katika toleo la edge kwenye laini ya uzalishaji, ugunduzi wa hali wa ARSR unaotegemea K-Means ulibadilishwa kwa makusudi. Kwa kuwa awamu za Start-up, High-speed na Idle zinaweza tayari kufafanuliwa kwa njia deterministi kwa kutumia mipaka ya kimwili ya RPM, mfumo halisi ulitumia uelekezaji huu wa kudumu unaotegemea fizikia badala ya K-Means. Lengo lilikuwa kuondoa gharama ya clustering mtandaoni, kufanya ugawaji wa hali uweze kurudiwa kikamilifu na kubaki ndani ya kikomo cha muda wa Takt cha 100 ms.
Kwa hiyo, mipangilio miwili ya ARSR katika utafiti inapaswa kutofautishwa: muundo wa benchmark/jumla hutumia K-Means routing isiyo na lebo, huku deployment ya laini halisi ya kuunganisha ikitumia hard-switching inayotegemea mipaka ya RPM.
CSWE Inajaribuje Kugundua Kasoro Adimu za Injini?
Class-Specific Weighted Ensemble (CSWE), badala ya kumpa kila kiainishaji uzani mmoja wa kimataifa kwa madarasa yote ya kasoro, hutumia utendaji wa uthibitishaji wa F1 wa modeli kama SVM, KNN, Gaussian Naive Bayes na Bagging katika kila darasa la kasoro kama uzani tofauti wa umahiri; kwa njia hii inalenga kulinda kasoro adimu dhidi ya kutawaliwa na darasa la wengi.
Matriki ya umahiri maalumu kwa darasa
Kwa viainishaji \(m\) na madarasa \(n\) ya kasoro lengwa, matriki ya umahiri hufafanuliwa kama:
\[ W= \begin{bmatrix} w_{1,1} & w_{1,2} & \cdots & w_{1,n}\\ w_{2,1} & w_{2,2} & \cdots & w_{2,n}\\ \vdots & \vdots & \ddots & \vdots\\ w_{m,1} & w_{m,2} & \cdots & w_{m,n} \end{bmatrix} \]
.
Katika chanzo, kila uzani umetolewa kwa msingi wa F1 ya uthibitishaji maalumu kwa darasa kama ifuatavyo:
\[ w_{j,k} = F1_{j,k} = \frac{2P_{j,k}R_{j,k}} {P_{j,k}+R_{j,k}} +\epsilon \]
Hapa \(P_{j,k}\) ni Precision ya kiainishaji \(j\) kwa darasa \(k\), huku \(R_{j,k}\) ikiwa Recall. Katika fomula ya chanzo, \(\epsilon\) imeonyeshwa kama neno la nyongeza la uthabiti wa namba.
Katika hatua ya uamuzi mtandaoni, matokeo ya jozi ya modeli za msingi huunda matriki \(V\in\{0,1\}^{m\times n}\). Alama ya jumla ya kila darasa huhesabiwa kama:
\[ S_k= \sum_{j=1}^{m} w_{j,k}v_{j,k} \]
.
Darasa la mwisho huamuliwa kwa:
\[ c^*= \operatorname*{arg\,max}_{k} S_k \]
. Hivyo kiainishaji msingi kilekile kinaweza kuwa na uzani mkubwa wa uamuzi kwa aina moja ya kasoro na uzani mdogo kwa aina nyingine.
Kwa nini metrika za tathmini zinalenga Recall?
Katika udhibiti wa ubora wa injini, False Negative, yaani kukubali injini yenye kasoro halisi kama nzuri, inaweza kuwa na gharama kubwa kuliko kufanya ukaguzi wa ziada kwa sababu ya False Positive. Kwa hiyo utafiti unasisitiza hasa Recall na F1 badala ya kutegemea Accuracy ya jumla.
\[ Accuracy=\frac{TP+TN}{TP+TN+FP+FN} \]
\[ Precision=\frac{TP}{TP+FP} \]
\[ Recall=\frac{TP}{TP+FN} \]
\[ F1= 2\frac{Precision\cdot Recall} {Precision+Recall} \]
Accuracy inaweza kupotosha katika seti ya data yenye madarasa yasiyosawiana. Kiwango cha kasoro kinapokuwa cha chini sana, modeli inayotaja karibu injini zote kuwa “kawaida” inaweza kupata Accuracy ya juu lakini ikakosa kasoro muhimu. Kwa hiyo Recall ni kiashiria cha moja kwa moja zaidi cha kugundua kasoro katika lango la ubora.
Mbinu na Matokeo ya Utafiti
Seti ya data ya viwandani
Data halisi za uzalishaji zilipatikana kutoka kwa modeli ya injini JL478QEA-AJ katika laini ya kuunganisha H4 ya mtengenezaji mkubwa wa magari. Data ziliunganishwa kupitia Engine Test Data Management Database kwa kutumia Engine ID kama ufunguo mkuu.
| Kazi | Sampuli isiyo na lebo | Sampuli yenye lebo | Awamu |
|---|---|---|---|
| ARSR | 2090 | 520 | SUP |
| ARSR | 2090 | 520 | HSP |
| ARSR | 2090 | 520 | IP |
| CSWE | 620 | 135 | SUP |
| CSWE | 620 | 135 | HSP |
| CSWE | 620 | 135 | IP |
Katika mgawanyo wa mafunzo na majaribio, upangaji mkali kwa nambari ya mfululizo wa injini ulitumika ili kuzuia sampuli kutoka injini ileile ya kimwili kuingia katika makundi yote mawili. Maelezo haya ni muhimu kwa sababu vipande vya data za sensa vinavyohusiana sana kutoka injini ileile vikiwa katika seti zote mbili za mafunzo na majaribio vingepandisha utendaji kwa njia bandia.
Seti za data za benchmark za umma
| Seti ya data | Kazi | Sampuli / sifa | Changamoto kuu |
|---|---|---|---|
| AI4I 2020 | Uainishaji na regresha | 10.000 sampuli, 14 sifa | Ukosefu mkubwa wa uwiano wa madarasa kwa kiwango cha takribani %3,4 cha hitilafu; utabiri wa uchakavu wa zana |
| UCI SECOM | Uainishaji | 3140 sampuli, 591 sifa | Vipimo vingi, kelele na data chache |
| NASA C-MAPSS FD002 | Regresha | 21 sifa | Hali sita tofauti za uendeshaji zisizo na lebo na utabiri wa Remaining Useful Life |
Lengo la benchmark hizi si kuiga matumizi yaleyale katika seti zote tatu za data. Kila moja huweka shinikizo kwa sehemu tofauti ya mfumo: ukosefu wa uwiano wa madarasa, kelele yenye vipimo vingi au hali fiche za uendeshaji.
Vifaa na programu
| Hatua | Vifaa / programu |
|---|---|
| Mafunzo ya modeli na majaribio ya benchmark | Intel Xeon Gold 6430 CPU; NVIDIA RTX 4090, 24 GB VRAM |
| Edge deployment ya laini halisi ya uzalishaji | line-side edge cluster inayotegemea Intel Xeon E5-2680 v4 |
| Programu | Python 3.8; PyTorch 2.0.0; Scikit-learn 1.0 |
| Global random seed | 42 |
Kazi za uainishaji na matokeo ya AI4I Tool Wear ziliripotiwa kwa wastani na mkengeuko sanifu wa utekelezaji 10 huru. Majaribio ya mfululizo wa muda ya NASA C-MAPSS yenye gharama zaidi yalitathminiwa kwa utekelezaji 5 huru.
Matokeo ya uainishaji: AI4I
| Modeli | Accuracy (%) | F1 (%) | Recall (%) | Precision (%) |
|---|---|---|---|---|
| SAE + CSWE | 98,80 ± 0,24 | 81,55 ± 3,51 | 77,94 ± 3,83 | 85,70 ± 4,89 |
| LightGBM | 98,81 ± 0,24 | 81,05 ± 4,63 | 75,29 ± 7,05 | 88,42 ± 4,20 |
| Bagging | 98,45 ± 0,28 | 75,51 ± 4,56 | 70,44 ± 5,71 | 81,77 ± 5,76 |
| Random Forest | 98,35 ± 0,30 | 75,13 ± 3,53 | 73,09 ± 5,92 | 78,25 ± 7,43 |
| CNN | 97,66 ± 0,40 | 65,47 ± 3,84 | 65,44 ± 10,15 | 67,78 ± 8,39 |
| Transformer | 97,62 ± 0,38 | 62,22 ± 4,34 | 57,50 ± 6,85 | 69,90 ± 10,65 |
| XGBoost | 98,28 ± 0,26 | 77,22 ± 3,46 | 85,74 ± 4,16 | 70,29 ± 3,38 |
| SVM | 97,19 ± 0,54 | 61,13 ± 2,63 | 64,71 ± 9,53 | 60,25 ± 8,83 |
| MLP | 98,49 ± 0,34 | 77,03 ± 4,26 | 74,12 ± 3,10 | 80,58 ± 7,74 |
SAE + CSWE ilitoa thamani ya juu zaidi ya F1. XGBoost ilitoa Recall ya juu zaidi, lakini Precision yake ya chini ilimaanisha tahadhari nyingi zaidi zisizo sahihi. Kwa hiyo madai ya utafiti si kuwa “bora katika kila metrika”, bali kutoa uwiano bora zaidi kati ya kugundua kasoro na tahadhari za uongo.
Matokeo ya uainishaji: UCI SECOM
| Modeli | Accuracy (%) | F1 (%) | Recall (%) | Precision (%) |
|---|---|---|---|---|
| SAE + CSWE | 85,54 ± 7,36 | 33,17 ± 6,29 | 49,05 ± 17,82 | 30,87 ± 16,01 |
| XGBoost | 87,55 ± 5,11 | 32,94 ± 3,36 | 45,24 ± 16,25 | 28,88 ± 6,66 |
| LightGBM | 86,53 ± 7,36 | 30,86 ± 5,85 | 40,95 ± 11,11 | 28,05 ± 10,87 |
| Random Forest | 87,45 ± 4,58 | 18,90 ± 11,83 | 27,62 ± 19,73 | 17,69 ± 10,94 |
| SVM | 91,66 ± 1,01 | 9,67 ± 6,31 | 6,67 ± 4,36 | 18,82 ± 12,52 |
| Transformer | 89,39 ± 1,47 | 14,78 ± 5,25 | 13,81 ± 5,41 | 16,67 ± 6,34 |
Matokeo ya SECOM yanaonyesha vizuri kwa nini Accuracy pekee haitoshi katika madarasa yasiyosawiana. Kwa mfano, Accuracy ya SVM ni %91,66 lakini Recall ni %6,67 tu. SAE + CSWE, licha ya Accuracy ya chini zaidi, ilinasa sehemu kubwa zaidi ya kasoro na kufikia Recall ya %49,05.
Metrika za regresha
Katika kazi za regresha, metrika tatu kuu zilitumika:
\[ MSE= \frac{1}{n} \sum_{i=1}^{n} (y_i-\hat{y}_i)^2 \]
\[ R^2= 1- \frac{\sum_i(y_i-\hat{y}_i)^2} {\sum_i(y_i-\bar{y})^2} \]
\[ MAPE= \frac{1}{n} \sum_{i=1}^{n} \left| \frac{y_i-\hat{y}_i}{y_i} \right| \]
MSE huadhibu zaidi makosa makubwa kwa kuyapandisha mraba. \(R^2\) huonyesha kiwango cha tofauti katika kigezo lengwa kinachoelezwa na modeli. MAPE hutoa kosa la asilimia lisilotegemea mizani; hata hivyo, linaweza kutokuwa thabiti kihisabati wakati thamani lengwa inakaribia sifuri. Tatizo hili la mwisho lilionekana moja kwa moja katika uchambuzi wa mkengeuko sanifu wa kasi ya mzunguko katika awamu ya Idle ya utafiti.
Regresha ya AI4I Tool Wear
| Modeli | MSE | \(R^2\) | MAPE (%) |
|---|---|---|---|
| SAE + ARSR | 2584,88 ± 62,40 | 0,9196 ± 0,0047 | 2,67 ± 0,02 |
| 1D-CNN | 2589,83 ± 65,09 | 0,9194 ± 0,0048 | 2,66 ± 0,03 |
| Transformer | 2648,32 ± 80,67 | 0,9176 ± 0,0045 | 2,66 ± 0,02 |
| XGBoost | 2735,70 ± 68,53 | 0,9149 ± 0,0043 | 2,72 ± 0,03 |
| SVR | 3651,86 ± 234,76 | 0,8866 ± 0,0070 | 2,81 ± 0,03 |
SAE + ARSR ilipata MSE ya chini zaidi na \(R^2\) ya juu zaidi, lakini kwa MAPE, CNN na Transformer zilitoa thamani takribani sawa au chini kidogo. Kwa hiyo matokeo hayapaswi kutafsiriwa kama ubora kamili katika metrika zote zilizotumika.
Regresha ya NASA C-MAPSS FD002
| Modeli | MSE | \(R^2\) | MAPE (%) |
|---|---|---|---|
| SAE + ARSR | 424,49 ± 36,03 | 0,7561 ± 0,0207 | 32,14 ± 1,03 |
| Bagging | 433,81 ± 34,72 | 0,7508 ± 0,0199 | 31,82 ± 1,16 |
| XGBoost | 434,01 ± 32,28 | 0,7507 ± 0,0185 | 31,70 ± 1,01 |
| LightGBM | 435,13 ± 32,30 | 0,7500 ± 0,0185 | 32,01 ± 1,02 |
| 1D-CNN | 484,69 ± 41,63 | 0,7216 ± 0,0239 | 41,31 ± 3,48 |
| Transformer | 970,55 ± 131,33 | 0,4425 ± 0,0754 | 114,26 ± 23,29 |
ARSR ilitoa MSE ya chini zaidi na \(R^2\) ya juu zaidi katika FD002. Hata hivyo, XGBoost na Bagging zilitoa MAPE ya chini zaidi. Matokeo haya pia yanaonyesha kwamba utendaji wa modeli unapaswa kutathminiwa kulingana na metrika ya kosa inayotumika.
Majaribio ya ablation yalionyesha nini kuhusu jukumu la SAE na mgawanyo wa hali?
| Toleo | SECOM F1 (%) | SECOM Recall (%) | NASA FD002 MSE |
|---|---|---|---|
| Modeli kamili | 33,17 ± 6,29 | 49,05 ± 17,82 | 424,49 ± 36,03 |
| Bila sparsity - AE ya kawaida | 23,94 ± 2,75 | 40,00 ± 21,63 | 485,99 ± 39,20 |
| Bila SAE - sifa ghafi | 32,38 ± 4,48 | 40,48 ± 9,82 | 452,24 ± 35,74 |
| Bila mgawanyo wa hali - modeli ya kimataifa | 29,23 ± 6,13 | 43,33 ± 14,67 | 474,45 ± 38,80 |
Kuondoa adhabu ya sparsity kulipunguza F1 ya SECOM kutoka %33,17 hadi %23,94. Kutumia sensa ghafi zilizosanifishwa moja kwa moja kuliongeza Accuracy lakini kulipunguza Recall kutoka %49,05 hadi %40,48. Chanzo kinaeleza hili kwa kusema kwamba kelele ghafi zenye vipimo vingi husababisha mwelekeo kuelekea darasa la wengi.
Katika NASA FD002, kuondoa mgawanyo wa hali kuliongeza MSE kutoka 424,49 hadi 474,45. Matokeo haya yanaunga mkono kwamba kulazimisha hali sita tofauti za uendeshaji kwenye kazi moja ya regresha ya kimataifa huleta kosa na kwamba mkakati wa wataalamu wa ndani ni muhimu katika michakato yenye hali nyingi.
Uainishaji wa kasoro katika laini halisi ya H4
| Metrika | Bagging | CSWE |
|---|---|---|
| Precision | 80,00% | 81,63% |
| Recall | 69,20% | 76,92% |
| F1 | 74,21% | 79,21% |
Ongezeko kamili la Recall ni pointi 7,72 za asilimia. Chanzo kinafupisha matokeo haya kama “uboreshaji wa %7,72 katika Recall ya kugundua kasoro”. Hata hivyo, thamani ya %76,92 iko chini kwa wazi ya kiwango cha >%95 kinachochukuliwa katika mjadala wa utafiti kuwa bora kwa uhakikisho wa ubora.
Utabiri endelevu wa utendaji wa injini kwenye laini halisi
Lengo la regresha si kasi ya mzunguko wa injini inayodaiwa na dereva. Kinachotabiriwa ni mwitikio wa kiutendaji unaotarajiwa wa injini chini ya itifaki ya mzigo usiobadilika kwenye benchi la majaribio. Modeli huunda msingi wa “tabia ya kawaida” kwa wastani wa kasi ya mzunguko na mkengeuko sanifu wa kasi hiyo. Mikengeuko kutoka msingi huu hutumika kama viashiria vya ziada vinavyoweza kuashiria matatizo madogo zaidi kama hitilafu ya msuguano au tatizo la kalibresheni ya ECU.
Kwa wastani wa kasi ya mzunguko wa injini, ARSR ilichagua:
- Linear Regression katika awamu ya Start-up,
- SVR katika awamu ya High-speed,
- SVR katika awamu ya Idle
na mlolongo wa wataalamu wa L-S-S ulitoa jumla ya %2,276 MAPE. Kwa LR pekee MAPE iliripotiwa kuwa %2,646, na kwa SVR pekee %2,350.
Katika kutabiri mkengeuko sanifu wa kasi ya mzunguko wa injini, mchanganyiko wa wataalamu wa SVR-GPR-Bagging ulitumika na MAPE ya jumla ilikuwa %39,00. Thamani hii inaonekana kubwa; hata hivyo, hasa katika awamu ya Idle mkengeuko sanifu halisi huwa karibu sana na sifuri, hivyo denominator ya MAPE huwa ndogo sana. Chanzo kinaeleza kwamba makosa madogo ya kabisa yanaweza kwa sababu hii kubadilika kuwa makosa makubwa sana ya asilimia.
Iliripotiwa kwamba kosa la utabiri la kabisa katika awamu ya Idle lilibaki ndani ya uvumilivu wa viwandani wa ±10 RPM. Kwa hiyo, ilikubaliwa kwamba matumizi ya MAPE pekee kama kiashiria cha utendaji wa kimwili katika hali hii yana mipaka.
Edge Deployment Katika Utafiti Huu Ni ya Haraka na yenye Mafanikio kwa Kiwango Gani?
Toleo la edge lililotumika katika laini halisi ya kuunganisha injini ya H4 lilifanya kazi ndani ya kikomo cha muda wa Takt cha 100 ms, likiwa na ucheleweshaji wa wastani wa inference wa 80 ± 3 ms, na katika kipindi cha majaribio cha miezi mitatu iliripotiwa kupungua kwa %7,2 kwa kiwango cha ukarabati/urekebishaji upya wa injini; hata hivyo, kwa kuwa chanzo hakikutenganisha uboreshaji huu wa kiutendaji kwa jaribio sambamba la udhibiti wa kisababishi, thamani ya %7,2 inapaswa kutafsiriwa kama matokeo ya uwanjani yaliyoonekana.
Maamuzi mawili ya msingi ya uboreshaji wa edge
Uboreshaji wa kwanza: Badala ya K-Means routing mtandaoni, hali ya injini iliamuliwa moja kwa moja kwa mipaka ya RPM. Hivyo ukokotoaji wa ugawaji wa cluster uliondolewa.
Uboreshaji wa pili: Kwa kutumia \(\gamma=0\), ni sifa fiche zilizobanwa na SAE pekee ndizo zilipelekwa kwenye modeli ya downstream. Hivyo kuepukwa kubeba na kukokotoa zaidi ya sifa ghafi 10.000 kwenye prosesa ya edge.
Mpangilio huu ulitoa muda wa wastani wa inference wa 80 ± 3 ms kwenye vifaa vya line-side edge vinavyotegemea Intel Xeon E5-2680 v4. Utafiti unalinganisha hili na kikomo cha muda wa Takt cha 100 ms.
Matokeo ya uzalishaji wa majaribio ya miezi mitatu
Waandishi waliripoti kupungua kwa %7,2 kwa kiwango cha ukarabati/urekebishaji upya wa injini baada ya majaribio ya miezi mitatu. Hili ni muhimu kwa sababu linaonyesha kwamba mbinu haikuendeshwa tu kwenye seti za data za benchmark bali pia katika mtiririko halisi wa kazi wa uzalishaji.
Hata hivyo, chanzo hakiripoti laini tofauti ya udhibiti, ulinganisho uliorandomishwa au muundo wa athari ya kisababishi unaotenganisha kitakwimu mabadiliko mengine katika mchakato wa uzalishaji. Kwa hiyo, thamani ya %7,2 ni kiashiria cha utendaji kilichoonekana moja kwa moja katika kipindi cha majaribio; haipaswi kupanuliwa kuwa athari sahihi ya kisababishi iliyosababishwa na algoritimu pekee.
Matriki za mkanganyiko zinaonyesha nini?
Kielelezo 12 katika ukurasa wa 21 wa chanzo kinaonyesha matriki za mkanganyiko zilizokusanywa kutoka utekelezaji 10 huru kwenye UCI SECOM. LightGBM iligundua kasoro halisi 86, Bagging 76 na XGBoost 95. XGBoost pia ilitoa tahadhari zisizo sahihi 234. CSWE iliyopendekezwa iligundua kasoro halisi 103 huku ikitoa False Positive 231.
Ujumbe mkuu wa ulinganisho huu si tu kwamba CSWE huongeza Recall, bali kwamba hujaribu kuweka idadi ya tahadhari zisizo sahihi chini ya udhibiti wakati Recall inaongezeka.
Matokeo yanayoungwa mkono na utafiti
- Muundo wa sparsity wa SAE ulitoa mchango unaoweza kupimika kwa uainishaji wa kasoro katika data za sensa zenye vipimo vingi na kelele.
- Uzani maalumu kwa darasa uliweza kuboresha Recall na F1 katika madarasa ya kasoro yasiyosawiana.
- Uchaguzi wa mtaalamu kulingana na hali za uendeshaji uliweza kupunguza kosa ikilinganishwa na modeli moja ya kimataifa katika kazi za regresha zenye hali nyingi.
- Muundo uliopendekezwa uliweza kufanya kazi ndani ya kikomo cha 100 ms kwenye vifaa vya edge vinavyotegemea CPU katika laini halisi ya uzalishaji wa injini ya H4.
- Katika majaribio ya miezi mitatu ya uzalishaji halisi, kupungua kwa %7,2 kwa kiwango cha ukarabati/urekebishaji upya kuliripotiwa.
Matokeo ambayo utafiti hauungi mkono
- Mfumo haugundui kasoro zote za injini; Recall ya viwandani ni %76,92.
- Matokeo hayawezi kuenezwa kiotomatiki kwa watengenezaji wote wa magari, familia zote za injini na laini zote za kuunganisha.
- Uboreshaji wa uzalishaji wa %7,2 si ukubwa wa athari ya kisababishi uliodhibitiwa.
- Mfumo wa sasa wa sensa za jedwali wa modali moja hauwezi kuona anomalia zote ndogo za kimuundo.
- Modeli katika hali yake ya sasa haina ujifunzaji endelevu mtandaoni wala urekebishaji wa moja kwa moja wa concept-drift.
- Thamani kubwa za MAPE katika awamu ya Idle hazimaanishi pekee kwamba utendaji wa kimwili ni mbaya; thamani lengwa inapokaribia sifuri huongeza MAPE kihisabati.
Mapungufu na mwelekeo wa kazi za baadaye
Kikomo cha data za modali moja: Utafiti unategemea hasa vipimo vya mchakato/sensa katika mfumo wa jedwali kama torati, shinikizo na vingine vinavyofanana. Waandishi wanaeleza kwamba modaliti za ziada kama sensa za Acoustic Emission na ufuatiliaji wa kuona wa wakati halisi zinaweza kuhitajika ili kuongeza zaidi ugunduzi wa kasoro.
Ukadiriaji wa kutokuwa na uhakika: Kwa sababu utabiri wa pointi na MAPE vina mipaka hasa kwa malengo yanayokaribia sifuri, inapendekezwa katika siku zijazo kutathmini mbinu za uwezekano kama Bayesian Neural Networks na vipindi vya kujiamini.
Concept drift: Modeli hutumia data tuli za mafunzo zilizokusanywa katika kipindi fulani cha uthabiti wa uzalishaji. Wakati uchakavu wa zana, halijoto ya mazingira au kundi la nyenzo kutoka kwa msambazaji linapobadilika, usambazaji wa data unaweza kuhama kadiri muda unavyopita. Toleo la sasa halina utaratibu wa ujifunzaji endelevu mtandaoni.
Uwezo wa kuenezwa: Uthibitishaji tofauti unahitajika katika modeli tofauti za injini na laini tofauti za kuunganisha. Utafiti wa chanzo unatambua kwamba mafanikio ya viwandani yaliyopatikana kwenye laini moja ya kimwili hayamaanishi utendaji wa uzalishaji wa ulimwengu wote.
Maelezo ya Chanzo na Mbinu
Utafiti asili: Predicting Car-Engine Manufacturing Quality with Multi-Sensor Data of Manufacturing Assembly Process
Waandishi: Xinyu Yang; Qianxi Zhang; Junjie Bao; Xue Wang; Nengchao Wu; Qing Tao; Haijia Wu; Li Liu.
Mwandishi anayewajibika: Li Liu.
Taasisi: School of Mechanical Engineering, Xinjiang University, Urumqi, China; Chongqing Municipal Economy and Information Technology Commission, Chongqing, China; School of Big Data & Software Engineering, Chongqing University, Chongqing, China.
Jarida: Sensors.
Mchapishaji: MDPI.
Rekodi ya bibliografia: Sensors 2026, 26(5), 1651.
DOI: 10.3390/s26051651
Aina ya chanzo: Makala ya utafiti iliyopitiwa na wataalamu.
Sehemu ya makala: Industrial Sensors.
Imepokelewa: 29 Januari 2026.
Marekebisho: 21 Februari 2026.
Imekubaliwa: 27 Februari 2026.
Imechapishwa: 5 Machi 2026.
Leseni: Creative Commons Attribution (CC BY).
Mfumo wa viwandani: laini ya kuunganisha injini ya H4; modeli ya injini JL478QEA-AJ.
Seti za data za uthibitishaji wa umma: AI4I 2020 Predictive Maintenance Dataset; UCI SECOM; NASA C-MAPSS FD002.
Ufadhili: Chongqing Municipal Economy and Information Technology Commission, Grant No. YJX-2025001001008.
Utafiti wa binadamu/wanyama: Imeelezwa kwamba utafiti haukuhusisha utafiti uliofanywa kwa washiriki wa binadamu au wanyama.
Upatikanaji wa data: Imeelezwa kwamba data zinazounga mkono matokeo zinaweza kupatikana kutoka kwa mwandishi anayewajibika Li Liu kwa ombi linalofaa.
Mgongano wa maslahi: Waandishi wametangaza kwamba hakuna mgongano wa maslahi.
Michango ya waandishi: Xinyu Yang, Li Liu na Qing Tao — uundaji wa dhana; Xinyu Yang na Li Liu — mbinu; Xinyu Yang, Qianxi Zhang, Junjie Bao na Nengchao Wu — programu; Qianxi Zhang, Xue Wang na Nengchao Wu — uthibitishaji; Xinyu Yang na Qianxi Zhang — uchambuzi rasmi; Xinyu Yang, Junjie Bao na Xue Wang — utafiti; Li Liu na Haijia Wu — rasilimali; Xinyu Yang, Qianxi Zhang na Nengchao Wu — uratibu wa data; Xinyu Yang — rasimu ya kwanza; Li Liu, Qing Tao na Haijia Wu — mapitio/uhariri; Xinyu Yang na Qianxi Zhang — uwasilishaji wa kuona; Li Liu na Qing Tao — usimamizi; Li Liu na Haijia Wu — usimamizi wa mradi na ufadhili.
Kikomo kikuu cha tafsiri: Ingawa uthibitishaji wa viwandani ulifanywa kwenye laini halisi ya uzalishaji, uko katika muktadha wa modeli moja ya injini na laini maalumu ya kuunganisha. Recall ni %76,92, chini ya lengo bora la QA la >%95 lililotajwa na waandishi. Mfumo wa sasa unategemea modali moja tu ya sensa za jedwali, hauna urekebishaji wa concept-drift mtandaoni, na sehemu ya kisababishi inayohusishwa mahsusi na algoritimu katika uboreshaji wa uwanjani wa %7,2 wa miezi mitatu haikutenganishwa kwa utafiti tofauti uliodhibitiwa.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *