


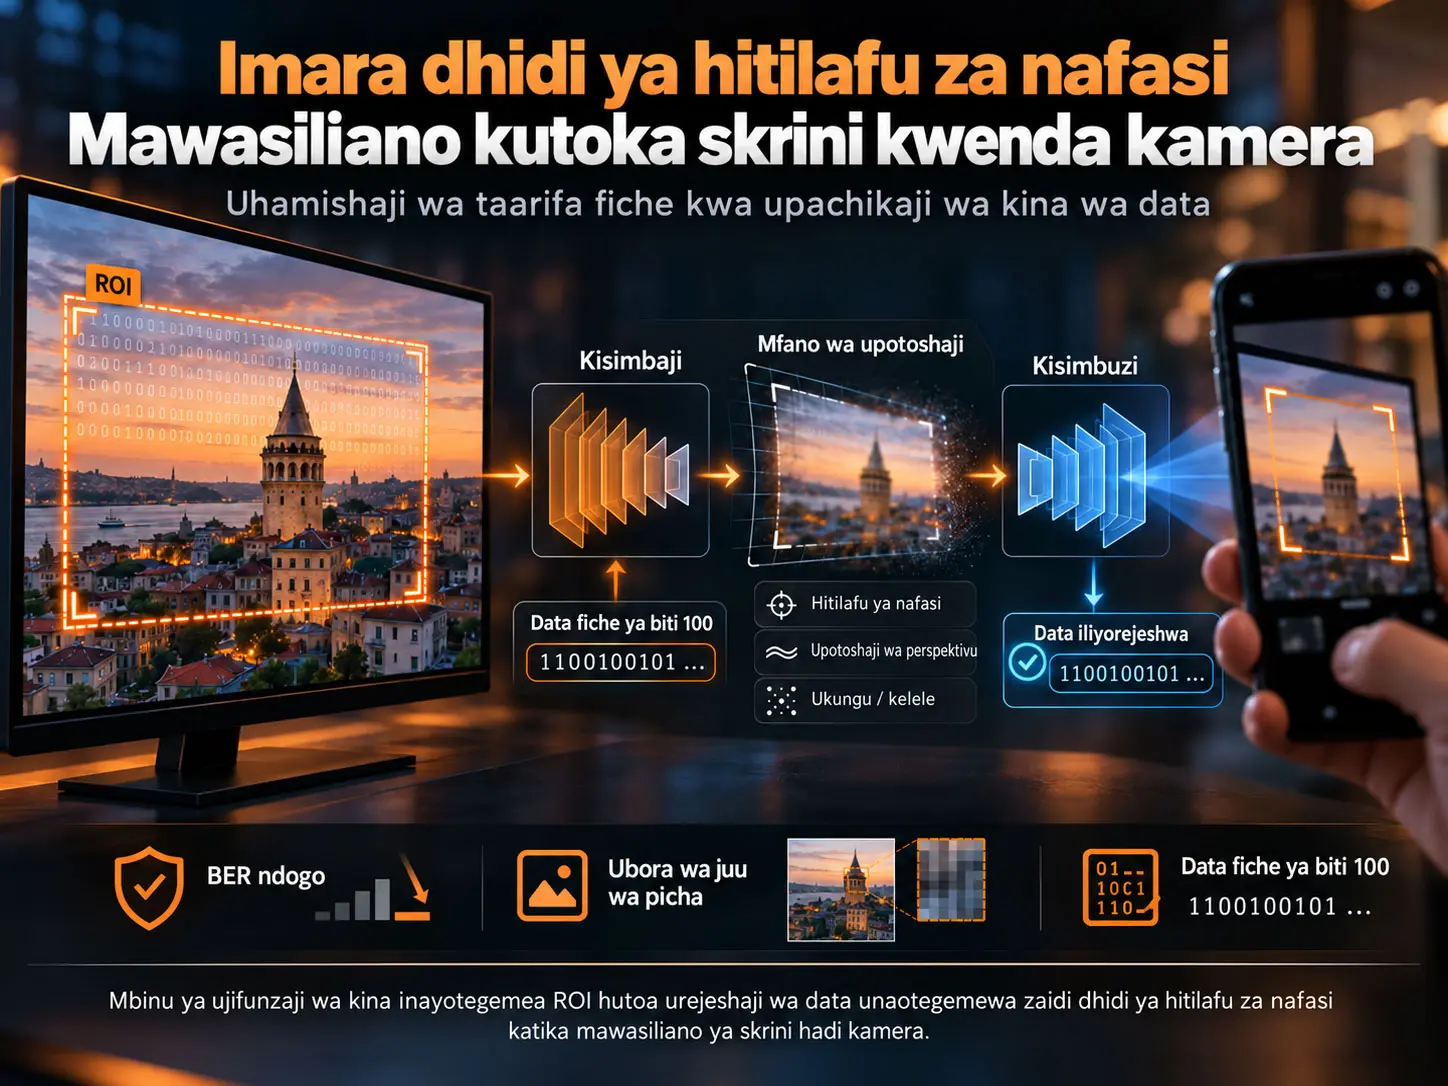
Mawasiliano kutoka skrini hadi kamera (Display-to-Camera Communication, D2C) ni mbinu ya mawasiliano ya macho inayofanya kazi kwa kupachika taarifa za kidijitali katika maudhui ya kuona yanayoonyeshwa kwenye skrini ya kielektroniki, kisha taarifa hiyo kupigwa picha na kamera na kurejeshwa. Utafiti huu, uliotengenezwa na Dae-Gyu Lee, Pankaj Singh na Sung-Yoon Jung, unapendekeza mfumo wa mwisho-hadi-mwisho wa upachikaji wa kina wa data unaotegemea eneo lengwa (Region of Interest, ROI) ili kuongeza ustahimilivu dhidi ya makosa ya uwekaji yanayotokana na hatua za utambuzi wa vitu na ukataji wa picha katika mifumo ya D2C. Encoder huunganisha picha na data ya jozi katika ramani za vipengele za viwango vingi, huku decoder ikirejesha data kupitia muundo mwembamba zaidi wa convolution. Modeli ilifundishwa pamoja na athari za chaneli kama vile mbano wa JPEG, mabadiliko ya rangi, motion blur, defocus, upotoshaji wa perspektiva na kelele ya sensa.
Katika ulinganisho mkuu wa chanzo uliotekelezwa kwa mzigo wa data wa 100 bit, modeli iliyopendekezwa ilipata PSNR = 31,3438 dB, SSIM = 0,9605 na BER = %0,0080; kwa StegaStamp, thamani hizo hizo ziliripotiwa kuwa 28,6677 dB, 0,9170 na %0,0879. Mbinu ya ROI iliyopendekezwa pia ilionyesha BER ya chini zaidi kadiri kosa la nafasi lilivyoongezeka. Kwa mfano, wakati mkengeuko sanifu wa upotoshaji wa nafasi σl = 5, BER ya modeli iliyopendekezwa ni %0,0550 na BER ya StegaStamp ni %0,2240.
Utafiti pia ulijaribu kiunganishi halisi cha skrini-kamera kwa kutumia monitari ya LG na Samsung Galaxy S22+ katika mazingira ya ndani yaliyodhibitiwa. Mbinu iliyopendekezwa ilizalisha makosa machache kuliko StegaStamp katika umbali wa 20–40 cm na mabadiliko ya perspektiva ya 0°–45°. Hata hivyo, matokeo haya yamewekewa mipaka na usanidi mmoja wa vifaa na hali za mwanga zilizodhibitiwa; uthibitishaji wa ziada unahitajika kwa vifaa tofauti, upigaji picha kwa mkono, mazingira ya nje, mwanga unaobadilika na masafa makubwa zaidi ya umbali.
Mawasiliano ya Skrini hadi Kamera (D2C) ni Nini?
Mawasiliano ya skrini hadi kamera ni mbinu ya mawasiliano ya kamera kwa njia ya macho inayowezesha picha-bebaji inayoonekana kwenye skrini kuonekana kwa binadamu huku data ya kidijitali iliyopachikwa ndani yake ikitambuliwa na kutatuliwa na kamera; katika utafiti huu, lengo ni kutumia upachikaji na urejeshaji wa data unaotegemea ujifunzaji wa kina ambao kwa kiasi kikubwa huhifadhi uadilifu wa kuona wa picha, badala ya QR code iliyo wazi.
Kutoka QR code hadi upachikaji wa data usioonekana
QR code ni mojawapo ya aina zinazojulikana zaidi za mawasiliano ya D2C; hata hivyo, moduli nyeusi-na-nyeupe zenye utofautishaji mkubwa, finder pattern na jiometri ya wazi ya msimbo hupunguza uhuru wa muundo wa picha-bebaji. Uwepo wa QR code pia humwonyesha mtazamaji moja kwa moja kuwa picha ina taarifa inayoweza kusomwa na mashine.
Mbinu za upachikaji wa kina wa data hufuata lengo tofauti. Taarifa ya jozi huwakilishwa ndani ya picha-bebaji kwa mabadiliko yasiyoonekana kwa urahisi na jicho la binadamu kadiri inavyowezekana. Kamera inapopiga picha hiyo tena, neural decoder hujaribu kurejesha muundo huu uliofichwa.
Mchakato huu si kunakili faili ya picha ya kidijitali kwenda kwenye kompyuta nyingine pekee. Mnyororo wa skrini → mazingira ya macho → kamera unapoanza kufanya kazi, athari nyingine za upotoshaji hujitokeza, kama perspektiva, umakini, mwendo, sifa za rangi za skrini, kelele ya sensa na kukata picha kutoka mahali pasipofaa. Katika fasihi, tatizo hili la mpito kutoka ulimwengu wa kidijitali kwenda ulimwengu halisi mara nyingi hujadiliwa katika muktadha wa “analog hole”.
Pengo kuu ambalo utafiti unalenga kutatua
Mbinu za awali za D2C zinazotegemea ujifunzaji wa kina zimeboresha kwa kiasi kikubwa ustahimilivu dhidi ya upotoshaji kama kelele, mbano, perspektiva na ukungu. Hata hivyo, katika mfumo wa vitendo, ni lazima mfumo wa utambuzi wa vitu au ujanibishaji uamue kwanza ni sehemu gani ya picha itakayotolewa kwa decoder.
Iwapo pembe za skrini katika fremu halisi ya kamera zitatambuliwa kwa makosa ya pikseli chache, picha iliyokatwa inaweza kutobaki ndani ya mipaka sahihi. Crop inayovuka mpaka humpa decoder pikseli za mandharinyuma zilizo nje ya skrini. Kosa la mwelekeo wa kinyume linaweza kukata pikseli zinazobeba data katika sehemu halisi ya ndani ya picha.
Kwa hiyo, tatizo kuu la utafiti si “data iliyofichwa inayostahimili kelele” pekee. Swali la msingi ni: katika mfumo wa D2C ambao hatua ya upstream ya utambuzi wa vitu si kamilifu, data inaweza kurejeshwaje kwa kuaminika? Hilo ndilo swali kuu.
Kwa Nini Upachikaji wa Data Unaotegemea ROI Unastahimili Zaidi Makosa ya Nafasi?
Mbinu inayotegemea ROI hujikita kwenye eneo thabiti la ndani lililotenganishwa na kingo kwa ukingo fulani wa usalama, badala ya kusambaza mzigo wa data ya jozi hadi kwenye mipaka nyeti ya nje ya picha; hivyo, mpaka wa skrini uliotambuliwa unapohama kwa pikseli chache kwenda nje au ndani, uwezekano wa decoder kufikia pikseli za mandharinyuma au kupoteza pikseli muhimu za ndani zinazobeba data hupungua.
Bafa ya ukingo ya %1
Katika mbinu ya chanzo, ukingo wa ROI umewekwa kuwa hasa %1 ya urefu na upana wa picha. Katika picha ya ingizo ya 400 × 400 × 3, pikseli 4 hutengwa kutoka kila ukingo. Matokeo yake, eneo linalotumika la upachikaji wa data huwa:
392 × 392 × 3
kwa ukubwa.
Lengo la mpangilio huu si kutumia picha ndogo tu. Ukingo huunda bafa ya kijiometri kati ya mipaka ya nje inayoathiriwa zaidi na makosa ya ujanibishaji na perspektiva na mzigo wa data uliopachikwa.
Makosa ya Overshooting na undershooting
Chanzo kinaeleza kuwa makosa ya ujanibishaji huunda aina mbili kuu za kushindwa. Overshooting ni pale mpaka uliotambuliwa unapovuka nje ya eneo halisi la skrini na decoder kuona pikseli za mandharinyuma. Undershooting ni pale mpaka unapohamia ndani kupita kiasi na pikseli halisi za picha zinazobeba data kupotea.
Kwa kuwa ROI huweka mzigo wa data mbali na ukingo wa nje, hutoa ustahimilivu wa kijiometri dhidi ya aina zote mbili za kosa. Mbinu hii haiondoi kosa la nafasi; inalenga kufanya decoder isiwe nyeti sana kwa makosa ya ukubwa fulani.
Mnyororo wa jumla wa uchakataji wa mfumo uliopendekezwa
| Hatua | Mchakato | Kazi ya kisayansi |
|---|---|---|
| 1 | Picha asili + data ya L-bit | Kuingiza kwenye mfumo ujumbe wa jozi utakaotumwa pamoja na picha-bebaji |
| 2 | Utenganishaji wa ROI | Kuacha ukingo wa usalama wa %1 kutoka kingo zisizo thabiti za picha |
| 3 | Kubadilisha umbo la data katika tabaka la FC | Kubadilisha ujumbe wa jozi kuwa tensor inayoweza kuunganishwa na nafasi ya picha |
| 4 | Encoder | Kutengeneza residual image kutokana na vipengele vya picha na data |
| 5 | Residual + picha asili | Kutengeneza encoded image yenye ufanano mkubwa wa kuona |
| 6 | Modeli ya upotoshaji | Kuiga upotoshaji wa chaneli halisi ya skrini-kamera wakati wa mafunzo |
| 7 | Utenganishaji wa ROI | Kufanya decoder ilenge eneo thabiti la ndani linalobeba data |
| 8 | Decoder | Kupunguza vipengele vya picha ili kurejesha ujumbe wa L-bit |
Data ya jozi huhamishwaje kwenda kwenye nafasi ya picha?
L-bit binary string inayoingia kwenye encoder kwanza huprojikiwa kuwa vekta ya 7500 × 1 kwa tabaka la fully connected (FC). Kisha vekta hii:
50 × 50 × 3
hubadilishwa umbo kuwa tensor. Tensor huongezwa hadi vipimo vya anga vya H × W × 3 vya picha-bebaji kwa kutumia pixel replication.
Baada ya mchakato wa ROI na zero padding, picha na tensor ya data huunganishwa katika kipimo cha channel ili kuunda:
H × W × 6
ingizo lililounganishwa la ukubwa huo.
Usanifu wa expansion–preservation–contraction wa Encoder
Encoder ina njia tatu za kiutendaji. Expansion pathway huongeza vipimo vya anga vya ramani za vipengele kwa kutumia tabaka za transposed convolution. Lengo ni kuunganisha vipengele vya picha na data katika viwango tofauti.
Preservation pathway hujaribu kuhifadhi vipengele muhimu kupitia shughuli za convolution. Contraction pathway nayo hupunguza tena vipengele vilivyopanuliwa hadi kwenye azimio la picha asili kwa kutumia tabaka za pooling na convolution.
Skip connection kati ya tabaka za mapema na za baadaye huruhusu vipengele vya awali kutumika tena katika tabaka za baadaye. Tokeo la mwisho la encoder si picha ya mwisho moja kwa moja; kwanza residual image yenye chaneli tatu hutengenezwa. Picha hii ya residual huongezwa kwenye picha-bebaji asili ili kupata encoded image.
| Sehemu | Muundo mkuu | Kazi iliyoripotiwa katika chanzo |
|---|---|---|
| Expansion | Tabaka 6 za transposed convolution | Kupanua ramani ya vipengele ili muungano wa picha-data uwe wa viwango vingi |
| Preservation | Convolution + max pooling | Kuhifadhi vipengele muhimu vya kuona/data |
| Contraction | Tabaka za Convolution | Kupunguza vipimo vya anga tena hadi 400 × 400 |
| Skip connection | Muunganisho wa tabaka za mapema na za baadaye | Kuwezesha vipengele vya awali kutumika tena katika hatua za baadaye |
| Tokeo | 400 × 400 × 3 residual image | Kutengeneza mabadiliko madogo yatakayoongezwa kwenye picha asili |
Kwa nini Decoder hutumia muundo wa “thin”?
Kazi ya decoder si kutengeneza taswira, bali kurejesha muundo wa jozi ndani ya encoded image kwa ufanisi kadiri inavyowezekana. Kwa hiyo usanifu hutumia muundo rahisi zaidi unaopunguza vipimo vya feature map hatua kwa hatua.
Decoder ina tabaka sita za convolution, shughuli mbili za average pooling na tabaka moja la FC. Katika tabaka tatu za kwanza za convolution hutumiwa stride 1, na katika tatu zinazofuata stride 2. Tabaka za convolution huendeshwa bila padding na uanzishaji wa ReLU hutumika.
Ingizo la ROI la 392 × 392 × 3 hupunguzwa hatua kwa hatua hadi kufikia ramani ya vipengele ya 10 × 10 × 64 katika tokeo la mwisho la convolution. Tabaka la FC hutengeneza matokeo 100 kwa uanzishaji wa sigmoid. Katika hatua ya mwisho, 0,5 binary threshold hutumika ili kupata makadirio ya mfuatano asili wa 100 bit.
Chaneli halisi huigwa kwa upotoshaji gani?
Utafiti hugawanya upotoshaji katika makundi mawili: upande wa skrini na upande wa kamera.
| Upande | Upotoshaji | Masafa yaliyotumika katika chanzo |
|---|---|---|
| Skrini | Mbano wa JPEG | Quality factor Q = 50–100 |
| Skrini | Utofautishaji | Uongezaji wa kipimo 0,5–1,5 |
| Skrini | Mwangaza | Mabadiliko ya hadi ±0,3 |
| Skrini | Hue | Mabadiliko ya hadi ±0,1 |
| Skrini | Saturation | Kipengele cha desaturation cha 0,0–1,0 |
| Kamera | Motion blur | 7 × 7 linear blur; σ = 0,25–1,0 |
| Kamera | Defocus | 7 × 7 Gaussian blur; σ = 1,0–3,0 |
| Kamera | Perspective warping | Random homography; maksimum ±%10 translation scale |
| Kamera | Internal sensor noise | Additive white Gaussian noise; μ = 0, σ = 0–0,02 |
Defocus blur na motion blur zilitumika kwa sampuli za mafunzo kila moja kwa uwezekano wa %25. Sehemu iliyobaki ya %50 iliachwa bila kutumia ukungu. Chaguo hili linalenga kuzuia modeli kujifunza picha zenye blur pekee na kuiweka katika hali mbalimbali za chaneli.
Fungsi ya hasara husawazisha malengo gani?
Modeli hufundisha encoder na decoder kwa pamoja kutoka mwisho hadi mwisho. Katika chanzo, fungsi ya jumla ya lengo imefafanuliwa kama:
\[ L_{\mathrm{total}} = \lambda_1 L_{\mathrm{LPIPS}} + \lambda_2 L_{2} + \lambda_3 L_{\mathrm{DATA}} + \lambda_4 L_{\mathrm{GAN}} \tag{1} \]
.
\(L_{\mathrm{LPIPS}}\) hujaribu kuhifadhi ufanano kati ya vipengele vya perceptual vya picha asili na encoded image. \(L_2\) huadhibu tofauti za kiwango cha pikseli katika nafasi ya rangi ya YUV ili kusaidia uaminifu wa kimuundo/kiona.
\(L_{\mathrm{DATA}}\) ni hasara ya binary cross-entropy kati ya ujumbe asili wa L-bit na tokeo lililoundwa upya na decoder. Ndiyo sehemu kuu ya mafunzo kwa usahihi wa urejeshaji wa data.
\(L_{\mathrm{GAN}}\) ni sehemu ya discriminator ya Wasserstein Generative Adversarial Network na inalenga kuhamasisha encoded image isiwe rahisi kutofautishwa kitakwimu na picha za chanzo.
Katika mafunzo, uwiano wa uzito:
λ1 : λ2 : λ3 : λ4 = 1,5 : 2 : 1,5 : 0,5
ulitumiwa. Uzito huu huamua usawazishaji wa uboreshaji kati ya ubora wa picha, urejeshaji wa data na lengo la adversarial.
Uwepo wa sehemu ya WGAN pekee hauthibitishi kuwa mfumo ni salama dhidi ya mashambulizi yote ya steganalysis. Utafiti hauripoti tathmini huru na pana ya steganalysis.
Uhusiano kati ya Gaussian blur na ukubwa wa kernel
Mlinganyo wa pili wa utafiti unaonyesha uhusiano kati ya thamani ya Gaussian blur standard deviation na ukubwa wa takriban wa kernel:
\[ k \approx 6\sigma_b+1 \tag{2} \]
Hapa \(k\) inaonyesha urefu wa upande wa blur kernel, na \(\sigma_b\) inaonyesha thamani ya Gaussian blur standard deviation. Chanzo kinasema kuwa \(k\) lazima iwe nambari witiri. Katika majaribio, ukubwa wa kernel wa 3 × 3, 5 × 5, 7 × 7 na 9 × 9 ulitathminiwa.
Mbinu na Matokeo ya Utafiti
Usanidi wa mafunzo
| Kigezo | Thamani |
|---|---|
| Seti ya data ya mafunzo | MIRFLICKR |
| Ukubwa wa picha | 400 × 400 × 3 |
| Mzigo chaguomsingi wa data | 100 bit |
| Jumla ya hatua za mafunzo | 160.000 |
| Mafunzo ya awali ya decoder-only | Hatua 2000 za kwanza; lengo la usahihi wa msingi wa urejeshaji wa data >%95 |
| Batch size | 2 |
| Learning rate | 10−4 |
| Total-loss optimizer | Adam |
| WGAN critic optimizer | RMSProp |
| Uzito wa Loss | 1,5 : 2 : 1,5 : 0,5 |
| Vifaa vya mafunzo | NVIDIA GeForce RTX 3060 |
Seti ya data ya majaribio na jaribio la kimwili
Kwa tathmini ya jumla ya ubora wa picha na urejeshaji wa data, picha 10.000 zilizochaguliwa kwa nasibu kutoka MS COCO zilitumika. Mbali na tathmini ya kidijitali, picha zilionyeshwa kwenye monitari halisi na kupigwa tena kwa kamera ya simu mahiri.
| Kipengele | Sifa iliyoripotiwa katika chanzo |
|---|---|
| Skrini | LG monitor |
| Azimio la skrini | 2560 × 1080 pikseli |
| Kiwango cha kuonyesha upya skrini | 60 Hz |
| Kamera | Samsung Galaxy S22+ |
| Azimio la kamera | 1920 × 1080 pikseli |
| Kasi ya fremu ya kamera | 30 fps |
| Zoom | 0,6 |
| Mwangaza | Mwangaza wa kawaida wa dari wa ndani |
| Jaribio la umbali | 20–40 cm |
| Jaribio la pembe | Mabadiliko ya perspektiva ya 0°–45° katika umbali usiobadilika wa 30 cm |
BER, PSNR na SSIM Hupima Nini katika Utafiti Huu?
BER hupima uwiano wa makosa ya bit katika ujumbe wa jozi uliorejeshwa na hivyo kutegemewa kwa mawasiliano; BER ya chini humaanisha urejeshaji bora wa data. PSNR hutathmini ukubwa wa upotoshaji wa kiwango cha pikseli kati ya picha asili na encoded image kwa dB, na thamani ya juu hupendelewa. SSIM hutathmini ufanano wa kimuundo wa picha, na thamani zinazokaribia 1 huonyesha ufanano wa juu zaidi wa kimuundo.
Ulinganisho mkuu wa StegaStamp
| Mbinu | PSNR (dB) | SSIM | BER |
|---|---|---|---|
| StegaStamp | 28,6677 | 0,9170 | %0,0879 |
| Modeli iliyopendekezwa | 31,3438 | 0,9605 | %0,0080 |
Mbinu iliyopendekezwa ilitoa matokeo bora kuliko StegaStamp katika metriki zote tatu. Chanzo kinaripoti kupungua kwa BER kwa %90,90. Ongezeko la ubora wa picha limewasilishwa kama tofauti ya 2,6761 dB katika PSNR na 0,0435 katika SSIM.
Utendaji chini ya Gaussian noise
Katika majaribio ya Gaussian noise, BER iliongezeka kadiri SNR ilivyopungua. Mwelekeo huu unaotarajiwa ulihusishwa na kuongezeka kwa kelele katika ishara, jambo linalofanya decoder iwe na ugumu zaidi kutenganisha muundo wa bit uliopachikwa.
Katika SNR = 25 dB, StegaStamp ilionyesha takriban %0,22 BER, huku modeli iliyopendekezwa ikipata takriban %0,11 BER. Chanzo kinaeleza tofauti hii kama uboreshaji wa kutegemewa wa %48,97.
SNR inapozidi 30 dB, BER ya modeli iliyopendekezwa inaripotiwa katika chanzo kuwa chini kwa %85–91 kuliko StegaStamp. Katika hali ya kelele kubwa chini ya SNR 20 dB, modeli zote mbili huzorota kwa kiasi kikubwa.
Utendaji chini ya Gaussian blur
| Mbinu | 3 × 3, σ=0,3 | 5 × 5, σ=0,6 | 7 × 7, σ=1,0 | 9 × 9, σ=1,2 |
|---|---|---|---|---|
| StegaStamp | %0,0868 | %0,0693 | %0,0664 | %0,0665 |
| Modeli iliyopendekezwa | %0,0079 | %0,0076 | %0,0095 | %0,0103 |
Modeli iliyopendekezwa ilidumisha BER ya chini sana katika hali za blur za 3 × 3 na 5 × 5, huku kiwango cha makosa kikianza kuongezeka katika 7 × 7 na 9 × 9. Chanzo kinaripoti kuwa hata katika ukungu wa juu wa jaribio wa 9 × 9, BER ya modeli iliyopendekezwa ilikuwa chini kwa %84,51 kuliko StegaStamp.
Inavutia kwamba modeli zote mbili katika baadhi ya hali za blur ya kiwango cha kati zilionyesha urejeshaji bora wa data kuliko hali isiyo na upotoshaji. Waandishi wanaeleza hili kwa kuwa blur ipo katika distortion pipeline ya mafunzo na mitandao imeandaliwa mahsusi kwa upotoshaji huo.
Upimaji wa kimajaribio wa kosa la nafasi katika utambuzi wa vitu
Ili kubaini kiwango halisi cha uigaji wa kosa la nafasi, modeli ya utambuzi wa vitu ya BiSeNet ilitathminiwa kwenye picha 10.000. Utambuzi ulizingatiwa kuwa umefanikiwa wakati kosa la nafasi lilikuwa pikseli 10 au chini, na kiwango cha mafanikio kiliripotiwa kuwa %81,28.
Katika utambuzi uliofanikiwa, wastani wa makosa katika mhimili x na y ulikuwa 0,687 na 0,178 pikseli mtawalia; mikengeuko sanifu ilikuwa 2,719 na 2,665 pikseli.
Kutokana na uchunguzi huu, pembe nne za mipaka ya picha zilibadilishwa katika mhimili x na y kwa makosa huru ya nafasi yenye mgawanyo wa kawaida.
Ustahimilivu dhidi ya kosa la nafasi
| Mbinu | μl=0, σl=0 | μl=0, σl=3 | μl=0, σl=5 |
|---|---|---|---|
| StegaStamp | %0,0879 | %0,1293 | %0,2240 |
| Modeli iliyopendekezwa | %0,0080 | %0,0109 | %0,0550 |
BER ya mfumo uliopendekezwa huongezeka kadiri σl inavyotoka 0 hadi 5; hivyo ROI haiondoi kabisa kosa la nafasi. Hata hivyo, ongezeko hilo ni dogo zaidi kwa kiasi kikubwa kuliko StegaStamp.
Chanzo kinaripoti kwa σl = 3 kupungua kwa BER kwa %91,57 dhidi ya StegaStamp, na kwa σl = 5 uboreshaji wa %75,45. Aidha, BER ya %0,0550 katika hali ya σl = 5 ni ya chini hata kuliko thamani ya %0,0879 ya StegaStamp bila kosa la nafasi.
Athari ya umbali halisi wa kamera
Katika jaribio halisi la skrini-kamera, umbali uliongezwa kutoka 20 cm hadi 40 cm. Kwa sababu alama ya anga ya picha kwenye sensa ya kamera hupungua, azimio la sampuli hupungua na BER huongezeka.
Chanzo kinaripoti kwa mfumo uliopendekezwa BER = 0,0003 katika 20 cm, BER = 0,0009 katika 30 cm na BER = 0,0053 katika 40 cm. Kupungua kwa kosa katika 20 cm kumeonyeshwa kuwa %89,29 dhidi ya StegaStamp, na faida katika 40 cm kuwa %65,13.
Kwa kuwa katika sehemu hii chanzo kilitoa thamani za BER bila alama ya asilimia, maandishi ya Verianla hayakuzibadilisha kiotomatiki kuwa asilimia.
Athari ya pembe ya perspektiva
Umbali wa kamera–skrini uliwekwa 30 cm na pembe ya kamera ikabadilishwa kutoka 0° hadi 45°. Kadiri pembe ilivyoongezeka, perspective warping na makosa ya ulinganishaji wa pikseli yaliongezeka, hivyo BER ya mifumo yote miwili ikaongezeka.
Modeli iliyopendekezwa ilionyesha BER = 0,0009 katika 0° na BER ya juu ya 0,0035 katika mzunguko wa 45° kulia. Kwa StegaStamp, thamani ya 0° ilikuwa 0,0052, na thamani katika mzunguko wa 45° kushoto iliripotiwa kuwa 0,0193.
Waandishi wanahusisha tofauti hii na ROI kuunda bafa dhidi ya athari za edge nonlinearity na localization jitter, pamoja na usanifu wa encoder wa viwango vingi/decoder mwembamba kuhifadhi vipengele vya data.
Nini hutokea mzigo wa data unapoongezeka?
| Metriki | 50 bit | 100 bit | 200 bit |
|---|---|---|---|
| PSNR (dB) | 31,3525 | 31,3438 | 29,4619 |
| SSIM | 0,9609 | 0,9605 | 0,9458 |
| BER | %0,0072 | %0,0080 | %0,1106 |
Katika mabadiliko kutoka 50 bit hadi 100 bit, ubora wa picha na BER huonyesha mabadiliko madogo tu. Kinyume chake, mzigo wa data wa 200 bit hupunguza kwa kiasi kikubwa uaminifu wa picha na mafanikio ya urejeshaji wa data.
Chanzo kinasema BER ya %0,1106 katika 200 bit ni takriban mara 13,8 zaidi ya thamani ya %0,0080 katika 100 bit. Kwa kuwa msongamano mkubwa wa data unahitaji mabadiliko makubwa zaidi kwenye picha-bebaji, uwiano kati ya kutokuonekana na utenganishaji wa data huzorota.
Kwa hiyo, utafiti ulichagua 100 bit kwa usawa wa utendaji–uwezo katika usanifu na hali ulizochunguza. Matokeo haya hayamaanishi kwamba “100 bit ndiyo optimum ya jumla kwa mifumo yote ya D2C”.
Utata wa kihesabu
| Kipimo | StegaStamp | Modeli iliyopendekezwa |
|---|---|---|
| FLOPs | 55,19 M | 2,52 M |
| Kigezo kinachofundishika | 54,27 M | 2,24 M |
| Muda wa wastani wa decoding | 7,1 ms | 4,1 ms |
Chanzo kinaripoti kupungua kwa takriban mara 22 kwa idadi ya FLOPs na takriban mara 24 kwa idadi ya vigezo vinavyofundishika. Sababu kuu ni kurahisishwa kwa usanifu wa decoder. Mzigo mdogo wa hesabu una uwezo wa kutoa faida muhimu kwa matumizi ya D2C ya simu; hata hivyo, utafiti haujapima matumizi ya nishati au ucheleweshaji wa programu kutoka mwisho hadi mwisho kwenye vichakataji tofauti vya simu.
Utafiti wa ablation wa ROI ulionyesha nini?
Katika jaribio la ablation, moduli ya ROI ilipoondolewa, ukubwa wa tokeo la mwisho la convolution la decoder ulibadilika; kwa hiyo, ili kuunda usanifu unaoweza kulinganishwa, ukubwa wa convolution kernel ya kwanza ulibadilishwa kuwa 7.
| Hali | PSNR (dB) | SSIM | BER |
|---|---|---|---|
| Bila ROI — kulingana na maandishi ya maelezo ya chanzo | 30,2658 | 0,9472 | %0,0611 |
| Kwa ROI — kulingana na maandishi ya maelezo ya chanzo | 31,3438 | 0,9605 | %0,0080 |
Kwa mujibu wa maelezo ya chanzo, bila ROI BER ni %0,0611, lakini ROI inapoongezwa hushuka hadi %0,0080; hili limeripotiwa kama uboreshaji wa takriban mara 7,6. PSNR na SSIM pia huongezeka kidogo kwa ROI.
Matokeo ya ablation yanaunga mkono kwamba ROI si maelezo madogo ya muundo wa usanifu pekee, bali huchangia sehemu muhimu ya mafanikio ya urejeshaji wa data yaliyoripotiwa katika chanzo.
Matokeo yanayoungwa mkono na utafiti
Utafiti unaunga mkono kwamba, katika seti za data na hali za majaribio zilizochunguzwa, mbinu ya upachikaji wa kina wa data inayotegemea ROI na inayostahimili kosa la nafasi inaweza kutoa ubora wa juu zaidi wa picha na BER ya chini zaidi kuliko StegaStamp.
Majaribio yaliyoigwa ya Gaussian noise, Gaussian blur na kosa la nafasi yanaonyesha usanifu uliopendekezwa ni thabiti zaidi chini ya athari hizi za upotoshaji. Majaribio yaliyodhibitiwa ya skrini-kamera halisi pia yanaonyesha kwamba faida hiyo inaweza kuhamishwa hadi kwenye chaneli halisi ya upigaji picha katika umbali wa 20–40 cm na perspektiva ya 0°–45°.
Utafiti wa ablation unaonyesha moduli ya ROI inachangia kwa kiasi kikubwa mafanikio ya urejeshaji wa data; ulinganisho wa utata wa kihesabu unaonyesha usanifu mwembamba wa decoder hutoa FLOPs chache, vigezo vichache na muda mfupi wa decoding.
Majumuisho yasiyoungwa mkono na utafiti
Utafiti hauthibitishi kwamba mfumo uliopendekezwa utatoa utendaji sawa kwenye skrini zote, kamera zote, hali zote za mwanga au mazingira ya nje. Jaribio halisi lilifanywa kwa monitari maalumu ya LG, kamera ya Samsung Galaxy S22+, mwanga wa dari uliodhibitiwa na hali za ufungaji thabiti.
Utafiti hauhakikishi utendaji wa juu kwa mizigo yote ya data. Jaribio la 200 bit linaonyesha kwamba kadiri uwezo unavyoongezeka, uaminifu wa picha na utendaji wa BER vinaweza kuzorota kwa kiasi kikubwa.
Kwa sababu utafiti unatumia WGAN loss, hauthibitishi usalama wa kriptografia au steganografia dhidi ya mbinu zote za steganalysis. Tathmini ya Dedicated ya mashambulizi haimo katika wigo wa majaribio wa makala hii.
Utafiti hauondoi hitaji la upstream object detection. Ujanibishaji wa skrini/picha kwa BiSeNet bado ni sehemu ya mnyororo wa mfumo; mbinu ya ROI iliyopendekezwa inalenga kuongeza ustahimilivu dhidi ya mapungufu katika hatua hii.
Mapungufu na kazi za baadaye
Katika sehemu ya hitimisho, chanzo kinaonyesha uchunguzi wa kina zaidi wa maafikiano kati ya uwezo na mafanikio ya mawasiliano kama kazi ya baadaye. Hususan, athari za mzigo wa data unaobadilika kwenye usanifu wa modeli na ubora wa picha zinahitaji kutathminiwa katika masafa mapana zaidi.
Waandishi pia wanapendekeza mchango wa kila sehemu ya loss uchunguzwe kando. Ingawa utafiti wa sasa unatoa ablation kwa ROI, hauripoti ablation huru na pana kwa sehemu zote za LPIPS, L2, DATA na GAN loss.
Kupanua uthibitishaji wa kimwili kwa skrini, kamera na hali mbalimbali za mwanga pia ni lengo wazi la kazi za baadaye. Hoja hii inaonyesha kwamba matokeo ya sasa ya ulimwengu halisi si uthibitisho wa utendaji wa jumla usiotegemea kifaa.
Mwisho, waandishi wanapendekeza kutengeneza algoriti zinazoweza kujirekebisha kwa mizigo tofauti ya data na maazimio tofauti ya picha. Upanuzi kama huo unalenga kutumia mbinu ya D2C katika hali mbalimbali zaidi za ubiquitous computing.
Maelezo ya Chanzo na Mbinu
Kichwa asili: Robust Display-to-Camera Communication via Location Error-Tolerant Deep Data Embedding.
Waandishi: Dae-Gyu Lee; Pankaj Singh; Sung-Yoon Jung.
Waandishi wa mawasiliano: Pankaj Singh; Sung-Yoon Jung.
Taasisi: Department of Electronic Engineering, Yeungnam University, Gyeongsan, Gyeongsangbuk, Republic of Korea.
Jarida: Applied Sciences.
Mchapishaji: MDPI, Basel, Switzerland.
Taarifa ya uchapishaji: Applied Sciences 2026, 16, 8767.
DOI: 10.3390/app16178767.
Historia ya makala: Ilipokelewa 29 Mei 2026; marekebisho 22 Juni 2026; ilikubaliwa 24 Juni 2026; ilichapishwa 3 Septemba 2026.
Aina ya chanzo: Makala asilia ya utafiti wa uhandisi iliyopitiwa na wataalamu na yenye ufikiaji wazi; ukuzaji wa modeli ya mwisho-hadi-mwisho inayotegemea ujifunzaji wa kina, upotoshaji wa chaneli ulioigwa na uthibitishaji wa kimwili wa skrini-kamera uliodhibitiwa.
Leseni: Creative Commons Attribution 4.0 International (CC BY 4.0). Hakimiliki ni za waandishi.
Mbinu kuu: Usanifu wa upachikaji wa data wa D2C wa encoder–decoder unaotegemea ROI na unaostahimili kosa la nafasi.
Encoder: Njia za expansion, preservation na contraction; transposed convolution, convolution, pooling na skip connection; ujifunzaji wa residual-image.
Decoder: Tabaka sita za convolution, shughuli mbili za average-pooling na tabaka la FC lenye tokeo la sigmoid; 0,5 binary threshold.
Seti ya data ya mafunzo: MIRFLICKR.
Seti ya data ya majaribio: Picha 10.000 zilizochaguliwa kwa nasibu kutoka MS COCO.
Ukubwa wa picha: 400 × 400 × 3 pikseli.
ROI: Ukingo wa %1 kwenye kila upande wa urefu na upana wa picha; eneo la upachikaji wa data la 392 × 392 kwa picha ya 400 × 400.
Payload chaguomsingi: 100 bit.
Mafunzo: Hatua 160.000; hatua 2000 za kwanza zikilenga decoder loss; batch size 2; learning rate 10−4.
Optimizer: Adam kwa total loss; RMSProp kwa WGAN critic.
Loss: LPIPS + YUV L2 + binary-cross-entropy DATA + WGAN discriminator loss.
Metriki za utendaji: PSNR, SSIM na BER.
Vifaa halisi vya kimwili: Monitari ya LG 2560 × 1080 / 60 Hz na kamera ya Samsung Galaxy S22+ 1920 × 1080 / 30 fps.
Mbinu ya kulinganisha: StegaStamp.
Ufadhili: Gyeongbuk ANCHOR system through the Gyeongbuk ANCHOR CENTER; Ministry of Education na Gyeongsangbuk-do, Republic of Korea; mradi 2026-ANCHOR-15-115.
Bodi ya Mapitio ya Taasisi: Haitumiki.
Ridhaa yenye taarifa: Haitumiki.
Upatikanaji wa data: Makala ya chanzo inaripoti kuwa data zilizo msingi wa matokeo zinapatikana katika rejea nambari [41] kwenye orodha yake ya marejeo.
Mgongano wa maslahi: Waandishi wameripoti kuwa hakuna mgongano wa maslahi.
Tamko la matumizi ya akili bandia: Waandishi wameripoti kwamba walitumia ChatGPT 5.5 kuboresha lugha, usomekaji na mpangilio wa maudhui ya makala; walikagua na kuhariri matokeo na kuchukua jukumu la maudhui yaliyochapishwa.
Michango ya waandishi: Sung-Yoon Jung alichangia katika uundaji wa dhana, supervision, usimamizi wa mradi na upatikanaji wa ufadhili; Dae-Gyu Lee katika metodolojia, programu, uchambuzi formal, utafiti, kuratibu data na rasimu asili; Pankaj Singh katika metodolojia, uthibitishaji, uchambuzi formal, mapitio/uhariri na uoneshaji. Katika tamko la kina la CRediT la chanzo, baadhi ya majukumu yanashirikiwa kati ya waandishi zaidi ya mmoja.
Dokezo la uripoti ndani ya chanzo: Mistari yote miwili ya Jedwali 8 imewekewa lebo “Proposed (w/o ROI)”; hata hivyo, maandishi yaliyo mara moja kabla yake yanahusisha seti ya pili ya matokeo na modeli iliyopendekezwa yenye ROI. Aidha, katika baadhi ya majedwali ya uigaji BER imeripotiwa kama asilimia, ilhali katika maelezo ya majaribio halisi ya umbali/pembe imeripotiwa kwa mfumo wa desimali bila alama ya asilimia. Katika maudhui haya ya Verianla, hoja hizi hazijasawazishwa kimya kimya kwa makadirio.
Kikomo kikuu cha kimetodolojia: Ingawa uthibitishaji wa kimwili ulitumia skrini na kamera halisi, ulifanywa katika mazingira ya ndani yaliyodhibitiwa, kwa vifaa maalumu na katika masafa machache ya umbali na pembe. Matokeo hayawezi kujumlishwa kiotomatiki kwa vifaa tofauti, mwanga tofauti, mwendo wa simu na hali za nje.
Dokezo la matumizi tena ya picha: Chanzo kina leseni ya CC BY 4.0. Hata hivyo, kwa Verianla imependelewa kujenga upya mahusiano ya mbinu na matokeo ya namba kwa michoro na majedwali ya kiufundi asilia badala ya kubeba vielelezo vya chanzo kama screenshot.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *