

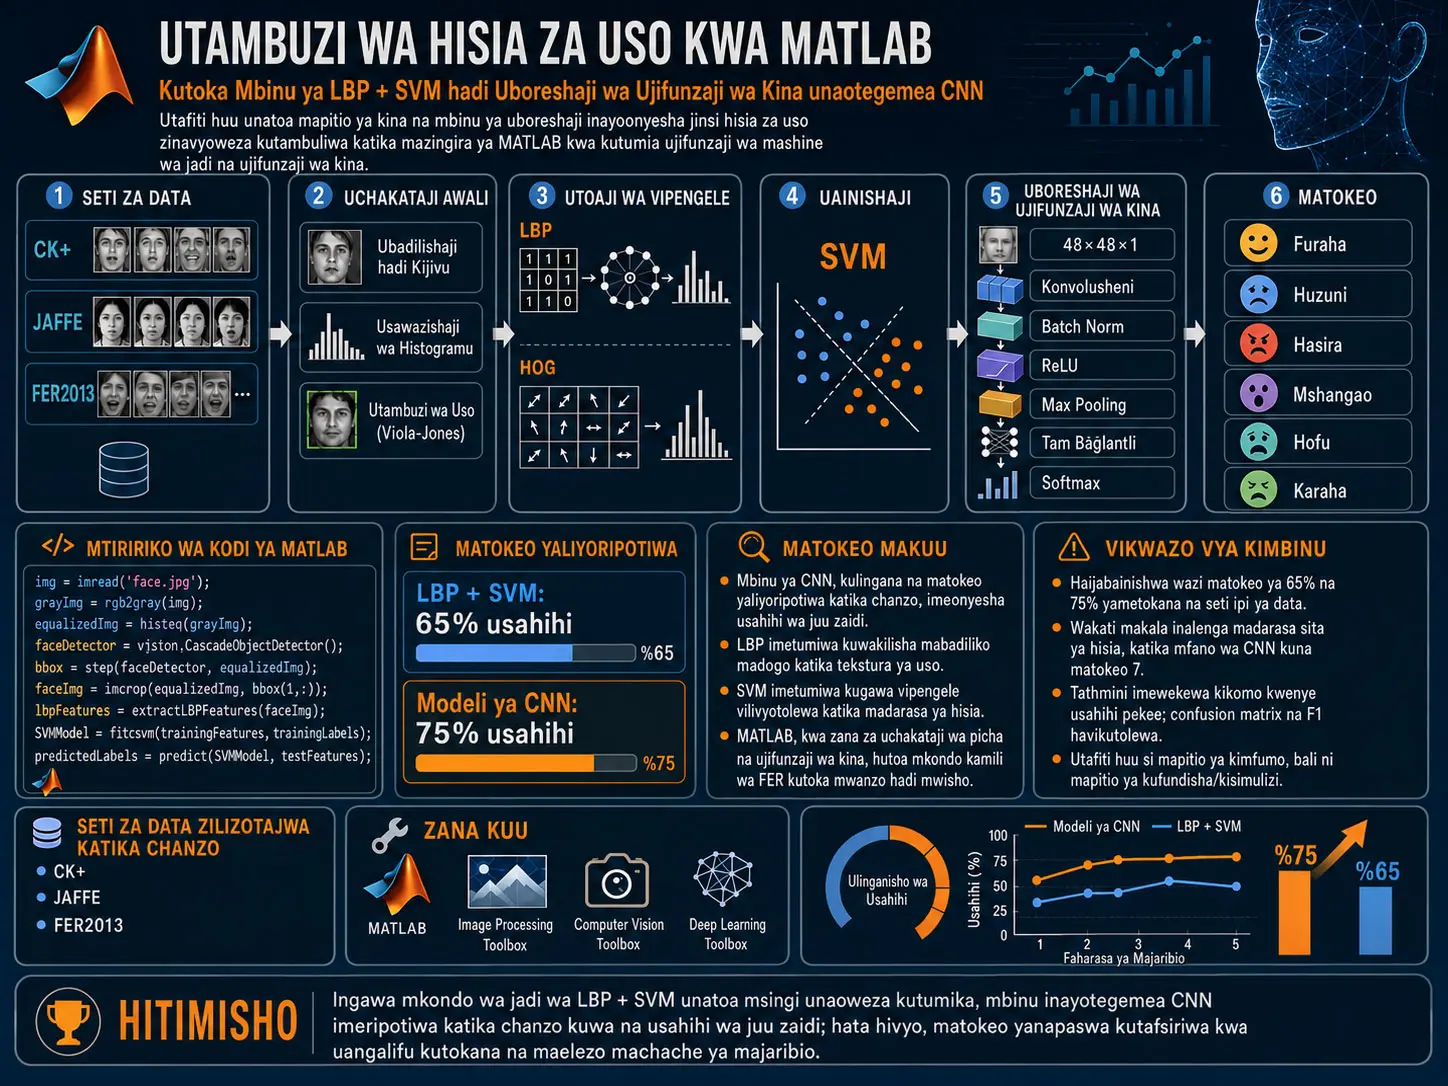
Utafiti huu unachunguza mbinu za jadi za ujifunzaji wa mashine na ujifunzaji wa kina zinazoweza kutekelezwa katika MATLAB ili kuainisha kiotomatiki mifumo ya misemo katika picha za uso. Utambuzi wa misemo ya uso (Facial Expression Recognition, FER) ni tatizo la uoni wa kompyuta na utambuzi wa mifumo linalojaribu kuipangia picha ya uso moja ya madarasa ya misemo yaliyofafanuliwa mapema kwa kutumia sifa za kijiometri na tekstura zinazoonekana kwenye picha hiyo. Utafiti wa chanzo unalenga madarasa sita ya msingi ya misemo: furaha, huzuni, hasira, mshangao, hofu na kuchukizwa; katika mkondo wa jadi hutumia utambuzi wa uso, ubadilishaji kuwa kijivu, usawazishaji wa histogramu, uchimbaji wa sifa za Local Binary Patterns (LBP) na uainishaji wa Support Vector Machine (SVM). Kama njia mbadala, unapendekeza usanifu wa Convolutional Neural Network (CNN) katika MATLAB Deep Learning Toolbox.
Kulingana na matokeo yaliyoripotiwa katika chanzo, mbinu ya SVM inayotumia sifa za LBP ilitoa usahihi wa %65, huku mbinu ya CNN ikitoa usahihi wa %75. Hivyo, katika makala hiyo hiyo, CNN imeripotiwa kuwa na usahihi wa juu kwa pointi 10 za asilimia. Hata hivyo, kwa kuwa haijaelezwa wazi ni seti gani ya data iliyotumika kupata thamani hizi, mgawanyo wa mafunzo-majaribio, idadi ya sampuli, uwiano wa madarasa, idadi ya marudio na vipimo vingine vya tathmini, matokeo haya hayapaswi kufasiriwa kama benchmark iliyodhibitiwa na inayoweza kurudiwa.
Sifa muhimu ya kimethodolojia ya makala ni kwamba inafanya mkondo wa uchakataji wa picha kuwa halisi kwa vipande vya msimbo wa MATLAB. Chanzo kina mifano ya kusoma picha, kuibadilisha kuwa kijivu, kusawazisha histogramu, kutambua uso kwa msingi wa Viola-Jones, kuchimba sifa za LBP, kufundisha SVM na mipangilio ya mafunzo ya CNN. Hata hivyo, ingawa chanzo kinajieleza kama mapitio ya kina, hakitoi itifaki ya utafutaji wa fasihi wa kimfumo; kwa hiyo utafiti huu unafaa zaidi kutazamwa kama mapitio ya kufundisha/masimulizi na mfumo wa mfano wa utekelezaji.
Matokeo ya FER pia yanahitaji kutafsiriwa kwa mipaka sahihi. Algoriti kuipangia picha ya uso darasa kama “happy”, “sad” au “angry” lililofafanuliwa katika seti ya data hakumaanishi kwamba inapima moja kwa moja hali halisi ya ndani ya kihisia ya mtu. Utafiti huu pia unajadili hasa utendaji wa uainishaji wa picha.
Utambuzi wa Misemo ya Uso (FER) ni Nini?
Utambuzi wa misemo ya uso ni tatizo la uoni wa kompyuta linalobadilisha mabadiliko yanayoonekana ya umbo au tekstura katika mdomo, macho, nyusi na maeneo yanayozunguka kuwa sifa za nambari, kisha kuipangia picha moja ya madarasa ya misemo yaliyofafanuliwa mapema. Utafiti wa chanzo unaichukulia FER kama mkondo wa uchakataji wa MATLAB unaojumuisha uchakataji wa awali wa picha, uchimbaji wa sifa na uainishaji, na unaorodhesha furaha, huzuni, hasira, mshangao, hofu na kuchukizwa kama madarasa sita lengwa.
Mkondo msingi wa uchakataji wa mfumo wa FER
Mchakato wa jadi wa FER ulioelezwa katika chanzo unaweza kufupishwa katika hatua nne kuu:
- Kupata picha za uso zenye lebo.
- Kuchakata picha awali na kutenga eneo la uso.
- Kuchimba sifa za nambari zinazowakilisha uso.
- Kutabiri darasa la msemo kutokana na sifa zilizochimbwa.
Chanzo kinaeleza mkondo huu hasa kupitia zana za MATLAB. Katika sehemu ya mbinu, majina CK+, JAFFE na FER2013 yanatajwa kama mifano ya seti za kawaida za data za misemo ya uso. Zinatajwa kama vyanzo vinavyoweza kutoa picha za uso zenye lebo kwa mafunzo na majaribio; hata hivyo, haijaelezwa ni seti ipi hasa iliyotumika kupata usahihi wa %65 na %75 ulioripotiwa katika makala.
Kwa nini upatikanaji wa picha ni hatua ya kwanza?
Kiainishaji hakijui misemo ya uso chenyewe; kwanza kinahitaji mifano yenye lebo inayowakilisha madarasa tofauti. Chanzo kinafananishia hili na albamu kubwa ya picha zenye misemo mbalimbali ya nyuso za watu. Kila picha katika data ya mafunzo inadhaniwa kuwa na lebo ya darasa kama “happy”, “sad”, “angry”, “surprised”, “afraid” au “disgusted”.
Baada ya mafunzo, picha mpya hubadilishwa kuwa nafasi ileile ya uwakilishi na modeli hutoa lebo ya darasa kwa kutegemea mifumo iliyojifunza hapo awali. Kile algoriti inachofanya hapa ni kulinganisha mifumo kati ya sifa zinazoonekana za picha na miundo ya madarasa iliyojifunza wakati wa mafunzo.
Seti za data zilizotajwa katika chanzo
| Seti ya data | Jukumu katika utafiti wa chanzo |
|---|---|
| CK+ | Inatajwa kama mojawapo ya seti za kawaida za data ambazo misemo ya uso yenye lebo inaweza kupatikana kwa mafunzo na majaribio. |
| JAFFE | Inaorodheshwa kama chanzo cha picha za uso zenye lebo kinachoweza kutumika katika tafiti za FER. |
| FER2013 | Inatajwa kama mojawapo ya seti za kawaida za data za misemo ya uso. |
Chanzo hakisemi wazi kwamba seti hizi tatu za data zilitumika pamoja katika jaribio moja. Kwa hiyo, ukweli kwamba majina yake yanaonekana katika sehemu ya mbinu haumaanishi kwamba matokeo ya utendaji yaliyoripotiwa yalitokana na matumizi ya zote tatu kwa pamoja.
Kiolesura cha MATLAB katika PDF
Kielelezo 1 katika ukurasa wa 2 wa chanzo kinaonyesha kiolesura cha picha cha mtumiaji kinachotegemea MATLAB chenye kichwa “AdaBoost Facial Expression Recognition”. Kiolesura kina kazi kama kuchagua picha, kuongeza picha iliyochaguliwa kwenye hifadhidata, kutambua msemo wa uso, kuonyesha taarifa za hifadhidata, kufuta hifadhidata, kuonyesha taarifa za programu na kuonyesha msimbo chanzi.
Kielelezo hiki kinaonyesha, kwa mtazamo wa kufundisha, mtiririko wa upande wa mtumiaji wa programu ya FER. Hata hivyo, kwa kuwa kiainishaji kikuu cha jadi katika makala kinawasilishwa kama SVM, chanzo hakielezi jinsi kiolesura cha AdaBoost kinavyohusishwa na ulinganisho wa utendaji wa SVM-CNN.
Maktaba ya picha ya chanzo
Kielelezo 2 katika ukurasa wa 2 wa PDF kinaonyesha maktaba ya picha za misemo ya uso yenye picha nyingi za uso za kijivu. Picha hiyo inaonyesha kwa vitendo kwamba mfumo wa uainishaji hufanya kazi kwa mantiki ya hifadhidata ya mifano ya mafunzo badala ya picha moja pekee.
Hatua ya uchakataji wa awali
Chanzo kinapendekeza picha ghafi isipelekwe moja kwa moja kwa kiainishaji bali isawazishwe kwanza. Michakato mitatu ya msingi imetajwa:
- Kubadilisha kuwa kijivu: Hupunguza njia za rangi kuwa njia moja ya ukubwa wa mwangaza na kurahisisha muundo wa data inayochakatwa.
- Usawazishaji wa histogramu: Hulenga kupunguza athari ya kontrasti ndogo au isiyo sawa kwa uchimbaji wa sifa kwa kurekebisha kontrasti ya picha.
- Utambuzi wa uso: Eneo la picha lenye uso hutambuliwa kwa kitambua uso cha aina ya Viola-Jones na hukatwa.
Katika mfano wa MATLAB wa chanzo, imread hutumika kusoma picha, rgb2gray kubadilisha kuwa kijivu, histeq kusawazisha histogramu, vision.CascadeObjectDetector kutambua uso na imcrop kukata picha.
Miingiliano iliyoonyeshwa kabla na baada ya utambuzi wa uso
Katika ukurasa wa 3 wa PDF kuna picha mbili za skrini za kiolesura kilekile cha FER. Chanzo kinaziita Kielelezo 3 “before detection” na Kielelezo 4 “after detection”. Hata hivyo, katika skrini ya Kielelezo 3 kuna sehemu ya matokeo inayoonyesha kuwa msemo uliotambuliwa ni “Surprise”, huku Kielelezo 4 kina ujumbe unaosema picha mpya iliyochaguliwa bado inaweza kuongezwa kwenye hifadhidata. Kwa hiyo kuna kutolingana kunakoonekana kati ya vichwa vya vielelezo na hali za kiolesura.
LBP na SVM Hufanyaje Kazi Pamoja?
Katika mbinu ya chanzo, Local Binary Patterns (LBP) hubadilisha mabadiliko ya tekstura ya eneo katika picha ya uso kuwa sifa za nambari; Support Vector Machine (SVM) hutumia vekta hizi za sifa kujifunza mpaka wa uamuzi unaotenganisha madarasa tofauti ya misemo. Hivyo LBP huzalisha uwakilishi wa picha na SVM hutabiri lebo ya darasa kwa kutumia uwakilishi huo.
Local Binary Patterns huwakilisha nini?
LBP ni kifafanuzi cha tekstura ya eneo kinacholinganisha ukubwa wa pikseli ya katikati na pikseli jirani. Kwa mujibu wa maelezo ya chanzo, ikiwa thamani ya pikseli jirani ni sawa na au kubwa kuliko ya pikseli ya katikati, hutolewa thamani ya kibinari 1; vinginevyo hutolewa 0. Mchoro wa kibinari unaotokana na ulinganisho huu huwakilisha tekstura ya eneo ya picha.
Katika misemo ya uso, mabadiliko madogo ya umbo na tekstura hasa karibu na mdomo, macho na nyusi ni muhimu. Chanzo kinaeleza kuwa LBP inaweza kutumiwa kunasa tofauti za tekstura ya eneo zinazohusishwa na mabadiliko ya msemo kama kutabasamu, kukunja uso au kuinua nyusi.
Kwa upande wa MATLAB, chanzo hutumia kazi ya extractLBPFeatures kwa mchakato huu.
Njia mbadala ya HOG
Chanzo pia kinaorodhesha Histogram of Oriented Gradients (HOG) kama njia mbadala ya uchimbaji wa sifa. HOG hufupisha usambazaji wa gradienti zenye mwelekeo katika ukubwa wa picha ili kutoa sifa kuhusu umbo na miundo ya kingo. Hata hivyo, matokeo ya nambari ya %65 katika utafiti yanaunganishwa wazi na mbinu ya “SVM with LBP Features”; hakuna thamani tofauti ya utendaji iliyotolewa kwa HOG.
Jukumu la SVM
Support Vector Machine ni mbinu ya ujifunzaji wa mashine unaosimamiwa inayojifunza mpaka wa uamuzi unaotenganisha madarasa tofauti kutokana na mifano ya mafunzo. Chanzo kinaeleza kuwa SVM hutumika sana katika uainishaji wa FER kwa sababu hufanya kazi vizuri katika nafasi za sifa zenye vipimo vingi.
Katika mfano wa MATLAB, mafunzo ya modeli kwa fitcsvm na uainishaji wa sifa za majaribio kwa predict yanaonyeshwa.
Katika sehemu ya “Mathematical Formulation”, chanzo kinasema tatizo la uboreshaji la SVM linalenga kupata hyperplane inayotenganisha madarasa kwa njia bora. Hata hivyo, kwa kuwa mlinganyo halisi wa uboreshaji haujaonyeshwa wazi katika PDF iliyochapishwa, Verianla haiongezi mlinganyo wa kawaida wa SVM kana kwamba ni fomula ya chanzo.
Utegemezi mkuu wa mbinu ya jadi
Katika mkondo wa LBP + SVM, uwakilishi wa sifa hubuniwa wazi kabla ya kiainishaji. Yaani, ili modeli iweze kufanya uamuzi, kwanza hutumiwa LBP, ambayo ni mbinu ya uwakilishi wa picha iliyochaguliwa na binadamu. Tofauti kuu ya mbinu ya CNN ni kwamba inaingiza pia uchimbaji wa sifa ndani ya mchakato wa kujifunza.
FER Inayotegemea CNN Imeundwaje katika Utafiti Huu?
CNN iliyopendekezwa katika chanzo ni usanifu mdogo wa ujifunzaji wa kina unaopokea picha za uso za njia moja zenye ukubwa wa pikseli 48 × 48 kama ingizo; unajumuisha tabaka za konvolusheni, batch normalization, ReLU, max pooling, tabaka lililounganishwa kikamilifu, softmax na uainishaji. Mtandao hufundishwa kwa kutumia MATLAB Deep Learning Toolbox na njia ya uboreshaji ya Adam.
Tabaka za CNN zilizotolewa katika chanzo
| Tabaka | Muundo uliotolewa katika chanzo | Kazi |
|---|---|---|
| Ingizo | 48 × 48 × 1 | Hupokea picha ya uso ya kijivu. |
| Konvolusheni | 3 × 3 kichujio, njia 8, same padding | Huchimba mifumo ya eneo ya anga. |
| Batch normalization | batchNormalizationLayer | Hudhibiti kipimo cha uanzishaji wa kati wakati wa mafunzo. |
| Uanzishaji | ReLU | Hutoa ubadilishaji wa sifa usio wa mstari. |
| Pooling | 2 × 2, stride 2 | Hupunguza azimio la anga na mzigo wa hesabu. |
| Imeunganishwa kikamilifu | matokeo 7 | Imefafanuliwa kuzalisha alama za madarasa. |
| Softmax | softmaxLayer | Hubadilisha alama za madarasa kuwa usambazaji wa uwezekano wa jamaa. |
| Uainishaji | classificationLayer | Hudhibiti hasara ya uainishaji na darasa la matokeo wakati wa mafunzo. |
Kutolingana kati ya madarasa sita ya misemo na matokeo saba
Sehemu za muhtasari na utangulizi za makala zinaeleza wazi kuwa mfumo unalenga kutambua misemo sita ya msingi: furaha, huzuni, hasira, mshangao, hofu na kuchukizwa. Hata hivyo, katika msimbo wa CNN, tabaka la mwisho lililounganishwa kikamilifu lina matokeo saba. Chanzo hakielezi ikiwa darasa la saba ni “neutral” au msemo mwingine. Kwa hiyo sababu ya matokeo saba inabaki kuwa utata wa usanifu ambao haujatatuliwa katika chanzo.
Mipangilio ya mafunzo ya CNN
Chanzo hutumia njia ya uboreshaji ya Adam kwa mafunzo. Katika msimbo, idadi ya juu ya epoch imewekwa kuwa 10, mzunguko wa uthibitishaji ni 30 na kuonyesha grafu ya maendeleo ya mafunzo kunaombwa.
| Kigezo | Thamani |
|---|---|
| Optimizer | Adam |
| MaxEpochs | 10 |
| ValidationFrequency | 30 |
| Verbose | false |
| Training plot | training-progress |
Kwa upande mwingine, chanzo hakiripoti kiwango cha kujifunza, ukubwa wa mini-batch, random seed, njia ya kuongeza data, idadi ya picha za mafunzo na majaribio au sifa za vifaa.
Mbinu na Matokeo ya Utafiti
FER pipeline iliyoelezwa katika chanzo
Pipeline ya jadi ya MATLAB ya utafiti hufuata mpangilio huu:
- Kupakia picha za uso zenye lebo kutoka kwenye seti ya data.
- Kubadilisha picha ya uso kuwa kijivu.
- Kuboresha kontrasti kwa usawazishaji wa histogramu.
- Kutambua eneo la uso kwa kitambua uso kinachotegemea Viola-Jones.
- Kukata eneo la uso lililopatikana.
- Kuchimba sifa kwa msingi wa LBP au HOG.
- Kuainisha msemo kwa SVM.
Njia mbadala ya ujifunzaji wa kina inalenga kujifunza kwa pamoja sehemu za uchimbaji wa sifa na uainishaji ndani ya CNN.
Ulinganisho wa usahihi ulioripotiwa
| Mbinu | Mbinu ya sifa | Kiainishaji | Usahihi ulioripotiwa |
|---|---|---|---|
| FER ya jadi | Sifa zilizofafanuliwa kwa mkono kwa LBP | SVM | 65% |
| Ujifunzaji wa kina | Sifa zilizojifunza na CNN | CNN | 75% |
Kuna tofauti ya pointi 10 za asilimia kati ya thamani za chanzo. Huu ni ulinganisho wa majaribio ulioripotiwa katika makala pekee.
Je, CNN Imefanikiwa Zaidi kuliko LBP + SVM katika Utafiti Huu?
Kulingana na ulinganisho pekee wa usahihi ulioripotiwa katika chanzo, ndiyo: usahihi wa %75 umeripotiwa kwa CNN na %65 kwa SVM inayotumia sifa za LBP. Hata hivyo, kwa kuwa haijaelezwa ni seti gani ya data na itifaki gani ya train/test iliyotumika, tofauti hii ya pointi 10 za asilimia haithibitishi peke yake kwamba CNN ni bora kwa ujumla au kwa maana ya kitakwimu katika matatizo ya FER.
Maoni ya chanzo kuhusu CNN
Waandishi wanaeleza kuwa CNN zinaweza kujifunza kiotomatiki mifumo changamano ya picha katika maeneo kama macho, nyusi na mdomo kupitia tabaka, na kupunguza utegemezi wa uteuzi wa sifa kwa mkono. Kwa sababu hiyo, chanzo kinatathmini mbinu ya ujifunzaji wa kina kama suluhisho la FER lenye unyumbufu zaidi.
Hata hivyo, hakuna jaribio la ablation au ulinganisho wa usanifu unaoeleza kwa nini CNN ilipata hasa %75. Kwa mfano, athari tofauti za batch normalization, pooling au idadi ya vichujio hazijajaribiwa.
Taarifa zinazokosekana katika ulinganisho wa utendaji
Ili kulinganisha kwa kuaminika utendaji wa modeli ya FER, usahihi pekee huenda usitoshe. Taarifa zifuatazo hazijaripotiwa katika chanzo:
- Jumla ya idadi ya picha au watu.
- Idadi ya sampuli katika kila darasa.
- Seti halisi ya data iliyotumika.
- Uwiano wa mafunzo/uthibitishaji/majaribio.
- Ikiwa majaribio yasiyotegemea mtu yalitumika.
- Njia ya Cross-validation.
- Random seed.
- Confusion matrix.
- Precision kwa kila darasa.
- Recall kwa kila darasa.
- F1-score.
- Kipindi cha kujiamini.
- Wastani na mkengeuko sanifu wa majaribio yaliyorejelewa.
Kwa hiyo thamani za %65 na %75 zinapaswa kuhifadhiwa kama matokeo yaliyoripotiwa katika chanzo, lakini zisipanuliwe kama matokeo ya benchmark yenye usahihi wa juu.
Je, Darasa la Msemo wa Uso Linaonyesha kwa Uhakika Hisia Halisi ya Mtu?
Hapana. Miundo ya FER ya aina hii huainisha picha ya uso kwa mujibu wa madarasa ya misemo yanayoonekana yaliyofafanuliwa katika seti ya data ya mafunzo; uainishaji huu haupimi moja kwa moja hali halisi, ya ndani au ya muktadha ya kihisia ya mtu. Utafiti wa chanzo pia unatengeneza kiufundi mbinu ya uainishaji wa picha na hutoa thamani za %65 na %75 kwa kazi hii ya uainishaji.
Kwa nini tofauti hii ni muhimu?
Kwamba mwendo wa uso umehusishwa na lebo “anger” au “surprise” katika seti fulani ya data hakumaanishi kwamba mwonekano huo huo una maana moja na ya hakika ya kisaikolojia katika mazingira tofauti ya kitamaduni, binafsi au kimuktadha. Kwa hiyo, wakati wa kutathmini mifumo ya FER, utabiri wa darasa wa kialgoriti haupaswi kuchanganywa na hitimisho zenye nguvu zaidi kuhusu hali halisi ya kihisia ya binadamu.
Nguvu za utafiti
- Unaonyesha kwa namna ya kufundisha mkondo wa FER wa mwanzo hadi mwisho katika MATLAB.
- Unashughulikia mbinu ya jadi ya LBP + SVM pamoja na mbinu ya CNN ndani ya makala moja.
- Unaeleza uchakataji wa awali, utambuzi wa uso, uchimbaji wa sifa na uainishaji kama hatua tofauti.
- Unafanya vipengele vya msingi vya utekelezaji vionekane kupitia mifano ya msimbo wa MATLAB.
- Unaripoti moja kwa moja thamani za usahihi kwa mbinu za jadi na za ujifunzaji wa kina.
Mapungufu ya kimethodolojia ya utafiti
1. Hakuna itifaki ya mapitio ya kimfumo
Ingawa chanzo kinajiita mapitio ya kina, hakitoi hifadhidata ya fasihi, hoja ya utafutaji, kipindi cha tarehe, vigezo vya kujumuisha/kuondoa au mtiririko wa uteuzi wa tafiti. Kwa hiyo haiwezi kusemwa kuwa metodolojia ya mapitio ya kimfumo ilitumika.
2. Seti ya data ya majaribio haijabainishwa
CK+, JAFFE na FER2013 zimeorodheshwa kama mifano ya seti za data katika sehemu ya mbinu; lakini haijaelezwa ni ipi iliyotumika kupata matokeo ya %65 na %75.
3. Kuna kutolingana kwa madarasa sita na matokeo saba
Chanzo kinazungumzia madarasa sita ya msingi ya hisia, huku msimbo wa mfano wa CNN ukitumia tabaka lililounganishwa kikamilifu lenye matokeo saba.
4. Uhusiano wa mbinu za AdaBoost-SVM haujaelezwa
Kielelezo 1 kinaonyesha programu ya MATLAB inayotegemea AdaBoost; mbinu kuu ya kawaida katika maandishi ni LBP + SVM. Haijaelezwa jinsi mbinu hizi mbili zinavyohusiana ndani ya mpangilio mmoja wa majaribio.
5. Kuna kutolingana kunakoonekana katika mpangilio wa Vielelezo 3 na 4
Picha yenye kichwa “Before detection” inaonyesha skrini ya matokeo, ilhali picha yenye kichwa “after detection” inaonekana kama hali ya awali zaidi ya kiolesura cha mtumiaji.
6. Uundaji wa kihisabati haujakamilika
Tatizo la uboreshaji wa SVM na muundo wa kihisabati wa LBP vinatajwa kama vichwa, lakini hakuna milinganyo inayoonekana inayotolewa kwa ajili yake katika PDF.
7. Tathmini imepunguzwa kwenye accuracy pekee
Confusion matrix, precision, recall, F1 au utendaji wa kila darasa haujatolewa.
8. Maelezo ya urudiaji hayatoshi
Kwa kuwa mgawanyo wa data, kuongeza data, kiwango cha kujifunza, ukubwa wa batch, random seed na vifaa vilivyotumiwa havijaripotiwa, kurudia matokeo hayo moja kwa moja ni vigumu.
Matokeo yanayoungwa mkono na utafiti
- Inawezekana kujenga FER pipeline ya msingi kwa MATLAB.
- Kubadilisha kuwa kijivu, kusawazisha histogramu na kutambua uso kunaweza kutumika kama hatua za uchakataji wa awali.
- LBP inaweza kutumika kuwakilisha tekstura ya uso.
- SVM inaweza kuainisha misemo kwa kutumia sifa zilizochimbwa.
- CNN inaweza kuunganisha uchimbaji wa sifa na uainishaji katika mfumo mmoja wa kujifunza.
- Chanzo kinaripoti usahihi wa %65 kwa LBP + SVM na %75 kwa CNN.
Matokeo ambayo utafiti hauungi mkono
- Haijaonyeshwa kwamba CNN itatoa usahihi wa %75 katika seti zote za data za FER.
- Haijathibitishwa kwamba CNN ni bora kwa ujumla kuliko mbinu zote za jadi.
- Umuhimu wa kitakwimu wa tofauti ya usahihi ya %10 haujaonyeshwa.
- Hakuna kipimo cha latency au throughput katika matumizi halisi ya wakati halisi kilichotolewa.
- Uwezo wa kujumlisha katika tamaduni na makundi ya kidemografia haujatathminiwa.
- Haijaonyeshwa kwamba utabiri wa madarasa ya FER unaweza kuamua kwa uhakika hisia halisi ya ndani ya mtu.
Maelezo ya Chanzo na Mbinu
- Kichwa asili: Facial expression recognition using MATLAB: A comprehensive review and optimization approach
- Mwandishi 1: Borhan F Jumaa
- Mwandishi 2: Aoznor Y Zainal
- Mwandishi anayewajibika: Borhan F Jumaa
- Taasisi iliyoandikwa katika chanzo: Department of Computer Science, Kirkuk of University, Kirkuk, Iraq
- Jarida: International Journal of Computing and Artificial Intelligence
- Juzuu: 7
- Toleo: 1
- Sehemu: Part B
- Kurasa: 118–121
- Mwaka: 2026
- DOI: 10.33545/27076571.2026.v7.i1b.251
- E-ISSN: 2707-658X
- P-ISSN: 2707-6571
- Tarehe ya kupokelewa: 15-11-2025
- Tarehe ya kukubaliwa: 19-12-2025
- Mchapishaji: AkiNik Publications
- Aina ya chanzo: Mapitio ya FER ya masimulizi/kufundisha na mbinu ya utekelezaji wa MATLAB
- Hali ya mapitio: Tovuti rasmi ya jarida inaeleza uchapishaji kama peer-reviewed/refereed.
- Kiungo rasmi:https://doi.org/10.33545/27076571.2026.v7.i1b.251
Dokezo la kutolingana kwa kiufundi ndani ya chanzo
Ingawa chanzo kinafafanua madarasa sita ya misemo, katika mfano wa CNN kinatumia tabaka la mwisho lenye matokeo saba. Pia, uhusiano wa majaribio kati ya picha ya kiolesura cha AdaBoost na pipeline kuu ya SVM haujaelezwa, na kuna kutolingana kunakoonekana kati ya vichwa vya Vielelezo 3–4 na hali za skrini. Kwa kuwa masuala haya hayajatatuliwa katika chanzo, Verianla haijayasahihisha kimya kimya.
Dokezo la urudiaji
Chanzo kinatoa baadhi ya amri za MATLAB, tabaka za CNN na chaguo za mafunzo; hata hivyo, hakina mgawanyo wa data, idadi ya sampuli, kiwango cha kujifunza, ukubwa wa mini-batch, random seed, kuongeza data na taarifa za vifaa zinazohitajika kurudia matokeo kikamilifu. Kwa hiyo, thamani za usahihi za %65 na %75 zinapaswa kuwasilishwa kama matokeo yaliyochapishwa, lakini si kama vipimo vya benchmark vilivyothibitishwa kwa kujitegemea.
Kikomo cha tafsiri ya kisayansi
Mfumo wa FER unaozingatiwa na utafiti ni mfumo wa uoni wa kompyuta unaoainisha picha za uso kulingana na makundi ya lebo yaliyotumiwa wakati wa mafunzo. Utafiti huu hauonyeshi kwamba hali halisi ya kisaikolojia au kihisia ya mtu inaweza kuamuliwa kwa uhakika kutokana na picha ya uso pekee.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *