

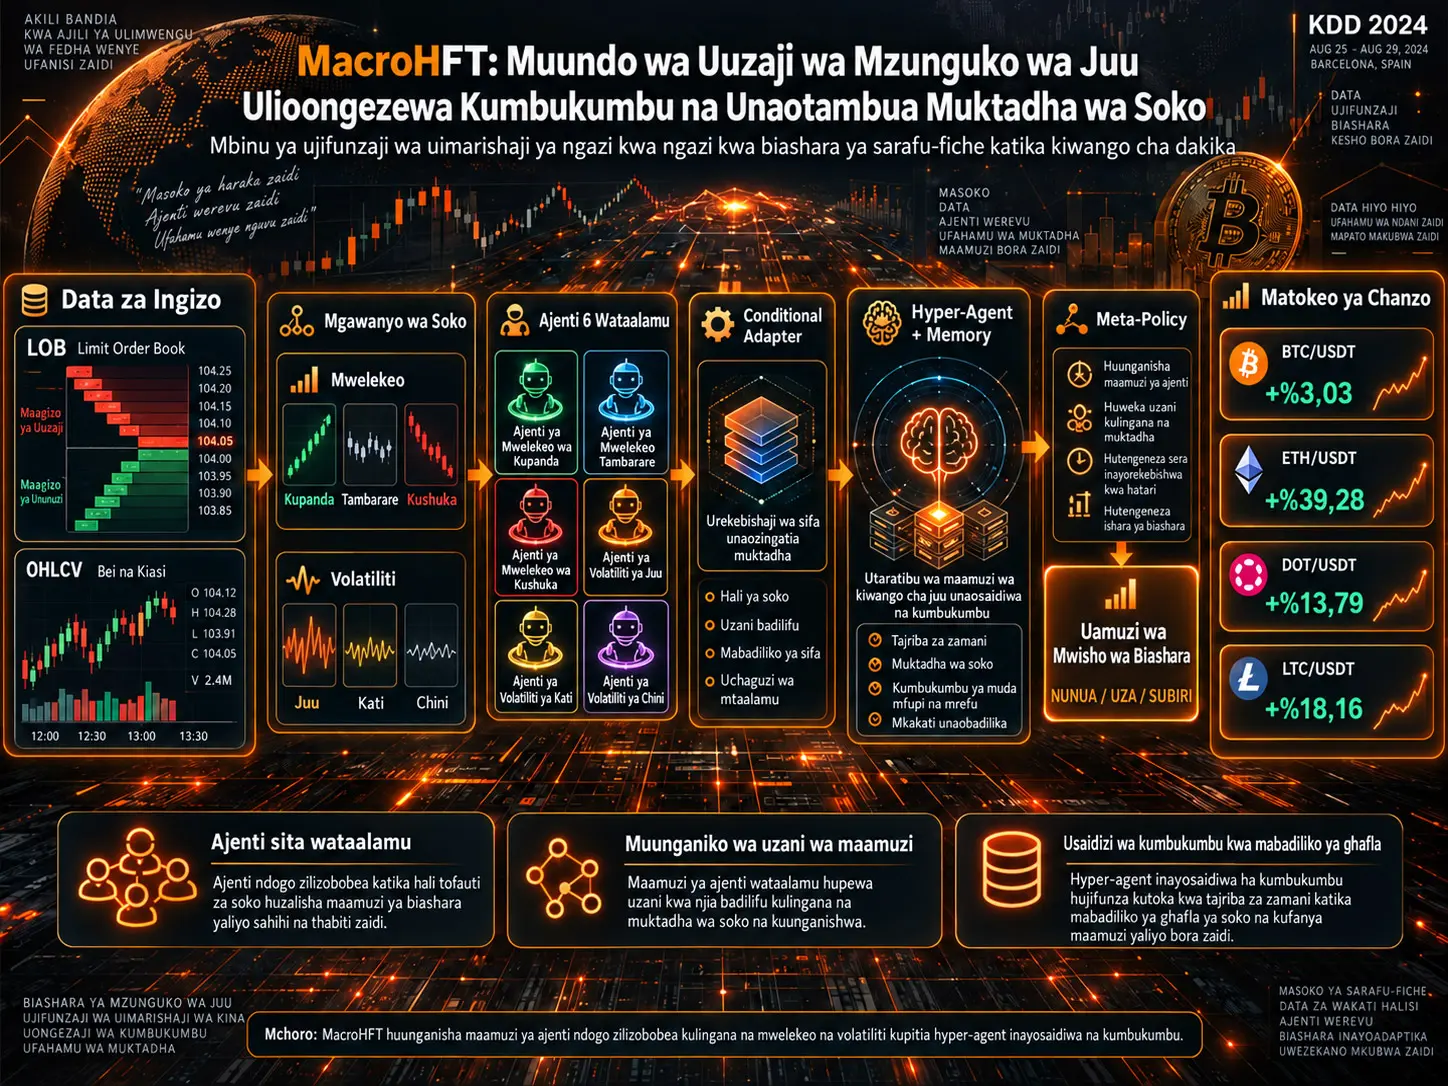
MacroHFT ni mfumo wa ujifunzaji wa uimarishaji wa kihierarkia unaosaidiwa na kumbukumbu na unaozingatia muktadha, uliotengenezwa ili kuweza kuzoea hali za soko zinazobadilika katika biashara ya fedha za kidijitali kwa kiwango cha dakika. Mbinu iliyotengenezwa na Chuqiao Zong, Chaojie Wang, Molei Qin, Lei Feng, Xinrun Wang na Bo An, badala ya kutarajia trading agent mmoja ajifunze mifumo yote ya soko, huunda sub-agent wanaobobea katika hali tofauti za trend na volatility na kuunganisha maamuzi yao kupitia hyper-agent.
Tatizo la msingi la utafiti ni kwamba soko la kripto si tulivu. trading policy ileile inaweza isitoe matokeo sawa katika masoko yanayopanda, yanayoshuka, yanayosogea kando, yenye volatility ya juu au yenye volatility ya chini. Standard RL agents pia wanaweza kuzoea kupita kiasi viashiria fulani na hivyo kutotumia vya kutosha muktadha wa soko wa kipindi cha karibu. MacroHFT hushughulikia matatizo haya kupitia mifumo minne inayokamilishana: market decomposition, conditional adaptation, policy mixture na episodic memory.
Katika hatua ya kwanza, data za kila dakika hugawanywa katika makundi sita tofauti kulingana na viashiria vya trend na volatility: Bull, Medium Trend, Bear, Volatile, Medium Volatility na Stable. Katika kila kundi la data, sub-agent tofauti inayotegemea DDQN hufunzwa. Kila sub-agent inaweza kutumia muktadha wa sasa wa soko pamoja na taarifa ya nafasi iliyopo kupitia conditional adapter ili kupanua au kuhamisha uwakilishi wake wa ndani wa hali.
Katika hatua ya pili, hyper-agent haichagui mmoja tu kati ya hawa mawakala sita wataalamu. Hutoa uzito wa softmax kwa Q-values za kila sub-agent na kuziunganisha ili kuunda meta-policy moja. Kwa njia hii mfumo unaweza kutumia mitazamo ya wataalamu tofauti kwa wakati mmoja. Hyper-agent pia hutumia memory module inayohifadhi uzoefu wa hivi karibuni wa soko ili kunufaika na hali zinazofanana za soko katika kipindi cha karibu kilichopita.
Katika simuleringi za kihistoria zilizofanywa kwenye BTC/USDT, ETH/USDT, DOT/USDT na LTC/USDT, MacroHFT iliripoti Total Return ya %3,03, %39,28, %13,79 na %18,16 mtawalia. Katika matokeo ya Jedwali 1 la utafiti, mfumo ulizalisha Total Return ya juu kuliko mbinu zilizolinganishwa katika seti zote nne za data; pia ulionyesha matokeo imara katika sehemu kubwa ya vipimo vilivyorekebishwa kwa hatari.
Hata hivyo, matokeo haya si live exchange deployment. Mfumo hufanya maamuzi katika kiwango cha dakika, gharama ya muamala imeundwa kuwa %0,02 isiyobadilika, na network latency, exchange queue priority, market impact pamoja na miundombinu halisi ya uendeshaji wa HFT havikupimwa kwa majaribio.
Kwa Nini MacroHFT Hutumia Wataalamu Wengi Badala ya RL Agent Mmoja?
Masoko ya fedha za kidijitali yanaweza kubadilika haraka kwa upande wa mwelekeo wa bei na volatility. Ndani ya mfululizo mrefu wa muda, vipindi vya kupanda, kushuka, kusogea kando, volatility ya juu na volatility ya chini vinaweza kufuatana. RL agent mmoja kujifunza tabia hizi zote ndani ya policy moja kunaweza kusababisha matatizo ya overfitting na policy bias.
Kwa sababu hiyo MacroHFT kwanza hugawanya soko katika mienendo tofauti. Chanzo hutumia vigezo viwili vya msingi:
- Trend: mteremko wa linear regression baada ya low-pass filter kutumika kwenye mfululizo wa muda wa bei.
- Volatility: wastani wa mabadiliko ya bei katika kipande husika cha data.
Kila kipande cha mfululizo wa muda kwanza hugawanywa katika chunk zenye urefu usiobadilika. Kwa kutumia mgawanyo wa quantile wa thamani za trend, makundi matatu huundwa:
- Bull — trend chanya,
- Medium — trend iliyo karibu kuwa ya kando,
- Bear — trend hasi.
Kando na hayo, kwa kutumia quantile za volatility:
- Volatile — volatility ya juu,
- Medium — volatility ya kati,
- Stable — volatility ya chini
makundi huundwa.
Jambo muhimu hapa ni kwamba utafiti hauundi mawakala tisa kutokana na mchanganyiko wa kuvukiza lebo za trend na volatility. Makundi matatu ya trend na makundi matatu ya volatility hutumiwa kama seti ndogo tofauti za data, na jumla ya sub-agent sita hufunzwa.
Conditional Adapter Hufanya Nini?
Conditional adapter ni utaratibu unaobadilisha trading policy ya sub-agent si kwa kuzingatia tu bei ya wakati huo na hali ya order-book, bali pia muktadha wa soko wa kipindi cha karibu na nafasi iliyopo.
Low-level state ina vipengele vitatu:
Hapa:
- \(s_{lt}^{1}\): vipengele vya single-state vinavyotolewa kutoka snapshot ya sasa ya LOB na OHLCV,
- \(s_{lt}^{2}\): vipengele vya context vinavyotolewa kutoka taarifa za soko katika hatua 60 za mwisho za muda,
- \(P_t\): ni nafasi ya sasa ya trader.
Taarifa za single-state na context huwakilishwa katika neural layer tofauti. Nafasi iliyopo pia hubadilishwa kuwa embedding:
Hapa \(c\) ni conditional representation iliyounganisha muktadha wa soko na hali ya sasa ya holding.
Conditional representation huzalisha vekta mbili:
na state representation hupimwa upya na kuhamishwa:
Chanzo kinaeleza kuwa muundo huu umechochewa na wazo la Adaptive Layer Norm katika Diffusion Transformer.
Lengo kuu ni kurahisisha, kwa mfano, harakati ileile ya bei kuzalisha Q-value tofauti kulingana na kama trader tayari yuko kwenye nafasi au la, au kulingana na utawala wa karibu wa trend/volatility.
Low-Level DDQN Agents Hufunzwaje?
Msingi wa kila sub-agent ni Double Deep Q-Network (DDQN) pamoja na usanifu wa dueling-network.
Muundo wa Dueling hugawanya Q-value kuwa state value na action advantage:
Training loss haijumuishi tu TD error ya kawaida. Optimal Value Supervisor iliyotumika katika utafiti wa EarnHFT pia imejumuishwa:
Hapa \(Q^*\) ni Q-value bora inayokokotolewa kwa dynamic programming katika hali iliyotolewa. Hivyo sub-agent haiongozwi tu na uzoefu wake wa utafutaji, bali pia na taarifa iliyokokotolewa ya optimal action-value.
Tofauti Kuu Kati ya MacroHFT na EarnHFT ni Nini?
EarnHFT huunda agent pool iliyofunzwa katika trend tofauti za soko, na router huchagua agent mmoja kati yao kulingana na hali ya sasa ya soko. MacroHFT hufanya mabadiliko mawili muhimu.
Kwanza, soko haligawanywi kwa trend pekee, bali kwa trend + volatility.
Pili, na muhimu zaidi, badala ya hyper-agent kuchagua mmoja wa sub-agent, huweka uzito kwenye Q-values za sub-agent wote:
Katika MacroHFT, \(N=6\).
Final action:
huamuliwa kwa njia hiyo.
Kwa hiyo meta-policy katika MacroHFT si “agent selector”, bali ni muundo wa policy mixture.
Kwa Nini Hyper-Agent Huongezewa Kumbukumbu?
Katika soko la kripto, matokeo ya muda mfupi ya hali mbili zinazoonekana kufanana yanaweza kuwa tofauti sana. Pia, harakati adimu kama crash, rebound ya haraka au breakout zinaweza kuwakilishwa kwa kiwango kidogo ndani ya replay buffer ya kawaida.
Kwa hili, MacroHFT hufafanua episodic memory ya jedwali yenye uwezo mdogo:
Hapa:
- \(K\): vekta za key zinazoundwa na state encoder,
- \(E\): jozi za state-action experience,
- \(V\): thamani zilizokokotolewa za uzoefu.
Uzoefu mpya unapowasili:
huundwa na \((k,(s,a),v)\) huandikwa kwenye memory.
Kumbukumbu inapofikia uwezo wake wa juu, mbinu ya FIFO hutumiwa; rekodi ya zamani zaidi hufutwa. Lengo la muundo huu ni kudhani kuwa historia ya karibu ya soko ina thamani zaidi kwa uamuzi wa sasa.
Hyper-agent hutafuta uzoefu \(m\) ulio karibu zaidi na state ya sasa kwa kutumia umbali wa L2:
na huunda memory Q-target kutokana na uzoefu huo:
Thamani hii huingia kama supervision ya ziada kwenye RL target ya kawaida ya hyper-agent:
Maandishi ya chanzo yanaeleza kuwa uzoefu wa karibu na unaofanana utatumika kwa ufanisi zaidi. Hata hivyo, katika Equation (7) iliyochapishwa, uzito wa attention kuonekana kuwa sawia moja kwa moja na umbali wa L2 huleta utata wa kihisabati katika notation; chanzo hakifafanui suala hili zaidi.
Limit Order Book na Ingizo za Kiufundi Hutumikaje?
Chanzo kinatumia Limit Order Book yenye viwango vitano:
Katika kila kiwango kuna bei ya bid/ask na kiasi kinachopatikana.
Pamoja na hayo, taarifa ya OHLCV:
hutumiwa.
Katika Jedwali la Nyongeza 4, vipengele vingi vya kiufundi vinafafanuliwa. Miongoni mwake ni:
- vipimo vya candle body na wick,
- kiasi kilichonormalishwa cha viwango vitano vya bid/ask,
- weighted average prices,
- buy/sell spreads,
- buy/sell volume,
- volume imbalance,
- price spread,
- vipimo vya VWAP,
- bid/ask log returns,
- WAP log returns,
- rolling trend features za hatua 60 za muda
vinapatikana.
Kwa mfano, volume imbalance:
na price spread:
hufafanuliwa hivyo.
Mbinu na Matokeo ya Utafiti
Seti za data
| Soko | Training | Validation | Test |
|---|---|---|---|
| BTC/USDT | 05.03.2022 – 22.02.2023 | 18.03.2023 – 15.06.2023 | 22.06.2023 – 15.10.2023 |
| ETH/USDT | 01.02.2022 – 31.01.2023 | 01.02.2023 – 31.05.2023 | 01.06.2023 – 31.10.2023 |
| DOT/USDT | 01.02.2022 – 31.01.2023 | 01.02.2023 – 31.05.2023 | 01.06.2023 – 31.10.2023 |
| LTC/USDT | 01.02.2022 – 31.01.2023 | 01.02.2023 – 31.05.2023 | 01.06.2023 – 31.10.2023 |
Katika mgawanyo wa data ya BTC, kuna vipindi vya muda vilivyo wazi kwenye jedwali la chanzo kati ya vipindi vya training, validation na test; Verianla haikuvijaza kiotomatiki.
Trading setup
Majaribio yalifanywa kwenye 4 NVIDIA RTX 4090 GPU.
Transaction commission:
iliwekwa hivyo, na chanzo kinaeleza kuwa inaendana na sera ya Binance.
Urefu wa Training chunk:
- BTC/USDT: dakika 360 = saa 6,
- ETH/USDT, DOT/USDT na LTC/USDT: dakika 4320 = siku 3.
Kila sub-agent ilifunzwa kwa 15 epoch; hyper-agent pia kwa 15 epoch.
Kwa parameter zote za neural-network, Adam optimizer na:
vilitumika.
Kigezo cha optimal supervisor cha sub-agent:
kilichaguliwa kulingana na utendaji wa validation.
Kwa hyper-agent:
na kigezo cha memory-loss:
vilijaribiwa. Kwa DOT/USDT \(\beta=1\), na kwa masoko mengine matatu \(\beta=5\) kilichaguliwa.
Mbinu zilizolinganishwa
MacroHFT ililinganishwa na baseline nane:
- DQN,
- DDQN,
- PPO,
- CDQNRP,
- CLSTM-PPO,
- EarnHFT,
- Imbalance Volume (IV),
- MACD.
Vipimo vya tathmini
Vipimo sita vya kifedha vilitumika:
- Total Return (TR),
- Annual Sharpe Ratio (ASR),
- Annual Calmar Ratio (ACR),
- Annual Sortino Ratio (ASoR),
- Annual Volatility (AVOL),
- Maximum Drawdown (MDD).
Total Return:
Annual Volatility inategemea ku-annualize return za kila dakika kwa dhana ya dakika 525.600 kwa mwaka:
Annual Sharpe Ratio:
Matokeo makuu ya utendaji
| Soko | TR (%) | ASR | ACR | ASoR | AVOL (%) | MDD (%) | Trading Number |
|---|---|---|---|---|---|---|---|
| BTC/USDT | 3,03 | 0,61 | 2,06 | 0,34 | 18,19 | 5,41 | 19 |
| ETH/USDT | 39,28 | 3,89 | 8,41 | 2,49 | 20,93 | 9,67 | 20 |
| DOT/USDT | 13,79 | 0,97 | 2,45 | 0,68 | 40,31 | 15,89 | 38 |
| LTC/USDT | 18,16 | 1,50 | 3,11 | 0,66 | 29,59 | 14,24 | 138 |
Kulingana na Jedwali 1 na Kielelezo 3 cha chanzo, MacroHFT ilizalisha Total Return ya juu zaidi katika masoko yote manne.
BTC/USDT
Wakati MacroHFT ilizalisha return ya %3,03, matokeo ya BTC ya baseline zote zilizolinganishwa katika chanzo yalikuwa hasi. Kwa mfano, CDQNRP iliripoti −%1,51, PPO −%9,15, EarnHFT −%11,16 na MACD −%18,99.
Hata hivyo, baadhi ya miundo yenye return hasi ilizalisha AVOL au MDD ya chini zaidi. Kwa hiyo matokeo ya return ya juu zaidi ya MacroHFT hayamaanishi “hatari ya chini zaidi katika vipimo vyote vya hatari”.
ETH/USDT
MacroHFT:
iliripoti.
Katika test hiyo hiyo, EarnHFT ilizalisha %18,02, IV %0,56 na PPO −%2,12 return.
MacroHFT pia inaripoti:
thamani hizo.
DOT/USDT
MacroHFT ilizalisha Total Return ya %13,79. IV ni mbinu nyingine imara iliyozalisha return chanya ya %10,58; EarnHFT ni −%2,67 na MACD −%20,29.
LTC/USDT
MacroHFT ilizalisha return ya %18,16. IV %7,75, EarnHFT %0,54; huku MACD ikiwa −%13,16.
Je, Hyper-Agent Huchanganya Wataalamu Tofauti Kweli?
Kielelezo 5 cha chanzo kinaonyesha uzito ambao hyper-agent hutoa kwa sub-agent sita tofauti kadiri muda unavyopita katika test ya BTC/USDT. Uzito si wa kudumu; kadiri muktadha wa soko unavyobadilika, mtaalamu anayetawala pia hubadilika.
Taswira hii inaonyesha kuwa MacroHFT haiundi tu mawakala tofauti wakati wa training, bali wakati wa inference pia hubadilisha kwa kuendelea contribution ya wataalamu kulingana na hali ya soko.
Je, Conditional Adapter na Memory Ni Muhimu Kweli?
Majaribio ya ablation hutathmini athari za vipengele viwili vya msingi kimoja baada ya kingine:
- w/o-CA: MacroHFT bila conditional adapter,
- w/o-MEM: MacroHFT bila memory mechanism.
| Soko | Modeli | TR (%) | ASR | MDD (%) |
|---|---|---|---|---|
| BTC | w/o-CA | 1,69 | 0,36 | 7,24 |
| BTC | w/o-MEM | 2,03 | 0,49 | 6,49 |
| BTC | MacroHFT | 3,03 | 0,61 | 5,41 |
| ETH | w/o-CA | 14,27 | 2,42 | 7,57 |
| ETH | w/o-MEM | 12,73 | 1,26 | 20,87 |
| ETH | MacroHFT | 39,28 | 3,89 | 9,67 |
| DOT | w/o-CA | -16,79 | -1,18 | 31,66 |
| DOT | w/o-MEM | 2,41 | 0,34 | 27,23 |
| DOT | MacroHFT | 13,79 | 0,97 | 15,89 |
| LTC | w/o-CA | -6,71 | -0,36 | 18,83 |
| LTC | w/o-MEM | -8,66 | -0,58 | 22,03 |
| LTC | MacroHFT | 18,16 | 1,50 | 14,24 |
Tofauti kubwa zaidi zinaonekana katika masoko ya DOT na LTC. Chanzo kinaeleza kuwa katika vipindi hivi vya test, thamani ya soko ilishuka kwa takriban %14,85 kwa DOT na takriban %24,94 kwa LTC.
Katika LTC, wakati MacroHFT kamili ilizalisha return ya %18,16, kuondoa conditional adapter kulitoa −%6,71 na kuondoa memory kulitoa −%8,66 return.
Katika ETH, MacroHFT ilizalisha return ya %39,28, huku w/o-CA ikiwa %14,27 na w/o-MEM %12,73. Hata hivyo, kwa upande wa MDD, w/o-CA ikiwa %7,57 ni ya chini kuliko thamani ya %9,67 ya MacroHFT kamili. Kwa hiyo hata matokeo ya ablation hayaonyeshi ubora kamili katika vipimo vyote vya hatari.
Memory Mechanism Hutoa Nini Katika Harakati za Ghafla za Soko?
Katika Kielelezo 6 cha chanzo, memory inapoondolewa katika soko la ETH, modeli haiwezi kujibu kwa kasi ya kutosha kushuka kwa ghafla kwa bei na hasara kubwa hutokea. Conditional adapter inapoondolewa, modeli haiwezi kubadilisha trading policy kwa kiwango cha kutosha wakati soko linahama kutoka hali ya flat/bear kwenda hali ya bull, hivyo hupoteza fursa ya kupanda.
Waandishi wanafasiri uchunguzi huu kama ushahidi wa kitabia kwamba memory ni muhimu katika harakati za ghafla na adimu za bei, huku conditional adapter ikiwa muhimu katika mabadiliko ya regime.
Mifano ya Trading Iliyoonyeshwa Katika Chanzo Inaeleza Nini?
Kielelezo 4 cha chanzo kinaonyesha mifano minne.
ETH
Waandishi wanafasiri modeli kama mkakati unaonasa fursa ya “breakout” katika ongezeko la muda mfupi. Nafasi hufunguliwa na kufungwa ndani ya harakati fupi.
DOT
MacroHFT hudumisha nafasi yake katika sehemu ya ongezeko la muda mrefu, ikionyesha tabia ya trend-following, na baadaye hutoka kwenye nafasi.
LTC
Katika kuporomoka kwa bei, tabia ya kutoka inayofanana na stop-loss huonyeshwa, ikifuatiwa na mfano wa nafasi mpya yenye faida wakati wa rebound.
BTC
Operesheni zinazojaribu kutumia ongezeko ndogo ndani ya soko la jumla lenye mwelekeo wa kushuka zinaonyeshwa.
Mifano hii minne si formal trading rules za mbinu. Ni tafsiri za ex-post za waandishi kuhusu trading behavior inayozalishwa na modeli.
Matokeo Yanayoungwa Mkono na Utafiti
- Kufunza sub-agent wataalamu kwa kutumia trend na volatility kama vigezo tofauti kumeunda muundo wa kihierarkia wa RL unaofanya kazi katika masoko ya kripto yaliyojaribiwa.
- Conditional adapter huwezesha muktadha wa sasa wa soko na nafasi kuwa na athari ya moja kwa moja zaidi kwenye low-level Q-policy.
- Badala ya kuchagua mtaalamu mmoja, hyper-agent inayochanganya Q-values za sub-agent sita imezalisha matokeo imara katika seti za data zilizojaribiwa.
- Kuondoa memory mechanism kumepunguza utendaji kwa kiasi kikubwa, hasa katika baadhi ya test zenye harakati za ghafla za soko.
- Kuondoa conditional adapter kumedhoofisha uwezo wa kuzoea mabadiliko ya regime.
- MacroHFT ilizalisha Total Return chanya katika seti zote nne za data za test na iliripoti Total Return iliyo juu ya baseline zote katika Jedwali 1 la chanzo.
- Modeli pia ilizalisha return chanya katika seti za data kama DOT na LTC ambako bei ya jumla ya soko ilishuka kwa kasi katika kipindi cha test.
- Kutumia policy mixture badala ya single-agent routing ya EarnHFT ni mojawapo ya tofauti kuu za usanifu wa utafiti huu.
Ujumlishaji Ambao Utafiti Hauungi Mkono
- Haijaonyeshwa kwamba MacroHFT itazalisha return zilezile kwenye Binance ya moja kwa moja au exchange nyingine.
- Haijaonyeshwa kwamba return ya %39,28 ya ETH au %18,16 ya LTC itajirudia siku zijazo.
- Modeli haipimi muda wa microsecond au nanosecond execution wa mifumo ya kawaida ya ultra-low-latency HFT.
- exchange queue priority, network jitter, packet loss, API throttling au faida ya co-location katika mazingira halisi havijaundwa kwa majaribio.
- Jinsi market impact itakavyobadilisha matokeo katika nafasi kubwa haijajaribiwa kwa kina.
- Muundo wa long-position pekee hauwakilishi mikakati yote halisi ya HFT.
- Matokeo yaliyopatikana kwenye fedha nne za kidijitali hayawezi kujumlishwa kwa token, exchange au vipindi vyote vya soko.
- Haijaonyeshwa kwamba conditional adapter au memory components kila kimoja peke yake kitatoa ongezeko la utendaji la ukubwa uleule katika kila trading algorithm.
Vikwazo Vikuu vya Kimethodolojia
Kwanza, modeli inaruhusu tu nafasi za \(P_t\geq0\); yaani, hakuna muundo wa short-selling. Hili ni rahisisho muhimu ikilinganishwa na nafasi ya mikakati ya mifumo halisi ya kripto HFT.
Pili, gharama ya muamala inachukuliwa kuwa %0,02 isiyobadilika katika masoko yote manne. trading fee, spread na execution cost halisi zinaweza kubadilika kulingana na trader tier, exchange, aina ya order na hali ya soko.
Tatu, trading interval ni dakika moja. Hii inaweza kutoa mzunguko wa juu wa maamuzi, lakini ni kiwango cha muda tofauti sana na ushindani wa microsecond/nanosecond latency katika HFT ya kawaida ya market-microstructure.
Nne, mfumo umejaribiwa kwenye crypto trading pair nne. Idadi ya masoko ni ndogo kwa ujumlishaji mpana wa kimataifa.
Tano, chaguo za model-selection na hyperparameter zinategemea return za vipindi vya validation. Ingawa mbinu hii husaidia kulinda test set, haiwezi kuondoa kabisa utegemezi wa mchakato wa model-development kwa regime fulani za kihistoria.
Sita, chanzo kinaacha hoja ya kihisabati isiyo wazi kati ya umbo lililochapishwa la Equation (7), linalotumiwa katika uwekaji uzito wa uzoefu wa karibu wa memory mechanism, na maelezo ya maandishi ya “kutumia uzoefu ulio karibu zaidi kulingana na ufanano”.
Maelezo ya Chanzo na Mbinu
Kichwa asili: MacroHFT: Memory Augmented Context-aware Reinforcement Learning On High Frequency Trading.
Waandishi: Chuqiao Zong, Chaojie Wang, Molei Qin, Lei Feng, Xinrun Wang na Bo An.
Mwandishi wa mawasiliano: Chaojie Wang.
Taasisi: Nanyang Technological University; Skywork AI; Singapore University of Technology and Design.
Chapisho: Proceedings of the 30th ACM SIGKDD Conference on Knowledge Discovery and Data Mining, KDD ’24.
Mkutano: 25–29 Agosti 2024, Barcelona, Spain.
Mchapishaji: Association for Computing Machinery.
ACM ISBN: 979-8-4007-0490-1/24/08.
DOI: 10.1145/3637528.3672064.
arXiv: 2406.14537v1 [cs.LG], 20 Juni 2024.
Mbinu kuu: Memory-Augmented Context-aware Hierarchical Reinforcement Learning.
Low-level RL: Dueling DDQN + Optimal Value Supervisor + conditional adaptation.
High-level RL: mixture yenye uzito wa softmax ya Q-policies za sub-agent wote + episodic memory supervision.
Idadi ya sub-agent: 6.
Market decomposition: Bull, Medium Trend, Bear, Volatile, Medium Volatility na Stable.
Kina cha LOB: viwango 5.
Low-level context window: dakika 60.
Trading time resolution: dakika 1.
Action space: \(\{0,1\}\) nafasi lengwa.
Kizuizi cha nafasi: non-negative / long position pekee.
Commission: %0,02.
Masoko ya test: BTC/USDT, ETH/USDT, DOT/USDT na LTC/USDT.
Idadi ya baseline: 8.
Baselines: DQN, DDQN, PPO, CDQNRP, CLSTM-PPO, EarnHFT, Imbalance Volume na MACD.
Vipimo vya kifedha: TR, ASR, ACR, ASoR, AVOL na MDD.
GPU: 4 × NVIDIA RTX 4090.
Optimizer: Adam.
Learning rate: \(1\times10^{-4}\).
Training: Sub-agent 15 epoch; hyper-agent 15 epoch.
Return kuu za test: BTC %3,03; ETH %39,28; DOT %13,79; LTC %18,16.
Matokeo ya Ablation: Kuondoa conditional adapter na memory kumepunguza Total Return katika masoko yote manne; katika DOT na LTC, variant zilishuka hadi return hasi.
Funding: National Research Foundation, Singapore — Industry Alignment Fund – Pre-positioning (IAF-PP) Funding Initiative.
Code: Chanzo kinaeleza kuwa utekelezaji umechapishwa katika hazina ya GitHub ya ZONG0004/MacroHFT.
Dokezo la kiufundi ndani ya chanzo 1: Istilahi ya bid/ask order katika maelezo ya Low-level target-position haionekani kuendana kikamilifu kwa upande wa mwelekeo na ufafanuzi wa bid/ask uliotolewa katika sehemu hiyo hiyo.
Dokezo la kiufundi ndani ya chanzo 2: Ingawa maelezo ya Memory lookup yanasisitiza uzoefu ulio karibu zaidi, formula iliyochapishwa ya attention huweka uzito wa moja kwa moja kwenye umbali wa L2; chanzo hakielezi tofauti hii ya notation.
Mpaka mkuu wa kisayansi: Matokeo yanahusu trading simulation kwenye data za kihistoria za soko; si jaribio la live exchange execution wala tathmini ya mfumo wa uzalishaji wa ultra-low-latency HFT.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *