

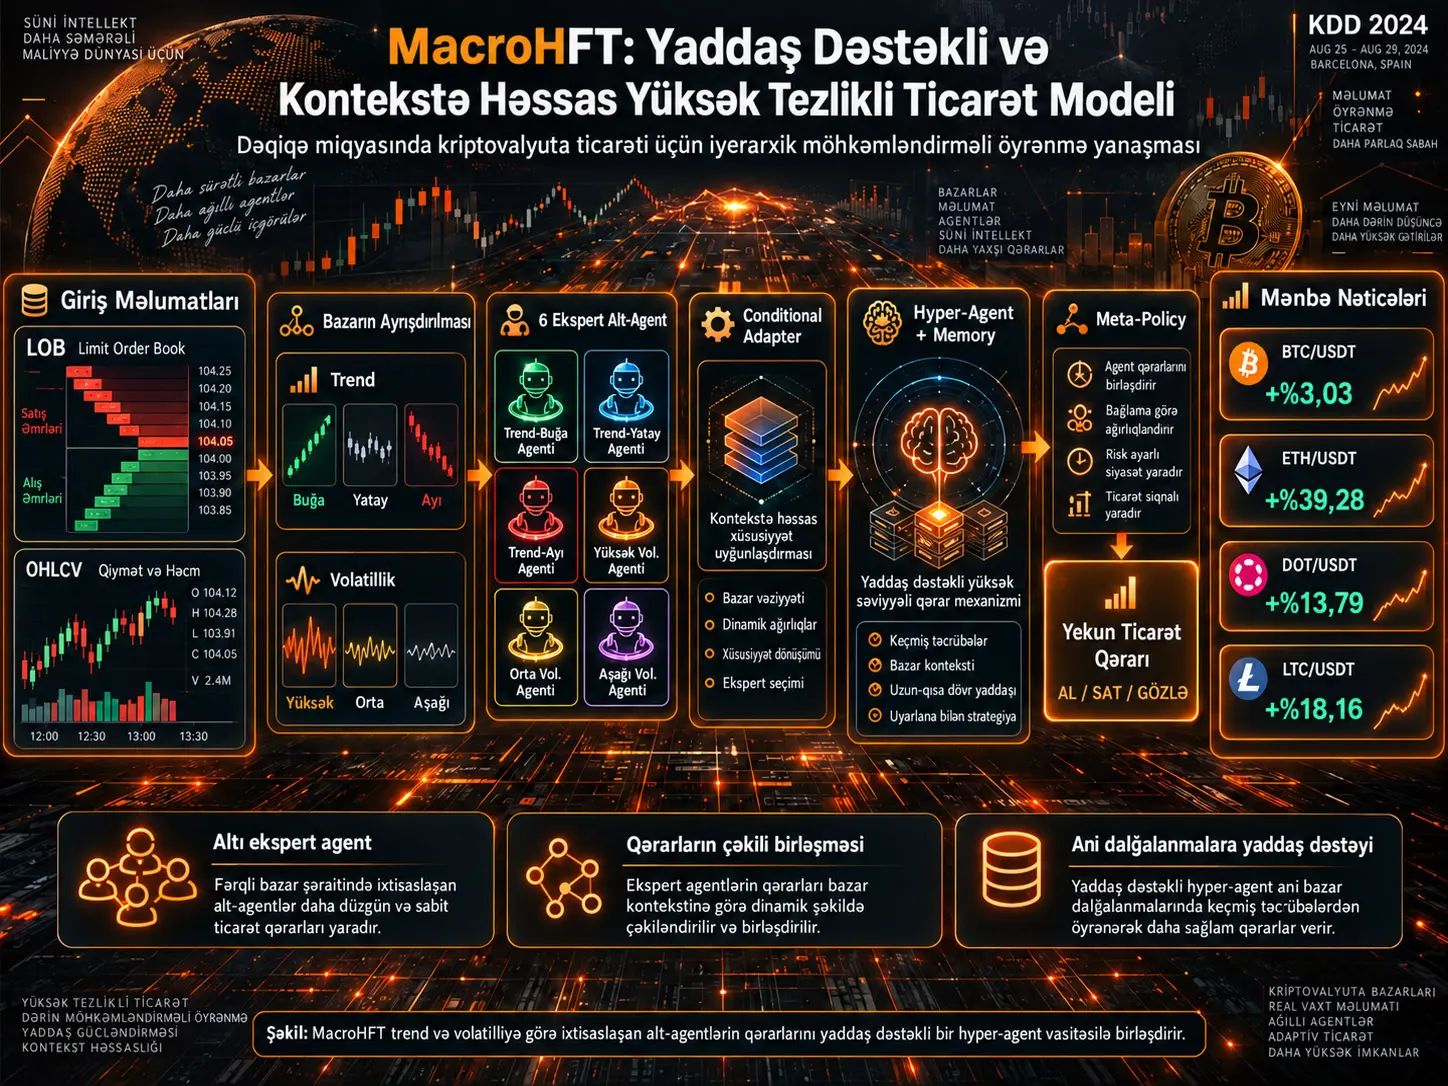
MacroHFT, dəqiqə miqyaslı kriptovalyuta alqı-satqısında dəyişən bazar şəraitinə uyğunlaşmaq məqsədilə hazırlanmış, yaddaş dəstəkli və kontekstə həssas iyerarxik möhkəmləndirici öyrənmə sistemidir. Chuqiao Zong, Chaojie Wang, Molei Qin, Lei Feng, Xinrun Wang və Bo An tərəfindən hazırlanmış metod, tək bir trading agentinin bütün bazar rejimlərini öyrənməsini gözləmək əvəzinə müxtəlif trend və volatillik şəraitində ixtisaslaşan alt-agentlər yaradır və onların qərarlarını hyper-agent vasitəsilə birləşdirir.
Tədqiqatın əsas problemi kripto bazarının stasionar olmamasıdır. Eyni trading policy yüksələn, enən, üfüqi, yüksək volatillikli və ya aşağı volatillikli bazarlarda eyni nəticəni verməyə bilər. Standart RL agentləri həmçinin müəyyən göstəricilərə həddindən artıq uyğunlaşaraq yaxın dövrdəki bazar kontekstindən kifayət qədər istifadə etməyə bilər. MacroHFT bu problemləri market decomposition, conditional adaptation, policy mixture və episodic memory olmaqla dörd tamamlayıcı mexanizmlə həll edir.
Birinci mərhələdə dəqiqəlik məlumatlar trend və volatillik göstəricilərinə görə altı müxtəlif qrupa bölünür: Bull, Medium Trend, Bear, Volatile, Medium Volatility və Stable. Hər məlumat qrupunda ayrıca DDQN əsaslı sub-agent öyrədilir. Hər alt-agent cari bazar konteksti ilə mövcud mövqe məlumatından conditional adapter vasitəsilə istifadə edərək öz daxili vəziyyət təmsilini miqyaslandıra və sürüşdürə bilər.
İkinci mərhələdə hyper-agent bu altı ekspert agentdən yalnız birini seçmir. Hər alt-agentin Q-dəyərlərinə softmax çəkisi verir və onları birləşdirərək vahid meta-policy yaradır. Beləliklə sistem müxtəlif ekspertlərin baxışlarından eyni anda istifadə edə bilir. Hyper-agent həmçinin son bazar təcrübələrini saxlayan memory module-dan istifadə edərək yaxın keçmişdəki oxşar bazar vəziyyətlərindən yararlanmağı hədəfləyir.
BTC/USDT, ETH/USDT, DOT/USDT və LTC/USDT üzərində aparılmış tarixi simulyasiyalarda MacroHFT müvafiq olaraq %3,03, %39,28, %13,79 və %18,16 Total Return bildirmişdir. Tədqiqatın Cədvəl 1 nəticələrində sistem dörd məlumat dəstinin hamısında müqayisə olunan metodlardan daha yüksək Total Return əldə etmiş; riskə uyğunlaşdırılmış metriklərin böyük hissəsində də güclü nəticələr göstərmişdir.
Bununla belə, nəticələr canlı exchange deployment nəticələri deyil. Sistem dəqiqə səviyyəsində qərar verir, əməliyyat xərci sabit %0,02 kimi modelləşdirilir və real network latency, exchange queue priority, market impact və əməliyyat HFT infrastrukturu eksperimental olaraq ölçülmür.
MacroHFT Niyə Tək Bir RL Agenti Əvəzinə Bir Neçə Ekspertdən İstifadə Edir?
Kriptovalyuta bazarları qiymət istiqaməti və volatillik baxımından sürətlə dəyişə bilər. Uzun zaman sırası daxilində yüksəliş, eniş, üfüqi hərəkət, yüksək volatillik və aşağı volatillik dövrləri ardıcıl mövcud ola bilər. Tək bir RL agentinin bütün bu davranışları vahid siyasət daxilində öyrənməsi overfitting və policy bias problemlərinə səbəb ola bilər.
MacroHFT buna görə əvvəlcə bazarı müxtəlif dinamikalara ayırır. Mənbə iki əsas meyardan istifadə edir:
- Trend: qiymət zaman sırasına low-pass filter tətbiq edildikdən sonra xətti reqressiya meyli.
- Volatillik: müvafiq məlumat parçasının orta qiymət dəyişkənliyi.
Hər zaman sırası parçası əvvəlcə sabit uzunluqlu chunk-lara bölünür. Trend dəyərlərinin quantile paylanmasından istifadə edilərək üç qrup yaradılır:
- Bull — müsbət trend,
- Medium — təxminən üfüqi trend,
- Bear — mənfi trend.
Ayrıca volatillik quantile-ları əsasında:
- Volatile — yüksək volatillik,
- Medium — orta volatillik,
- Stable — aşağı volatillik
qrupları yaradılır.
Buradakı mühüm detal ondan ibarətdir ki, tədqiqat trend və volatillik etiketlərinin çarpaz kombinasiyalarından doqquz agent yaratmır. Üç trend və üç volatillik qrupu ayrı məlumat alt-dəstləri kimi istifadə olunur və ümumilikdə altı sub-agent öyrədilir.
Conditional Adapter Nə Edir?
Conditional adapter, alt-agentin trading policy-sini yalnız ani qiymət və order-book vəziyyətinə deyil, yaxın dövr bazar kontekstinə və mövcud mövqeyə görə dəyişdirən mexanizmdir.
Low-level state üç komponentdən ibarətdir:
Burada:
- \(s_{lt}^{1}\): cari LOB və OHLCV snapshot-ından çıxarılan single-state xüsusiyyətləri,
- \(s_{lt}^{2}\): son 60 zaman addımındakı bazar məlumatından çıxarılan context xüsusiyyətləri,
- \(P_t\): treyderin mövcud mövqeyidir.
Single-state və context məlumatları ayrı neural layer-larda təmsil olunur. Mövcud mövqe də embedding-ə çevrilir:
Buradakı \(c\), bazar konteksti ilə mövcud holding vəziyyətinin birləşmiş conditional representation-ıdır.
Conditional representation iki vektor yaradır:
və state representation miqyaslanıb sürüşdürülür:
Mənbə bu dizaynın Diffusion Transformer-dəki Adaptive Layer Norm ideyasından ilhamlandığını bildirir.
Əsas məqsəd, məsələn, eyni qiymət hərəkətinin treyderin artıq mövqedə olub-olmamasına və ya yaxın dövrdəki trend/volatillik rejiminə görə fərqli Q-dəyəri yaratmasını asanlaşdırmaqdır.
Low-Level DDQN Agentləri Necə Öyrədilir?
Hər sub-agentin əsasında Double Deep Q-Network (DDQN) və dueling-network arxitekturası dayanır.
Dueling quruluşu Q-dəyərini state value və action advantage kimi ayırır:
Training loss yalnız standart TD error-dan ibarət deyil. EarnHFT tədqiqatında istifadə olunan Optimal Value Supervisor da daxil edilmişdir:
Buradakı \(Q^*\), verilmiş vəziyyətdə dinamik proqramlaşdırma ilə hesablanan optimal Q-dəyəridir. Beləliklə alt-agent yalnız öz kəşf təcrübəsindən deyil, hesablanmış optimal action-value məlumatından da istiqamətləndirilir.
MacroHFT ilə EarnHFT Arasındakı Əsas Fərq Nədir?
EarnHFT müxtəlif bazar trendlərində öyrədilən agent pool yaradır və router mövcud bazar şəraitinə görə bunlardan tək bir agent seçir. MacroHFT isə iki mühüm dəyişiklik edir.
Birincisi, bazar yalnız trendə görə deyil, trend + volatillik əsasında parçalanır.
İkincisi və daha önəmlisi, hyper-agent alt-agentlərdən birini seçmək əvəzinə bütün alt-agentlərin Q-dəyərlərinə çəki verir:
MacroHFT-də \(N=6\)-dır.
Final action:
ilə müəyyən edilir.
Buna görə MacroHFT-dəki meta-policy “agent selector” deyil, policy mixture quruluşudur.
Niyə Hyper-Agent-ə Yaddaş Əlavə Edilir?
Kripto bazarında oxşar görünən iki vəziyyətin qısamüddətli nəticəsi çox fərqli ola bilər. Bundan əlavə, crash, sürətli rebound və ya breakout kimi nadir hərəkətlər standart replay buffer daxilində az təmsil oluna bilər.
MacroHFT bunun üçün məhdud tutumlu cədvəl əsaslı episodic memory müəyyən edir:
Burada:
- \(K\): state encoder tərəfindən yaradılan key vektorları,
- \(E\): state-action experience cütləri,
- \(V\): təcrübələrin hesablanmış dəyərləri.
Yeni təcrübə daxil olduqda:
yaradılır və \((k,(s,a),v)\) memory-yə yazılır.
Yaddaş maksimum tutuma çatdıqda FIFO yanaşması istifadə olunur; ən köhnə qeyd silinir. Bu dizaynın məqsədi bazarın yaxın keçmişinin cari qərar baxımından daha dəyərli olduğunu fərz etməkdir.
Hyper-agent cari state-ə ən yaxın \(m\) təcrübəni L2 məsafəsi ilə axtarır:
və bunlardan əldə edilən memory Q-target yaradır:
Bu dəyər hyper-agent-in standart RL target-ına əlavə supervision kimi daxil olur:
Mənbənin mətni yaxın və oxşar təcrübələrdən daha effektiv istifadə ediləcəyini bildirir. Bununla belə, çap olunmuş Tənlik (7)-də attention çəkisinin L2 məsafəsi ilə birbaşa mütənasib görünməsi riyazi notasiya qeyri-müəyyənliyi yaradır; mənbə bu məqamı ayrıca izah etmir.
Limit Order Book və Texniki Girişlər Necə İstifadə Olunur?
Mənbə beş səviyyəli Limit Order Book istifadə edir:
Hər səviyyədə bid/ask qiyməti və mövcud miqdar vardır.
Bununla yanaşı OHLCV məlumatı:
istifadə olunur.
Əlavə Cədvəl 4-də çoxsaylı texniki xüsusiyyətlər müəyyən edilir. Bunların arasında:
- candle body və wick ölçüləri,
- beş bid/ask səviyyəsinin normallaşdırılmış miqdarları,
- weighted average prices,
- buy/sell spreads,
- buy/sell volume,
- volume imbalance,
- price spread,
- VWAP ölçüləri,
- bid/ask log returns,
- WAP log returns,
- 60 zaman addımlı rolling trend features
yer alır.
Məsələn, volume imbalance:
və price spread:
kimi müəyyən edilir.
Tədqiqatın Metodu və Nəticələri
Məlumat dəstləri
| Bazar | Training | Validation | Test |
|---|---|---|---|
| BTC/USDT | 05.03.2022 – 22.02.2023 | 18.03.2023 – 15.06.2023 | 22.06.2023 – 15.10.2023 |
| ETH/USDT | 01.02.2022 – 31.01.2023 | 01.02.2023 – 31.05.2023 | 01.06.2023 – 31.10.2023 |
| DOT/USDT | 01.02.2022 – 31.01.2023 | 01.02.2023 – 31.05.2023 | 01.06.2023 – 31.10.2023 |
| LTC/USDT | 01.02.2022 – 31.01.2023 | 01.02.2023 – 31.05.2023 | 01.06.2023 – 31.10.2023 |
BTC məlumat bölgüsündə training, validation və test dövrləri arasında mənbə cədvəlində boş zaman intervalları mövcuddur; Verianla bunları avtomatik olaraq doldurmamışdır.
Trading setup
Eksperimentlər 4 ədəd NVIDIA RTX 4090 GPU üzərində aparılmışdır.
Transaction commission:
kimi müəyyən edilmiş və mənbə bunun Binance siyasətinə uyğun olduğunu bildirmişdir.
Training chunk uzunluqları:
- BTC/USDT: 360 dəqiqə = 6 saat,
- ETH/USDT, DOT/USDT və LTC/USDT: 4320 dəqiqə = 3 gün.
Hər sub-agent 15 epoch; hyper-agent də 15 epoch öyrədilmişdir.
Bütün neural-network parametrlərində Adam optimizer və:
istifadə edilmişdir.
Sub-agent optimal supervisor əmsalı:
üzrə validation performansına əsasən seçilmişdir.
Hyper-agent üçün:
və memory-loss əmsalı:
kimi sınaqdan keçirilmişdir. DOT/USDT üçün \(\beta=1\), digər üç bazar üçün \(\beta=5\) seçilmişdir.
Müqayisə olunan metodlar
MacroHFT səkkiz baseline ilə müqayisə edilmişdir:
- DQN,
- DDQN,
- PPO,
- CDQNRP,
- CLSTM-PPO,
- EarnHFT,
- Imbalance Volume (IV),
- MACD.
Qiymətləndirmə meyarları
Altı maliyyə metriyi istifadə edilmişdir:
- Total Return (TR),
- Annual Sharpe Ratio (ASR),
- Annual Calmar Ratio (ACR),
- Annual Sortino Ratio (ASoR),
- Annual Volatility (AVOL),
- Maximum Drawdown (MDD).
Total Return:
Annual Volatility, dəqiqəlik return-ların ildə 525.600 dəqiqə fərziyyəsi ilə annualize edilməsinə əsaslanır:
Annual Sharpe Ratio:
Əsas performans nəticələri
| Bazar | TR (%) | ASR | ACR | ASoR | AVOL (%) | MDD (%) | Trading Number |
|---|---|---|---|---|---|---|---|
| BTC/USDT | 3,03 | 0,61 | 2,06 | 0,34 | 18,19 | 5,41 | 19 |
| ETH/USDT | 39,28 | 3,89 | 8,41 | 2,49 | 20,93 | 9,67 | 20 |
| DOT/USDT | 13,79 | 0,97 | 2,45 | 0,68 | 40,31 | 15,89 | 38 |
| LTC/USDT | 18,16 | 1,50 | 3,11 | 0,66 | 29,59 | 14,24 | 138 |
Mənbənin Cədvəl 1 və Şəkil 3-ünə görə MacroHFT dörd bazarın hamısında ən yüksək Total Return dəyərini əldə etmişdir.
BTC/USDT
MacroHFT %3,03 gəlir əldə etdiyi halda mənbədə müqayisə olunan bütün baseline-ların BTC nəticələri mənfidir. Məsələn, CDQNRP −%1,51, PPO −%9,15, EarnHFT −%11,16 və MACD −%18,99 gəlir bildirmişdir.
Bununla belə, bəzi mənfi-return modelləri daha aşağı AVOL və ya MDD əldə etmişdir. Buna görə MacroHFT-nin daha yüksək gəlir nəticəsi “bütün risk ölçülərində ən aşağı risk” demək deyil.
ETH/USDT
MacroHFT:
bildirmişdir.
Eyni testdə EarnHFT %18,02, IV %0,56 və PPO −%2,12 gəlir əldə etmişdir.
MacroHFT eyni zamanda:
dəyərlərini bildirir.
DOT/USDT
MacroHFT %13,79 Total Return əldə etmişdir. IV %10,58 ilə müsbət gəlir yaradan digər güclü metoddur; EarnHFT −%2,67 və MACD −%20,29-dur.
LTC/USDT
MacroHFT %18,16 gəlir əldə etmişdir. IV %7,75, EarnHFT %0,54; MACD isə −%13,16-dır.
Hyper-Agent Həqiqətən Müxtəlif Ekspertləri Qarışdırırmı?
Mənbənin Şəkil 5-i BTC/USDT testində hyper-agent-in altı müxtəlif sub-agent-ə zaman ərzində verdiyi çəkiləri göstərir. Çəkilər sabit deyil; bazar konteksti dəyişdikcə dominant ekspert də dəyişir.
Bu vizual MacroHFT-nin yalnız training zamanı müxtəlif agentlər yaratmadığını, inference zamanı da bazar şəraitinə görə ekspertlərin contribution-ını davamlı şəkildə dəyişdirdiyini göstərir.
Conditional Adapter və Memory Həqiqətən Lazımdırmı?
Ablation testləri iki əsas komponentin təsirini ayrıca qiymətləndirir:
- w/o-CA: conditional adapter çıxarılmış MacroHFT,
- w/o-MEM: memory mexanizmi çıxarılmış MacroHFT.
| Bazar | Model | TR (%) | ASR | MDD (%) |
|---|---|---|---|---|
| BTC | w/o-CA | 1,69 | 0,36 | 7,24 |
| BTC | w/o-MEM | 2,03 | 0,49 | 6,49 |
| BTC | MacroHFT | 3,03 | 0,61 | 5,41 |
| ETH | w/o-CA | 14,27 | 2,42 | 7,57 |
| ETH | w/o-MEM | 12,73 | 1,26 | 20,87 |
| ETH | MacroHFT | 39,28 | 3,89 | 9,67 |
| DOT | w/o-CA | -16,79 | -1,18 | 31,66 |
| DOT | w/o-MEM | 2,41 | 0,34 | 27,23 |
| DOT | MacroHFT | 13,79 | 0,97 | 15,89 |
| LTC | w/o-CA | -6,71 | -0,36 | 18,83 |
| LTC | w/o-MEM | -8,66 | -0,58 | 22,03 |
| LTC | MacroHFT | 18,16 | 1,50 | 14,24 |
Ən böyük fərqlər DOT və LTC bazarlarında müşahidə olunur. Mənbə bu test dövrlərində bazar dəyərinin DOT üçün təxminən %14,85 və LTC üçün təxminən %24,94 azaldığını bildirir.
LTC-də tam MacroHFT %18,16 gəlir əldə etdiyi halda conditional adapter çıxarıldıqda −%6,71, memory çıxarıldıqda isə −%8,66 gəlir əldə edilmişdir.
ETH-də MacroHFT %39,28 gəlir əldə etdiyi halda w/o-CA %14,27 və w/o-MEM %12,73-dür. Lakin MDD baxımından w/o-CA %7,57 ilə tam MacroHFT-nin %9,67 dəyərindən daha aşağıdır. Buna görə ablation nəticəsi belə bütün risk ölçülərində tam üstünlük göstərmir.
Memory Mexanizmi Ani Bazar Hərəkətlərində Nə Təmin Edir?
Mənbənin Şəkil 6-sında ETH bazarında memory çıxarıldıqda model ani qiymət enişinə kifayət qədər sürətlə reaksiya verə bilmir və nəzərəçarpan zərər yaranır. Conditional adapter çıxarıldıqda isə model bazarın flat/bear şəraitindən bull şəraitinə keçidi zamanı trading policy-ni kifayət qədər dəyişə bilmir və yüksəliş fürsətini əldən verir.
Müəlliflər bu müşahidələri memory-nin ani və nadir qiymət hərəkətlərində, conditional adapter-in isə rejim dəyişikliklərində mühüm olduğuna dair davranış sübutu kimi şərh edirlər.
Mənbədə Göstərilən Trading Nümunələri Nəyi Anladır?
Mənbənin Şəkil 4-də dörd nümunə göstərilir.
ETH
Müəlliflər modeli qısamüddətli yüksəlişdə bir “breakout” fürsətini tutan strategiya kimi şərh edirlər. Mövqe qısa bir hərəkət daxilində açılıb bağlanır.
DOT
MacroHFT uzunmüddətli yüksəliş hissəsində mövqeyini qoruyaraq trend-following davranışı göstərir və daha sonra mövqedən çıxır.
LTC
Qiymət çöküşündə stop-loss-a bənzər çıxış davranışı, ardınca rebound zamanı yeni gəlirli mövqe nümunəsi göstərilir.
BTC
Eniş meylli ümumi bazar daxilində daha kiçik yüksəlişlərdən istifadə etməyə çalışan əməliyyatlar göstərilir.
Bu dörd nümunə metodun formal trading rules-u deyil. Bunlar müəlliflərin modelin ortaya çıxardığı trading davranışına dair ex-post şərhləridir.
Tədqiqatın Dəstəklədiyi Nəticələr
- Trend və volatillikdən ayrı meyarlar kimi istifadə edərək ekspert sub-agent-lərin öyrədilməsi sınaqdan keçirilən kripto bazarlarında işləyən iyerarxik RL quruluşu yaratmışdır.
- Conditional adapter cari bazar konteksti və mövqenin low-level Q-policy üzərində daha birbaşa təsir göstərməsini təmin edir.
- Tək bir eksperti seçmək əvəzinə altı sub-agent-in Q-dəyərlərini qarışdıran hyper-agent sınaqdan keçirilən məlumat dəstlərində güclü nəticələr əldə etmişdir.
- Memory mexanizminin çıxarılması xüsusilə ani bazar hərəkətlərinin olduğu bəzi testlərdə performansı nəzərəçarpacaq dərəcədə azaltmışdır.
- Conditional adapter-in çıxarılması rejim dəyişikliklərinə uyğunlaşmanı zəiflətmişdir.
- MacroHFT dörd test məlumat dəstinin hamısında müsbət Total Return əldə etmiş və mənbənin Cədvəl 1-dəki bütün baseline-larından yüksək Total Return bildirmişdir.
- DOT və LTC kimi test dövründə ümumi bazar qiymətinin kəskin düşdüyü məlumat dəstlərində də model müsbət gəlir əldə etmişdir.
- EarnHFT-dəki single-agent routing əvəzinə policy mixture istifadə etmək bu tədqiqatın mərkəzi arxitektura fərqlərindən biridir.
Tədqiqatın Dəstəkləmədiyi Ümumiləşdirmələr
- MacroHFT-nin canlı Binance və ya başqa bir exchange üzərində eyni gəlirləri yaradacağı göstərilməmişdir.
- %39,28 ETH və ya %18,16 LTC gəlirinin gələcəkdə təkrarlanacağı göstərilməmişdir.
- Model klassik ultra-low-latency HFT sistemlərinin microsecond və ya nanosecond execution müddətini ölçmür.
- Real exchange queue priority, network jitter, packet loss, API throttling və ya co-location üstünlüyü eksperimental olaraq modelləşdirilməmişdir.
- Market impact-in böyük mövqelərdə nəticələri necə dəyişdirəcəyi geniş şəkildə sınaqdan keçirilməmişdir.
- Yalnız long-position quruluşu real HFT strategiyalarının hamısını təmsil etmir.
- Dörd kriptovalyuta üzrə əldə edilən nəticələr bütün token, exchange və ya bazar dövrlərinə ümumiləşdirilə bilməz.
- Conditional adapter və ya memory komponentlərinin təkbaşına hər trading alqoritmində eyni böyüklükdə performans artımı verəcəyi göstərilməmişdir.
Əsas Metodoloji Məhdudiyyətlər
Birincisi, model yalnız \(P_t\geq0\) mövqelərə icazə verir; yəni short-selling quruluşu yoxdur. Bu, real kripto HFT sistemlərinin strategiya sahəsi ilə müqayisədə mühüm sadələşdirmədir.
İkincisi, əməliyyat xərci dörd bazarın hamısında sabit %0,02 qəbul edilir. Real trading fee, spread və execution cost trader tier, exchange, order növü və bazar şəraitinə görə dəyişə bilər.
Üçüncüsü, trading interval bir dəqiqədir. Bu, yüksək qərar tezliyi təmin edə bilər, lakin klassik market-microstructure HFT-dəki microsecond/nanosecond latency yarışından çox fərqli zaman miqyasıdır.
Dördüncüsü, sistem dörd kripto trading pair üzərində sınaqdan keçirilmişdir. Bazar sayı geniş universal ümumiləşdirmə üçün məhduddur.
Beşincisi, model-selection və hyperparameter seçimləri validation dövrlərinin gəlirlərinə əsaslanır. Bu yanaşma test dəstinin qorunmasına kömək etsə də, model-development prosesinin müəyyən tarixi rejimlərdən asılılığını tam aradan qaldırmır.
Altıncısı, mənbə yaddaş mexanizminin yaxın təcrübə çəkiləndirilməsində istifadə olunan Tənlik (7)-nin çap edilmiş forması ilə “oxşarlığa görə daha yaxın təcrübələrdən istifadə” mətn izahı arasında aydın olmayan riyazi məqam saxlayır.
Mənbə və Metod Qeydi
Orijinal başlıq: MacroHFT: Memory Augmented Context-aware Reinforcement Learning On High Frequency Trading.
Müəlliflər: Chuqiao Zong, Chaojie Wang, Molei Qin, Lei Feng, Xinrun Wang və Bo An.
Məsul müəllif: Chaojie Wang.
Qurumlar: Nanyang Technological University; Skywork AI; Singapore University of Technology and Design.
Nəşr: Proceedings of the 30th ACM SIGKDD Conference on Knowledge Discovery and Data Mining, KDD ’24.
Konfrans: 25–29 Avqust 2024, Barcelona, Spain.
Nəşriyyat: Association for Computing Machinery.
ACM ISBN: 979-8-4007-0490-1/24/08.
DOI: 10.1145/3637528.3672064.
arXiv: 2406.14537v1 [cs.LG], 20 İyun 2024.
Əsas metod: Memory-Augmented Context-aware Hierarchical Reinforcement Learning.
Low-level RL: Dueling DDQN + Optimal Value Supervisor + conditional adaptation.
High-level RL: Bütün sub-agent Q-policies-in softmax çəkili mixture-ı + episodic memory supervision.
Sub-agent sayı: 6.
Market decomposition: Bull, Medium Trend, Bear, Volatile, Medium Volatility və Stable.
LOB dərinliyi: 5 səviyyə.
Low-level context window: 60 dəqiqə.
Trading zaman ayırdetməsi: 1 dəqiqə.
Action space: \(\{0,1\}\) hədəf mövqe.
Mövqe məhdudiyyəti: Yalnız non-negative / long position.
Commission: %0,02.
Test bazarları: BTC/USDT, ETH/USDT, DOT/USDT və LTC/USDT.
Baseline sayı: 8.
Baselines: DQN, DDQN, PPO, CDQNRP, CLSTM-PPO, EarnHFT, Imbalance Volume və MACD.
Maliyyə meyarları: TR, ASR, ACR, ASoR, AVOL və MDD.
GPU: 4 × NVIDIA RTX 4090.
Optimizer: Adam.
Learning rate: \(1\times10^{-4}\).
Training: Sub-agent-lər 15 epoch; hyper-agent 15 epoch.
Əsas test gəlirləri: BTC %3,03; ETH %39,28; DOT %13,79; LTC %18,16.
Ablation nəticəsi: Conditional adapter və memory-nin çıxarılması dörd bazarın hamısında Total Return-ü azaltmışdır; DOT və LTC-də variantlar mənfi gəlirə qədər geriləmişdir.
Funding: National Research Foundation, Singapore — Industry Alignment Fund – Pre-positioning (IAF-PP) Funding Initiative.
Kod: Mənbə tətbiqin ZONG0004/MacroHFT GitHub deposunda yayımlandığını bildirir.
Mənbədaxili texniki qeyd 1: Low-level target-position izahındakı bid/ask order terminologiyası, eyni bölmədə verilən bid/ask tərifləri ilə istiqamət baxımından tam uyğun görünmür.
Mənbədaxili texniki qeyd 2: Memory lookup izahı ən yaxın təcrübələri vurğuladığı halda çap olunmuş attention formulu L2 məsafəsini birbaşa çəkiləndirir; mənbə bu notasiya fərqini izah etmir.
Əsas elmi sərhəd: Nəticələr tarixi bazar məlumatları üzərində trading simulation-a aiddir; canlı exchange execution eksperimenti və ya ultra-low-latency istehsal HFT sisteminin qiymətləndirilməsi deyil.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib