

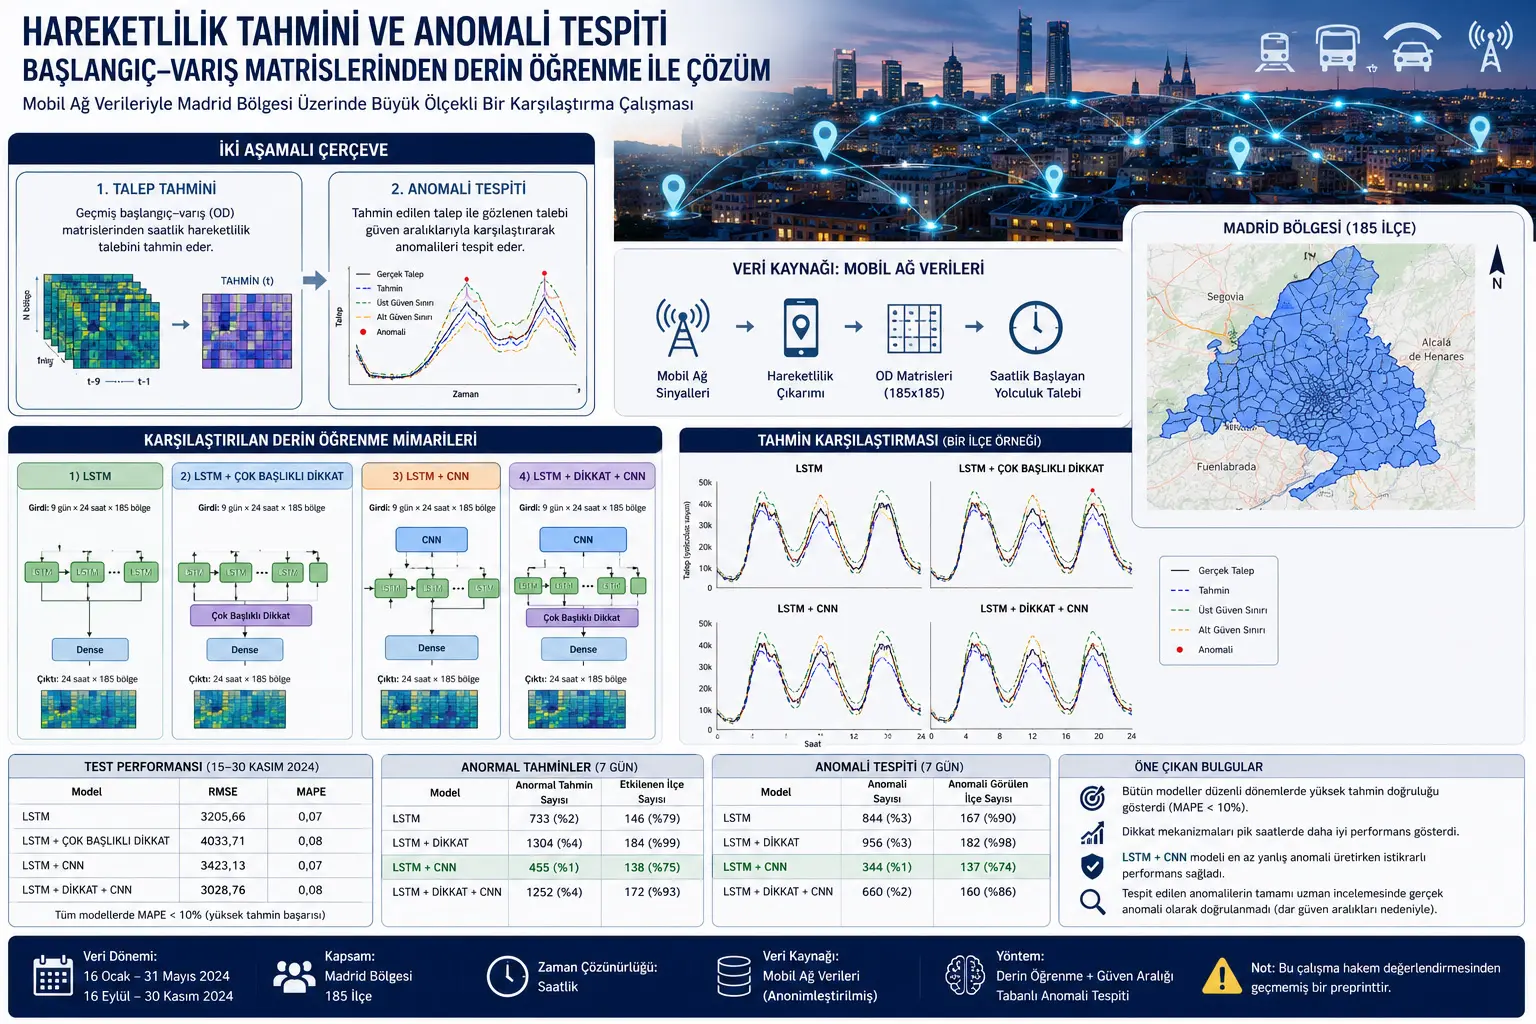
Mojawapo ya maswali muhimu zaidi katika upangaji wa usafiri ni hili: Watu wanasafiri kutoka eneo gani kwenda eneo gani, katika saa zipi na kwa kiwango gani cha msongamano? Jibu la swali hili lina athari ya moja kwa moja katika maeneo mengi, kuanzia uwezo wa usafiri wa umma hadi usimamizi wa trafiki, upangaji wa matengenezo ya barabara na maamuzi ya uendeshaji katika siku za matukio maalumu.
Taarifa za aina hii za uhamaji kwa kawaida huwakilishwa kwa origin-destination matrices. Origin-destination matrix ni muundo wa data unaoonyesha ni watu wangapi walisafiri kutoka eneo moja kwenda eneo jingine katika kipindi fulani cha muda. Kwa mfano, wilaya za jiji zikiwekwa katika safu na nguzo, safu huwakilisha eneo la mwanzo na nguzo huwakilisha eneo la mwisho. Kila seli ya matrix huonyesha idadi ya safari kati ya jozi fulani ya mwanzo na mwisho.
Tatizo kuu la utafiti ni kujifunza mahitaji haya ya uhamaji kutoka data za zamani ili kuyatabiri kwa siku zijazo na kutambua mikengeuko isiyo ya kawaida kutoka kwenye tabia inayotarajiwa. Katika mfumo wa usafiri, anomaly inaweza kumaanisha mahitaji yanayotofautiana na muundo wa kawaida kutokana na likizo, mgomo, tukio la michezo, hali ya hewa, ajali, kukatika kwa miundombinu au uhamaji wa kijamii usiotarajiwa. Mikengeuko ya aina hii ikitambuliwa mapema, waendeshaji wa usafiri wanaweza kuongeza frequency ya huduma, kurekebisha capacity katika maeneo fulani, vituo vya usimamizi wa trafiki vinaweza kuchukua hatua au mipango ya hali maalumu inaweza kuanzishwa.
Kwa nini tatizo hili ni muhimu?
Uhamaji wa mijini si wa nasibu. Kuna mifumo inayojirudia kama safari za kwenda kazini asubuhi siku za kazi, uhamaji wa chini wakati wa mchana, msongamano wa kutoka kazini jioni, mienendo tofauti wikendi na tabia za safari zinazobadilika siku za likizo. Hata hivyo, mifumo hii haibaki sawa kila wakati. Tamasha, mechi ya mpira wa miguu, hali mbaya ya hewa, mgomo au kufungwa kwa barabara kunaweza kufanya mahitaji katika maeneo fulani kuwa juu au chini sana kuliko kawaida.
Kwa usimamizi wa usafiri, tatizo si swali la “ni watu wangapi watasafiri?” pekee. Swali muhimu zaidi ni “je, kuna hali isiyo ya kawaida ikilinganishwa na mahitaji yanayotarajiwa, na hali hii inatokea wapi?”. Kwa sababu mfumo unaweza kufanya kazi vizuri siku ya kawaida, lakini mpango huo huo ukawa hautoshi siku isiyo ya kawaida. Ikiwa mahitaji yasiyo ya kawaida yatatambuliwa mapema au katika hatua za mwanzo, mfumo wa usafiri unaweza kusimamiwa kwa njia yenye utabiri zaidi.
Utafiti huu ni muhimu kwa sababu unachunguza pamoja utabiri wa uhamaji na ugunduzi wa anomaly. Modeli inayotabiri vizuri pekee inaweza isimuambie mtoa uamuzi anomaly imetokea wapi na lini. Mfumo unaofanya anomaly detection pekee, ikiwa hauna utabiri imara wa mahitaji yanayotarajiwa, unaweza kutafsiri vibaya fluctuations za kawaida kama anomaly. Utafiti unalenga kuunganisha mahitaji haya mawili kwa kwanza kukokotoa mahitaji yanayotarajiwa na kisha kutathmini mikengeuko kutoka kwenye matarajio hayo.
Kwa nini data za mtandao wa simu zinatumika?
Data zilizotumika katika utafiti ni origin-destination matrices zilizozalishwa kutoka data za mtandao wa simu. Data za mtandao wa simu huruhusu kutoa mifumo ya uhamaji kutoka kwenye miunganisho ambayo simu za watu huanzisha na base stations. Data hizi zinapotumika si kwa ufuatiliaji wa mtu binafsi, bali kuelewa kwa pamoja na kwa anonymized mtiririko wa uhamaji, zinaweza kuwa chanzo chenye thamani sana cha data katika kiwango cha jiji.
Data za mtandao wa simu zina faida muhimu kwa upangaji wa usafiri. Tafiti za jadi kwa dodoso ni ghali, hufanywa kwa sampuli ndogo na hufunika vipindi fulani tu. Sensors, cameras au turnstile data zinaweza kuona uhamaji katika maeneo maalumu pekee. Data za mtandao wa simu zinaweza kuwakilisha kwa njia ya jumla zaidi eneo pana, kipindi kirefu cha muda na uhamaji kati ya maeneo tofauti.
OD matrices zilizotumika katika utafiti zilitengenezwa na Nommon kwa ajili ya Wizara ya Usafiri na Uhamaji Endelevu ya Hispania. Data za mtandao wa simu zilichakatwa kwa Nommon Mobility Insights solution, activity-travel diaries ziliundwa kwa watumiaji wa simu waliochaguliwa katika sampuli na kupanuliwa hadi idadi yote ya watu kwa kutumia census data. Matrices hutoa muundo tajiri wa data unaoweza kugawanywa si kwa uhamaji wa kikanda pekee, bali pia kwa saa ya siku, lengo la safari, umbali, umri, jinsia, mahali pa kuishi na mapato.
Pengo katika fasihi ni nini?
Mbinu mbalimbali zimetumika katika fasihi ya utabiri wa mahitaji ya usafiri na anomaly detection. Baadhi ya tafiti zinategemea mbinu za takwimu. Kalman filters, Gaussian kernel-based methods, Z-score criteria na confidence intervals ni zana za kawaida zinazotumika katika eneo hili. Mbinu hizi zina interpretability ya juu; lakini zinaweza kukumbana na tatizo la scalability katika OD matrices kubwa na zenye dimensionality nyingi.
Machine learning methods zimeanza kutumiwa kupunguza vikwazo hivi. Support vector machines, random forests, k-nearest neighbors, linear models na mbinu kama PCA kwa dimensionality reduction zimetumika katika tafiti mbalimbali. Hata hivyo, anomalies kali na mifumo ya uhamaji isiyo stationary inaweza kuathiri uthabiti wa modeli hizi.
Deep learning, hasa LSTM networks, imejitokeza katika utabiri wa mahitaji ya usafiri kwa sababu inaweza kukamata long-term dependencies katika time series. Hata hivyo, bado kuna pengo muhimu katika fasihi: Tafiti nyingi hujikita ama kwenye usahihi wa utabiri au anomaly detection; tafiti zinazolinganisha kwa mfumo mmoja athari za deep learning architectures tofauti kwenye utabiri na anomaly detection kwa OD data kubwa ni chache zaidi.
Utafiti huu unalenga pengo hili. Unalinganisha architectures nne tofauti za deep learning ndani ya data na mfumo mmoja wa tathmini. Hivyo unaonyesha LSTM, attention mechanism na CNN components zinafanya kazi vizuri zaidi chini ya hali gani, zinatofautianaje katika low demand na peak hours, na zinaathirije tabia ya false flagging katika anomaly detection.
Mbinu ya hatua mbili iliyopendekezwa inafanyaje kazi?
Mbinu ya utafiti ina hatua mbili. Hatua ya kwanza ni utabiri wa mahitaji. Modeli ya time series inayotegemea deep learning hutumia data za zamani zenye dimensions nyingi za mahitaji ya OD kuzalisha mahitaji ya kila saa ya siku inayofuata. Input ya modeli ni mahitaji ya kila saa ya siku tisa zilizopita; output yake ni utabiri wa mahitaji wa saa 24 kwa wilaya 185. Yaani kila utabiri huzalisha demand matrix ya dimensions 185 × 24.
Hatua ya pili ni anomaly detection. Katika hatua hii, utabiri wa modeli haukubaliwi moja kwa moja kama “reference sahihi”. Kwanza huangaliwa kama mahitaji yaliyotabiriwa yanaendana na tabia ya kihistoria ya mahitaji. Kisha mahitaji halisi yaliyoonekana hulinganishwa na utabiri uliothibitishwa. Ikiwa mahitaji halisi yako nje ya confidence interval, huwekwa alama kama anomaly candidate.
Muundo huu wa hatua mbili ni muhimu. Kwa sababu tofauti inayozalishwa na utabiri mbaya inaweza kuonekana kama anomaly halisi. Utafiti unakagua kwanza uthabiti wa utabiri na pattern ya kihistoria ili kupunguza hatari hii. Hivyo, kabla ya mfumo kuuliza “je, mahitaji halisi ni abnormal?”, huangalia kwanza “je, mahitaji yanayotarajiwa na modeli ni reasonable?”.
Kuthibitisha mahitaji yanayotarajiwa dhidi ya tabia ya kihistoria
Katika utafiti, confidence interval ya kwanza hutumika kupima kama mahitaji yaliyotabiriwa yanaendana na pattern ya siku ileile ya wiki katika historia. Kwa mfano, ikiwa utabiri unafanywa kwa siku ya Jumanne, Jumanne zilizopita huzingatiwa. Mean demand na standard deviation hukokotolewa kupitia siku hizi.
Confidence interval iliyotolewa katika utafiti ni kama ifuatavyo:
\[ [(1-\alpha)avg_n-k\cdot std_n,\ (1+\alpha)avg_n+k\cdot std_n] \]
Hapa avg_n inawakilisha mean demand iliyokokotolewa kwa n ya siku za wiki zinazofanana hapo awali. std_n ni standard deviation ya observations hizo za kihistoria. k ni parameter inayoweka upana wa confidence interval katika units za standard deviation. n inaonyesha ni periods ngapi za zamani zitatumika. α hutumika kuongeza flexibility kwa fluctuations ndogo za mahitaji ambazo haziwezi kukamatwa kikamilifu na standard deviation.
Maana ya kila siku ya fomula hii ni hii: “Katika siku zinazofanana hapo awali, mahitaji katika eneo hili kwa kawaida yalitokea ndani ya range gani? Je, utabiri wa modeli wa leo uko ndani ya band hii ya tabia inayotarajiwa?” Ikiwa utabiri unabaki ndani ya range hiyo, unakubaliwa kuwa unaendana na tabia ya kihistoria. Ikiwa uko nje, hali hii inaweza kuashiria aidha demand pattern iliyobadilika kwa kweli au kushuka kwa model performance.
Kulinganisha mahitaji halisi na mahitaji yaliyotabiriwa
Baada ya utabiri kupatikana kuwa reasonable kwa tabia ya kihistoria, katika hatua ya pili unalinganishwa na observation halisi. Hapa confidence interval huundwa kuzunguka thamani ya utabiri:
\[ [(1-\alpha)prediction-\ell\cdot std_n,\ (1+\alpha)prediction+\ell\cdot std_n] \]
Hapa prediction ni thamani ya mahitaji iliyotabiriwa na modeli. std_n ni standard deviation ya n ya siku zinazofanana hapo awali. ℓ ni calibration parameter inayobainisha upana wa range itakayotumika katika anomaly detection. α hutoa flexibility kwa namna inayolingana na hatua ya awali.
Observations halisi zinazobaki ndani ya range hii hukubaliwa kuwa normal. Thamani zilizo nje huwekwa alama kama anomaly candidates. Hapa kauli “anomaly candidate” ni muhimu hasa. Katika utafiti, kila thamani iliyopewa alama haikukubaliwa moja kwa moja kuwa anomaly halisi; umuhimu wa expert validation ulisisitizwa. Kwa sababu deviations ndogo zilizo nje ya range kwa kitakwimu zinaweza kutokana si na tukio halisi, bali confidence intervals nyembamba sana au natural variability.
Matumizi katika Mkoa wa Madrid
Mbinu ilijaribiwa katika Mkoa wa Madrid. Eneo liligawanywa katika wilaya 185. Katika utafiti, mgawanyo wa kijiografia wa wilaya hizi unaonyeshwa kwenye ramani ya eneo, na maeneo ya bluu yanaonyesha upeo wa eneo la uchambuzi. Ramani hii ni muhimu kwa kuonyesha kwamba utafiti haufanyi kazi kwa corridor ndogo au data ya station moja, bali kwa data pana ya uhamaji wa kikanda.
OD matrices zilibadilishwa kuwa safari zinazoanza kila saa kwa kila wilaya. Hivyo modeli ilitabiri wakati mmoja time series za mahitaji ya kila saa za wilaya 185 tofauti. Hili ni tatizo gumu zaidi kuliko utabiri wa time series moja; kwa sababu kila wilaya ina demand rhythm yake, huku pia kukiwa na uhusiano kati ya maeneo na patterns za pamoja za muda.
Dataset ya majaribio iliundwa tu kutoka wiki kamili na za kawaida katika mwaka 2024. Likizo au disruptions kubwa ziliondolewa. Kipindi cha uchambuzi kinajumuisha 16 Januari–31 Mei 2024 na 16 Septemba–30 Novemba 2024. Wiki ya Easter na wiki ya likizo ya kikanda ya Madrid ziliondolewa. Uchaguzi huu ulilenga kuelewa kwanza jinsi mbinu inavyofanya kazi chini ya regular demand conditions. Vipindi vya likizo na matukio makubwa ni tata zaidi na ni eneo linalohitaji kutathminiwa tofauti katika tafiti zijazo.
Deep learning architectures zilizolinganishwa
Katika utafiti, neural network architectures nne zililinganishwa. Modeli ya kwanza ni basic LSTM architecture. LSTM networks zimetengenezwa kujifunza long-term temporal dependencies. Kwa hiyo zinafaa kwa kutabiri mahitaji ya baadaye kutoka patterns za uhamaji katika siku na saa zilizopita. Katika basic architecture, LSTM layers tatu zenye units 128, dropout rate ya 0,3, fully connected layer yenye neurons 1024 na output layer ya dimensions 24 × 185 zilitumika.
Modeli ya pili ni LSTM yenye multi-head attention mechanism. Attention mechanism huruhusu modeli kutoa uzito mkubwa zaidi kwa time steps muhimu zaidi kati ya observations za zamani. Kwa mfano, ikiwa mahitaji ya eneo yana patterns zenye maana zaidi katika saa fulani au siku fulani za wiki, attention mechanism inaweza kukamata uhusiano huu vizuri zaidi. Katika utafiti huu, attention module yenye heads nne, key dimension 32 na dropout rate 0,1 iliwekwa kati ya LSTM stack na dense layers.
Modeli ya tatu ni muunganiko wa LSTM na CNN. CNN layer hutumika kukamata local temporal na spatial patterns katika hatua ya input. Katika mobility data, kunaweza kuwa na uhusiano kati ya maeneo jirani au yaliyounganishwa kiutendaji. Msongamano unaotokea katika eneo moja unaweza kuathiri mahitaji katika eneo jingine. CNN component husaidia kutoa short-term na local patterns za aina hii. Katika modeli hii, convolution layer yenye filters 64 na kernel size 5 iliongezwa kwenye basic LSTM architecture.
Modeli ya nne hutumia pamoja LSTM, multi-head attention na CNN components. Architecture hii tata zaidi inajumuisha convolution layer, LSTM layers tatu, multi-head attention module, global average pooling na dense output layers. Lengo ni kuunganisha nguvu ya CNN katika local pattern extraction, uwezo wa LSTM wa kujifunza long-term dependencies na uwezo wa attention mechanism wa kuzingatia time steps muhimu.
Mpangilio wa mafunzo na majaribio
Modeli zote zilifundishwa kwa MAE, yaani mean absolute error loss function, na optimized kwa Adam optimization algorithm. Dataset iligawanywa katika training na test subsets. Training set inajumuisha observations zote hadi 14 Novemba 2024. Test set inajumuisha siku 16 zinazofuata kati ya 15–30 Novemba 2024 na ilitumika tu kutathmini generalization performance.
Input-output samples ziliundwa kwa sliding window ya siku tisa. Modeli hutazama mahitaji ya kila saa ya siku tisa zilizopita na kutabiri mahitaji ya saa 24 ya siku moja inayofuata. Kwa kuwa kila utabiri una wilaya 185 na saa 24, output matrix ina dimensions 185 × 24.
Model performance ilitathminiwa kwa RMSE na MAPE. RMSE huadhibu makosa makubwa zaidi; kwa hiyo hufanya deviations kubwa wakati wa high-demand periods zionekane zaidi. MAPE hupima relative error kulingana na observed value; katika low-demand periods, hata absolute differences ndogo zinaweza kuwa percentage errors kubwa. Kwa hiyo, ni muhimu kutumia metrics zote mbili pamoja.
RMSE na MAPE zinamaanisha nini?
Ingawa fomula hazikutolewa wazi katika utafiti, mahusiano ya msingi yanaweza kuonyeshwa kama ifuatavyo ili kuelewa metrics zilizotumika. Fomula hizi ni background formulas zilizotolewa kueleza mantiki ya utafiti:
\[ RMSE=\sqrt{\frac{1}{N}\sum_{i=1}^{N}(y_i-\hat{y}_i)^2} \]
Hapa y_i inawakilisha mahitaji halisi, \hat{y}_i mahitaji yaliyotabiriwa na N jumla ya observations. Kwa sababu RMSE inachukua square ya errors, huwa sensitive zaidi kwa makosa makubwa. Utabiri ukikosea sana katika peak hours, RMSE huadhibu hilo kwa nguvu.
\[ MAPE=\frac{100}{N}\sum_{i=1}^{N}\left|\frac{y_i-\hat{y}_i}{y_i}\right| \]
Hapa MAPE hutoa kosa kama asilimia ya thamani halisi. Mahitaji yakiwa chini, hata absolute deviation ndogo inaweza kuwa percentage error kubwa. Kwa hiyo, utafiti unaeleza kuwa attention-based models zinaonekana nzuri wakati wa peak hours lakini dhaifu katika low demand kupitia sensitivity tofauti za RMSE na MAPE.
Matokeo ya utabiri: Ni modeli gani iliyofanikiwa zaidi?
Thamani za makosa za modeli nne kwenye test set ni kama ifuatavyo:
| Modeli | RMSE | MAPE |
|---|---|---|
| LSTM | 3205,66 | 0,07 |
| LSTM + multi-head attention | 4033,71 | 0,08 |
| LSTM + CNN | 3423,13 | 0,07 |
| LSTM + multi-head attention + CNN | 3028,76 | 0,08 |
Modeli zote zilionyesha performance ya juu ya utabiri. Thamani zote za MAPE ziko kati ya 0,07–0,08; yaani relative error iko chini ya asilimia 10. Hii inaonyesha kwamba katika regular operating periods, mahitaji ya uhamaji yanaweza kutabiriwa kwa mafanikio na deep learning models.
RMSE ya chini zaidi, 3028,76, ilipatikana katika modeli ya LSTM + multi-head attention + CNN. Hii inaonyesha kwamba modeli hiyo ina nguvu hasa katika kupunguza deviations kubwa wakati wa high-demand periods. Hata hivyo, MAPE ya modeli hiyo ni 0,08; jambo linaloashiria kwamba inaweza kuwa dhaifu zaidi kwa relative error katika low-demand hours. Basic LSTM na LSTM-CNN zinaonekana bora kwa MAPE kwa 0,07.
Tafsiri muhimu ya utafiti ni hii: Attention-based models hukamata peak demand hours vizuri zaidi, lakini zinaweza kufanya vibaya zaidi katika low-demand periods. Modeli rahisi zisizo na attention huwakilisha low-demand hours vizuri zaidi, lakini zinaweza kuwa na mipaka katika kukamata peaks tatu za mahitaji ya kila siku. Kwa hiyo, hakuna jibu moja la “modeli bora”. Ikiwa application inaweka kipaumbele zaidi katika utabiri wa peak hours, attention-based models zinaweza kuwa na faida. Ikiwa relative error katika low-demand hours au kuepuka false anomalies ni muhimu zaidi, LSTM rahisi au LSTM-CNN inaweza kufaa zaidi.
Prediction curves katika vielelezo zinaonyesha nini?
Grafu za ulinganisho wa utabiri katika utafiti zinaonyesha, kwa wilaya moja ya mfano iliyochaguliwa, real demand na prediction curve za modeli nne. Katika uhamaji wa kila siku kuna wave pattern ya wazi: mahitaji ya chini usiku na mapema asubuhi, uhamaji unaoongezeka mchana na peaks katika saa fulani.
Grafu zinaonyesha kwamba modeli zote zinakamata overall daily pattern. Hata hivyo, kuna tofauti za kimfumo kati ya architectures. Modeli zisizo na attention mechanism zinaonekana karibu zaidi na real curve katika low-demand hours, lakini hupata ugumu kukamata peak points kikamilifu katika peak hours. Attention-based models huwakilisha peak hours kwa usahihi zaidi, lakini relative deviations zinaweza kuongezeka katika low-demand periods.
Umuhimu wa grafu hizi si kuthibitisha error table kwa picha pekee. Pia zinaonyesha kwamba saa tofauti hubeba ugumu tofauti katika mobility forecasting. Modeli inaweza kuwa nzuri katika high-demand hours lakini ikafanya overprediction au underprediction usiku wakati mahitaji ni ya chini. Tofauti hii huwa muhimu pia katika anomaly detection; kwa sababu katika saa zenye variability ndogo, confidence intervals hupungua na deviations ndogo zinaweza kuwekewa alama kimakosa kama anomaly.
Matokeo ya anomaly detection
Katika utafiti, hourly forecasts zilitathminiwa kwa wilaya 185 katika uchambuzi wa siku saba. Jumla ya predictions ilikuwa 31.080. Idadi ya abnormal predictions na idadi ya wilaya zilizoathiriwa kwa kila modeli ni kama ifuatavyo:
| Modeli | Idadi ya abnormal predictions | Idadi ya wilaya zenye abnormal predictions |
|---|---|---|
| LSTM | 733 (%2) | 146 (%79) |
| LSTM + multi-head attention | 1304 (%4) | 184 (%99) |
| LSTM + CNN | 455 (%1) | 138 (%75) |
| LSTM + multi-head attention + CNN | 1252 (%4) | 172 (%93) |
Jedwali hili linaonyesha kwamba LSTM-CNN ndiyo modeli iliyozalisha abnormal predictions chache zaidi. Modeli zenye multi-head attention zilizalisha abnormal predictions nyingi zaidi. Hali hii ilihusishwa hasa na relative prediction weakness katika low-demand periods na confidence intervals nyembamba.
Katika hatua inayofuata, thamani zilizowekwa alama kama anomaly kulingana na real observed demand zilitathminiwa:
| Modeli | Idadi ya anomaly | Idadi ya wilaya zenye anomaly |
|---|---|---|
| LSTM | 844 (%3) | 167 (%90) |
| LSTM + multi-head attention | 956 (%3) | 182 (%98) |
| LSTM + CNN | 344 (%1) | 137 (%74) |
| LSTM + multi-head attention + CNN | 660 (%2) | 160 (%86) |
Hapa pia inaonekana kwamba LSTM-CNN ilitoa tabia bora zaidi ya anomaly detection. Modeli hii iliweka alama 344 kama anomaly na ikazalisha false flagging ndogo kwa kiasi kikubwa kuliko modeli nyingine. Tafsiri ya utafiti ni kwamba LSTM-CNN, kwa kuunganisha nguvu ya LSTM ya kujifunza long-term temporal dependencies na uwezo wa CNN wa kukamata short-term na spatial patterns, huzalisha forecasts zenye uthabiti zaidi na confidence intervals zinazoaminika zaidi.
Je, anomalies zilizogunduliwa ni anomalies halisi?
Utafiti una matokeo muhimu sana: Hakuna detection katika test set iliyochambuliwa iliyotathminiwa kama hali halisi ya anomaly. Thamani zilizowekwa alama zilikuwa valid demand observations. Sababu ya kuonekana kama anomaly ilikuwa, katika visa vingi, confidence intervals kuwa nyembamba kupita kiasi.
Confidence interval ikiwa nyembamba, hata real demand ikiwa karibu sana na normal behavior inaweza kuanguka nje ya range. Hii hutokea hasa ikiwa variability ya mahitaji katika siku zilizopita ni ndogo sana. Standard deviation ikiwa ndogo, term ya std_n katika fomula hupunguza confidence band. Hivyo hata fluctuations ndogo sana zinaweza kuwekewa alama kistatistiki kama anomaly candidate.
Vielelezo katika utafiti vinaonyesha kwamba abnormal forecasts na detected anomalies ziko karibu sana na mipaka ya confidence interval. Hii inaonyesha kwamba hakukuwa na disruption kubwa ya usafiri au mabadiliko makubwa ya mahitaji; badala yake hali ilihusiana zaidi na calibration sensitivity.
Kwa nini confidence intervals zinazofanana na Bollinger bands zinapaswa kukalibishwa kwa tahadhari?
Katika utafiti, confidence intervals ziliundwa kama variation ya Bollinger band approach. Kwa kuwa muundo huu unategemea mean na standard deviation, ni mbinu inayoeleweka na inayoweza kutumika. Hata hivyo, standard deviation ikiwa ndogo, range inaweza kuwa nyembamba sana; standard deviation ikiwa kubwa, range inaweza kuwa pana sana na anomalies halisi zikapitwa.
Kwa hiyo, parameter calibration iliungwa mkono na expert validation katika utafiti. Wataalamu wa uhamaji wa Nommon walichunguza time series za events zilizogunduliwa na kutathmini iwapo ni anomalies halisi. Muundo uliochaguliwa mwisho ulikuwa moving average ya periods sita, standard deviation coefficient ya k = ℓ = 2 na flexibility parameter ya α = 1. Configuration hii ilielezwa kutoa balance inayofaa kati ya sensitivity na robustness.
Katika utafiti pia ilionekana kwamba confidence intervals za siku za Ijumaa zilikuwa pana zaidi. Mojawapo ya sababu ilikuwa kujumuishwa kwa 1 Novemba, yaani siku ya likizo rasmi nchini Hispania, katika historical sample. Likizo hii iliongeza variability katika historical Friday pattern na kusababisha confidence band ya Ijumaa zinazofuata kuwa pana. Maelezo haya yanaonyesha umuhimu wa calendar effects katika anomaly detection.
Athari gani zinaweza kuwa katika maisha ya kila siku?
Mfumo wa aina hii unaweza kutoa manufaa mengi ya vitendo katika usimamizi wa jiji. Kwa mfano, operator wa public transport akitambua mapema kwamba katika wilaya fulani na saa fulani idadi ya safari zinazoanza iko juu kuliko ilivyotarajiwa, anaweza kupanga extra services au vehicle allocation. Traffic management center inaweza kuchunguza kama uhamaji mkubwa kuliko uliotarajiwa unatokana na tukio fulani, ajali au hali ya hewa. Kwa muda mrefu, planners wanaweza kuimarisha maamuzi ya miundombinu na huduma kwa kuelewa vizuri zaidi regular na irregular mobility patterns za jiji.
Mbinu hii ina thamani si kwa siku za crisis pekee, bali pia kwa kuelewa vizuri siku za kawaida. Ikiwa modeli inaweza kutoa forecasts zinazoaminika katika regular periods, irregular periods zinaweza kutambulika kwa uwazi zaidi. Kwa maneno mengine, kufafanua vizuri “kawaida ni nini” ni sharti la kwanza la kukamata “isiyo ya kawaida” kwa usahihi.
Nguvu za utafiti
Mojawapo ya nguvu za utafiti ni kufanya kazi na large-scale na high-dimensional mobility data. Utabiri wa hourly demand kwa wilaya 185 si utabiri wa barabara moja au OD pair ndogo. Kiwango hiki kinaonyesha kwamba mbinu ilijaribiwa kwenye tatizo lililo karibu zaidi na real regional transportation planning.
Nguvu ya pili ni ulinganisho wa kimfumo wa deep learning architectures nne tofauti. Kutumia basic LSTM model kama reference kunaruhusu mchango wa attention mechanism na CNN components kufasiriwa kwa uwazi zaidi. Utafiti hausomi tu kwamba “modeli tata zaidi ndiyo bora”; unaonyesha kwamba model selection inaweza kubadilika kulingana na malengo ya peak demand, low demand na anomaly detection.
Nguvu ya tatu ni kuingiza human expert validation katika mchakato. Anomaly detection haikuachwa kuwa automatic kabisa; iwapo thamani zilizowekwa alama zilikuwa anomalies halisi ilitafsiriwa kwa tathmini ya mobility experts. Hili ni muhimu hasa katika maeneo yanayounganishwa na operational decisions kama transportation planning.
Vikwazo vya utafiti
Kizuizi muhimu zaidi cha utafiti ni kwamba experiment dataset ilichaguliwa kutoka regular weeks. Likizo, disruptions kubwa na irregularities muhimu zilitolewa kwa makusudi. Uchaguzi huu unafaa kuelewa prediction na false anomaly behavior chini ya normal conditions; lakini hauonyeshi moja kwa moja jinsi mbinu itakavyofanya kazi katika event periods zenye anomalies halisi.
Kizuizi cha pili ni kwamba anomalies zilizogunduliwa katika test week iliyochambuliwa hazikulingana na anomalies halisi. Hali hii ni ya thamani kwa kuelewa false positives za mbinu; lakini datasets zisizo regular na zenye events zinahitajika kupima uwezo wa kukamata matukio halisi.
Kizuizi cha tatu ni kwamba tafsiri ya anomaly haijaunganishwa kikamilifu na external variables. Utafiti unapendekeza kuingiza weather, event data, calendar effects na external factors nyingine katika siku zijazo. Bila integration hii, mfumo unaweza kuweka alama deviation; lakini una mipaka katika kueleza automatically sababu ya deviation hiyo.
Nne, utafiti ni preprint na haujapitia tathmini ya wenzao. Kwa hiyo, matokeo yanapaswa kuonekana kama technical comparison yenye thamani, lakini si kama ushahidi wa mwisho wa kisayansi uliothibitishwa au application standard.
Utafiti unasema nini, na hausemi nini?
Utafiti unaonyesha kwamba hourly mobility demand katika Mkoa wa Madrid inaweza kutabiriwa kwa usahihi wa juu kwa deep learning models kwa kutumia OD matrices zilizotengenezwa kutoka mobile network data. Katika regular periods, MAPE za modeli zote zilibaki chini ya asilimia 10. Aidha, LSTM-CNN architecture ilijitokeza kama chaguo thabiti linalozalisha false flagging chache zaidi kwa anomaly detection.
Utafiti hausemi kwamba katika irregular events halisi anomalies zote zitakamatwa kwa uhakika. Haudai kutoa bidhaa iliyo tayari moja kwa moja kwa real-time operational system. Hauhakikishi kwamba mobile network data itapatikana kwa quality na coverage sawa katika kila jiji. Pia, automatic classification ya sababu za anomaly si scope kuu ya utafiti huu; imeachwa kama eneo la kuendelezwa kwa kuingiza external variables kama weather na event data katika siku zijazo.
Mbinu na Matokeo ya Utafiti
Hatua za mbinu
- Chanzo cha data: Origin-destination matrices zilizotengenezwa kutoka mobile network data zilitumika.
- Eneo la utafiti: Mkoa wa Madrid uligawanywa katika wilaya 185.
- Demand series: OD matrices zilibadilishwa kuwa hourly starting trip demand na 185 parallel hourly time series zikapatikana.
- Uchaguzi wa data: Regular na complete weeks za mwaka 2024 zilichaguliwa; vipindi vya likizo na major disruptions viliondolewa.
- Muundo wa input-output: Mahitaji ya kila saa ya siku tisa zilizopita yalitumiwa kutabiri mahitaji ya saa 24 ya siku inayofuata.
- Ulinganisho wa modeli: LSTM, LSTM + multi-head attention, LSTM + CNN na LSTM + multi-head attention + CNN architectures zilijaribiwa.
- Kipimo cha performance: Prediction performance ilitathminiwa kwa RMSE na MAPE.
- Anomaly detection: Prediction na observation values zililinganishwa kupitia confidence intervals zinazofanana na Bollinger bands.
- Expert validation: Deviations zilizogunduliwa zilichunguzwa na mobility experts na calibration ikatathminiwa ipasavyo.
Fomula za msingi
| Fomula | Maelezo |
|---|---|
| [ [(1-\alpha)avg_n-k\cdot std_n,\ (1+\alpha)avg_n+k\cdot std_n] ] | Ni confidence interval inayokagua kama prediction inaendana na tabia ya siku ileile ya wiki katika historia. |
| [ [(1-\alpha)prediction-\ell\cdot std_n,\ (1+\alpha)prediction+\ell\cdot std_n] ] | Ni anomaly detection range inayobainisha kama real observed demand inabaki ndani ya normal range kuzunguka prediction. |
| [ RMSE=\sqrt{\frac{1}{N}\sum_{i=1}^{N}(y_i-\hat{y}_i)^2} ] | Ni background formula ya RMSE metric iliyotumika katika utafiti; huadhibu makosa makubwa kwa nguvu zaidi. |
| [ MAPE=\frac{100}{N}\sum_{i=1}^{N}\left|\frac{y_i-\hat{y}_i}{y_i}\right| ] | Ni background formula ya MAPE metric iliyotumika katika utafiti; huonyesha kosa kama asilimia ya observed value. |
Prediction performance
| Modeli | RMSE | MAPE | Tafsiri |
|---|---|---|---|
| LSTM | 3205,66 | 0,07 | General performance yenye nguvu; nzuri kwa relative error katika low-demand periods. |
| LSTM + multi-head attention | 4033,71 | 0,08 | Inasaidia kukamata peak periods; lakini relative error inaweza kuongezeka katika low-demand hours. |
| LSTM + CNN | 3423,13 | 0,07 | Inatoa matokeo yenye balance katika prediction accuracy na anomaly detection stability. |
| LSTM + multi-head attention + CNN | 3028,76 | 0,08 | Inatoa RMSE ya chini zaidi; yenye nguvu katika high-demand periods, lakini MAPE ni juu zaidi katika low demand. |
Abnormal prediction na anomaly detection
| Modeli | Abnormal prediction | Anomaly | Tafsiri ya kiufundi |
|---|---|---|---|
| LSTM | 733 | 844 | Ingawa inatoa predictions nzuri kwa ujumla, flagging nje ya confidence interval ni nyingi kuliko LSTM-CNN. |
| LSTM + multi-head attention | 1304 | 956 | Ilizalisha false flagging nyingi zaidi kutokana na relative deviations katika low-demand hours. |
| LSTM + CNN | 455 | 344 | Ni modeli yenye false anomalies chache zaidi na yenye balance bora zaidi kwa anomaly detection. |
| LSTM + multi-head attention + CNN | 1252 | 660 | Ingawa ina nguvu kwa RMSE, si thabiti kama LSTM-CNN katika anomaly detection. |
Matokeo makuu yanayoelezwa na vielelezo na majedwali
Ramani inayoonyesha Mkoa wa Madrid ukiwa umegawanywa katika wilaya inaonyesha kwamba utafiti ulifanywa kwa kiwango pana cha kikanda na ulijumuisha spatial units 185. Hii inaonyesha kwamba mbinu ilijaribiwa si kwa data ndogo ya maabara, bali kwa high-dimensional data iliyo karibu na muundo halisi wa uhamaji wa kikanda.
Grafu za ulinganisho wa predictions zinaonyesha kwamba modeli zote zilikamata daily demand wave; lakini attention-based models ziliwakilisha peak hours vizuri zaidi, huku models zisizo na attention zikiwakilisha low-demand hours vizuri zaidi. Uchunguzi huu unaendana na matokeo ya RMSE na MAPE.
Katika grafu za abnormal predictions na anomalies, points zilizowekwa alama zinaonekana karibu sana na confidence interval boundaries. Matokeo haya ya picha yanaunga mkono tafsiri ya maandishi ya utafiti: Katika test week, thamani zilizogunduliwa hazikuwa anomalies halisi, bali deviations ndogo zilizotokana na confidence intervals nyembamba.
Majedwali yanaonyesha wazi kwamba LSTM-CNN ndiyo architecture yenye faida zaidi kwa anomaly detection. Modeli hii ilidumisha prediction accuracy huku ikipunguza false anomaly flagging.
Hitimisho la kiufundi la jumla
Hitimisho kuu la kiufundi la utafiti ni kwamba deep learning architectures zinaonyesha performance yenye nguvu kwa large-scale mobility demand forecasting; lakini model selection inapaswa kufanywa kulingana na matumizi. Ikiwa kukamata peak demand hours ni kipaumbele, attention-based architectures zina faida. Ikiwa relative error thabiti katika low-demand periods na false anomalies chache zinahitajika, hybrid architectures zisizo na attention kama LSTM-CNN zinaweza kutoa matokeo yenye balance zaidi.
Kwa anomaly detection, matokeo yanaonyesha kwamba kufanya prediction nzuri pekee haitoshi. Upana wa confidence intervals, historical variability, calendar effects na expert validation huathiri moja kwa moja detection performance. Kwa hiyo, utafiti unapendekeza operational approach salama zaidi inayochanganya automatic anomaly detection na human expert validation.
Maelezo ya Chanzo na Mbinu
Makala hii imeandaliwa kwa msingi wa utafiti wenye kichwa “Mobility Demand Forecasting and Anomaly Detection from Origin–Destination Matrices: A Benchmark of Deep Learning Architectures” uliotayarishwa na Raquel Sánchez-Cauce, Oliva G. Cantú Ros, Miguel Picornell, Pablo Ruiz na Sergio Teso. Waandishi wana uhusiano na Nommon Solutions and Technologies. Utafiti ni sehemu ya mradi wa CONDUCTOR unaofadhiliwa chini ya mpango wa Horizon Europe wa Umoja wa Ulaya.
Maandishi ya chanzo ni makala ya utafiti ya preprint iliyoko SSRN. Kwa kuwa yana kauli ya wazi “This preprint research paper has not been peer reviewed”, utafiti haujapitia tathmini ya wenzao. Kwa hiyo, matokeo hayapaswi kusomwa kama findings zilizothibitishwa kikamilifu katika peer-reviewed journal, bali kama matokeo ya preprint yenye maelezo ya kiufundi ambayo mchakato wa peer review haujakamilika.
Maudhui haya yameandaliwa kwa msingi wa utafiti katika PDF. Hakuna dhamana ya field application, commercial success, guaranteed performance katika real-time system, generalizability kwa miji yote au dai la kukamata anomalies zote kwa uhakika ambalo halipo katika PDF lililoongezwa. Mbinu ya utafiti inategemea OD matrices zilizozalishwa kutoka mobile network data, deep learning-based time series forecasting na confidence interval-based anomaly detection.
Utafiti ulijaribiwa kwenye regular weeks; vipindi vya likizo na major disruptions viliondolewa kwa makusudi. Kwa hiyo, mbinu ilitathminiwa kwa prediction accuracy na false anomaly behavior chini ya regular demand conditions. Performance katika vipindi visivyo regular vyenye real anomaly events inahitaji kujaribiwa tofauti. Aidha, integration yenye nguvu zaidi ya external variables kama hali ya hewa, event data na calendar effects imetajwa kama mada ya utafiti wa baadaye.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *