

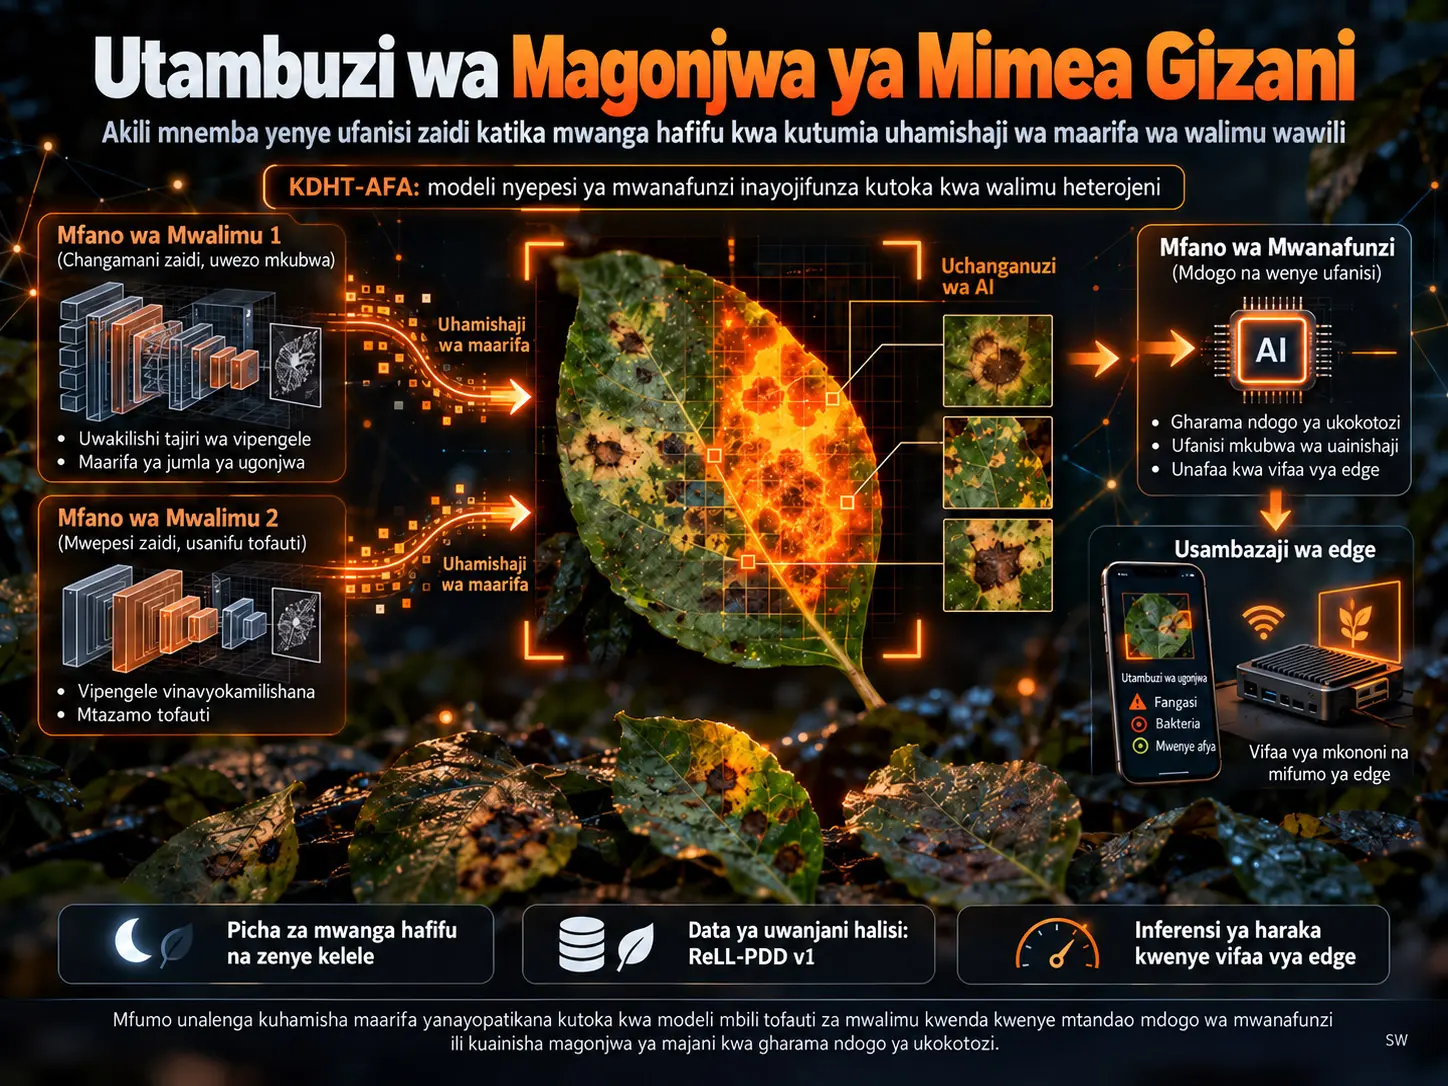
Uhamishaji wa maarifa kutoka kwa miundo tofauti ya walimu wenye upatanishaji wa vipengele unaojirekebisha (Knowledge Distillation using Heterogeneous Teachers with Adaptive Feature Alignment, KDHT-AFA), ni mfumo wa ujifunzaji wa kina unaohamisha taarifa za maamuzi na vipengele vya kati kutoka mitandao miwili tofauti ya walimu kwenda mtandao mdogo zaidi wa mwanafunzi, na kuchagua kwa kujirekebisha ni mwalimu gani anayetoa uwakilishi wenye taarifa nyingi zaidi katika kila kiwango cha mwonekano wa vipengele. Utafiti unalenga kuainisha magonjwa katika picha za majani ya mimea zilizopigwa kwenye mwanga hafifu na zenye kelele ya picha kwa gharama ndogo ya ukokotoaji. DPA-Net yenye uzito mkubwa na EfficientNet-B1 iliyo nyepesi zaidi ziliunganishwa kama walimu, huku RSHA-Net large yenye vigezo milioni 5,16 ikitumika kama modeli kuu ya mwanafunzi. Modeli ilipata wastani wa usahihi wa %92,64 kwenye PlantVillage, %88,97 kwenye Potato Leaf Disease na %86,88 kwenye mkusanyiko wa data za shambani za ReLL-PDD v1 zilizopigwa katika mwanga hafifu wa kweli. Hata hivyo, matokeo hayo ni ya majaribio ya uainishaji wa picha; yenyewe hayathibitishi uhakika wa kilimo wa utambuzi wa magonjwa katika mashamba halisi wala usalama na usahihi wa viuatilifu vinavyopendekezwa.
Sifa inayoutofautisha utafiti si kuunganisha utabiri wa walimu wawili pekee. Adaptive Feature Distillation Switch (AFDS) hulinganisha vipengele vya kati vya DPA-Net na EfficientNet-B1 katika viwango vinne tofauti vya mwonekano wa nafasi; Informative Diversity Statistical Attention (IDSA) hupima vipengele kwa kutumia wastani wa uamilishaji, mkengeuko sanifu na entropia ya Shannon ili kuchagua kipengele cha mwalimu kitakachohamishwa kwa mwanafunzi katika hatua husika. RSHA-Net pia hutumia spatial attention kutokana na utofauti wa pikseli za karibu na channel attention kutokana na taarifa za jumla za chaneli ili kuwakilisha dalili ndogo za ugonjwa kwa uwazi zaidi katika mwanga hafifu.
Tatizo la utafiti
Mitandao yenye uwezo mkubwa inayotumia ujifunzaji wa kina kuainisha magonjwa ya mimea inaweza kufikia usahihi mkubwa; hata hivyo, ukubwa wa modeli, FLOPs, matumizi ya kumbukumbu na muda wa inference vinaweza kuifanya iwe vigumu kuitumia kwenye roboti za kilimo, vifaa vya mkononi au mifumo mingine ya edge. Mwanga hafifu huongeza tatizo hili kwa sababu rangi, mipaka, muundo wa uso na utofauti wa rangi wa madoa ya ugonjwa hudhoofika; kelele kutoka kwenye vihisi inaweza pia kuficha zaidi maelezo muhimu ya picha.
Uhamishaji wa maarifa hushughulikia tatizo hili kwa kuhamisha uhusiano wa maamuzi na uwakilishi wa kati uliojifunzwa na mtandao mkubwa wa mwalimu kwenda kwenye modeli ndogo ya mwanafunzi. Dhana ya kuanzia ya utafiti chanzo ni kwamba mwalimu mmoja si lazima atoe taarifa bora zaidi kwa kila ingizo na katika kila tabaka. Walimu wawili wenye usanifu tofauti wanaweza kunasa aina tofauti za vipengele muhimu; lakini kuviunganisha bila kuchagua kunaweza pia kutoa supervision zinazokinzana.
Kwa nini KDHT-AFA hutumia modeli mbili tofauti za walimu?
KDHT-AFA huunganisha uwakilishi imara wa kiwango cha juu wa DPA-Net katika mwanga hafifu na vipengele vyepesi zaidi na vinavyokamilishana vya EfficientNet-B1; lengo si kukusanya vipengele vyote vya kati vya walimu wote wawili kwa pamoja, bali kutoa taarifa za uamuzi zilizounganishwa katika kiwango cha logit huku ikichagua kupitia AFDS mwalimu mwenye taarifa nyingi zaidi katika kila kiwango cha mwonekano wa feature.
Mwalimu 1: DPA-Net
DPA-Net ni mwalimu mzito zaidi unaotumia usanifu wa msingi wa ConvNext-small. Kwa mujibu wa utafiti chanzo, mtandao hutumia vipengele maalumu kama Triple Dilated Convolution Block, Fused Convolution Block, Multiscale Feature Extraction Block na Pixel Attention Block ili kunasa mifumo ya magonjwa katika mwanga hafifu na utofauti mdogo wa rangi.
Mwalimu 2: EfficientNet-B1
EfficientNet-B1 ni mwalimu wa pili aliye mwepesi zaidi, anayetumia compound scaling na blok za MBConv. Depth-wise separable convolution na squeeze-and-excitation channel attention huruhusu hasa vipengele vya umbo, rangi na mipaka ya maeneo yenye ugonjwa kuwakilishwa kwa gharama ndogo zaidi.
Kuunganisha logit za walimu
Utafiti chanzo ulilinganisha njia nne za score-fusion: weighted sum, weighted product, perceptron rule na Bayesian rule. Kwa sababu matokeo ya juu zaidi yalipatikana kwa weighted sum, muundo wa mwisho wa logits za walimu uliundwa kwa njia hiyo.
\[ S_{\mathrm{sum}}=\omega S_{\mathrm{DPA}}+(1-\omega)S_{\mathrm{Eff}} \]
Hapa \(S_{\mathrm{DPA}}\) inawakilisha logit za makundi za DPA-Net, \(S_{\mathrm{Eff}}\) logit za EfficientNet-B1, na \(\omega\) mgawo unaosawazisha mchango wa vyanzo hivyo viwili. Makala kuu haitoi thamani halisi za \(\omega\) kwa kila fold na inaeleza kwamba migawo hiyo ilichaguliwa kivyake kwa kila fold.
Modeli ya mwanafunzi ya RSHA-Net
RSHA-Net ina hatua nne kuu. Katika toleo kubwa, kina cha marudio ya RSHA-IBR ni 2, 2, 6 na 5, kwa mpangilio huo. Kila hatua hutumia miundo ya channel expansion, RSHA-SepCon na RSHA-IBR. convolution ya kwanza hubadilisha ingizo la 224×224×3 kuwa uwakilishi wa 112×112×24; baadaye vipimo vya nafasi hupunguzwa hadi 56×56, 28×28, 14×14 na 7×7.
Toleo kubwa la mwisho la modeli lina vigezo milioni 5,16. Chanzo pia kililinganisha toleo dogo la RSHA-Net lenye vigezo milioni 1,90, ambamo kina cha hatua ni 1, 1, 3 na 1.
RSHA: kuunganisha muundo wa karibu na taarifa za chaneli
Regional Statistical Hybrid Attention (RSHA) hutumia spatial na channel attention kwa pamoja. Sehemu ya spatial attention hutumia mkengeuko sanifu wa karibu wa pikseli jirani na hivyo kuwa nyeti zaidi kwa madoa, mipaka na mabadiliko ya muundo wa uso kuliko maeneo yaliyo sawa.
\[ \mu(h,w)=\frac{1}{K\times K}\sum_{i=-r}^{r}\sum_{j=-r}^{r}F(h+i,w+j) \]
\[ \sigma(h,w)=\sqrt{\frac{1}{K\times K}\sum_{i=-r}^{r}\sum_{j=-r}^{r} \left[F(h+i,w+j)-\mu(h+i,w+j)\right]^2} \]
Mkengeuko sanifu wa karibu hurekebishwa kwa kiwango cha kawaida kisha kupitishwa kwenye kazi ya sigmoid ili kuunda ramani ya spatial attention. Muundo huu unalenga kuongeza uzito wa maeneo yanayoonyesha mabadiliko dhahiri ya kimuundo ikilinganishwa na mazingira yake, hata katika mwanga hafifu.
Sehemu ya channel attention huhesabu umuhimu wa chaneli kwa kutumia global average pooling na pointwise convolution mbili. Kwa njia hii, chaneli zinazohusiana na rangi na muundo wa ugonjwa huimarishwa huku chaneli zenye manufaa kidogo zikidhoofishwa. Vipengele vyote viwili vya RSHA vilipotumika kwa pamoja, jaribio la ablation katika chanzo lilipata usahihi mkubwa zaidi kuliko kutumia spatial au channel attention peke yake.
AFDS huhamisha kipengele cha mwalimu gani kwa mwanafunzi?
Adaptive Feature Distillation Switch (AFDS) hutumia IDSA kupima vipengele vya kati vya DPA-Net na EfficientNet-B1 vilivyopatanishwa katika kiwango kimoja cha mwonekano wa nafasi, na kuhamisha kwenda RSHA-Net kipengele kimoja tu cha mwalimu chenye alama kubwa zaidi ya taarifa katika hatua hiyo; hivyo hutumia supervision ya kuchagua kulingana na hatua badala ya kuunganisha bila kuchagua vipengele vya kati vya walimu wawili vinavyokinzana.
Upatanishaji wa chaneli
Kwa kuwa DPA-Net na EfficientNet-B1 zina usanifu tofauti, idadi ya chaneli kwenye feature map zinazozalishwa katika mwonekano uleule si sawa. Kwa hiyo AFDS kwanza hutumia 1×1 convolution na batch normalization kupeleka vipengele vya walimu wawili katika nafasi moja ya chaneli. Uamilishaji wa GELU huhifadhiwa upande wa DPA-Net na SiLU upande wa EfficientNet-B1.
Vipimo vitatu vya taarifa vya IDSA
Informative Diversity Statistical Attention (IDSA) hutathmini kipengele cha kila mwalimu kwa takwimu tatu zinazokamilishana:
- Wastani wa uamilishaji (M): huonyesha nguvu ya jumla ya uamilishaji wa kipengele.
- Mkengeuko sanifu (St): huonyesha kiwango cha muundo na utofauti wa karibu.
- Entropia ya Shannon (H): huonyesha utofauti wa taarifa zilizomo katika feature map.
Alama ya mwisho ya IDSA:
\[ S=(\lambda_1M)+(\lambda_2St)+(\lambda_3H) \]
hutolewa kwa namna hiyo. Uzito uliochaguliwa kwa ablation ni \(\lambda_1=0,50\), \(\lambda_2=0,25\) na \(\lambda_3=0,25\). Chanzo hufafanua takwimu hizi si kama vipimo vya moja kwa moja vya “feature quality”, bali kama vipimo vya feature informativeness.
Feature distillation katika viwango vinne
Uhamishaji wa taarifa katika kiwango cha feature hufanyika katika viwango vinne vya mwonekano wa nafasi: 56×56, 28×28, 14×14 na 7×7. Tabaka za mwanzo hubeba vipengele vya kiwango cha chini kama rangi, mipaka na muundo wa uso; tabaka za kati hubeba taarifa za kimuundo na muktadha; na tabaka za kina hubeba uwakilishi wa kisemantiki wa eneo lenye ugonjwa.
Hasara ya feature distillation kati ya kipengele cha mwalimu kilichochaguliwa na kipengele cha mwanafunzi huhesabiwa kwa cosine distance:
\[ \mathcal{L}_{FD}^{(i)} = 1- \frac{F_c^{i}\cdot F_s^{i}} {\lVert F_c^{i}\rVert\lVert F_s^{i}\rVert} \]
Hasara za viwango vinne vya nafasi huchukuliwa wastani ili kupata hasara ya jumla ya feature distillation.
Logit distillation
Logit za mwalimu na mwanafunzi hubadilishwa kuwa mgawanyo wa soft probability uliotumia temperature scaling. Tofauti kati ya migawanyo hiyo huhesabiwa kwa Kullback–Leibler divergence:
\[ \mathcal{L}_{LD} = KL(p^T_{\mathrm{fuse}}\parallel p^T_{\mathrm{st}}) = \sum_{i=1}^{n} p^T_{\mathrm{fuse}}(i) \log \frac{p^T_{\mathrm{fuse}}(i)} {p^T_{\mathrm{st}}(i)} \]
Katika jaribio la ablation la temperature lililoelezwa kwenye Supplementary Material, \(T=5\) ilitoa matokeo bora zaidi kwa ujumla.
Hasara ya jumla ya mafunzo
Mtandao wa mwanafunzi hujifunza kwa wakati mmoja kutoka vyanzo vitatu: lebo halisi ya kundi, matokeo ya soft logits ya mwalimu na kipengele cha kati kilichochaguliwa cha mwalimu.
\[ \mathcal{L}_{total} = \alpha\mathcal{L}_{CE} + \beta\mathcal{L}_{LD} + \gamma\mathcal{L}_{FD} \]
Uzito uliochaguliwa kwa ablation:
- \(\alpha=0,15\) — cross-entropy,
- \(\beta=0,15\) — logit distillation,
- \(\gamma=0,70\) — feature distillation.
Waandishi wa chanzo walitafsiri ongezeko la utendaji lililotokana na kuipa feature distillation uzito mkubwa zaidi kama ishara ya umuhimu wa supervision ya miundo ya kati katika ujifunzaji wa mwanafunzi.
Mbinu na matokeo ya utafiti
Mikusanyiko ya data iliyotumiwa
| Mkusanyiko wa data | Chanzo | Kundi | Picha | Hali ya mwanga |
|---|---|---|---|---|
| Toleo la PlantVillage la mwanga hafifu/kelele | Ubadilishaji wa sintetiki wa mwanga hafifu kutoka PlantVillage ya umma | 38 | 54.305 | Mwanga hafifu wa sintetiki + kelele |
| Toleo la Potato Leaf Disease la mwanga hafifu/kelele | Ubadilishaji wa sintetiki wa mwanga hafifu kutoka mkusanyiko wa data wa umma | 3 | 4.072 | Mwanga hafifu wa sintetiki + kelele |
| ReLL-PDD v1 | Zilikusanywa shambani halisi katika utafiti | 7 | 796 | Hali halisi ya shamba lenye mwanga hafifu |
Yaliyomo kwenye ReLL-PDD v1
| Mmea | Kundi | Picha |
|---|---|---|
| Citrus | Canker | 153 |
| Spinach | Anthracnose | 128 |
| Spinach | Leaf spot | 172 |
| Spinach | Healthy | 69 |
| Ornamental | Blotch of gardenia | 100 |
| Ornamental | Insect attack | 109 |
| Ornamental | Healthy | 65 |
| Jumla | Makundi 7 | 796 |
ReLL-PDD v1 ilikusanywa Sargodha, Pakistan, kati ya Desemba 2025 na Februari 2026. Infinix Hot 30 na Samsung A23 zilitumiwa kupiga picha; kila jani lilipigwa picha mara moja tu ili kupunguza uwezekano wa sampuli ileile kuvuja katika sehemu tofauti za data. Lebo ziliwekwa na kuthibitishwa na mtaalamu wa kilimo kwa kuzingatia dalili zinazoonekana.
Mpangilio wa mafunzo na tathmini
| Kigezo | Thamani |
|---|---|
| Cross-validation | Fold 5 |
| Mafunzo kwa kila fold | %72 |
| Uthibitishaji kwa kila fold | %8 |
| Jaribio kwa kila fold | %20 |
| Learning rate | 0,0005 |
| Batch size | 8 |
| Optimizer | Adam |
| Idadi ya juu ya epoch | 100 |
| Early stopping | Validation accuracy |
| Logit temperature | T=5 |
| Mazingira ya uundaji | PyTorch 1.12.0, PyCharm 2023.3.2, Anaconda 2023.09-0 |
| GPU ya mafunzo | NVIDIA GeForce GTX 1070, 8 GB |
Athari za uhamishaji wa maarifa kwa modeli ya mwanafunzi
| Mkusanyiko wa data | Hali | Accuracy | F1-score |
|---|---|---|---|
| PlantVillage | RSHA-Net large, bila KD | %88,89 ± 0,30 | %84,99 ± 0,58 |
| PlantVillage | KDHT-AFA | %92,64 ± 0,21 | %91,48 ± 0,40 |
| Potato Leaf Disease | RSHA-Net large, bila KD | %84,10 ± 4,62 | %83,98 ± 4,91 |
| Potato Leaf Disease | KDHT-AFA | %88,97 ± 1,43 | %88,92 ± 1,42 |
| ReLL-PDD v1 | RSHA-Net large, bila KD | %85,82 ± 7,42 | %85,93 ± 6,85 |
| ReLL-PDD v1 | KDHT-AFA | %86,88 ± 7,77 | %86,25 ± 8,19 |
Katika PlantVillage na Potato Leaf Disease, uhamishaji wa maarifa uliongeza utendaji kwa kiasi kikubwa. Katika ReLL-PDD v1, ongezeko la accuracy lilikuwa dogo zaidi, na wastani wa F1-score uliongezeka kutoka 85,93 bila KD hadi 86,25 kwa KD. Kwa hivyo, hitimisho kwamba “KD ilileta manufaa yenye ukubwa sawa katika kila mkusanyiko wa data” haliungwi mkono na chanzo.
Jaribio la ablation: viwango vya mwonekano vya feature distillation
| Viwango vya feature | Accuracy | F1-score |
|---|---|---|
| Bila feature distillation | %88,56 | %84,46 |
| 56×56 | %88,96 | %84,86 |
| 56×56 + 28×28 | %89,53 | %85,48 |
| + 14×14 | %89,76 | %85,89 |
| + 7×7 — viwango vinne | %90,12 | %86,21 |
Jaribio la ablation: uchaguzi wa mwalimu
| Mkakati | Accuracy | F1-score |
|---|---|---|
| Teacher 1 katika kila kiwango | %89,18 | %85,12 |
| Teacher 2 katika kila kiwango | %89,54 | %85,45 |
| T1–T2 kwa kupokezana | %89,05 | %84,73 |
| T2–T1 kwa kupokezana | %89,71 | %85,84 |
| Uchaguzi unaojirekebisha kwa AFDS | %90,12 | %86,21 |
Jaribio la ablation: utaratibu wa attention
| Attention | Accuracy | F1-score |
|---|---|---|
| Standard-deviation spatial pekee | %88,16 | %83,82 |
| Channel attention pekee | %89,59 | %85,84 |
| CBAM | %88,36 | %83,85 |
| ECA | %88,89 | %84,68 |
| Coordinate attention | %89,33 | %85,59 |
| SimAM | %87,64 | %83,03 |
| Spatial + channel RSHA inayopendekezwa | %90,12 | %86,21 |
KDHT-AFA ilifanikiwa kwa kiasi gani katika data halisi za shambani za mwanga hafifu?
Kwenye ReLL-PDD v1, KDHT-AFA inayotumia RSHA-Net large ilipata accuracy ya %86,88±7,77, precision ya %86,82±8,00, recall ya %85,95±8,14 na F1-score ya %86,25±8,19; huo ndio wastani wa accuracy wa juu zaidi miongoni mwa mbinu zilizolinganishwa katika mpangilio uleule wa majaribio. Hata hivyo, kuwa na picha 796 pekee na tofauti kubwa za mikengeuko sanifu kati ya fold kunahitaji tahadhari wakati wa kueneza matokeo kwa hali nyingine za shambani.
Ufafanuzi wa ulinganisho wa SOTA
Katika PlantVillage, DPA-Net ilipata accuracy ya %92,11 na F1-score ya %89,11, huku KDHT-AFA large ikifikia %92,64 na %91,48. Katika Potato Leaf Disease, DPA-Net ilipata accuracy ya %88,92 na F1-score ya %88,60, na KDHT-AFA ilipata %88,97 na %88,92. Katika ReLL-PDD v1, accuracy ya pili kwa ubora zaidi katika mbinu zinazotumia KD ilikuwa %85,71 kwa GoLD Loss, huku KDHT-AFA ikifikia %86,88.
Kutumia upya na kufundisha upya mbinu zote za SOTA katika hali zilezile za majaribio huimarisha ulinganifu wa ndani wa tathmini. Hata hivyo, matokeo haya yanahusu tu mgawanyo wa data, mbinu ya kutengeneza mwanga hafifu, itifaki ya mafunzo na mikusanyiko mitatu ya data iliyotumika kwenye utafiti.
Tathmini ya takwimu
| Mkusanyiko wa data | Paired t-test p | Cohen's d | Tafsiri ya chanzo |
|---|---|---|---|
| PlantVillage | 0,0013 | 2,0845 | Athari kubwa |
| ReLL-PDD v1 | 0,039 | 1,1939 | Athari kubwa |
Takwimu hizi zinategemea uchunguzi tano tu wa accuracy uliowekwa katika jozi kutoka fold tano. Kwa hiyo, thamani ya p na Cohen's d hazipaswi kutafsiriwa kama athari ya mamia ya majaribio tofauti yaliyofanywa kwenye makundi huru ya watu au maeneo ya shambani.
Gharama ya ukokotoaji
| Modeli | Vigezo | Kumbukumbu | FLOPs |
|---|---|---|---|
| RSHA-Net small | 1,90 M | 7,29 MB | 0,31 G |
| RSHA-Net large | 5,16 M | 19,81 MB | 0,59 G |
Inference kwenye kifaa cha edge
| Modeli | Jetson TX2 | Jetson Orin Nano | GPU ya kompyuta ya mezani | Simu |
|---|---|---|---|---|
| RSHA-Net small | 6,47 ms / 154,60 FPS | 1,15 ms / 869,57 FPS | 0,76 ms / 1315,79 FPS | 12,11 ms / 82,58 FPS |
| RSHA-Net large | 10,63 ms / 94,07 FPS | 2,39 ms / 418,41 FPS | 1,35 ms / 740,74 FPS | 27,97 ms / 35,75 FPS |
Katika vipimo vya edge, batch size 1 na FP16 precision zilitumiwa; bodi ziliendeshwa katika hali ya utendaji wa juu kabisa kwa masafa ya saa yasiyobadilika na angalau 200 ms warm-up ilitumika. Matumizi ya umeme yalirekodiwa kutoka vihisi vya INA3221 kila baada ya sekunde 0,1.
| Modeli | Jetson TX2 | Jetson Orin Nano |
|---|---|---|
| RSHA-Net small | 7,47 W | 5,41 W |
| RSHA-Net large | 6,84 W | 2,92 W |
Baadhi ya vifaa kuonyesha matumizi ya nguvu ya board-level yaliyo chini zaidi kwa modeli kubwa kuliko modeli ndogo kunaonyesha kuwa idadi ya vigezo haiamui matumizi ya nguvu peke yake. Chanzo kinahusisha hili na mambo ya kiwango cha maunzi kama matumizi ya GPU, CPU–GPU overhead, kernel execution efficiency na memory access pattern.
Uchambuzi wa makosa
Katika confusion matrix ya PlantVillage, matatizo makubwa zaidi ya uainishaji yalionekana katika madarasa ya tomato early blight (%32 makosa), corn gray leaf spot (%27), pepper bacterial spot (%23) na tomato target spot (%22). Makosa ya tomato early blight yalitawanyika katika makundi mengi, ilhali sehemu kubwa ya makosa ya corn gray leaf spot yalielekezwa kwenye corn leaf blight.
Mifano ya Grad-CAM inaonyesha taratibu tatu kuu za makosa: sifa za pamoja za nekrosisi/muundo wa uso miongoni mwa magonjwa yanayofanana, kupotea kwa maelezo ya vidonda vidogo kutokana na mwanga hafifu, na modeli kuangazia muundo mpana zaidi au usiohusika badala ya eneo lenye ugonjwa. Mifano ya spinach anthracnose kuainishwa kuwa spinach leaf spot na spinach leaf spot kuainishwa kuwa healthy katika ReLL-PDD v1 inaonyesha tatizo hili.
Ujumlishaji kati ya mikusanyiko ya data
Utendaji ulipungua modeli ilipofundishwa kwenye mkusanyiko mmoja wa data na kupimwa kwenye mwingine. Chanzo kinahusisha athari hii ya domain-shift na tofauti za mandharinyuma, mwangaza na mwonekano wa ugonjwa. Kwa kuwa matokeo ya nambari ya cross-dataset yamewekwa kwenye Supplementary Table S3, hakuna viwango halisi vilivyotolewa kutokana na makala kuu.
Je, mapendekezo ya viuatilifu ya SPPM yamethibitishwa na wataalamu?
Hapana. Smart Pesticide Prescription Module (SPPM) ni muunganisho wa edge-server wa kiwango cha proof-of-concept unaotuma jina la ugonjwa uliotambuliwa na KDHT-AFA kwenda LLaMA 3.2 na kurudisha taarifa za viuatilifu kwenye programu ya simu; chanzo kinasema wazi kwamba mapendekezo yanayotolewa hayajathibitishwa kwa utaratibu na wataalamu wa kilimo. Hivyo SPPM haipaswi kutumiwa kama mfumo wa maamuzi ya kilimo unaoaminika sawa na “agizo la dawa” kwa maana ya kitabibu.
Mtiririko wa kazi wa SPPM
- Kamera ya simu hupiga picha ya jani la mmea.
- Modeli ya KDHT-AFA/RSHA-Net katika muundo wa ONNX iliyo kwenye programu ya simu hutabiri kundi la ugonjwa.
- Taarifa za ugonjwa uliogunduliwa hutumwa kwa seva kupitia HTTP.
- LLaMA 3.2 kwenye seva huzalisha pendekezo la maandishi kuhusu kiuatilifu.
- Jibu la HTTP hurudishwa kwenye kifaa cha simu.
Mtiririko huu unaonyesha uwezekano wa kutekeleza muunganisho wa kiufundi. Ufanisi wa kiuatilifu, kipimo, usajili wa bidhaa, sheria za eneo husika, mdudu au kisababishi lengwa, hatua ya ukuaji wa mmea, hatari kwa mazingira na usalama wa binadamu havijathibitishwa kwa majaribio katika utafiti huu.
Matokeo yanayoungwa mkono na utafiti
- Kuhamisha kwa pamoja taarifa za logit na vipengele vya kati vilivyochaguliwa kutoka walimu wawili tofauti kunaweza kutoa utendaji wa juu zaidi kuliko mikakati inayotumia mwalimu mmoja au uteuzi usiobadilika katika mazingira ya majaribio ya utafiti huu.
- Feature distillation katika viwango vinne vya mwonekano iliongeza utendaji ikilinganishwa na muundo unaotumia logit supervision pekee.
- Kutumia pamoja vipengele vya spatial na channel attention vya RSHA kulitoa accuracy kubwa kuliko mifumo mbadala ya attention iliyochunguzwa.
- RSHA-Net large ilionyesha utendaji imara sana wa uainishaji miongoni mwa mbinu zilizolinganishwa katika mikusanyiko yote mitatu ya data.
- Mtandao wa mwanafunzi uliopendekezwa ulitathminiwa kwa vipimo halisi vya inference-time kwenye Jetson TX2, Jetson Orin Nano, kifaa cha simu na kompyuta ya mezani.
- Uchambuzi wa Grad-CAM ulionyesha modeli inaweza kuangazia maeneo yenye ugonjwa katika mifano mingi iliyotambuliwa kwa usahihi, lakini katika hali za makosa inaweza kuelekeza umakini kwenye maeneo yasiyo sahihi au mapana kupita kiasi.
Matokeo yasiyoungwa mkono na utafiti
- KDHT-AFA haihakikishi usahihi uleule kwenye mazao yote, magonjwa yote na maeneo yote ya kijiografia.
- Accuracy ya %86,88 kwenye ReLL-PDD v1 haimaanishi utendaji huohuo utapatikana katika mashamba yote halisi.
- Utendaji wa cross-dataset ulipungua chini ya domain shift.
- Uainishaji wa picha hauthibitishi kuwa unaweza kuchukua nafasi ya vipimo vya maabara au uthibitisho wa mtaalamu wa magonjwa ya mimea.
- Mapendekezo ya viuatilifu ya SPPM hayajathibitishwa kwa utaratibu na wataalamu wa kilimo.
- Chanzo hakikupima mafanikio ya udhibiti wa magonjwa au ongezeko la mavuno wakati wa operesheni ya muda mrefu ya roboti halisi ya kilimo shambani.
Mapungufu makuu
ReLL-PDD v1 ina picha 796 tu na imewekewa mipaka ya vikundi vitatu vya mimea. Sampuli zilikusanywa Sargodha pekee ndani ya kipindi cha takribani miezi mitatu; utofauti wa mazao, mabadiliko ya msimu na utofauti wa maeneo ya kijiografia ni mdogo.
Kutokuwepo kwa kundi la mmea wenye afya linalolingana kwa baadhi ya mimea kunaweza kuleta upendeleo wa uainishaji. Aidha, kupungua kwa mwonekano wa vidonda vidogo katika mwanga hafifu, mifumo ya kuona inayofanana kati ya magonjwa yanayofanana na localization isiyo sahihi ni vyanzo muhimu vya makosa ya modeli.
Matoleo ya mwanga hafifu ya PlantVillage na Potato Leaf Disease si picha halisi za shamba zilizopigwa usiku, bali ni mabadiliko ya sintetiki ya mwanga hafifu/kelele yaliyotokana na utafiti uliochapishwa awali. Makala hii haijatoa tena maelezo ya kina ya vigezo vyote vya kubadilisha picha vilivyotumika kuunda uharibifu huo wa sintetiki.
SPPM ni proof-of-concept tu. Kwa kuwa matokeo ya LLM hayajathibitishwa na wataalamu, usahihi wa pendekezo, usalama wake kwa zao husika au kufuata sheria za eneo husika kuhusu viuatilifu havijathibitishwa.
Kutokuwiana kwa taarifa za upatikanaji wa data ndani ya chanzo
Sehemu ya Introduction ya makala inasema msimbo wa KDHT-AFA na mikusanyiko mitatu ya data iliyotumiwa inapatikana hadharani kwenye GitHub. Utafiti huohuo unaitaja ReLL-PDD v1 kuwa mkusanyiko mpya wa data uliochukuliwa. Kinyume chake, tamko la mwisho la Data Availability linasema “No datasets were generated or analysed during the current study”. Kwa kuwa kauli hizi mbili hazipatani, Verianla haifanyi marekebisho ya upande mmoja kuhusu upatikanaji wa data.
Maelezo ya chanzo na mbinu
Utafiti asilia: Seeing through the dark: adaptive switch-guided knowledge distillation via heterogeneous teachers for robust plant disease diagnosis
Waandishi: Hafiz Ali Hamza Gondal; Su Jin Im; Muhammad Hamza Tariq; Muhammad Irfan; Muhammad Usman; Muhammad Ahmad Zeshan; Kang Ryoung Park.
Mwandishi anayewajibika: Kang Ryoung Park.
Taasisi: Division of Electronics and Electrical Engineering, Dongguk University, Seoul, Republic of Korea; Department of Plant Pathology, College of Agriculture, University of Sargodha, Sargodha, Pakistan.
Jarida: Journal of King Saud University Computer and Information Sciences.
Jukwaa / mchapishaji: Springer Nature.
Juzuu / nambari ya makala: 38, 826.
Tarehe ya kuchapishwa: 31 Agosti 2026.
Kupokelewa / kukubaliwa: 16 Juni 2026 / 10 Agosti 2026.
DOI: 10.1007/s44443-026-01238-9.
Aina ya chanzo: Utafiti wa majaribio wa ujifunzaji wa mashine / ujifunzaji wa kina uliofanyiwa mapitio ya kitaalamu.
Mbinu kuu: Uhamishaji wa maarifa kwa walimu wawili tofauti; logit fusion, uteuzi unaojirekebisha wa vipengele vya kati kwa AFDS, IDSA, RSHA-Net.
Modeli za walimu: DPA-Net na EfficientNet-B1.
Mwanafunzi: RSHA-Net small na RSHA-Net large; toleo kuu lenye utendaji mkubwa ni modeli ya large yenye vigezo milioni 5,16.
Mikusanyiko ya data: Toleo la mwanga hafifu/kelele la PlantVillage; toleo la mwanga hafifu/kelele la Potato Leaf Disease; ReLL-PDD v1.
ReLL-PDD v1: Picha 796 halisi za shambani kwenye mwanga hafifu; mimea ya citrus, spinach na ornamental; Sargodha, Pakistan; Desemba 2025–Februari 2026.
Tathmini: Cross-validation ya fold tano; kila fold ina %72 ya mafunzo, %8 ya uthibitishaji na %20 ya majaribio.
Optimizer: Adam.
Learning rate: 0,0005.
Batch size: 8.
Idadi ya juu ya epoch: 100.
Early stopping: Validation accuracy.
Vipimo vya utendaji: Accuracy, macro-precision, macro-recall na F1-score.
Takwimu: Paired t-test na Cohen's d kwa kutumia accuracy za fold tano kwenye PlantVillage na ReLL-PDD v1.
Tathmini ya edge: Jetson TX2, Jetson Orin Nano, Samsung S21 na mfumo wa kompyuta ya mezani.
Uwezo wa kuelezeka: Grad-CAM.
Moduli ya LLM: SPPM yenye LLaMA 3.2; proof-of-concept pekee, hakuna uthibitisho wa wataalamu.
Maadili: Chanzo kilisema “Not applicable”.
Ufadhili: National Research Foundation of Korea; Ministry of Science and ICT; Grant RS-2026-25470264.
Michango ya waandishi: Hafiz Ali Hamza Gondal na Kang Ryoung Park waliandika maandishi makuu ya makala. Su Jin Im, Muhammad Hamza Tariq, Muhammad Irfan, Muhammad Usman na Muhammad Ahmad Zeshan walichangia majaribio na uthibitishaji. Waandishi wote waliipitia makala.
Mgongano wa maslahi: Katika sehemu inayoonekana ya declarations ya PDF iliyowasilishwa, tamko tofauti la competing-interests halikupatikana; haikuchukuliwa kuwa hakuna mgongano huo.
Upatikanaji wa data: Kauli kuhusu GitHub/data huria katika maandishi makuu haipatani na tamko la mwisho “No datasets were generated or analysed”.
Leseni: Creative Commons Attribution-NonCommercial-NoDerivatives 4.0 International (CC BY-NC-ND 4.0). Matoleo yaliyobadilishwa ya vielelezo au mipangilio ya uwasilishaji kutoka chanzo hayakuhamishwa kwenda makala ya Verianla.
Kikomo kikuu cha tafsiri ya matokeo: Utafiti unapima utendaji wa uainishaji wa picha na edge inference; hauthibitishi utambuzi wa uhakika katika mazingira yote halisi ya kilimo, mavuno au uaminifu wa mapendekezo ya viuatilifu yanayotegemea LLM.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *