

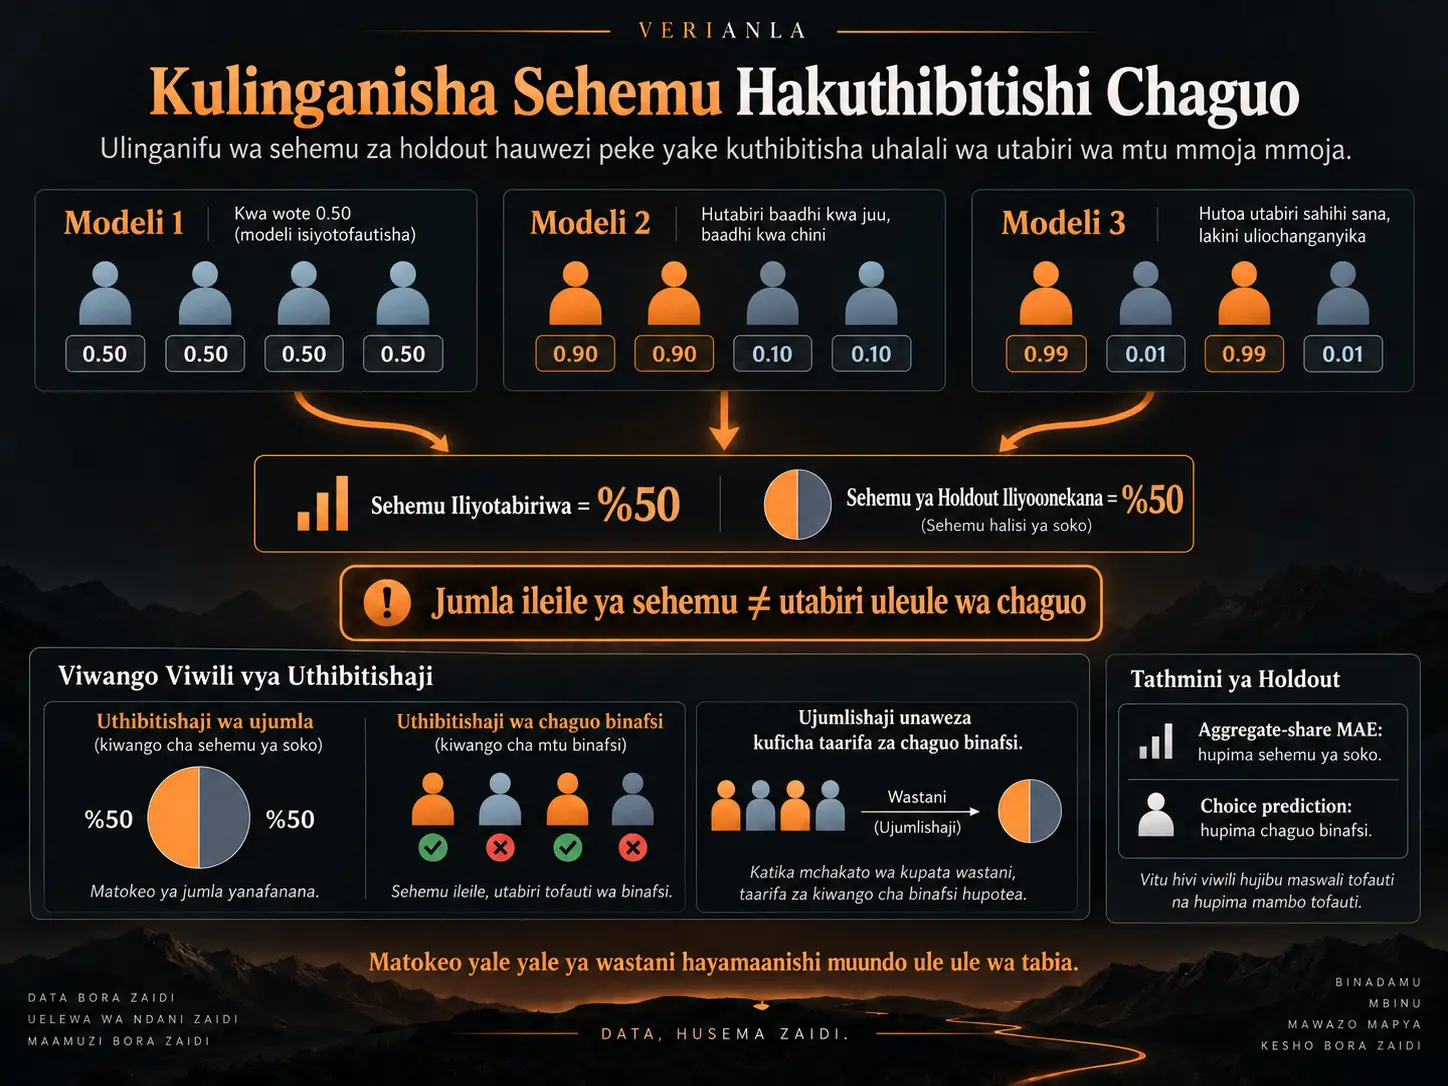
Aggregate-share mean absolute error (aggregate-share MAE), ni kipimo cha hitilafu ya ujumla kinachopima tofauti kamili ya wastani kati ya jumla ya sehemu za mbadala zinazotabiriwa na modeli ya uchaguzi tofauti na jumla ya sehemu zinazoonekana katika sampuli ya holdout. Utafiti wa Jake Lee, huku ukikubali kuwa kipimo hiki kinaweza kuwa halali kwa utabiri wa sehemu ya soko, unasema kwamba hakitoshi peke yake kuthibitisha uhalali wa utabiri wa nje wa chaguo za mtu mmoja mmoja. Sababu kuu ni kwamba mifumo tofauti sana ya uwezekano wa uchaguzi wa mtu binafsi inaweza kutoa sehemu ileile ya wastani ya soko. Utabiri unapowekwa wastani kwanza na kisha kulinganishwa na sehemu za holdout, taarifa kuhusu modeli ilitabiri kwa usahihi kiasi gani chaguo la kila mtu hupotea. Kwa hiyo aggregate-share MAE ya chini inaweza kuonyesha kuwa modeli imezalisha upya vizuri sehemu za aggregate katika data mpya; lakini hilo halimaanishi moja kwa moja kwamba modeli inatabiri vizuri zaidi tabia ya uchaguzi wa mtu binafsi katika data ya nje.
Mfano ulio katikati ya utafiti ni rahisi sana. Katika sampuli huru ya holdout ya watu mia moja, ikiwa watu 50 wanachagua A na watu 50 wanachagua B, sehemu zinazoonekana ni %50–%50. Model 1 ikitabiri pia %50–%50, aggregate MAE huwa sifuri. Model 2 ikitabiri %60–%40, aggregate MAE huwa pointi 10 za asilimia. Kwa kulinganisha kwa ujumla, Model 1 hushinda wazi. Hata hivyo, utabiri wa Model 1 wa sehemu ya %50 ya A unaweza kutokana na kutoa uwezekano wa \(0.50\) kwa kila mtu, au kutoa takriban \(0.90\) kwa nusu ya watu na \(0.10\) kwa nusu nyingine. Modeli hizi zinatoa matokeo sawa katika kiwango cha aggregate lakini zinawakilisha miundo tofauti kabisa ya uchaguzi katika kiwango cha mtu binafsi.
Hoja ya mwandishi hailengi tu fomula ya MAE. Baada ya utabiri kupunguzwa kwanza kuwa sehemu za aggregate, matumizi ya MAD, MSE, RMSE au kazi nyingine yoyote ya hitilafu yanakabiliwa na upotevu huohuo wa msingi wa taarifa. Tatizo hutokea kabla ya fomula ya kipimo: kiwango cha tathmini kimeshushwa kutoka chaguo za mtu binafsi hadi wastani wa aggregate.
Makala pia inaweka mpaka muhimu. Ikiwa lengo halisi la utabiri wa utafiti ni sehemu ya soko ya aggregate, uthibitishaji wa aggregate-share ni halali. Hata hivyo, ushahidi huu unaruhusu hitimisho tu kuhusu hali za soko zilizojaribiwa na upeo wa mabadiliko uliokuwapo kweli katika hali hizo. Ikiwa lengo ni kutabiri mwitikio wa soko wakati bei, usanidi wa bidhaa au hali za ushindani zinabadilika, hali za uthibitishaji lazima zijumuishe mabadiliko hayo yenye maana.
Jukumu kuu la uthibitishaji wa holdout ni nini?
Modeli inaweza kutoshea vizuri sana data iliyotumiwa kuunda vigezo vya mafunzo au makadirio na bado ikafanya vibaya zaidi katika data mpya. Kadiri unyumbufu wa modeli unavyoongezeka, mfumo wa utabiri unaweza kujifunza si tu muundo halisi na unaoweza kujumlishwa wa tabia, bali pia mifumo ya nasibu iliyo mahususi kwa data ya makadirio. Hili ni tatizo la kufaa kupita kiasi, yaani overfitting.
Kwa hiyo kazi ya msingi ya uthibitishaji wa holdout si tu kutoa kipimo cha hitilafu. Holdout ni utaratibu wa kinga unaojaribu kama ubora unaoonekana wa modeli katika data ya mafunzo kweli unahamia kwenye data mpya. Ikiwa faida inayoonekana inashindwa kwenye data ambayo haikutumika kuunda modeli, imani kwamba faida katika data ya mafunzo inaweza kujumlishwa hupungua.
Chanzo kinasema kuwa data ya holdout inaweza kutoka kwenye mgawanyo tofauti wa sampuli au sampuli ya uthibitishaji iliyokusanywa kabisa kando. Sharti kuu ni kwamba data inayowasilishwa kama “out-of-sample” haikutumiwa kuzalisha matokeo yanayopaswa kuthibitishwa.
Je, Aggregate-Share MAE Inathibitisha Uhalali wa Utabiri wa Nje?
Hapana; kwa dai la uhalali wa utabiri wa nje wa chaguo za mtu binafsi, aggregate-share MAE haitoshi peke yake. Aggregate-share MAE huonyesha jinsi sehemu ya wastani inayotabiriwa na modeli ilivyo karibu na sehemu ya wastani iliyotokea katika sampuli ya holdout; lakini kwa kuwa haiwezi kutofautisha mifumo tofauti ya utabiri wa mtu binafsi inayotoa sehemu ileile ya aggregate, haiwezi kubainisha kama modeli inatabiri chaguo vizuri zaidi kweli katika data mpya.
Katika hitimisho hili, “kama data ya holdout ni ya nje au la” lazima itenganishwe na “ni taarifa gani kipimo cha uthibitishaji kinachotumiwa kinajaribu”. Sampuli inaweza kuwa huru kabisa na ya nje, lakini ikiwa utabiri wa modeli hupunguzwa kwanza kuwa sehemu ya aggregate, tathmini bado hubeba taarifa ya kiwango cha aggregate pekee.
Kutumia data mpya hakurudishi taarifa ya mtu binafsi iliyopotezwa na kigezo cha tathmini. Kwa sababu hiyo, chanzo kinachukulia kama hitimisho batili kujenga matokeo ya comparative external predictive validity kwa chaguo za mtu binafsi kwa kutegemea tu ulinganisho wa aggregate-share.
Maonyo ya awali katika fasihi
Utafiti hauwasilishi tatizo kama jambo lililogunduliwa sasa hivi. Mwandishi anakusanya fasihi ya awali ya uchaguzi tofauti iliyoonyesha kuwa viwango tofauti vya uthibitishaji vinaweza kutoa upangaji tofauti wa modeli.
- Utafiti wa Hagerty wa 1986 ulionyesha kuwa utabiri wa mapendeleo ya mtu binafsi na utabiri wa sehemu ya soko ni malengo tofauti na unaweza kutuza ugumu wa modeli kwa namna tofauti.
- Utafiti wa Huber na wenzake wa 1993 uliripoti kwamba vipimo vya utabiri wa mtu binafsi na aggregate-share MAE vinaweza kutoa matokeo tofauti katika upangaji wa utendaji.
- Allenby, Arora na Ginter mwaka 1995 walisisitiza kwamba tahadhari inahitajika wakati vipimo vya aggregate first-choice share vinapotumiwa kama ushahidi wa predictive fit.
- Moore, Gray-Lee na Louviere mwaka 1998 waliripoti kupata ulinganifu dhaifu tu kati ya uthibitishaji wa kiwango cha mtu binafsi na aggregate.
- Chanzo kinachukulia utafiti wa Sablotny-Wackershauser na wenzake wa 2024 kama mfano wa sasa wa kuendelea kutumia aggregate share MAE katika sampuli tofauti ya uthibitishaji.
Mchango wa Jake Lee, kwa mujibu wa maelezo ya mwandishi mwenyewe, ni kuyaunganisha mambo haya chini ya kanuni moja ya uhitimishaji: tayari inajulikana kwamba utendaji wa aggregate share unaweza kutofautiana na utendaji wa utabiri wa choice-level; kwa hiyo inapaswa kusemwa wazi kwamba aggregate-share MAE haiwezi kuhesabiwa kuwa ushahidi wa kutosha wa kulinganisha kuhusu uhalali wa utabiri wa nje wa chaguo za mtu binafsi.
Mfano rahisi wa holdout
Chanzo kinatumia mfano rahisi wa uchaguzi wa aina mbili wa watu mia moja ili kufanya tatizo lionekane. Watu wote 100 katika sampuli ya holdout wanakabiliwa na hali ileile ya uchaguzi wa A/B.
| Kipimo | Holdout iliyoonekana | Model 1 | Model 2 |
|---|---|---|---|
| Sehemu inayochagua A | 50% | 50% | 60% |
| Sehemu inayochagua B | 50% | 50% | 40% |
| Aggregate MAE | - | 0 | pointi 10 za asilimia |
Kwa tathmini ya aggregate, Model 1 inaonekana kamilifu. Inazalisha upya kabisa mgawanyo ulioonekana wa %50–%50 kwa A na B, na aggregate MAE ni sifuri.
Hata hivyo, haiwezi kujulikana kutokana na matokeo ya aggregate ni utabiri gani wa mtu binafsi ulio chini ya wastani wa %50. Modeli inaweza kuwa imetabiri uwezekano wa A kuwa \(0.50\) kwa kila mtu. Modeli nyingine inaweza kuwa imetoa \(0.90\) kwa nusu ya watu na \(0.10\) kwa nusu nyingine. Miundo yote miwili inaweza kufikia wastani wa %50 wa sehemu ya A.
Kwa hiyo, kauli “Model 1 ilitabiri kwa usahihi sehemu za aggregate” si sawa na kauli “Model 1 ilijifunza kwa usahihi tabia za uchaguzi za watu binafsi”.
Ujumlishaji Hupoteza Sehemu Gani ya Taarifa ya Utabiri?
Ujumlishaji hupunguza muundo kati ya uwezekano wa uchaguzi ambao modeli hutengeneza kwa kila mtu na chaguo lililotokea la mtu huyo au uchunguzi unaoweza kulinganishwa kuwa wastani mmoja. Kwa kuwa vekta nyingi tofauti za utabiri zenye wastani uleule huwa sawa kwa mtazamo wa kipimo cha aggregate, haiwezekani kubaini kutoka kwa ulinganisho wa sehemu ya aggregate kama modeli imejifunza kwa usahihi tabia tofauti za uchaguzi.
Chanzo kinafafanua sehemu ya aggregate inayotabiriwa na modeli katika hali ya uchaguzi wa aina mbili kama ifuatavyo:
\[ \bar{p}=\frac{1}{N}\sum_{i=1}^{N}p_i \]
Hapa \(p_i\) ni uwezekano wa uchaguzi ambao modeli inampa mbadala husika kwa mtu wa \(i\) anayemodeliwa; na \(N\) ni idadi ya uchunguzi katika idadi ya watu ya modeli inayotumiwa kubadilisha utabiri kuwa sehemu ya aggregate.
Sehemu ya uchaguzi uliotokea iliyoonekana katika sampuli ya holdout ni:
\[ \bar{y}=\frac{1}{M}\sum_{k=1}^{M}y_k \]
huonyeshwa kwa namna hii. Hapa \(y_k\) ni kiashiria cha uchaguzi wa aina mbili uliotokea kwa uchunguzi wa \(k\) katika sampuli ya holdout, na \(M\) ni ukubwa wa sampuli ya holdout.
Jambo ambalo chanzo kinalisisitiza hasa ni kwamba wastani hizi mbili si lazima zitokane na data za watu wale wale. Idadi ya watu ya utabiri na sampuli ya holdout zinaweza kuwa na washiriki tofauti na ukubwa wa sampuli unaweza pia kutofautiana. Uthibitishaji wa aggregate hulinganisha tu wastani zinazotokea.
Vekta tofauti za utabiri zinazotoa sehemu ileile ya %50
Vekta tatu za mfano za utabiri zinazotolewa na chanzo ni hizi:
\[ (0.5,\;0.5,\;0.5,\;0.5) \]
\[ (0.9,\;0.9,\;0.1,\;0.1) \]
\[ (0.99,\;0.01,\;0.99,\;0.01) \]
Wastani wa kihesabu wa vekta zote tatu ni \(0.50\). Hata hivyo, miundo ya uchaguzi inayowakilisha ni tofauti wazi.
| Vekta ya utabiri | Sehemu ya aggregate ya A | Muundo katika kiwango cha mtu binafsi |
|---|---|---|
| (0.5, 0.5, 0.5, 0.5) | 50% | Kutokuwa na uhakika kabisa kwa kila mtu |
| (0.9, 0.9, 0.1, 0.1) | 50% | Utabiri wenye mwelekeo mkubwa kwa A kwa watu wawili na kwa B kwa watu wawili |
| (0.99, 0.01, 0.99, 0.01) | 50% | Utabiri karibu wa kuamua kabisa lakini katika mielekeo tofauti kati ya watu |
Ikiwa holdout inatathminiwa tu kwa sehemu ya aggregate ya %50 A na %50 B, utabiri wote watatu unaweza kupata alama sawa ya aggregate. Hii ndiyo sababu ulinganisho wa aggregate hauwezi kusema ni modeli gani iliyo karibu zaidi na muundo halisi wa uchaguzi wa mtu binafsi.
Kwa nini tatizo si MAE pekee?
Ingawa chanzo kinaanza mjadala na MAE, kinasisitiza kwamba mantiki si mahususi kwa MAE. Baada ya utabiri wa modeli kupunguzwa kwanza kuwa sehemu ya aggregate, kutumia MAD, MSE, RMSE au kazi nyingine ya hitilafu hakuondoi tatizo la msingi.
Kwa sababu upotevu wa taarifa umetokea kabla ya fomula ya hitilafu kutumiwa. Taarifa kuhusu ni chaguo zipi zilizotokea zinazohusiana na thamani za mtu binafsi za \(p_i\) imepunguzwa kuwa thamani moja ya \(\bar p\). Operesheni ya hisabati inayofuata haiwezi kurejesha uhusiano huu uliopotea.
Kwa maneno mengine, tatizo si kwamba “MAE ni fomula isiyo sahihi”. Tatizo ni kwamba, kwa lengo la kutathmini dai pana la choice-level predictive-validity, upimaji wa alama unafanywa katika kiwango cha aggregate.
Je, Kutumia Majukumu Zaidi ya Holdout Hutatua Tatizo?
Ikiwa kila jukumu la holdout bado hupunguzwa kwanza kuwa sehemu ya aggregate, kuongeza tu idadi ya majukumu hakutatui tatizo la msingi. Kuhesabu hitilafu za sehemu ya aggregate katika hali tano, kumi au kumi na tano tofauti za holdout hutengeneza ulinganisho zaidi wa aggregate; lakini ikiwa uhusiano kati ya utabiri wa mtu binafsi na chaguo zilizotokea unapotea katika kila jukumu kabla ya aggregation, mchakato huu haugeuki kuwa jaribio la choice-level external predictive validity.
Chanzo hapa kinatenganisha hali ya pili muhimu. Muundo ambao majukumu ya holdout yanajumuisha mabadiliko yenye maana ya hali ya soko kama bei tofauti, sifa za bidhaa au hali za ushindani unaweza kutoa taarifa halisi kwa utabiri wa mwitikio wa aggregate wa soko.
Kwa hiyo tatizo si kwamba “holdout nyingi hazina manufaa yoyote”. Kinachoamua ni aina ya utofauti unaobebwa na hali za uthibitishaji na dai ambalo mtafiti anataka kulijaribu.
Kujaribu mabadiliko katika hali ya soko
Chanzo kinaeleza mfano ambapo hali ya soko hubadilika kutoka \(X_0\) hadi \(X_1\) kama ifuatavyo:
\[ X_0 \rightarrow X_1 \]
Mabadiliko ya sehemu yanayotabiriwa na modeli kwa mbadala fulani:
\[ \Delta \hat{S} = \hat{S}(X_1)-\hat{S}(X_0) \]
huonyeshwa hivyo.
Mabadiliko ya sehemu yanayoonekana kwa kweli ni:
\[ \Delta S = S(X_1)-S(X_0) \]
kwa namna hiyo.
Ikiwa modeli inafuatilia mwitikio wa soko kwa usahihi, uhusiano unaolengwa:
\[ \Delta \hat{S}\approx\Delta S \]
unaweza kufikiriwa kwa namna hii.
Mwandishi hasemi hapa kwamba mabadiliko ya sehemu lazima yapewe alama moja kwa moja kwa kipimo tofauti cha hitilafu. Hoja kuu ni kwamba muundo wa uthibitishaji lazima uwe na utofauti halisi katika hali ambazo modeli itatarajiwa kutabiri baadaye.
Mfano wa mwitikio kwa mabadiliko ya bei
Kwa mfano, ikiwa modeli ya uchaguzi tofauti itatumika baadaye kutabiri athari za mabadiliko ya bei kwenye sehemu ya soko, kupata viwango sahihi vya sehemu ya aggregate katika majukumu machache ya holdout yenye miundo ya bei inayofanana sana hutoa taarifa ndogo.
Uthibitishaji wenye nguvu zaidi wa aggregate unaweza kujaribu kama modeli inaweza kufuatilia kweli mienendo ya sehemu ya soko katika hali tofauti na zenye maana za bei. Mantiki hiyo hiyo inatumika kwa usanidi wa bidhaa, mazingira ya ushindani au vipengele vingine muhimu vya choice state.
Hata hivyo, hili bado linapaswa kutafsiriwa kama aggregate response validation. Ili kujenga dai pana zaidi kuhusu individual choice prediction, kiwango cha tathmini lazima kilingane na hilo.
Kwa nini kuwa kwa data ya holdout nje kwa kweli bado hakutoshi?
Kutumia data huru ya holdout ni kinga muhimu ya kimetodolojia; lakini kwa mujibu wa hoja ya chanzo, haitoshi peke yake. Ukweli kwamba data ya uthibitishaji imetenganishwa kabisa na mafunzo ya modeli haugeuzi kiotomatiki kipimo kuwa ushahidi mpana wa uhalali wa utabiri ikiwa kipimo kinachotumiwa hakihifadhi taarifa muhimu kuhusu individual choice prediction.
Mantiki ya kauli ya mwandishi ni hii:
- Kuwa kwa data nje ni sharti muhimu kwa udhibiti wa overfit.
- Lakini dai la modeli ambalo kipimo kinajaribu lazima litathminiwe kando.
- Aggregate-share error hujaribu moja kwa moja aggregate-share agreement pekee.
- Choice-level predictive validity huhitaji uhusiano kati ya chaguo iliyotabiriwa na chaguo iliyotokea uhifadhiwe.
Ushindi wa Model 1 katika kiwango cha aggregate unathibitisha nini?
Katika mfano rahisi, ukweli kwamba Model 1 inapata aggregate MAE ya chini kuliko Model 2 unaunga mkono hitimisho halali na wazi: Model 1 imezalisha upya sehemu za aggregate za soko katika hali hiyo ya holdout kwa ukaribu zaidi kuliko Model 2.
Hatua inayopingwa na chanzo ni inayofuata. Kutoka kwenye matokeo hayo hayo kwenda kwenye hitimisho kwamba “Model 1 inatabiri vizuri zaidi chaguo za mtu binafsi katika data ya nje” kunaunda dai pana kuliko kiwango cha ushahidi kinachoruhusu.
Kwa hiyo kauli “Matching the Shares Does Not Validate the Choices” katika kichwa cha makala haimaanishi kwamba utabiri wa aggregate hauna thamani. Inaonyesha mpaka kati ya dai linaloungwa mkono na kipimo na dai pana zaidi linalotolewa kutokana nalo.
Kwa nini overfitting haisuluhishwi kabisa?
Kwa kuwa modeli ni nyumbufu zaidi, inaweza kuonekana kuwakilisha vizuri zaidi muundo wa tabia katika data ya makadirio. Inaweza pia kulinganisha vizuri zaidi sehemu ya aggregate ya holdout kuliko modeli nyingine. Matokeo haya yanaendana na maelezo mawili tofauti:
- Muundo wa ziada wa modeli kwa kweli umejifunza vizuri zaidi tabia ya uchaguzi inayoweza kujumlishwa.
- Muundo wa ziada wa modeli umetengeneza muundo mwingine wa utabiri ambao si sahihi katika kiwango cha mtu binafsi lakini wastani wake unalingana na sehemu ya soko ya holdout.
Ulinganisho wa sehemu ya aggregate hauwezi kutenganisha maelezo haya mawili. Kwa hiyo ikiwa jaribio pekee la nje ni aggregate-share error, uwezekano wa overfit bado haujasuluhishwa kikamilifu kwa dai la choice-level kwamba ubora unaoonekana wa modeli kweli umehamia nje ya data ya estimation.
Mbinu na Matokeo ya Utafiti
Tatizo la utafiti
Swali kuu la kimetodolojia la utafiti ni kama kulinganisha sehemu za soko za holdout kwa kutumia MAE au kipimo sawa cha hitilafu ya aggregate katika ulinganisho wa modeli za uchaguzi tofauti kunaunga mkono kweli dai la uhalali wa utabiri wa nje kwa chaguo za mtu binafsi.
Mbinu ya utafiti
Utafiti haufanyi jaribio la mapendeleo kwa washiriki wapya. Badala yake, mwandishi:
- anafafanua kazi ya kimetodolojia ya holdout validation,
- anakusanya tofauti kati ya uthibitishaji wa mtu binafsi na aggregate katika fasihi ya awali ya choice-model,
- anatumia mfano rahisi wa kupinga wa kihisabati,
- anaonyesha rasmi upotevu wa taarifa katika mchakato wa aggregation,
- anajadili kwa nini majukumu zaidi ya holdout si suluhisho la kiotomatiki,
- anaweka mipaka ya dai jembamba lakini halali la uthibitishaji kwa utabiri wa aggregate wa soko.
Dai kuu la chanzo
Kwa maneno ya makala yenyewe, kanuni kuu ni hii:
Aggregate-share MAE haiwezi kutumiwa kama ushahidi wa kutosha wa kulinganisha wa uhalali wa utabiri wa nje kwa chaguo za mtu binafsi.
Neno “wa kutosha” ni muhimu hapa. Chanzo hakisemi kwamba aggregate-share MAE haina taarifa yoyote. Kipimo hutoa taarifa kuhusu mafanikio ya utabiri wa sehemu ya aggregate ya soko. Tatizo ni kufasiri taarifa hii nyembamba kwa upana kiasi cha kuitumia peke yake kuanzisha dai la choice-level external predictive validity.
Uhalali wa Utabiri wa Nje wa Chaguo za Mtu Binafsi Unapaswa Kujaribiwaje?
Kwa mujibu wa chanzo, ikiwa dai la uhalali wa utabiri wa nje litatolewa kwa utabiri wa chaguo za mtu binafsi, tathmini lazima ihifadhi uhusiano kati ya utabiri wa modeli na chaguo zilizotokea katika data mpya ambayo haikutumiwa na modeli kuunda utabiri. Ikiwa utabiri na chaguo zilizotokea hupunguzwa kuwa sehemu tofauti za aggregate kabla ya kupewa alama, uhusiano huo hupotea na jaribio huwa aggregate-share validation jembamba zaidi.
Utafiti haupendekezi scoring rule moja ya lazima kama mbadala. Sharti kuu la kimetodolojia ni kwamba muundo wa tathmini ulingane na prediction target inayodaiwa.
Kwa maneno mengine:
| Lengo linalodaiwa | Taarifa ambayo uthibitishaji lazima uhifadhi |
|---|---|
| Kutabiri sehemu ya aggregate ya soko | Sehemu za aggregate zinazotabiriwa na zinazoonekana; utofauti wenye maana katika hali za soko zilizojaribiwa |
| Kutabiri chaguo za mtu binafsi | Uhusiano kati ya utabiri wa modeli katika kiwango cha mtu/uchunguzi na chaguo zilizotokea |
| Kutabiri mwitikio wa aggregate kwa mabadiliko ya soko | Mabadiliko yenye maana ya state kama bei, muundo wa bidhaa au hali za ushindani na mwitikio wa soko unaoambatana nayo |
Matumizi halali ya uthibitishaji wa sehemu ya aggregate
Moja ya sentensi muhimu za kuweka mpaka katika utafiti ni kwamba aggregate-share prediction ni predictive target halali. Ikiwa biashara au mtafiti kweli analenga kutabiri jumla ya sehemu za mbadala katika hali fulani za soko, holdout aggregate share comparison inaweza kuwa jaribio linalohusika moja kwa moja.
Hata hivyo, uwezo wa kujumlisha ushahidi huu umewekewa mipaka na upeo wa hali zilizojaribiwa. Ikiwa uthibitishaji unahusisha product configuration moja tu au choice state zinazofanana sana, hitimisho la utendaji katika bei au hali za ushindani zilizo tofauti sana haliwezi kutolewa kiotomatiki.
Kwa nini hali nyingi zenye maana za soko zina thamani zaidi?
Ikiwa matumizi halisi ya modeli ni kutabiri mwitikio kwa mabadiliko ya hali za soko, seti ya uthibitishaji lazima pia ijumuishe mabadiliko hayo. Kwa sababu hiyo, chanzo kinaonyesha kwamba “holdout zaidi” na “utofauti zaidi wenye maana” si dhana zilezile.
Majukumu yote kumi na tano ya holdout yanaweza kuwakilisha hali za soko zinazofanana sana. Kinyume chake, hali chache zaidi lakini zenye mabadiliko yenye maana katika bei, sifa au muundo wa mshindani zinaweza kutoa taarifa ya moja kwa moja zaidi kuhusu aggregate response prediction.
Matokeo yanayoungwa mkono na utafiti
- Aggregate-share MAE inaweza kutathmini ukaribu wa sehemu za aggregate za soko na data ya holdout.
- Vekta tofauti za utabiri wa mtu binafsi zinaweza kutoa sehemu ileile ya aggregate ya soko.
- Kwa hiyo ulinganifu wa sehemu ya aggregate pekee hauwezi kubainisha uhalali wa nje wa utabiri wa chaguo za mtu binafsi.
- Baada ya kupunguza utabiri kuwa sehemu ya aggregate, kutumia MSE, RMSE au kipimo kingine cha hitilafu badala ya MAE hakurudishi taarifa ya mtu binafsi iliyopotea.
- Kurudia uthibitishaji uleule wa aggregate katika majukumu zaidi ya holdout hakubadili kiwango cha tathmini.
- Ikiwa utabiri wa aggregate wa soko ndio lengo halisi la utafiti, uthibitishaji wa aggregate ni halali.
- Thamani ya uthibitishaji wa aggregate kwa mwitikio mpana wa soko inategemea kiwango ambacho choice state zilizojaribiwa zinajumuisha utofauti wenye maana katika hali zinazotarajiwa kutabiriwa baadaye.
Matokeo yasiyoungwa mkono na utafiti
- Haipaswi kuhitimishwa kwamba aggregate-share MAE kwa ujumla ni kipimo “kibaya” au kisichoweza kutumika.
- Haidaiwi kwamba utabiri wa sehemu ya aggregate ya soko hauna thamani ya kisayansi au kibiashara.
- Haisemwi kwamba kila uthibitishaji wa aggregate ni batili.
- Chanzo hakiainishi kipimo kimoja cha lazima cha mbadala kwa uthibitishaji wa utabiri wa mtu binafsi.
- Haidaiwi kwamba majukumu zaidi ya holdout hayana manufaa kamwe; tatizo ni majukumu kutathminiwa tu katika kiwango kilekile cha aggregate.
- Haisemwi kwamba Model 1 kukadiria vizuri sehemu za aggregate ni kosa; hoja ni kwamba kutoka hapo haiwezekani kuhamia moja kwa moja kwenye hitimisho la choice-level predictive validity.
- Makala haionyeshi kwa njia ya majaribio ni katika hali zipi modeli mpya ni bora kabisa.
Nguvu ya kimetodolojia
Nguvu ya utafiti ni kupunguza tatizo tata la uthibitishaji wa modeli kuwa hoja rahisi ya upotevu wa taarifa. Uwepo wa vekta tofauti za utabiri zinazotoa wastani uleule unaonyesha moja kwa moja ni taarifa gani aggregate scoring haiwezi kutathmini.
Aidha, makala inahoji dhana kwamba “ikiwa takwimu imehesabiwa kwenye data mpya, basi inatoa external predictive validity moja kwa moja”. Inachukulia uhuru wa data na ulinganifu wa kipimo cha tathmini na lengo kama masharti mawili tofauti ya kimetodolojia.
Mipaka ya upeo wa utafiti
Chanzo ni hoja ya kimetodolojia ya kurasa saba na haitoi simulation mpya ya kiwango kikubwa, uchanganuzi wa Monte Carlo au ulinganisho wa utabiri wa soko halisi. Hitimisho kuu linategemea mantiki ya kihisabati ya upotevu wa taarifa, mfano rahisi na usanisi wa matokeo ya kutengana kati ya mtu binafsi/aggregate katika fasihi iliyotangulia.
Kwa hiyo utafiti haupaswi kusomwa kama meta-analysis inayotangaza matokeo mengine yote ya kila utafiti wa zamani uliotumia aggregate-share MAE kuwa batili. Ukosoaji unaelekezwa kwenye hitimisho ambapo kigezo hicho cha aggregate kinatumiwa kama ushahidi wa kutosha kwa choice-level comparative external predictive validity.
Maelezo ya Chanzo na Mbinu
Kichwa asili: Matching the Shares Does Not Validate the Choices
Kichwa kidogo asili: Why Matching Holdout Shares Is Not Sufficient Evidence of Predictive Validity
Mwandishi: Jake Lee
Taasisi: Red Analytics, Inc.
Tarehe ya PDF: August 2026
SSRN Date Written: 18 Agosti 2026
SSRN Posted: 19 Agosti 2026
Nambari ya kazi ya SSRN: 7309578
DOI: 10.2139/ssrn.7309578
Aina ya chanzo: Utafiti wa kimetodolojia kuhusu uundaji wa modeli za uchaguzi tofauti na uthibitishaji wa modeli / preprint ya SSRN.
Hali ya mapitio ya kitaalamu: Haijaonyeshwa kuwa imechapishwa katika jarida lenye mapitio ya kitaalamu; inapaswa kutathminiwa kama preprint.
Leseni: Metadata ya SSRN inaonyesha Creative Commons Attribution 4.0 International.
Ufadhili: Kwa mujibu wa rekodi ya SSRN, utafiti haukupokea ufadhili wa nje.
Mgongano wa maslahi: Kwa mujibu wa rekodi ya SSRN, mwandishi anatamka kwamba hakuna maslahi yanayoshindana/yanayokinzana.
Maadili: Kwa mujibu wa maelezo ya SSRN, kwa kuwa utafiti haukujumuisha washiriki wapya wa kibinadamu, data binafsi inayotambulika au ukusanyaji mpya wa data, idhini ya kamati ya maadili haikuhitajika.
Aina ya utafiti: Uchanganuzi wa kimawazo na kihisabati wa mbinu; usanisi wa fasihi ya awali kuhusu uthibitishaji wa uchaguzi tofauti.
Dhana kuu za utabiri: holdout validation, out-of-sample prediction, external predictive validity, aggregate-share prediction, individual choice prediction na mean absolute error.
Utaratibu mkuu wa kihisabati: Kupunguza utabiri wa modeli wa mtu binafsi kuwa utabiri wa aggregate wa \(\bar p\), na chaguo za holdout zilizotokea kuwa uchunguzi wa aggregate wa \(\bar y\); uwezekano wa vekta tofauti za utabiri wa mtu binafsi kutoa thamani ileile ya \(\bar p\).
Mpaka mkuu wa tafsiri: Makala haikatai uthibitishaji wa sehemu ya aggregate ya soko. Pingamizi linaelekezwa kwenye matumizi ya aggregate-share error kama ushahidi unaotosha peke yake kwa dai pana la external predictive validity kwa chaguo za mtu binafsi.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *