


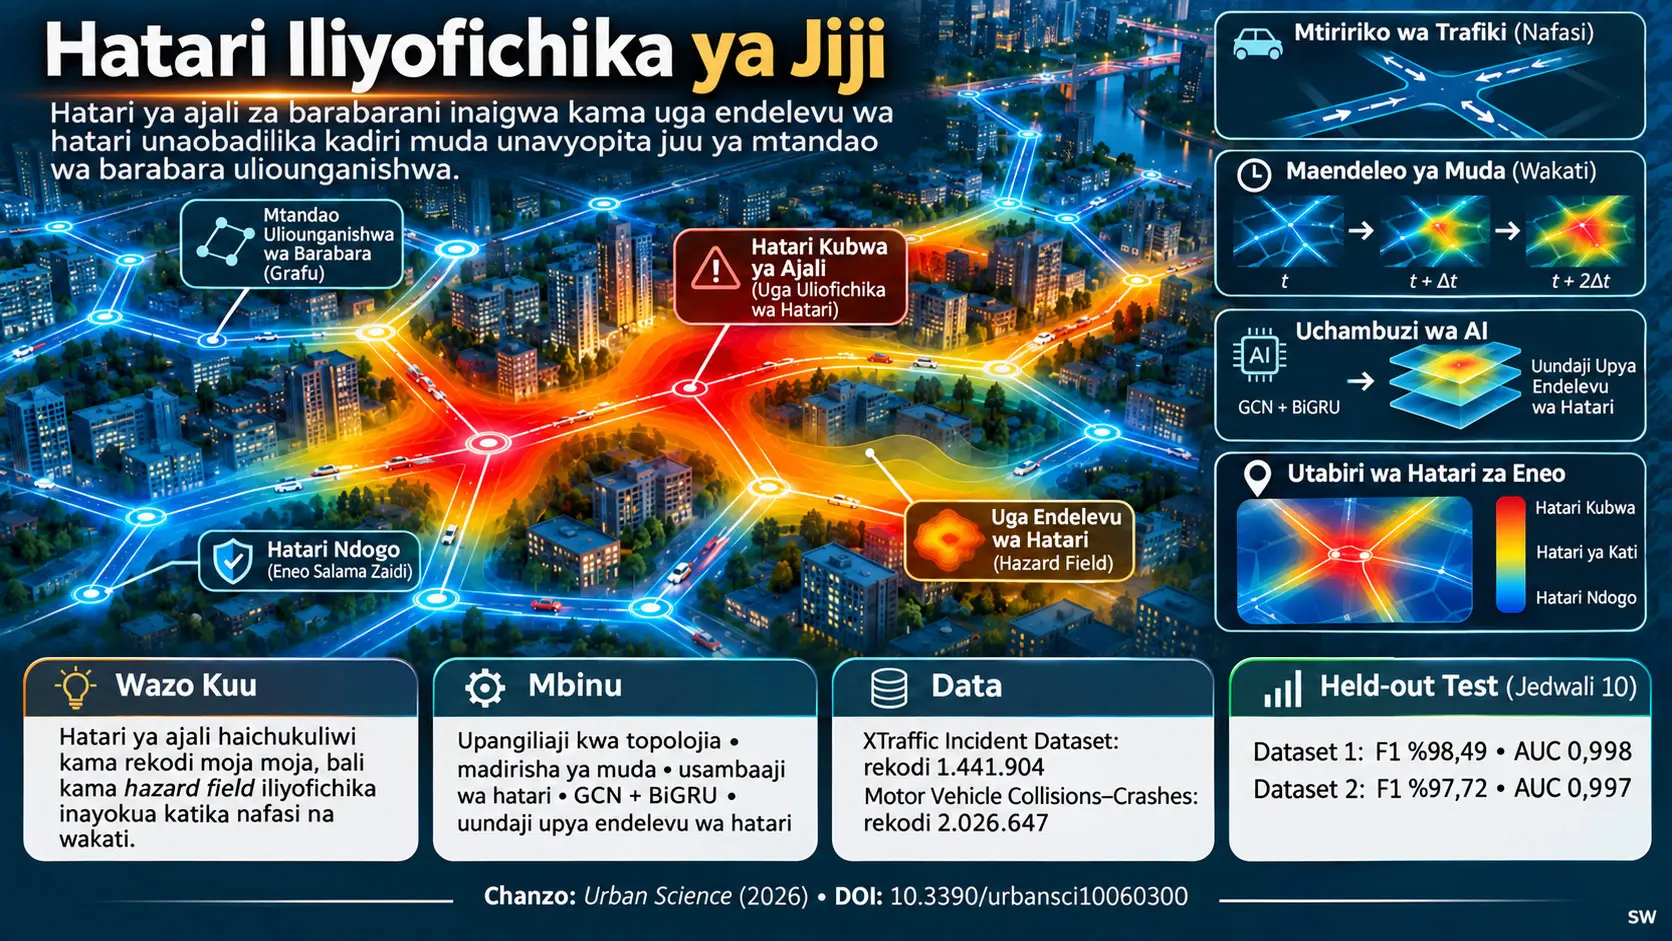
Mfumo wa Upelelezi wa Uga Endelevu wa Hatari (Continuous Hazard Field Intelligence Framework, CHFI) ni mfumo wa deep learning unaojaribu kujifunza hatari ya ajali za barabarani si kama uainishaji wa moja kwa moja wa rekodi moja moja kwa namna ya “ajali ipo/haipo” au “daraja la ukali”, bali kama uga wa hatari uliofichika unaotokea, kusambaa na kujikusanya katika miundombinu ya barabara iliyounganishwa katika nafasi na wakati. Utafiti unatathmini kwa pamoja katika XTraffic Incident Dataset yenye rekodi 1.441.904 za kipindi cha 2022–2024 na Motor Vehicle Collisions–Crashes Dataset yenye rekodi 2.026.647; upangiliaji wa kieneo unaozingatia topolojia, temporal hazard windows, risk-diffusion feature lifting, hazard-sensitive normalization, uanzishaji wa continuous hazard surface, graph-based spatial encoding, temporal modeling inayotegemea GRU/BiGRU na hatua za continuous hazard reconstruction.
Wazo kuu la modeli ni hili: mara nyingi ajali ya barabarani haipaswi kuchukuliwa kama tukio moja la nukta lililo huru kabisa na linalotokea ghafla. Katika modeli iliyojengwa na chanzo, kutokuwa thabiti kwa mtiririko wa trafiki, utofauti wa kasi, msongamano, muunganisho wa mtandao wa barabara, athari za makutano, hali za mazingira na athari za hatari kutoka sehemu za karibu za barabara kwanza hubadilishwa kuwa uga wa hatari uliofichika. Kisha modeli hutumia si ukubwa wa sasa wa uga huu pekee, bali pia kama umeongezeka ikilinganishwa na wakati uliopita na kama hatari katika sehemu jirani za barabara inaimarisha eneo la ndani, ili kutoa uwezekano wa eneo maalum wa kutokea kwa ajali.
Katika muhtasari wa chanzo na sehemu ya matokeo, kwa final CHFI katika Dataset 1 zimeripotiwa %99,12 accuracy, %98,94 precision, %98,76 recall, %98,85 F1 na 0,998 AUC; katika Dataset 2 zimeripotiwa %98,63 accuracy, %98,41 precision, %98,16 recall, %98,28 F1 na 0,997 AUC. Hata hivyo, thamani hizi ni sawa na mstari wa E10 wa “Training Stage” katika Jedwali 9 la chanzo. Katika Jedwali 10 tofauti la “Test-stage”, thamani za independent test ni %98,84 accuracy, %98,62 precision, %98,37 recall, %98,49 F1 na 0,998 AUC kwa Dataset 1; na %98,07 accuracy, %97,86 precision, %97,59 recall, %97,72 F1 na 0,997 AUC kwa Dataset 2. Verianla haiunganishi tofauti hii ya kuripoti ndani ya chanzo kuwa namba moja.
Katika majaribio yenye uthibitishaji mkali zaidi, utendaji hupungua lakini hubaki juu. Kwa mujibu wa Jedwali 14 la chanzo, F1 ya Dataset 1 ni %98,85 kwa stratified random split, %97,39 kwa temporal hold-out, %96,93 kwa geographic hold-out na %96,21 kwa blocked spatio-temporal validation. Katika Dataset 2 thamani hizo zimeripotiwa kwa mtiririko huo kama %98,28, %96,82, %96,35 na %95,60. Hata hivyo, kwa kuwa mistari ya random-split pia ni sawa na thamani za summary/Training Stage katika chanzo, jedwali hili pia linapaswa kusomwa pamoja na matokeo ya independent test katika Jedwali 10 na kwa uangalifu.
Utafiti unaonyesha matokeo yenye nguvu katika mazingira yaliyodhibitiwa; lakini haujafanya live deployment kwenye mtiririko wa trafiki wa wakati halisi. Chanzo kinaacha real-time streaming, miji na mitandao zaidi ya usafiri, signal timing na lane-level dynamics zilizo na undani zaidi, multimodal mobility, hali za hewa zenye undani zaidi, uncertainty modeling na muunganisho na mifumo ya udhibiti wa trafiki kama maeneo ya utafiti wa baadaye. Kwa hiyo, matokeo ya CHFI hayapaswi kufasiriwa kama “mfumo tayari unaozuia ajali kwa uhakika katika jiji halisi”.
Utafiti unajaribu kutatua tatizo gani?
Sehemu kubwa ya modeli za jadi za utabiri wa ajali za barabarani huchukulia kila rekodi ya trafiki au kila eneo la ajali kama mfano tofauti. Katika mtazamo kama huo, kazi ya modeli mara nyingi ni kuweka uchunguzi uliotolewa katika daraja fulani. Lakini katika mtandao halisi wa barabara, hali ya usalama ya sehemu moja ya barabara inaweza kuathiriwa na sehemu jirani za barabara, makutano, foleni ya trafiki, kutokuwa thabiti kwa kasi na vipindi vya wakati vilivyotangulia.
Tatizo kuu la utafiti la CHFI ni kuwakilisha hatari isiyoonekana kama uga unaobadilika kwa kuendelea katika mtandao wa usafiri uliounganishwa, badala ya kupoteza utegemezi huu ndani ya “uainishaji wa tukio moja”.
Uga Endelevu wa Hatari ni Nini?
Uga endelevu wa hatari ni muundo wa kati wa kihisabati ambao katika utafiti huu unawakilisha hatari iliyofichika ya trafiki katika sehemu ya barabara au makutano si kwa uwepo wa eneo la ajali pekee, bali kama ukali endelevu wa latent unaoamuliwa kwa pamoja na hali ya trafiki ya ndani, vitengo jirani vya mtandao na hali ya hatari ya wakati uliopita; uga huu si label ya mwisho ya ajali, bali ni uwakilishi unaoweza kufasiriwa wa hatari iliyofichika unaotumika kuzalisha utabiri wa mwisho.
Tofauti hii ni muhimu sana. Uga wa hatari unaowakilishwa na \(\hat{H}(u_i,t)\) katika chanzo si label ya moja kwa moja ya “ajali itatokea”. Modeli kwanza hujenga upya muundo wa hatari uliofichika; kisha uwezekano wa eneo maalum wa kutokea kwa ajali hupatikana kutoka katika muundo huu.
Kwa nini modeli inaonyesha mtandao wa barabara kama graph?
Mfumo wa usafiri unafafanuliwa kama graph katika umbo \(G=(V,E)\). \(V\) inawakilisha nodes zinazoundwa na sehemu za barabara, makutano au vitengo vingine vya kieneo vya usafiri; \(E\) inawakilisha miunganisho yao.
Lengo la uwakilishi huu si umaridadi wa kihisabati pekee. Msongamano au foleni katika sehemu moja unaweza kusambaa kwenda sehemu inayofuata; eneo la kuungana, makutano au corridor jirani linaweza kuongeza hatari iliyopo. Wakati flat tabular data haibebi miunganisho hii ya kimwili kwa njia ya asili, muundo wa graph huipa modeli uhusiano wa ujirani moja kwa moja.
Seti mbili za data zilizotumika
| Kipengele | Dataset 1 | Dataset 2 |
|---|---|---|
| Jina | XTraffic Incident Dataset (2022–2024) | Motor Vehicle Collisions–Crashes Dataset |
| Idadi ya rekodi | 1.441.904 | 2.026.647 |
| Aina kuu ya uchunguzi | Rekodi za incident zinazojumuisha pia hazard, disabled vehicle, roadway disruption na matukio mengine ya kiutendaji pamoja na ajali | Mgongano wa magari uliotokea na matokeo yake |
| Upeo wa Temporal | 2022: rekodi 478.581; 2023: 476.768; 2024: 486.555 | Haujatolewa katika chanzo kama kipindi kimoja cha miaka mitatu. |
| Mifano ya vigeu muhimu | incident_id, duration, Abs PM, Fwy, AREA, DESCRIPTION, LOCATION, dt, Latitude, Longitude, Freeway direction, Type | CRASH DATE, CRASH TIME, BOROUGH, ZIP CODE, LATITUDE, LONGITUDE, idadi ya majeruhi/vifo, contributing factor na vehicle type |
| Jukumu la majaribio | Kuchunguza mifumo ya hatari ya kiutendaji katika kiwango cha incident-emergence na precursor | Kuchunguza crash outcome na severity iliyotokea |
Kwa kuwa Dataset 1 haiundwi na rekodi za ajali pekee, ina precursor signals zilizo karibu zaidi na lengo la CHFI la kujifunza “uvurugikaji wa kiutendaji kabla ya kutokea kwa ajali”. Dataset 2, kwa sababu ya taarifa za majeruhi, vifo, watembea kwa miguu, waendesha baiskeli, madereva na magari, inawakilisha matokeo ya ajali iliyotokea kwa njia ya moja kwa moja zaidi.
Madaraja manne ya severity katika Dataset 2
Chanzo kinagawa target ya Dataset 2 katika madaraja manne:
- No Injury: \(I_i=0\) na \(F_i=0\)
- Minor Injury: \(I_i=1\) na \(F_i=0\)
- Multi-Injury: \(I_i>1\) na \(F_i=0\)
- Fatal/Severe: \(F_i\geq1\)
Hapa \(I_i\) ni jumla ya idadi ya waliojeruhiwa katika rekodi; \(F_i\) ni jumla ya idadi ya vifo.
Kwa Nini “Target Leakage” ni Tatizo Muhimu katika Modeli?
Target leakage ni ongezeko bandia la utendaji wa modeli linalotokea wakati vigeu ambavyo tayari vinaeleza moja kwa moja au kwa njia isiyo ya moja kwa moja matokeo yanayopaswa kutabiriwa vinatolewa kama input ya modeli; ili kupunguza hatari hii, utafiti hutenganisha kutoka kwenye inputs za utabiri vigeu vya majeruhi, vifo, aina ya tukio, maelezo na post-outcome vinavyotumiwa kuunda label.
Mlinganyo (1): Kuchagua sifa za mwisho za input
\[ F_{\mathrm{input}}^{(m)} = F_{\mathrm{all}}^{(m)} \setminus \left( F_{\mathrm{target}}^{(m)} \cup F_{\mathrm{proxy}}^{(m)} \right), \qquad m\in\{1,2\} \]
Fomula inahesabu nini? Inaamua sifa za input ambazo modeli inaruhusiwa kutumia kweli.
\(F_{\mathrm{all}}\): Vigeu vyote vilivyoandikwa katika seti ya data.
\(F_{\mathrm{target}}\): Vigeu vinavyounda target label moja kwa moja.
\(F_{\mathrm{proxy}}\): Proxy variables ambazo hazijengi target moja kwa moja lakini baada ya tukio zinafichua target karibu waziwazi.
\(\setminus\): Ni operator ya tofauti ya seti. Yaani target na proxy variables zinaondolewa kutoka katika vigeu vyote.
Mlinganyo (2): Kuunda label ya Dataset 1
\[ y_i^{(1)} = g_1(\mathrm{Type}_i,\mathrm{DESCRIPTION}_i) \]
\(g_1\) ni mapping function inayobadilisha aina ya tukio na maelezo ya tukio kuwa daraja la mwisho la incident-risk. Rekodi za collision-related, injury-related, unknown-injury na hazard-related zinawekwa katika madaraja ya hatari ya juu zaidi; rekodi za non-accident operational zinawekwa katika risk ya chini au madaraja ya non-emergence.
Hata hivyo, kwa sababu Type na DESCRIPTION zinaweza kuashiria target moja kwa moja au kwa nguvu sana, zinaondolewa kwenye input ya modeli baada ya label kuundwa.
Mlinganyo (3)–(4): Severity label ya Dataset 2
\[ y_i^{(2)}=g_2(I_i,F_i) \]
Katika chanzo, mapping inafafanuliwa kwa muundo wa vipande vifuatavyo:
\[ y_i^{(2)}= \begin{cases} \text{No Injury}, & I_i=0,\;F_i=0\\ \text{Minor Injury}, & I_i=1,\;F_i=0\\ \text{Multi-Injury}, & I_i>1,\;F_i=0\\ \text{Fatal/Severe}, & F_i\geq1 \end{cases} \]
Baada ya label kuundwa, sehemu zote za injury na fatality count huondolewa kwenye input. Vinginevyo, modeli inaweza kuonekana kuwa “inatabiri ukali wa ajali” ilhali kwa kweli inasoma moja kwa moja matokeo yanayopaswa kutabiriwa.
Mlinganyo (5): Kujifunza parameter za preprocessing kutoka training data pekee
\[ \phi_{\mathrm{prep}}=\operatorname{Fit}(D_{\mathrm{train}}), \qquad \widetilde{D}_{\mathrm{test}} = \operatorname{Transform} \left(D_{\mathrm{test}};\phi_{\mathrm{prep}}\right) \]
Mlinganyo huu ni safu ya pili muhimu ya leakage prevention. Parameter za normalization, encoding, hazard-field initialization na preprocessing nyingine kwanza hujifunzwa kutoka sehemu ya training pekee. Test data haishiriki katika kuamua parameter hizi; transformation iliyojifunzwa awali ndiyo inayotumika kwenye test data.
Temporal Hazard Window Embedding inafanya nini?
Badala ya kutumia kila timestamp kama mfano tofauti, modeli hugawanya uchunguzi unaofuatana wa trafiki katika temporal windows zinazopishana kwa sehemu. Urefu wa dirisha unawakilishwa na \(W\), na stride na \(\Delta\).
Kwa mfano, katika usanidi wa baadaye wa majaribio ya chanzo, mipangilio kama \(W=6,8,10\) na \(\Delta=2,3\) ilijaribiwa. \(W\) inapokuwa kubwa, modeli inaweza kuona historia ya karibu iliyo ndefu zaidi; \(\Delta\) huamua dirisha linasonga kwa kiasi gani katika mfuatano wa wakati. Ufafanuzi huu wa kihisabati si dai jipya la mafanikio nje ya jaribio la chanzo.
Mlinganyo (6)–(10): Risk-diffusion feature lifting
Mtandao wa barabara:
\[ G=(V,E) \]
Vekta ya sifa za ndani ya kila node katika wakati \(t\):
\[ x_i^{(t)}\in\mathbb{R}^{d} \]
Sifa iliyoboreshwa kwa athari ya jirani:
\[ \widetilde{x}_i^{(t)} = \alpha x_i^{(t)} + (1-\alpha) \sum_{j\in N(i)} \omega_{ij}x_j^{(t)} \]
Uzito wa majirani:
\[ \sum_{j\in N(i)}\omega_{ij}=1 \]
Umbo la matrix:
\[ \widetilde{X}^{(t)} = \alpha X^{(t)} + (1-\alpha)WX^{(t)} \]
Ina maana gani? Input ya modeli ya sehemu ya barabara haijengwi na hali yake ya trafiki pekee. Taarifa ya ndani yenye sehemu \(\alpha\), na taarifa yenye uzito kutoka vitengo jirani vya barabara yenye sehemu \(1-\alpha\), hutumika.
Ikiwa \(\alpha=1\), mlinganyo hubaki na uchunguzi wa ndani pekee; ikiwa \(\alpha=0\), sehemu ya ndani hupotea na hali yenye uzito ya majirani pekee hubaki. Hizi ni hali za mipaka ya kihisabati ya mlinganyo; si matokeo ya majaribio ya utafiti.
Mlinganyo (11): Uzito wa majirani wenye kutokuwa thabiti kunakofanana
\[ \omega_{ij} = \frac{ a_{ij} \exp\left( -\frac{\|x_i^{(t)}-x_j^{(t)}\|_2^2}{\sigma^2} \right) }{ \sum_{k\in N(i)} a_{ik} \exp\left( -\frac{\|x_i^{(t)}-x_k^{(t)}\|_2^2}{\sigma^2} \right) } \]
\(a_{ij}\) hudhibiti taarifa ya graph adjacency; \(\sigma\) hudhibiti thamani ya diffusion sensitivity. Kwa sababu ya exponential function, majirani ambao hali zao za sifa zinafanana zaidi wanaweza kupata uzito mkubwa zaidi. Denominator hunormalize jumla ya uzito ili michango ya majirani kwa pamoja itengeneze mgawanyo unaodhibitiwa.
Kwa nini hazard-sensitive normalization si global scaling ya kawaida?
Kulingana na dai la chanzo, wakati mwingine hali hatari inaweza kuwa mkengeuko mdogo lakini usio wa kawaida katika sehemu fulani ya barabara ambayo kawaida huwa thabiti sana. Kuscale data ya jiji lote kwa average na variance moja ya global kunaweza kuficha mkengeuko kama huo wa ndani. Kwa hiyo CHFI hutumia hazard-sensitive normalization inayojaribu kufasiri kila road segment kulingana na muktadha wake wa kihistoria na kimuundo.
Chanzo hakitoi tofauti exact closed-form normalization equation ya mchakato huu wala parameter zake zote za nambari. Kwa hiyo, hakuna fomula mpya ya normalization iliyobuniwa hapa.
Nukta Tofauti za Ajali Zinabadilishwaje kuwa Uga Endelevu wa Hatari?
Utafiti husambaza athari ya kila ajali au tukio la hatari kubwa kwa vitengo vya karibu vya spatial katika mtandao wa barabara na vipindi jirani vya wakati kwa Gaussian-like spatial na temporal kernels, hukusanya michango yote ya matukio juu ya nyingine, hu-project matokeo kwenye vitengo halali vya mtandao wa barabara na kuyafanyia normalization ili kuunda uga wa awali wa hatari endelevu ulio tayari kwa kujifunza.
Hisabati ya msingi ya Algorithm 1 na Algorithm 2
Sparse event set:
\[ S=\{(s_k,t_k,y_k)\}_{k=1}^{M} \]
\(s_k\) inawakilisha mahali pa tukio, \(t_k\) wakati, na \(y_k\) ukubwa wa hazard/severity.
Spatial kernel:
\[ K_s(u,s_k) = \exp\left( -\frac{d_G(u,s_k)^2}{2\sigma_s^2} \right) \]
Temporal kernel:
\[ K_t(t,t_k) = \exp\left( -\frac{(t-t_k)^2}{2\sigma_t^2} \right) \]
Mchango wa tukio kwa nukta ya mahali-wakati:
\[ y_kK_s(u,s_k)K_t(t,t_k) \]
Uga ghafi baada ya michango ya matukio yote kuongezwa juu ya nyingine:
\[ H_0(u,t) = \sum_{k=1}^{M} y_kK_s(u,s_k)K_t(t,t_k) \]
Kisha graph projection:
\[ H_0^G(u,t)=\Pi_G(H_0(u,t)) \]
na normalization:
\[ \widehat{H}_0(u,t)=\mathcal{N}(H_0^G(u,t)) \]
\(d_G\): Inawakilisha umbali wa topology-aware katika transportation graph badala ya Euclidean distance rahisi ya mstari wa moja kwa moja.
\(\sigma_s\): Ni Spatial bandwidth. Kihisabati, inapoongezeka, athari ya spatial kernel ya tukio inaweza kusambaa katika eneo pana zaidi; inapopungua, hubaki ya eneo zaidi.
\(\sigma_t\): Ni Temporal bandwidth. Inapoongezeka, athari ya tukio katika wakati inaweza kusambaa katika dirisha pana zaidi.
Dokezo muhimu la reproducibility: Chanzo kinafafanua \(\sigma_s\) na \(\sigma_t\) kama parameter zinazohitajika katika Algorithm 1 na 2, lakini hakiripoti thamani zao mahususi za nambari katika majedwali ya usanidi wa majaribio yaliyopitiwa. Verianla haijazi pengo hili kwa kubuni.
Mlinganyo (12)–(18): Continuous spatial hazard field
Hatari ya latent katika kitengo cha barabara:
\[ H_i(t)\in\mathbb{R}_{\geq0} \]
Local contextual feature vector:
\[ x_i(t)\in\mathbb{R}^{d} \]
Local hazard generation:
\[ \phi_i(t)=f(x_i(t)) \]
Uzito wa majirani:
\[ \omega_{ij}\geq0, \qquad \sum_{j\in N(i)}\omega_{ij}=1 \]
Topology-coupled hazard:
\[ H_i(t) = \alpha\phi_i(t) + (1-\alpha) \sum_{j\in N(i)} \omega_{ij}\phi_j(t) \]
Chanzo kinaieleza hii kwa mtandao mzima katika umbo la matrix:
\[ H(t) = \alpha\Phi(t) + (1-\alpha)W\Phi(t) \]
kwa namna hiyo.
Tofauti muhimu hapa ni kwamba \(x_i\) ni sifa ghafi; \(\phi_i=f(x_i)\) ni latent hazard contribution inayotolewa kutoka katika sifa hizi; na \(H_i\) ni hazard state ambamo contributions za ndani na za majirani huunganishwa.
Mlinganyo (19)–(29): Unified governing formulation
Chanzo kwanza kinafafanua tena graph:
\[ G=(V,E) \]
Local hazard contribution:
\[ \phi_i(t)=f(x_i(t)) \]
Neighbor hazard aggregation:
\[ S_i(t) = \sum_{j\in N(i)} \omega_{ij}\phi_j(t) \]
na:
\[ \sum_{j\in N(i)}\omega_{ij}=1 \]
Instantaneous coupled hazard:
\[ \widetilde{H}_i(t) = \alpha\phi_i(t) + (1-\alpha)S_i(t) \]
Temporal memory inapoongezwa:
\[ H_i(t) = \beta H_i(t-1) + (1-\beta)\widetilde{H}_i(t) \]
\(\beta\) ni temporal persistence coefficient inayodhibiti kiasi cha hazard state ya zamani kinachohifadhiwa.
Ikiwa \(\beta=0\), hali iliyopita haitiliwi maanani na hazard mpya huwa sawa tu na coupled state ya sasa. Katika mpaka wa \(\beta=1\), mlinganyo hubeba state iliyopita kikamilifu na instantaneous contribution mpya haina athari. Hizi ni mipaka ya kihisabati ya mlinganyo.
Accident emergence probability:
\[ P_i(t) = \sigma\left( \gamma_1H_i(t) + \gamma_2\Delta H_i(t) + \gamma_3H_{N(i)}(t) + b \right) \]
Hapa:
- \(H_i(t)\): kiwango cha sasa cha hatari iliyofichika,
- \(\Delta H_i(t)=H_i(t)-H_i(t-1)\): kuongezeka au kupungua kwa hatari katika hatua ya mwisho ya wakati,
- \(H_{N(i)}(t)\): muktadha wa hatari wa vitengo jirani vya barabara,
- \(\gamma_1,\gamma_2,\gamma_3\): coefficients zinazoweza kujifunzwa,
- \(b\): bias,
- \(\sigma(\cdot)\): sigmoid activation.
Kazi ya sigmoid function ni kubadilisha mchanganyiko wa linear kuwa output yenye mipaka inayofanana na probability. Hivyo modeli hutumia kwa pamoja, pamoja na swali “hatari iko juu?”, maswali “hatari inaongezeka haraka?” na “vitengo vya karibu vya mtandao pia vina hatari?”.
Mnyororo wa chanzo katika umbo la matrix:
\[ \Phi(t)=f(X(t)) \]
\[ \widetilde{H}(t) = \alpha\Phi(t) + (1-\alpha)W\Phi(t) \]
\[ H(t) = \beta H(t-1) + (1-\beta)\widetilde{H}(t) \]
\[ P(t) = \sigma\left( \gamma_1H(t) + \gamma_2\Delta H(t) + \gamma_3WH(t) + b \right) \]
Kwa nini hatari ya muda si thamani ya sasa pekee?
Hypothesis ya modeli ya chanzo ni kwamba hatari kabla ya ajali hujikusanya kwa muda kupitia michakato kama congestion buildup, unstable speed transition, repeated interaction pressure, intersection conflict au corridor-level propagation.
Kwa hiyo \(\Delta H(t)\) ni ishara muhimu. Hata kama \(H(t)\) ya sasa ni sawa katika vitengo viwili vya barabara, katika kimoja hatari inaweza kuwa inaongezeka haraka huku katika kingine ikibaki thabiti. Modeli inalenga kutokuchukulia hali hizi mbili kuwa sawa.
Mlinganyo (30)–(42): Hisabati ya architecture ya deep learning
Input tensor:
\[ X(t)\in\mathbb{R}^{N\times d} \]
\(N\) ni idadi ya spatial unit; \(d\) ni hazard-aware feature dimension kwa kila kitengo.
Graph:
\[ G=(V,E) \]
Spatial hazard encoding:
\[ Z_s(t) = \rho\left( WX(t)\Theta_s^{(1)} + X(t)\Theta_s^{(2)} + b_s \right) \]
Mlinganyo huu unaunganisha njia mbili za taarifa: \(WX(t)\Theta_s^{(1)}\) hubeba athari ya graph ya majirani; \(X(t)\Theta_s^{(2)}\) hubeba sifa ya ndani. \(\rho\) ni nonlinear activation function. Output \(Z_s(t)\in\mathbb{R}^{N\times h}\) ni latent spatial hazard embedding.
Temporal evolution:
\[ Z_t(t) = \Psi\left( Z_s(t),Z_t(t-1) \right) \]
\(\Psi\) ni uwakilishi wa jumla wa temporal operator katika chanzo; chanzo kinasema muundo huu unaweza kujengwa kama GRU, LSTM, Transformer-style attention au sequential mechanism nyingine. Katika mfululizo wa majaribio E1–E10, GRU na baadaye BiGRU zilitumika.
Uwakilishi uliorahisishwa wa memory wa kufundishia katika chanzo:
\[ Z_t(t) = \beta Z_t(t-1) + (1-\beta)Z_s(t) \]
Hazard reconstruction:
\[ \widehat{H}(t) = \rho\left( Z_t(t)\Theta_h+b_h \right) \]
Hapa \(\widehat{H}(t)\in\mathbb{R}^{N\times1}\) ni makadirio ya modeli ya usambazaji wa hatari iliyofichika katika vitengo vyote vya road segment/intersection.
Hazard escalation:
\[ \Delta\widehat{H}(t) = \widehat{H}(t) - \widehat{H}(t-1) \]
Neighborhood hazard:
\[ \widehat{H}_{N}(t) = W\widehat{H}(t) \]
Localized emergence probability:
\[ \widehat{P}(t) = \sigma\left( \gamma_1\widehat{H}(t) + \gamma_2\Delta\widehat{H}(t) + \gamma_3\widehat{H}_{N}(t) + b_p \right) \]
Baadaye chanzo kinafupisha mnyororo wa forward propagation kwa functions nne:
\[ Z_s(t)=F_s(X(t),W) \]
\[ Z_t(t)=F_t(Z_s(t),Z_t(t-1)) \]
\[ \widehat{H}(t)=F_h(Z_t(t)) \]
\[ \widehat{P}(t) = F_p\left( \widehat{H}(t), \Delta\widehat{H}(t), W\widehat{H}(t) \right) \]
Composite loss
Katika Algorithm 3, lengo la training linatolewa katika umbo la jumla lifuatalo:
\[ L(t) = \lambda_1 L_{\mathrm{pred}} \left( \widehat{P}(t),Y(t) \right) + \lambda_2 L_{\mathrm{haz}} \left( \widehat{H}(t) \right) \]
\(L_{\mathrm{pred}}\) inawakilisha accident-emergence prediction error; \(L_{\mathrm{haz}}\) inawakilisha sehemu ya hazard-field consistency. \(\lambda_1\) na \(\lambda_2\) hudhibiti uzito kati ya malengo mawili.
Mpaka wa chanzo: Utafiti unafafanua composite objective hii katika Algorithm 3; hata hivyo, katika maandishi yaliyopitiwa hauripoti kando umbo kamili la closed-form la \(L_{\mathrm{haz}}\) wala thamani za nambari zilizotumika za \(\lambda_1,\lambda_2\). Kwa hiyo Verianla haijazi kwa kukisia.
Muundo wa majaribio E1–E10
| Jaribio | Mabadiliko makuu | Spatial | Temporal | Hazard reconstruction | W, Δ | h | α, β | Training |
|---|---|---|---|---|---|---|---|---|
| E1 | Baseline | Hakuna | Hakuna | Hakuna | 1,1 | 64 | — | Adam, 10−3, batch 64, 60 epoch |
| E2 | Spatial encoding | GCN | Hakuna | Hakuna | 1,1 | 64 | 0,70; 0 | Adam, 10−3, batch 64, 70 epoch |
| E3 | Temporal hazard | Hakuna | GRU | Hakuna | 6,2 | 96 | 1,00; 0,60 | Adam, 8×10⁻⁴, batch 64, 80 epoch |
| E4 | Spatial + temporal | GCN | GRU | Hakuna | 6,2 | 128 | 0,70; 0,60 | Adam, 8×10⁻⁴, batch 64, 90 epoch |
| E5 | Reconstruction | GCN | GRU | Linear + ReLU | 6,2 | 128 | 0,70; 0,65 | Adam, 5×10⁻⁴, batch 64, 100 epoch |
| E6 | Risk diffusion | GCN + lifted diffusion | GRU | Hazard field | 8,2 | 128 | 0,65; 0,70 | Adam, 5×10⁻⁴, batch 64, 100 epoch |
| E7 | Escalation cue | GCN + diffusion | GRU | Hazard field | 8,2 | 160 | 0,65; 0,75 | Adam, 3×10⁻⁴, batch 64, 110 epoch |
| E8 | Neighborhood context | GCN + diffusion | GRU | Hazard field | 8,2 | 160 | 0,60; 0,75 | Adam, 3×10⁻⁴, batch 64, 110 epoch |
| E9 | Temporal memory ndefu | GCN + diffusion | BiGRU | Hazard field | 10,3 | 192 | 0,60; 0,80 | Adam, 2×10⁻⁴, batch 32, 120 epoch |
| E10 | Final CHFI | GCN + topology-aware diffusion | BiGRU + memory | Continuous reconstruction | 10,3 | 256 | 0,60; 0,80 | Adam, 2×10⁻⁴, batch 32, 120 epoch, early stopping |
W: temporal window length; Δ: stride; h: latent hazard embedding dimension; α: local/neighbor balance; β: temporal persistence.
Vifaa na programu za majaribio
Majaribio yote yalifanywa katika MATLAB R2023a kwa kutumia mfumo wa uendeshaji wa Windows 11 Home 64-bit. Vifaa vimeripotiwa kuwa ASUS TUF Gaming F15 FX506LH; Intel Core i5-10300H 2,50 GHz CPU; 32 GB RAM; NVIDIA GeForce GTX 1650, 4 GB dedicated display memory na 16 GB shared memory.
Mgawanyo wa training, validation na test
Kila seti ya data iligawanywa kwa kujitegemea kama:
\[ D^{(m)} = D_{\mathrm{train}}^{(m)} \cup D_{\mathrm{test}}^{(m)} \]
na:
\[ D_{\mathrm{train}}^{(m)} \cap D_{\mathrm{test}}^{(m)} = \varnothing \]
kwa namna hiyo.
Uwiano wa 70/30:
\[ |D_{\mathrm{train}}^{(m)}| = 0.70|D^{(m)}|, \qquad |D_{\mathrm{test}}^{(m)}| = 0.30|D^{(m)}| \]
Sehemu ya training ndani yake iligawanywa kuwa:
\[ D_{\mathrm{train}}^{(m)} = D_{\mathrm{fit}}^{(m)} \cup D_{\mathrm{val}}^{(m)} \]
na:
\[ D_{\mathrm{fit}}^{(m)} \cap D_{\mathrm{val}}^{(m)} = \varnothing \]
kwa namna hiyo. \(D_{\mathrm{fit}}\) ilitumika kwa parameter learning; \(D_{\mathrm{val}}\) kwa validation-loss monitoring, early stopping na checkpoint selection. Held-out \(D_{\mathrm{test}}\) haipaswi kutumika kwa training, hyperparameter monitoring au model selection.
Maelezo ya reproducibility yanayokosekana: Chanzo hakitoi katika sehemu hii asilimia ya internal validation subset wala thamani ya nambari ya early-stopping patience \(P\).
Precision, Recall na F1 hupima nini?
Kwa kila daraja \(c\), precision:
\[ \mathrm{Precision}_c = \frac{TP_c} {TP_c+FP_c+\epsilon} \]
TP ni true positive; FP ni false positive. Precision ikiwa juu, sehemu kubwa ya mifano ambayo modeli inasema “ni daraja hili” kweli huwa katika daraja hilo.
Recall:
\[ \mathrm{Recall}_c = \frac{TP_c} {TP_c+FN_c+\epsilon} \]
FN ni mfano halisi wa positive ambao modeli imeukosa. Recall ikiwa juu, sehemu kubwa zaidi ya mifano halisi ya daraja hupatikana.
F1:
\[ F1_c = \frac{ 2\mathrm{Precision}_c\mathrm{Recall}_c }{ \mathrm{Precision}_c+\mathrm{Recall}_c+\epsilon } \]
F1 hutumia harmonic mean kati ya precision na recall. Ikiwa mojawapo iko chini sana, F1 pia hupungua.
Macro-F1:
\[ \mathrm{MacroF1} = \frac{1}{C} \sum_{c=1}^{C} F1_c \]
Kwa kuwa kila daraja linapata uzito sawa, uwezekano wa daraja kubwa kutawala metric nzima kwa idadi yake kubwa ya mifano hupunguzwa. Kwa sababu hii chanzo kinachagua Macro-F1 kama metric kuu katika matatizo ya usalama wa trafiki yenye class imbalance.
Uchaguzi wa checkpoint kwa validation loss
\[ L_{\mathrm{val}}^{(m,e)} = \frac{1} {|D_{\mathrm{val}}^{(m)}|} \sum_{(x_i,y_i)\in D_{\mathrm{val}}^{(m)}} L(y_i,\widehat{y}_i^{(e)}) \]
Epoch iliyochaguliwa:
\[ e^{*(m)} = \operatorname*{arg\,min}_{e\in\{1,\ldots,E\}} L_{\mathrm{val}}^{(m,e)} \]
Final parameter checkpoint:
\[ \theta^{*(m)} = \theta^{(e^{*(m)})} \]
Early stopping:
\[ L_{\mathrm{val}}^{(m,e)} \geq \min_{k<e} L_{\mathrm{val}}^{(m,k)} \quad \text{P ardışık epoch boyunca} \]
Yaani ikiwa validation loss haiboreki katika muda uliowekwa wa patience, training inaweza kusimamishwa. Chanzo hakiripoti thamani ya nambari ya \(P\).
Final evaluation set:
\[ D_{\mathrm{eval}}^{(m)} = D_{\mathrm{test}}^{(m)} \]
Class distribution ya test set haikusawazishwa kwa njia bandia; athari ya class imbalance ilitathminiwa kwa macro precision, recall, F1, AUC, confusion matrix na precision–recall behavior.
Mbinu na Matokeo ya Utafiti
Matokeo ya E10 yaliyoangaziwa katika chanzo
| Seti ya data | Accuracy | Precision | Recall | F1 | AUC | Hali katika chanzo |
|---|---|---|---|---|---|---|
| Dataset 1 | %99,12 | %98,94 | %98,76 | %98,85 | 0,998 | Abstract / matokeo / Jedwali 9 Training Stage |
| Dataset 2 | %98,63 | %98,41 | %98,16 | %98,28 | 0,997 | Abstract / matokeo / Jedwali 9 Training Stage |
Matokeo huru ya Test-stage katika Jedwali 10
| Seti ya data | Test Accuracy | Test Precision | Test Recall | Test F1 | Test AUC | Test Loss |
|---|---|---|---|---|---|---|
| Dataset 1 | %98,84 | %98,62 | %98,37 | %98,49 | 0,998 | 0,089 |
| Dataset 2 | %98,07 | %97,86 | %97,59 | %97,72 | 0,997 | 0,101 |
Mpaka wa tafsiri: Katika chanzo kuna kutolingana wazi kwa kuripoti kati ya tabaka hizi mbili za performance. Verianla inahifadhi label ya Jedwali 10 kama matokeo ya held-out test; lakini pia haipuuzi thamani za abstract/conclusion za waandishi. Seti hizi mbili hazipaswi kutumiwa badala ya nyingine.
Maendeleo kutoka E1 hadi E10 katika hatua ya test
| Usanidi | Dataset 1 Test F1 | Dataset 1 AUC | Dataset 2 Test F1 | Dataset 2 AUC |
|---|---|---|---|---|
| E1 | %90,06 | 0,938 | %89,14 | 0,931 |
| E2 | %91,73 | 0,951 | %90,85 | 0,944 |
| E3 | %92,44 | 0,958 | %91,62 | 0,952 |
| E4 | %94,00 | 0,970 | %93,17 | 0,965 |
| E5 | %94,92 | 0,977 | %94,11 | 0,973 |
| E6 | %95,67 | 0,983 | %94,80 | 0,980 |
| E7 | %96,57 | 0,988 | %95,62 | 0,986 |
| E8 | %97,18 | 0,992 | %96,28 | 0,990 |
| E9 | %97,84 | 0,996 | %96,98 | 0,994 |
| E10 | %98,49 | 0,998 | %97,72 | 0,997 |
Kulingana na jedwali hili la test, ongezeko la absolute F1 kutoka E1 hadi E10 ni asilimia pointi 8,43 kwa Dataset 1 na asilimia pointi 8,58 kwa Dataset 2. Maandishi ya discussion ya chanzo pia yanahesabu tofauti hizi mbili za test-stage kwa namna hii.
Kinyume chake, abstract na Table 11 katika chanzo zinatumia thamani za Training Stage na kuripoti ongezeko la +7,91 na +8,26 percentage points. Hesabu hizi mbili zinategemea majedwali tofauti.
Ablation inaonyesha nini?
Lengo la mantiki ya ablation ni kuchunguza kama performance ya mwisho inatokana na module moja “ya kimiujiza” au na components zinazoongezeka hatua kwa hatua.
| Hatua ya modeli | F1 D1 | F1 D2 | Taarifa kuu iliyoongezwa |
|---|---|---|---|
| Baseline MLP | %90,94 | %90,02 | Spatial/temporal hazard reasoning hakuna |
| Spatial-only | %92,64 | %91,70 | Road-network topology |
| Temporal-only | %93,29 | %92,40 | Temporal buildup |
| Spatial + Temporal | %94,69 | %93,85 | Coupled spatio-temporal model |
| + Hazard Reconstruction | %95,54 | %94,79 | Explicit hidden-danger field |
| + Risk Diffusion | %96,21 | %95,42 | Uhamishaji wa risk kutoka barabara jirani |
| + Escalation Cue | %97,02 | %96,23 | Recent hazard intensification |
| + Neighborhood Context | %97,60 | %96,87 | Corridor-level reinforcement |
| + BiGRU | %98,17 | %97,50 | Temporal memory ndefu zaidi |
| Full CHFI | %98,85 | %98,28 | Hazard-to-emergence mapping kamili |
Dokezo jingine muhimu: Thamani hizi za Jedwali 11 zinafuata mfululizo uleule wa performance kama matokeo ya Jedwali 9 Training Stage. Thamani sambamba za F1 katika Test-stage Jedwali 10 ni chini kidogo.
Kila module ilitoa nini?
Spatial encoder: Inaongeza road network connectivity kwenye mtazamo wa flat record.
Temporal module: Hujifunza jinsi hatari katika eneo lilelile ilivyokua kutoka zamani hadi sasa. Katika chanzo, temporal-only model kutoa F1 ya juu kidogo kuliko spatial-only model kunaonyesha kwamba taarifa ya buildup kwa muda ni predictive signal yenye nguvu yenyewe.
Spatial + temporal: Huiwezesha modeli kukaribia si tu swali la “wapi?” au “lini?”, bali pia “inakua wapi kwa muda katika mtandao uliounganishwa?”.
Hazard reconstruction: Huilazimisha modeli kujenga explicit latent hazard field kabla ya classification embedding ya moja kwa moja.
Risk diffusion: Huacha kuichukulia sehemu ya barabara kuwa huru kabisa kutoka mazingira yake.
Escalation cue: Inawakilisha kasi ya kuongezeka kwa hazard kando na absolute hazard level.
Neighborhood context: Husaidia kuelewa kama hatari ya ndani ni ya pekee au sehemu ya muundo mpana wa corridor-level risk.
BiGRU na memory: Ni uimarishaji wa mwisho wa temporal unaolenga kumodeli hazard evolution patterns ndefu zaidi.
Kwa nini validation kali inahitajika?
Katika spatio-temporal data, random train/test split inaweza kuonyesha generalizability ya ulimwengu halisi kuwa bora kuliko ilivyo, hasa ikiwa nyakati zilizo karibu au maeneo jirani ya barabara yanabaki katika vikundi vyote viwili. Kwa hiyo chanzo kinatumia temporal, geographic na blocked spatio-temporal hold-out pamoja na random split.
| Dataset | Validation | Accuracy | Precision | Recall | F1 |
|---|---|---|---|---|---|
| Dataset 1 | Stratified random | %99,12 | %98,94 | %98,76 | %98,85 |
| Dataset 1 | Temporal hold-out | %97,84 | %97,51 | %97,28 | %97,39 |
| Dataset 1 | Geographic hold-out | %97,36 | %97,04 | %96,82 | %96,93 |
| Dataset 1 | Blocked spatio-temporal | %96,71 | %96,38 | %96,05 | %96,21 |
| Dataset 2 | Stratified random | %98,63 | %98,41 | %98,16 | %98,28 |
| Dataset 2 | Temporal hold-out | %97,29 | %96,94 | %96,71 | %96,82 |
| Dataset 2 | Geographic hold-out | %96,88 | %96,52 | %96,19 | %96,35 |
| Dataset 2 | Blocked spatio-temporal | %96,14 | %95,78 | %95,43 | %95,60 |
Blocked spatio-temporal validation inaelezwa kuwa test kali zaidi kwa sababu inazuia kwa pamoja kufanana kwa wakati na nafasi, na F1 ya chini zaidi katika seti zote mbili za data inaonekana hapa. Kushuka kwa performance kunaonyesha kwamba thamani za random record split ni hali rahisi zaidi ya tathmini.
Hata hivyo, ukweli kwamba mistari ya random split ni sawa kabisa na thamani za Jedwali 9 Training Stage unaonyesha kwamba kutolingana kwa result-labeling ndani ya chanzo kunaendelea pia hapa. Kwa hiyo jedwali hapo juu limewasilishwa kama chanzo kilivyoripoti; halipaswi kutumika badala ya matokeo ya Jedwali 10.
Gharama ya ukokotoaji
| Exp. | Parameter | Train / epoch | Inference | Peak memory | FLOPs |
|---|---|---|---|---|---|
| E1 | 0,18 M | 9,4 s | 2,1 ms | 186 MB | 12,6 M |
| E2 | 0,31 M | 13,8 s | 3,4 ms | 224 MB | 21,7 M |
| E3 | 0,42 M | 15,9 s | 4,2 ms | 241 MB | 28,1 M |
| E4 | 0,64 M | 20,3 s | 5,6 ms | 292 MB | 39,8 M |
| E5 | 0,78 M | 23,1 s | 6,2 ms | 317 MB | 46,5 M |
| E6 | 0,83 M | 25,4 s | 6,8 ms | 336 MB | 51,2 M |
| E7 | 0,89 M | 27,9 s | 7,2 ms | 348 MB | 55,6 M |
| E8 | 0,94 M | 29,2 s | 7,8 ms | 361 MB | 58,9 M |
| E9 | 1,08 M | 33,7 s | 8,9 ms | 388 MB | 66,4 M |
| E10 | 1,26 M | 36,8 s | 9,6 ms | 412 MB | 73,8 M |
E10 ina takribani mara saba model parameters zaidi kuliko E1 na gharama kubwa zaidi ya computation/memory. Pamoja na hayo, chanzo kinaeleza thamani ya 9,6 ms inference kama “practical inference cost”. Thamani hii inahusu hardware na implementation conditions zilizoripotiwa katika utafiti; latency hiyo hiyo haihakikishwi kwa hardware tofauti au mfumo wa production wa real-time.
Vielelezo vya chanzo vinaonyesha uga wa hatari unabadilika kuwa nini kwa kuonekana?
Kabla ya preprocessing, chanzo kinaonyesha taarifa ya hazard kama visiwa vyembamba, vilivyotengwa na vilivyogawanyika vya high-intensity. Baada ya preprocessing, muundo huo huo wa dhana hubadilika kuwa hazard surface pana zaidi, laini na inayosambaa kwa mwendelezo katika maeneo jirani ya barabara.
Surfaces katika vielelezo hivi vinaeleza utaratibu wa preprocessing wa utafiti. Verianla haijazalisha upya contour coordinates zilezile au intensities za rangi kana kwamba ni data mpya ya majaribio; kwa sababu chanzo hakitoi underlying numerical grid kamili inayohitajika kuzichora upya.
Baadhi ya matokeo ya visual diagnostic yaliyoripotiwa katika chanzo
Katika E1 baseline, Dataset 1 test AUC ni 0,938 na generalization dhaifu zaidi inaonekana katika rare class. Katika Dataset 2 baseline, hasa kutenganisha madaraja yaliyo machache kama Multi-Injury na Fatal/Severe ni vigumu zaidi.
Kwa E10, chanzo kinaripoti normalized diagonal ratios katika Dataset 1 confusion matrix kama Low %99,5, Moderate %94,9, Elevated %93,4 na Critical %94,3. Chanzo pia kinasema calibration curve hufuata kwa karibu ideal calibration line katika sehemu kubwa. Thamani hizi ni tafsiri ya diagnostic ya Figure 24 ya chanzo na hazihakikishi calibration behavior ileile katika seti nyingine zote za data.
Ulinganisho na tafiti zinazohusiana unapaswa kusomwaje?
Jedwali 15 la chanzo linaweka tafiti tofauti kama mtazamo wa MLP wa Park na Hong, modeli ya GEE ya Macedo na wenzake, XTraffic benchmark za Gou na wenzake, mtazamo wa TRAVEL wa Huang na wenzake, modeli ya RoadInTCP ya Wang na wenzake, utafiti wa XGBoost/RF/MLP wa Yumak na wenzake, modeli ya CNN–LSTM–GNN ya Li na Chen na mtazamo wa GNN–LSTM–MLP wa Alnowaiser.
Hata hivyo, tafiti hizi hutumia seti tofauti za data, target definitions tofauti, sample distributions tofauti na evaluation protocols tofauti. Kwa mfano, si sahihi kimethodolojia kupanga %99,97 accuracy iliyoripotiwa katika utafiti mmoja na thamani za CHFI katika kiwango cha %98–99 kwa kuangalia namba pekee na kuuliza “ipi ni bora?”.
Dai kuu la novelty la chanzo si accuracy ya juu pekee. Tofauti ya CHFI ni kuunda hidden hazard field yenye topology-aware, temporally evolving na interpretable kabla ya discrete accident classification.
Nini kinakosekana katika ulinganisho wa external baseline wa chanzo?
Maandishi yanasema RF, XGBoost, MLP, LSTM/GRU na graph-based models ni familia zenye nguvu za external benchmark na kujadili umuhimu wake katika evaluation design. Hata hivyo, majedwali makuu ya matokeo ya nambari katika makala yanatoa usanidi wa ndani wa E1–E10. Jedwali 15, kwa upande mwingine, linawasilisha matokeo ya tafiti nyingine zilizochapishwa.
Kwa hiyo, kwa kuwa jedwali tofauti la same-dataset, same-split RF/XGBoost/LSTM/GCN numerical benchmark halionekani katika chanzo, Verianla haitengenezi jedwali kama hilo.
Matokeo yanayoungwa mkono na utafiti
- Kutoka Flat MLP baseline kwenda topology-aware na temporal architecture kumeongeza performance katika seti zote mbili za data.
- Muundo wa temporal-only umeonyesha F1 ya juu kidogo kuliko spatial-only.
- Kutumia spatial na temporal model kwa pamoja kumetoa matokeo bora kuliko kuzitumia kila moja peke yake.
- Kuongeza explicit hazard reconstruction kumeongeza performance zaidi.
- Kuongeza risk-diffusion, hazard escalation na neighborhood context kumetoa maboresho ya hatua kwa hatua.
- BiGRU na temporal window ndefu zaidi zimetoa maboresho ya ziada katika hatua za mwisho.
- Performance ilipungua kutoka random split kwenda temporal, geographic na blocked spatio-temporal validation, lakini ilibaki juu katika chanzo.
- Modeli imeripotiwa kuwa na takribani 1,26 million parameter na 9,6 ms inference cost kwenye hardware ya chanzo.
- Continuous hazard representation inalenga kuifanya modeli izalishe latent safety structure inayoweza kufasiriwa kabla ya accident prediction.
Ujumlishaji ambao utafiti hauungi mkono
- Haijaonyeshwa kwamba CHFI imethibitishwa moja kwa moja katika mfumo wa trafiki wa jiji wa real-time.
- Haijaonyeshwa kwamba modeli imezuia ajali kwa vitendo au kupunguza idadi ya ajali kwa asilimia fulani.
- Output ya modeli si amri ya moja kwa moja ya autonomous traffic signal control.
- Accuracy ya juu katika seti mbili za data haionyeshi kwamba performance ileile itapatikana katika miji na nchi zote.
- Random split performance si kitu kilekile na geographic au temporal generalization.
- Hazard field si uga halisi wa kimwili uliopimwa moja kwa moja; ni reconstructed latent representation inayotolewa na modeli.
- Kupatikana kwa hazard hotspot peke yake hakuthibitishi causal accident mechanism.
- Metrics za tafiti tofauti katika Jedwali 15 si matokeo yaliyoshindanishwa moja kwa moja kwenye test set ileile.
- Thamani za \(\sigma_s\), \(\sigma_t\), \(\lambda_1\), \(\lambda_2\) na patience \(P\) ambazo hazijapewa thamani ya nambari katika chanzo hazijulikani.
- Haiwezi kusemwa kwamba namba za performance katika muhtasari na hitimisho zinaendana kikamilifu na independent held-out test values; chanzo kinaripoti thamani tofauti katika Jedwali 9 na Jedwali 10.
Mapungufu muhimu ya utafiti na tafiti za baadaye
Ingawa chanzo hakitoi orodha ndefu ya mapungufu chini ya kichwa maalum cha “Limitations”, kinaeleza wazi katika sehemu ya hitimisho maeneo ambayo yanahitaji kuthibitishwa baadaye.
Real time: Modeli inapaswa kupanuliwa katika siku zijazo hadi real-time streaming environment. Utafiti wa sasa haujaithibitisha kwenye live traffic flow.
Context tajiri zaidi: Signal timing, lane-level dynamics, multimodal mobility interaction na weather progression yenye undani zaidi vinaweza kushughulikiwa katika modeli katika siku zijazo.
Cross-city generalization: Tathmini inahitajika katika miji zaidi, mitandao ya usafiri na external benchmark dataset zaidi.
Uncertainty: Uncertainty-aware accident emergence modeling ni mada ya utafiti wa baadaye; matokeo ya sasa hayatoi mfumo kamili wa uncertainty quantification.
Traffic-control integration: Muunganisho na traffic control na intervention systems ni eneo la matumizi ya baadaye.
Reproducibility: Chanzo kinatoa architectural hyperparameter nyingi; hata hivyo baadhi ya thamani kama kernel bandwidths, composite loss weights na early-stopping patience hazijakamilika kwa nambari.
Reporting consistency: Final performance values katika Training Stage, Test Stage, abstract/conclusion na robustness tables hazifanani. Hali hii inahitaji kufuatilia kwa makini kila matokeo yanahusu evaluation layer ipi.
Kwa vitendo, modeli inakusudiwa kuendeshwaje?
- Data mpya ya traffic, incident, road, time na contextual inapokelewa.
- Uchunguzi unawekwa sawa na kitengo sahihi cha road segment/intersection katika transportation graph.
- Data inawekwa katika overlapping temporal windows.
- Kwa risk-diffusion, athari za mtandao jirani huhamishwa kwenda feature space.
- Hazard-sensitive normalization inatumika.
- Initial continuous hazard surface huundwa kutoka sparse events.
- GCN hujifunza spatial hazard relationships.
- GRU/BiGRU hujifunza buildup na persistence structure ya hazard kwa muda.
- Modeli huzalisha continuous latent hazard field \(\widehat{H}(t)\).
- Hazard escalation huhesabiwa kwa \(\Delta\widehat{H}(t)\).
- Neighborhood context hutolewa kwa \(W\widehat{H}(t)\).
- Prediction head hubadilisha taarifa hizi kuwa localized accident-emergence probability.
- Outputs zinaweza kufasiriwa kama hazard map, risk zone, hotspot na decision support kwa safety inspection/early-warning.
Maana ya kisayansi
Mchango mkuu wa dhana wa utafiti ni kuondoa ajali kutoka kuwa matokeo yanayotabiriwa peke yake na kuichukulia kama matokeo ya “hali tangulizi ya hatari” isiyoonekana lakini inayofanyiwa reconstruct na modeli.
Katika mtazamo huu, modeli inalenga kujibu si tu swali “rekodi ipi ni ajali?”, bali pia “hatari inajikusanya katika sehemu zipi za barabara zilizounganishwa, inasambaa kutoka wapi, inaongezeka kwa muda, na kitengo gani cha ndani kinakaribia kuwa critical?”.
Hata hivyo, uga huu wa hatari si “dutu halisi ya hatari” iliyopimwa moja kwa moja na sensa ya kimwili. Ni learned latent mathematical representation. Tofauti hii ni muhimu kwa tafsiri ya output ya modeli.
Maelezo ya Chanzo na Mbinu
Kichwa asilia: Learning the City’s Hidden Danger: A Continuous Hazard Field Intelligence Framework for Traffic Accident Emergence and Urban Safety Prediction
Waandishi: Nawal Louzi; Mahmoud AlJamal; Mohammad Q. Al-Jamal.
Corresponding authors: Nawal Louzi na Mahmoud AlJamal.
Mchango sawa / equal first authorship: Chanzo hakiripoti alama ya mchango sawa.
Taasisi 1: Civil Engineering Department, Al-Ahliyya University, Amman 19111, Jordan.
Taasisi 2: Department of Cybersecurity, Science and Information Technology, Irbid National University, Irbid 21110, Jordan.
Taasisi 3: Department of Renewable Energy, Technical Faculty, Jadara University, P.O. Box 733, Irbid 21110, Jordan.
Jarida: Urban Science.
Mchapishaji: MDPI, Basel, Switzerland.
Volume / issue / article: Volume 10, Issue 6, Article 300.
DOI: 10.3390/urbansci10060300.
Uwasilishaji: 5 Aprili 2026.
Marekebisho: 10 Mei 2026.
Kukubaliwa: 22 Mei 2026.
Kuchapishwa: 27 Mei 2026.
Aina ya chanzo: Article; utafiti wa computational unaoendeleza topology-aware spatio-temporal deep learning na continuous hazard-field modeling kwenye seti za data za usalama wa trafiki za ulimwengu halisi.
Hali ya peer review: Version of Record iliyochapishwa katika jarida la peer-reviewed Urban Science.
Preprint: Hakuna taarifa tofauti ya preprint katika chanzo; pia katika ukaguzi mahususi, hakuna preprint tofauti iliyopatikana kwa kichwa hiki.
Leseni: Creative Commons Attribution (CC BY).
Modeli kuu: Continuous Hazard Field Intelligence Framework — CHFI.
Dataset 1: XTraffic Incident Dataset (2022–2024), rekodi 1.441.904.
Dataset 2: Motor Vehicle Collisions–Crashes Dataset, rekodi 2.026.647, feature 29 zilizoandikwa.
Mgawanyo mkuu wa data: %70 training / %30 held-out testing. Validation subset tofauti ilitumika ndani ya sehemu ya training; exact validation ratio haijaripotiwa katika chanzo.
Optimizer: Adam.
Final E10 learning rate: 2×10⁻⁴.
Final batch size: 32.
Maximum epoch: 120.
Final temporal window / stride: W=10, Δ=3.
Final latent dimension: h=256.
Final local–neighbor balance: α=0,60.
Final temporal persistence: β=0,80.
Final temporal model: BiGRU + temporal memory update.
Spatial model: GCN + topology-aware diffusion.
Hazard reconstruction: Continuous hazard reconstruction layer.
Evaluation metrics: Accuracy, macro-precision, macro-recall, Macro-F1, AUC, loss; pamoja na confusion matrix, ROC na precision–recall diagnostic evaluations.
Robust validation ya ziada: Stratified random split, temporal hold-out, geographic hold-out na blocked spatio-temporal validation.
Mazingira ya utekelezaji: MATLAB R2023a; Windows 11 Home 64-bit.
Hardware: ASUS TUF Gaming F15 FX506LH; Intel Core i5-10300H 2,50 GHz; 32 GB RAM; NVIDIA GeForce GTX 1650, 4 GB dedicated display memory na 16 GB shared memory.
Final model complexity: Kwa mujibu wa Jedwali 12 la chanzo, takribani 1,26 million parameter, 36,8 s training time/epoch, 9,6 ms inference, 412 MB peak memory na 73,8 M FLOPs.
Ufadhili: Imeripotiwa kwamba utafiti uliungwa mkono na kufadhiliwa na Al-Ahliyya University, Amman, Jordan.
Institutional Review Board: Haitumiki.
Informed Consent: Haitumiki.
Upatikanaji wa data: Waandishi wanasema seti za data zilizotumika zilipatikana kutoka vyanzo vya mtandaoni vilivyo wazi kwa umma; derived processing scripts, feature-engineering procedures na implementation details zinaweza kutolewa na corresponding author kwa reasonable request.
Dokezo la chanzo kuhusu upatikanaji wa data: XTraffic Dataset inaonyeshwa kama rekodi ya Kaggle katika rejea [21]. Motor Vehicle Collisions–Crashes imeorodheshwa kama rekodi ya TUSH32 Kaggle katika rejea [22]. Kwa kuwa DOI 10.1016/j.aap.2024.107564 iliyotolewa mwishoni mwa sehemu ya Data Availability inalingana na makala ya Cui na wenzake katika rejea [11], haijafasiriwa kama repository ya Dataset 2.
Michango ya waandishi: Conceptualization — N.L., M.A., M.Q.A.-J.; methodology — N.L., M.A.; software — M.A.; validation — N.L., M.A., M.Q.A.-J.; formal analysis — N.L., M.A.; investigation — N.L., M.A.; resources — N.L., M.Q.A.-J.; data curation — M.A.; writing—original draft — N.L., M.A.; writing—review and editing — N.L., M.A., M.Q.A.-J.; visualization — M.A.; supervision — N.L., M.Q.A.-J.; project administration — N.L.; funding acquisition — N.L.
Mgongano wa maslahi: Waandishi wanatangaza kuwa hakuna mgongano wa maslahi.
Kutolingana muhimu kwa kuripoti: Abstract, conclusion, Jedwali 9 na baadhi ya summary tables za baadaye zinatoa kwa final CHFI %99,12 accuracy / %98,85 F1 katika Dataset 1 na %98,63 accuracy / %98,28 F1 katika Dataset 2, wakati thamani za E10 za Jedwali 10 lililoandikwa wazi “Test-stage” zimeripotiwa kama %98,84 accuracy / %98,49 F1 katika Dataset 1 na %98,07 accuracy / %97,72 F1 katika Dataset 2. Verianla haijasahihisha tofauti hii kimya kimya.
Dokezo la ablation reporting: Mfululizo wa F1 katika Jedwali 11 unalingana na matokeo ya Jedwali 9 Training Stage; kwa test-stage values, Jedwali 10 linapaswa kutathminiwa tofauti.
Dokezo la external baseline: Chanzo kinajadili RF, XGBoost, MLP, LSTM/GRU na graph-based models kama familia zenye nguvu za benchmark; lakini majedwali ya kina ya nambari ya E1–E10 katika makala hasa ni usanidi wa ndani wa CHFI. Matokeo ya tafiti nyingine katika Jedwali 15 si direct head-to-head comparison kwenye dataset ileile.
Parameter za reproducibility zinazokosekana: Thamani za nambari za Spatial bandwidth \(\sigma_s\), temporal bandwidth \(\sigma_t\), composite loss weights \(\lambda_1,\lambda_2\), exact internal validation fraction na early-stopping patience \(P\) hazijaripotiwa wazi katika chanzo.
Mpaka mkuu wa tafsiri: Utafiti unafanya controlled computational evaluation kwenye seti mbili kubwa za data zilizopo. Real-time live urban deployment, intervention halisi ya trafiki, prospective reduction katika idadi ya ajali au large-scale field validation katika miji tofauti hazijafanywa.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *