

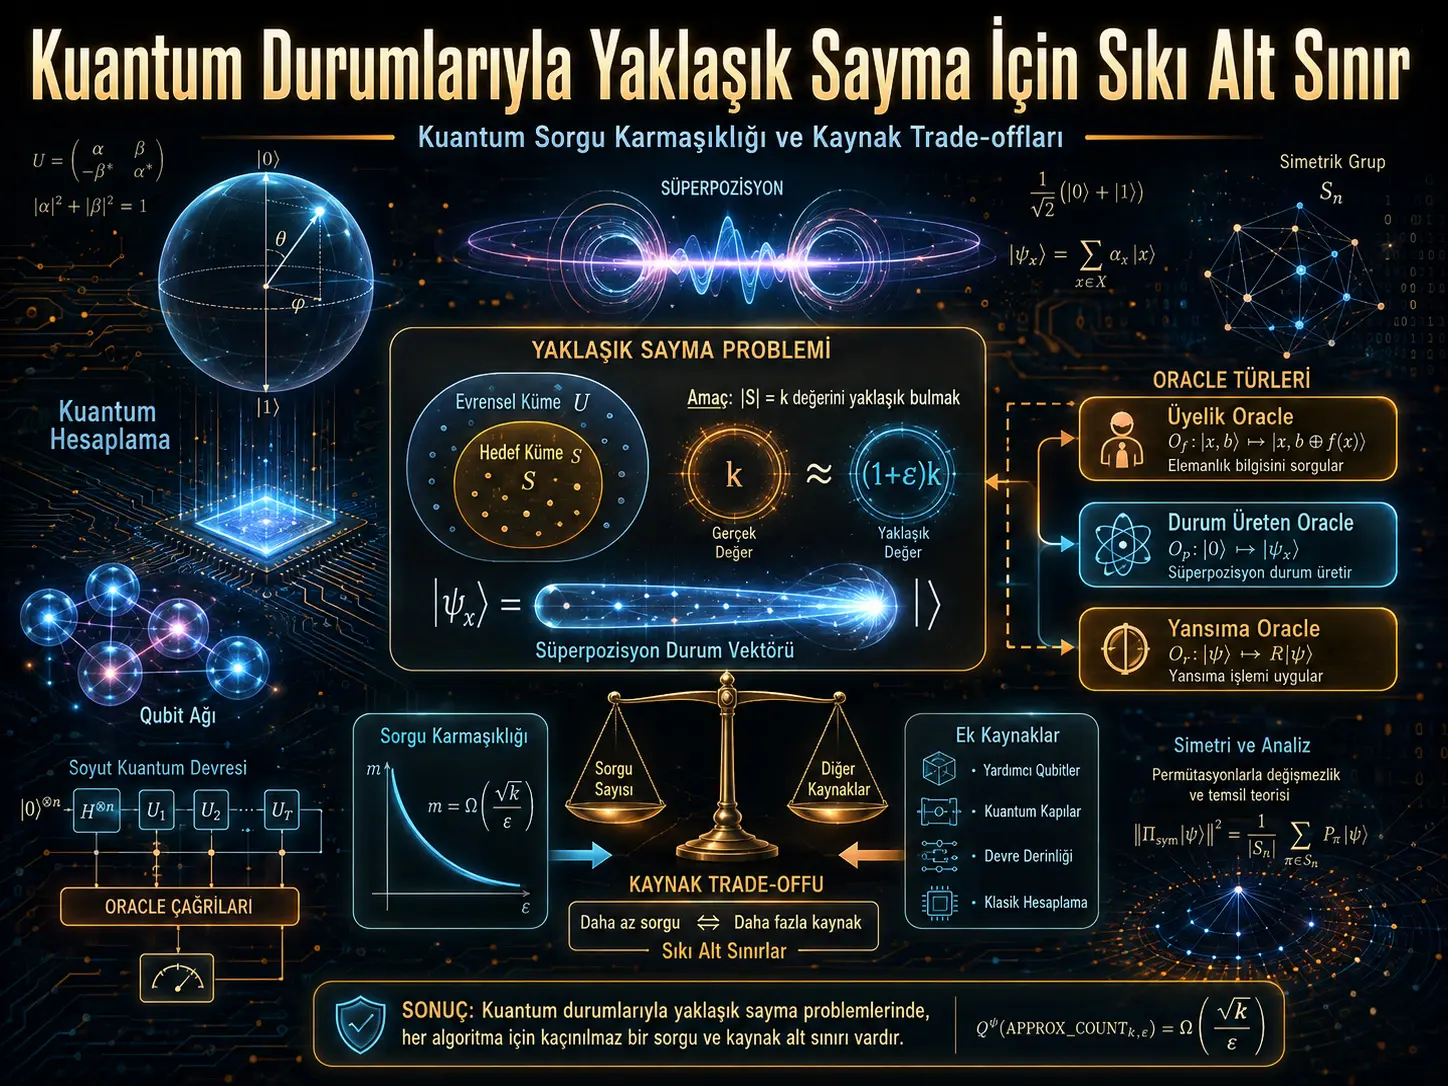
Utafiti huu unaweka wazi mipaka ya msingi ya gharama ya tatizo la kukadiria kwa takribani idadi ya elementi za seti kwa kutumia rasilimali za quantum. Watafiti wanachunguza algoriti za quantum zinazotofautisha hali mbili ambapo ukubwa wa seti ya ingizo ni ama k au k′ = (1+ε)k. Mbali na membership oracle, ambayo ni sawa ya quantum ya swali la kawaida la uanachama, algoriti inapewa aina tatu tofauti za ufikiaji wa hali \(|\psi_x\rangle\), ambayo ni superposition ya quantum yenye uzani sawa ya elementi za seti: nakala za hali hiyo, oracle inayofanya reflection kuzunguka hali hiyo, na oracle inayozalisha hali hiyo. Matokeo makuu ya utafiti ni kupata lower bounds zilizo tight kwa kila moja ya rasilimali hizi na mchanganyiko wake katika eneo la \(n\geq5k\) na \(1/k\leq\varepsilon\leq1\), na kuonyesha kwa algoriti zinazolingana kwamba mipaka hiyo kwa kiasi kikubwa ni optimal.
Matokeo hayajibu tu swali la “ni quantum queries ngapi zinahitajika?”. Jambo muhimu zaidi ni kufichua resource trade-offs zinazobainisha kihisabati kiwango ambacho rasilimali nne tofauti zinaweza kubadilishana. Kwa mfano, ikiwa membership oracle pekee inatumika, idadi inayohitajika ya queries ni \(\Omega((1/\varepsilon)\sqrt{n/k})\), ilhali ikiwa state-generating oracle pekee inatumika, tatizo linaweza kutatuliwa katika baadhi ya maeneo ya vigezo kwa kiwango cha \(k^{1/3}/\varepsilon^{2/3}\). Hata hivyo, kuunganisha rasilimali tofauti hakutoi faida isiyo na kikomo; theorem kuu inaonyesha kwamba algoriti yoyote yenye mafanikio lazima itimize angalau mojawapo ya masharti nane ya rasilimali yaliyotolewa katika makala.
Matokeo haya si muda wa utekelezaji kwenye kompyuta halisi ya quantum wala kipimo cha utendaji katika sekunde. Utafiti unathibitisha theoretical lower na upper bounds katika modeli ya quantum query complexity. Kwa hiyo, muda halisi wa kufanya kazi, kiwango cha hitilafu au faida ya kiutendaji ya hardware maalum ya quantum haiwezi kutolewa moja kwa moja kutoka katika matokeo haya.
Tatizo la approximate counting ni nini?
Tatizo linalochunguzwa na watafiti si kupata kwa usahihi ukubwa wa seti isiyojulikana \(x\subseteq[n]\), bali kutofautisha uwezekano mbili:
\[ |x|=k \]
au
\[ |x|=k'=(1+\varepsilon)k. \]
Hapa \(n\) inawakilisha idadi ya elementi zote zinazowezekana; \(k\) ni ukubwa wa seti ndogo; na \(\varepsilon\) ni parameter ya usahihi inayobainisha tofauti ya uwiano kati ya uwezekano hizo mbili. Kadiri \(\varepsilon\) inavyopungua, hali hizi mbili zinakaribiana na tatizo la kuzitofautisha linakuwa gumu zaidi.
Tatizo hili la uamuzi linatumika kuchunguza lower bounds za tatizo la jumla zaidi la “kukadiria ukubwa wa seti kwa multiplicative error”. Ikiwa algoriti inalazimika kutumia kiasi fulani cha rasilimali hata kutofautisha \(k\) na \((1+\varepsilon)k\), basi tatizo la jumla la approximate counting haliwezi kuwa nafuu kuliko hilo.
Membership oracle hutoa nini?
Seti inaweza kuwakilishwa kwa njia ya kawaida kwa characteristic bit string. Kwa kila \(i\in[n]\), ikiwa \(x_i=1\), basi \(i\in x\); ikiwa \(x_i=0\), basi \(i\notin x\). Quantum membership oracle hufanya taarifa hii ya uanachama ipatikane kama quantum query.
Muundo wa kawaida unaotumiwa katika utafiti ni mabadiliko yafuatayo:
\[ O_x:|i\rangle|b\rangle\mapsto|i\rangle|b\oplus x_i\rangle. \]
Ikiwa oracle hii pekee inapatikana, query complexity ya approximate counting, kulingana na matokeo yaliyokuwa yanajulikana tayari, ni katika kiwango cha
\[ \Theta\!\left(\frac{1}{\varepsilon}\sqrt{\frac{n}{k}}\right) \]
Utafiti huu unaenda zaidi ya hapo kwa kuchunguza modeli ambazo algoriti inaweza kufikia moja kwa moja hali ya quantum inayowakilisha seti.
Hali ya quantum ya seti inafafanuliwaje?
Superposition yenye uzani sawa juu ya elementi za seti inafafanuliwa kama
\[ |\psi_x\rangle= \frac{1}{\sqrt{|x|}} \sum_{i\in x}|i\rangle \]
Hali hii ya quantum hutoa amplitude sawa kwa kila elementi iliyo katika seti. Swali muhimu la utafiti ni kiasi gani gharama ya approximate counting inaweza kupunguzwa ikiwa algoriti inapewa, pamoja na membership oracle, rasilimali za ziada za quantum kuhusu hali hii.
Kwa nini aina tatu tofauti za ufikiaji wa hali ya quantum zinatenganishwa?
Makala inahesabu aina tatu tofauti za ufikiaji kama rasilimali zinazojitegemea.
- Nakala za hali: Algoriti inapewa moja kwa moja idadi fulani ya nakala za hali \(|\psi_x\rangle\).
- Reflecting oracle: Algoriti inaweza kutumia oracle inayotekeleza reflection kuzunguka hali \(|\psi_x\rangle\).
- State-generating oracle: Oracle hutolewa ambayo hubadilisha hali ya mwanzo kwa namna \(|0\rangle\mapsto|\psi_x\rangle\) na pia inaweza kutekelezwa kinyume.
State-generating oracle ni yenye nguvu hasa kati ya hizi tatu. Kulingana na chanzo, call moja inatosha kuzalisha nakala moja ya \(|\psi_x\rangle\); calls mbili — moja forward na moja inverse — zinaweza kutekeleza reflection kuzunguka \(|\psi_x\rangle\). Kinyume chake, haijaonyeshwa kwamba general state-generating oracle inaweza kuigwa kwa urahisi kwa kutumia nakala na reflections pekee.
Theorem kuu inasema nini?
Matokeo makuu yanatolewa kwa \(n\geq5k\) na \(1/k\leq\varepsilon\leq1\). Tuchukulie kwamba algoriti ina nakala \(\ell\) za \(|\psi_x\rangle\), na hutumia membership, state-generating na reflecting oracle mara \(q_M\), \(q_G\) na \(q_R\), mtawalia. Algoriti yenye mafanikio lazima ifikie kiwango kinachobainishwa na angalau mojawapo ya masharti ya rasilimali yafuatayo.
| Rasilimali au mchanganyiko wa rasilimali | Lower bound / trade-off iliyothibitishwa | Maana ya kisayansi |
|---|---|---|
| Nakala za hali pekee | \(\ell=\Omega\!\left(\min\left\{k,\frac{\sqrt{k}}{\varepsilon},\frac{n}{k\varepsilon^2}\right\}\right)\) | Kupokea hali ya quantum kama sample pekee hakutoi taarifa isiyo na kikomo. |
| Membership oracle pekee | \(q_M=\Omega\!\left(\frac{1}{\varepsilon}\sqrt{\frac{n}{k}}\right)\) | Kikomo cha kawaida cha quantum approximate counting kinabaki. |
| State-generating oracle pekee | \(q_G=\Omega\!\left(\min\left\{\frac{1}{\varepsilon}\sqrt{\frac{n}{k}},\frac{k^{1/3}}{\varepsilon^{2/3}}\right\}\right)\) | Kutayarisha hali kwa active access kunaweza kuwa na nguvu zaidi kuliko membership queries katika baadhi ya maeneo ya vigezo. |
| State-generating oracle + nakala za hali | \(q_G\sqrt{\ell}=\Omega\!\left(\frac{\sqrt{k}}{\varepsilon}\right)\) | Nakala nyingi zaidi zilizotayarishwa zinaweza kupunguza state-generating queries zinazohitajika, lakini product trade-off inabaki. |
| Reflecting oracle pekee | \(q_R=\Omega\!\left(\min\left\{\frac{1}{\varepsilon}\sqrt{\frac{n}{k}},\sqrt{\frac{k}{\varepsilon}}+\sqrt{\frac{n}{k}}\right\}\right)\) | Reflecting oracle pia haiwezi kushuka chini ya gharama fulani ya asymptotic. |
| Reflecting oracle + copy/state-generating resource | \(q_R\sqrt{\ell+q_G}=\Omega\!\left(\frac{\sqrt{k}}{\varepsilon}\right)\) | Kuna trade-off tight kati ya reflection access na state-preparation resources. |
| Reflecting oracle + angalau state resource moja | \(q_R=\Omega\!\left(\sqrt{\frac{k}{\varepsilon}}\right)\), na pia \(\ell+q_G\geq1\) | Hata state resource moja ya ziada haiwezi kuondoa kabisa hitaji la reflecting oracle. |
| Reflecting oracle + membership oracle | \(q_R=\Omega\!\left(\sqrt{\frac{k}{\varepsilon}}\right)\) na \(q_M=\Omega\!\left(\sqrt{\frac{n}{k}}\right)\) | Kutumia oracle hizi mbili pamoja hakuwezi kupunguza gharama ya msingi ya zote mbili hadi sifuri. |
Hapa \(\Omega(\cdot)\) inamaanisha kwamba, ukipuuza constant factors, kiasi cha rasilimali hakiwezi kuwa asymptotically kidogo kuliko function iliyotolewa. Jedwali halionyeshi wall-clock time ya algoriti halisi, bali resource complexity kwa oracle calls na nakala za hali.
Kwa nini kutumia rasilimali zote nne pamoja hakuzalishi faida tofauti?
Moja ya matokeo muhimu ya utafiti ni kwamba kutumia rasilimali tatu au nne pamoja katika algoriti moja hakuzalishi “regime ya tisa” mpya na huru. Kulingana na theorem ya waandishi, katika matumizi ya rasilimali ya algoriti yenye mafanikio lazima kuwe na rasilimali moja au jozi ya rasilimali inayotimiza angalau mojawapo ya masharti nane hapo juu.
Matokeo haya yanaonyesha kwamba aina tofauti za quantum access zinaweza kusaidiana, lakini haziwezi kuvuka kiholela mathematical lower bounds za gharama ya jumla ya rasilimali.
Kwa nini lower bound inaitwa “tight”?
Ili complexity lower bound iitwe “tight”, haitoshi kuthibitisha tu kwamba algoriti haiwezi kufanya kazi kwa rasilimali chache; lazima pia kuwe na upper-bound algorithm inayofikia kiwango hicho. Appendix A ya makala inatoa matching algorithms kwa kusudi hili.
Waandishi wanaripoti kwamba lower bounds zote katika Table 1 zinalingana hadi constant factors. Jambo moja pekee ni kwamba kwa nakala pekee, upper bound ya term ya kwanza \(k\) iliyotolewa katika utafiti ni \(O(k\log k)\). Makala inaeleza wazi kwamba hapa kuna logarithmic gap kati ya lower bound na algoriti iliyotolewa.
Approximate counting inaweza kufanywaje kwa nakala?
Appendix A inatoa mbinu kadhaa. Moja inafanana na mantiki ya classical coupon collector: hali za \(|\psi_x\rangle\) zinapimwa ili kupata samples za nasibu zenye usambazaji sawa kutoka katika seti, na idadi ya elementi tofauti zilizoonekana inafuatiliwa.
Katika mbinu nyingine, idadi ya jozi zinazolingana miongoni mwa samples \(\ell\) hutumiwa. Kwa kuwa probability ya samples mbili huru na uniform kuwa sawa ni takribani \(1/|x|\), idadi ya collisions hutoa taarifa kuhusu ukubwa wa seti. Makala inaonyesha kwamba kwa njia hii
\[ O\!\left(\frac{\sqrt{k}}{\varepsilon}\right) \]
samples zinatosha.
Katika algoriti nyingine inayotegemea nakala, \(|\psi_x\rangle\) hupimwa dhidi ya superposition uniform ya elementi zote za \([n]\). Kwa kuwa probability ya tukio husika la kipimo ni \(|x|/n\), Bernoulli sampling inaweza kutofautisha \(k/n\) na \((1+\varepsilon)k/n\). Gharama yake ya rasilimali ni
\[ O\!\left(\frac{n}{k\varepsilon^2}\right) \]
nakala.
Kiwango cha \(k^{1/3}\) kwa state-generating oracle kinatoka wapi?
Algoriti katika Appendix A kwanza hupata elementi \(t\) tofauti kutoka katika seti, kisha hutumia subset hii inayojulikana kufanya amplitude estimation. Gharama ya rasilimali inaweza kuandikwa kwa takribani
\[ O\!\left( t+\frac{1}{\varepsilon}\sqrt{\frac{k}{t}} \right) \]
Term ya kwanza ni gharama ya kukusanya samples, na ya pili ni gharama ya tatizo la counting lililobaki.
Gharama hizi mbili zikisawazishwa, kiwango cha
\[ t\sim\frac{k^{1/3}}{\varepsilon^{2/3}} \]
kinatokea na total state-generating oracle complexity hushuka hadi kiwango hicho hicho cha asymptotic. Hii inaeleza chanzo cha kialgoriti cha term \(k^{1/3}/\varepsilon^{2/3}\) katika makala.
Kwa nini reflecting oracle ni muhimu kwa amplitude amplification?
Reflection kuzunguka hali ya quantum ni sehemu ya msingi ya amplitude amplification na amplitude estimation. Makala inaonyesha kwamba ikiwa elementi inayojulikana mapema kuwa katika seti \(x\) ipo, reflecting oracle inaweza kutumiwa kupata elementi mpya na kisha kukadiria ukubwa wa seti.
Katika hali hii, kwa uchaguzi unaofaa wa vigezo, approximate counting inahitaji
\[ O\!\left(\sqrt{\frac{k}{\varepsilon}}\right) \]
reflecting-oracle queries. Lakini ikiwa hakuna elementi ya \(x\) inayojulikana mwanzoni, inahitajika pia Grover-type search ya takribani kiwango cha \(\sqrt{n/k}\) ili kuipata.
Muundo wa uthibitisho wa utafiti unaendeleaje?
Verianla Live: Mlolongo wa uthibitisho wa tight quantum lower bound
Mchakato huu unafupisha mkakati wa kihisabati unaofuatwa katika sehemu za utafiti. Hatua zinawakilisha muundo halisi wa uthibitisho uliotumiwa katika chanzo; hakuna algoriti mpya au intermediate result iliyoongezwa.
| Hatua | Maelezo | Chanzo |
|---|---|---|
| 1. Kufafanua tatizo la approximate counting | Hali za \(|x|=k\) na \(|x|=(1+\varepsilon)k\) pamoja na aina nne za rasilimali zinafafanuliwa. | Sehemu 1–2 |
| 2. Mfumo wa multi-oracle adversary | General adversary method inaandaliwa ili algoriti iweze kutumia input oracle nyingi kama rasilimali huru. | Sehemu 3 |
| 3. Kurahisisha adversary matrix kwa kutumia symmetry | Permutation symmetry ya tatizo hutumika kugawanya adversary matrix kwa irreducible representations za symmetric group. | Sehemu 4–5 |
| 4. Norm estimates kwa aina za oracle | Lemmas kuu zinazoweka mipaka kwa athari za membership, state-generating na reflecting oracle kwenye adversary matrix zinathibitishwa. | Sehemu 4, 6 na 7 |
| 5. Representation theory ya symmetric group | Moduli \(\mathbb{C}^{\binom{[n]}k}\) na \(\mathbb{C}^{\binom{[n]}k}\otimes\mathbb{C}^n\) zinachambuliwa ili kutambua isotypical subspaces zinazohitajika. | Sehemu 5–8 |
| 6. Parametric adversary matrix | Kwa uchaguzi wa \(\gamma_j=\max\{1-j/t,0\}\), muundo wa parameter moja unaoruhusu kusogea kwenye resource trade-off curve unajengwa. | Sehemu 4.2 |
| 7. Theorem kuu ya lower bound | Norm estimates zinaunganishwa na kuonyeshwa kwamba algoriti yenye mafanikio lazima itimize angalau mojawapo ya masharti nane ya rasilimali. | Theorem 1.1 / Sehemu 4.3 |
| 8. Matching upper bounds | Sampling, coupon collector, amplitude amplification na amplitude estimation algorithms zinaonyesha tightness ya lower bounds. | Appendix A |
Kwa nini adversary method ni ya msingi hapa?
Mojawapo ya zana kuu za kuthibitisha lower bounds katika quantum query complexity ni adversary method. Kwa ujumla, lengo ni kuweka kikomo kwa kiasi cha maendeleo kinachoweza kupatikana katika kila oracle query wakati wa kutofautisha inputs zinazohitaji outputs sahihi tofauti.
Ubunifu wa kiufundi wa utafiti huu ni kutumia, badala ya adversary method iliyotengenezwa kwa standard membership oracle pekee, lahaja inayoweza kushughulikia general unitary input oracles na oracle resources nyingi ndani ya mfumo mmoja.
Katika hali ya multi-oracle, inequality kuu iliyotolewa katika makala ni:
\[ \sum_{i=1}^{r} \left\|\Gamma\circ\Delta^{(i)}\right\| \max_{x\in D} L_x^{(i)} \geq \|\Gamma\circ E\|. \]
Hapa \(\Gamma\) ni adversary matrix; \(\Delta^{(i)}\) inaeleza jinsi oracle ya \(i\) inavyotofautiana kati ya inputs tofauti; \(L_x^{(i)}\) ni matumizi ya rasilimali ya algoriti kwa oracle husika; na \(E\) ni tofauti kati ya Gram matrices za initial na target states.
Kazi ya formula hii ni kuweka kikomo kwa uwezekano wa “algoriti kutumia rasilimali zote kwa kiwango kidogo kwa wakati mmoja”. Kwa uchaguzi unaofaa wa \(\Gamma\), inaweza kuonyeshwa kwamba angalau rasilimali moja lazima iwe kubwa vya kutosha.
Symmetry inarahisishaje tatizo?
Katika approximate counting, jambo muhimu si ni elementi zipi hasa ziko ndani ya \(x\), bali jumla ya elementi zilizopo. Kwa hiyo permutation ya labels za elementi haibadilishi tatizo. Watafiti hutumia symmetry hii kuandika adversary matrix kwa representations za symmetric group:
\[ \Gamma=\sum_{j=0}^{k}\gamma_j\Phi_j. \]
Operators \(\Phi_j\) zinawakilisha isometric isomorphisms kati ya nakala husika za irreducible representations za \(S_n\). Kwa kuwa image na co-image spaces za components tofauti ni orthogonal, tatizo changamano la matrix ya dimension kubwa hubadilika kuwa tatizo lililopangwa zaidi ambalo coefficients \(\gamma_j\) zinaweza kudhibitiwa.
Kwa nini \(\gamma_j=\max\{1-j/t,0\}\) huchaguliwa?
Katika uthibitisho mkuu, coefficients za adversary matrix huchaguliwa kuwa
\[ \gamma_j=\max\left\{1-\frac{j}{t},0\right\} \]
Parameter \(t\) huchaguliwa kati ya 1 na takribani \(k/5\).
Uchaguzi huu huunda linear gradient inayotoka thamani kubwa katika \(j=0\) na kushuka hadi sifuri katika \(j=t\). Kwa kubadilisha \(t\), waandishi wanaweza kufikia maeneo tofauti ya trade-off curve kati ya mchanganyiko mbalimbali wa rasilimali. Hivyo badala ya kujenga adversary matrix mpya kabisa kwa kila jozi ya rasilimali, familia moja ya parametriki hutumiwa.
Kwa nini representation theory inahitajika?
Sehemu ya pili kubwa ya kihisabati katika utafiti ni representation theory ya symmetric group \(S_n\). Watafiti hutumia hasa decomposition ya module
\[ \mathbb{C}^{\binom{[n]}k} \]
katika irreducible components:
\[ S^{(n)} \oplus S^{(n-1,1)} \oplus S^{(n-2,2)} \oplus\cdots\oplus S^{(n-k,k)} \]
Inaonyeshwa kwamba kila irreducible component inatokea hapa kwa multiplicity 1.
Kwa uchambuzi wa state oracles, module changamano zaidi
\[ \mathbb{C}^{\binom{[n]}k}\otimes\mathbb{C}^{n} \]
inahitajika. Sehemu ndefu ya representation theory katika makala hujenga orthonormal bases na isotypical components zinazohitajika kubaini jinsi adversary matrix inavyotenda katika spaces hizi.
Figure 1 inaonyesha nini?
Figure pekee katika ukurasa wa 33 wa utafiti inaonyesha kwa schematic muundo wa image ya operator \(D_j\) ndani ya modules mbalimbali za
\[ \mathbb{C}^{\binom{[n]}\ell}\otimes\mathbb{C}^{n} \]
Columns zinahusiana na modules zinazobadilika kwa \(\ell=j-1,j,j+1,\ldots,k\). Maeneo ya njano yanawakilisha sehemu ya dimension nne \(A^\ell_j\) ya image ya jumla ya dimension sita inayohitajika katika utafiti.
Vectors za kwanza zilizowekewa fremu katika figure zinaonyesha starting point ya kila representation sequence, na arrows zinaonyesha kuhamishwa kwa representation component hiyo hiyo hadi thamani kubwa za \(k\) kupitia morphism \(W_{\ell\rightarrow k}\). Hii si experimental result; ni representation-theoretic diagram inayoeleza organization ya uthibitisho wa muundo mrefu wa algebra.
Matokeo yanayoungwa mkono na utafiti
- Katika regime ya \(n\geq5k\) na \(1/k\leq\varepsilon\leq1\), tight resource lower bounds zinaweza kujengwa kati ya membership, state-generating na reflecting oracle pamoja na nakala za hali ya quantum kwa tatizo la approximate counting lililochunguzwa.
- Membership oracle ikitumika pekee, query lower bound ni \(\Omega((1/\varepsilon)\sqrt{n/k})\).
- State-generating oracle inaweza kutoa faida hadi query scale ya \(k^{1/3}/\varepsilon^{2/3}\) katika baadhi ya maeneo ya vigezo.
- Kutumia state copies na oracle queries pamoja huunda resource trade-offs; kuongeza rasilimali moja kunaweza kupunguza nyingine lakini hakuondoi lower bounds zote.
- General adversary method inaweza kutumika kuchambua unitary input oracles nje ya standard membership oracle pamoja na oracle resources nyingi.
- Representation theory ya symmetric group hurahisisha kwa kiasi kikubwa adversary optimization kwa kutumia symmetry ya tatizo la approximate counting.
- Lower bounds za utafiti, isipokuwa exception moja iliyotajwa, zinalingana hadi constant factors na algorithms katika Appendix A.
Matokeo ambayo utafiti hauungi mkono au haujapima
- Utafiti haufanyi experiment kwenye real quantum hardware.
- Haupimi runtime ya quantum processor maalum katika sekunde.
- Hauonyeshi kwamba oracle calls ni sawa moja kwa moja na idadi ya physical gates, error-correction cost au energy consumption.
- Matokeo hayajathibitishwa kwa muundo mmoja kwa thamani zote zinazowezekana za \(n,k,\varepsilon\); theorem kuu hutumia wazi assumptions \(n\geq5k\) na \(1/k\leq\varepsilon\leq1\).
- Theoretical query advantage haimaanishi moja kwa moja quantum speedup au commercial advantage katika kiwango cha utekelezaji.
- Utafiti hautatui time na space complexity ya approximate counting katika modeli zote za quantum computing; kipimo kikuu kinachochunguzwa ni complexity ya query resources.
Ni tatizo gani linalobaki wazi kwa utafiti wa baadaye?
Waandishi wanataja hasa resource trade-offs katika tatizo la k-fold search kama mwelekeo wazi. Katika tatizo hili ukubwa wa seti \(x\) unajulikana kuwa \(k\), na kazi si kukadiria ukubwa tu bali kutoa seti yote.
Inaelezwa kwamba additive adversary technique iliyotumiwa katika utafiti haifai kuzalisha better-than-linear dependencies katika success probabilities ndogo. Kwa hiyo, jinsi ya kuunganisha mawazo ya multiplicative adversary na general oracle approach inabaki kuwa swali wazi la kiufundi.
Umuhimu wake wa kisayansi kwa Türkiye ni upi?
Utafiti hauna data, taasisi, quantum hardware au matokeo ya matumizi maalum kwa Türkiye. Kwa mtazamo wa Türkiye, maana yake si utabiri wa moja kwa moja wa utendaji wa ndani; ni kutoa framework ya kimsingi ya nadharia inayoweza kutumiwa katika utafiti wa quantum algorithms, computational complexity na mathematical quantum information. Inaweza kutumika kama chanzo kwa kazi za kinadharia katika vyuo vikuu na vikundi vya utafiti kuhusu quantum query complexity, oracle models au adversary methods.
Mbinu na Matokeo ya Utafiti
Muundo wa utafiti
Utafiti huu si wa majaribio, bali ni kazi ya mathematical-theoretical quantum computing. Lengo kuu ni kuthibitisha gharama ya asymptotic inayolazimika kwa quantum access resources tofauti katika decision problem iliyobainishwa.
Input domain hugawanywa katika classes mbili:
- \(X\): bit strings/seti zote zenye Hamming weight \(k\),
- \(Y\): bit strings/seti zote zenye Hamming weight \(k'=(1+\varepsilon)k\).
Kazi ya algoriti ni kubaini kwa bounded error probability kama input iko katika \(X\) au \(Y\).
Vigezo vya rasilimali
| Alama | Rasilimali | Maana |
|---|---|---|
| \(\ell\) | Nakala za \(|\psi_x\rangle\) | Idadi ya nakala za hali ya quantum zinazotolewa kwa algoriti mwanzoni |
| \(q_M\) | Membership oracle | Kiasi cha queries zinazofanywa kwa membership oracle |
| \(q_G\) | State-generating oracle | Kiasi cha matumizi ya resource ya transformation \(|0\rangle\leftrightarrow|\psi_x\rangle\) |
| \(q_R\) | Reflecting oracle | Kiasi cha matumizi ya oracle inayofanya reflection kuzunguka \(|\psi_x\rangle\) |
Multi-oracle query complexity inafafanuliwaje?
Watafiti huunganisha oracle zote kihisabati katika direct-sum oracle moja. Lakini badala ya kuhesabu tu total number of queries, kiasi cha quantum amplitude ambacho algoriti inabeba katika kila oracle component hufuatiliwa kando.
Kwa oracle ya \(i\), query complexity kwenye input \(x\) inafafanuliwa kama
\[ L_x^{(i)} = \sum_t \left\| \psi^{(i)}_{t,x} \right\|^2 \]
Hivyo modeli zinazonyumbulika zaidi, ambapo quantum algorithm huchagua oracle kwa intermediate measurements au katika superposition, pia zinaweza kuingizwa katika lower-bound analysis.
Muundo maalum wa adversary matrix
Baada ya kutumia permutation symmetry, adversary matrix huandikwa kama
\[ \Gamma= \sum_{j=0}^{k}\gamma_j\Phi_j \]
na kwa uthibitisho mkuu wa lower bound huchaguliwa
\[ \gamma_j= \max\left\{ 1-\frac{j}{t},0 \right\} \]
Kwa uchaguzi huu \(\|\Gamma\|=1\), na kwa \(j\geq t\) coefficients huwa sifuri.
Athari ya initial state inahesabiwaje?
Algoriti ikipewa nakala \(\ell\) za \(|\psi_x\rangle\), initial states za inputs tofauti si sawa. Kwa hiyo, tofauti na classical adversary problem, initial Gram matrix pia huingia katika uchambuzi.
Makala inafafanua matrix
\[ \Psi[[x,y]] = \langle\psi_x|\psi_y\rangle \]
Ikiwa kuna nakala \(\ell\), Gram matrix ya initial states ni
\[ \Xi=\Psi^{\circ\ell} \]
ambapo \(\circ\) inawakilisha Hadamard, yaani element-wise product.
Hili ni jambo muhimu: nakala za hali ya quantum zinazotolewa bila query zinampa algoriti taarifa kuhusu input kabla haijafanya query yoyote. Uthibitisho wa lower bound lazima uhesabu wazi taarifa hii ya mwanzo.
Norm estimate iliyopatikana kwa state-generating oracle
Kwa uchaguzi maalum wa adversary matrix, waandishi wanaweka kikomo kwa matrix norms zinazohusiana na state-generating oracle katika kiwango cha
\[ O\!\left( \varepsilon\sqrt{\frac{k}{n}} + \varepsilon\sqrt{\frac{t}{k}} + \frac{1}{t} \right) \]
Terms hizi tatu hubeba, mtawalia, athari za precision ya tatizo pamoja na uwiano \(n/k\), adversary cutoff parameter \(t\), na finite slope ya gradient.
Norm estimate iliyopatikana kwa reflecting oracle
Kwa reflecting oracle, adversary norm inayohusika inawekewa kikomo cha
\[ O\!\left( \frac{1}{t}+\varepsilon \right) \left( \sqrt{\frac{k}{n}} + \sqrt{\frac{t}{k}} \right) \]
Estimate hii inaruhusu choices tofauti za \(t\) kuzalisha regimes tofauti za reflecting-oracle lower bound.
Membership oracle estimate
Norm estimate kuu inayopatikana kwa membership oracle ni
\[ \|\Gamma\circ\Delta_i\| = O\!\left( \frac{1}{t}+\varepsilon \right) \sqrt{\frac{k}{n}} \]
Expression hii ikiwekwa kwenye general adversary lower bound, inachangia kurejesha kiwango cha kawaida cha \((1/\varepsilon)\sqrt{n/k}\).
Masharti ya vigezo katika theorem kuu
Waandishi hutumia wazi assumptions
\[ n\geq5k \]
na
\[ \frac{1}{k}\leq\varepsilon\leq1 \]
kwa matokeo makuu. Zaidi ya hapo, katika hatua fulani za uthibitisho kwa adversary parameter \(t\) hutumika sharti
\[ 2\ell\leq t\leq\frac{k}{5} \]
Sharti hili hutumika.
Kwa hiyo si sahihi kusoma matokeo katika jedwali za chanzo kama universal equalities zisizotegemea assumptions hizi.
Muhtasari wa kiufundi wa upper-bound algorithms
| Zana ya kialgoriti | Lengo la matumizi | Kiwango kilichopatikana katika chanzo |
|---|---|---|
| Coupon collector | Kuona elementi tofauti za kutosha kutoka katika seti | \(O(k\log k)\) samples kwa complete distinct-element threshold |
| Kuhesabu sample collisions | Kutofautisha \(k\) na \((1+\varepsilon)k\) | \(O(\sqrt{k}/\varepsilon)\) samples |
| Projection kwenye uniform state | Kukadiria probability \(|x|/n\) | \(O(n/(k\varepsilon^2))\) nakala |
| Amplitude estimation | Kukadiria ukubwa wa seti kwa multiplicative precision | Hubadilika kulingana na regime husika ya tatizo |
| Amplitude amplification / Grover search | Kupata elementi kutoka katika seti | \(O(\sqrt{n/k})\) oracle calls |
| Search kutoka subset inayojulikana mapema | Kutumia state-generating au reflecting resources kwa ufanisi zaidi | Hutoa upper-bound algorithms za resource trade-offs |
Lengo la algoriti hizi si kuwasilisha real hardware implementation, bali kuonyesha kwamba lower bounds katika theorem kuu zinaweza kufikiwa na kwa hiyo ni asymptotically tight.
Nguvu za utafiti
- Kupima kwa kujitegemea quantum access resources nyingi tofauti ndani ya lower-bound framework moja.
- Kufunika small-\(\varepsilon\) regime iliyobaki wazi katika approximate counting problems za awali.
- Kuweza kutofautisha kati ya state copies, reflecting oracle na state-generating oracle.
- Kurahisisha kwa mfumo general adversary problem kwa kutumia symmetry kupitia representation theory.
- Kutotoa lower bounds pekee, bali pia matching upper-bound algorithms.
- Kuonyesha matumizi ya adversary method kwa general unitary input oracles kwenye tatizo halisi.
Mapungufu ya utafiti
- Theorem kuu imeundwa kwa eneo la \(n\geq5k\) na \(1/k\leq\varepsilon\leq1\).
- Uchambuzi unalenga quantum query complexity; total gate complexity na physical runtime si kitu kimoja.
- Waandishi wanaeleza kuwa additive adversary approach inayotumiwa kwa small success probabilities ina mipaka.
- Kwa term ya kwanza \(k\) katika case ya state copies pekee, upper bound iliyotolewa ni \(O(k\log k)\), hivyo logarithmic gap inabaki.
- Makala haifanyi experimental quantum implementation au hardware validation.
Maelezo ya Chanzo na Mbinu
Jina kamili la kazi asilia: Tight Quantum Lower Bound for Approximate Counting with Quantum States
Waandishi: Aleksandrs Belovs; Ansis Rosmanis.
Mpangilio wa waandishi: Mpangilio uliotolewa katika chanzo umehifadhiwa bila kubadilishwa.
Equal contribution/co-first author: Haijaelezwa katika chanzo.
Corresponding author: Hakuna alama ya wazi ya corresponding-author katika hati iliyopakiwa.
Affiliations katika hati ya chanzo: Aleksandrs Belovs — Faculty of Computing, University of Latvia. Ansis Rosmanis — Graduate School of Mathematics, Nagoya University, Japan.
Aina ya chanzo kilichopakiwa: arXiv preprint version.
Version iliyopakiwa: arXiv:2002.06879v2 [quant-ph].
Tarehe ya kwanza ya preprint submission: 17 Februari 2020.
Tarehe ya v2 revision iliyopakiwa: 7 Mei 2024.
arXiv/DataCite DOI: 10.48550/arXiv.2002.06879.
Kiungo rasmi cha preprint: https://arxiv.org/abs/2002.06879
Leseni ya preprint: Ukurasa rasmi wa rekodi ya arXiv unaunganisha version hii na Creative Commons Attribution 4.0 International (CC BY 4.0).
Peer-review na published-version note: Faili iliyopakiwa ya 2002.06879v2 ni preprint na si yenyewe peer-reviewed journal version. Bibliographic verification imethibitisha kwamba kazi yenye jina hilo hilo na waandishi hao hao ilichapishwa baadaye katika jarida la peer-reviewed Computational Complexity.
Peer-reviewed journal version: Belovs, A.; Rosmanis, A. Tight Quantum Lower Bound for Approximate Counting with Quantum States. Computational Complexity, 35, Article 2 (2026).
DOI ya peer-reviewed version: 10.1007/s00037-025-00282-7.
Mchapishaji wa peer-reviewed version: Springer Nature / Springer International Publishing.
Kiungo rasmi cha peer-reviewed version: https://doi.org/10.1007/s00037-025-00282-7
Chanzo cha maudhui ya kisayansi: Problem definition, theorems, formulas, algorithms, representation-theory explanations, lower na upper bounds pamoja na methodological limitations katika makala hii ya Verianla zinategemea hati iliyopakiwa ya arXiv:2002.06879v2. Rekodi ya jarida ya 2026 imetumiwa tu kuthibitisha bibliographic status; hakuna matokeo mapya ya kisayansi kutoka nje yaliyoingizwa katika main text.
Ufadhili: Sehemu ya shukrani ya chanzo inasema kwamba A.B. aliungwa mkono ndani ya Latvian Quantum Initiative na mradi wa European Union Recovery and Resilience Facility no. 2.3.1.1.i.0/1/22/I/CFLA/001; sehemu ya kazi iliungwa mkono na ERDF project no. 1.1.1.2/I/16/113. Kwa A.R., msaada wa JSPS KAKENHI JP20H05966, MEXT Q-LEAP JPMXS0120319794, na kwa vipindi vya awali JP19F19079 pamoja na Centre for Quantum Technologies/National University of Singapore umeripotiwa.
Upatikanaji wa data: Hakuna data-availability statement tofauti katika chanzo. Utafiti si wa experimental dataset; ni mathematical-theoretical query-complexity study.
Conflict of interest: Hakuna conflict-of-interest statement tofauti iliyobainishwa katika chanzo kilichopakiwa.
Michango ya waandishi: Hakuna CRediT au detailed author-contributions statement katika chanzo kilichopakiwa.
Mbinu kuu: General adversary method iliyopanuliwa kwa multiple unitary input oracles, representation theory ya symmetric group \(S_n\), na matching upper-bound quantum algorithms.
Kikomo kikuu cha kimethodolojia: Matokeo yanahusu query complexity. Haipaswi kuhitimishwa kwamba oracle calls ni sawa moja kwa moja na physical operation time, error-correction overhead, qubit count au total circuit complexity katika real quantum hardware.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *