

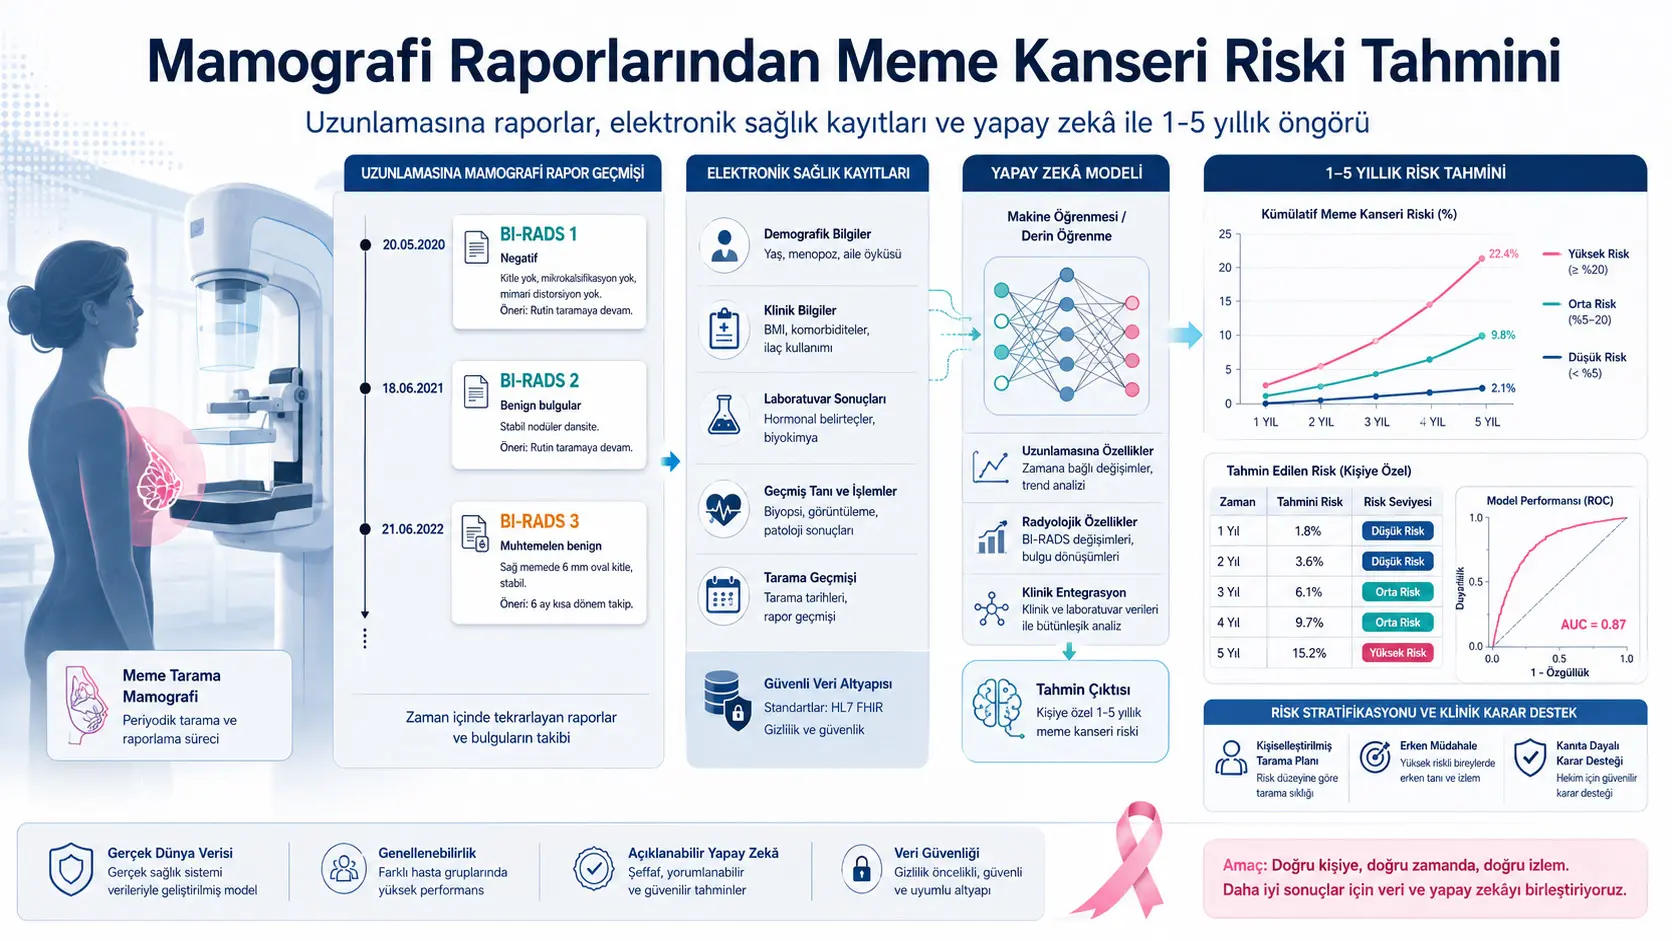
Watu wanaopata matokeo ya BI-RADS 1, 2 au 3 katika mammography screening kwa kawaida huchukuliwa kuwa negative kwa saratani katika uchunguzi wa sasa au kuwa na findings zinazokadiriwa kwa kiasi kikubwa kuwa benign. Hata hivyo, watu walio katika BI-RADS class ileile hawana future breast-cancer risk sawa. Screening systems za sasa mara nyingi hutumia follow-up intervals zinazofanana kwa msingi wa age na current mammography class; contribution ya clinical signals zinazokusanyika katika previous reports kwa future risk haikokotolewi kwa utaratibu katika routine practice.
Utafiti huu ulitengeneza modeli inayotabiri risk ya breast cancer ndani ya mwaka mmoja hadi miaka mitano bila kufikia raw mammography images, kwa kutumia tu past na current radiology-report text pamoja na structured information katika electronic health records.
Data zilitoka zaidi ya hospitali na clinics 200 za Hapvida, ambayo waandishi wanaieleza kuwa private health system kubwa zaidi Brazil. Kati ya Januari 2016 na Desemba 2025, takriban mammography reports milioni 4,61 zilizoainishwa BI-RADS 1, 2 au 3 na watu milioni 1,81 ziliunda initial data pool.
Kwa five-year risk analysis, criteria za age, previous cancer status, early cancer confirmation na adequate follow-up zilitumika. Main text na patient-flow diagram zinaripoti kwamba five-year cohort ilikuwa na eligible mammography examinations 706.545 kutoka watu 278.475, na 9.620 kati ya examinations hizo zilihusishwa na positive outcome ndani ya miaka mitano. Hii ni event frequency ya takriban %1,36 katika examination level.
Hata hivyo, kuna numerical internal inconsistency katika reporting ya study. Table 1 inatoa total five-year examination count ya 706.910. Jumla ya BI-RADS 1, 2 na 3 counts katika table hiyo pia ni 706.910. Lakini main text na Figure 2 hutumia 706.545. Aidha, jumla ya reported training examinations 566.698 na test examinations 142.517 ni 709.215 na hailingani na total yoyote kati ya hizo mbili. Tofauti hizi zinahitaji kufafanuliwa katika final version.
Model inputs zilikuwa katika blocks mbili kuu. Block ya kwanza ilikuwa na structured clinical information kama age, age at menarche na menopause, nulliparity, number of miscarriages, family history ya breast au ovarian cancer, breastfeeding, body mass index, BI-RADS class, insurance payment na geographic postal code.
Block ya pili ilikuwa na text za radiology reports kabla ya index mammogram zikiwa zimepangwa chronologically, pamoja na time intervals kati ya examinations. Report texts zilibadilishwa kuwa numerical vectors kwa TF-IDF, na previous reports ziliunganishwa kwa average au time-weighted aggregation inayoweka weight kubwa zaidi kwa examinations za karibuni.
Kwa five-year prediction, AUROC katika test set ilikuwa 0,863 na %95 confidence interval 0,853-0,871. Katika one-to-four-year models, AUROC values zilikuwa kati ya 0,82 na 0,85. Concordance index iliyotathmini pamoja five-year follow-up ilikuwa 0,859.
AUROC 0,86 ina maana kwamba ukilinganisha examination moja iliyochaguliwa kwa nasibu ambayo baadaye itapata cancer na examination moja isiyopata cancer, probability ya modeli kutoa higher risk score kwa examination itakayopata cancer ni takriban %86. Hii haimaanishi kwamba modeli “inajua cancer kwa accuracy ya %86” kwa mtu mmoja.
Modeli ilipoflag highest-risk %3,4 ya examinations pekee, ilikamata %50,1 ya positive examinations ambazo zingehusishwa na cancer ndani ya miaka mitano. Katika operating point hii, specificity ilikuwa %97,3 na positive predictive value takriban %25,1. Kwa maneno mengine, takriban examination moja kati ya nne zilizoflagiwa high risk ilihusishwa na positive outcome ya miaka mitano; lakini hii haimaanishi kwamba mtu ana cancer mara moja au anahitaji biopsy.
Low-risk analysis pia ni muhimu. Lowest-risk %25 ya examinations ilipochaguliwa kuwa low-risk group, %5 ya five-year cancer events zote zilibaki katika group hiyo. Lowest-risk %47 ilipochaguliwa, %10 ya positive events zote zilibaki katika group hiyo. Tafsiri sahihi si “%10 ya watu katika low-risk group walipata cancer”.
Kauli ya abstract kwamba “katika lowest %47 group cancer ilitokea kwa %10 pekee” inapotosha. Kulingana na Figure 4 na Results, %10 ni false-negative rate inayoonyesha ni sehemu gani ya cancer events zote iliyobaki katika low-risk group. Takriban %99,6 ya examinations za low-risk group zilibaki negative kwa miaka mitano; kwa hiyo within-group positivity ilikuwa takriban %0,4.
Modeli pia ilionyesha risk heterogeneity kubwa ndani ya BI-RADS classes zenyewe. Risk scores za examinations katika BI-RADS 1, 2 na 3 ambazo baadaye zilipata cancer zilikuwa na distribution pana. Hii inaonyesha kwamba BI-RADS class ya mammogram moja haielezi future risk yote na kwamba past reports pamoja na clinical features zinaweza kubeba taarifa ya ziada.
Katika explainability analysis, report expressions zilizoathiri high-risk predictions zaidi zilijumuisha previous breast surgery, mastectomy, calcifications na architectural distortions. Katika low-risk predictions, symmetric appearance ya breasts, kutokuwepo suspicious findings katika contralateral breast au axillary lymph nodes na reassuring radiological language zilijitokeza.
Katika structured variables, family history na reproductive history zilichangia zaidi high-risk predictions. Socioeconomic indicators kama insurance-payment level na geographic region zilijitokeza katika baadhi ya correct-negative predictions. Finding hii inahitaji tahadhari; economic na geographic variables zinaweza kuakisi access to care, follow-up pattern au data-recording practice badala ya biological risk.
Model calibration iliboreshwa kwa beta calibration na isotonic regression. Katika methods zote mbili Brier score ilikuwa takriban 0,014, dhidi ya 0,093 katika uncalibrated model. Kulikuwa na slight overconfidence katika highest-risk predictions. Kwa sababu event prevalence ni ndogo, Brier score inapaswa kutafsiriwa pamoja na prevalence; utafiti haukutoa Brier score ya simple baseline model inayotabiri prevalence pekee.
Utafiti haukuonyesha kwamba model use katika real clinical practice huongeza early detection, hupunguza deaths au hupunguza screening costs. Model haikufanyiwa prospective deployment ili kubadilisha maamuzi ya healthcare workers, high-risk group haikupewa additional MRI au biopsy, na screening interval ya low-risk group haikuongezwa kweli hadi miaka miwili.
Kwa hiyo matokeo yanaonyesha strong technical possibility kwa personalized screening, lakini bado si screening guideline. Kama waandishi wanavyosema, kabla ya clinical policy kubadilishwa, prospective validation, cost-effectiveness analysis, false-positive burden ya biopsy na anxiety, risk ya delayed diagnosis na external validation katika health systems tofauti zinahitajika.
Tatizo kuu la utafiti ni nini?
Katika traditional breast-cancer screening programs, factors chache kama age, family history na current mammography result hutumika. Katika health systems nyingi, watu wa age group fulani hupendekezwa mammography kila mwaka au kila miaka miwili.
Mbinu hii ni practical katika population level, lakini true risk ya watu wawili wenye age sawa na BI-RADS class sawa inaweza kutofautiana sana. Kwa mfano, watu wawili wanaweza wote kuwa BI-RADS 2, lakini mmoja akawa na recurrent calcifications, architectural distortion na surgical history katika past reports, huku mwingine akiwa na stable, symmetric, benign findings kwa miaka mingi.
Swali kuu la utafiti ni:
Ikiwa history nzima ya past mammography reports na routine electronic health records ya mtu itatathminiwa pamoja, je, future breast-cancer risk ndani ya mwaka mmoja hadi miaka mitano inaweza kutenganishwa vizuri zaidi hata kama current exam ni negative au probably benign?
BI-RADS 1, 2 na 3 zinamaanisha nini?
| BI-RADS class | Maana ya jumla ya kliniki | Jukumu katika utafiti |
|---|---|---|
| BI-RADS 1 | Negative examination; hakuna suspicious finding | Moja ya makundi makuu yanayotabiriwa future cancer risk |
| BI-RADS 2 | Benign findings | Current cancer suspicion ni ndogo, lakini long-term risk inaweza kuwa heterogeneous |
| BI-RADS 3 | Probably benign finding; kwa kawaida short-interval follow-up | Kundi la tatu ambamo modeli hutafuta finer risk difference |
Modeli haikutengenezwa kutathmini current-cancer probability kwa watu wenye BI-RADS 4, 5 au 6. Lengo ni kutenganisha future risk miongoni mwa watu ambao current study yao ni negative au probably benign.
Je, modeli inatabiri cancer iliyopo katika current mammogram au future cancer?
Utafiti unalenga future cancer risk. Examinations ambazo malignancy ilithibitishwa ndani ya first 90 days baada ya index mammogram ziliondolewa. Hii ililenga kuzuia cancer iliyokuwepo tayari katika current study au iliyogunduliwa mara moja baadaye kupewa label ya “future risk”.
Primary outcome ilikuwa breast-cancer indicator iliyotokea kuanzia siku 90 baada ya index mammogram hadi mwisho wa prediction horizon iliyochaguliwa.
Positive outcome ilifafanuliwa kwa mojawapo ya njia hizi:
- BI-RADS 6 classification,
- Malignant biopsy result,
- BI-RADS 5 classification, ikiwa haikukanushwa na negative au benign study ndani ya miezi sita inayofuata.
Outcome definition hii haijumuishi histopathologically confirmed cancers pekee. BI-RADS 5 na 6 codes pia huchangia outcome label na zinaweza kuleta misclassification. Watafiti walifanya sensitivity analyses kwa kubadilisha time windows na hawakuripoti mabadiliko makubwa katika model performance.
Adequate follow-up iliamuliwaje?
Ili examination ipewe negative label katika prediction horizon fulani, mgonjwa alipaswa kuwa observable katika mfumo kwa muda huo. Follow-up iligawanywa katika annual intervals na ilihitajika kuwepo angalau mammography au biopsy record mwishoni mwa target period au baadaye.
Kwa mfano, katika five-year analysis, mtu alipaswa kuwa na mammography au biopsy record katika mwaka wa tano au baadaye. Examinations zisizo na sufficient follow-up ziliondolewa kutoka five-year analysis lakini zingeweza kubaki katika one- au two-year analyses ikiwa zilifikia shorter follow-up criterion.
Mbinu hii inalenga kupunguza false-negative labels. Lakini pia huchagua watu wenye regular follow-up na wanaobaki katika private health system ileile. Watu wanaoondoka kwenye mfumo, wanaogunduliwa kwingine au wasiopata mammography kwa muda mrefu wanaweza kuondolewa.
Kwa hiyo model performance ilipimwa katika private-health-system users wenye regular documented follow-up. Haijaonyeshwa kwamba performance itahamia kwa namna ileile katika fragmented-record health systems.
Five-year cohort iliundwaje?
| Hatua | Idadi iliyoripotiwa | Maelezo |
|---|---|---|
| Initial mammography reports | 4.609.295 | BI-RADS 1, 2 au 3 reports |
| Initial persons | 1.810.345 | Total persons katika 2016-2025 |
| Five-year eligible persons | 278.475 | Waliofikia age, early-cancer exclusion na follow-up criteria |
| Five-year eligible examinations | Main text na Figure 2: 706.545 | Table 1: 706.910 |
| Negative-outcome examinations | 696.925 | Waliofuatiliwa bila positive outcome katika miaka mitano |
| Positive-outcome examinations | 9.620 | Examination-level %1,36 event frequency |
| First indication via BI-RADS 5 or 6 | 8.517 | Huenda ilithibitishwa baadaye kwa biopsy |
| Malignant biopsy as first positive signal | 1.103 | Wasiokuwa na BI-RADS 5 au 6 kabla yake |
Analysis ilifanyika person level au mammography level?
Mtu mmoja anaweza kuwa na eligible mammograms zaidi ya moja katika kipindi cha utafiti. Kila eligible mammogram ilitathminiwa kama index examination tofauti na risk prediction tofauti kwa kutumia taarifa iliyopatikana katika tarehe hiyo.
Mtu mmoja hakugawanywa kati ya training na test sets. Data split ilifanywa katika person level na examinations zote za mtu huyo zilibaki katika set moja. Hii ni strength muhimu ya kupunguza training-test data leakage.
Hata hivyo, unit ya performance metrics kwa kiasi kikubwa ni mammography examination. Mtu mmoja anaweza kuwakilishwa na index examinations kadhaa katika test set. Kwa hiyo “highest-risk %3,4” haimaanishi moja kwa moja %3,4 ya unique persons.
Examinations za mtu mmoja si independent. Main text haielezi kwa undani jinsi dependence hii ilivyoshughulikiwa katika confidence intervals.
Structured data zilizotumika
| Kundi la variables | Mifano |
|---|---|
| Demography | Age |
| Reproductive history | Age at menarche, age at menopause, nulliparity, number of miscarriages, breastfeeding history |
| Family history | Family breast or ovarian cancer |
| Current radiologic class | BI-RADS class ya index mammogram |
| Body measure | Body mass index |
| Socioeconomic indicators | Monthly insurance payment |
| Geographic context | First three digits of Brazilian postal code |
Insurance payment na postal code si biological breast-cancer markers moja kwa moja. Zinaweza kuwakilisha access to care, income, regional health infrastructure, follow-up frequency na record quality.
Longitudinal mammography reports zilitumikaje?
Kila mtu aliwakilishwa na sequence ya mammography reports kabla ya index examination iliyopangwa chronologically. Kila past record ilikuwa na:
- Free-text radiology report,
- Related BI-RADS class,
- Time interval to previous mammogram.
Modeli haikutazama last report pekee; ilijaribu kufupisha radiologic expressions zilizoonekana, kutoweka au kurudiwa katika past reports.
Mbinu hii inaweza kukamata taarifa kama:
- Calcification phrases zinazojirudia kwa miaka,
- Kama architectural distortion ni mpya au persistent,
- Previous surgical changes,
- Kuongezeka au kupungua kwa interval between examinations,
- Trajectory ya BI-RADS classes kwa muda.
TF-IDF ilifanya nini?
Radiology reports hazikuingizwa moja kwa moja katika neural network kama raw sentences. Text zilibadilishwa kuwa numerical vectors kwa TF-IDF, inayopima umuhimu wa words na word pairs katika report.
Mantiki ya msingi ya method inaweza kuonyeshwa kama:
\[ TF\text{-}IDF(t,d)=TF(t,d)\times\log\left(\frac{N}{DF(t)}\right) \]
Hapa:
- t ni word au term fulani,
- d ni radiology report inayochunguzwa,
- TF(t,d) ni frequency ya term katika report hiyo,
- DF(t) ni number of reports ambamo term inaonekana,
- N ni total number of reports.
Maneno kama “breast” au “mammography” yanayoonekana karibu kila report hupata low discriminative weight, huku “architectural distortion” au specific surgical phrases yakipata weight kubwa zaidi ya kutenganisha.
Faida ya TF-IDF ni kwamba inaweza kuonyesha words au word pairs ambazo modeli imezipa umuhimu. Hata hivyo, haiwakilishi context ya words kwa kina kama modern language models. Negation, uncertainty, report templates na institution-specific writing styles zinaweza kuathiri model performance.
Muda wa past reports uliingizwa vipi?
Model architecture ilikuwa na interchangeable aggregation module inayobadilisha past reports kuwa patient vector moja. Simple average na time-weighted average zinazoweka importance kubwa kwa recent examinations zilichunguzwa.
Mantiki ya exponential time weighting inaweza kuonyeshwa kama:
\[ w_i=\frac{e^{-\lambda\Delta t_i}}{\sum_j e^{-\lambda\Delta t_j}} \]
Hapa:
- Δti ni muda kati ya past report na index examination,
- λ ni parameter inayodhibiti jinsi weight ya old reports inavyopungua kwa kasi,
- wi ni weight ya past report katika aggregate summary.
Formula hii imewekwa kueleza time-weighted approach. Exact parameters na best aggregation option hazikuripotiwa kwa undani katika main PDF, bali zilielekezwa kwenye supplementary material.
Inconsistency muhimu katika maelezo ya model architecture
Study-design section inasema separate model ilifunzwa kwa kila prediction horizon. Lakini model-architecture section na Figure 1 zinaonyesha dense neural network moja inayotoa probabilities za mwaka mmoja, miwili, mitatu, minne na mitano kwa wakati mmoja.
Maelezo haya mawili yanaelezea model setups tofauti:
- Independent model kwa kila time horizon,
- Multi-output single model inayotabiri time points tano kwa wakati mmoja.
Inahitaji kufafanuliwa ni setup ipi ilitumika katika final implementation. Tofauti hii ni muhimu kwa model architecture, loss function na information sharing kati ya time horizons.
Modeli ilifunzwaje na kujaribiwa?
- Data ziligawanywa katika training na test sets katika person level.
- Mtu mmoja hakuingia katika main sets mbili tofauti.
- Five-fold cross-validation ilitumika ndani ya training data.
- Hyperparameters zilichaguliwa kulingana na validation performance.
- Final metrics zilikokotolewa katika held-out test set.
- Uncertainty ilitolewa kwa resampling-based confidence intervals.
Mbinu hii ni internal validation inayotegemea random patient split. Hakukuwa na temporal validation kwa patients wa years za baadaye au independent external validation katika health system nyingine.
Matokeo ya AUROC
| Prediction horizon | Overall AUROC | %95 confidence interval |
|---|---|---|
| Mwaka 1 | 0,84 | 0,82-0,85 |
| Miaka 2 | 0,85 | 0,83-0,86 |
| Miaka 3 | 0,82 | 0,80-0,83 |
| Miaka 4 | 0,83 | 0,81-0,83 |
| Miaka 5 | 0,86 | 0,85-0,87 |
Utendaji wa five-year model kuwa juu zaidi unaweza kuonekana wa kushangaza kwa sababu utabiri wa future ya mbali kwa kawaida unaweza kuwa mgumu zaidi. Waandishi wanahusisha hili na kuwepo kwa cancer events nyingi zaidi katika five-year cohort na training setups tofauti kwa time horizons.
AUROC inaonyesha nini na haionyeshi nini?
AUROC hupima jinsi modeli inavyorank positive na negative examinations. Tafsiri ya kawaida ni:
\[ AUROC=P(Risk_{pozitif}>Risk_{negatif}) \]
Five-year AUROC=0,863 ina maana kwamba probability ya kutoa higher risk score kwa randomly selected positive examination kuliko randomly selected negative examination ni takriban %86,3.
AUROC:
- Haionyeshi exact cancer probability ya mtu.
- Peke yake haithibitishi kwamba predicted percentage imecalibrate kwa usahihi.
- Haijumuishi clinical cost ya false positives au false negatives.
- Haionyeshi kwamba kutumia modeli hupunguza mortality.
Concordance index
Wakati all follow-up times hadi miaka mitano zilitathminiwa pamoja, C-index ilikuwa 0,859. Concordance index hutathmini kama examination itakayopata cancer mapema imepewa higher risk.
Hata hivyo, main modeling inaelezwa kama binary time-horizon predictions. Main text ina maelezo machache kuhusu risk score na censoring approach iliyotumika kuhesabu C-index.
Kwa nini calibration ni muhimu?
Modeli mbili zinaweza kurank wagonjwa kwa discrimination inayofanana, lakini moja ikatabiri risk kubwa kupita kiasi kwa kila mtu. Katika clinical decisions, si ranking pekee bali pia swali “five-year risk ya mtu huyu ni karibu asilimia ngapi?” ni muhimu.
Utafiti ulitathmini calibration methods tatu:
- Platt scaling,
- Beta calibration,
- Isotonic regression.
Platt scaling ilibana probabilities katika range nyembamba chini ya severe class imbalance. Beta na isotonic calibration zilitoa matokeo yanayofaa zaidi.
| Calibration approach | Brier score katika Figure 3 | Tafsiri |
|---|---|---|
| Uncalibrated model | 0,093 | Mismatch kubwa zaidi na observed risk |
| Beta calibration | 0,014 | Predictions karibu zaidi na observed rates |
| Isotonic regression | 0,014 | Matokeo sawa na beta calibration |
Katika highest-risk range, calibrated models zote mbili zilitabiri risk juu kidogo. Sample ndogo na event rarity katika eneo hili huongeza uncertainty.
Kwa kuwa five-year cancer prevalence ni ndogo, Brier score inaweza kuwa ndogo kwa asili. Utafiti haukutoa Brier comparison na simple reference model inayowapa wote overall prevalence. Kwa hiyo 0,014 peke yake haithibitishi clinical adequacy ya calibration.
Highest-risk %3,4 group
| Measure | Result | Maana |
|---|---|---|
| Examinations flagged high risk | Highest %3,4 | Sehemu ndogo ya test examinations inatengwa kwa additional evaluation |
| Sensitivity | %50,1 | Takriban nusu ya five-year positive examinations inakamatwa |
| Specificity | %97,3 | Negative examinations nyingi haziflagiwi high risk |
| Positive predictive value | %25,1 | Takriban examination moja kati ya nne zilizoflagiwa huwa positive ndani ya miaka mitano |
Threshold hii si validated clinical threshold ya biopsy au MRI. Waandishi wanajadili kwamba high-risk persons wanaweza kupewa priority kwa re-evaluation, shorter follow-up au additional imaging; lakini strategies hizi hazikutekelezwa katika study.
Takriban robo tatu ya high-risk flagged examinations hazikuwa na positive outcome ndani ya miaka mitano. Additional biopsy au imaging kwa watu hawa inaweza kuleta false positives, anxiety, cost na unnecessary procedures.
Low-risk %25 na %47 zinapaswa kutafsiriwaje?
| Sehemu iliyochaguliwa kuwa low risk | Sehemu ya positives zote iliyobaki katika group | Negative predictive value |
|---|---|---|
| Lowest-risk %25 | %5,0; 123 kati ya positives 2.468 | Takriban %99,6 |
| Lowest-risk %47 | %10,0; 247 kati ya positives 2.468 | Takriban %99,6 |
False-negative rate huonyesha ni sehemu gani ya positive cases zote ilipelekwa low-risk group. Si cancer rate ndani ya group yenyewe.
Modeli inatoa policy scenario ya kuongeza screening interval kwa low-risk persons hadi miaka miwili. Lakini scenario hii haikutekelezwa wala kujaribiwa. Stage shift, interval cancer, mortality, quality of life au cost outcome zinazoweza kutokana na delayed screening hazikupimwa.
Hidden risk variation ndani ya BI-RADS classes
Figure 4 inaonyesha distributions pana na overlapping za model risk scores katika future-positive BI-RADS 1, 2 na 3 examinations.
Matokeo haya yanaonyesha mambo mawili muhimu:
- BI-RADS 3 kwa ujumla inaweza kuwa na risk kubwa zaidi lakini BI-RADS 3 examinations zote si sawa.
- Baadhi ya BI-RADS 1 au 2 examinations zinaweza kupata high long-term risk score kwa sababu ya past reports na clinical features.
Modeli haikusanifiwa kuchukua nafasi ya BI-RADS bali kuongeza long-term risk layer juu ya BI-RADS class.
Performance kwa age groups
| Age group | 5-year AUROC | %95 confidence interval | Prevalence iliyoripotiwa katika text |
|---|---|---|---|
| 18-39 | 0,81 | 0,79-0,83 | %1,1 |
| 40-49 | 0,85 | 0,84-0,87 | %1,8 |
| 50-74 au 50-75 | 0,87 | 0,86-0,89 | %2,4 |
Table 2 inafafanua upper age group kuwa 50-74, lakini results text inatumia 50-75. Overall eligibility criterion ni 18-75. Hii ni reporting difference ndogo lakini inayohitaji kurekebishwa.
Pia ni muhimu kwa nini watu wa 18-39 walipata mammography. Watu wanaofanyiwa mammography katika umri huu wanaweza kuwa na risk features tofauti na general young population. Kwa hiyo performance haiwezi ku-generalize kwa watu wote wa 18-39.
Performance kwa regions
| Region | 5-year AUROC | %95 confidence interval |
|---|---|---|
| North | 0,81 | 0,76-0,87 |
| Northeast | 0,85 | 0,83-0,86 |
| Central-West | 0,74 | 0,65-0,85 |
| Southeast | 0,88 | 0,86-0,90 |
| South | 0,74 | 0,58-0,90 |
Modeli ilionyesha discrimination juu ya chance katika regions zote. Lakini %70,4 ya five-year eligible examinations zilitoka Northeast. Samples za South na Central-West zilikuwa ndogo zaidi na confidence intervals pana.
Katika Table 1, counts za regions tano hazifiki total examination count; examinations zenye missing regional information ziliondolewa kutoka subgroup analysis. Kwa hiyo kauli “strong generalization across all regions” inapaswa kutumiwa kwa tahadhari hasa katika underrepresented regions.
Integrated gradients kwa explainability
Kwa kutathmini features zinazochangia model decisions, integrated gradients zilitumika.
Mantiki ya msingi ya kihisabati ni:
\[ IG_i(x)=(x_i-x_i')\int_0^1\frac{\partial F(x'+\alpha(x-x'))}{\partial x_i}\,d\alpha \]
Hapa:
- x ni actual examination input,
- x′ ni baseline input ya comparison,
- F ni model risk output,
- IGi ni contribution ya feature i kwa prediction.
Kwa text features, baseline ilikuwa zero vector isiyo na information; kwa structured features ilikuwa standardized population mean.
Method inaonyesha direction na magnitude ya jinsi feature inavyobadilisha model risk prediction. Haithibitishi kwamba feature hiyo inasababisha cancer katika real world.
Text block au structured data zilikuwa na athari kubwa?
Katika Figure 5, total contribution ya radiology-report texts ilikuwa generally kubwa kuliko structured features. Hata hivyo, text block ina maelfu ya words na word pairs, wakati structured block ina variables chache zaidi.
Kwa hiyo higher total contribution inaweza kutokana kwa sehemu na dimension kubwa ya text block. Watafiti wanakubali wazi limitation hii.
Negative predictions zilitegemea strong reassuring expressions chache zaidi, wakati positive predictions ziliundwa na combined contribution ya report vocabulary pana.
Expressions zinazojitokeza katika high-risk predictions
- Breast surgery,
- Right mastectomy,
- Ductal extension,
- Vascular dilatation,
- Calcifications,
- Spiculated au suspicious findings,
- Architectural distortion,
- Microcalcifications,
- Expressions zinazoashiria breast tumor au mass.
Terms hizi kuhusishwa na high risk zinaweza kuonekana clinically plausible. Lakini explainability analysis pia ilionyesha kwamba baadhi ya surgical au implant histories ambazo hazikuwepo katika structured records ziliingia kwenye modeli kupitia report text.
Waandishi wanakiri kwamba baadhi ya watu wenye breast implant au past surgery history huenda waliingia kwenye cohort kimakosa kwa sababu structured records zilikuwa incomplete. Hii inaonyesha utegemezi wa modeli kwa accuracy ya electronic health records.
Expressions zinazojitokeza katika low-risk predictions
- Symmetric breasts,
- No suspicious finding in contralateral breast,
- No axillary lymph-node enlargement,
- Normal configuration,
- Benign au unchanged findings,
- Absence of suspicious pathologic findings.
Expressions hizi zinaonyesha kwamba modeli haipati low risk kutoka age au BI-RADS class pekee, bali pia kutoka combined pattern ya reassuring report language.
Contribution ya structured features
Katika high-risk predictions, family history na reproductive history zilikuwa na contribution iliyo dhahiri zaidi. Katika low-risk predictions, socioeconomic indicators kama monthly insurance payment na geographic region zilijitokeza zaidi.
Finding hii inaweza kuunga mkono kwamba modeli inatumia clinically meaningful features, lakini contribution ya socioeconomic features pia inaibua uwezekano wa:
- Regional follow-up frequency differences,
- Access to healthcare,
- Probability ya diagnosis confirmation,
- Report-writing practices,
- Imaging intensity inayohusiana na insurance package.
Kwa hiyo fairness ya modeli katika socioeconomic na geographic groups inahitaji kutathminiwa si kwa AUROC pekee bali pia kwa calibration, false-negative rates na clinical outcomes.
Ulinganisho na classic risk models
Waandishi wanaonyesha published AUROC values za Gail, Tyrer-Cuzick, BOADICEA na image-based deep-learning models kuwa chini kuliko 0,86 ya utafiti huu.
Hata hivyo, hizi si direct comparisons katika same patients, outcome definition na test set. Studies tofauti zimetumia:
- Countries tofauti,
- Age na risk distributions tofauti,
- Cancer definitions tofauti,
- Follow-up periods tofauti,
- Imaging na clinical data types tofauti.
Kwa hiyo, ingawa model performance ni strong, superiority dhidi ya models nyingine haijathibitishwa kwa independent head-to-head evaluation.
Kwa nini kutotumia raw mammography images ni muhimu?
Kwa image-based models, raw mammography files zinahitaji kuhifadhiwa kwa standardized format, kusafirishwa na kuchakatwa kwa high computational power. Katika health systems nyingi, past images zinaweza kuwa incomplete, katika different device formats au fragmented across centers.
Radiology reports na electronic health records mara nyingi zina smaller data size na zinapatikana kwa urahisi zaidi.
Potential advantages za approach hii ni:
- Lower computational load,
- Easier integration with existing record systems,
- Explainable report terms,
- Ability to use cumulative history over time,
- Applicability katika health systems zenye incomplete image archives.
Disadvantage kuu ni kupotea kwa image details ambazo hazikuandikwa katika report. Modeli inajifunza zaidi radiologist ameandika nini kuliko ameona nini. Reporting habits zikibadilika, performance pia inaweza kubadilika.
Modeli inaweza kutumikaje kliniki?
Waandishi wanapendekeza possible uses zifuatazo:
- Earlier re-evaluation ya high-risk persons ndani ya BI-RADS 1-3,
- Prioritization kwa additional mammography, ultrasound au MRI,
- Closer follow-up ya higher-risk persons ndani ya BI-RADS 3,
- Kuhamisha very-low-risk persons kutoka annual hadi biennial screening,
- Allocation ya limited imaging resources according to risk.
Hakuna moja ya hizi iliyojaribiwa kama clinical intervention katika study. Haijulikani jinsi kuongeza model outputs kwa clinician decisions kutabadilisha cancer stage, mortality, number of biopsies, cost au patient anxiety.
Umuhimu wa zamani, sasa na ujao
Zamani breast-cancer risk models zilitumia zaidi fixed variables kama age, family history, reproductive history na genetic markers. Mammography-based AI studies zilitegemea zaidi image ya examination moja.
Leo utafiti huu unaonyesha kwamba history nzima ya past radiology reports na timing between examinations inaweza kuwa na future-risk information muhimu. Approach hii hutathmini screening history ya mtu kwa muda badala ya mammography frame moja.
Katika siku zijazo report text, images, prescriptions, genetic information na lifestyle data zinaweza kuunganishwa katika comprehensive risk models. Lakini more data haimaanishi automatically better clinical outcomes. Data quality, privacy, discrimination risk, model calibration na health-system impact zinahitaji kutathminiwa.
Nguvu za utafiti
- Initial database kubwa sana ya takriban mammography reports milioni 4,61 na watu milioni 1,81 ilitumika.
- Data zilitoka katika miaka kumi ya real-world health-system records.
- Future-risk heterogeneity ndani ya BI-RADS 1, 2 na 3 ililengwa.
- Past mammography reports ziliingizwa chronologically.
- Approach scalable zaidi isiyohitaji raw images ilitengenezwa.
- TF-IDF ilitoa clinical-term-level explainability.
- Structured clinical, reproductive, family-history na socioeconomic information ziliunganishwa.
- Training-test split ilifanywa katika person level.
- Performance ya one-to-five-year horizons iliripotiwa.
- Age na geographic-region subgroup analyses zilifanywa.
- Beta na isotonic calibration methods zilinganishwa.
- Operational sensitivity, specificity, PPV, NPV na false-negative scenarios zilitolewa.
- Risk distributions ndani ya BI-RADS classes zilivisualize.
- Correct na incorrect predictions zilichunguzwa separately kwa integrated gradients.
- Text na structured feature contributions zilitathminiwa separately.
- Sensitivity analyses za early-cancer exclusion na outcome-confirmation windows zilifanywa.
Mapungufu ya utafiti
- Hakuna peer review: utafiti bado ni preprint.
- Retrospective design: record errors, selection na unmeasured confounding vinaweza kuwepo.
- Single health system: data ni za private health network moja; hakuna external validation katika other countries au public systems.
- Random internal validation: test data ni za independent persons lakini zimetoka institution, period na record process ileile.
- Follow-up selection: people bila sufficient follow-up records waliondolewa.
- Private-health-system population: results haziwezi kugeneralize moja kwa moja kwa whole Brazilian population au public system.
- Examination-level analysis: mtu mmoja anaweza kuwakilishwa na multiple index mammograms.
- Within-person dependence: statistical dependence ya repeated examinations haijashughulikiwa kwa undani katika main text.
- Outcome label si histology pekee: BI-RADS 5 na 6 records pia huchangia positive outcome.
- Raw images hazikutumika: image information isiyoandikwa katika reports imepotea.
- Report-writing dependence: hospital, device, radiologist na language changes zinaweza kuathiri performance.
- Incomplete clinical records: baadhi ya surgical au implant histories zilijulikana kutoka text pekee.
- Socioeconomic proxy variables: insurance payment na postal code huenda zinajifunza healthcare access.
- Limited fairness analysis: detailed error analysis kwa race, ethnicity, income na other social groups haikutolewa.
- Regional imbalance: sehemu kubwa ya five-year cohort ni ya Northeast.
- Underrepresented regions: confidence intervals ni pana katika South na Central-West.
- High-risk calibration drift: highest predictions zilikuwa slightly overconfident.
- Brier comparison missing: simple prevalence model comparison haikutolewa.
- No direct model comparison: Gail, Tyrer-Cuzick au image-based models hazikutathminiwa katika same test set.
- No prospective clinical utility: haijulikani kama model use huongeza early detection au survival.
- Screening interval not tested: safety ya biennial screening katika low-risk group haijajaribiwa.
- Effect ya additional imaging haijulikani: benefit-harm balance ya MRI au biopsy katika high-risk group haikupimwa.
- No cost-effectiveness: real impact kwa health-system resources haikokotewe.
- Model-setup inconsistency: descriptions za separate time models na multi-output single model hazilingani.
- Cohort-total inconsistency: 706.545, 706.910 na training-test total hazilingani.
- Misleading low-risk wording: %10 katika abstract si within-group cancer rate bali share ya all positives katika low-risk group.
- Age-group reporting differs: table inatumia 50-74, text 50-75.
- Supplement missing: baadhi ya important hyperparameters na implementation details ziko supplement, si main PDF.
- Limited reproducibility: raw report text haitashirikiwa kwa privacy na data/weights zitapatikana conditionally baada ya publication.
Utafiti unasema nini?
- Longitudinal mammography reports zina strong prediction signal kwa future breast-cancer risk.
- Strong risk discrimination ilipatikana bila raw mammography images.
- Five-year model test AUROC ni takriban 0,86.
- Modeli ilionyesha similar discrimination katika one-to-five-year horizons.
- Kuna substantial risk heterogeneity ndani ya BI-RADS 1, 2 na 3.
- Highest-risk %3,4 examination group ina takriban nusu ya five-year positives.
- Large low-risk examination group ina negative predictive value ya juu sana.
- Previous surgery phrases, calcifications na architectural distortions huchangia high-risk predictions.
- Reassuring na symmetric radiologic phrases hujitokeza katika low-risk predictions.
- Text reports zilionyesha higher total predictive contribution kuliko structured clinical features.
- Beta na isotonic calibration ziliboresha raw model probabilities.
- Routine report text inaweza kuwa scalable data source kwa personalized-screening research.
Utafiti hausimi nini?
- Hauonyeshi kwamba modeli inaweza kuchukua nafasi ya mammography au radiologist assessment.
- Hauonyeshi kwamba modeli inadiagnose current cancer kwa uhakika.
- Hauonyeshi kwamba AUROC 0,86 ni %86 individual accuracy.
- Hauonyeshi kwamba kila high-risk flagged person atapata cancer.
- Hauonyeshi kwamba %10 ya lowest-risk %47 walipata cancer.
- Haudhibitishi kwamba low-risk persons wanaweza kuscreeniwa safely kila miaka miwili.
- Haudhibitishi kwamba high-risk persons wanapaswa automatically kupata biopsy au MRI.
- Hauonyeshi kwamba model use hugundua cancer katika earlier stage.
- Hauonyeshi kwamba hupunguza breast-cancer mortality.
- Hauonyeshi superiority dhidi ya other risk models kwa head-to-head comparison.
- Haudhibitishi kwamba performance itakuwa sawa katika Brazilian public system au other countries.
- Hauonyeshi kwamba socioeconomic features ni biologically protective au risk increasing.
- Hauonyeshi kwamba modeli ni safe kwa equity, cost na patient quality of life.
Mbinu na Matokeo ya Utafiti
Muhtasari wa kiufundi wa mbinu
| Method area | Approach iliyotumika |
|---|---|
| Study type | Retrospective real-world cohort na prognostic modeling |
| Health system | Hapvida, private health network Brazil |
| Data period | 1 Januari 2016-31 Desemba 2025 |
| Initial data volume | 4.609.295 mammography reports na 1.810.345 persons |
| Index mammography classes | BI-RADS 1, 2 na 3 |
| Age range | Miaka 18-75 |
| Previous breast cancer | Excluded |
| Early-cancer exclusion window | First 90 days after index examination |
| Prediction horizons | Miaka 1, 2, 3, 4 na 5 |
| Primary outcome | Future positive outcome defined by BI-RADS 5/6 au malignant biopsy |
| Structured inputs | Demography, reproductive history, family history, BMI, BI-RADS, insurance payment na postal code |
| Text inputs | Chronological series of past mammography reports |
| Text encoding | TF-IDF |
| Time information | Intervals between examinations na time-weighted aggregation |
| Prediction model | Dense neural network using combined vectors |
| Data split | Person-level training/test split |
| Validation | Five-fold cross-validation katika training set na held-out test set |
| Discrimination metrics | AUROC na concordance index |
| Operational metrics | Sensitivity, specificity, PPV, NPV na false-negative rate |
| Calibration | Platt, beta na isotonic calibration |
| Explainability | Integrated gradients na term-pair contribution maps |
Sifa kuu za five-year cohort
| Sifa | Result |
|---|---|
| Persons | 278.475 |
| Eligible examinations | Main text 706.545; Table 1 706.910 |
| Median age | Miaka 43; interquartile range 36-52 |
| BI-RADS 1 | 404.042; %57,2 |
| BI-RADS 2 | 218.295; %30,9 |
| BI-RADS 3 | 84.573; %11,9 |
| Positive outcome | 9.620; %1,36 |
| Training examinations | 566.698 |
| Test examinations | 142.517 |
Muhtasari wa model performance
| Performance area | Result | Tafsiri sahihi |
|---|---|---|
| 5-year AUROC | 0,863 | Strong risk ranking; si individual accuracy percentage |
| 5-year C-index | 0,859 | Strong ordering by event time |
| 1-4-year AUROC | 0,82-0,85 | Similar discrimination across horizons |
| Calibrated Brier score | 0,014 | Inahitaji kutafsiriwa na rare-event prevalence na reference model |
| Sensitivity katika highest-risk %3,4 | %50,1 | Takriban nusu ya positive examinations zote zinakamatwa |
| Specificity katika highest-risk %3,4 | %97,3 | Negative examinations nyingi haziflagiwi |
| PPV katika highest-risk %3,4 | %25,1 | Takriban examination moja kati ya nne zilizoflagiwa huwa positive |
| FNR katika lowest-risk %47 | %10,0 | %10 ya positives zote ziko katika group hii; si within-group cancer rate |
| NPV katika low-risk group | Takriban %99,6 | Takriban %0,4 ya examinations zinaweza kuwa positive |
Vipengele vikuu vya modeli vilivyoelezwa kwa formula
Text weighting:
\[ TF\text{-}IDF(t,d)=TF(t,d)\times\log\left(\frac{N}{DF(t)}\right) \]
Uhusiano huu hupa weight zaidi terms zinazotokea mara nyingi katika report lakini si katika reports zote.
Time-weighted report aggregation:
\[ w_i=\frac{e^{-\lambda\Delta t_i}}{\sum_j e^{-\lambda\Delta t_j}} \]
Recent reports zinaweza kupata weight kubwa zaidi kulingana na parameter.
Binary future-risk prediction:
\[ \hat{p}_k=P(Y=1\mid X,\ T\leq k) \]
Hapa p̂k ni probability ya positive outcome ndani ya k years kwa information ya current examination, na X ni report na structured features.
Integrated-gradient contribution:
\[ IG_i(x)=(x_i-x_i')\int_0^1\frac{\partial F(x'+\alpha(x-x'))}{\partial x_i}\,d\alpha \]
Kipimo hiki huonyesha magnitude na direction ya jinsi specific word au clinical feature inavyochangia model risk prediction.
Reporting issues kati ya text, tables na figures
| Topic | Reported in one place | Reported elsewhere | Kwa nini ni muhimu? |
|---|---|---|---|
| Five-year total examinations | 706.545 | Table 1: 706.910 | Cohort size na prevalence calculation zinahitaji ufafanuzi |
| Training-test total | 566.698 + 142.517 = 709.215 | Higher than both cohort totals | Exact data-split counts haziko wazi |
| Model structure | Separate model for each horizon | Figure 1: one model with simultaneous 1-5-year outputs | Architecture na training method zinatofautiana |
| Lowest-risk %47 | Abstract: “only %10 developed cancer” | Results/Figure 4: %10 of all positives remain in group | Within-group risk isichanganywe na false-negative share |
| Upper age group | Text: 50-75 | Table 2: 50-74 | Subgroup boundary inahitaji kuwa wazi |
Ethics approval, funding na conflicts of interest
Utafiti uliidhinishwa na Brazilian National Research Ethics Commission kwa CAAE 83210524.4.0000.0229.
Utafiti ulifanywa kwa mujibu wa Declaration of Helsinki na Brazilian National Health Council Resolution 466/2012. Kwa retrospective use ya de-identified secondary data, individual informed-consent requirement iliondolewa.
Utafiti uliungwa mkono na FAPESP, Hapvida Assistência Médica S.A., CNPq, CAPES na FUNCAP. Funders hawakuwa na role katika study design, data collection, analysis, interpretation au manuscript writing.
Waandishi hawakutangaza conflicts of interest.
Dokezo la Chanzo na Mbinu
Maudhui haya yanatokana na utafiti wa Higor S. Monteiro, José A. Shiomi da Cruz, César L. C. Mattos, Iago C. Chaves, Javam C. Machado, Hernán A. Makse, Lucas C. Parra na José S. Andrade Jr. wenye kichwa “Breast cancer risk prediction from longitudinal mammography reports in a real-world health system: a prognostic modelling study”.
Utafiti ni preprint iliyowasilishwa kwenye SSRN. Maandishi asilia yana kauli wazi “This preprint research paper has not been peer reviewed”. Kwa hiyo model, analyses na clinical interpretations bado hazijapitia peer review na zinaweza kubadilika katika versions zijazo.
Utafiti si randomized screening trial au prospective clinical implementation study. Ni retrospective prognostic-modeling study inayotokana na electronic health records za private health system moja Brazil kati ya 2016-2025.
Modeli haikutumia raw mammography images. Predictions zilitokana na radiology-report text, previous BI-RADS records, time between examinations na structured clinical information.
Modeli haikutengenezwa ku-diagnose cancer katika current mammogram, bali kutabiri positive-outcome risk ndani ya mwaka mmoja hadi miaka mitano baada ya BI-RADS 1-3 examinations.
Positive outcome katika study haijumuishi histopathologic cancer confirmation pekee; BI-RADS 5 na 6 records pia huchangia outcome definition. Possible misclassification ya outcome label inapaswa kuzingatiwa.
Thresholds za highest-risk %3,4 na lowest-risk %47 ni operational scenarios zilizoundwa kwenye retrospective test data. Si validated clinical thresholds za biopsy, MRI au screening interval.
Utafiti hauonyeshi kwamba biennial screening katika low-risk group ni safe, additional imaging katika high-risk group hutoa benefit au model use hupunguza breast-cancer mortality.
Kuna inconsistencies zinazohitaji ufafanuzi katika cohort counts, training-test split, time-horizon model structure na interpretation ya low-risk rate kati ya text, tables na figures.
Modeli imejaribiwa tu katika randomly split persons kutoka health system ileile. Hakuna external validation katika independent health system, public system au another country.
Imeelezwa kwamba raw radiology reports hazitashirikiwa kwa privacy, na de-identified data na model weights zinaweza kutolewa conditionally baada ya publication kwa approval ya data controller. Hii inapunguza independent reproducibility ya current preprint.
Maudhui haya yameandaliwa kwa kutegemea tu methods, cohort flow, tables, model diagram, ROC na calibration plots, risk percentiles, BI-RADS distributions, explainability analyses, author interpretations na limitations katika PDF iliyopakiwa. Hakuna madai yasiyopo kwenye PDF kuhusu clinical benefit, screening safety, treatment success au precise personal risk yaliyoongezwa.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *