

Modeli za akili bandia za sauti sasa hazibadilishi usemi kuwa maandishi tu. Zinajaribu pia kuelewa sauti ya mtumiaji, muktadha wa mazungumzo na wakati mwingine sauti za mazingira za chinichini. Kwa mfano, wakati wa mazungumzo inaweza kusikika sauti ya mvua, honi ya gari, kisafisha vumbi, kubwekwa kwa mbwa au kulia kwa mtoto.
Makala hii iliyoandaliwa na Yang Xiao na wenzake inachunguza jinsi modeli kubwa za sauti–lugha zinavyoweza kukumbuka sauti hizi za mazingira katika mazungumzo ya mizunguko mingi. Matokeo makuu ya kazi ni ya kuvutia sana: Modeli zinakumbuka taarifa za maneno na maana katika mazungumzo bora kuliko sauti za mazingira. Sauti za chinichini husahaulika haraka zaidi mazungumzo yanapozidi kuwa marefu.
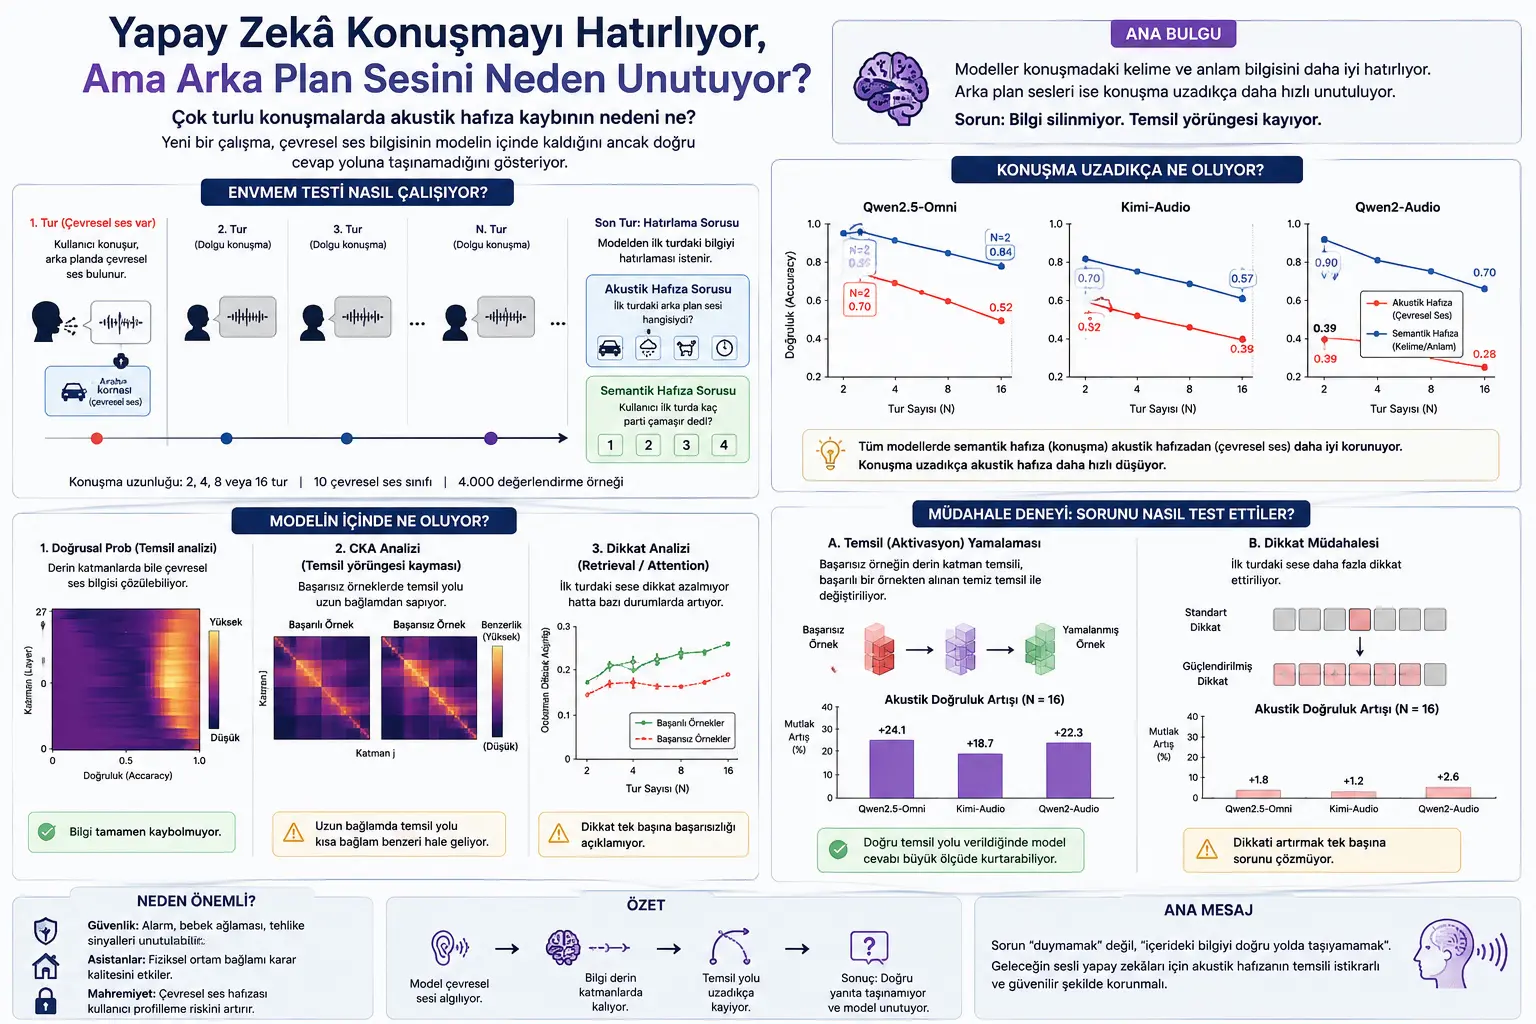
Watafiti wanaunda mfumo wa majaribio unaodhibitiwa uitwao EnvMem ili kupima hali hii. Sauti moja ya mazingira inawekwa kwenye mzunguko wa kwanza wa mazungumzo. Kisha mazungumzo yanaendelea kwa mizunguko kadhaa. Mwishoni modeli inaulizwa ama taarifa ya maandishi kutoka mazungumzo au sauti ya mazingira ya chinichini.
Kulingana na matokeo, tatizo si tu kwamba “modeli inapoteza sauti kabisa”. Taarifa ya sauti ya mazingira bado inaweza kufunguliwa katika tabaka za kina za modeli. Lakini taarifa hiyo haihamishwi kwa njia sahihi kwenye njia ya kuzalisha jibu. Makala inaita hili representational trajectory drift, yaani mkengeuko wa njia ya uwakilishaji.
Unapozungumza na wasaidizi wa sauti hakuna maneno tu. Chinichini kunaweza kuwa kengele ya mlango, alamu, trafiki, mvua, kulia kwa mtoto au sauti ya mashine. Sauti hizi wakati mwingine ni muhimu kwa muktadha.
Kwa mfano, katika mfumo wa usalama sauti ya alamu, katika msaidizi wa matengenezo sauti ya mashine, katika msaidizi wa nyumbani kulia kwa mtoto au sauti ya maji inaweza kuwa muhimu. Ikiwa akili bandia inagundua sauti hizi mwanzoni kisha inazisahau mazungumzo yanavyoendelea, mchakato wa kufanya maamuzi unaweza kudhoofika.
Modeli kubwa za sauti–lugha zilizopo kwa kawaida huhifadhi maana ya mazungumzo vizuri zaidi. Ikiwa mtumiaji anasema “nitaosha nguo kwa sehemu tatu”, modeli inaweza kukumbuka hilo baada ya mizunguko kadhaa. Lakini ikiwa katika mazungumzo yale yale ya kwanza kuna honi ya gari chinichini, inapata shida zaidi kukumbuka hilo baada ya mizunguko kadhaa.
Hali hii inaleta maswali mawili:
1. Je, modeli zinakumbuka bora taarifa ya maneno katika mazungumzo, au taarifa ya sauti za mazingira?
2. Ikiwa sauti ya mazingira inasahaulika, je taarifa hiyo inaondolewa kweli ndani ya modeli, au taarifa iko ndani lakini haitumiki katika kuzalisha jibu?
Thamani halisi ya makala iko hapa. Watafiti hawaangalii alama za modeli tu; wanachambua tabaka za ndani za modeli ili kujaribu kuelewa mahali kosa linapotokea.
Mbinu inapendekeza nini?
Watafiti wanaunda mfumo wa majaribio uitwao EnvMem ili kuchunguza tatizo hili.
Mantiki ya EnvMem ni rahisi:
- Sauti moja ya mazingira inaongezwa kwenye usemi wa kwanza wa mtumiaji.
- Sauti hii ya mazingira ipo tu katika mzunguko wa kwanza.
- Mazungumzo yanayofuata yanaendelea kama mazungumzo ya kujaza.
- Mwishoni modeli inaulizwa swali lenye chaguo nyingi.
- Swali linalenga kukumbuka ama taarifa ya maandishi kutoka mazungumzo ya kwanza au sauti ya mazingira ya chinichini.
Kwa mfano, katika mazungumzo ya kwanza mtumiaji anazungumza kuhusu kufua nguo na chinichini kuna honi ya gari. Kisha mazungumzo yanaendelea. Mwishoni modeli inaweza kuulizwa aina mbili tofauti za maswali:
Swali la kumbukumbu ya akustiki:
Sauti gani ya mazingira ilikuwepo chinichini katika ujumbe wa kwanza wa sauti?
Swali la kumbukumbu ya semantik:
Mtumiaji alisema sehemu ngapi za kufua katika mazungumzo ya kwanza?
Muundo huu ni muhimu kwa sababu taarifa ya maandishi na sauti ya mazingira zinatokana na muktadha mmoja wa mwanzo. Hivyo inawezekana kupima kwa usawa zaidi kama modeli inakumbuka bora taarifa ya mazungumzo au sauti ya mazingira.
Katika seti ya data ya EnvMem madarasa 10 ya sauti za mazingira yanatumika:
- Mvua
- Ngurumo
- Mawimbi ya bahari
- Sauti ya motori
- Kisafisha vumbi
- Honi ya gari
- Sauti ya mbwa
- Kulia kwa mtoto
- Tiktoki ya saa
- Moto unaowaka kwa kishindo
Urefu wa mazungumzo hubadilishwa kuwa mizunguko 2, 4, 8 na 16. Hivyo hupimwa jinsi kumbukumbu ya sauti ya mazingira inavyoharibika mazungumzo yanapozidi kuwa marefu.
Fomula zinasema nini?
Fomula katika makala zinaeleza muundo wa majaribio na jinsi hasara ya kumbukumbu inavyopimwa. Tukirahisisha kwa msomaji, kuna mawazo makuu mawili.
Wazo la kwanza: Muundo wa mazungumzo ya mizunguko mingi
Makala inaeleza mazungumzo kama mizunguko mfululizo. Katika mzunguko wa kwanza mtumiaji anazungumza na sauti ya mazingira inaongezwa kwenye usemi huo. Mizunguko inayofuata inarefusha mazungumzo. Katika mzunguko wa mwisho modeli inaombwa kukumbuka taarifa kutoka mzunguko wa kwanza.
Jambo muhimu hapa ni hili: Sauti ya mazingira ipo tu katika mzunguko wa kwanza. Hairudiwi katika mizunguko inayofuata. Hivyo hujaribiwa kama modeli inakumbuka kweli sauti ya awali au la.
Wazo la pili: Kulinganisha hasara ya kumbukumbu ya akustiki na hasara ya kumbukumbu ya semantik
Makala inalinganisha kushuka kwa usahihi wa modeli katika aina mbili za taarifa mazungumzo yanapozidi kuwa marefu:
- Taarifa ya akustiki: Sauti ya chinichini ilikuwa nini?
- Taarifa ya semantik: Ukweli wa maandishi uliotajwa katika mazungumzo ulikuwa nini?
Ikiwa usahihi wa akustiki unashuka haraka zaidi, ina maana modeli inasahau sauti ya mazingira haraka kuliko maana ya mazungumzo.
Kwa hiyo kipimo cha tofauti katika makala kinasema hivi:
Mazungumzo yanapozidi kuwa marefu, je kumbukumbu ya sauti ya mazingira inaharibika haraka kuliko kumbukumbu ya maneno/maana?
Kulingana na matokeo jibu ni ndiyo. Modeli zinashikilia taarifa ya sauti ya mazingira kwa udhaifu zaidi kuliko taarifa ya semantik katika mazungumzo.
Ujumbe kuu wa grafu / jedwali / mchoro
Mchoro wa EnvMem:
Mchoro mkubwa wa kwanza katika makala unaonyesha jinsi majaribio yalivyoundwa. Sauti ya mazingira inawekwa kwenye mzunguko wa kwanza wa mazungumzo, mizunguko inayofuata inarefusha mazungumzo, na mwishoni modeli inaombwa kukumbuka ama sauti ya mazingira au taarifa ya maandishi. Ujumbe kuu wa mchoro ni huu: Watafiti wanaunda jaribio la kumbukumbu linalodhibitiwa badala ya mazungumzo halisi ya bahati nasibu. Hivyo kumbukumbu ya sauti na ya maana zinaweza kupimwa kando.
Grafu ya kumbukumbu ya akustiki na semantik:
Grafu ya utendaji katika makala inaonyesha mafanikio ya modeli za Qwen2.5-Omni, Kimi-Audio na Qwen2-Audio katika mazungumzo ya mizunguko 2, 4, 8 na 16. Ujumbe kuu wa grafu ni wazi: Mazungumzo yanapozidi kuwa marefu kumbukumbu ya maandishi na ya akustiki zote zinashuka; lakini kumbukumbu ya sauti ya mazingira inaharibika haraka zaidi.
Grafu ya linear probing tabaka kwa tabaka:
Grafu ya linear probing katika makala inaonyesha katika tabaka gani za modeli taarifa ya sauti ya mazingira bado inaweza kufunguliwa. Matokeo ya kuvutia ni haya: Hata modeli ikitoa jibu lisilo sahihi, taarifa ya sauti ya mazingira bado inaweza kupatikana katika tabaka za kina. Yaani taarifa haijafutwa kabisa.
Ramani za joto za CKA:
Grafu za CKA zinaonyesha jinsi safari ya uwakilishaji wa ndani wa modeli inavyobadilika katika majaribio yaliyofaulu na yaliyoshindwa. Ujumbe kuu ni huu: Katika hali zilizoshindwa, uwakilishaji unapotoka kwenye njia inayobeba muktadha mrefu kwa usahihi na kuelekea mpangilio wa uchakataji unaofanana na muktadha mfupi. Hii pia inasaidia wazo la “mkengeuko wa njia ya uwakilishaji”.
Grafu ya uchambuzi wa uangalifu:
Makala pia inachunguza kama modeli inatoa uangalifu wa kutosha kwa mazungumzo yenye sauti ya mazingira ya kwanza. Matokeo yanashangaza: Usambazaji wa uangalifu peke yake hauelezi kushindwa. Hata katika baadhi ya muktadha mrefu, modeli inaweza kuonekana ikitoa uangalifu zaidi kwa mzunguko wa kwanza bado ishindwe kutoa jibu sahihi.
Grafu ya kubandika uamilifu:
Katika jaribio la kuingilia katika makala, uwakilishaji wa tabaka ya kina wa modeli iliyoshindwa hubadilishwa na uwakilishaji safi uliochukuliwa kutoka mfano sahihi. Hatua hii inaongeza kwa kiasi kikubwa asilimia ya majibu sahihi. Ujumbe kuu ni huu: Tatizo halitatuliwi kwa kuongeza uangalifu tu; modeli inaweza kuokoa jibu wakati uwakilishaji wa ndani uliolainishwa vizuri unahitajika.
Majaribio yamefanywaje?
Watafiti wanajaribu modeli kubwa tatu za sauti–lugha:
- Qwen2.5-Omni
- Qwen2-Audio
- Kimi-Audio
Modeli hizi huchaguliwa kama miundo ya kisasa yenye uzito wazi inayoweza kuchakata moja kwa moja pembejeo za sauti na usemi.
Katika kila mfano wa jaribio modeli hupokea mazungumzo ya sauti yenye mizunguko mingi. Katika mazungumzo ya kwanza kuna sauti ya mazingira. Mizunguko inayofuata inarefusha mazungumzo tu. Mwishoni modeli inaombwa kujibu swali lenye chaguo nne.
Jaribio linafanywa kwa namna mbili:
1. Jaribio la kukumbuka akustiki
Modeli inaombwa kuchagua sauti ya mazingira kutoka mazungumzo ya kwanza.
2. Jaribio la kukumbuka semantik
Modeli inaombwa kuchagua taarifa ya maandishi iliyotajwa katika mazungumzo ya kwanza.
Jumla ya mifano 4.000 ya tathmini inaundwa. Kati ya hizo, 2.000 hutumika kwa maswali ya akustiki na 2.000 kwa maswali ya semantik.
Watafiti pia hutumia mbinu mbili za uchambuzi ili kuchunguza ndani ya modeli:
Linear probing:
Huangaliwa kama taarifa ya sauti ya mazingira bado inaweza kufunguliwa katika tabaka tofauti za modeli.
Uchambuzi wa CKA:
Hupimwa jinsi muundo wa uwakilishaji wa ndani wa modeli unavyofanana kati ya mifano iliyofaulu na iliyoshindwa.
Hatimaye aina mbili za kuingilia hujaribiwa:
- Kubadilisha uwakilishaji katika tabaka ya kina
- Kubadilisha utaratibu wa uangalifu ili ulekee zaidi sauti ya kwanza
Hivyo hujaribiwa kama tatizo lipo katika kiwango cha uwakilishaji au katika kiwango cha uangalifu.
Matokeo yanaonyesha nini?
Matokeo yanaelekeza kwenye pointi kadhaa muhimu.
Kwanza, modeli zinakumbuka taarifa ya maana katika mazungumzo bora kuliko taarifa ya sauti ya mazingira. Kwa mfano, katika modeli ya Qwen2.5-Omni katika mazungumzo ya mizunguko 2, usahihi wa semantik ni takriban 0.92 huku usahihi wa akustiki ukibaki karibu 0.70. Mazungumzo yanapofika mizunguko 16, usahihi wa semantik unashuka hadi takriban 0.84, huku usahihi wa akustiki ukishuka hadi takriban 0.56.
Pili, tofauti hii haitokani na udhaifu wa ugunduzi wa awali tu. Mazungumzo yanapozidi kuwa marefu, sauti za mazingira zinaharibika haraka kuliko taarifa ya maandishi.
Tatu, taarifa ya sauti ya mazingira haipotei kabisa. Uchambuzi wa linear probing unaonyesha kuwa hata modeli ikitoa jibu lisilo sahihi, darasa la sauti ya mazingira bado linaweza kufunguliwa katika tabaka za kina. Hili ni matokeo muhimu sana. Kwa sababu tatizo si “taarifa imefutwa”; inaonekana kama “taarifa haikuwa na umbizo linalolingana na njia ya kuzalisha jibu sahihi”.
Nne, utaratibu wa uangalifu peke yake si wa kueleza. Kuongeza uangalifu wa modeli kwenye sehemu yenye sauti ya mazingira ya kwanza hakurekebishi majibu yaliyoshindwa kwa kiasi kinachoonekana.
Tano, kubadilisha uwakilishaji wa tabaka ya kina na uwakilishaji uliochukuliwa kutoka mfano sahihi na safi kunaweza kuokoa sehemu muhimu ya majibu yaliyoshindwa. Matokeo haya yanaunga mkono kuwa kizuizi kikuu kiko katika kiwango cha uwakilishaji.
Matokeo yenye nguvu zaidi ya makala yanaweza kufupishwa hivi:
Modeli ya akili bandia ya sauti haisahau sauti ya mazingira kabisa; lakini inapata shida kuiweka taarifa hiyo katika njia sahihi ya uwakilishaji katika mazungumzo marefu.
Kwa nini hii ni muhimu?
Kazi hii inaonyesha tatizo muhimu kwa wasaidizi wa sauti wa siku zijazo.
Leo mifumo ya akili bandia ya sauti inalenga zaidi swali “mtumiaji alisema nini?”. Lakini katika maisha halisi swali “chinichini kuna nini?” pia linaweza kuwa muhimu.
Kwa mfano:
- Je, msaidizi wa nyumbani anapaswa kukumbuka kulia kwa mtoto?
- Je, mfumo wa usalama unapaswa kuhifadhi sauti ya alamu katika mazungumzo yote?
- Je, msaidizi wa matengenezo unapaswa kutumia ishara ya onyo katika sauti ya mashine kama muktadha katika mazungumzo yanayofuata?
- Je, katika mfumo wa afya au dharura sauti za mazingira zinaweza kuchangia mchakato wa maamuzi?
Katika matumizi kama haya modeli inapaswa kukumbuka kwa uaminifu si mazungumzo tu, bali pia muktadha wa akustiki wa mazingira.
Lakini hii pia inaongeza hatari ya faragha. Kwa sababu kutoka sauti za mazingira inaweza kudokezwa kama mtu yuko nyumbani, kazini au barabarani; kama kuna mtoto karibu; utaratibu wa kila siku au taarifa nyeti za mazingira. Kwa hiyo wakati teknolojia za kumbukumbu ya akustiki zinaendelezwa, ruhusa wazi, mipaka ya kuhifadhi data na hatua za usalama zinahitajika.
Mambo yanayopaswa kuzingatiwa
Ingawa kazi hii inatoa uchambuzi wenye nguvu, ina baadhi ya mipaka.
Kwanza, EnvMem inatumia mazingira ya majaribio yanayodhibitiwa na sintetiki. Mazungumzo yameundwa kwa sauti moja ya TTS. Wasemaji tofauti wa maisha halisi, lafudhi, ubora wa maikrofoni, mazungumzo ya ghafla na sauti za mazingira zinazopishana haziwakilishwi kikamilifu katika jaribio hili.
Pili, katika kila mazungumzo sauti moja tu ya mazingira inawekwa kwenye mzunguko wa kwanza. Katika maisha halisi sauti za mazingira zinaweza kubadilika daima, sauti nyingi zinaweza kuwepo kwa wakati mmoja, au kelele ya chinichini inaweza kuendelea katika mazungumzo yote.
Tatu, uingiliaji katika kazi haufanywi kama suluhisho la bidhaa la vitendo, bali kwa madhumuni ya uchunguzi. Yaani mbinu ya kubadilisha uwakilishaji wa tabaka ya kina katika hali yake ya sasa si suluhisho linalotumika moja kwa moja katika mifumo ya kila siku.
Nne, kazi imefungwa kwa modeli mahususi. Ingawa matokeo yaliyopatikana kwenye Qwen2.5-Omni, Qwen2-Audio na Kimi-Audio ni muhimu, si sahihi kufanya ujumlishaji mkali kwa modeli zote za akili bandia za sauti.
Tano, kuimarika kwa kumbukumbu ya sauti ya mazingira kuna pande mbili kwa faragha. Mifumo inayokumbuka bora inaweza kuwa ya manufaa zaidi; lakini inaweza pia kuzua hatari ya kufuatilia na kuweka wasifu wa mazingira ya mtumiaji kwa muda mrefu zaidi.
Hitimisho
Makala hii inaonyesha kuwa modeli kubwa za sauti–lugha zinashikilia taarifa ya maana katika mazungumzo kwa uthabiti zaidi kuliko taarifa ya sauti ya mazingira. Modeli katika mazungumzo ya mizunguko mingi zinajibu bora swali “mtumiaji alisema nini?” kuliko swali “chinichini kulikuwa na nini?”.
Matokeo muhimu zaidi ya watafiti ni kuwa taarifa ya sauti ya mazingira haipotei kabisa. Taarifa bado inaweza kufunguliwa katika tabaka za kina za modeli. Lakini katika muktadha mrefu taarifa hiyo haihamishwi kwa njia inayolingana na mchakato wa kuzalisha jibu sahihi. Hali hii inaitwa mkengeuko wa njia ya uwakilishaji.
Kutoka mtazamo wa Verianla, ujumbe kuu wa makala ni huu:
Ili akili bandia za sauti ziweze kweli kuelewa mazingira yao, kubadilisha usemi kuwa maandishi haitoshi. Zinapaswa kuwakilisha sauti za chinichini kwa usahihi katika mazungumzo marefu na kuzikumbuka kwa uaminifu inapohitajika. Lakini uwezo huu unapaswa kuendelezwa pamoja na wajibu wa faragha na usalama.
Kumbuka ya chanzo na mbinu
Maudhui haya yameandaliwa kwa njia asilia katika muundo wa uhariri wa Verianla kwa kutumia kazi ya kitaaluma iliyoandaliwa na Yang Xiao, Siyi Wang, Han Yin, Hong Jia, Vidhyasaharan Sethu, Eun-Jung Holden na Ting Dang yenye kichwa “Why Can’t They Remember? Uncovering Representation and Retrieval Bottlenecks in Multi-Turn Acoustic Memory”.
Andiko hili si tafsiri neno kwa neno; mbinu, muundo wa majaribio wa EnvMem, grafu, fomula, majaribio, uchambuzi wa ndani wa modeli na matokeo katika makala yamerahisishwa na kuandikwa upya kwa wasomaji wa Kiswahili. Maudhui yana lengo la taarifa na elimu. Katika maeneo kama wasaidizi wa sauti, ufuatiliaji wa sauti za mazingira, mifumo ya usalama au uwekaji wasifu wa mtumiaji, mahitaji ya maadili, sheria na faragha yanapaswa kuzingatiwa.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *