

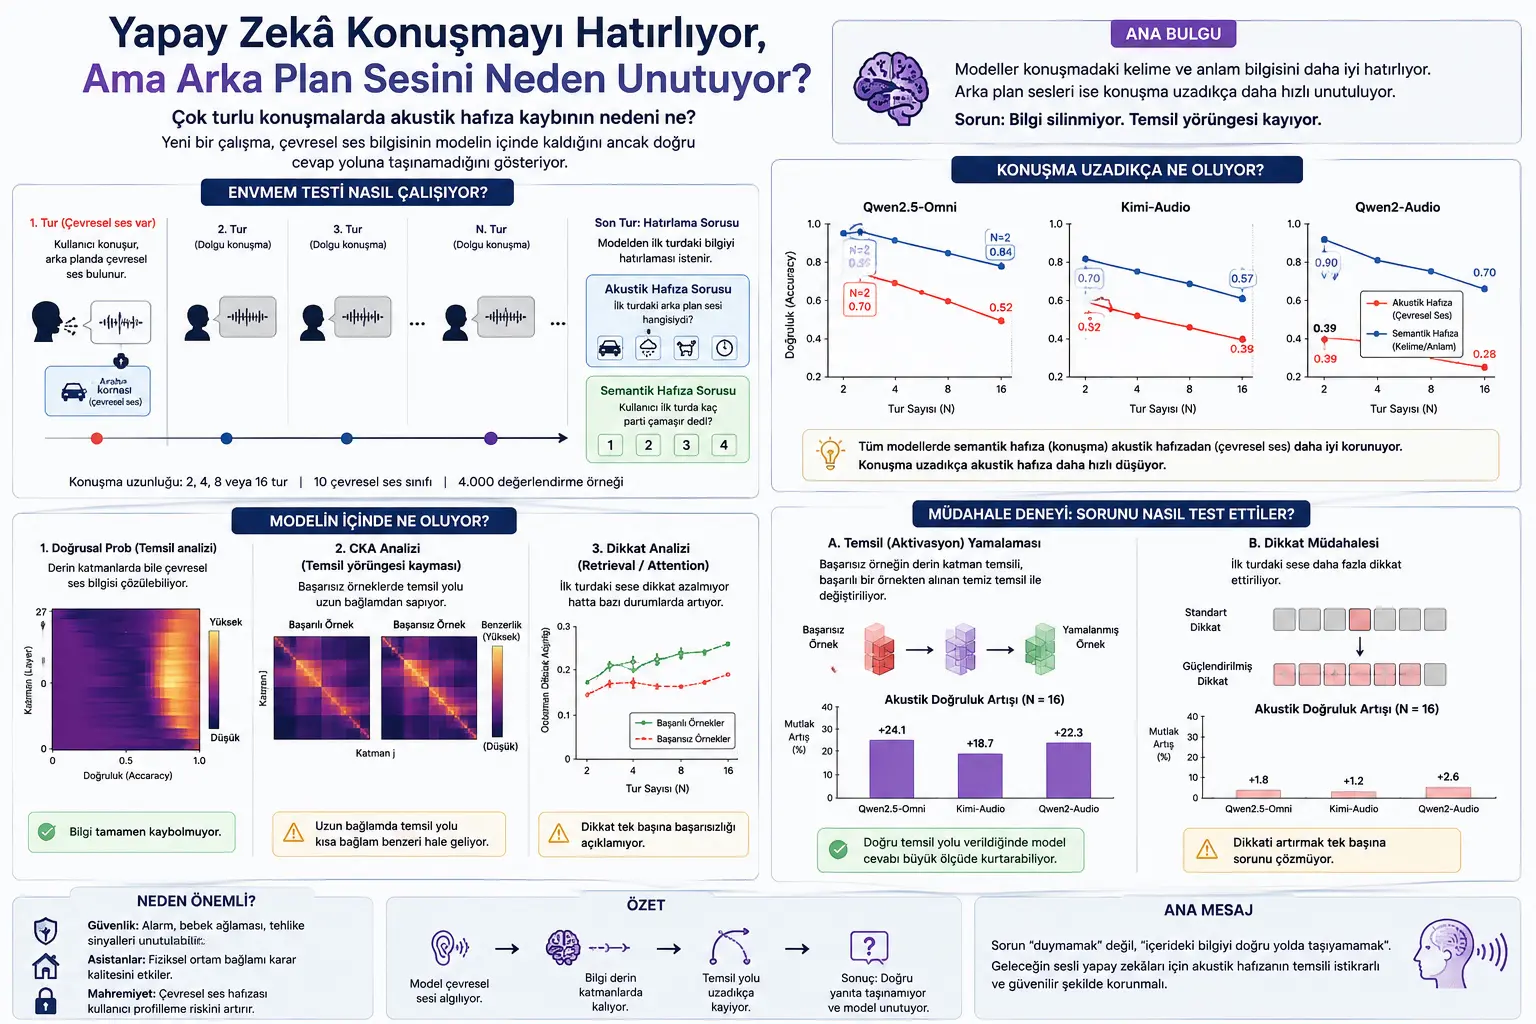
Sesli yapay zekâ modelleri artık yalnızca konuşmayı yazıya çevirmiyor. Kullanıcının sesini, konuşma bağlamını ve bazen arka plandaki çevresel sesleri de anlamaya çalışıyor. Örneğin konuşma sırasında yağmur sesi, araba kornası, elektrikli süpürge, köpek havlaması veya bebek ağlaması duyulabilir.
Yang Xiao ve çalışma arkadaşlarının hazırladığı bu makale, büyük ses-dil modellerinin çok turlu konuşmalarda bu çevresel sesleri ne kadar hatırlayabildiğini inceliyor. Çalışmanın ana bulgusu oldukça dikkat çekici: Modeller konuşmada geçen kelime ve anlam bilgisini çevresel seslere göre daha iyi hatırlıyor. Arka plan sesleri ise konuşma uzadıkça daha hızlı unutuluyor.
Araştırmacılar bu durumu ölçmek için EnvMem adlı kontrollü bir test sistemi kuruyor. İlk konuşma turuna bir çevre sesi yerleştiriliyor. Sonra konuşma birkaç tur devam ediyor. En sonunda modele ya konuşmadaki metinsel bilgi ya da arka plandaki çevre sesi soruluyor.
Sonuçlara göre sorun basitçe “model sesi tamamen kaybediyor” değil. Çevre sesi bilgisi modelin derin katmanlarında hâlâ çözülebiliyor. Ancak bu bilgi cevap üretme yoluna doğru biçimde taşınamıyor. Makale buna representational trajectory drift, yani temsil yörüngesi kayması diyor.
Sesli asistanlarla konuşurken sadece kelimeler yoktur. Arka planda kapı zili, alarm, trafik, yağmur, bebek ağlaması veya makine sesi olabilir. Bu sesler bazen bağlam için önemlidir.
Örneğin bir güvenlik sisteminde alarm sesi, bir bakım asistanında makine sesi, bir ev asistanında bebek ağlaması veya su sesi kritik olabilir. Eğer yapay zekâ bu sesleri ilk anda algılayıp sonra konuşma ilerledikçe unutuyorsa, karar verme süreci zayıflayabilir.
Mevcut büyük ses-dil modelleri genellikle konuşmadaki anlamı daha iyi koruyor. Kullanıcı “çamaşırları üç parti yapacağım” dediyse, model bunu birkaç tur sonra hatırlayabiliyor. Ama aynı ilk konuşmada arka planda araba kornası varsa, birkaç tur sonra bunu hatırlamakta daha fazla zorlanıyor.
Bu durum iki soruyu gündeme getiriyor:
1. Modeller konuşmadaki kelime bilgisini mi, yoksa çevresel ses bilgisini mi daha iyi hatırlıyor?
2. Çevresel ses unutuluyorsa, bu bilgi gerçekten modelin içinden silindiği için mi oluyor, yoksa bilgi içeride durduğu halde cevap üretiminde kullanılamadığı için mi?
Makalenin asıl değeri burada. Araştırmacılar sadece model skorlarına bakmıyor; modelin iç katmanlarını analiz ederek hatanın nerede oluştuğunu anlamaya çalışıyor.
Yöntem Ne Öneriyor?
Araştırmacılar bu problemi incelemek için EnvMem adlı bir test çerçevesi oluşturuyor.
EnvMem’in mantığı sade:
- İlk kullanıcı konuşmasına bir çevre sesi ekleniyor.
- Bu çevre sesi yalnızca ilk turda bulunuyor.
- Sonraki konuşmalar dolgu konuşmaları olarak ilerliyor.
- En sonda modele çoktan seçmeli bir soru soruluyor.
- Soru ya ilk konuşmadaki metinsel bilgiyi ya da arka plandaki çevre sesini hatırlamaya yönelik oluyor.
Örneğin ilk konuşmada kullanıcı çamaşırdan bahsediyor ve arka planda araba kornası var. Daha sonra konuşma devam ediyor. En sonunda modele iki farklı türde soru sorulabiliyor:
Akustik hafıza sorusu:
İlk sesli mesajın arka planında hangi çevre sesi vardı?
Semantik hafıza sorusu:
Kullanıcı ilk konuşmada çamaşır için kaç parti demişti?
Bu tasarım önemli çünkü metinsel bilgi ve çevre sesi aynı başlangıç bağlamından geliyor. Böylece modelin konuşma bilgisini mi yoksa çevresel sesi mi daha iyi hatırladığı daha adil şekilde ölçülebiliyor.
EnvMem veri setinde 10 çevre sesi sınıfı kullanılıyor:
- Yağmur
- Gök gürültüsü
- Deniz dalgaları
- Motor sesi
- Elektrikli süpürge
- Araba kornası
- Köpek sesi
- Bebek ağlaması
- Saat tik takı
- Çıtırdayan ateş
Konuşma uzunlukları 2, 4, 8 ve 16 tur olarak değiştiriliyor. Böylece konuşma uzadıkça çevresel ses hafızasının nasıl bozulduğu ölçülüyor.
Formüller Ne Anlatıyor?
Makaledeki formüller, test yapısını ve hafıza kaybını ölçme biçimini anlatıyor. Okuyucu için sadeleştirirsek iki ana fikir var.
Birinci fikir: Çok turlu konuşma yapısı
Makale konuşmayı sıralı turlar olarak tanımlıyor. İlk turda kullanıcı konuşuyor ve bu konuşmaya çevre sesi ekleniyor. Sonraki turlar konuşmayı uzatıyor. En son turda ise modelden ilk turdaki bilgiyi hatırlaması isteniyor.
Burada önemli nokta şu: Çevresel ses yalnızca ilk turda var. Sonraki turlarda tekrar edilmiyor. Böylece modelin gerçekten önceki sesi hatırlayıp hatırlamadığı test ediliyor.
İkinci fikir: Akustik hafıza kaybı ile semantik hafıza kaybını karşılaştırma
Makale, konuşma uzadıkça modelin iki tür bilgideki doğruluk düşüşünü karşılaştırıyor:
- Akustik bilgi: Arka plan sesi neydi?
- Semantik bilgi: Konuşmada geçen metinsel gerçek neydi?
Eğer akustik doğruluk daha hızlı düşüyorsa, model çevresel sesi konuşma anlamına göre daha çabuk unutuyor demektir.
Bu yüzden makaledeki fark ölçümü şunu anlatıyor:
Konuşma uzadığında çevresel ses hafızası, kelime/anlam hafızasına göre daha hızlı mı bozuluyor?
Sonuçlara göre cevap evet. Modeller çevresel ses bilgisini, konuşmadaki semantik bilgiye göre daha kırılgan şekilde tutuyor.
Grafik / Tablo / Şema Ana Mesajı
EnvMem şeması:
Makaledeki ilk büyük şema, testin nasıl kurulduğunu gösteriyor. İlk konuşma turuna çevre sesi yerleştiriliyor, sonraki turlar konuşmayı uzatıyor, en sonunda modelden ya çevre sesini ya da metinsel bilgiyi hatırlaması isteniyor. Şemanın ana mesajı şu: Araştırmacılar rastgele gerçek konuşmalar yerine kontrollü bir hafıza testi kuruyor. Böylece ses ve anlam hafızası ayrı ayrı ölçülebiliyor.
Akustik ve semantik hafıza grafiği:
Makaledeki performans grafiği, Qwen2.5-Omni, Kimi-Audio ve Qwen2-Audio modellerinin 2, 4, 8 ve 16 turlu konuşmalardaki başarısını gösteriyor. Grafiklerin ana mesajı net: Konuşma uzadıkça hem metinsel hem de akustik hafıza düşüyor; ancak çevresel ses hafızası daha hızlı bozuluyor.
Katman katman doğrusal prob grafiği:
Makaledeki doğrusal prob grafiği, çevre sesi bilgisinin modelin hangi katmanlarında çözülebildiğini gösteriyor. İlginç sonuç şu: Model yanlış cevap verse bile, derin katmanlarda çevre sesi bilgisi hâlâ bulunabiliyor. Yani bilgi tamamen silinmiş değil.
CKA ısı haritaları:
CKA grafikleri, başarılı ve başarısız denemelerde modelin iç temsil yolculuğunun nasıl değiştiğini gösteriyor. Ana mesaj şu: Başarısız durumlarda temsil, uzun bağlamı doğru taşıyan yoldan sapıyor ve kısa bağlam benzeri bir işleme düzenine kayıyor. Bu da “temsil yörüngesi kayması” fikrini destekliyor.
Dikkat analizi grafiği:
Makale, modelin ilk çevre sesi içeren konuşmaya yeterince dikkat edip etmediğini de inceliyor. Sonuç şaşırtıcı: Dikkat dağılımı tek başına başarısızlığı açıklamıyor. Hatta bazı uzun bağlamlarda model ilk tura daha fazla dikkat ediyor gibi görünse bile doğru cevap veremeyebiliyor.
Aktivasyon yamalama grafiği:
Makaledeki müdahale deneyinde, başarısız bir modelin derin katman temsili doğru bir örnekten alınan temiz temsil ile değiştiriliyor. Bu işlem doğru cevap oranını ciddi biçimde artırıyor. Ana mesaj şu: Sorun dikkati artırmakla çözülmüyor; doğru biçimde hizalanmış iç temsil gerektiğinde model cevabı kurtarabiliyor.
Deneyler Nasıl Yapılmış?
Araştırmacılar üç büyük ses-dil modelini test ediyor:
- Qwen2.5-Omni
- Qwen2-Audio
- Kimi-Audio
Bu modeller, ses ve konuşma girdilerini doğrudan işleyebilen açık ağırlıklı güncel mimariler olarak seçiliyor.
Her test örneğinde model çok turlu bir sesli konuşma alıyor. İlk konuşmada çevresel ses var. Sonraki turlar yalnızca konuşmayı uzatıyor. En sonunda modelden dört seçenekli bir soruya cevap vermesi isteniyor.
Test iki biçimde yapılıyor:
1. Akustik hatırlama testi
Modelden ilk konuşmadaki çevre sesini seçmesi isteniyor.
2. Semantik hatırlama testi
Modelden ilk konuşmada geçen metinsel bilgiyi seçmesi isteniyor.
Toplamda 4.000 değerlendirme örneği oluşturuluyor. Bunun 2.000’i akustik sorular, 2.000’i semantik sorular için kullanılıyor.
Araştırmacılar ayrıca modelin içini incelemek için iki analiz yöntemi kullanıyor:
Linear probing:
Modelin farklı katmanlarında çevre sesi bilgisi hâlâ çözülebiliyor mu diye bakılıyor.
CKA analizi:
Başarılı ve başarısız örneklerde modelin iç temsil yapısı birbirine ne kadar benziyor diye ölçülüyor.
Son olarak iki tür müdahale deneniyor:
- Derin katmandaki temsilin değiştirilmesi
- Dikkat mekanizmasının ilk sese daha fazla odaklanacak şekilde değiştirilmesi
Bu sayede sorunun temsil seviyesinde mi, yoksa dikkat seviyesinde mi olduğu test ediliyor.
Sonuçlar Ne Gösteriyor?
Sonuçlar birkaç önemli noktaya işaret ediyor.
İlk olarak, modeller konuşmadaki anlam bilgisini çevresel ses bilgisinden daha iyi hatırlıyor. Örneğin Qwen2.5-Omni modelinde 2 turlu konuşmada semantik doğruluk yaklaşık 0.92 iken, akustik doğruluk yaklaşık 0.70 seviyesinde kalıyor. Konuşma 16 tura çıktığında semantik doğruluk yaklaşık 0.84’e düşerken, akustik doğruluk yaklaşık 0.56’ya kadar geriliyor.
İkinci olarak, bu fark yalnızca ilk algılama zayıflığından kaynaklanmıyor. Konuşma uzadıkça çevre sesleri, metinsel bilgiye göre daha hızlı bozuluyor.
Üçüncü olarak, çevre sesi bilgisi tamamen yok olmuyor. Doğrusal prob analizleri, model yanlış cevap verdiğinde bile derin katmanlarda çevre sesi sınıfının hâlâ çözülebildiğini gösteriyor. Bu çok önemli bir bulgu. Çünkü sorun “bilgi silindi” değil; “bilgi doğru cevap üretim yoluna uygun formatta taşınamadı” gibi görünüyor.
Dördüncü olarak, dikkat mekanizması tek başına açıklayıcı değil. Modele ilk çevre sesi içeren bölüme daha fazla dikkat ettirmek, başarısız cevapları belirgin şekilde düzeltmiyor.
Beşinci olarak, derin katman temsilini doğru ve temiz bir örnekten alınan temsil ile değiştirmek, başarısız cevapların önemli bir bölümünü kurtarabiliyor. Bu sonuç, asıl darboğazın temsil seviyesinde olduğunu destekliyor.
Makalenin en güçlü sonucu şu şekilde özetlenebilir:
Sesli yapay zekâ modeli çevre sesini tamamen unutmuyor; fakat bu bilgiyi uzun konuşma boyunca doğru temsil yolunda tutmakta zorlanıyor.
Bu Neden Önemli?
Bu çalışma, geleceğin sesli asistanları için önemli bir problemi gösteriyor.
Bugün sesli yapay zekâ sistemleri çoğunlukla “kullanıcı ne dedi?” sorusuna odaklanıyor. Ancak gerçek hayatta “arka planda ne oluyor?” sorusu da önemli olabilir.
Örneğin:
- Bir ev asistanı bebek ağlamasını hatırlamalı mı?
- Bir güvenlik sistemi alarm sesini konuşma boyunca koruyabilmeli mi?
- Bir bakım asistanı makine sesindeki uyarı işaretini sonraki konuşmalarda bağlam olarak kullanabilmeli mi?
- Bir sağlık veya acil durum sisteminde çevresel sesler karar sürecine katkı verebilir mi?
Bu tür uygulamalarda modelin yalnızca konuşmayı değil, çevresel akustik bağlamı da güvenilir biçimde hatırlaması gerekir.
Ancak bu aynı zamanda mahremiyet riskini de büyütür. Çünkü çevresel seslerden kişinin evde mi, işte mi, trafikte mi olduğu; yanında bebek olup olmadığı; günlük rutini veya hassas ortam bilgileri çıkarılabilir. Bu nedenle akustik hafıza teknolojileri geliştirilirken açık rıza, veri saklama sınırı ve güvenlik önlemleri gerekir.
Dikkat Noktaları
Bu çalışma güçlü bir analiz sunsa da bazı sınırlamalar içeriyor.
İlk olarak EnvMem kontrollü ve sentetik bir test ortamı kullanıyor. Konuşmalar tek bir TTS sesiyle oluşturulmuş. Gerçek hayattaki farklı konuşmacılar, aksanlar, mikrofon kalitesi, spontane konuşmalar ve üst üste binen çevre sesleri bu testte tam olarak temsil edilmiyor.
İkinci olarak her konuşmada yalnızca bir çevresel ses ilk tura yerleştiriliyor. Gerçek hayatta çevresel sesler sürekli değişebilir, aynı anda birden fazla ses olabilir veya arka plan gürültüsü konuşma boyunca devam edebilir.
Üçüncü olarak çalışmadaki müdahaleler pratik bir ürün çözümü olarak değil, tanı koyma amacıyla yapılıyor. Yani derin katman temsili değiştirme yöntemi, bugünkü haliyle doğrudan günlük sistemlere uygulanacak bir çözüm değildir.
Dördüncü olarak çalışma belirli modellerle sınırlı. Qwen2.5-Omni, Qwen2-Audio ve Kimi-Audio üzerinde bulunan sonuçlar önemli olsa da, tüm sesli yapay zekâ modelleri için kesin genelleme yapmak doğru olmaz.
Beşinci olarak çevresel ses hafızasının güçlenmesi mahremiyet açısından çift yönlüdür. Daha iyi hatırlayan sistemler daha faydalı olabilir; ama kullanıcı ortamını daha uzun süre izleme ve profilleme riski de doğurabilir.
Sonuç
Bu makale, büyük ses-dil modellerinin konuşmadaki anlam bilgisini çevresel ses bilgisinden daha sağlam tuttuğunu gösteriyor. Modeller, çok turlu konuşmalarda “kullanıcı ne dedi?” sorusunu “arka planda ne vardı?” sorusuna göre daha iyi cevaplıyor.
Araştırmacıların en önemli bulgusu, çevresel ses bilgisinin tamamen kaybolmadığı. Bilgi modelin derin katmanlarında hâlâ çözülebiliyor. Fakat uzun bağlamlarda bu bilgi doğru cevap üretim süreciyle uyumlu biçimde taşınamıyor. Bu duruma temsil yörüngesi kayması deniyor.
Verianla açısından makalenin ana mesajı şu:
Sesli yapay zekâların gerçekten çevresini anlayabilmesi için yalnızca konuşmayı yazıya çevirmesi yetmez. Arka plan seslerini uzun konuşma boyunca doğru temsil edip, gerektiğinde güvenilir şekilde hatırlayabilmesi gerekir. Ancak bu yetenek mahremiyet ve güvenlik sorumluluğuyla birlikte geliştirilmelidir.
Kaynak ve Yöntem Notu
Bu içerik, Yang Xiao, Siyi Wang, Han Yin, Hong Jia, Vidhyasaharan Sethu, Eun-Jung Holden ve Ting Dang tarafından hazırlanan “Why Can’t They Remember? Uncovering Representation and Retrieval Bottlenecks in Multi-Turn Acoustic Memory” adlı akademik çalışmadan yararlanılarak Verianla editoryal formatında özgün olarak hazırlanmıştır.
Bu yazı birebir çeviri değildir; makaledeki yöntem, EnvMem test yapısı, grafikler, formüller, deneyler, model içi analizler ve sonuçlar sadeleştirilerek Türkçe okuyucu için yeniden anlatılmıştır. İçerik bilgilendirme ve eğitim amacı taşır. Sesli asistanlar, çevresel ses takibi, güvenlik sistemleri veya kullanıcı profilleme gibi alanlarda etik, hukuki ve mahremiyet gereklilikleri dikkate alınmalıdır.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir