

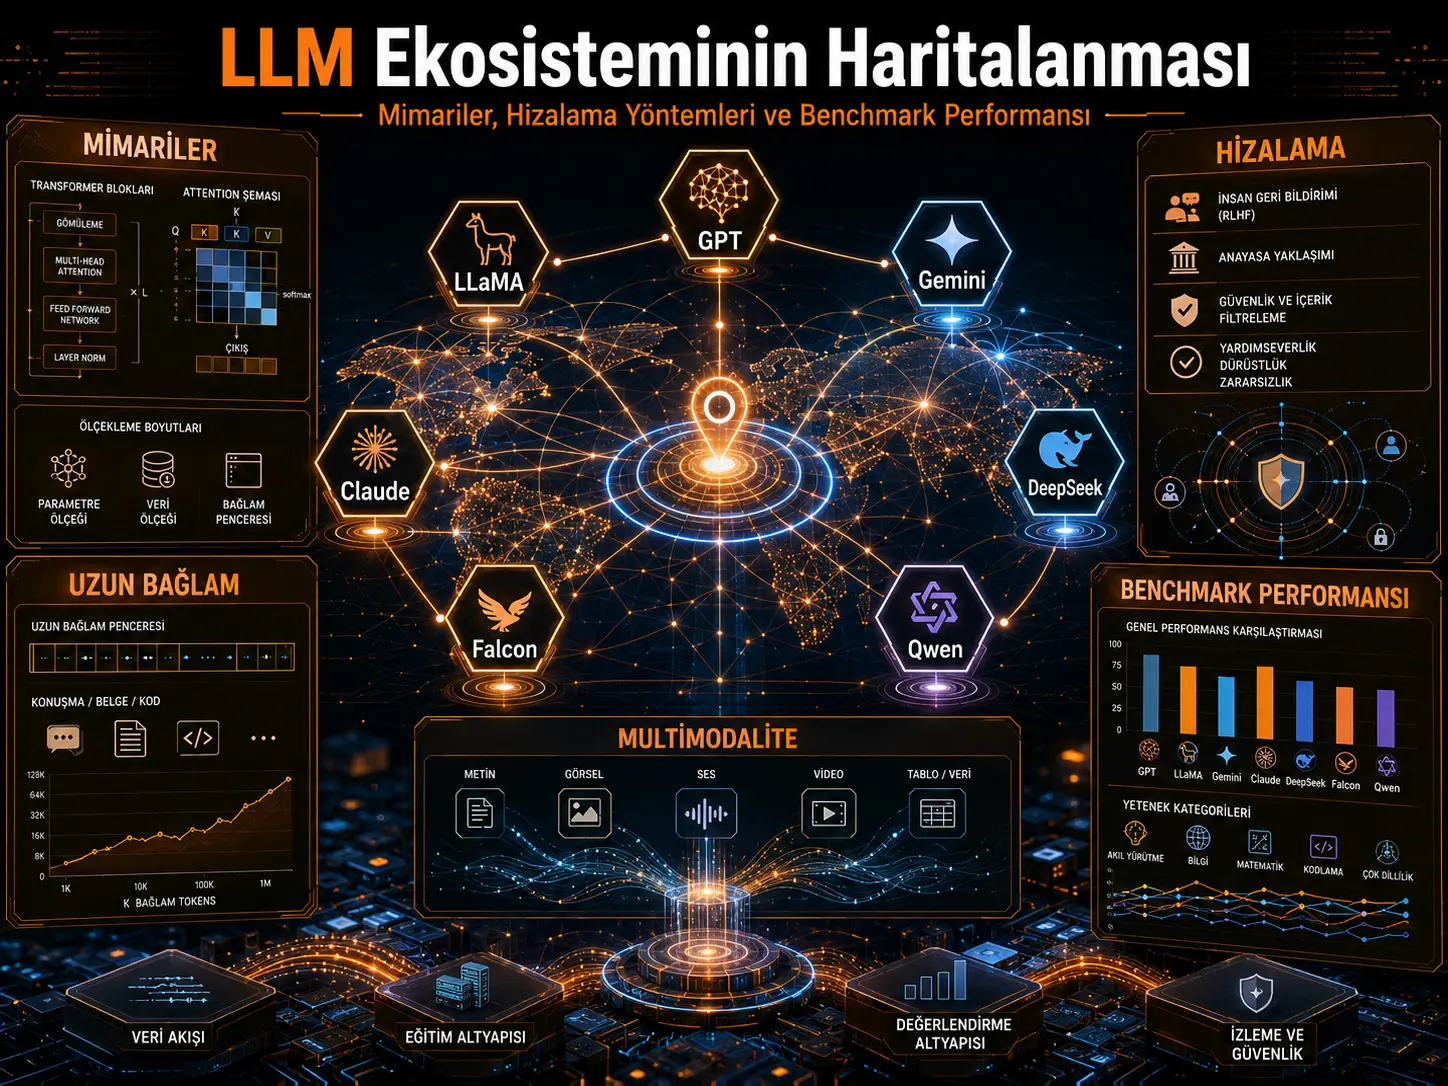
Miundo mikubwa ya lugha sasa haiendelei tu kama wazalishaji wa maandishi wenye vigezo vingi zaidi. Mifumo ya sasa inaundwa na muunganiko wa maamuzi mengi ya usanifu na mafunzo, kama vile jinsi utaratibu wa attention unavyohesabiwa, ni wataalamu gani huamilishwa, jinsi context yenye urefu wa mamia ya maelfu au mamilioni ya token inavyochakatwa, jinsi aina tofauti za data kama picha–sauti–video zinavyounganishwa, na jinsi mapendeleo ya binadamu pamoja na kanuni za usalama zinavyohamishiwa kwenye model. Utafiti huu wa mapitio unalenga kulinganisha familia saba kubwa za LLM, ambazo ni GPT, LLaMA 2, Gemini, Claude, DeepSeek, Falcon na Qwen, chini ya taksonomia ya pamoja.
Watafiti walitumia ripoti za kiufundi zilizo wazi kwa umma, model cards na nyaraka za model ili kujenga upya zaidi ya usanifu wakilishi 50 wa LLM; waliweka misimbo ya models kulingana na vipimo kama attention mechanism, normalization, positional encoding, dense au mixture-of-experts routing, usimamizi wa context, mkakati wa mafunzo, alignment na uwezo wa multimodal. Utafiti pia unatoa kiolesura cha LLM Model Explorer chenye msimbo wazi ili kuchunguza taksonomia hii kwa njia shirikishi.
Katika jedwali la kulinganisha la benchmark la makala, familia ya GPT-4/GPT-4o imeorodheshwa katika MMLU kwa %86,4 na GSM8K kwa %92,0; Gemini 1.5 katika HumanEval kwa %74,9; Claude 3.x katika SWE-bench kwa %49,0; na familia ya DeepSeek katika GSM8K kwa %89,4 na SWE-bench kwa %42,5. Hata hivyo, takwimu hizi hazikutolewa katika mzunguko mmoja wa benchmark wa pamoja. Zimekusanywa kutoka matoleo tofauti ya model, ripoti za wazalishaji, leaderboard, mbinu za prompting na protokali za tathmini. Kwa hiyo utafiti chanzo unaeleza wazi kuwa thamani hizo ni za kuashiria tu na haziwezi kulinganishwa moja kwa moja kikamilifu kati ya models.
Mchango mkuu wa utafiti si kutangaza LLM fulani kuwa “mshindi”, bali ni kufanya ionekane wazi ni katika mihimili gani ya usanifu miundo mikubwa ya lugha ya kisasa hutofautiana. Mwelekeo mkuu unaopendekezwa na mapitio ni pamoja na mpito kuelekea mifumo ya attention yenye ufanisi zaidi, utafutaji wa ukokotoaji wa moduli kwa context ndefu, kuenea kwa vipengele kama RoPE na RMSNorm katika models zenye uzito wazi, kukua kwa mifumo ya multimodal na mbinu za alignment kama RLHF, RLAIF au Constitutional AI kuwa za kati katika uendelezaji wa model.
Hata hivyo, baadhi ya hitimisho kali zinazotokana na taksonomia si sheria za usanifu zilizothibitishwa kwa majaribio. Hasa, hitimisho kwamba “models zote zenye context ndefu kuliko 32K hutumia sparse expert routing” haliendani na majedwali ya context ya GPT-4o na Claude ndani ya utafiti wenyewe. Maelezo yanayohusisha tofauti za benchmark na sifa fulani za usanifu pia yametokana na ulinganisho wa uchunguzi kati ya familia, si majaribio ya ablation yaliyodhibitiwa.
| Wigo wa utafiti | Muundo ulioripotiwa katika chanzo | Unapaswa kufasiriwa vipi? |
|---|---|---|
| Familia ya LLM | 7 | GPT, LLaMA 2, Gemini, Claude, DeepSeek, Falcon na Qwen |
| Usanifu ulioundwa upya | 50+ | Umejengwa upya katika kiwango cha juu kutoka nyaraka za kiufundi na model cards. |
| Mihimili mikuu ya kulinganisha | Usanifu, mafunzo, alignment, context, multimodality, usalama, benchmark | Imechunguzwa chini ya taksonomia ya pamoja. |
| Mbinu ya benchmark | Matokeo yaliyoripotiwa kutoka vyanzo vya pili | Si matokeo yaliyopimwa upya katika mazingira ya pamoja ya majaribio. |
| Zana shirikishi | LLM Model Explorer | Huwezesha kulinganisha sifa za taksonomia kwa msingi wa model. |
| Kikomo kikuu cha kisayansi | Hakuna ulinganisho wa usanifu wa kisababishi uliodhibitiwa | Mahusiano ya taksonomia huzalisha dhana; hayathibitishi usababishi. |
Kwa nini swali la “vigezo bilioni ngapi?” pekee halitoshi tena?
Katika vizazi vya awali vya miundo mikubwa ya lugha, ongezeko la kiwango lilikuwa moja ya mihimili mikuu ya maendeleo. Katika simulizi ya kihistoria ya utafiti, mabadiliko yanaelezwa kutoka mbinu ya mafunzo ya awali ya kiwango kikubwa ya GPT-2 mwaka 2019 hadi GPT-3 yenye vigezo bilioni 175, na baadaye kuibuka kwa models zenye context ndefu na multimodal.
Lakini kulingana na watafiti, eneo la usanifu wa LLM za kisasa haliwezi tena kupunguzwa kuwa mhimili mmoja wa ukubwa. Mifumo miwili yenye idadi ya vigezo inayokaribiana inaweza kuonyesha profaili tofauti sana za ukokotoaji na tabia kutokana na attention mechanism, idadi ya wataalamu hai, mbinu ya normalization, positional encoding, mchanganyiko wa data, instruction tuning, alignment au muundo wa multimodal encoder.
Utafiti unachunguza familia gani saba za model?
| Familia ya model | Models wakilishi zilizochunguzwa katika chanzo | Sifa kuu inayosisitizwa na utafiti |
|---|---|---|
| GPT | GPT-2, GPT-3/3.5, GPT-4, GPT-4o, O1 | Decoder-only Transformer, mafunzo ya awali ya kiwango kikubwa, multimodality na RLHF |
| LLaMA | LLaMA, LLaMA 2, Code LLaMA | RoPE, GQA, RMSNorm na ekosistemu yenye uzito wazi |
| Gemini | Gemini 1.x na Gemini 1.5 | Multimodality, context ndefu na muundo unaofafanuliwa katika chanzo kama MoE |
| Claude | Claude 2, Claude 3 na matoleo ya 3.5 | Context ndefu, Constitutional AI na RLAIF |
| DeepSeek | DeepSeek-V2/V3 na Reasoner/R1 | MLA, MoE na mafunzo yanayolenga reasoning |
| Falcon | Falcon 7B/40B/180B, Falcon 2, Falcon 3 na Mamba | Multi-query/multigroup attention na matoleo ya state-space |
| Qwen | Qwen, Qwen2 na Qwen-Max | RoPE, RMSNorm, SwiGLU, lugha nyingi na utaalamu wa code/hisabati |
Kwa nini mifumo ya attention hutofautiana?
Multi-head attention katika Transformer ya kawaida hutumia makadirio tofauti ya query, key na value kwa kila attention head. Katika models kubwa, hasa key–value cache hubadilika kuwa gharama muhimu ya kumbukumbu chini ya context ndefu na mzigo mkubwa wa watumiaji wa wakati mmoja.
Utafiti unasisitiza kuwa familia tofauti zimeleta suluhisho tofauti kwa tatizo hili. Katika LLaMA 2, Grouped Query Attention (GQA); katika familia ya Falcon na Qwen, multi-query au multigroup attention; na katika DeepSeek, mbinu kama Multi-Head Latent Attention (MLA) zinalenga kupunguza gharama hii.
Mbinu ya MLA ya DeepSeek inalenga kupunguza mzigo wa ukokotoaji na uhifadhi kwa kubana uwakilishi wa key–value kuwa maumbo ya latent yenye vipimo vya chini zaidi. Mbinu ya multi-query/multigroup ya Falcon pia inalenga kupunguza mzigo wa KV-cache kupitia kushirikisha zaidi makadirio ya key na value kati ya attention heads.
Mixture-of-Experts hutoa nini?
Katika mbinu ya Mixture-of-Experts (MoE), si vigezo vyote vya model huamilishwa kwa wakati mmoja kwa kila token. Utaratibu wa routing huchagua mitandao midogo ya wataalamu kulingana na ingizo. Hivyo, uwezo wa jumla wa model unapoongezeka, ukokotoaji hai kwa kila token unaweza kuwekwa chini kuliko jumla ya idadi ya vigezo.
Utafiti chanzo unahusisha mbinu hii hasa na mikakati ya kuongeza kiwango na context ndefu ya familia za Gemini na DeepSeek. Kwa DeepSeek-R1, dhidi ya jumla ya vigezo bilioni 671, taarifa ya takribani vigezo hai bilioni 37 kwa kila token hutolewa.
Hata hivyo, uwepo wa MoE peke yake hauwezi kukubaliwa kama sababu ya reasoning bora zaidi, context ndefu zaidi au performans ya benchmark ya juu zaidi. Mbinu ya routing, data ya mafunzo, idadi ya wataalamu hai, usanifu wa attention na mchakato wa post-training huathiri matokeo kwa pamoja.
Kwa nini Falcon Mamba ni tofauti?
Falcon Mamba 7B ni mojawapo ya tofauti muhimu za usanifu katika utafiti kwa sababu hutumia model ya Mamba state-space badala ya self-attention ya kawaida. Chanzo kinaeleza kuwa hii inalenga uchakataji wa wakati wa mstari katika mfululizo mrefu na tabia ya kumbukumbu iliyo takribani thabiti.
Kuwepo pamoja kwa mbinu za Transformer na state-space katika familia ya Falcon 3 kunaonyesha kuwa maendeleo ya LLM ya kisasa sasa hayajumuishi tu tofauti ndani ya Transformer, bali pia usanifu wa mfululizo mrefu nje ya attention.
Kwa nini RMSNorm, RoPE na SwiGLU huonekana mara nyingi?
Katika taksonomia ya utafiti, vipengele vitatu vinaonekana kujirudia mara nyingi katika sehemu ya familia za model zenye uzito wazi: RMSNorm, Rotary Positional Embedding (RoPE) na SwiGLU.
RMSNorm hurahisisha gharama ya normalization; RoPE hubeba taarifa ya nafasi ya jamaa ndani ya attention mechanism. SwiGLU hutumia muundo wa gated activation. Utafiti unachukulia LLaMA 2 na Qwen kama mifano dhahiri ya vipengele hivi.
Nini hubadilika katika models za multimodal?
Ili kuchakata taarifa nje ya maandishi, kama picha, sauti na video, haitoshi kwa model kuwa na tokenizer moja tu na language decoder. Katika utafiti, Gemini, GPT-4o na Claude 3 zinachunguzwa kama mifano tofauti ya mabadiliko haya.
Katika mchoro wa usanifu wa Gemini, aina tofauti za data zinaonyeshwa kuchakatwa kupitia modality-specific encoders na kuhamishiwa kwenye nafasi ya pamoja ya latent kupitia cross-modal attention. Utafiti unachukulia GPT-4o kama muundo wa pamoja wa multimodal unaoweza kuchakata maandishi, code, picha, sauti na video.
Alignment: RLHF hufanya nini?
Reinforcement Learning from Human Feedback (RLHF) ni mojawapo ya mbinu za post-training zinazotumika ili model iliyofunzwa awali itoe matokeo yanayolingana zaidi na mapendeleo ya binadamu badala ya kuboresha tu uwezekano wa token inayofuata.
Utafiti chanzo unaeleza kuwa aina mbalimbali za supervised fine-tuning na preference optimization hutumiwa katika familia kama GPT-4, LLaMA 2, Claude, DeepSeek na Qwen.
Hata hivyo, waandishi wanasisitiza kuwa RLHF haitatui usalama kwa uhakika. Feedback ya binadamu ni ghali; reward hacking inaweza kutokea; mafunzo ya usalama yanaweza kusababisha tabia ya kukataa kupita kiasi, na hatari za jailbreak au adversarial prompting hazitoweki kabisa.
Constitutional AI na RLAIF ni nini?
Familia ya Claude inachukuliwa katika utafiti kama kategoria tofauti kwa upande wa mbinu ya alignment. Katika Constitutional AI, lengo ni model kukosoa na kupanga upya matokeo yake ndani ya mfumo wa kanuni fulani. Reinforcement Learning from AI Feedback (RLAIF) inahusisha kusaidia sehemu ya tathmini ya binadamu kwa feedback inayotolewa na AI.
Waandishi wa chanzo wanaeleza kuwa mbinu hii inaweza kupunguza utegemezi kwa annotation ya binadamu, lakini feedback ya AI ina hatari ya kuzalisha upya upendeleo unaotokana na model.
Mifumo mitatu mikuu ya taksonomia
Baada ya kuiweka familia saba za model katika vipimo vya pamoja, makala inapendekeza mifumo mitatu ya kuvuka familia.
| Muundo wa chanzo | Mihimili iliyolinganishwa | Hitimisho la waandishi | Kikomo cha tafsiri cha Verianla |
|---|---|---|---|
| A — Alignment–Efficiency Divergence | Mkakati wa alignment × uboreshaji wa attention | Inapendekezwa kuwa alignment ya kina na ufanisi wa juu zaidi wa attention havionekani pamoja katika model ileile. | Si jaribio la performans lililodhibitiwa katika mihimili miwili iliyofafanuliwa kwa kipimo. |
| B — Context–Routing Co-Adoption | Urefu wa context × expert routing | Inapendekezwa kuwa models zenye context ya >32K hutumia sparse/modular routing. | Kauli ya jumla haiendani na majedwali ya GPT-4o na Claude ya chanzo. |
| C — Open-Weight Convergence | Uwazi × normalization × positional encoding | Inapendekezwa kuwa models zenye uzito wazi hukusanyika kuzunguka RMSNorm + RoPE. | Hakuna kiwango sawa cha uwazi wa kiufundi kwa matoleo yote ndani ya familia ya model. |
Kwa nini kutokulingana kwa ndani katika Pattern B ni muhimu?
Maandishi ya Pattern B katika utafiti yanasema kuwa “kila model” kati ya models zilizochunguzwa inayotoa context window ndefu kuliko 32K hutumia sparse expert routing au tabaka za selective state-space.
Hata hivyo, jedwali la kulinganisha katika chanzo hicho hicho linaripoti kwa GPT-4/GPT-4o 128K na kwa Claude 2/3 100K–200K context window. Katika muhtasari wa usanifu wa familia hizi mbili, sparse MoE au selective state-space routing haijaonyeshwa.
Kwa hiyo data ndani ya chanzo inaweza kuunga mkono tafsiri ya “kuonekana pamoja kwa context ndefu na ukokotoaji wa moduli katika baadhi ya familia”; lakini haiungi mkono, kupitia majedwali yake yenyewe, hitimisho kwamba “models zote zilizo juu ya 32K hutumia hili”.
Je, “model wazi” na “open source” ni kitu kimoja?
Katika utafiti chanzo, models hushughulikiwa katika kategoria tofauti kama zilizofungwa, zenye uzito wazi, zilizo wazi kiasi au zenye leseni ya utafiti. Tofauti hii ni muhimu. Kuchapishwa kwa uzito wa model hakumaanishi kuwa data ya mafunzo, code kamili ya mafunzo, mnyororo wa post-training na mfumo mzima wa usalama viko wazi.
Kwa hiyo, wakati wa kusoma kauli ya “open-source ecosystem” katika utafiti, ni lazima izingatiwe kuwa kiwango halisi cha uwazi kinaweza kutofautiana kwa kila familia.
Kwa nini matokeo ya benchmark si jedwali moja la ligi?
Tablo 2 ya makala inaweka benchmark tano sambamba: MMLU, HumanEval, GSM8K, SWE-bench na MathVista. Lakini seli zote za jedwali hazijapimwa chini ya toleo lilelile la model, tarehe ileile, mkakati uleule wa prompting au evaluation harness ileile.
Zaidi ya hayo, katika baadhi ya safu, jedwali haliwakilishi model moja bali matoleo kadhaa ndani ya familia moja kwa pamoja: kama “GPT-4/GPT-4o”, “Claude 3.x (Opus/Sonnet)”, “Gemini 1.5 (Pro/Ultra)” au “DeepSeek (V3/Reasoner)”.
Kwa hiyo haipaswi kudhaniwa kuwa score ya MMLU katika safu moja na score ya SWE-bench katika safu hiyo hiyo lazima zimetoka kwenye checkpoint ileile au toleo lilelile la model.
Tofauti kati ya benchmark za mtengenezaji na za kujitegemea
Utafiti unaeleza kuwa kunaweza kuwa na tofauti kati ya matokeo yanayoripotiwa na watengenezaji na tathmini huru, na kwamba score za watengenezaji zinaweza kuwa juu kwa takribani pointi 2–8 za asilimia katika MMLU, na katika benchmark mpya zaidi kama GPQA-Diamond na SWE-bench zinaweza kuwa juu kwa takribani pointi 10–15 katika baadhi ya hali.
Waandishi wanaeleza kuwa hii inaweza kutokana na mbinu ya prompting, programu ya tathmini, toleo la model na uwezekano wa evaluation-set contamination. Hata hivyo, jedwali la data ghafi la vipimo vyote vilivyooanishwa vinavyounda tofauti hizi za pointi 2–8 na 10–15 halijatolewa katika makala. Kwa hiyo vipindi hivi havipaswi kutathminiwa kama matokeo ya meta-analysis huru.
Matokeo yanayoungwa mkono na utafiti
- Familia za LLM za kisasa, ingawa zinatoka kwenye msingi mmoja wa Transformer, hutofautiana kwa kiasi kikubwa katika vipimo vya attention, normalization, routing, context, multimodality na alignment.
- Mbinu za GQA, MQA, MLA, FlashAttention, MoE na state-space hutoa suluhisho tofauti za kiufundi kwa masuala ya ufanisi na uchakataji wa mfululizo mrefu katika models za kiwango kikubwa.
- RLHF si mbinu pekee ya alignment; mbinu mbadala au za kukamilisha kama Constitutional AI na RLAIF pia hutumiwa.
- Ekosistemu za uendelezaji wa model zenye uzito wazi na zilizofungwa zina trade-off tofauti katika uwazi, uwezo wa kurudiwa, gharama na uhandisi wa usalama.
- Uteuzi wa model unapaswa kufanywa si kwa score ya benchmark pekee, bali pia kulingana na eneo la matumizi, hitaji la context, multimodality, gharama, usalama na masharti ya usambazaji.
- Kulinganisha moja kwa moja matokeo ya benchmark bila taarifa ya toleo la model na protokali ya tathmini si jambo la kuaminika.
Matokeo ambayo utafiti hauyathibitishi
- Haijathibitishwa kuwa familia moja ya LLM ndiyo bora kabisa kwa kila kazi.
- Thamani za Tablo 2 si ulinganisho wa model kwa model uliopatikana katika jaribio la pamoja lililodhibitiwa.
- Haijathibitishwa kuwa tofauti ya benchmark imetokana tu na attention mechanism moja, MoE au mbinu ya alignment.
- Haijaonyeshwa kwa majaribio kuwa Constitutional AI hutengeneza trade-off ya kimwili ya lazima na ufanisi wa attention.
- Data ya chanzo haithibitishi kuwa sparse expert routing ni sharti la lazima kwa context ndefu.
- Haiwezi kuhitimishwa kuwa models zenye uzito wazi kwa ujumla ni salama zaidi au si salama zaidi kuliko models zilizofungwa.
- Performans ya juu katika benchmark si dhamana ya uaminifu wa dunia halisi, factuality au matumizi salama.
Ina maana gani kwa mtazamo wa Uturuki?
Utafiti haufanyi ulinganisho wa LLM mahsusi kwa Uturuki na hautoi matokeo ya benchmark ya Kituruki kama kundi tofauti la majaribio. Kwa hiyo haiwezi kudhaniwa kuwa model inayoonyesha matokeo ya juu katika jedwali itaonyesha performans hiyo hiyo katika matumizi ya Kituruki katika sheria, afya, elimu, viwanda au sekta ya umma.
Ikiwa shirika nchini Uturuki litachagua model, taksonomia hii inaweza kutumika kama zana ya uchujaji wa awali wa usanifu; lakini performans ya lugha ya Kituruki, istilahi za kikoa, mahali pa data, ulinzi wa data binafsi, ucheleweshaji, gharama, mahitaji ya kuhifadhi ndani ya shirika na matukio ya matumizi ya ndani yanapaswa kupimwa kando. Uthibitishaji huu wa ndani si uchambuzi uliofanywa na utafiti chanzo.
Mbinu na Matokeo ya Utafiti
Je, utafiti huu ni mapitio ya kimfumo ya kawaida?
Makala ni utafiti mpana wa mapitio na taksonomia; hata hivyo, katika maandishi ya chanzo hakuna protokali ya utafutaji wa fasihi ya kimfumo kama PRISMA, misururu ya utafutaji wa hifadhidata iliyowekwa mapema, mchoro wa mtiririko wa kujumuisha/kutoa au meta-analysis ya ubora wa tafiti.
Waandishi wanaegemeza uteuzi wa model kwenye vigezo vitatu:
- upatikanaji wa nyaraka za kiufundi,
- anuwai ya usanifu,
- umuhimu kwa upande wa utafiti na matumizi ya viwanda.
Kwa vigezo hivi, familia za GPT, LLaMA 2, Gemini, Claude, DeepSeek, Falcon na Qwen zilichaguliwa.
Usanifu ulijengwa upya vipi?
Waandishi walijenga upya michoro ya usanifu wa models kutoka ripoti za kiufundi zilizo wazi kwa umma, system cards na nyaraka za model. Kwa kuwa hasa maelezo ya implementation ya mifumo iliyofungwa hayajachapishwa, michoro iliwekwa katika kiwango cha juu na kiwango cha pamoja cha abstraction.
Vipimo vikuu vya usanifu vilivyotathminiwa ni hivi:
- Multi-Head Attention (MHA), Grouped Query Attention (GQA), Multi-Query Attention (MQA) na Multi-Head Latent Attention (MLA),
- LayerNorm na RMSNorm,
- dense na mixture-of-experts routing,
- context handling na positional encoding,
- alignment na training pipeline.
Taksonomia iliundwaje?
Kila model iliwakilishwa na vekta ya sifa inayoundwa na vipengele vya kategoria na vya nambari. Utafiti unaeleza kuwa ni sifa zilizopo tu katika nyaraka wazi ndizo ziliwekewa msimbo, na pale taarifa zilipokuwa haziko wazi, “conservative labeling” ilitumika ili kuepuka ufafanuzi wa kupita kiasi.
Kisha vipimo vya taksonomia vililinganishwa kupitia mahusiano ya jozi au mengi. Kwa mfano, mbinu ya alignment ilichunguzwa pamoja na ufanisi wa attention; context length pamoja na expert routing; na uwazi wa model pamoja na normalization na positional encoding.
Verianla Live: Mchakato wa kuunda taksonomia ya LLM
Mchakato huu unategemea metodolojia katika sehemu ya 3.1 ya utafiti chanzo. Mifumo ya kimuundo katika hatua ya “Matokeo” si usababishi wa majaribio uliodhibitiwa, bali ni makisio yaliyotokana na taksonomia ya kulinganisha.
| Hatua | Operesheni katika utafiti chanzo |
|---|---|
| 1. Uteuzi wa familia ya model | Familia saba zilichaguliwa kwa vigezo vya nyaraka, anuwai ya usanifu na umuhimu wa utafiti/viwanda. |
| 2. Ukusanyaji wa vyanzo vya kiufundi | Ripoti za kiufundi, system cards na nyaraka za model zilitumika. |
| 3. Ujenzi upya wa usanifu | Zaidi ya usanifu wakilishi 50 ulijengwa upya katika kiwango cha pamoja cha abstraction. |
| 4. Uwekaji msimbo wa sifa | Vipimo vya attention, normalization, routing, context, positional encoding, training na alignment viliwekewa msimbo. |
| 5. Ulinganisho kati ya familia | Mahusiano ya jozi na mengi ya vipimo vya taksonomia yalichunguzwa. |
| 6. Kuhusisha na benchmark | Mifumo ya taksonomia ililinganishwa na matokeo ya benchmark yaliyoripotiwa katika vyanzo. |
| 7. Uzalishaji wa dhana | Mifumo ya alignment–efficiency, context–routing na open-weight convergence ilipendekezwa. |
Jedwali la benchmark la chanzo
Thamani zilizo hapa chini zimechukuliwa kutoka Tablo 2 ya makala. Onyo la utafiti chanzo linapaswa kuhifadhiwa: kwa kuwa matokeo yanatoka katika vyanzo na protokali tofauti, si upangaji wa moja kwa moja na wa uhakika wa models.
| Familia ya model | MMLU (%) | HumanEval Pass@1 (%) | GSM8K (%) | SWE-bench Pass@1 (%) | MathVista (%) |
|---|---|---|---|---|---|
| GPT-4 / GPT-4o | 86,4 | 67,0 | 92,0 | 33,2 | 63,8 |
| Claude 3.x (Opus/Sonnet) | 82,1 | 60,1 | 88,0 | 49,0 | 60,5 |
| Gemini 1.5 (Pro/Ultra) | 81,9 | 74,9 | 87,8 | 35,0 | 59,2 |
| LLaMA 2 (70B) | 68,9 | 48,1 | 56,8 | 18,0 | 44,1 |
| Falcon (180B/Falcon 2) | 66,5 | 45,2 | 55,4 | 15,3 | 41,6 |
| DeepSeek (V3/Reasoner) | 79,8 | 72,6 | 89,4 | 42,5 | 61,2 |
| Qwen (Qwen2/Qwen-Max) | 78,5 | 65,3 | 83,7 | 36,4 | 58,1 |
Maana ya benchmark
| Benchmark | Kusudi la matumizi katika utafiti |
|---|---|
| MMLU | Performans ya jumla ya model ya lugha katika nyanja tofauti za maarifa na matatizo |
| HumanEval | Performans ya upangaji programu/uzalishaji wa code |
| GSM8K | Utatuzi wa matatizo ya maneno ya kihisabati |
| SWE-bench | Uwezo wa kuandika code kwenye matatizo halisi ya uhandisi wa programu |
| MathVista | Kazi zinazochanganya reasoning ya kuona na ya kihisabati |
Ulinganisho wa context na multimodality wa familia za model
| Familia | Context iliyoripotiwa katika chanzo | Muundo wa multimodal | Alignment / usalama |
|---|---|---|---|
| GPT-4 / GPT-4o | 128K GPT-4o | Maandishi, picha, sauti, video | SFT, RLHF, PPO, moderation na vichujio vya maudhui |
| GPT-O1 | 8K–32K | Maandishi | SFT, RLHF na models za reward zinazolenga reasoning |
| LLaMA 2 | 4K | Maandishi | SFT, RLHF, Ghost Attention na models za safety reward |
| Gemini 1.5 | hadi 1M | Maandishi, picha, sauti, video, code | RLHF, expert gating na moderation |
| Claude 2/3 | 100K–200K | Maandishi; picha katika Claude 3 | Constitutional AI, RLAIF, self-critique na red teaming |
| Falcon | 4K–32K | Familia ya msingi ni maandishi; toleo la VLM katika Falcon 2 | Safety classifier na alignment inayotegemea LoRA |
| DeepSeek R1/V3 | 32K–128K | Kimsingi maandishi katika utafiti | GRPO, SFT, data sintetiki, rejection sampling |
| Qwen | 32K+ | Maandishi katika jedwali la kulinganisha la utafiti | SFT, RLHF, preference optimization na bias mitigation |
Maelezo ya taksonomia kwa tofauti za benchmark
Tablo 6 ya utafiti chanzo inahusisha tofauti tatu za mfano za benchmark na vipimo vya usanifu:
| Benchmark | Familia A | Familia B | Tofauti ya score | Vipimo vya taksonomia vinavyohusishwa na chanzo |
|---|---|---|---|---|
| GSM8K | DeepSeek-V3: %89,4 | LLaMA 2: %56,8 | +32,6 pointi za asilimia | MLA/GQA, MTP/next-token prediction, rejection-sampled RL/Ghost Attention RLHF |
| SWE-bench | Claude 3.x: %49,0 | GPT-4o: %33,2 | +15,8 pointi za asilimia | Constitutional AI + RLAIF/RLHF-PPO na 200K/128K context |
| HumanEval | Gemini 1.5: %74,9 | LLaMA 2: %48,1 | +26,8 pointi za asilimia | MoE/dense Transformer na 1M/4K context |
Jedwali hili si jaribio la moja kwa moja la mechanism. Katika kila ulinganisho, familia za model pia hutofautiana katika vigezo vingine vingi, pamoja na data, vigezo, post-training, toleo la model na evaluation protocol. Utafiti chanzo unakubali hili wazi na kusema kuwa uchambuzi huunda “structured explanatory hypotheses”, si usababishi.
Kwa nini hitimisho la alignment–efficiency liko katika kiwango cha dhana?
Waandishi wanafasiri kuonekana pamoja kwa kina cha Constitutional AI/RLAIF katika Claude na attention isiyoboreshwa sana kwa ufanisi, pamoja na matumizi ya njia rahisi zaidi za alignment katika familia kama DeepSeek, Falcon na Gemini ambazo zinatilia mkazo ufanisi wa attention, kama trade-off.
Hata hivyo, katika utafiti hakuna score ya pamoja ya kiasi iliyofafanuliwa kwa “alignment depth” na “attention efficiency”; wala hakuna ablation iliyodhibitiwa iliyofanywa kwa kubadilisha tu mbinu ya alignment au tu mbinu ya attention kwenye model ileile. Kwa hiyo uhusiano huu ni uchunguzi wa kitaksonomia wa utafiti; haujathibitishwa kama ulazima wa kikokotoaji.
Kutokulingana kwa ndani ya chanzo katika hitimisho la Context–routing
Sentensi kuu ya Pattern B inapendekeza kuwa kila model inayotumia context window kubwa kuliko 32K hutumia sparse expert routing au selective state-space layer.
Lakini katika jedwali la kulinganisha la makala hiyo hiyo:
- GPT-4o kwa 128K context,
- Claude 2/3 kwa 100K–200K context
zinaripotiwa, ingawa maelezo ya usanifu wa familia hizi hayatoi MoE au selective SSM routing.
Kwa hiyo ujanibishaji wa “every >32K-context model” hauko thabiti ndani ya chanzo. Katika makala hii ya Verianla, muundo husika umehamishwa tu kama dhana inayopendekezwa na waandishi.
Muunganiko wa models zenye uzito wazi
Kulingana na hitimisho la Pattern C la utafiti, mifumo iliyo wazi/zenye uzito wazi kama LLaMA 2, Falcon na Qwen hukusanyika zaidi kuzunguka vipengele vinavyojulikana vizuri kama RoPE na RMSNorm, ilhali models zilizofungwa hutawanyika katika maeneo ya usanifu yenye utofauti zaidi.
Waandishi wanahusisha hili na upendeleo wa vipengele vinavyoweza kurudiwa na kuthibitishwa katika jumuiya za model wazi. Hata hivyo, kwa kuwa hasa maelezo ya usanifu wa models zilizofungwa ni finyu, nafasi halisi yote ya usanifu wa mifumo iliyofungwa haiwezi kuzingatiwa. Hitimisho hili pia linapaswa kutathminiwa kama tafsiri ya taksonomia ya kulinganisha, si kama mechanism ya kisababishi iliyothibitishwa.
Matokeo kwa biashara na jamii
Kulingana na utafiti, LLM zinaweza kuwa na uwezo wa kuongeza tija katika kazi zinazotegemea maarifa kama uandaaji wa nyaraka, uzalishaji wa code, uchambuzi wa data na huduma kwa wateja, huku pia zikiweza kuunda hatari kama uzalishaji wa maudhui yaliyo fasaha lakini yenye makosa, kupungua kwa usimamizi wa binadamu na kuamini kupita kiasi matokeo yasiyo sahihi.
Katika elimu, fursa za feedback iliyobinafsishwa zinajadiliwa pamoja na masuala ya uadilifu wa kitaaluma na fikra tunduizi. Tofauti za performans katika lugha zenye rasilimali chache zinaonyesha kuwa si usanifu pekee, bali pia wigo wa data na uwakilishi wa kitamaduni huathiri tabia ya model.
Mada za utafiti wa baadaye katika utafiti huu
- Tathmini ya LLM iliyosanifiwa na inayoweza kurudiwa,
- cross-lingual generalization katika lugha zenye rasilimali chache na context za kitamaduni,
- context ndefu na models za memory-augmented,
- michanganyiko ya state-space na attention–memory,
- model cards, data sheets na mifumo ya bias audit,
- red teaming na utoaji taarifa wa usalama ulio wazi zaidi,
- kupunguza gharama za ukokotoaji na nishati,
- asili ya data, mali miliki, faragha na haki ya uwakilishi.
Maelezo ya Chanzo na Mbinu
| Jina kamili la kazi asili | Mapping the LLM Landscape: A Cross-Family Survey of Architectures, Alignment Methods, and Benchmark Performance |
|---|---|
| Waandishi | Deepshikha Bhati; Fnu Neha; Devi Sri Bandaru; Matthew Weber; Ishan Dilipbhai Gajera |
| Mpangilio wa waandishi | 1. Deepshikha Bhati; 2. Fnu Neha; 3. Devi Sri Bandaru; 4. Matthew Weber; 5. Ishan Dilipbhai Gajera |
| Mchango sawa / mwandishi wa kwanza sawa | Hakuna tamko la mchango sawa au mwandishi wa kwanza sawa lililotajwa katika utafiti chanzo. |
| Mwandishi anayewajibika | Deepshikha Bhati |
| Taasisi | Department of Computer Science, Kent State University, Kent, Ohio, Marekani |
| Aina ya chanzo | Mapitio ya kulinganisha, taksonomia ya usanifu na uchunguzi wa familia za model za LLM. |
| Hali ya uhakiki | Ni makala ya mapitio iliyochapishwa katika jarida lenye uhakiki wa rika; si preprint. |
| Jarida | AI |
| Mchapishaji | MDPI |
| Juzuu / toleo / makala | 2026, 7(4), 142 |
| DOI | 10.3390/ai7040142 |
| Tarehe ya kupokelewa | 11 Machi 2026 |
| Tarehe ya marekebisho | 7 Aprili 2026 |
| Tarehe ya kukubaliwa | 11 Aprili 2026 |
| Tarehe ya kuchapishwa | 16 Aprili 2026 |
| Kiungo rasmi | https://doi.org/10.3390/ai7040142 |
| Leseni | Creative Commons Attribution (CC BY). |
Hali ya data na uchambuzi wa utafiti
Utafiti huu haufunzi LLM mpya ya msingi na haubenchmark upya familia saba za model katika miundombinu ya pamoja ya ukokotoaji. Chanzo kikuu cha data ya kisayansi ni ripoti za kiufundi zilizo wazi kwa umma, system cards, nyaraka za model na vyanzo vya benchmark.
Waandishi wamejenga upya zaidi ya usanifu 50 wa model kutoka nyaraka hizi katika kiwango cha pamoja cha abstraction, wameweka misimbo ya sifa zake na kuziweka katika hali ya kulinganishwa sambamba ndani ya programu ya LLM Model Explorer.
Kulingana na tamko la upatikanaji wa data la makala, data iliyotumika katika uchambuzi imewasilishwa ndani ya maandishi kuu. Msimbo wa chanzo na anwani za onyesho hai za LLM Model Explorer iliyotengenezwa na utafiti pia zimeshirikishwa katika sehemu ya mbinu ya makala.
Ufadhili
Utafiti uliungwa mkono kwa sehemu na programu ya Open Access APC Support Fund ya Kent State University.
Bodi ya maadili na ridhaa iliyoarifiwa
Katika utafiti chanzo, sehemu za Institutional Review Board na informed consent ziliripotiwa kama “Not applicable”. Utafiti haujumuishi jaribio jipya kwa washiriki binadamu au ukusanyaji wa data ya kliniki.
Migongano ya maslahi
Waandishi waliripoti kuwa hakuna mgongano wa maslahi.
Michango ya waandishi
Uundaji wa dhana: Deepshikha Bhati na Devi Sri Bandaru. Metodolojia: Deepshikha Bhati na Devi Sri Bandaru. Uthibitishaji: Deepshikha Bhati, Fnu Neha na Devi Sri Bandaru. Uchambuzi rasmi: Deepshikha Bhati na Devi Sri Bandaru. Mapitio na uhariri: Deepshikha Bhati, Fnu Neha, Devi Sri Bandaru, Matthew Weber na Ishan Dilipbhai Gajera.
Vikwazo vikuu vya kimetodolojia vya utafiti
- Familia za model zilichaguliwa kwa vigezo vya nyaraka, anuwai na umuhimu badala ya protokali ya utafutaji wa fasihi ya kimfumo iliyofafanuliwa mapema.
- Kwa kuwa maelezo ya usanifu na mafunzo ya models zilizofungwa hayajafichuliwa kikamilifu, michoro iliyojengwa upya ni abstractions za kiwango cha juu.
- Si maelezo yote ya implementation ya zaidi ya usanifu 50 yanaweza kuthibitishwa kwa kujitegemea.
- Score za benchmark hazijahesabiwa upya kwa kutumia evaluation harness moja ya pamoja.
- Baadhi ya safu za benchmark zinawakilisha pamoja matoleo kadhaa ndani ya familia moja badala ya model moja.
- Chanzo cha matokeo ya vendor-reported na independent benchmark hakijatenganishwa kwa kiwango cha seli katika jedwali moja.
- Matokeo ya benchmark yanaweza kutofautiana kulingana na prompting, toleo la model, tarehe na protokali ya tathmini.
- Mahusiano kati ya vipimo vya taksonomia ni ya uchunguzi/kulinganisha; jaribio la ablation lililodhibitiwa halijafanywa.
- Usababishi hauwezi kutolewa kutoka mahusiano ya Architecture–benchmark.
- Hakuna index ya pamoja ya kiasi iliyofafanuliwa kwa alignment depth na attention efficiency.
- Hitimisho kwamba “models zote zenye context ndefu kuliko 32K hutumia expert routing” haliendani na taarifa za context za GPT-4o na Claude katika makala hiyo hiyo.
- Tafsiri kuhusu muunganiko wa models zenye uzito wazi kuelekea RMSNorm + RoPE haitegemei kiwango sawa cha nyaraka kwa matoleo yote ya model ndani ya familia.
- Utafiti chanzo unachora ramani ya eneo la teknolojia linalobadilika haraka ndani ya kipindi maalumu cha tarehe; taksonomia haiwakilishi moja kwa moja vizazi vya model vya baadaye.
Rekodi wazi ya kutokulingana muhimu ndani ya chanzo
Katika hitimisho la Pattern B la chanzo, inadaiwa kuwa kwa “every model in our survey supporting context windows exceeding 32K tokens” kuna sparse expert routing au mbinu ya selective state-space. Kinyume chake, jedwali la kulinganisha la utafiti huo huo linatoa kwa GPT-4o 128K na kwa Claude 2/3 100K–200K context window, lakini halionyeshi miundo hiyo ya routing kwa familia hizi mbili. Kwa hiyo sentensi ya Pattern B yenye tabia ya jumla haiendani na taarifa nyingine ndani ya chanzo.
Kwa Pattern A na maelezo ya performans ya benchmark pia, uhakika wa kisababishi haupaswi kutumiwa kwa namna hiyo hiyo. Utafiti wenyewe unasema kuwa uchambuzi husika hauundi causality wakati unaeleza tofauti za benchmark.
Kwa hiyo mchango wenye nguvu zaidi wa utafiti si kutoa jibu la uhakika kwa swali “LLM ipi ni bora zaidi?”. Mchango mkuu ni kuweka vipimo vya usanifu, mafunzo, alignment, context, multimodality na uwazi vya familia za miundo mikubwa ya lugha ndani ya fremu moja ya kulinganisha; na kubadilisha usanifu uliorejeshwa kutoka nyaraka za model kuwa taksonomia inayoweza kuchunguzwa na zana shirikishi.
Maelezo ya kisayansi ya usanifu, thamani za kulinganisha, hitimisho na vikwazo katika maandishi haya ya Verianla yanategemea utafiti chanzo uliopakiwa. Nje ya utambulisho wa bibliografia na hali ya uhakiki, hakuna matokeo mapya ya performans ya LLM kutoka vyanzo vya nje yaliyoongezwa kwenye maandishi kuu ya kisayansi.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *