

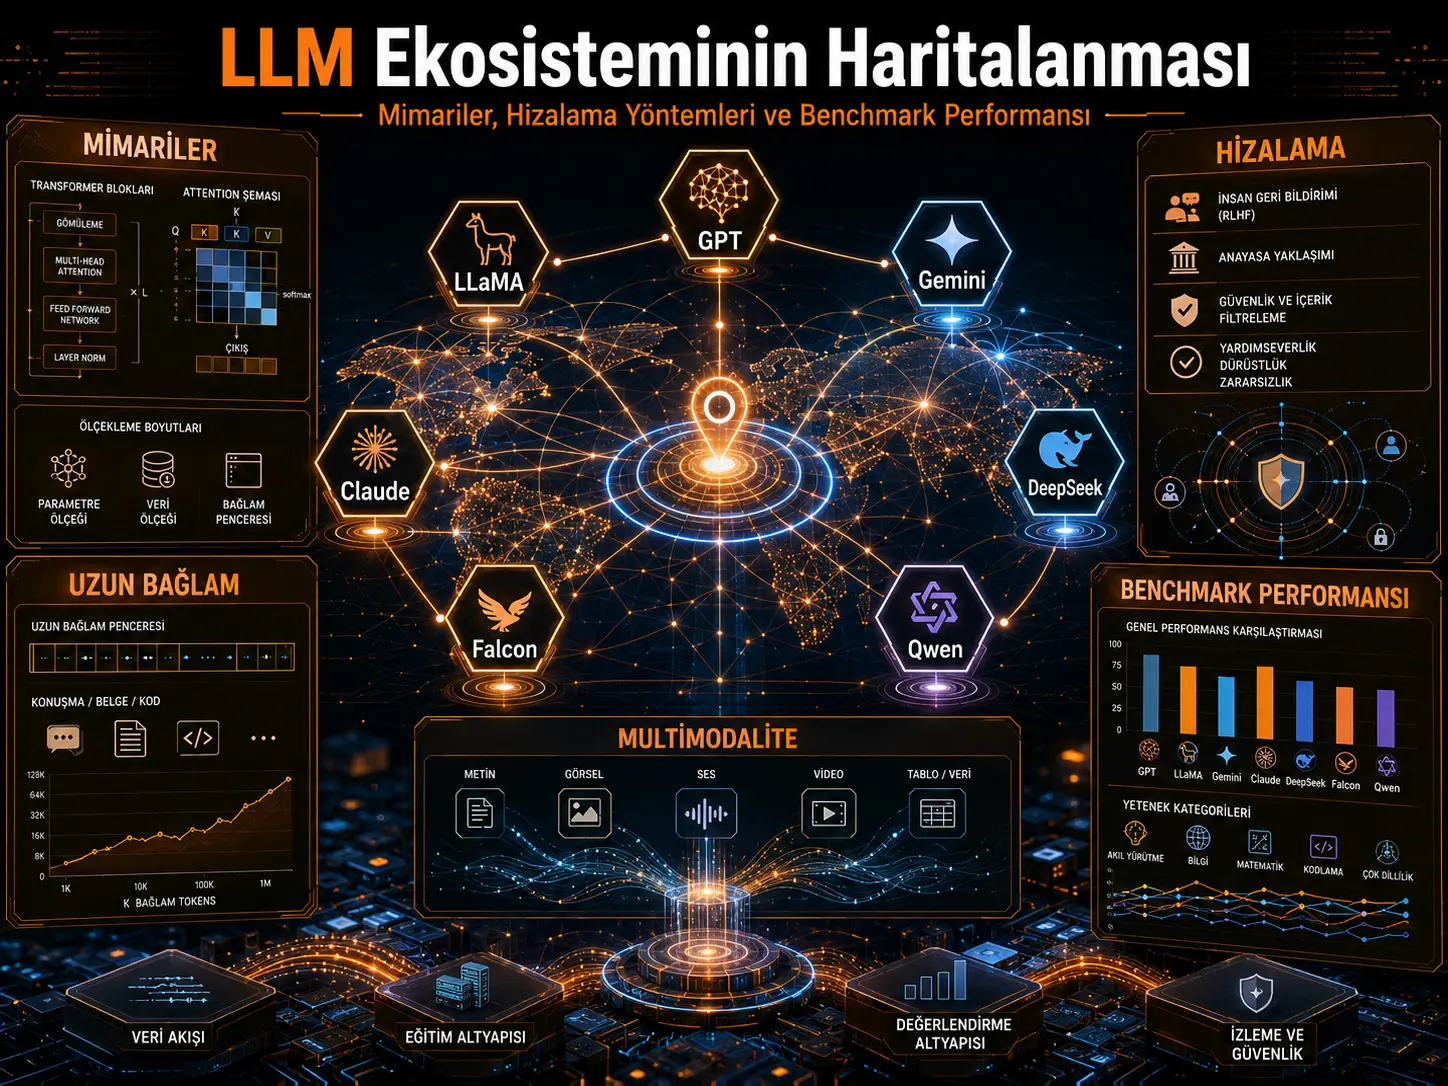
Böyük dil modelləri artıq yalnız daha çox parametrə malik mətn istehsalçıları kimi inkişaf etmir. Müasir sistemlər; diqqət mexanizminin necə hesablandığı, hansı mütəxəssislərin aktivləşdirildiyi, yüz minlərlə və ya milyonlarla token uzunluğundakı kontekstin necə emal edildiyi, görüntü–səs–video kimi fərqli məlumat növlərinin necə birləşdirildiyi və insan üstünlükləri ilə təhlükəsizlik qaydalarının modelə necə ötürüldüyü kimi çoxsaylı arxitektura və təlim qərarlarının birləşməsindən ibarətdir. Bu icmal tədqiqatı GPT, LLaMA 2, Gemini, Claude, DeepSeek, Falcon və Qwen olmaqla yeddi böyük LLM ailəsini ortaq bir taksonomiya altında müqayisə etməyi məqsəd qoyur.
Tədqiqatçılar açıq texniki hesabatlardan, model kartlarından və model sənədlərindən istifadə edərək 50-dən çox təmsilçi LLM arxitekturasını yenidən qurmuş; modelləri diqqət mexanizmi, normallaşdırma, mövqesəl kodlama, dense və ya mixture-of-experts yönləndirməsi, kontekst idarəetməsi, təlim strategiyası, uyğunlaşdırma və multimodal qabiliyyət kimi ölçülərdə kodlaşdırmışdır. Tədqiqat bu taksonomiyanı interaktiv şəkildə araşdırmaq üçün açıq mənbəli LLM Model Explorer interfeysini də təqdim edir.
Məqalənin müqayisəli benchmark cədvəlində GPT-4/GPT-4o ailəsi MMLU-da %86,4 və GSM8K-da %92,0; Gemini 1.5 HumanEval-da %74,9; Claude 3.x SWE-bench-də %49,0; DeepSeek ailəsi GSM8K-da %89,4 və SWE-bench-də %42,5 kimi göstərilmişdir. Lakin bu rəqəmlər tək bir ortaq benchmark sınağında istehsal edilməmişdir. Fərqli model versiyaları, istehsalçı hesabatları, leaderboard-lar, prompting metodları və qiymətləndirmə protokollarından derlənmişdir. Mənbə tədqiqatı buna görə dəyərlərin göstərici xarakter daşıdığını və modellər arasında tam olaraq birbaşa müqayisə edilə bilməyəcəyini açıq şəkildə bildirir.
Tədqiqatın əsas töhfəsi müəyyən bir LLM-nin “qalib” olduğunu elan etməkdən çox, müasir böyük dil modellərinin hansı dizayn oxlarında bir-birindən ayrıldığını görünən hala gətirməsidir. İcmalın təklif etdiyi başlıca meyillər; daha səmərəli diqqət mexanizmlərinə keçid, uzun kontekst üçün modulyar hesablama axtarışı, açıq çəkili modellərdə RoPE və RMSNorm kimi komponentlərin yayğınlaşması, multimodal sistemlərin böyüməsi və RLHF, RLAIF və ya Constitutional AI kimi uyğunlaşdırma metodlarının model inkişafında mərkəzi hala gəlməsidir.
Bununla belə taksonomiyadan çıxarılan bəzi güclü nəticələr eksperimental olaraq doğrulanmış arxitektura qanunları deyil. Xüsusilə “32K-dan uzun kontekstə malik bütün modellər sparse expert routing istifadə edir” nəticəsi tədqiqatın öz GPT-4o və Claude kontekst cədvəlləri ilə uyğun gəlmir. Benchmark fərqlərini müəyyən arxitektura xüsusiyyətlərinə bağlayan izahlar da kontrollu ablasiya təcrübələrindən deyil, ailələrarası müşahidəli müqayisələrdən törədilmişdir.
| Tədqiqatın əhatə dairəsi | Mənbədə bildirilən quruluş | Necə şərh edilməlidir? |
|---|---|---|
| LLM ailəsi | 7 | GPT, LLaMA 2, Gemini, Claude, DeepSeek, Falcon və Qwen |
| Yenidən qurulan arxitektura | 50+ | Texniki sənəd və model kartlarından yüksək səviyyədə yenidən qurulmuşdur. |
| Əsas müqayisə oxları | Arxitektura, təlim, uyğunlaşdırma, kontekst, multimodallıq, təhlükəsizlik, benchmark | Ortaq bir taksonomiya altında araşdırılmışdır. |
| Benchmark metodu | İkincil mənbələrdən bildirilən nəticələr | Ortaq təcrübə mühitində yenidən ölçülmüş nəticələr deyil. |
| İnteraktiv alət | LLM Model Explorer | Taksonomiyadakı xüsusiyyətlərin model əsasında müqayisə edilməsini təmin edir. |
| Əsas elmi sərhəd | Kontrollu səbəb-nəticə arxitektura müqayisəsi yoxdur | Taksonomiya əlaqələri hipotez yaradır; səbəbliyi sübut etmir. |
Niyə yalnız “neçə milyard parametr?” sualı artıq kifayət deyil?
İlk böyük dil modeli nəsillərində miqyas artımı başlıca irəliləyiş oxlarından biri idi. Tədqiqatın tarixi anlatımında GPT-2-nin 2019-dakı böyük miqyaslı əvvəlcədən təlim yanaşmasından GPT-3-ün 175 milyard parametrinə, daha sonra uzun kontekstli və multimodal modellərin ortaya çıxmasına uzanan bir dönüşüm təsvir edilir.
Lakin tədqiqatçılara görə müasir LLM dizayn sahəsi artıq tək bir böyüklük oxuna endirilə bilməz. Parametr sayı yaxın olan iki sistem; attention mexanizmi, aktiv ekspert sayı, normallaşdırma metodu, mövqesəl kodlama, məlumat qarışığı, instruction tuning, uyğunlaşdırma və ya multimodal encoder quruluşu səbəbindən çox fərqli hesablama və davranış profilləri göstərə bilər.
Tədqiqat hansı yeddi model ailəsini araşdırır?
| Model ailəsi | Mənbədə araşdırılan təmsilçi modellər | Tədqiqatın önə çıxardığı əsas xüsusiyyət |
|---|---|---|
| GPT | GPT-2, GPT-3/3.5, GPT-4, GPT-4o, O1 | Decoder-only Transformer, böyük miqyaslı əvvəlcədən təlim, multimodallıq və RLHF |
| LLaMA | LLaMA, LLaMA 2, Code LLaMA | RoPE, GQA, RMSNorm və açıq çəkili ekosistem |
| Gemini | Gemini 1.x və Gemini 1.5 | Multimodallıq, uzun kontekst və mənbədə MoE kimi təsvir edilən quruluş |
| Claude | Claude 2, Claude 3 və 3.5 variantları | Uzun kontekst, Constitutional AI və RLAIF |
| DeepSeek | DeepSeek-V2/V3 və Reasoner/R1 | MLA, MoE və reasoning yönümlü təlim |
| Falcon | Falcon 7B/40B/180B, Falcon 2, Falcon 3 və Mamba | Multi-query/multigroup attention və state-space variantları |
| Qwen | Qwen, Qwen2 və Qwen-Max | RoPE, RMSNorm, SwiGLU, çoxdillilik və kod/riyaziyyat ixtisaslaşması |
Attention mexanizmləri niyə fərqlənir?
Klassik Transformer-dəki multi-head attention hər attention head üçün ayrı query, key və value proyeksiyalarından istifadə edir. Böyük modellərdə xüsusilə key–value önbelleği uzun kontekst və yüksək eyni-vaxtlı istifadəçi yükü altında mühüm yaddaş xərcinə çevrilir.
Tədqiqat bu problemə fərqli ailələrin fərqli həllər gətirdiyini vurğulayır. LLaMA 2-də Grouped Query Attention (GQA), Falcon və Qwen ailəsində multi-query və ya multigroup attention, DeepSeek-də isə Multi-Head Latent Attention (MLA) kimi yanaşmalar bu xərci azaltmağı hədəfləyir.
DeepSeek-in MLA yanaşması key–value təmsillərini daha aşağı ölçülü latent göstəricilərə sıxışdıraraq hesablama və saxlanma yükünü azaltmağı məqsəd qoyur. Falcon-un multi-query/multigroup yanaşması da key və value proyeksiyalarının attention head-ləri arasında daha çox paylaşılması yolu ilə KV-cache yükünü azaltmağa yönəlmişdir.
Mixture-of-Experts nə təmin edir?
Mixture-of-Experts (MoE) yanaşmasında modelin bütün parametrləri hər token üçün eyni anda aktivləşdirilmir. Bir yönləndirmə mexanizmi girişə görə müəyyən ekspert alt şəbəkələrini seçir. Beləliklə ümumi model tutumu böyüyərkən token başına aktiv hesablama ümumi parametr sayından daha aşağı saxlanıla bilər.
Mənbə tədqiqatı bu yanaşmanı xüsusilə Gemini və DeepSeek ailələrinin miqyaslanma və uzun kontekst strategiyaları ilə əlaqələndirir. DeepSeek-R1 üçün 671 milyard ümumi parametrə qarşı token başına təxminən 37 milyard aktiv parametr məlumatı verilir.
Ancaq MoE-nin mövcudluğu təkbaşına daha yaxşı reasoning, daha uzun kontekst və ya daha yüksək benchmark performansının səbəbi kimi qəbul edilə bilməz. Yönləndirmə metodu, təlim məlumatı, aktiv ekspert sayı, attention arxitekturası və post-training prosesi nəticələrə birlikdə təsir edir.
Falcon Mamba niyə fərqlidir?
Falcon Mamba 7B, klassik self-attention əvəzinə Mamba state-space modelindən istifadə etməsi səbəbindən tədqiqatdakı mühüm arxitektura ayrımlarından biridir. Mənbə bunun uzun ardıcıllıqlarda xətti zamanlı emal və təxminən sabit yaddaş davranışı hədəflədiyini bildirir.
Falcon 3 ailəsində Transformer və state-space yanaşmalarının birlikdə olması müasir LLM inkişafının artıq yalnız Transformer daxilindəki variasiyalardan deyil, attention xarici uzun-ardıcıllıq arxitekturalarından da ibarət olduğunu göstərir.
RMSNorm, RoPE və SwiGLU niyə tez-tez görünür?
Tədqiqatın taksonomiyasında açıq çəkili model ailələrinin bir hissəsində üç komponentin tez-tez təkrarlandığı görünür: RMSNorm, Rotary Positional Embedding (RoPE) və SwiGLU.
RMSNorm normallaşdırma xərcini sadələşdirərkən; RoPE attention mexanizminin içinə nisbi mövqe məlumatını daşıyır. SwiGLU isə gated aktivasiya quruluşundan istifadə edir. Tədqiqat LLaMA 2 və Qwen-i bu komponentlərin aydın nümunələri kimi nəzərdən keçirir.
Multimodal modellərdə nə dəyişir?
Mətndən kənar görüntü, səs və video məlumatını emal etmək üçün modelin yalnız bir tokenizer və dil decoder-indən ibarət olması kifayət deyil. Tədqiqatda Gemini, GPT-4o və Claude 3 bu dönüşümün fərqli nümunələri kimi araşdırılır.
Gemini arxitektura sxemində fərqli məlumat növlərinin modality-specific encoder-lar üzərindən emal edilib cross-modal attention yolu ilə ortaq bir latent sahəyə köçürülməsi göstərilir. Tədqiqat GPT-4o-nu isə mətn, kod, görüntü, səs və video emal edə bilən birləşik multimodal dizayn kimi nəzərdən keçirir.
Uyğunlaşdırma: RLHF nə edir?
Reinforcement Learning from Human Feedback (RLHF), əvvəlcədən təlim almış modelin yalnız növbəti token ehtimalını optimallaşdırmaq əvəzinə insan üstünlükləri ilə daha uyğun çıxışlar verməsi üçün istifadə olunan post-training metodlarından biridir.
Mənbə tədqiqatı GPT-4, LLaMA 2, Claude, DeepSeek və Qwen kimi ailələrdə müxtəlif supervised fine-tuning və üstünlük optimallaşdırması formalarının istifadə edildiyini izah edir.
Bununla birlikdə müəlliflər RLHF-nin təhlükəsizliyi qəti şəkildə həll etmədiyini vurğulayırlar. İnsan geri bildirimi bahalıdır; reward hacking ortaya çıxa bilər; təhlükəsizlik təlimi həddindən artıq rədd davranışına yol aça bilər və jailbreak və ya adversarial prompting riskləri tamamilə aradan qalxmır.
Constitutional AI və RLAIF nədir?
Claude ailəsi tədqiqatda alignment yanaşması baxımından ayrıca bir kateqoriya kimi nəzərdən keçirilir. Constitutional AI-da modelin müəyyən prinsiplər çərçivəsində öz çıxışını tənqid etməsi və yenidən tənzimləməsi məqsəd qoyulur. Reinforcement Learning from AI Feedback (RLAIF) isə insan qiymətləndirməsinin bir hissəsinin AI tərəfindən verilən geri bildirimlə dəstəklənməsini ehtiva edir.
Mənbə müəllifləri bu yanaşmanın insan annotasiyasından asılılığı azalda biləcəyini, lakin AI geri bildiriminin model qaynaqlı qərəzləri yenidən istehsal etmə riski olduğunu bildirirlər.
Taksonomiyanın üç əsas örüntüsü
Məqalə yeddi model ailəsini ortaq ölçülərə yerləşdirdikdən sonra üç ailələrarası örüntü təklif edir.
| Mənbənin örüntüsü | Müqayisə edilən oxlar | Müəlliflərin çıxarımı | Verianla şərh sərhədi |
|---|---|---|---|
| A — Alignment–Efficiency Divergence | Alignment strategiyası × attention optimallaşdırması | Dərin uyğunlaşdırma ilə ən irəli attention səmərəliliyinin eyni modeldə birlikdə görünmədiyi irəli sürülür. | Kəmiyyət olaraq müəyyən edilmiş iki oxda kontrollu performans testi deyil. |
| B — Context–Routing Co-Adoption | Kontekst uzunluğu × expert routing | >32K kontekstli modellərin sparse/modulyar routing istifadə etdiyi irəli sürülür. | Mənbənin GPT-4o və Claude cədvəlləri ilə universal ifadə uyğun gəlmir. |
| C — Open-Weight Convergence | Açıqlıq × normallaşdırma × mövqesəl kodlama | Açıq çəkili modellərin RMSNorm + RoPE ətrafında qruplaşdığı irəli sürülür. | Model ailəsi daxilində bütün variantlar üçün eyni səviyyədə texniki açıqlıq yoxdur. |
Pattern B-dəki daxili uyğunsuzluq niyə vacibdir?
Tədqiqatın Pattern B mətni, araşdırılan modellər içində 32K-dan daha uzun context window təmin edən “hər modelin” sparse expert routing və ya selective state-space qatlarından istifadə etdiyini ifadə edir.
Lakin eyni mənbədə olan müqayisə cədvəli GPT-4/GPT-4o üçün 128K, Claude 2/3 üçün isə 100K–200K context window bildirir. Bu iki ailənin müvafiq arxitektura xülasələrində sparse MoE və ya selective state-space routing göstərilmir.
Buna görə mənbə daxilindəki məlumatlar “uzun context ilə modulyar hesablama arasında bəzi ailələrdə birlikdə görünmə” şərhini dəstəkləyə bilər; lakin “32K-dan yuxarı bütün modellər bundan istifadə edir” nəticəsini öz cədvəlləri əsasında dəstəkləmir.
“Açıq model” ilə “açıq mənbə” eyni şeydirmi?
Mənbə tədqiqatında modellər qapalı, açıq çəkili, qismən açıq və ya tədqiqat lisenziyalı kimi fərqli kateqoriyalarda nəzərdən keçirilir. Bu ayrım vacibdir. Model çəkilərinin yayımlanması; təlim məlumatının, tam təlim kodunun, post-training xəttinin və təhlükəsizlik sisteminin hamısının açıq olduğu mənasına gəlmir.
Bu səbəbdən tədqiqatdakı “open-source ecosystem” ifadəsi oxunarkən hər ailə üçün real açıqlıq səviyyəsinin fərqli ola biləcəyi nəzərə alınmalıdır.
Benchmark nəticələri niyə tək bir liqa cədvəli deyil?
Məqalənin Tablo 2-si beş benchmark-ı yan-yana verir: MMLU, HumanEval, GSM8K, SWE-bench və MathVista. Lakin cədvəl hüceyrələrinin hamısı eyni model versiyası, eyni tarix, eyni prompting strategiyası və ya eyni evaluation harness altında ölçülməmişdir.
Üstəlik cədvəl bəzi sətirlərdə tək bir modeli deyil, ailə daxilində birdən çox variantı birlikdə təmsil edir: “GPT-4/GPT-4o”, “Claude 3.x (Opus/Sonnet)”, “Gemini 1.5 (Pro/Ultra)” və ya “DeepSeek (V3/Reasoner)” kimi.
Dolayısıyla bir sətirdəki MMLU skoru ilə eyni sətirdəki SWE-bench skorunun mütləq eyni checkpoint və ya eyni model variantından gəldiyi fərz edilməməlidir.
İstehsalçı və müstəqil benchmark fərqi
Tədqiqat istehsalçılar tərəfindən bildirilən nəticələrlə müstəqil qiymətləndirmələr arasında fərqlər ola bildiyini və istehsalçı skorlarının MMLU-da təxminən 2–8 faiz bəndi, GPQA-Diamond və SWE-bench kimi daha yeni benchmark-larda bəzi hallarda təxminən 10–15 bənd daha yüksək ola bildiyini ifadə edir.
Müəlliflər bunun prompting metodu, qiymətləndirmə proqramı, model versiyası və mümkün evaluation-set contamination kimi amillərdən qaynaqlana biləcəyini bildirirlər. Bununla birlikdə bu 2–8 və 10–15 bəndlik fərqləri yaradan bütün cütləşdirilmiş ölçmələrin xam məlumat cədvəli məqalədə təqdim edilmir. Buna görə bu aralıqlar müstəqil bir meta-analiz nəticəsi kimi qiymətləndirilməməlidir.
Tədqiqatın dəstəklədiyi nəticələr
- Müasir LLM ailələri eyni əsas Transformer kökündən gəlsələr də attention, normallaşdırma, routing, context, multimodallıq və alignment ölçülərində əhəmiyyətli dərəcədə fərqlənir.
- GQA, MQA, MLA, FlashAttention, MoE və state-space yanaşmaları böyük miqyaslı modellərdə səmərəlilik və uzun-ardıcıllıq emalı problemlərinə yönəlmiş fərqli texniki həllər təqdim edir.
- RLHF tək alignment yanaşması deyil; Constitutional AI və RLAIF kimi alternativ və ya tamamlayıcı yanaşmalar da istifadə olunur.
- Açıq çəkili və qapalı model inkişaf ekosistemləri şəffaflıq, yenidən istehsal edilə bilmə, xərc və təhlükəsizlik mühəndisliyi baxımından fərqli ödünləşmələr ehtiva edir.
- Model seçimi yalnız benchmark skoruna deyil, istifadə sahəsi, context ehtiyacı, multimodallıq, xərc, təhlükəsizlik və yerləşdirmə şərtlərinə görə aparılmalıdır.
- Benchmark nəticələrinin model versiyası və qiymətləndirmə protokolu məlumatı olmadan birbaşa müqayisəsi etibarlı deyil.
Tədqiqatın sübut etmədiyi nəticələr
- Hər tapşırıq üçün tək bir LLM ailəsinin mütləq ən yaxşı olduğu sübut edilməmişdir.
- Tablo 2 dəyərləri ortaq kontrollu təcrübədə əldə edilmiş baş-başa model müqayisəsi deyil.
- Bir benchmark fərqinin yalnız bir attention mexanizmi, MoE və ya alignment metodu tərəfindən yaradıldığı sübut edilməmişdir.
- Constitutional AI-ın attention səmərəliliyi ilə zəruri fiziki trade-off yaratdığı eksperimental olaraq göstərilməmişdir.
- Uzun context üçün sparse expert routing-in zəruri şərt olduğu mənbə məlumatları ilə sübut olunmur.
- Açıq çəkili modellərin qapalı modellərdən ümumən daha təhlükəsiz və ya daha təhlükəli olduğu nəticəsinə gəlmək olmaz.
- Benchmark-dakı yüksək performans real dünya etibarlılığı, factuality və ya təhlükəsiz istifadə zəmanəti deyil.
Türkiyə baxımından nə ifadə edir?
Tədqiqat Türkiyəyə məxsus bir LLM müqayisəsi aparmır və türkcə benchmark nəticələrini ayrıca bir təcrübə qrupu kimi təqdim etmir. Buna görə cədvəldə yüksək nəticə göstərən bir modelin türkcə hüquq, səhiyyə, təhsil, sənaye və ya ictimai sektor tətbiqlərində eyni performansı göstərəcəyi fərz edilə bilməz.
Türkiyədəki bir qurum üçün model seçimi ediləcəksə, bu taksonomiya arxitektura üzrə ilkin seçim aləti kimi istifadə oluna bilər; lakin türkcə dil performansı, sahə terminologiyası, məlumat yerləşməsi, şəxsi məlumatların qorunması, gecikmə, xərc, qurumdaxili hostinq tələbləri və yerli istifadə ssenariləri ayrıca test edilməlidir. Bu yerli doğrulama mənbə tədqiqatının həyata keçirdiyi analiz deyil.
Tədqiqatın Metodu və Nəticələri
Bu tədqiqat klassik sistematik icmaldırmı?
Məqalə geniş bir icmal və taksonomiya tədqiqatıdır; lakin mənbə mətnində PRISMA kimi sistematik ədəbiyyat axtarışı protokolu, əvvəlcədən müəyyən edilmiş verilənlər bazası axtarış sətirləri, daxil etmə/xaric etmə axış sxemi və ya tədqiqat keyfiyyəti meta-analizi təqdim edilmir.
Müəlliflər model seçimini üç meyara əsaslandırır:
- texniki sənədləşmənin mövcudluğu,
- arxitektura müxtəlifliyi,
- tədqiqat və sənaye istifadəsi baxımından əhəmiyyət.
Bu meyarlarla GPT, LLaMA 2, Gemini, Claude, DeepSeek, Falcon və Qwen ailələri seçilmişdir.
Arxitekturalar necə yenidən quruldu?
Müəlliflər modellərin arxitektura sxemlərini ictimaiyyətə açıq texniki hesabatlardan, system card-lardan və model sənədləşmələrindən yenidən qurmuşdur. Xüsusilə qapalı sistemlərin implementation ayrıntıları yayımlanmadığı üçün sxemlər yüksək səviyyədə və ortaq abstraksiya səviyyəsində saxlanılmışdır.
Qiymətləndirilən başlıca arxitektura ölçüləri bunlardır:
- Multi-Head Attention (MHA), Grouped Query Attention (GQA), Multi-Query Attention (MQA) və Multi-Head Latent Attention (MLA),
- LayerNorm və RMSNorm,
- dense və mixture-of-experts routing,
- context handling və positional encoding,
- alignment və training pipeline-ları.
Taksonomiya necə yaradıldı?
Hər model kateqorik və ədədi xüsusiyyətlərdən ibarət bir xüsusiyyət vektoru ilə təmsil edilmişdir. Tədqiqat yalnız açıq sənədləşmədə olan xüsusiyyətlərin kodlaşdırıldığını və məlumat qeyri-müəyyən olduqda həddindən artıq detallandırmadan qaçmaq üçün “conservative labeling” tətbiq edildiyini bildirir.
Sonra taksonomiya ölçüləri ikili və ya çoxlu əlaqələr üzərindən müqayisə edilmişdir. Məsələn alignment metodu attention səmərəliliyi ilə; context length expert routing ilə; model açıqlığı normallaşdırma və positional encoding ilə birlikdə araşdırılmışdır.
Verianla Live: LLM taksonomiyasının yaradılma prosesi
Bu proses mənbə tədqiqatının 3.1 bölməsindəki metodologiyaya əsaslanır. “Nəticə” mərhələsindəki struktur örüntülər kontrollu eksperimental səbəblik deyil, müqayisəli taksonomiyadan çıxarılan nəticələrdir.
| Mərhələ | Mənbə tədqiqatındakı əməliyyat |
|---|---|
| 1. Model ailəsi seçimi | Sənədləşmə, arxitektura müxtəlifliyi və tədqiqat/sənaye əhəmiyyəti meyarları ilə yeddi ailə seçildi. |
| 2. Texniki mənbələrin toplanması | Texniki hesabatlar, system card-lar və model sənədləşməsi istifadə edildi. |
| 3. Arxitektura yenidən qurulması | 50-dən çox təmsilçi arxitektura ortaq bir abstraksiya səviyyəsində yenidən quruldu. |
| 4. Xüsusiyyət kodlaması | Attention, normallaşdırma, routing, context, positional encoding, training və alignment ölçüləri kodlaşdırıldı. |
| 5. Ailələrarası müqayisə | Taksonomiya ölçülərinin ikili və çoxlu əlaqələri araşdırıldı. |
| 6. Benchmark ilə əlaqələndirmə | Taksonomiya örüntüləri mənbələrdə bildirilən benchmark nəticələri ilə müqayisə edildi. |
| 7. Hipotez istehsalı | Alignment–efficiency, context–routing və open-weight convergence örüntüləri təklif edildi. |
Mənbənin benchmark cədvəli
Aşağıdakı dəyərlər məqalənin Tablo 2-sindən köçürülmüşdür. Mənbə tədqiqatının öz xəbərdarlığı qorunmalıdır: nəticələr fərqli mənbə və protokollardan gəldiyi üçün qəti və birbaşa model sıralaması deyil.
| Model ailəsi | MMLU (%) | HumanEval Pass@1 (%) | GSM8K (%) | SWE-bench Pass@1 (%) | MathVista (%) |
|---|---|---|---|---|---|
| GPT-4 / GPT-4o | 86,4 | 67,0 | 92,0 | 33,2 | 63,8 |
| Claude 3.x (Opus/Sonnet) | 82,1 | 60,1 | 88,0 | 49,0 | 60,5 |
| Gemini 1.5 (Pro/Ultra) | 81,9 | 74,9 | 87,8 | 35,0 | 59,2 |
| LLaMA 2 (70B) | 68,9 | 48,1 | 56,8 | 18,0 | 44,1 |
| Falcon (180B/Falcon 2) | 66,5 | 45,2 | 55,4 | 15,3 | 41,6 |
| DeepSeek (V3/Reasoner) | 79,8 | 72,6 | 89,4 | 42,5 | 61,2 |
| Qwen (Qwen2/Qwen-Max) | 78,5 | 65,3 | 83,7 | 36,4 | 58,1 |
Benchmark-ların mənası
| Benchmark | Tədqiqatdakı istifadə məqsədi |
|---|---|
| MMLU | Fərqli bilik və problem sahələrində ümumi dil modeli performansı |
| HumanEval | Proqramlaşdırma/kod istehsalı performansı |
| GSM8K | Riyazi sözlü məsələ həlli |
| SWE-bench | Real proqram mühəndisliyi problemləri üzərində kodlama qabiliyyəti |
| MathVista | Vizual və riyazi mühakimənin birləşdiyi tapşırıqlar |
Model ailələrinin context və multimodallıq müqayisəsi
| Ailə | Mənbədə bildirilən context | Multimodal quruluş | Uyğunlaşdırma / təhlükəsizlik |
|---|---|---|---|
| GPT-4 / GPT-4o | 128K GPT-4o | Mətn, görüntü, səs, video | SFT, RLHF, PPO, moderasiya və məzmun filtrləri |
| GPT-O1 | 8K–32K | Mətn | SFT, RLHF və reasoning yönümlü mükafat modelləri |
| LLaMA 2 | 4K | Mətn | SFT, RLHF, Ghost Attention və safety reward modelləri |
| Gemini 1.5 | 1M-ə qədər | Mətn, görüntü, səs, video, kod | RLHF, expert gating və moderasiya |
| Claude 2/3 | 100K–200K | Mətn; Claude 3-də görüntü | Constitutional AI, RLAIF, self-critique və red teaming |
| Falcon | 4K–32K | Əsas ailə mətn; Falcon 2-də VLM variantı | Safety classifier və LoRA əsaslı uyğunlaşdırma |
| DeepSeek R1/V3 | 32K–128K | Tədqiqatda əsasən mətn | GRPO, SFT, sintetik məlumat, rejection sampling |
| Qwen | 32K+ | Tədqiqatın müqayisə cədvəlində mətn | SFT, RLHF, preference optimization və bias mitigation |
Taksonomiyanın benchmark fərqlərinə gətirdiyi izah
Mənbə tədqiqatının Tablo 6-sı üç nümunə benchmark fərqini arxitektura ölçüləri ilə əlaqələndirir:
| Benchmark | Ailə A | Ailə B | Skor fərqi | Mənbənin əlaqələndirdiyi taksonomiya ölçüləri |
|---|---|---|---|---|
| GSM8K | DeepSeek-V3: %89,4 | LLaMA 2: %56,8 | +32,6 faiz bəndi | MLA/GQA, MTP/next-token prediction, rejection-sampled RL/Ghost Attention RLHF |
| SWE-bench | Claude 3.x: %49,0 | GPT-4o: %33,2 | +15,8 faiz bəndi | Constitutional AI + RLAIF/RLHF-PPO və 200K/128K context |
| HumanEval | Gemini 1.5: %74,9 | LLaMA 2: %48,1 | +26,8 faiz bəndi | MoE/dense Transformer və 1M/4K context |
Bu cədvəl birbaşa mexanizm testi deyil. Hər müqayisədə model ailələri məlumat, parametr, post-training, model versiyası və evaluation protocol daxil olmaqla çoxsaylı başqa dəyişəndə də fərqlənir. Mənbə tədqiqatı bunu açıq şəkildə qəbul edərək analizlərin səbəblik deyil, “structured explanatory hypotheses” yaratdığını bildirir.
Alignment–efficiency çıxarımı niyə hipotez səviyyəsindədir?
Müəlliflər Claude-dakı Constitutional AI/RLAIF dərinliyinin daha az efficiency-optimized attention ilə birlikdə görünməsini, DeepSeek, Falcon və Gemini kimi attention səmərəliliyinə ağırlıq verən ailələrdə isə daha sadə uyğunlaşdırma xətlərinin istifadə edilməsini bir trade-off kimi şərh edirlər.
Lakin tədqiqatda “alignment depth” və “attention efficiency” üçün ortaq kəmiyyət skoru müəyyən edilməmiş; eyni model üzərində yalnız alignment və ya yalnız attention metodu dəyişdirilərək kontrollu ablasiya aparılmamışdır. Buna görə əlaqə tədqiqatın taksonomik müşahidəsidir; hesablama baxımından zərurət kimi sübut edilmiş deyil.
Context–routing çıxarımındakı mənbədaxili uyğunsuzluq
Pattern B-nin əsas cümləsi, 32K-dan böyük context window istifadə edən hər modelin sparse expert routing və ya selective state-space layer istifadə etdiyini irəli sürür.
Lakin eyni məqalənin öz müqayisə cədvəlində:
- GPT-4o üçün 128K context,
- Claude 2/3 üçün 100K–200K context
bildirilməsinə baxmayaraq bu ailələrin arxitektura izahlarında MoE və ya selective SSM routing verilmir.
Dolayısıyla “every >32K-context model” ümumiləşdirməsi mənbə daxilində tutarlı deyil. Bu Verianla məqaləsində sözügedən örüntü yalnız müəlliflərin təklif etdiyi hipotez kimi aktarılmışdır.
Açıq çəkili model yaxınlaşması
Tədqiqatın Pattern C çıxarımına görə LLaMA 2, Falcon və Qwen kimi açıq/açıq çəkili sistemlər RoPE və RMSNorm kimi yaxşı bilinən komponentlərin ətrafında daha çox qruplaşarkən qapalı modellər daha heterogen dizayn sahələrinə yayılır.
Müəlliflər bunu açıq model icmalarında yenidən istehsal edilə bilən və doğrulana bilən komponentlərin seçilməsi ilə əlaqələndirirlər. Lakin xüsusilə qapalı modellərin arxitektura ayrıntıları məhdud olduğu üçün qapalı sistemlərin real dizayn məkanının hamısı müşahidə edilə bilmir. Bu çıxarım da doğrulanmış səbəb mexanizmi kimi deyil, müqayisəli taksonomiya şərhi kimi qiymətləndirilməlidir.
İş dünyası və ictimai nəticələr
Tədqiqata görə LLM-lər sənəd hazırlama, kod istehsalı, məlumat analizi və müştəri dəstəyi kimi bilik intensiv işlərdə məhsuldarlıq potensialı daşıyarkən axıcı, lakin səhv məzmun istehsalı, insan nəzarətinin azalması və yanlış çıxışa həddindən artıq güvən kimi risklər yarada bilər.
Təhsildə fərdiləşdirilmiş geri bildirim imkanları akademik bütövlük və tənqidi düşünmə problemləri ilə birlikdə nəzərdən keçirilir. Aşağı resurslu dillərdəki performans fərqləri isə yalnız arxitekturanın deyil, məlumat əhatəsi və mədəni təmsilin də model davranışına təsir etdiyini göstərir.
Tədqiqatın gələcəyə yönəlik araşdırma başlıqları
- Standartlaşdırılmış və yenidən istehsal edilə bilən LLM qiymətləndirməsi,
- aşağı resurslu dillər və mədəni kontekstlərdə cross-lingual generalization,
- uzun context və memory-augmented modellər,
- state-space və attention–memory hibridləri,
- model kartları, məlumat səhifələri və bias audit mexanizmləri,
- red teaming və daha şəffaf təhlükəsizlik hesabatı,
- hesablama və enerji xərclərinin azaldılması,
- məlumat mənşəyi, əqli mülkiyyət, məxfilik və təmsil ədaləti.
Mənbə və Metod Qeydi
| Tam özgün çalışma adı | Mapping the LLM Landscape: A Cross-Family Survey of Architectures, Alignment Methods, and Benchmark Performance |
|---|---|
| Müəlliflər | Deepshikha Bhati; Fnu Neha; Devi Sri Bandaru; Matthew Weber; Ishan Dilipbhai Gajera |
| Müəllif sırası | 1. Deepshikha Bhati; 2. Fnu Neha; 3. Devi Sri Bandaru; 4. Matthew Weber; 5. Ishan Dilipbhai Gajera |
| Bərabər töhfə / bərabər birinci müəllif | Mənbə tədqiqatında bərabər töhfə və ya bərabər birinci müəllif bəyanı göstərilməmişdir. |
| Məsul müəllif | Deepshikha Bhati |
| Qurum | Department of Computer Science, Kent State University, Kent, Ohio, ABŞ |
| Mənbə növü | Müqayisəli icmal, arxitektura taksonomiyası və LLM model ailəsi araşdırması. |
| Rəyçilik vəziyyəti | Rəyli jurnalda yayımlanmış icmal məqaləsidir; preprint deyil. |
| Jurnal | AI |
| Nəşriyyat | MDPI |
| Cild / say / məqalə | 2026, 7(4), 142 |
| DOI | 10.3390/ai7040142 |
| Alınma tarixi | 11 Mart 2026 |
| Reviziya tarixi | 7 Aprel 2026 |
| Qəbul tarixi | 11 Aprel 2026 |
| Yayın tarixi | 16 Aprel 2026 |
| Rəsmi bağlantı | https://doi.org/10.3390/ai7040142 |
| Lisenziya | Creative Commons Attribution (CC BY). |
Tədqiqatın məlumat və analiz xarakteri
Bu tədqiqat yeni bir əsas LLM öyrətmir və yeddi model ailəsini ortaq hesablama infrastrukturu üzərində yenidən benchmark etmir. Əsas elmi məlumat mənbəyi ictimaiyyətə açıq texniki hesabatlar, system card-lar, model sənədləşməsi və benchmark mənbələridir.
Müəlliflər bu sənədlərdən 50-dən çox model arxitekturasını ortaq bir abstraksiya səviyyəsində yenidən qurmuş, xüsusiyyətlərini kodlaşdırmış və LLM Model Explorer tətbiqi daxilində yan-yana müqayisə edilə bilən hala gətirmişdir.
Məqalənin məlumat əlçatanlığı bəyanına görə analizdə istifadə olunan məlumatlar əsas mətn daxilində təqdim edilmişdir. Tədqiqatın hazırladığı LLM Model Explorer-in mənbə kodu və canlı göstərim ünvanları da məqalənin metod bölməsində paylaşılmışdır.
Maliyyələşdirmə
Tədqiqat Kent State University-nin Open Access APC Support Fund proqramı tərəfindən qismən dəstəklənmişdir.
Etik komitə və məlumatlandırılmış razılıq
Mənbə tədqiqatında Institutional Review Board və informed consent sahələri “Not applicable” kimi bildirilmişdir. Tədqiqat insan iştirakçılar üzərində yeni təcrübə və ya klinik məlumat toplama ehtiva etmir.
Maraqlar toqquşması
Müəlliflər maraqlar toqquşmasının olmadığını bildirmişdir.
Müəllif töhfələri
Konseptuallaşdırma: Deepshikha Bhati və Devi Sri Bandaru. Metodologiya: Deepshikha Bhati və Devi Sri Bandaru. Doğrulama: Deepshikha Bhati, Fnu Neha və Devi Sri Bandaru. Formal analiz: Deepshikha Bhati və Devi Sri Bandaru. Gözdən keçirmə və redaktə: Deepshikha Bhati, Fnu Neha, Devi Sri Bandaru, Matthew Weber və Ishan Dilipbhai Gajera.
Tədqiqatın əsas metodoloji məhdudiyyətləri
- Model ailələri əvvəlcədən müəyyən edilmiş sistematik ədəbiyyat axtarışı protokolu yerinə sənədləşmə, müxtəliflik və əhəmiyyət meyarları ilə seçilmişdir.
- Qapalı modellərin arxitektura və təlim ayrıntıları tam açıqlanmadığı üçün yenidən qurulan sxemlər yüksək səviyyəli abstraksiyalardır.
- 50-dən çox arxitekturanın bütün implementation ayrıntıları müstəqil olaraq doğrulana bilən deyil.
- Benchmark skorları tək bir ortaq evaluation harness istifadə edilərək yenidən hesablanmamışdır.
- Bəzi benchmark sətirləri tək bir model yerinə bir ailədəki birdən çox variantı birlikdə təmsil edir.
- Vendor-reported və independent benchmark nəticələrinin mənbəyi hüceyrə əsasında tək cədvəldə ayrılmamışdır.
- Benchmark nəticələri prompting, model versiyası, tarix və qiymətləndirmə protokolu baxımından fərqlilik göstərə bilər.
- Taksonomiya ölçüləri arasındakı əlaqələr müşahidəli/müqayisəlidir; kontrollu ablasiya təcrübəsi aparılmamışdır.
- Architecture–benchmark əlaqələrindən səbəblik çıxarıla bilməz.
- Alignment depth və attention efficiency üçün ortaq kəmiyyət indeksi müəyyən edilməmişdir.
- “32K-dan uzun kontekstə malik bütün modellər expert routing istifadə edir” çıxarımı eyni məqalədəki GPT-4o və Claude context məlumatları ilə uyğun gəlmir.
- Açıq çəkili modellərin RMSNorm + RoPE yaxınlaşmasına dair şərh ailə daxilindəki bütün model variantları üçün bərabər sənədləşmə səviyyəsinə əsaslanmır.
- Mənbə tədqiqatı sürətlə dəyişən bir texnologiya sahəsini müəyyən bir tarix aralığında xəritələndirir; taksonomiya gələcək model nəsillərini avtomatik olaraq təmsil etmir.
Mənbədaxili kritik uyğunsuzluğun açıq qeydi
Mənbənin Pattern B çıxarımında “every model in our survey supporting context windows exceeding 32K tokens” üçün sparse expert routing və ya selective state-space yanaşmasının olduğu irəli sürülür. Buna qarşı eyni tədqiqatın müqayisə cədvəli GPT-4o üçün 128K və Claude 2/3 üçün 100K–200K context window verərkən bu iki ailə üçün sözügedən routing quruluşları göstərilmir. Buna görə universal xarakterli Pattern B cümləsi mənbə daxilindəki digər məlumatlarla tutarlı deyil.
Pattern A və benchmark performans izahları üçün də oxşar şəkildə səbəbi qətilik istifadə edilməməlidir. Tədqiqatın özü benchmark fərqlərini izah edərkən sözügedən analizlərin causality yaratmadığını bildirir.
Nəticə olaraq tədqiqatın ən güclü töhfəsi “hansı LLM ən yaxşıdır?” sualına qəti cavab verməsi deyil. Əsas töhfə böyük dil modeli ailələrinin arxitektura, təlim, alignment, context, multimodallıq və açıqlıq ölçülərini tək bir ortaq müqayisə çərçivəsinə yerləşdirməsi; model sənədlərindən yenidən qurulan arxitekturaları araşdırıla bilən bir taksonomiya və interaktiv alət halına gətirməsidir.
Bu Verianla mətnindəki elmi arxitektura izahları, müqayisə dəyərləri, çıxarımlar və məhdudiyyətlər yüklənən mənbə tədqiqatına əsaslanır. Biblioqrafik kimlik və rəyçilik vəziyyəti xaricində xarici mənbələrdən yeni LLM performans nəticəsi əsas elmi mətnə əlavə edilməmişdir.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib