

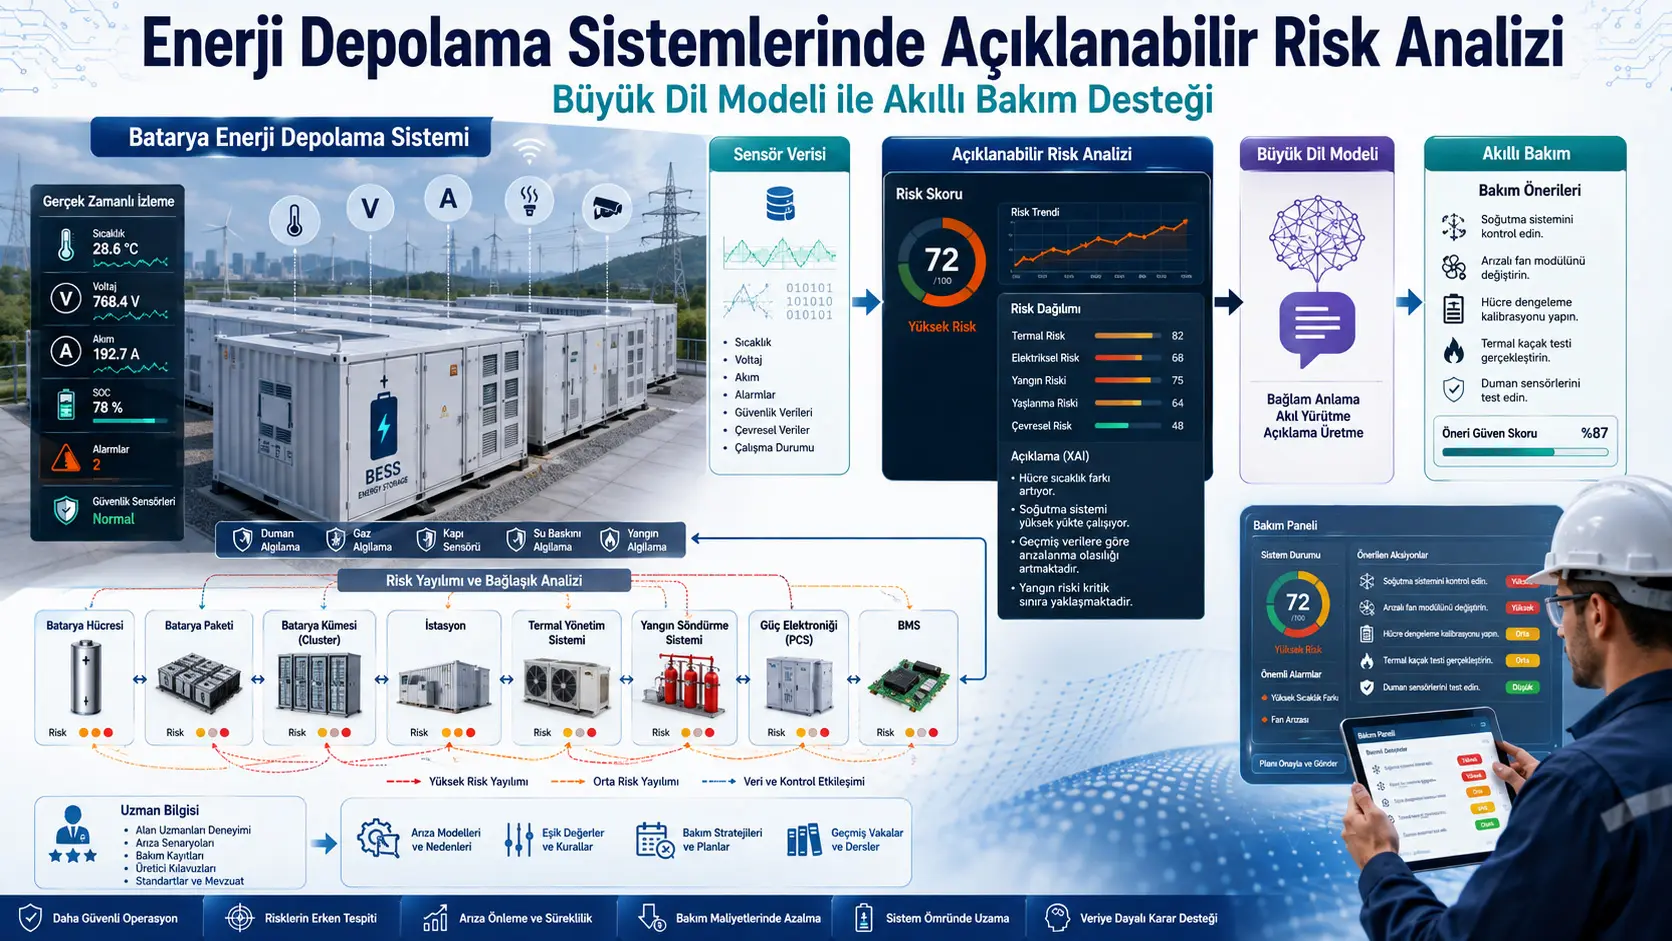
Utafiti huu unapendekeza mfumo unaoelezeka wa usalama na matengenezo kwa vituo vya uhifadhi wa nishati vya kielektrokemia, unaounganisha data za sensa, tathmini za wataalamu, mahusiano ya uenezaji wa hatari, viwango vya kiufundi na modeli kubwa za lugha ndani ya mfumo mmoja wa kusaidia maamuzi. Lengo la mfumo si tu kutoa alama ya jumla ya hatari kwa kituo, bali pia kueleza hatari inatoka kwenye seli gani, pakiti ya betri, nguzo ya betri, mfumo wa kupoza, mfumo wa kuzima moto, umeme wa nguvu au sehemu ya mfumo wa usimamizi wa betri, na jinsi inavyoweza kuenea hadi sehemu nyingine.
Tathmini ya hatari ina makundi makuu nane, vipengele 26, vipengele vidogo 42 na vipengee 87 vya hatari. Kati ya hivyo, 32 vinategemea data za kiasi kama joto, voltage, current, humidity na idadi ya alarm; 55 vinategemea tathmini za ubora zinazohitaji ukaguzi wa wataalamu kwa mambo kama uharibifu wa kimwili, maandalizi ya moto, hitilafu za mawasiliano au upungufu wa matengenezo. Uzito wa vipengele uliamuliwa kwa fuzzy analytic hierarchy process, hatari za kiasi zilipewa alama kwa mbinu ya CRPS inayotegemea marudio ya alarm, na hatari za ubora kwa modeli ya severity-probability-exposure.
Mfumo ulitumika kwenye data za mwaka 2024 kutoka vituo sita vya uhifadhi wa nishati vinavyofanya kazi nchini China. Kuongeza mahusiano ya sababu-na-matokeo kati ya hatari kwenye alama kulipunguza alama za jumla za hatari za vituo vyote sita kwa angalau asilimia 7 katika tathmini za Machi 2024; kwa maneno mengine, mfumo uliangalia si tu matatizo yanayoonekana moja kwa moja bali pia hatari za pili zinazoweza kuchochewa na matatizo hayo. Katika kituo cha kwanza, ongezeko la alarm za overcharge na overdischarge katika kipindi cha Julai–Septemba lilipunguza alama za hatari za matumizi na kuzeeka kwa seli, wakati kituo cha sita kilichokuwa kikifanya kazi kawaida hakikuonyesha muundo huo.
Sehemu ya modeli kubwa ya lugha hutumia RAG, reranking, prompt design na domain-focused fine-tuning kueleza alama za hatari kwa lugha ya kawaida na kutoa mapendekezo ya matengenezo yaliyounganishwa na viwango vya kiufundi. Katika maswali ya maarifa, modeli iliyofanyiwa fine-tuning ya Qwen3-8B ilitoa matokeo mazuri; katika kazi pana zaidi kama maelezo ya hatari na mapendekezo ya matengenezo, Kimi-K2.6 ilipata alama za juu kati ya modeli za kiwango kamili, na Qwen2.5-14B kati ya modeli zilizofanyiwa fine-tuning. Matokeo yanaonyesha kuwa modeli ndogo zinaweza kubadilishwa vizuri kwa maarifa ya sekta, lakini katika maamuzi magumu ya matengenezo ukubwa wa modeli na uwezo wa jumla wa reasoning bado ni muhimu.
Umuhimu kwa Uturuki: Katika vituo vya uhifadhi wa nishati ya betri vinavyojengwa au kuendeshwa Uturuki, kutathmini pamoja joto la seli, voltage, current na rekodi za alarm pamoja na mfumo wa kuzima moto, miundombinu ya kupoza, BMS, power converter na ukaguzi wa eneo kunatoa mbinu muhimu ya usalama. Hata hivyo vipengee vya hatari, thresholds, nyaraka za kiufundi na mapendekezo ya matengenezo katika utafiti huu viliandaliwa kwa viwango vya China. Kabla ya kutumika Uturuki, risk index inapaswa kujengwa upya kwa mujibu wa sheria za ndani zinazotumika, masharti ya kuunganishwa kwenye gridi, mahitaji ya usalama wa moto, usanifu wa vituo na masharti ya ulinzi wa data; ithibitishwe kwa data halisi za vituo katika maeneo tofauti ya hali ya hewa; na mapendekezo ya akili bandia yasitumike moja kwa moja kwenye vifaa bila idhini ya mhandisi mwenye mamlaka. Utafiti huu hauwezi kutoa moja kwa moja uwezekano wa moto maalumu kwa Uturuki, faida ya gharama au njia ya lazima ya matengenezo.
Utafiti unaweka modeli kubwa ya lugha si kama kidhibiti cha usalama, bali kama safu inayotoa maelezo na msaada wa maamuzi kwa wafanyakazi wa matengenezo. Toleo la sasa la mfumo uliopendekezwa halitoi amri moja kwa moja kwa vifaa vya kuzima moto, kupoza au kubadilisha nguvu. Kikomo hiki ni kanuni muhimu ya usalama inayopunguza uwezekano wa jibu lisilo sahihi au lisilokamilika la akili bandia kusababisha hatari moja kwa moja kwenye kituo halisi.
Tatizo kuu la utafiti ni nini?
Vituo vya uhifadhi wa nishati vya kielektrokemia vina idadi kubwa ya seli za betri, pakiti za betri, nguzo za betri, power converters, mfumo wa usimamizi wa betri, mfumo wa usimamizi wa joto, miundombinu ya mawasiliano na sehemu za kuzima moto. Hitilafu katika sehemu moja inaweza isibaki kuwa tatizo la eneo moja tu; inaweza kuenea hadi mifumo mingine kupitia joto, kutokuwiana kwa umeme, kupotea kwa mawasiliano au kosa la udhibiti.
Mbinu za jadi za tathmini ya hatari mara nyingi hutegemea alama zinazotolewa na wataalamu kwa vipindi fulani au hali moja ya hitilafu. Mbinu hizi zinaweza kupanga hatari kwa umuhimu, lakini si kila mara zinaeleza kwa nini alama ilishuka, tatizo linaweza kuathiri sehemu zipi na timu ya matengenezo inapaswa kufanya hatua zipi kwa mpangilio gani.
Mapengo matatu makuu ambayo utafiti unalenga kutatua ni haya:
- Ukosefu wa tathmini ya hatari ya mabadiliko inayofunika kituo kizima na kuunganisha data za sensa na maoni ya wataalamu,
- Kutoweza kueleza kwa wafanyakazi wa matengenezo sababu za alama za hatari na njia za uenezaji wa hatari kwa njia inayoeleweka,
- Kutokuwepo kwa kiungo cha moja kwa moja kati ya tathmini ya hatari na mapendekezo yanayotekelezeka ya matengenezo yanayotegemea viwango vya kiufundi.
Usanifu wa jumla wa mfumo uliopendekezwa
Kielelezo cha kwanza kwenye ukurasa wa sita wa utafiti kinaonyesha sehemu mbili kuu za mfumo. Sehemu ya kwanza ni tathmini ya hatari ya ngazi mbalimbali. Data za sensa na maarifa ya wataalamu hubadilishwa kuwa risk index, uzito wa vipengele, alama za hatari na mahusiano kati ya vipengele.
Sehemu ya pili ni msaada wa maamuzi ya matengenezo unaotegemea modeli kubwa ya lugha. Matokeo ya hatari huingizwa kwenye database yenye vyanzo vingi pamoja na viwango vya kiufundi, miongozo ya vifaa, machapisho ya kitaaluma na rekodi za zamani za uendeshaji. Swali la mtumiaji linapowasilishwa, modeli kubwa ya lugha hurejesha nyaraka husika na kutoa maelezo ya hatari pamoja na mapendekezo ya matengenezo.
Mtiririko mkuu wa data katika mfumo ni huu:
- Kukusanya data za sensa na ukaguzi wa eneo,
- Kutoa alama za kiasi au ubora kwa vipengee vya hatari,
- Kutumia uzito wa vipengele,
- Kuhesabu upya alama kwa mahusiano ya uenezaji wa hatari,
- Kutambua hatari muhimu zaidi,
- Kurejesha viwango na nyaraka husika za matengenezo kwa RAG,
- Modeli kubwa ya lugha kutoa maelezo na mapendekezo ya matengenezo,
- Kuwasilisha matokeo kwa mhandisi au mfanyakazi wa matengenezo.
Upeo wa risk index ya ngazi mbalimbali
Mfumo wa risk indexing katika utafiti una ngazi nne:
- Ngazi ya kundi: Maeneo makuu nane ya mfumo,
- Ngazi ya kipengele: Aina za hitilafu za umeme, joto, mitambo au mazingira,
- Ngazi ya kipengele kidogo: Matukio maalumu zaidi kama short circuit ya seli, thermal runaway ya pakiti au hitilafu ya sensa,
- Ngazi ya kipengee cha hatari: Viashiria 87 vinavyopimwa au kutathminiwa na mtaalamu.
| Kodi | Kundi kuu la hatari | Maeneo makuu yanayochunguzwa |
|---|---|---|
| C1 | Hatari ya seli ya betri | Short circuit ya ndani, overcharge/discharge, ongezeko la joto, kuvimba, kuvuja na hali za mazingira |
| C2 | Hatari ya pakiti ya betri | Upotevu wa capacity, over/undervoltage, insulation, tofauti ya joto ndani ya pakiti na uharibifu wa mitambo |
| C3 | Hatari ya nguzo ya betri | Kosa la SOC, kutokuwiana kwa pakiti, efficiency, connection impedance, insulation na thermal propagation |
| C4 | Hatari ya kituo au cabinet | Current kati ya cabinets, local overheating, uharibifu wa ventilation, humidity, moshi na gesi inayowaka |
| C5 | Hatari ya mfumo wa usimamizi wa joto | Temperature sensors, pump, radiator, coolant pipes na flow rate |
| C6 | Hatari ya mfumo wa kuzima moto | Utambuzi wa moshi, mawasiliano, mfumo wa udhibiti, extinguishing agent, sprinkler, access na emergency preparedness |
| C7 | Hatari ya umeme wa nguvu | Transformer insulation, converter failure, overheating na winding deformation |
| C8 | Hatari ya mfumo wa usimamizi wa betri | Makosa ya kupima joto, voltage na current; insulation, electromagnetic compatibility na mawasiliano |
Vipengee vya hatari vya kiasi na ubora
Kati ya vipengee 87 vya hatari, 32 vimeainishwa kuwa vya kiasi na 55 vya ubora. Vipengee vya kiasi ni variables kama joto, voltage, SOC, humidity, efficiency na idadi ya alarm vinavyoweza kupatikana kutoka sensa au rekodi za uendeshaji.
Vipengee vya ubora vinahusisha mambo ambayo ni vigumu kupimwa moja kwa moja kwa sensa inayoendelea, kama deformation ya casing ya seli, ukosefu wa access ya moto, upungufu wa uzoefu wa matengenezo, uharibifu wa bomba au hitilafu ya mfumo wa kuzima moto. Vipengee hivi hupewa alama kupitia ukaguzi wa eneo na tathmini za wataalamu.
Kuunganisha aina hizi mbili za data kunaweza kufunika sehemu kubwa zaidi ya kituo kuliko mbinu zinazotegemea sensa za kielektroniki pekee. Kwa upande mwingine, matokeo yanakuwa tegemezi kwa ubora wa tathmini za wataalamu na consistency kati ya ukaguzi.
Uzito wa vipengele uliamuliwaje?
Ilikubaliwa kwamba vipengele vya hatari havina umuhimu sawa. Wataalamu sita walilinganisha umuhimu wa kila jozi ya vipengele kwa mizani ya lugha. Tathmini kama “muhimu sawa”, “muhimu kwa kiwango cha kati” au “muhimu zaidi kabisa” zilibadilishwa kuwa triangular fuzzy numbers.
Consistency ya expert comparison matrix ilikaguliwa kwa vigezo hivi:
\[ CI=\frac{\lambda_{\max}-n}{n-1} \]
\[ CR=\frac{CI}{RI} \]
Hapa CI ni consistency index, CR consistency ratio, λmax eigenvalue kubwa zaidi ya comparison matrix, n idadi ya vipengele vinavyolinganishwa na RI reference consistency index kwa random matrices.
Katika utafiti, CR ≤ 0,1 ilitumika kama condition ya consistency inayokubalika. Ratio ilipozidi thamani hii, matrix ilirekebishwa iteratively huku ikibaki karibu iwezekanavyo na maoni ya awali ya wataalamu. Baadaye uzito wa vipengele ulihesabiwa kwa fuzzy analytic hierarchy process.
Hatari za kiasi kutoka sensa zilipataje alama?
Kwa hatari za kiasi zinazotegemea idadi na kiwango cha alarm, Cumulative Risk Score System ilitumika:
\[ I=\max\left(0,\ 10-\alpha\sum_{i=1}^{A}i\,n_i^2\right) \]
Hapa I ni safety score ya kipengee cha hatari, α sensitivity coefficient, i alarm level, ni alarm frequency katika level husika na A idadi ya alarm levels. Katika utafiti, α kwa kawaida ilichukuliwa kuwa 0,6.
Kutumia square ya alarm frequency kunafanya alarm zinazojirudia zipunguze alama kwa kasi isiyo ya mstari. Kwa njia hii, mfumo unajaribu kuzuia alarm moja ya muda mfupi kutathminiwa sawa na tatizo linalojirudia mara kwa mara.
Hatari za ubora zilipataje alama?
Kwa vipengee vinavyotegemea tathmini ya wataalamu, modeli ya Severity, Probability na Exposure ilitumika:
\[ I=10-\beta(S\cdot P\cdot E) \]
S inawakilisha severity ya hatari, P probability ya kutokea, E exposure level na β sensitivity coefficient. Variables zote tatu zilitathminiwa na wataalamu katika range ya 0–10.
Thamani kubwa za S, P na E zinaonyesha hali mbaya zaidi ya usalama. Alama ya juu zaidi katika formula ni 10. Hata hivyo utafiti haujaeleza wazi exact value ya β iliyotumika katika implementation wala jinsi negative results zilivyobaniwa katika lower bound.
Kwa nini risk-propagation network ilitumika?
Hatari katika kituo cha uhifadhi wa nishati hazijitegemei. Kupungua kwa flow katika cooling system kunaweza kuongeza joto la seli; ongezeko la joto linaweza kuharakisha kuzeeka kwa seli; kosa la kipimo cha BMS linaweza kuchelewesha kugunduliwa kwa ongezeko hilo la joto.
Kielelezo 3 kwenye ukurasa wa kumi kinaonyesha directed cause-effect relationships kati ya vipengele vidogo 42. Mwanzo wa mshale unawakilisha hatari inayosababisha, na mwisho wake hatari inayoweza kuathiriwa. Network iliundwa kwa kutumia maoni ya wataalamu sita.
Matching coefficient kati ya vipengele viwili vilivyounganishwa ilihesabiwa hivi:
\[ C_{y\leftarrow x}= \left[ \frac{I_yI_x} {\left(\frac{I_y+I_x}{2}\right)^2} \right]^5 \]
Ix ni initial score katika hali ya sababu na Iy initial score katika hali iliyoathiriwa. Correction ya score ilitolewa kwa muundo huu:
\[ I_{c,y}=I_y\exp\left[ -\frac{C_{y\leftarrow x} \sqrt{(I_y-I_x+1)I_y/I_x^2}} {G} \right],\qquad G=7 \]
Ikiwa kipengele kidogo kinaathiriwa na hatari zaidi ya moja, lowest corrected score iliyohesabiwa huchaguliwa. Lengo ni kuhakikisha relationship yenye athari mbaya zaidi inaonekana katika matokeo.
Final risk contribution ilihesabiwa kwa kuchanganya corrected score na uzito wa kipengele:
\[ R_{c,y}=(10-I_{c,y})w \]
w ni uzito wa kipengele husika uliohesabiwa kwa fuzzy hierarchy method. Low safety score na high weight hutengeneza higher risk contribution.
Risk-propagation score inapaswa kutafsiriwaje?
Corrected score kuwa lower than initial score haimaanishi kwamba physical failure mpya imeonekana. Kupungua huku ni mathematical expression ya kwamba existing risk inaweza kuathiri subsystem nyingine kutokana na cause-effect relationships zilizofafanuliwa na wataalamu.
Kwa hiyo score reductions za asilimia 7 au zaidi hazipaswi kutafsiriwa kama measured percentage increase katika real failure probability. Hizi ni relative changes ndani ya scoring system iliyoundwa na utafiti.
Knowledge base yenye vyanzo vingi
Kielelezo 5 kwenye ukurasa wa 12 kinagawa database inayotumiwa na modeli kubwa ya lugha katika makundi matatu makuu:
- Maarifa ya sekta: National standards, technical guides, user documents na academic publications,
- Data za tathmini ya hatari: Risk scores, indexing system, factor weights, scoring algorithms na connection network,
- Historical operating data: Sensor records, alarm levels, maintenance history na expert surveys.
Muundo huu unalenga kufanya modeli kubwa ya lugha itumie nyaraka za kiufundi zinazohusiana na matokeo ya hatari ya kila kituo badala ya kutegemea general knowledge yake pekee.
Modeli kubwa ya lugha ilibadilishwaje kwa sekta?
Utafiti uliunda two-stage training process kwa local na offline use. Stage ya kwanza ni semantic adaptation pretraining. Nyaraka za uhifadhi wa nishati zilitumika ili modeli ielewe vizuri technical terms na muundo wa maandishi wa sekta.
Pretraining loss function ni hii:
\[ L_{\mathrm{SAPT}}= -\sum_{i=1}^{N}\log P(y_i|x_i;\theta) \]
Katika stage ya pili, instruction fine-tuning ilifanywa kwa question-answer pairs kuhusu matengenezo, tathmini ya hatari na failure analysis:
\[ L_{\mathrm{IFT}}= -\sum_{i=1}^{N}\log P(y_i|x_i,z_i;\theta) \]
zi inawakilisha task context au required output format.
Kwa nini LoRA ilitumika?
Kusasisha parameters zote za modeli kubwa ya lugha kunahitaji memory na computation cost kubwa. Researchers walitumia low-rank adaptation kupunguza gharama hii:
\[ W=W_0+\Delta W,\qquad \Delta W=BA \]
\[ B\in\mathbb{R}^{d\times r},\qquad A\in\mathbb{R}^{r\times k},\qquad r<\min(d,k) \]
Original weight matrix W0 iliwekwa constant; only smaller A na B matrices zilifundishwa. Approach hii inalenga kufanya adaptation ya 7B na 14B scale models iwezekane kwa single RTX 4090 graphics card.
RAG process inafanyaje kazi?
Technical documents zilibadilishwa kwanza kuwa hierarchical Markdown texts na kugawanywa katika chunks za 500–1000 characters. Asilimia 10 overlap ilitumika kati ya neighboring chunks.
Kila text chunk ilibadilishwa kuwa 1024-dimensional vector:
\[ \mathbf{v}_{ij}=f_{\theta}(c_{i,j}) \]
Utafiti ulitumia multilingual BAAI/bge-m3 embedding model, LangChain na Chroma vector database. User query ilibadilishwa kuwa vector kwa same model na closest chunks zikarejeshwa according to cosine similarity:
\[ R(x)= \underset{\mathbf{v}_{ij}\in V}{\operatorname{arg\,max}}_{k} \ s\left(f_{\theta}(x),\mathbf{v}_{ij}\right) \]
Initial results zilirerankiwa kwa cross-encoder; chunks zenye higher semantic, logical na contextual relevance zilichaguliwa. Final answer iliundwa kwa kutumia pamoja user query, risk assessment, retrieved documents na structured prompt.
Muundo wa jibu la matengenezo linalotolewa
Katika prompt example kwenye ukurasa wa 15, modeli iliombwa kutoa kwanza sababu fupi tatu hadi sita, kisha matokeo ya pointi nne hadi sita. Jibu lilitarajiwa kufuata mpangilio huu:
- General risk-assessment result,
- Explanation ya most critical risks,
- Two or three actionable maintenance recommendations,
- Ikiwezekana standard number na clause reference.
Muundo huu unalenga kumpa mfanyakazi wa matengenezo output fupi na inayoweza kuchukuliwa hatua badala ya maandishi marefu na yaliyotawanyika.
Vituo sita vya eneo
Utafiti ulitumia data za sensa za mwaka 2024 kutoka vituo sita vinavyofanya kazi katika maeneo tofauti ya hali ya hewa na uendeshaji nchini China.
| Kituo | Mahali | Maelezo katika utafiti |
|---|---|---|
| 1 | Fuzhou, Fujian | Kituo cha maonesho chenye usimamizi mkali |
| 2 | Wuzhong, Ningxia | Mradi wa uhifadhi wa ndani unaotumia cabinets za nje |
| 3 | Weihai, Shandong | Kituo cha pwani kinachoathiriwa sana na hali za mazingira ya asili |
| 4 | Xiamen, Fujian | Kituo cha ushirikiano wa third party kinachofanya kazi kwa uthabiti |
| 5 | Dezhou, Shandong | Kituo cha aina ya jamii kinachohudumia watumiaji wa eneo |
| 6 | Linfen, Shanxi | Kituo cha uhifadhi wa nishati kilichounganishwa na gridi |
Muundo wa kundi la wataalamu
Wataalamu sita walitumika kuamua uzito wa vipengele na kuunda risk-connection network. Uzoefu wao ulikuwa kati ya miaka 7–16. Kundi lilihusisha maeneo ya cell development, quality control, system architecture, BMS development na energy-storage-system design.
Idadi ya wataalamu na utofauti wa maeneo yao hutoa maarifa ya vitendo. Hata hivyo, kwa sababu wataalamu wote walitoka katika nchi na mazingira sawa ya viwanda, tathmini zao haziwezi kuhamishwa moja kwa moja kwenye mazingira tofauti ya kisheria na kiutendaji bila uthibitisho.
Matokeo ya alama za hatari za vituo
Kielelezo cha sita kwenye ukurasa wa 17 kinaonyesha initial na corrected annual scores za vituo sita pamoja na monthly heatmap ya overcharge na overdischarge alarms. Baada ya connection network kutumika, overall score ilishuka katika vituo vyote.
Katika tathmini ya Machi 2024, approximate station-level reductions zilikuwa:
| Kituo | Mabadiliko ya overall score baada ya connection correction |
|---|---|
| 1 | Approximately %7,8 reduction |
| 2 | Approximately %7,6 reduction |
| 3 | Approximately %8,8 reduction |
| 4 | Approximately %7,9 reduction |
| 5 | Approximately %7,2 reduction |
| 6 | Approximately %7,0 reduction |
Largest overall change ilionekana katika kituo cha tatu na lowest change katika kituo cha sita. Kwa sababu C8 category ilikuwa starting node katika connection network, haikuathiriwa moja kwa moja na hatari nyingine na haikurekebishwa at category level.
Comparison ya kituo cha kwanza na cha sita
Kielelezo 8 kwenye ukurasa wa 18 kinalinganisha overcharge na overdischarge alarm results za kituo cha kwanza na cha sita.
Kituo cha kwanza kiliingia katika no-load operation period katika Julai–Septemba 2024 na idadi ya alarm ikaongezeka wazi. Matokeo yake, score ya overcharge/discharge risk item, abnormal cell-use subfactor na cell-risk category ilishuka.
Katika kituo cha sita, alarm counts zilibaki lower na stable, na hakuna reduction ya aina hiyo iliyoonekana katika risk score. Mfano huu unaonyesha jinsi repeated sensor alarms zinavyoweza kusambazwa ndani ya hierarchical structure hadi higher-level risk scores.
Mfano wa maintenance explanation kwa kituo cha kwanza
Kwa Machi 2024, initial score ya kituo cha kwanza imetolewa kuwa 9,422752 na score baada ya connection kuwa 8,686389. Katika jibu la modeli kubwa ya lugha kwenye utafiti, hizi zilielezwa kama approximately 94,2 na 86,9 out of 100.
Modeli ilionyesha power electronics na battery-cluster risks kama contributors muhimu; ilitaja BMS measurement issues, thermal-propagation indicators na power-converter behavior kama maeneo yanayopaswa kukaguliwa.
Mapendekezo yaliyotolewa yalijumuisha sensor calibration, redundant measurement checks, kuimarisha thermal inspection katika battery clusters na packs, na kupima dynamic behavior ya power converter kulingana na relevant standards.
Maswali ya maarifa yalitathminiwaje?
Ili kupima maarifa ya sekta, jumla ya maswali 240 yaliandaliwa kutoka maswali 30 ya awali katika aina nane tofauti. Maswali yalipima uwezo huu:
- Kujibu swali la awali,
- Kuelewa formulations tofauti zenye maana sawa,
- Kuoanisha technical terms na abbreviations,
- Kustahimili spelling na grammar errors,
- Kujibu maswali ya jumla au yaliyobainishwa zaidi,
- Kuunganisha knowledge points nyingi,
- Kutambua negative na boundary cases.
Majibu yalipewa alama 0–5 na wataalamu watano wa uhifadhi wa nishati. Ikiwa alama za wataalamu zilitofautiana kwa zaidi ya pointi mbili, joint evaluation ilifanywa; kwa tofauti ndogo zaidi, average ilitumika.
Ni modeli zipi zilifanya vizuri katika maswali ya maarifa?
Kulingana na Kielelezo 11 kwenye ukurasa wa 22, fine-tuned Qwen3-8B ilipata highest au near-highest results katika semantic understanding, terminology na domain knowledge. Katika logical dimension, Kimi-K2.6 ilipata highest result.
Fine-tuned Llama3.1-8B pia ilionyesha performance ya kuridhisha. Fine-tuned Qwen2.5-7B ilitoa matokeo noticeably lower kati ya modeli zilizotathminiwa.
Result hii inaonyesha kwamba modeli ndogo haipaswi kutathminiwa kwa parameter count pekee; adaptation kwa high-quality domain data inaweza kuifanya ipite general models kubwa katika baadhi ya knowledge tasks.
Maswali ya kina ya matengenezo yalitathminiwaje?
Maswali 24 ya kina yaliandaliwa kutoka quarterly results za mwaka 2024 za vituo sita. Maswali haya yaliomba explanation ya risk score, identification ya most likely risks na generation ya maintenance recommendation.
Majibu yalipewa alama kwa criteria nne:
- Usahihi: Matumizi sahihi ya risk data na retrieved technical knowledge,
- Muundo: Kufuata requested format na order,
- Uwazi: Jibu kuwa fupi, linaloeleweka na lisilo na repetition isiyo ya lazima,
- Kulingana na nia ya mtumiaji: Kujibu swali moja kwa moja.
Evaluation ilifanywa na both wataalamu watano wa kibinadamu na AI evaluators walioitwa GPT5.5 thinking, Qwen3.7-max-thinking, Doubao na Gemini3.1-pro katika utafiti. Technical details za model versions hizi na full evaluation prompts hazikutolewa.
Matokeo ya modeli katika maswali ya kina
Kati ya full-scale models, both human na AI evaluators walichagua Kimi-K2.6 kama modeli yenye highest final score. Kulingana na human experts, DeepSeek-V3.2 iliongoza katika accuracy; Kimi-K2.6 katika structure, clarity na user-intent alignment.
Kati ya fine-tuned open models, Qwen2.5-14B ilipata highest final score. Qwen3-8B ilikuwa strong katika knowledge questions, lakini kwa human-expert evaluation haikuendeleza same level of success katika comprehensive risk explanations.
Different sizes za Qwen3 family zilipolinganishwa, comprehensive-task performance generally iliongezeka pamoja na model size. Hii inaashiria kwamba pamoja na technical knowledge recall, synthesizing multi-step risk relationships inaweza kuhitaji greater general reasoning capacity.
Mapungufu ya evaluation method
Kwa kuwa hakuna one correct answer kwa comprehensive maintenance responses, expert evaluation ni choice inayoeleweka. Hata hivyo study haijatoa inter-rater agreement statistics kama Cohen kappa, intraclass correlation au Krippendorff alpha.
Kutumia large language models nyingine kama judges kunaweza kupunguza evaluation cost, lakini kwa sababu ya possible overlap katika training data, language preferences au formatting biases, majibu haya hayawezi kuchukuliwa kama independent safety validation.
Pia rate ya modeli kurejea wrong standard, kutengeneza nonexistent clause number, kuacha required safety step au kupendekeza dangerous operation sequence haijaripotiwa kama separate metric.
Comparison na existing methods
Study inalinganisha proposed method na FAHP-CRITIC na D-ANP-based risk assessments.
| Feature | Conventional comparison methods | Proposed method |
|---|---|---|
| Data source | Mainly expert opinions | Expert opinions na sensor data |
| Update | Monthly au annually | Inaweza kusasishwa sensor data inapofika |
| Factor relationships | Hierarchical index | Hierarchical index na risk-propagation network |
| Scoring | Ranking statistics | SPE na CRPS-based scoring |
| Explanation | Limited | Explanation na maintenance recommendation kwa large language model |
Main novelty ya study si kila method peke yake, bali kuunganisha risk scoring, connection analysis, document retrieval na natural-language decision support katika one workflow.
Kikomo cha madai ya real-time evaluation
Kusasisha quantitative risk items kwa sensor data kunaweza technically kuruhusu near-real-time evaluation. Hata hivyo field results katika study zimeonyeshwa kwa annual, monthly na quarterly aggregations.
Time kutoka alarm hadi maintenance recommendation, data-processing latency, LLM response time, continuous-service availability na processing ya many stations simultaneously hazikupimwa. Kwa hiyo real-time industrial performance bado haijaonyeshwa kikamilifu.
Online na offline use
Mfumo unapendekeza deployment modes mbili:
- Online use: API ya large model inatumika. Local computation cost ni low, lakini kutuma data kwa external service kunahitaji privacy na security assessment.
- Offline use: Fine-tuned small model inaendeshwa kwenye server ya kituo au operator. Data zinaweza kubaki local, lakini stronger hardware inahitajika kwa training na inference.
Training system katika study ilikuwa na NVIDIA RTX 4090 yenye 24 GB memory, Intel Core i9-10900X processor, 128 GB DDR4 memory na Ubuntu 22.04 operating system. LLaMA-Factory ilitumika kwa training, Ollama kwa model loading na local execution.
Authors wanapendekeza at least one RTX 4090 na zaidi ya 64 GB system memory kwa offline deployment. Values hizi ni za model na software setup iliyotumika katika study; si universal hardware requirements kwa all models.
Mfumo unadhibiti vifaa moja kwa moja?
Hapana. Toleo la sasa la utafiti linatoa tu risk assessment, explanation na maintenance recommendation. Haliwezi kutuma amri directly kwa fire-suppression system, power converter, cooling system au switchgear.
Authors wanapendekeza baadaye kuunganisha software au devices kupitia Model Context Protocol na multi-agent structures. Hata hivyo kwa usalama, extension kama hiyo ingehitaji controls za ziada kama authorization, command validation, physical interlock, human approval, rollback na fail-safe transition. Controls hizi hazijaendelezwa katika study ya sasa.
Matokeo yanayoungwa mkono na study
- Sensor data na expert evaluations zinaweza kuunganishwa katika same hierarchical risk structure.
- Risk-connection network inaweza kufanya visible possible effects za directly measured problems kwa other subsystems.
- Data za mwaka 2024 kutoka vituo sita zinaonyesha kwamba changes katika alarm counts zinaweza kuakisiwa kwenye cell na higher-category scores.
- Structured maintenance explanations zinaweza kuzalishwa kwa kutumia RAG pamoja na risk-assessment results.
- Domain-focused fine-tuning inaweza kuboresha significantly performance ya small models katika technical knowledge questions.
- Katika complex risk explanations, full-scale models generally zinaweza kutoa stronger results.
- Human-approved decision support inaweza kuwa more practical kuliko risk system inayotoa scores bila explanation.
Study haithibitishi nini?
- Haithibitishi kwamba framework imepunguza kwa vitendo idadi ya fires, thermal-runaway events au equipment failures.
- Haionyeshi kwamba risk scores ni real failure probabilities au expected financial loss.
- Haionyeshi kwamba percentage reductions kutoka connection correction zinamaanisha same percentage increase katika real risk.
- Haithibitishi kwamba all maintenance recommendations za large language model ni safe, correct na complete.
- Haionyeshi kwamba knowledge base iliyoundwa kwa Chinese standards inaweza kutumika directly katika countries nyingine.
- Haionyeshi kwamba framework inafanya kazi real time at second-level scale au performance yake katika large-fleet scale.
- Haionyeshi kwamba inaweza kuchukua nafasi ya human maintenance personnel au iko ready kwa autonomous equipment control.
- Haionyeshi kwamba same results zitapatikana katika battery chemistries, manufacturers na facility architectures nje ya vituo sita vilivyochunguzwa.
Main limitations za study
- Study haijapitia peer review.
- Field sample imewekewa mipaka katika vituo sita vya China.
- Facility capacities, battery chemistry na detailed equipment architectures hazijatolewa.
- Risk-connection network inategemea maoni ya wataalamu sita.
- Hakuna comprehensive sensitivity analysis kwa fifth power katika connection coefficient na constant G=7.
- Exact applied value ya β coefficient katika SPE equation haiko wazi.
- Risk scores hazijathibitishwa dhidi ya independent target variables za actual failures na maintenance outcomes.
- Real-time claim imeonyeshwa mainly kupitia monthly na quarterly results.
- Retrieval accuracy, citation accuracy na missed-document rate ya RAG system hazijatolewa quantitatively.
- Inter-rater agreement statistic kati ya human evaluators haijaripotiwa.
- Versions, prompts na execution conditions za LLM evaluators hazijaelezwa fully.
- Kuna version inconsistency kati ya jina Kimi-K2.6 na Kimi K2.5 study iliyotolewa katika references.
- Dataset, code, expert surveys na full model outputs hazijashirikiwa kwa open-access link.
- Hakuna dedicated safety test kwa wrong au unsafe maintenance recommendations.
Hatua zinazohitajika kwa matumizi nchini Uturuki
Katika stage ya kwanza, architectures za energy-storage facilities zinazotumiwa Uturuki zinapaswa kuainishwa; country-specific risk-indexing system ijengwe kwa cell, pack, cluster, BMS, power converter, thermal management, fire suppression na site infrastructure.
Katika stage ya pili, local knowledge base inapaswa kuandaliwa kwa technical regulations zinazotumika Uturuki, grid-connection conditions, fire-safety documents, manufacturer manuals na maintenance procedures badala ya Chinese standards katika study. Kila document inapaswa kufuatiliwa kwa version, effective date na clause number.
Katika stage ya tatu, sensor data zinapaswa kubadilishwa kuwa common data dictionary. Inapaswa kuthibitishwa kama cell voltage, temperature, current, SOC, insulation, cooling flow, alarm codes na maintenance records zina maana sawa kati ya manufacturers tofauti.
Katika stage ya nne, risk score inapaswa kupimwa retrospectively si kwa expert opinion pekee bali pia dhidi ya actual failures, maintenance interventions, unplanned downtime, temperature events na false alarms. Inapaswa kupimwa ni sehemu gani ya situations ambazo model ilisema ni risky zilibadilika kuwa real events.
Katika stage ya tano, closed safety evaluation inapaswa kufanywa kwa large language model. Scenarios za kutengeneza nonexistent standard clause, kupendekeza wrong equipment, kupendekeza unsafe action under high voltage, kuacha critical warning na kuelekeza user kwenye unnecessary intervention zinapaswa kupimwa specifically.
Katika final stage, mfumo utumike only kama decision-support tool; kila maintenance recommendation ithibitishwe na authorized engineer au responsible operating personnel. Independent safety logic, authorization na human approval zinapaswa kuwepo kati ya AI na direct physical equipment control.
Mbinu na Matokeo ya Utafiti
Muhtasari wa research design
| Stage | Method | Main output |
|---|---|---|
| Kuunda risk system | Kutoa risk items kutoka standards na academic sources | 8 categories, 26 factors, 42 subfactors na 87 items |
| Kuamua weight | Wataalamu sita na consistency-corrected FAHP | Risk-factor weights |
| Quantitative scoring | CRPS na sensor alarm records | Scores za 32 quantitative risk items |
| Qualitative scoring | Severity, probability na exposure model | Scores za 55 qualitative risk items |
| Risk propagation | Expert-defined directed connection network | Corrected subfactor na category scores |
| Knowledge base | Standards, manuals, publications, sensor na risk data | Multi-source database kwa RAG |
| Model adaptation | SAPT, instruction fine-tuning na LoRA | Domain-focused LLMs zinazoweza kutumika locally |
| Response generation | Embedding, Chroma, reranking, prompt na CoT | Risk explanation na maintenance recommendations |
| Field application | 2024 sensor data kutoka six active stations | Initial na connection-corrected risk scores |
| LLM evaluation | 240 knowledge questions na 24 comprehensive maintenance questions | Performance comparison according to model type na task structure |
Numerical scope ya risk index
| Item | Number | Function |
|---|---|---|
| Main category | 8 | Inawakilisha main safety systems za facility |
| Risk factor | 26 | Inatenganisha electrical, thermal, mechanical na environmental failures |
| Subfactor | 42 | Inaunda nodes za risk-propagation network |
| Risk item | 87 | Ni level ambayo sensor au expert evaluation inapewa score directly |
| Quantitative item | 32 | Inapewa score kutoka sensor na alarm records |
| Qualitative item | 55 | Inapewa score kwa expert au site inspection |
Comparison ya risk-scoring methods
| Method | Input | Advantage | Limitation |
|---|---|---|---|
| FAHP | Pairwise importance comparisons za experts | Inabadilisha uncertain linguistic assessments kuwa weights | Inategemea expert group na comparison matrix |
| CRPS | Alarm level na repetition count | Inapenalize repeated alarms more strongly | Alarm thresholds zikiwa wrong, score inaweza pia kupotosha |
| SPE | Severity, probability na exposure | Inajumuisha physical na organizational risks zisizopimika kwa sensor | Iko open kwa subjective assessment |
| Connection correction | Subfactor scores na directed relationship network | Inafanya risk propagation na chain effects ziwe visible | Connections na coefficients si experimental proof ya causality |
Modeli zilizotumika katika LLM experiment
| Model group | Models evaluated in study | Use mode |
|---|---|---|
| Fine-tuned open models | Qwen2.5-7B, Qwen2.5-14B, Qwen3-8B, Llama3.1-8B | Local pretraining, instruction fine-tuning na offline inference |
| Full-scale models | Qwen3-235B-A22B, DeepSeek-V3.2, DeepSeek-R1, Kimi-K2.6, GLM-5.1 | Kupitia online API, bila additional fine-tuning |
| AI evaluators | GPT5.5 thinking, Qwen3.7-max-thinking, Doubao, Gemini3.1-pro | Kutoa scores kwa comprehensive responses pamoja na human experts |
Model names zimewasilishwa exactly kama zilivyotumika katika study. Kwa kuwa access dates, API settings, temperature parameters na full system prompts hazijatolewa, independent exact reproduction ya experiments ni limited.
Knowledge-question dataset
| Question type | Weight | Ability measured |
|---|---|---|
| Original question | 0,25 | Basic content na terminology accuracy |
| Meaning-equivalent rephrasing | 0,15 | Semantic alignment |
| Term na abbreviation substitution | 0,10 | Domain terminology |
| Spelling na grammar noise | 0,10 | Error tolerance |
| Question generalization | 0,10 | Knowledge transfer na generalization |
| Question narrowing | 0,10 | Precise knowledge retrieval |
| Inter-knowledge relationship | 0,10 | Logical integration |
| Boundary na negative question | 0,10 | Recognizing scope limits |
Main experimental findings
| Finding | Result reported in study | Interpretation limit |
|---|---|---|
| Field coverage | Six active stations in China, 2024 operating data | Haiwezi kugeneralizeiwa directly kwa countries na architectures nyingine |
| Connection correction | At least %7 reduction katika March 2024 overall scores | Si percentage change katika real failure probability |
| Alarm example | July–September alarms at Station 1 reduced scores | Haikuonyeshwa kwamba physical failure ilitokea baadaye |
| Knowledge questions | Fine-tuned Qwen3-8B strongest model katika most dimensions | Result ni specific kwa prepared 240-question evaluation |
| Logical knowledge task | Kimi-K2.6 got highest logical score | Kuna reference inconsistency katika model version |
| Full-scale comprehensive response | Kimi-K2.6 got highest final score | Inategemea subjective scores za human na LLM judges |
| Fine-tuned comprehensive response | Qwen2.5-14B got highest final score | Haimaanishi ndiyo best model katika every task |
| Model size | Generally larger model more successful in comprehensive tasks | Hardware, cost na data privacy zinapaswa kutathminiwa separately |
Scientific meaning ya figures na tables
- Figure 1: Inaonyesha overall architecture kutoka sensor na expert data hadi risk assessment, kisha LLM explanation na maintenance recommendation.
- Figure 2: Inaonyesha risk-index construction, FAHP weights, CRPS/SPE scoring, connection correction, LLM training na RAG steps katika one workflow.
- Figure 3: Inaonyesha expert-defined directed risk connections kati ya 42 subfactors.
- Figure 4: Inaeleza jinsi initial scores zinavyorekebishwa kwa connection coefficients na risk-propagation path kuhamishwa kwenye hierarchical score.
- Figure 5: Inaonyesha multi-source knowledge base yenye standards, guides, risk results na operating data.
- Figure 6: Inaonyesha annual initial na corrected scores za six stations pamoja na overcharge/discharge alarm heatmap.
- Figure 7: Inaonyesha kwa radar charts jinsi eight risk categories katika six stations zilivyoathiriwa na connection correction kwa March 2024.
- Figure 8: Inalinganisha propagation ya alarm increase katika Station 1 hadi cell na upper-category scores na stable condition katika Station 6.
- Figure 9: Inaonyesha raw risk score, summarized risk indicators na retrieved technical-knowledge chunks zinazotolewa kwa large language model.
- Figure 10: Inaonyesha sample responses kwa domain-knowledge question na comprehensive question inayohitaji risk explanation na maintenance recommendation.
- Figure 11: Inalinganisha semantic, lexical, knowledge, logic na integrity scores za models.
- Figure 12: Inaonyesha comprehensive response scores za full-scale models kutoka human na LLM judges.
- Figure 13: Inalinganisha accuracy, structure, clarity, alignment na final scores za fine-tuned open models.
- Figure 14: Inaonyesha general relationship kati ya model size katika Qwen3 family na comprehensive-task performance.
- Tables A.1–A.3: Zinaonyesha all eight categories na 87 risk items pamoja na quantitative au qualitative classifications.
- Table B.2: Inaorodhesha Chinese energy-storage standards zilizotumika katika knowledge base.
- Table C.1: Inaonyesha 30 basic questions zilizotumika katika domain-knowledge evaluation.
Dokezo la Chanzo na Mbinu
Full original title: Explainable Risk Assessment and Intelligent Maintenance for Electrochemical Energy Storage System with Large Language Model
Authors and correct order: Yijie Wang, Yujie Fu, Yi Lu, Jingbo Qu, Putai Zhang na Mian Li.
Equal first author: Equal contribution au equal-first-authorship information haijatajwa.
Corresponding author: Yijie Wang. Contact address imetolewa kama yijiewang@sjtu.edu.cn.
Institutional affiliations:
- Global Institute of Future Technology, Shanghai Jiao Tong University, Shanghai, China
- Global College, Shanghai Jiao Tong University, Shanghai, China
- Key Laboratory of Urban Complex Risk Control and Resilience Governance, Shanghai Jiao Tong University, Shanghai, China
Yijie Wang na Mian Li wameonyeshwa kuhusishwa na institution ya kwanza na ya tatu; Yujie Fu, Yi Lu na Putai Zhang na institution ya kwanza; Jingbo Qu na institution ya pili.
DOI: 10.2139/ssrn.7195888. DOI ni ya SSRN preprint record na haipaswi kutafsiriwa kama DOI ya peer-reviewed journal article.
Target journal: Study ina phrase “Preprint submitted to Applied Energy” na date 27 July 2026. Hakuna information kwamba imekubaliwa au kuchapishwa na Applied Energy.
Publication platform: SSRN.
SSRN abstract number: 7195888.
Publication year: 2026.
Source type: Engineering preprint inayounganisha real operating data, expert-based risk modeling, RAG, large-language-model fine-tuning na maintenance decision support.
Peer-review status: Study haijapitia peer review. Risk-scoring constants, field generalizability, LLM evaluation method na uwezo wa kuzalisha safe maintenance recommendations vinapaswa kutathminiwa kwa kuzingatia limitation hii.
Official link:https://ssrn.com/abstract=7195888
Funding: Study ili-supportiwa partly na support number 2023YFB2408200 ya China National Key Research and Development Program, Leading Talent Program yenye number BJKJ2025021 ndani ya Shanghai Eastern Talent Plan, na New Energy Battery 9σ Joint Research Project kati ya Shanghai Jiao Tong University na CATL.
Author contributions: Hakuna detailed individual author-contribution statement katika text.
Conflict of interest: Hakuna separate conflict-of-interest statement katika text.
Data na code access: Hakuna open-access link kwa raw sensor data za six stations, expert comparison matrices, full fine-tuning dataset, training code na all model responses.
Makala hii ya Kiswahili imeandaliwa kwa kuchunguza full text ya study, equations 22, main tables nane, figures 14, appendices tatu, risk-indexing system, station results, LLM comparisons na methodological limitations. External sources zilitumika only kwa bibliographic verification ya preprint identity, DOI, page count na official SSRN link; hakuna external finding iliyoongezwa kwenye scientific content ya study.
Main limitations za study ni kwamba only six Chinese stations zilichunguzwa, risk connections zinategemea expert opinion, risk scores hazijacalibrateiwa independently dhidi ya real-event outcomes, real-time performance imeonyeshwa kwa monthly na quarterly results, safety errors katika LLM responses hazikupimwa separately, kuna baadhi ya model-version inconsistencies, na raw data pamoja na code hazijashirikiwa.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *