

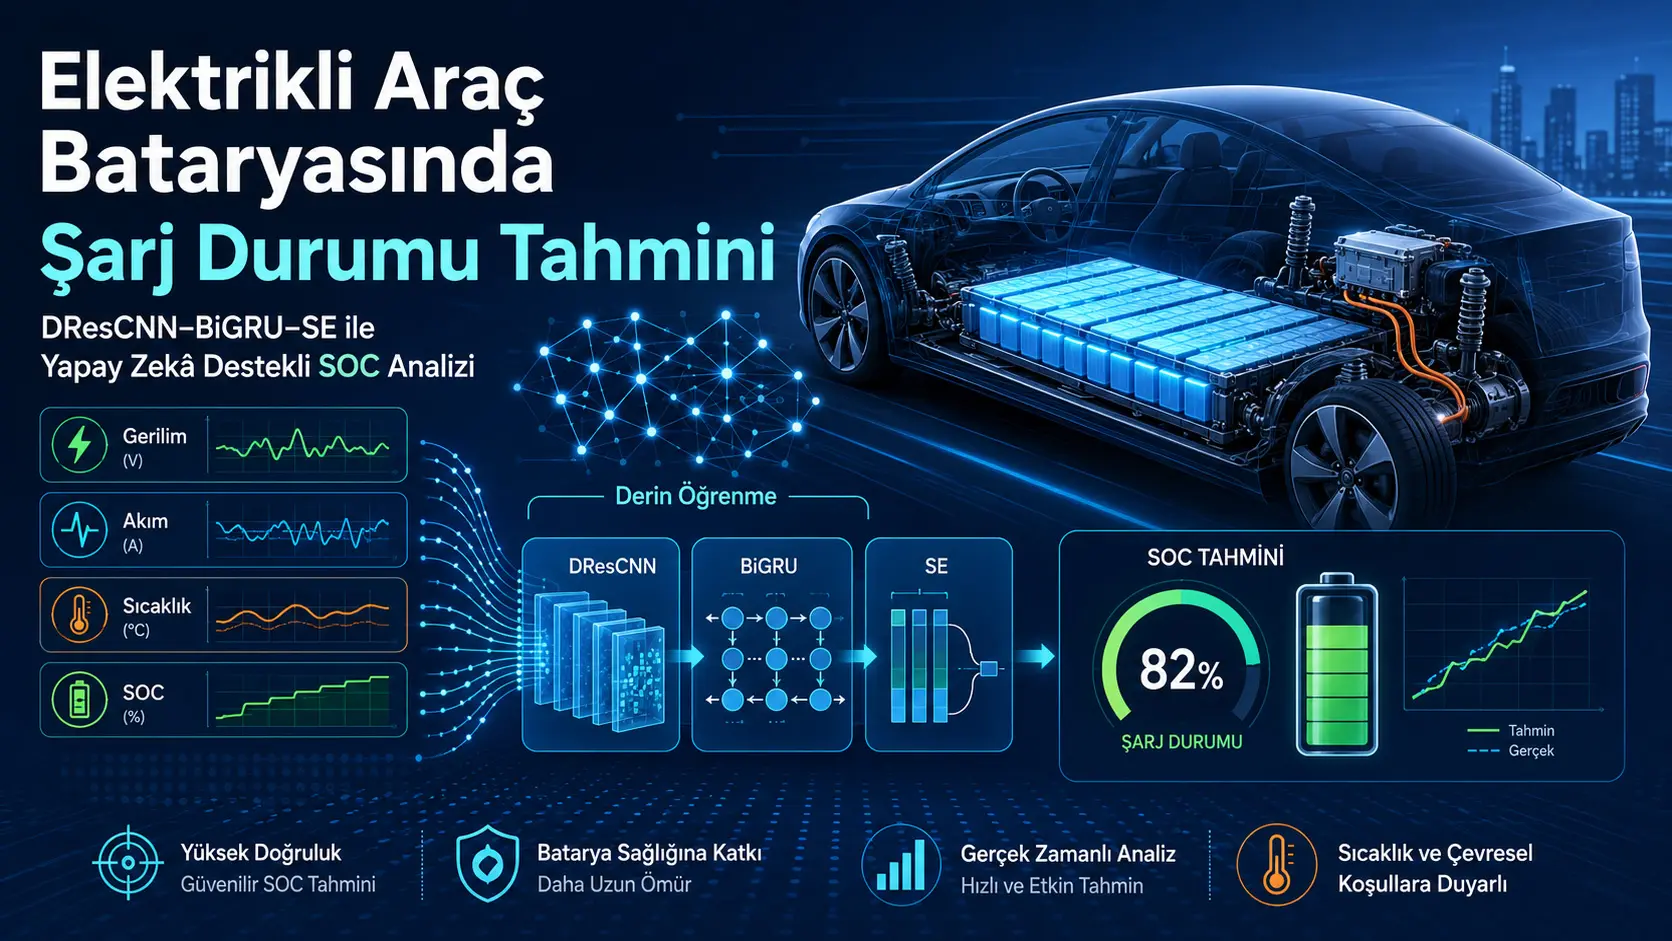
Katika magari ya umeme, hali ya chaji ya betri ni mojawapo ya viashiria vya msingi vinavyoamua kiasi cha nishati iliyobaki ambacho dereva anaweza kuona na umbali unaokadiriwa wa kuendesha. Hata hivyo, hali ya chaji haiwezi kupimwa moja kwa moja; inapaswa kukadiriwa kutokana na ishara zinazoweza kupimwa kama voltage ya betri, mkondo wa umeme, joto na mwenendo wa matumizi ya awali.
Katika utafiti huu, watafiti walipendekeza usanifu wa pamoja wa ujifunzaji wa kina unaoitwa DResCNN–BiGRU–SE kwa ajili ya kukadiria hali ya chaji ya betri za lithiamu-ioni. Modeli inaunganisha tabaka za convolution zilizopanuliwa zinazokamata mifumo katika vipimo tofauti vya muda, miunganisho ya mabaki inayorahisisha ujifunzaji, tabaka la BiGRU linalochakata mahusiano ya muda kwa pande mbili na utaratibu wa umakini wa Squeeze-and-Excitation unaosisitiza njia za sifa zenye manufaa.
Viingizo vya modeli ni voltage ya betri, mkondo wa betri na joto la betri pekee. Tathmini ilifanywa kwenye mkusanyo wa data ulio wazi uliorekodiwa kutoka gari la umeme la uzalishaji aina ya BMW i3 katika safari 70 halisi na unaojumuisha takribani vipimo 989.671. Safari 50 zilitengwa kwa mafunzo, 10 kwa uthibitishaji na 10 kwa majaribio.
Modeli iliyopendekezwa ilitoa %2,3522 ya kosa la mzizi wa wastani wa mraba, %1,7253 ya kosa la wastani kabisa na thamani ya 0,9754 ya R² kwenye data ya majaribio. Matokeo ya wastani yanaonyesha kwamba hali ya chaji iliyokadiriwa inalingana kwa kiwango kikubwa na thamani rejea katika mkusanyo wa data. Hata hivyo, kosa kubwa zaidi katika sampuli moja lilifikia %23,2645. Ukweli kwamba modeli hutoa kosa dogo katika hali nyingi haumaanishi kuwa ina kiwango sawa cha kutegemewa katika kila wakati.
Kuna matatizo muhimu ya kimetodolojia yanayoweka mipaka katika kutafsiri matokeo. Katika sehemu moja ya maandishi, data inaelezwa kugawanywa kwa kiwango cha sampuli kwa uwiano wa %70–%15–%15, huku katika sehemu ya mbinu kukitajwa mgawanyo wa safari wa 50–10–10. Mchoro wa usanifu unaonyesha uhalalishaji wa Min–Max, wakati maandishi makuu yanaeleza njia ya RobustScaler. Kwenye grafu ya ablation, modeli ya mwisho inaonyeshwa kwa jina DResCNN–BiGRU–CA na RMSE ya takribani %3,96, tofauti na thamani ya %2,3522 ya modeli kuu. Baadhi ya thamani za modeli katika grafu ya kulinganisha pia hazilingani na jedwali la kulinganisha katika makala.
Kwa hiyo utafiti huu unapaswa kutazamwa kama matokeo ya awali yenye kuahidi yanayoonyesha uwezo wa ujifunzaji wa kina katika data halisi ya uendeshaji. Modeli inahitaji kuthibitishwa kwa kujitegemea katika magari tofauti, kemia tofauti za betri, betri zilizozeeka na vifaa vya kupachikwa vinavyofanya kazi kwa wakati halisi.
Hali ya chaji ya betri ina maana gani?
Hali ya chaji, au State of Charge kwa Kiingereza, ni kigezo kinachokadiriwa kinachoonyesha kwa asilimia kiasi cha nishati inayoweza kutumika kilichobaki ndani ya betri. Inaweza kufananishwa na kipimo cha tanki la mafuta katika gari la kawaida; lakini kiasi cha nishati katika betri ya lithiamu-ioni hakiwezi kubainishwa kwa usahihi kwa kupima voltage pekee.
Voltage na mkondo wa betri unaopimwa vinaweza kubadilika kulingana na mambo yafuatayo:
- Mkondo wa sasa wa kuchaji au kutoa chaji wa betri,
- Joto la seli na kifurushi cha betri,
- Mabadiliko ya ghafla ya mzigo kama kuongeza kasi na breki ya kurejesha nishati,
- Upinzani wa ndani wa betri,
- Kemia ya seli na tofauti za utengenezaji,
- Kuzeeka na kupungua kwa uwezo,
- Historia ya awali ya kuchaji na kutoa chaji,
- Kelele za sensa na makosa ya urekebishaji.
Kwa hiyo mfumo wa usimamizi wa betri hujaribu kuhesabu kwa kuendelea hali ya chaji isiyoweza kupimwa moja kwa moja kutokana na ishara za umeme na joto zinazoweza kupimwa.
Kwa nini makadirio yasiyo sahihi ya hali ya chaji ni muhimu?
Kukadiria hali ya chaji kuwa juu kuliko ilivyo kunaweza kumwonyesha dereva umbali wa kuendesha ambao kwa kweli haupo. Kukadiria kuwa chini kuliko ilivyo kunaweza kusababisha uwezo unaoweza kutumika wa betri kupunguzwa bila sababu.
Makadirio sahihi yanaunga mkono kazi zifuatazo:
- Kuhesabu kwa kuaminika zaidi umbali uliobaki wa kuendesha,
- Kusimamia kwa usalama mipaka ya kuchaji na kutoa chaji,
- Kulinda betri dhidi ya kuchaji kupita kiasi au kutoa chaji kwa kina,
- Kupanga kwa usahihi zaidi nishati ya breki ya kurejesha,
- Kuboresha algoriti za usimamizi wa nguvu na nishati,
- Kuongeza maisha ya betri,
- Kupunguza wasiwasi wa dereva kuhusu umbali wa kuendesha.
Ni mipaka gani ya mbinu za jadi za makadirio?
Mojawapo ya mbinu kuu za kukadiria hali ya chaji ni kuhesabu Coulomb. Katika njia hii, mkondo unaoingia na kutoka kwenye betri hujumlishwa kwa muda. Ikiwa hali ya chaji ya mwanzo inajulikana kwa usahihi, njia inaweza kuwa na manufaa; lakini makosa madogo katika sensa ya mkondo yanaweza kujikusanya kadiri muda unavyopita na kusababisha makadirio kupotoka.
Njia zinazotegemea voltage ya mzunguko wazi huunganisha voltage inayopimwa baada ya betri kupumzishwa kwa muda na hali ya chaji. Hata hivyo, katika gari la umeme linalotembea, mara nyingi haiwezekani kuacha betri bila mzigo kwa muda mrefu.
Kichujio cha Kalman na mbinu nyingine zinazotegemea modeli huunganisha modeli za kifizikia za betri na data za sensa. Mafanikio ya mbinu hizi yanategemea usahihi wa kuwakilisha vigezo vya mzunguko sawa, upinzani wa ndani na tabia ya joto. Betri inapozeeka, vigezo vya modeli vinaweza kubadilika.
Mbinu zinazotegemea data hujaribu kujifunza moja kwa moja kutoka kwenye data uhusiano kati ya voltage, mkondo, joto na hali ya chaji. Njia hii inaweza kukamata mahusiano magumu yasiyo ya mstari; hata hivyo, kutegemewa kwake kunategemea upana wa data ya mafunzo, namna data ilivyogawanywa na majaribio ya modeli katika hali ambazo haikuwahi kuona awali.
Swali kuu la utafiti ni lipi?
Swali kuu la utafiti linaweza kufupishwa hivi:
Je, kwa kutumia mfululizo wa vipimo vya awali vya voltage, mkondo na joto, hali ya chaji ya betri ya gari la umeme katika mazingira halisi ya kuendesha inaweza kukadiriwa kwa usahihi kwa modeli ya pamoja ya ujifunzaji wa kina?
Kwa ajili hiyo watafiti waliunganisha uwezo tatu tofauti wa ujifunzaji katika modeli moja:
- Kutoa mifumo ya muda mfupi ya ishara katika vipimo tofauti vya muda,
- Kujifunza utegemezi wa muda mrefu wa wakati,
- Kupa uzito mkubwa zaidi njia za sifa zenye manufaa kuliko nyingine.
Jina DResCNN–BiGRU–SE lina maana gani?
Jina la modeli linaundwa na vipengele vitatu vya msingi:
- DResCNN: Mtandao wa neva wa convolution wa mwelekeo mmoja wenye miunganisho ya mabaki unaotumia convolution iliyopanuliwa.
- BiGRU: Kitengo cha kurudia chenye milango cha pande mbili kinachochakata data kwenda mbele na nyuma.
- SE: Utaratibu wa umakini wa Squeeze-and-Excitation unaoweka uzito wa umuhimu kwa njia za sifa.
Figure 1 katika ukurasa wa 4 wa utafiti inaonyesha usanifu wote katika hatua saba: maandalizi ya data, convolution ya vipimo vingi, vitalu vya mabaki, BiGRU, umakini wa njia, kichwa cha regression na mafunzo ya modeli.
Hatua ya kwanza: Kubadilisha vipimo kuwa mfululizo wa muda
Vekta ya ingizo katika kila hatua ya muda inaundwa na voltage, mkondo na joto:
\[ x_t=[V_t,I_t,T_t] \]
- \(V_t\): Voltage ya betri katika muda t.
- \(I_t\): Mkondo wa betri katika muda t.
- \(T_t\): Joto la betri katika muda t.
Sampuli moja ya ingizo ya modeli ni dirisha la muda linaloundwa na vipimo vinavyofuatana:
\[ X=\{x_1,x_2,\ldots,x_L\} \]
Katika utafiti, urefu wa dirisha uliwekwa kuwa \(L=40\) hatua za muda. Kwa hiyo modeli haiangalii vipimo vitatu vya wakati huo pekee, bali inatathmini pamoja historia fupi yenye vipimo 40 vilivyotangulia.
Utafiti haujaeleza wazi vipimo vilirekodiwa kwa masafa gani ya sampuli na hatua 40 zinawakilisha historia ya sekunde ngapi. Upungufu huu hufanya iwe vigumu kutafsiri kipimo halisi cha muda cha modeli.
Hatua ya pili: Utoaji wa sifa kwa convolution ya vipimo vingi
Katika sehemu ya kwanza ya ujifunzaji wa modeli, convolution mbili sambamba za mwelekeo mmoja hutumika kwenye mfululizo ule ule wa ingizo. Katika mchoro wa usanifu, tawi la kwanza lina ukubwa wa kiini 3 na kiwango cha upanuzi 1, huku tawi la pili likiwa na ukubwa wa kiini 5 na kiwango cha upanuzi 2.
Tawi la kwanza linalenga kunasa mabadiliko ya ndani ya muda mfupi, na tawi la pili mifumo katika kipindi kipana zaidi cha muda. Sifa zinazotolewa na matawi mawili huunganishwa baadaye.
Convolution iliyopanuliwa huweka nafasi kati ya vigezo vya kichujio ili kuangalia eneo pana bila kuongeza kupita kiasi idadi ya tabaka au ukubwa wa kichujio. Katika matumizi ya betri, mbinu hii inalenga kuwakilisha katika modeli moja mapigo ya mkondo ya muda mfupi pamoja na mabadiliko ya polepole ya voltage na joto.
Hata hivyo, ingawa kichwa “Step 2” kipo katika maandishi makuu ya makala, hatua hii haijaelezwa kwa undani na maandishi yanaenda moja kwa moja hadi hatua ya tatu. Idadi ya vichujio, vipimo kamili vya matokeo ya convolution na equation ya tatu inayotarajiwa kuhusiana na sehemu hii pia hazipo kwenye maandishi.
Hatua ya tatu: Miunganisho ya mabaki
Sifa za vipimo vingi hupelekwa kwenye vitalu vya mabaki vyenye convolution, batch normalization na uamilishaji wa ReLU. Uhusiano wa msingi wa muunganisho wa mabaki ni:
\[ Y=\mathcal{F}(X)+X \]
- \(X\): Sifa za ingizo za kizuizi.
- \(\mathcal{F}(X)\): Mabadiliko yaliyojifunzwa na tabaka za convolution.
- \(Y\): Jumla ya mabadiliko yaliyojifunzwa na ingizo.
Muundo huu unaweza kusaidia gradient kusafiri kwa urahisi zaidi katika mitandao ya kina. Badala ya kujifunza mabadiliko yote kutoka mwanzo, tabaka hujifunza marekebisho yanayopaswa kuongezwa kwenye ingizo.
Mchoro wa usanifu wa makala unaonyesha kwamba kizuizi cha mabaki hurudiwa mara \(N\); hata hivyo thamani ya \(N\) haijaelezwa. Idadi ya vichujio katika kila tabaka na jumla ya vigezo vya modeli pia hazijaripotiwa. Kwa hiyo taarifa zinazohitajika kujenga tena usanifu huu kwa namna ile ile hazitoshi.
Hatua ya nne: Kujifunza mahusiano ya muda kwa BiGRU
Tabaka za convolution hutoa mifumo ya ndani ya ishara, lakini hali ya chaji ya betri inaweza pia kuathiriwa na historia ya muda mrefu. Kwa hiyo sifa zilizounganishwa huingizwa kwenye tabaka la GRU la pande mbili.
Hali iliyofichwa ya mwelekeo wa mbele inaweza kuonyeshwa hivi:
\[ \overrightarrow{h_t}=\operatorname{GRU}(x_t,\overrightarrow{h_{t-1}}) \]
Hali iliyofichwa ya mwelekeo wa nyuma ni:
\[ \overleftarrow{h_t}=\operatorname{GRU}(x_t,\overleftarrow{h_{t+1}}) \]
Matokeo ya pande mbili huunganishwa:
\[ h_t=[\overrightarrow{h_t};\overleftarrow{h_t}] \]
Uchakataji wa pande mbili huwezesha taarifa za mwanzo na mwisho wa dirisha la hatua 40 kutathminiwa pamoja. Uchakataji wa nyuma si lazima uangalie data halisi ya baadaye ya gari; ikiwa dirisha linaundwa kabisa na vipimo vya hadi wakati wa sasa, dirisha hilo hilo la historia linaweza kuchakatwa kwa mwelekeo wa nyuma. Hata hivyo, kwa kuwa nafasi halisi ya muda wa lengo ndani ya dirisha haijaelezwa wazi katika utafiti, muundo wa sababu wa wakati halisi hauwezi kuthibitishwa kikamilifu.
Hatua ya tano: Umakini wa Squeeze-and-Excitation
Si kila njia ya sifa iliyotolewa na modeli inaweza kuwa na manufaa kwa kiwango sawa katika kukadiria hali ya chaji. Utaratibu wa SE hufupisha kila njia na kuipa uzito wa umuhimu unaoweza kujifunzwa kati ya 0 na 1.
Kwanza wastani wa kila njia ya sifa kwa muda unahesabiwa:
\[ z_c=\frac{1}{T}\sum_{t=1}^{T}X_c(t) \]
- \(z_c\): Thamani ya muhtasari ya njia c.
- \(T\): Urefu wa mfululizo wa muda.
- \(X_c(t)\): Thamani ya njia c katika muda t.
Uzito wa njia huhesabiwa kwa mabadiliko mawili yaliyounganishwa kikamilifu:
\[ A=\sigma(W_2\delta(W_1z)) \]
- \(W_1,W_2\): Matrices za uzito zinazojifunzwa.
- \(\delta\): Uamilishaji wa ReLU.
- \(\sigma\): Uamilishaji wa Sigmoid.
Sifa za mwisho hupimwa upya kwa uzito wa njia:
\[ Y=X\odot A \]
Mchakato huu unalenga kuruhusu modeli kuimarisha sifa zinazokuwa na manufaa zaidi katika hali fulani za kuendesha na kupunguza zile zenye manufaa kidogo.
Upana wa tabaka la kati au uwiano wa kupunguza katika sehemu ya SE haujaelezwa kwenye maandishi. Huu ni upungufu mwingine wa usanifu unaoweka kikomo katika uwezo wa kurudia utafiti.
Hatua ya sita: Matokeo endelevu ya hali ya chaji
Sifa zinazotoka kwenye utaratibu wa umakini hufupishwa kwa tabaka la global average pooling na kisha hupitishwa katika tabaka zifuatazo zilizounganishwa kikamilifu:
- Tabaka la neuroni 256 na 0,30 dropout,
- Tabaka la neuroni 128 na 0,20 dropout,
- Tabaka la neuroni 64,
- Tabaka la matokeo la mstari lenye neuroni moja.
Matokeo ya mstari huruhusu hali ya chaji kukadiriwa kama thamani endelevu ya asilimia:
\[ SOC_{tahmin}=f(g) \]
Hapa \(g\) ni vekta ya sifa iliyofupishwa baada ya pooling; \(f\) ni mabadiliko yaliyojifunzwa na tabaka zilizounganishwa kikamilifu.
Hatua ya saba: Mafunzo ya modeli
Modeli ilifunzwa kwa optimizer ya Adam na kiwango cha awali cha kujifunza kiliwekwa kuwa 0,0003. Norm ya gradient ilipunguzwa kwa 1,0, ukubwa wa batch uliwekwa kuwa 128 na muda wa juu wa mafunzo kuwa 100 epoch.
Huber loss ilitumika kama hasara ya mafunzo:
\[ L_\delta(y,\hat{y})= \begin{cases} \frac{1}{2}(y-\hat{y})^2, & |y-\hat{y}|\leq\delta \\ \delta|y-\hat{y}|-\frac{1}{2}\delta^2, & |y-\hat{y}|>\delta \end{cases} \]
- \(y\): Hali ya chaji ya rejea.
- \(\hat{y}\): Makadirio ya modeli.
- \(\delta\): Kizingiti kinachotenganisha maeneo ya kosa la mraba na la mstari.
Huber loss hufanya kazi kama kosa la mraba katika makosa madogo na hukua kwa mstari katika makosa makubwa. Kwa njia hii modeli hubaki nyeti kwa tofauti ndogo huku athari ya idadi ndogo ya mikengeuko mikubwa kwenye mafunzo ikipunguzwa.
Utafiti unaeleza kwamba early stopping na mpangilio wa kiwango cha kujifunza unaobadilika ulitumika. Hata hivyo, maelezo kama uvumilivu wa early stopping, sharti la kupunguza kiwango cha kujifunza na epoch bora iliyochaguliwa hayajatolewa.
Mkusanyo wa data wa BMW i3 una nini?
Modeli ilitathminiwa kwa mkusanyo wa data ulio wazi uliorekodiwa wakati wa matumizi halisi ya gari la umeme la uzalishaji aina ya BMW i3. Gari lina kifurushi cha betri ya lithiamu-ioni chenye uwezo wa 60 Ah.
| Sifa ya data | Thamani iliyoripotiwa katika utafiti |
|---|---|
| Gari | BMW i3 |
| Uwezo wa betri | 60 Ah |
| Jumla ya safari | 70 |
| Jumla ya sampuli | Takribani 989.671 |
| Chanzo cha data | IEEE DataPort |
| Lengo la rejea | Thamani ya SOC iliyotolewa na mtengenezaji wa gari |
Mbali na voltage, mkondo na joto la betri, mkusanyo wa data una vigezo vingine kama joto la mazingira, kasi ya gari, umbali wa safari na muda. Modeli iliyopendekezwa ilitumia voltage, mkondo na joto la betri pekee.
Figure 2 katika ukurasa wa 9 wa utafiti inaonyesha kwamba safari zinatofautiana sana kwa umbali na muda. Safari nyingi zimekusanyika katika takribani kilomita 10–20, huku pia kukiwa na idadi ndogo ya safari ndefu zinazokaribia kilomita 50–60.
Voltage, mkondo na joto vinahusianaje na hali ya chaji?
Matriksi ya uhusiano katika ukurasa wa 11 wa utafiti inaonyesha kwamba uhusiano wa mstari wenye nguvu zaidi na hali ya chaji upo katika voltage ya betri:
| Kigezo | Uhusiano wa Pearson na SOC |
|---|---|
| Voltage ya betri | 0,80 |
| Mkondo wa betri | 0,03 |
| Joto la betri | 0,28 |
| Kasi ya gari | −0,15 |
| Joto la mazingira | 0,40 |
Uhusiano wa mstari wa papo hapo wa 0,03 kati ya mkondo na SOC haumaanishi kwamba mkondo hauna manufaa. Athari ya mkondo kwa kawaida hujitokeza kwa kujikusanya kadiri muda unavyopita. Thamani ile ile ya mkondo inaweza kuwa na maana tofauti kulingana na historia ya mzigo wa betri. Kwa hiyo modeli ya mfululizo wa muda hujaribu kujifunza mahusiano tata zaidi kuliko uhusiano mmoja wa papo hapo.
Uhusiano kati ya joto la betri na joto la mazingira ni 0,87. Kwa kuwa modeli hutumia joto la betri pekee, sehemu ya taarifa kuhusu hali ya mazingira inaweza kuingia kwenye modeli kwa njia isiyo ya moja kwa moja kupitia joto la betri.
Data ilipimwaje upya?
Kulingana na maandishi makuu, vigezo vya ingizo na thamani lengwa za SOC zilipimwa upya kwa RobustScaler:
\[ x_{ölçekli}=\frac{x-\operatorname{Median}(x)}{Q_3-Q_1} \]
- \(\operatorname{Median}(x)\): Thamani ya kati ya kigezo.
- \(Q_1\): Robo ya kwanza.
- \(Q_3\): Robo ya tatu.
- \(Q_3-Q_1\): Masafa kati ya robo.
Njia hii ya kupima upya inaweza kuathiriwa kwa kiwango kidogo na thamani za pembeni kuliko mbinu zinazotegemea wastani na mkengeuko wa kawaida.
Hata hivyo, katika Figure 1 hatua ya usindikaji wa awali imeonyeshwa kama “Min–Max Normalization”. Uhalalishaji wa Min–Max na RobustScaler si mbinu ile ile. Kwa kuwa RobustScaler imeelezwa kwa undani zaidi katika maandishi, inaweza kuchukuliwa kuwa ndiyo mbinu kuu; hata hivyo kuna kutolingana wazi kati ya mchoro na maelezo ya mbinu.
Pia haijaelezwa kama kipimo kilifunzwa kwa kutumia safari za mafunzo pekee na baadaye kutumika kwenye safari za uthibitishaji na majaribio. Ikiwa vigezo vya kupima upya vilihesabiwa kutoka kwenye mkusanyo mzima wa data, taarifa ndogo kuhusu usambazaji wa data ya majaribio inaweza kuvuja. Taarifa iliyotolewa haitoshi kutathmini uwezekano huu.
Data iligawanywaje kwa mafunzo, uthibitishaji na majaribio?
Katika sehemu ya mbinu, mgawanyo ufuatao wa kiwango cha safari umeripotiwa:
| Kikundi | Idadi ya safari | Sehemu ya jumla |
|---|---|---|
| Mafunzo | 50 | Takribani %71,4 |
| Uthibitishaji | 10 | Takribani %14,3 |
| Majaribio | 10 | Takribani %14,3 |
Kugawanya kwa kiwango cha safari ni muhimu ili kuzuia madirisha ya muda yanayoingiliana yaliyotokana na safari ile ile kuingia katika seti ya mafunzo na seti ya majaribio kwa wakati mmoja.
Kinyume chake, jedwali la kulinganisha katika ukurasa wa 3 wa utafiti linaeleza mgawanyo wa data wa utafiti huu kama “%70 ya sampuli kwa mafunzo, %15 kwa uthibitishaji na %15 kwa majaribio”. Mgawanyo wa safari si sawa na mgawanyo wa sampuli. Ingawa maelezo ya 50–10–10 katika sehemu ya mbinu yanaonekana kuaminika zaidi, kutolingana kati ya maelezo haya mawili hakujatatuliwa.
Pia haijaorodheshwa ni safari zipi 10 zilizotumika kwa uthibitishaji na zipi 10 kwa majaribio. Thamani moja tu ya seed ya nasibu, 42, imetolewa; majaribio yaliyokaririwa kwa mgawanyo tofauti au seed tofauti hayajaripotiwa.
Curves za mafunzo na uthibitishaji zinaonyesha nini?
Katika grafu za ukurasa wa 14 na 15, hasara za mafunzo na uthibitishaji hushuka haraka katika epoch za mwanzo na kisha huboreka polepole zaidi. Curve ya mafunzo inaendelea kupungua kwa utaratibu, huku curve ya uthibitishaji ikianza kutikisika na kuongezeka kidogo baada ya takribani epoch ya 17–18.
Watafiti wanaeleza kwamba hakuna kutengana kubwa kati ya curves za mafunzo na uthibitishaji na kwamba modeli haionyeshi overfitting iliyo wazi. Ingawa grafu hazionyeshi kupotoka kusikodhibitiwa, mwishoni mwa mafunzo kuna tofauti inayoonekana kati ya hasara ya mafunzo na hasara ya uthibitishaji. Hii inaonyesha kwamba uwezekano wa overfitting ya kiwango kidogo hauwezi kuondolewa kabisa.
Matokeo makuu ya majaribio ya modeli ni yapi?
| Kipimo cha utendaji | Thamani iliyoripotiwa | Maana |
|---|---|---|
| RMSE | %2,3522 | Kipimo cha wastani wa kosa kinachoadhibu zaidi makosa makubwa |
| MAE | %1,7253 | Tofauti ya wastani kabisa kati ya makadirio na thamani rejea |
| R² | 0,9754 | Sehemu ya mabadiliko ya SOC rejea inayoelezwa na modeli |
| MAPE | %3,4049 | Kosa la wastani kwa asilimia ukilinganisha na thamani rejea |
| Kosa kubwa zaidi kabisa | %23,2645 | Mkengeuko mkubwa zaidi ulioonekana katika sampuli moja |
| Mkengeuko wa kawaida wa kosa | %2,3502 | Usambazaji wa makosa kuzunguka wastani |
MAE ya %1,7253 inaonyesha kwamba katika sampuli ya wastani, tofauti kati ya makadirio na rejea ni takribani pointi 1,73 za asilimia. Kwa mfano, ikiwa thamani rejea ni %60, ukubwa wa kosa la wastani ni takribani pointi 1,73; hata hivyo, hii haimaanishi kwamba kila makadirio yapo ndani ya kiwango hicho.
Kosa kubwa zaidi la %23,2645 ni muhimu hasa. Ingawa utendaji wa wastani unaonekana kuwa mzuri, katika wakati fulani wa mpito tofauti kati ya makadirio na rejea ilizidi pointi 23 za asilimia. Katika matumizi ya usimamizi wa betri yenye umuhimu wa usalama, si kosa la wastani pekee bali pia tabia katika hali mbaya zaidi inapaswa kutathminiwa.
Curves za SOC halisi na iliyokadiriwa zinaonyesha nini?
Katika Figure 7 na Figure 8 kwenye ukurasa wa 16, curves za makadirio zinafuata kwa karibu thamani rejea katika sehemu nyingi. Sehemu iliyokuzwa inaonyesha ulinganifu mkubwa hasa katika viwango vya kati na vya juu vya SOC. Katika kushuka kwa ghafla, kuna maeneo ambapo curve ya makadirio husawazisha au hukosa baadhi ya vilele na mabonde.
Grafu inaonyesha SOC ikishuka mara kwa mara kutoka karibu %80 hadi kiwango cha %30–40 na kisha kupanda tena kati ya sampuli zinazofuatana. Kwa kuwa katika safari moja halisi haitarajiwi betri kuchaji na kutoa chaji kwa kasi hiyo, grafu ina uwezekano mkubwa wa kuunganisha madirisha tofauti ya majaribio au safari tofauti. Hata hivyo, kwa sababu namna ya kupanga sampuli haijaelezwa, grafu haipaswi kutafsiriwa kama wasifu endelevu wa safari moja katika wakati halisi.
Matokeo ya majaribio hayajatolewa kwa kila safari kivyake. Kwa hiyo haiwezi kuonekana kama modeli ilifanya vizuri kwa kiwango sawa katika safari zote za majaribio au kama kosa liliongezeka katika hali fulani za joto au umbali.
Je, usambazaji wa kosa kweli hauna upendeleo?
Figure 9 katika ukurasa wa 18 inaonyesha grafu ya mabaki, histogramu, box plot na violin plot kwa pamoja. Sehemu kubwa ya makosa imejikusanya karibu na sifuri. Hata hivyo, katika box plot kuna thamani nyingi za pembeni katika upande hasi na chanya.
Grafu ya mabaki haionekani kama wingu la nasibu kabisa. Wakati SOC iliyokadiriwa iko chini, mabaki yanaonekana zaidi katika eneo hasi, na katika SOC za juu zaidi yanakusanyika karibu na sifuri au eneo chanya. Hii inaashiria kwamba kunaweza kuwa na muundo wa kimfumo unaotegemea kiwango cha SOC.
Kwa hiyo hitimisho kwamba “modeli haina mwelekeo wa wazi wa kukadiria juu au chini” linaweza kuwa la busara kwa wastani wa jumla, lakini haijaonyeshwa kwa uhakika kwamba modeli haina upendeleo kwa kiwango sawa katika viwango vyote vya SOC.
Thamani ya R² inaonyesha nini, na haionyeshi nini?
R² ya 0,9754 inaonyesha kwamba takribani %97,5 ya mabadiliko ya SOC rejea katika data ya majaribio inaweza kuelezwa kitakwimu na makadirio ya modeli.
Thamani hii peke yake haithibitishi yafuatayo:
- Kosa ni dogo katika kila wakati wa makadirio,
- Modeli itatoa matokeo yale yale katika magari tofauti,
- Thamani rejea za SOC hazina makosa,
- Utendaji utaendelea kuwa sawa betri inapozeeka,
- Modeli inaweza kufanya kazi katika kitengo cha udhibiti cha wakati halisi,
- Makosa ya hali mbaya zaidi yako ndani ya mipaka ya usalama.
Kulinganisha na tafiti zilizopita kunaaminika kwa kiwango gani?
Kulingana na jedwali kuu la kulinganisha katika makala, modeli iliyopendekezwa ilitoa RMSE na MAE za chini kuliko tafiti zilizotangulia zilizotumia mkusanyo huo huo wa data wa BMW i3:
| Modeli | Mgawanyo wa data | RMSE (%) | MAE (%) |
|---|---|---|---|
| TLBO-DNN | Data iliyounganishwa, %70–%30 | 4,6487 | 3,4480 |
| DNN-EMA | Safari 60 za mafunzo, safari 10 za majaribio | 4,7023 | 3,4584 |
| FFNN-BMO | Data iliyounganishwa, %80–%20 | 5,0954 | 3,7919 |
| Msitu Nasibu | Safari 60 za mafunzo na uthibitishaji, safari 10 za majaribio | 5,9020 | 4,4320 |
| BMO-CatBoost | Data iliyounganishwa, %70–%30 | 6,1031 | 4,1303 |
| FFNN | Safari 50 za mafunzo, 10 za uthibitishaji, 10 za majaribio | 8,3460 | 7,1662 |
| ResCNN–BiGRU–MHA | Tathmini kwa kiwango cha safari | 6,0470 | 4,5550 |
| DResCNN–BiGRU–SE | Imeelezwa kama 50 mafunzo, 10 uthibitishaji, 10 majaribio | 2,3522 | 1,7253 |
Mgawanyo wa data, hatua za usindikaji wa awali, safari za majaribio na maelezo ya utekelezaji katika kulinganisha huku si sawa. Kosa la chini la modeli kwenye seti tofauti ya majaribio halithibitishi moja kwa moja kwamba ni bora kuliko modeli nyingine. Kwa kulinganisha moja kwa moja kwa haki, modeli zote zinapaswa kuendeshwa upya katika safari zile zile za mafunzo, uthibitishaji na majaribio.
Figure 11 katika ukurasa wa 20 pia hailingani na jedwali la kulinganisha. Grafu inaonyesha RMSE ya takribani 7,20 kwa FFNN, 6,10 kwa LSTM, 5,80 kwa GRU, 5,50 kwa BiLSTM, 4,80 kwa ResCNN–BiGRU na takribani 3,96 kwa DResCNN–BiGRU–CA. Majina na thamani hizi si sawa na modeli katika jedwali kuu la kulinganisha; thamani ya 2,3522 RMSE ya modeli ya SE iliyopendekezwa haionyeshwi kwenye grafu.
Je, utafiti wa ablation unathibitisha vipengele vya usanifu?
Lengo la utafiti wa ablation ni kuonyesha jinsi kosa linavyobadilika vipengele vya usanifu vinapoongezwa kimoja baada ya kingine. Katika Figure 12, RMSE inaonekana kupungua hatua kwa hatua kuanzia CNN huku BiGRU, muunganisho wa mabaki, convolution iliyopanuliwa na utaratibu wa umakini vikiongezwa.
Hata hivyo, kuna matatizo makubwa ya kuripoti katika sehemu hii:
- Maandishi yanasema matokeo yametolewa katika “Table V”, lakini hakuna jedwali la namba la ablation.
- Table V tayari imetumika kwa vipimo vikuu vya utendaji.
- Jina la modeli ya mwisho kwenye grafu ni DResCNN–BiGRU–CA; modeli kuu inaitwa DResCNN–BiGRU–SE.
- RMSE ya pointi ya mwisho kwenye grafu inaonekana kuwa takribani 3,96; matokeo makuu ya majaribio ni 2,3522.
- Haijaelezwa kama modeli za ablation ziliendeshwa kwenye seti ile ile ya majaribio, mwanzo ule ule wa nasibu na mipangilio ile ile ya mafunzo.
- Matokeo hayajaripotiwa kwa marudio mengi ya mafunzo pamoja na mkengeuko wa kawaida.
Kwa hiyo grafu inatoa muundo wa jumla unaoonyesha utendaji kuboreka kadiri usanifu unavyoongezewa vipengele, lakini haiwezi kuchukuliwa kama jaribio kamili la ablation linalothibitisha kwa uaminifu na kwa namba mchango wa kila kipengele.
Nguvu muhimu zaidi za utafiti
- Mkusanyo wa data ulio wazi kutoka safari halisi umetumika badala ya mizunguko ya maabara iliyodhibitiwa.
- Takribani vipimo milioni moja vimeipa modeli msingi mpana wa sampuli.
- Voltage, mkondo na joto, ambazo hupatikana katika mifumo mingi ya usimamizi wa betri, zimechaguliwa kama viingizo.
- Mfumo wa ndani, uhusiano wa muda mrefu na umakini wa njia umeunganishwa katika usanifu mmoja.
- Imeelezwa kwamba safari tofauti zilitumika kwa uthibitishaji na majaribio.
- Mbali na RMSE na MAE, R², MAPE, kosa kubwa zaidi na mkengeuko wa kawaida wa kosa zimeripotiwa.
- Usambazaji wa makosa umechunguzwa kwa grafu nyingi.
- Utafiti unatambua mipaka yake na hitaji la uthibitishaji kwenye mfumo wa kupachikwa.
Mipaka kuu ya utafiti
- Modeli imetathminiwa kwenye aina moja tu ya gari na kifurushi kimoja cha betri.
- Kemia tofauti za seli na uwezo tofauti wa betri hazijajaribiwa.
- Athari ya kuzeeka kwa betri haijatathminiwa.
- SOC rejea si kipimo huru cha maabara, bali thamani iliyotolewa na mtengenezaji wa gari.
- Haijaelezwa kama scaler ilifunzwa kwenye data ya mafunzo pekee.
- Mgawanyo wa data umeelezwa kwa njia mbili tofauti: kwa sampuli na kwa safari.
- Mchoro unaonyesha Min–Max, maandishi yanaonyesha RobustScaler.
- Idadi ya vichujio vya convolution na idadi ya vitalu vya mabaki haijaelezwa.
- Uwiano wa kupunguza wa SE na jumla ya vigezo vya modeli havijatolewa.
- Muda wa uendeshaji, ucheleweshaji wa inference, mahitaji ya kumbukumbu na matumizi ya nishati hayajapimwa.
- Matokeo ya majaribio hayajaripotiwa kwa kila safari kivyake.
- Hakuna majaribio yaliyokaririwa kwa seed tofauti wala confidence interval.
- Grafu ya kulinganisha hailingani na jedwali kuu la kulinganisha.
- Jina la modeli na matokeo katika grafu ya ablation hayalingani na matokeo ya modeli kuu.
- Source code, vitambulisho vya safari zilizotumika kwa mafunzo na kifurushi kamili cha kurudia utafiti havijatolewa.
Utafiti unaunga mkono nini?
- Mfululizo wa voltage, mkondo na joto unaweza kuwa na taarifa nyingi kwa makadirio ya SOC,
- Kutumia pamoja tabaka za convolution na tabaka zinazorudia kunaonekana kuwa na matumaini katika data halisi ya uendeshaji,
- Umakini wa njia unaweza kutumika kupima upya kwa kuchagua sifa zilizojifunzwa,
- Kosa la wastani la chini limepatikana katika seti ya majaribio iliyoelezwa,
- Kugawa data kwa kiwango cha safari ni njia inayoweza kutumika katika tathmini.
Utafiti hauthibitishi nini?
- Haithibitishi kwamba modeli itatoa %2,35 RMSE katika magari yote ya umeme.
- Haionyeshi kwamba usanifu uliopendekezwa ni bora kwa uhakika kuliko mbinu zote za awali.
- Haionyeshi kwamba modeli itadumisha usahihi ule ule katika betri zilizozeeka.
- Haithibitishi kwamba kosa kubwa zaidi la %23,26 linakubalika kwa upande wa usalama.
- Haionyeshi kwamba modeli inaweza kufanya kazi kwa wakati halisi katika kitengo cha usimamizi wa betri cha kiwango cha magari.
- Haithibitishi kwamba makadirio yatakuwa na mafanikio yale yale katika joto, hali ya hewa na tamaduni tofauti za uendeshaji.
- Haionyeshi kwamba thamani rejea za SOC zinalingana bila kosa na SOC halisi ya kifizikia.
- Haithibitishi kwamba maboresho yanayoonekana katika grafu ya ablation yana umuhimu wa kitakwimu.
Hii ina maana gani kwa mfumo wa magari ya umeme nchini Uturuki?
Kadiri matumizi ya magari ya umeme, miundombinu ya kuchaji na teknolojia za magari ya ndani zinavyoendelea nchini Uturuki, umuhimu wa programu za usimamizi wa betri pia unaongezeka. Makadirio ya hali ya chaji yanaweza kuathiri si tu thamani ya asilimia kwenye dashibodi, bali pia upangaji wa umbali, usimamizi wa kuchaji haraka, dhamana ya betri na tathmini ya betri za matumizi ya pili.
Mbinu ya utafiti inaunga mkono maeneo yafuatayo ya utafiti kwa mifumo ya usimamizi wa betri itakayoundwa nchini Uturuki:
- Kukusanya data halisi ya uendeshaji katika maeneo tofauti ya hali ya hewa ya Uturuki,
- Kuchunguza athari ya joto la kiangazi na baridi ya majira ya baridi katika makadirio ya SOC,
- Kujaribu magari tofauti na kemia tofauti za betri katika hifadhidata ya pamoja,
- Kutathmini kwa pamoja betri mpya na zilizozeeka,
- Kupima ucheleweshaji na matumizi ya nishati ya modeli kwenye mikrokontroller za kiwango cha magari,
- Kuripoti makosa ya hali mbaya zaidi pamoja na mipaka ya usalama,
- Kuunganisha modeli za kifizikia za betri na ujifunzaji wa kina.
Hata hivyo, matokeo ya namba katika utafiti hayawezi kuhamishwa moja kwa moja hadi magari nchini Uturuki. Hali za matumizi ya ndani, vifaa vya gari, kemia ya betri, ubora wa sensa na masafa ya joto yanaweza kutofautiana. Kwa matumizi halisi, mafunzo mapya na uthibitishaji kwa data huru iliyokusanywa nchini Uturuki ni muhimu.
Mbinu na Matokeo ya Utafiti
Muhtasari wa mbinu ya kiufundi
| Kipengele cha mbinu | Njia iliyotumika katika utafiti |
|---|---|
| Aina ya utafiti | Uundaji na majaribio ya modeli ya ujifunzaji wa kina kwenye data wazi ya uendeshaji halisi |
| Gari | BMW i3 |
| Betri | Kifurushi cha betri ya lithiamu-ioni cha 60 Ah |
| Jumla ya safari | 70 |
| Jumla ya sampuli | Takribani 989.671 |
| Safari za mafunzo | 50 |
| Safari za uthibitishaji | 10 |
| Safari za majaribio | 10 |
| Viingizo | Voltage ya betri, mkondo na joto |
| Lengo | SOC iliyotolewa na mtengenezaji |
| Dirisha la muda | Hatua 40 za kipimo |
| Usindikaji wa awali | RobustScaler katika maandishi makuu; Min–Max katika mchoro wa usanifu |
| Convolution ya vipimo vingi | Matawi mawili sambamba: kiini 3, upanuzi 1 na kiini 5, upanuzi 2 |
| Tabaka la muda | BiGRU yenye vitengo 128 |
| Umakini | Umakini wa njia wa Squeeze-and-Excitation |
| Kichwa cha regression | Tabaka za neuroni 256, 128 na 64 pamoja na matokeo ya mstari |
| Optimizer | Adam |
| Kiwango cha kujifunza | 0,0003 |
| Hasara | Huber loss |
| Ukubwa wa batch | 128 |
| Epoch ya juu | 100 |
| Kupunguza gradient | clipnorm = 1,0 |
| Seed ya nasibu | 42 |
| Programu | TensorFlow/Keras |
| Vifaa | Intel Core i7, 16 GB RAM na NVIDIA RTX 3050 |
Matokeo makuu ya utendaji
| Matokeo | Thamani | Tathmini |
|---|---|---|
| Kosa la wastani kabisa | %1,7253 | Tofauti ya wastani ya makadirio ni ndogo |
| Kosa la mzizi wa wastani wa mraba | %2,3522 | Utendaji wa jumla wenye makosa makubwa pia ni mzuri |
| R² | 0,9754 | Kuna ulinganifu mkubwa na mabadiliko ya SOC rejea |
| Kosa la wastani kwa asilimia | %3,4049 | Tofauti ya wastani kulingana na thamani rejea |
| Kosa kubwa zaidi | %23,2645 | Kosa la sampuli moja katika hali mbaya ni kubwa |
| Mkengeuko wa kawaida wa kosa | %2,3502 | Usambazaji wa jumla wa makosa |
Malengo ya vipengele vya usanifu
| Kipengele | Taarifa inayolengwa kujifunzwa | Hali ya kuripoti |
|---|---|---|
| Conv1D iliyopanuliwa | Mifumo ya muda mfupi ya voltage, mkondo na joto katika vipimo tofauti vya muda | Ukubwa wa kiini na kiwango cha upanuzi vipo kwenye mchoro; idadi ya vichujio haipo |
| Miunganisho ya mabaki | Ujifunzaji wa sifa za kina zaidi na kuhifadhi mtiririko wa gradient | Idadi ya marudio haijaelezwa |
| BiGRU | Utegemezi wa mbele na nyuma ndani ya dirisha la muda | Vitengo 128 vimeripotiwa |
| Umakini wa SE | Kuimarisha njia zenye manufaa | Uwiano wa kupunguza haujaelezwa |
| Kichwa cha regression | Kubadilisha sifa zilizojifunzwa kuwa thamani endelevu ya SOC | Ukubwa wa tabaka na uwiano wa dropout umetolewa |
Kutolingana muhimu ndani ya maandishi
| Suala | Taarifa ya kwanza | Taarifa ya pili | Athari |
|---|---|---|---|
| Mgawanyo wa data | Sampuli kugawanywa %70–%15–%15 | Mgawanyo wa safari 50–10–10 | Huathiri tathmini ya kuvuja kwa taarifa na wigo wa majaribio |
| Kupima upya | Min–Max katika Figure 1 | RobustScaler katika maandishi | Hufanya kurudia modeli kuwa vigumu |
| Matokeo ya kulinganisha | Modeli na thamani za makosa tofauti katika Table 1 | Majina na thamani nyingine katika Figure 11 | Huweka kikomo katika kuthibitisha dai la ubora |
| Modeli ya mwisho ya ablation | Modeli kuu DResCNN–BiGRU–SE na RMSE %2,3522 | Kwenye grafu DResCNN–BiGRU–CA na takribani %3,96 | Hufanya tafsiri ya namba ya mchango wa vipengele kutotegemewa |
| Jedwali la ablation | Maandishi yanarejelea “Table V” | Hakuna jedwali tofauti la ablation | Matokeo kamili ya namba hayapatikani |
| Taarifa za waandishi | Hakuna mstari wa mwandishi katika ukurasa wa kwanza uliopakiwa | Waandishi wanapatikana katika rekodi ya SSRN pekee | Hupunguza ukamilifu wa kibibliografia wa hati |
Majaribio ya ziada yatakayoongeza uaminifu wa matokeo
- Kufundisha upya modeli zote za kulinganisha katika safari zile zile za majaribio,
- Kutoa RMSE, MAE na kosa kubwa zaidi kwa kila safari ya majaribio kivyake,
- Kufanya angalau marudio kadhaa huru ya mafunzo kwa seed tofauti,
- Kuripoti mkengeuko wa kawaida au confidence interval pamoja na matokeo ya wastani,
- Kufanya uthibitishaji wa safari kwa safari katika vikundi tofauti vya uendeshaji wa BMW i3,
- Kufanya uthibitishaji wa nje kwa magari mengine na kemia tofauti za betri,
- Kutathmini betri mpya na zilizozeeka kivyake,
- Kufanya scaler ilingane na seti ya mafunzo pekee na kueleza wazi hatua hiyo,
- Kuchapisha vigezo vya usanifu na source code,
- Kupima ucheleweshaji, kumbukumbu na matumizi ya nishati kwenye vifaa vya kupachikwa,
- Kuchambua kivyake hali ya uendeshaji ambayo kosa kubwa zaidi lilitokea,
- Kuongeza kiwango cha kutokuwa na uhakika katika makadirio ya SOC.
Dokezo la Chanzo na Mbinu
- Jina asili la utafiti: DResCNN–BiGRU–SE: A Deep Learning Framework for Accurate State-of-Charge Estimation of Lithium-Ion Batteries in Electric Vehicles
- Waandishi: Sushil Kumar; Yaduvir Singh
- Mpangilio wa waandishi: Sushil Kumar ni mwandishi wa kwanza, Yaduvir Singh wa pili.
- Onyo kuhusu taarifa za waandishi: Hakuna mstari wa mwandishi na taasisi katika ukurasa wa kwanza wa maandishi yaliyopakiwa. Waandishi wamethibitishwa kutoka taarifa za rekodi rasmi ya SSRN.
- Mwandishi mwenza wa kwanza: Hakuna tamko la mchango sawa au uandishi mwenza wa kwanza.
- Mwandishi wa mawasiliano: Rekodi ya SSRN inaonyesha Sushil Kumar kama mwandishi wa mawasiliano.
- Taasisi: Harcourt Butler Technical University, Kanpur, India
- Idara ya Yaduvir Singh: Department of Electrical Engineering katika rekodi rasmi ya chuo kikuu
- Taarifa ya idara ya Sushil Kumar: Jina la idara halijaonyeshwa wazi katika ukurasa wa kichwa wa utafiti uliokaguliwa wala katika taarifa fupi inayopatikana ya SSRN.
- Mwaka wa utafiti: 2026
- Siku na mwezi kamili: Havijaelezwa wazi katika maandishi yaliyopakiwa; kwa hiyo tarehe kamili haijatolewa.
- Aina ya chanzo: Maandishi ya utafiti wa preprint ambayo hayajapitia peer review
- Jukwaa la uchapishaji: SSRN
- Mwendeshaji wa jukwaa: Elsevier
- Preprint DOI: 10.2139/ssrn.7196249
- Rekodi rasmi:Ukurasa rasmi wa utafiti katika SSRN
- Kiungo cha kudumu cha DOI:10.2139/ssrn.7196249
- Jarida: Haijathibitishwa kwamba utafiti umechapishwa katika jarida lililopitia peer review.
- Hali ya peer review: Kila ukurasa wa maandishi yaliyopakiwa unaeleza kwamba utafiti haujapitia peer review.
- Chanzo cha data: BMW i3 Battery and Heating Data in Real Driving Cycles, IEEE DataPort
- DOI ya mkusanyo wa data: 10.21227/6JR9-5235
- Mgongano wa maslahi: Hakuna tamko tofauti la mgongano wa maslahi katika maandishi yaliyokaguliwa.
- Ufadhili: Hakuna taarifa ya ufadhili katika maandishi yaliyokaguliwa.
- Code na uzito wa modeli: Hakuna kiungo cha wazi cha source code kilichotolewa.
Maudhui ya kisayansi ya makala hii ya Verianla yameandaliwa kwa kuchunguza maandishi ya utafiti yaliyopakiwa, equations, majedwali, mchoro wa usanifu, grafu za utendaji na uchambuzi wa makosa pekee. Vyanzo vya nje vilitumika tu kuthibitisha kibibliografia utambulisho wa waandishi, taasisi, DOI, jukwaa na hali ya peer review. Hakuna matokeo mapya ya kisayansi yaliyoongezwa kutoka vyanzo vya nje.
Matokeo makuu ya utafiti, yaani %2,3522 RMSE, %1,7253 MAE na 0,9754 R², ni matokeo ya majaribio yaliyoripotiwa na watafiti. Kwa kuwa makadirio ghafi ya majaribio, source code na kumbukumbu za mafunzo hazijashirikiwa, thamani hizi hazijahesabiwa upya kwa kujitegemea.
Kuna kutolingana muhimu katika maandishi kuhusu mgawanyo wa data, njia ya normalization, grafu ya kulinganisha modeli na matokeo ya ablation. Kutolingana huku hakujasahihishwa kimya kimya; kumeonyeshwa wazi wakati wa kutathmini uzito wa kisayansi wa matokeo.
Utafiti haujapitia peer review. Matokeo yamewekewa mipaka na jukwaa moja la gari na usanidi mmoja wa betri. Modeli haijajaribiwa kwa wakati halisi katika mfumo wa usimamizi wa betri wa kiwango cha magari na haijafanyiwa uthibitishaji wa nje kwa kemia tofauti za betri.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *