

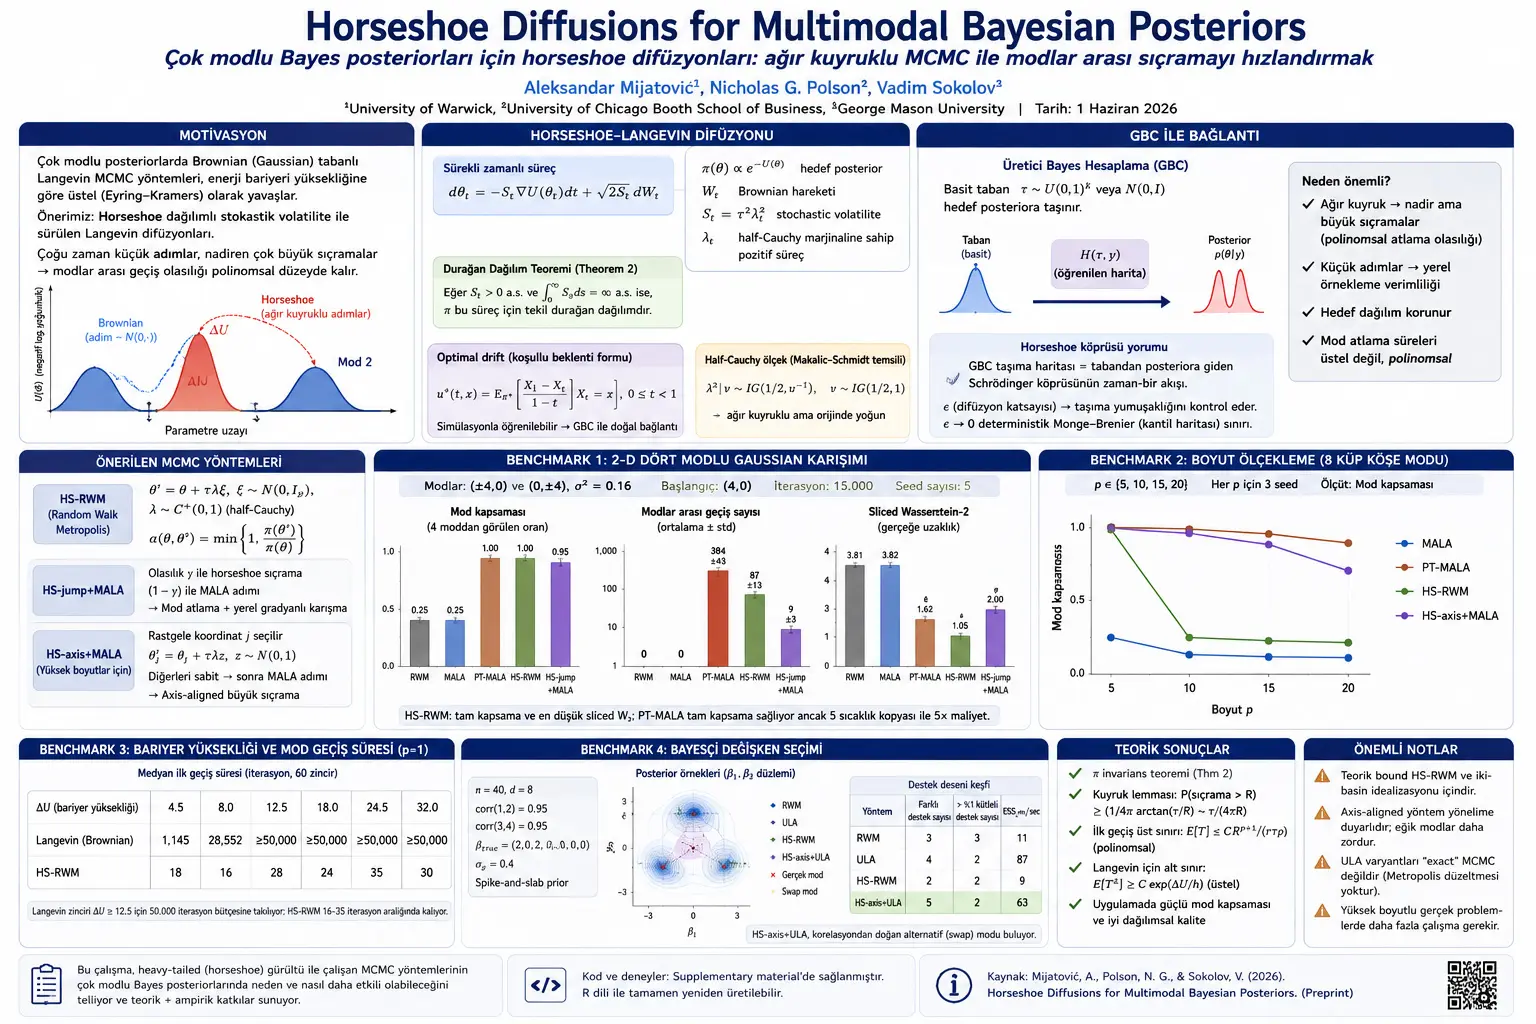
Katika takwimu za Bayes, lengo ni kupata posterior distribution kuhusu parameta zisizojulikana kwa kuzingatia data iliyochunguzwa. Posterior hii mara nyingi si ya kituo kimoja kama curve rahisi ya kengele. Hasa katika matumizi halisi, ni kawaida sana distribution kuwa na peaks zaidi ya moja. Distributions za aina hii huitwa multimodal posterior.
Multimodality si maelezo ya kiufundi tu; linaathiri moja kwa moja uaminifu wa inference. Ikiwa MCMC chain inabaki katika mode moja tu ya posterior na haitembelei modes nyingine, mtafiti anaweza kudhani ameona distribution yote ilhali amesample eneo la ndani tu. Katika hali hii uncertainty inawakilishwa kwa upungufu, model alternatives zinaweza kupitwa, na posterior summaries zinaweza kuwa za kupotosha.
Utangulizi wa utafiti unatoa mifano kadhaa muhimu inayoweza kusababisha multimodal posterior. Katika mixture models, label switching, yaani kubadilishana labels, inaweza kufanya maelezo yale yale ya takwimu yajitokeze tena chini ya parameter labels tofauti. Katika sparse regression kuna kutokuwa na uhakika kuhusu variables zipi ziingie kwenye model; combinations tofauti zenye explanatory power inayofanana zinaweza kuunda posterior modes tofauti. Katika Bayesian neural networks, weight symmetries huunda weight configurations tofauti zinazowakilisha function ileile. Katika hierarchical models, weak identifiability pia inaweza kufanya posterior ijikusanye katika maeneo mengi.
Moja ya mbinu zinazotumiwa sana katika classic MCMC workflows ni sampling inayotegemea Langevin dynamics. Standard overdamped Langevin diffusion inaweza kuandikwa:
\[ d\theta_t = -\nabla U(\theta_t)dt + \sqrt{2}dW_t \]
Hapa θt ni position ya chain katika muda t. U(θ) ni potential function inayofanya kazi kama negative log density ya target distribution. Target distribution ni:
\[ \pi(\theta) \propto \exp(-U(\theta)) \]
∇U(θ) ni gradient information inayosukuma chain kuelekea maeneo yenye probability kubwa. Wt ni Brownian motion, na √2dWt inawakilisha Gaussian randomness.
Muundo huu unaweza kuwa effective kwa unimodal au well-connected distributions. Lakini tatizo hutokea ikiwa kuna low-probability energy barrier kati ya high-probability modes mbili. Ili chain ipite kutoka mode moja kwenda nyingine, lazima ipitie low-density region. Gaussian steps mara nyingi ni ndogo au za ukubwa wa kati; probability ya very large steps hushuka kwa haraka sana, yaani exponentially. Kwa hiyo chain inaweza kuzunguka mode iliyopo kwa muda mrefu bila kufikia mode nyingine.
Utafiti unaunganisha tatizo hili na sheria ya Eyring–Kramers. Katika Brownian-driven Langevin dynamics, muda wa kuvuka barrier una tabia ya karibu exponential kulingana na barrier height ΔU na step size h:
\[ E[T_{cross}] \asymp \exp(\Delta U/h) \]
Maana ya vitendo ya formula hii ni kali. Barrier height ikiongezeka kidogo, crossing time haiongezeki mara mbili tu; inaweza kukua exponentially. Kwa hiyo classic Langevin-type samplers zinaweza kuwa unreliable kwenye posterior zenye modes zilizotenganishwa kweli. Kuweka hitimisho kwamba chain “imechanganyika vizuri” kwa sababu tu inazunguka vizuri ndani ya mode moja kunaweza kupotosha.
Suluhisho kuu linalopendekezwa na utafiti ni kubadilisha noise structure ya chain. Badala ya Brownian/Gaussian noise, hutumiwa horseshoe-distributed stochastic volatility. Horseshoe distribution inajulikana katika Bayesian statistics hasa kwa sparse signal na variable selection problems. Sifa yake muhimu ni kubeba tabia mbili za mwisho kwa wakati mmoja: strong concentration karibu na zero na heavy tail.
Katika sampling, sifa hizi mbili zinaweza kufasiriwa hivi. Concentration karibu na zero huruhusu chain kufanya small local steps mara nyingi. Heavy tail huruhusu occasional very large steps. Hiki ndicho kinachohitajika katika multimodal posterior: chain inapaswa kusample mode moja kwa umakini, lakini pia ibaki na probability ya kuruka kwenda mode nyingine.
Continuous-time process inayopendekezwa inaitwa horseshoe-Langevin diffusion:
\[ d\theta_t = -S_t \nabla U(\theta_t)dt + \sqrt{2S_t}dW_t \]
Katika formula hii St ni instantaneous scale au volatility process. Utafiti unaifafanua kama:
\[ S_t = \tau^2 \lambda_t^2 \]
Hapa τ ni global scale parameter. λt ni positive, cadlag process, yaani right-continuous with left limits, yenye marginal distribution ya half-Cauchy C+(0,1). St inapokuwa kubwa, drift na random-step magnitude zote hukua; inapokuwa ndogo, chain husogea locally zaidi.
Kuna balance muhimu hapa. Ikiwa sampler ingefanya only large jumps, inaweza kuvuka modes lakini inge-sample vibaya detailed shape ndani ya modes. Ikiwa sampler ingefanya only small steps, local structure ingesample vizuri lakini mode transitions zisingetokea. Horseshoe scale mixture inalenga kuunganisha tabia hizi mbili ndani ya mechanism moja.
Matokeo ya kwanza ya kinadharia yanahusu preservation ya target distribution. Kulingana na Theorem 2, ikiwa St ni positive almost surely, independent of Brownian motion, na inatimiza condition:
\[ \int_0^\infty S_s ds = \infty \quad \text{a.s.} \]
basi target distribution π ndiyo unique stationary distribution ya horseshoe-Langevin process. Hili ni muhimu kwa sababu kufanya noise scale kuwa random na heavy-tailed si lazima kuharibu target distribution. Process inaweza kufasiriwa kama time change inayoharakisha na kupunguza muda kwa nasibu; chini ya conditions zinazofaa, stationary distribution ya standard Langevin huhifadhiwa.
Intuition ya Theorem 2 ni hii. Standard Langevin process hukaribia target distribution sahihi. Horseshoe-Langevin process inaendesha dynamics hiyohiyo lakini kwa clock inayoharakishwa na kupunguzwa kwa nasibu. Ikiwa clock hii inaendelea kusonga bila kikomo, yaani accumulated scale jumla inakuwa infinite, process bado hufikia target distribution ileile. Hii inatoa msingi wa kuhakikisha kwamba heavy-tailed step scale haiharibu target.
Kwa practical generation ya half-Cauchy scale, utafiti hutumia Makalic-Schmidt augmentation:
\[ \lambda^2|\nu \sim IG\left(\frac{1}{2},\nu^{-1}\right),\quad \nu \sim IG\left(\frac{1}{2},1\right) \]
Hapa IG inamaanisha inverse-gamma distribution. Representation hii huwezesha kuzalisha half-Cauchy scale kupitia draws mbili za inverse-gamma. Code snippet katika sehemu ya implementation pia inaonyesha jinsi scale hii inavyosampled katika kila iteration.
Utafiti unafafanua discrete-time samplers tatu. Ya kwanza ni HS-RWM, yaani horseshoe-scaled random-walk Metropolis. Proposal hufanywa kama:
\[ \theta' = \theta + \tau \lambda \xi,\quad \xi \sim N(0,I_p),\quad \lambda \sim C^+(0,1) \]
Katika formula hii ξ ni p-dimensional standard Gaussian vector. λ ni half-Cauchy scale variable. Kwa kuwa proposal distribution ni symmetric, standard Metropolis acceptance probability hutumika:
\[ \alpha(\theta,\theta') = \min\left\{1,\frac{\pi(\theta')}{\pi(\theta)}\right\} \]
Mbinu hii inabaki reversible kwa π. Yaani kwa muda mrefu chain huhifadhi target distribution. HS-RWM ndiyo mbinu kuu inayotumiwa katika theoretical analysis; hasa polynomial upper bound ya first passage time kati ya modes inathibitishwa kwa mbinu hii.
Mbinu ya pili ni HS-jump+MALA. Hii ni mixture kernel. Kwa probability fulani horseshoe-scaled large jump hufanywa; kwa probability iliyobaki standard MALA step hutumika. Mantiki ni wazi: horseshoe jumps husaidia mode transitions, huku MALA steps zikitoa efficient local sampling ndani ya modes kwa kutumia gradient information.
Mbinu ya tatu ni HS-axis+MALA. Hii imeundwa kwa dimensions kubwa. Isotropic large jump inapogawanyika katika p dimensions zote, probability ya kutua kwenye mode sahihi inaweza kushuka katika high dimensions. Katika axis-aligned approach, coordinate moja huchaguliwa kwa nasibu, kisha horseshoe-scaled jump hufanywa kwenye coordinate hiyo pekee:
\[ \theta'_j = \theta_j + \tau\lambda z,\quad z\sim N(0,1) \]
Coordinates nyingine hubaki fixed. Standard Metropolis acceptance hutumika. Kernel hii ikichanganywa na MALA pia hubaki π-reversible. Sababu kuu ya HS-axis+MALA kuonekana robust zaidi kuliko isotropic HS-RWM katika high-dimensional experiments ni hii.
Katikati ya theoretical contribution ya utafiti kuna barrier-crossing probability ya horseshoe-scaled increments. Lemma 8 inatoa matokeo:
\[ P(\langle \tau\lambda\xi,u\rangle > R) \geq \frac{1}{4\pi}\arctan\left(\frac{\tau}{R}\right) \]
Kwa R kubwa, expression hii ina tabia:
\[ \frac{\tau}{4\pi R} + O(R^{-3}) \]
Hapa u ni unit vector yoyote. R ni distance au separation ya mode inayohitaji kuvukwa. Matokeo yanaonyesha kwamba probability ya horseshoe-scaled step kuvuka distance kubwa katika direction fulani hupungua polynomially kwa order ya 1/R.
Hii inatofautiana sana na Gaussian proposals. Katika Gaussian increments, probability ya large deviation ya aina hiyo hupungua karibu kama:
\[ \exp\left(-\frac{R^2}{2\tau^2}\right) \]
Yaani exponentially. Mechanism nzima ya utafiti inatokana na tofauti hii. Katika Gaussian noise, probability ya kuruka moja kwa moja kwenda mode ya mbali karibu hutoweka; horseshoe heavy tail huiweka probability hii hai katika kiwango cha polynomial.
Theorem 11 inatoa polynomial upper bound kwa first passage time ya HS-RWM chini ya idealized two-basin target assumption:
\[ E[T_{B_2}] \leq \frac{C R^{p+1}}{r^p \tau \rho} \]
Katika formula hii TB2 ni first entry time ya chain kwenye basin ya pili. R ni distance kati ya modes. p ni dimension. r inawakilisha radius ya acceptable small region karibu na target mode. τ ni horseshoe proposal scale. ρ ni acceptability parameter inayohusiana na density ratio karibu na mode ya pili. C ni numerical constant.
Maana ya bound hii ni kwamba kwa HS-RWM, kadiri mode separation inavyoongezeka, expected transition time huongezeka polynomially. Hii ni tofauti ya kinadharia muhimu ikilinganishwa na exponential lower bound ya classic Langevin:
\[ E[T^L_{B_2}] \geq C\exp(\Delta U/h) \]
Hapa ΔU ni energy-barrier height kati ya modes na h ni step size ya discretized Langevin. Barrier height ikiongezeka, classic Langevin transition time hukua exponentially; horseshoe proposal mechanism inaweza kutokana na heavy tail kuonyesha polynomial behavior.
Hata hivyo, mipaka ya theoretical result hii lazima ieleweke vizuri. Utafiti pia unaeleza wazi kwamba Theorem 11 ni hitting-time bound, si sharp bound kwa total-variation mixing time. Pia inategemea idealized two-basin target. Multimodal mixtures za experiments au high-dimensional cube-corner modes hazilingani moja kwa moja na assumption hii. Hata hivyo, matokeo yanatoa mathematical explanation kwa nini heavy-tailed proposals zinaweza kuwa na nguvu katika mode-jumping.
Experimental section ina benchmarks nne. Experiment ya kwanza ni mixture ya four Gaussian modes katika dimensions mbili. Modes ziko katika (±4,0) na (0,±4); common variance ni σ2 = 0.16. Chains zinaanzishwa katika (4,0) na kuendeshwa kwa iterations 15.000. Mbinu zinazolinganishwa ni RWM, MALA, PT-MALA, HS-RWM na HS-jump+MALA.
Figure 1 inatoa muhtasari wa experiment hii katika panels tatu. Left panel inaonyesha mode coverage, yaani modes ngapi kati ya nne zimetembelewa. Middle panel inaonyesha idadi ya mode-to-mode transitions. Right panel inaonyesha sliced Wasserstein-2 distance kutoka true distribution. Matokeo makuu ni wazi: RWM na MALA zinabaki katika initial mode pekee; mode coverage ni 0.25. PT-MALA na HS-RWM zinatembelea modes zote. HS-RWM pia inatoa sliced W2 ndogo zaidi.
Katika Table 1, numerical results zimeripotiwa kama ifuatavyo. HS-RWM inafikia mode coverage 1.00 ± 0.00, hufanya takriban 87 ± 13 mode transitions na sliced W2 ya 1.05 ± 0.29. PT-MALA pia ina mode coverage 1.00 ± 0.00 na cold-chain transitions zaidi, lakini sliced W2 ni 1.62 ± 0.45 na hutumia temperature replicas tano, hivyo computational cost kwa step ni karibu mara tano.
Matokeo haya yanaonyesha kwamba katika 2-D benchmark, HS-RWM inaweza kutumia single chain kufunika modes zote na kutoa strong distributional quality. Lakini lazima izingatiwe benchmark hii ni limited na controlled. Haiwezi kuhitimishwa kutoka experiment hii pekee kwamba performance hiyo itadumu moja kwa moja katika real high-dimensional posteriors.
Experiment ya pili ni dimension-scaling test. Target distribution ina modes nane zilizopachikwa katika p-dimensional space. Modes ziko kwenye corners za 3-cube:
\[ \mu_k \in \{-3,+3\}^3 \times \{0\}^{p-3} \]
Common variance ni:
\[ \sigma^2 = 0.36 \]
Dimensions hubadilishwa kama p ∈ {5,10,15,20}. Lengo ni kupima methods zinaweza kufunika modes nane kwa kiwango gani kadiri dimension inavyoongezeka.
Figure 2 na Table 2 zinaonyesha main result ya experiment hii. MALA inabaki karibu 0.12 coverage katika dimensions zote, yaani inapata takriban mode moja kati ya nane. Isotropic HS-RWM inaonekana nzuri kwa p = 5 na inatoa 0.83 ± 0.12 coverage; lakini kwa p = 10 inashuka hadi 0.17 ± 0.06, na kwa p = 15 na p = 20 karibu 0.12. Sababu ni kwamba large-jump magnitude inasambazwa katika dimensions zote na probability ya kuendana na direction ya mode sahihi hushuka kadiri dimension inavyoongezeka.
PT-MALA na HS-axis+MALA zinadumisha meaningful coverage hadi p = 20. PT-MALA inaripoti 0.71 ± 0.12 kwa p = 20, na HS-axis+MALA 0.62 ± 0.10. Kwa seeds tatu, tofauti hii inaweza kubaki ndani ya noise. Lakini computational cost ni tofauti: PT-MALA hutumia temperature replicas tano; HS-axis+MALA hutumia chain moja. Hii inaonyesha axis-aligned horseshoe jumps zinaweza kuwa practical alternative kwa high-dimensional multimodal targets.
Experiment ya tatu inalinganisha barrier height na mode-transition time moja kwa moja. Katika one-dimensional double-well targets, barrier height hubadilishwa kama:
\[ \Delta U \in \{4.5,8,12.5,18,24.5,32\} \]
Mode separation inawekwa kwa:
\[ R = \sqrt{2\Delta U} \]
Median first passage times kwa HS-RWM na Langevin hupimwa katika independent chains 60.
Katika Figure 3, y-axis iko kwenye log scale. Langevin chain inakuwa polepole sana kadiri ΔU inavyoongezeka na kwa ΔU ≥ 12.5 inafikia 50.000-iteration chain budget. Table 3 inatoa Langevin median crossing times 1145 kwa ΔU = 4.5, 28552 kwa ΔU = 8.0, na ≥ 50000 kwa barriers zote kubwa zaidi. Kwa kulinganisha HS-RWM inabaki katika range ya 18, 16, 28, 24, 35, 30 iterations.
Experiment hii ni mojawapo ya visual demonstrations zilizo wazi zaidi za theoretical message ya utafiti. Brownian/Gaussian noise inapokwama exponentially kadiri barrier height inavyoongezeka, horseshoe heavy tail huwezesha one-step large jumps. Kwa p = 1 theoretical bound ni quadratic katika R; kwenye experiment crossing times zinabaki karibu flat. Utafiti unaeleza hii kwa one-step mode crossings kutawala katika scales hizi.
Experiment ya nne ni Bayesian variable-selection example. Hapa n = 40 observations na d = 8 predictors hutumiwa. Correlation kati ya variables ya kwanza na ya pili ni ϱ = 0.95, na kati ya ya tatu na ya nne pia ϱ = 0.95. True coefficient vector ni:
\[ \beta_{true} = (2,0,2,0,0,0,0,0) \]
Noise standard deviation ni σy = 0.4, na continuous spike-and-slab prior hutumiwa. Chains huanza β = 0 na kuendeshwa iterations 60.000.
Lengo la experiment hii ni kuona kama alternative posterior support patterns zinazotokana na correlation zinaweza kupatikana. Ikiwa predictors mbili zina high correlation, hata kama variable ya kwanza ndiyo active kwenye true model, support pattern mbadala yenye variable ya pili active inaweza kujitokeza kama posterior mode. Modes kama hizi ni muhimu kwa variable-selection interpretation kwa sababu zinaonyesha kutokuwa na uhakika kuhusu variable ipi data inaunga mkono.
Figure 4 ina-project posterior samples kwenye β1-β2 plane. Red cross inaonyesha true mode, orange plus inaonyesha swap mode inayotokana na correlation. RWM, ULA na HS-RWM hazipati swap support pattern hii, lakini HS-axis+ULA ndiyo method pekee inayogundua alternative mode hii. Table 4 inaonyesha HS-axis+ULA imepata 5 distinct support patterns, ULA 4, RWM 3, na HS-RWM 2.
Hata hivyo, experiment hii ina methodological warning muhimu. HS-axis+ULA na ULA ni unadjusted methods zisizo na Metropolis correction; kwa hiyo exact π-reversibility guarantees zao si sawa na Metropolis-adjusted methods za Section 4. Utafiti unawasilisha matokeo haya kama exploratory demonstration. Ni meaningful kwamba HS-axis+ULA imepata swap mode, lakini haiwezi kusemwa variant hii inafanya exact posterior sampling.
Discussion inaunganisha horseshoe diffusions na score-based generative diffusion. Ikiwa Gaussian forward noise inabadilishwa na horseshoe scale mixture, forward process inaweza kuzalisha heavy-tailed marginals na labda kutembelea multimodal regions za data distribution kwa ufanisi zaidi. Hii inawasilishwa kama future-research direction kwa generative Bayesian computation na heavy-tailed diffusion models.
Pia inajadiliwa ni lini axis-aligned method inaweza kuwa dhaifu. HS-axis+MALA hudhani mode-separating directions ziko karibu na coordinate axes. Lakini ikiwa modes zimetenganishwa kwenye oblique direction au correlated coordinate blocks, single-coordinate jumps zinaweza kutotosha. Katika hali hiyo, horseshoe scale inaweza kuhitaji kutumika katika learned basis, Hessian eigenvectors, normalizing-flow coordinates au block-coordinate structures.
Nguvu za utafiti ni pamoja na target-preserving continuous-time theoretical framework, polynomial bound kwa mode-transition time, explicit theoretical comparison na Gaussian/Brownian methods, benchmarks zilizoripotiwa kwa multiple seeds, na test ya axis-aligned variant kwa higher dimensions. Variable-selection example pia inaonyesha heavy-tailed jumps zinaweza kusaidia si tu katika synthetic mixture benchmarks bali pia kwenye correlation-induced posterior modes.
Vikwazo ni muhimu pia. Theorem 11 ni kwa HS-RWM pekee na chini ya idealized two-basin assumption. High-dimensional theoretical guarantee ya HS-axis+MALA bado haijatolewa. Benchmarks zimefanywa kwa set ndogo ya problems. Katika Bayesian variable-selection experiment, HS-axis+ULA haitumii full Metropolis correction na hivyo haipaswi kutafsiriwa kama exact MCMC. Pia behavior ya method katika real high-dimensional Bayesian neural network posteriors haijaonyeshwa katika utafiti huu.
Lazima kutenganishwe kile ambacho utafiti unasema na ambacho hausisemi. Utafiti unadai kwa nadharia na experiments kwamba horseshoe diffusions zinaweza kuboresha sana mode transitions katika multimodal posterior. Lakini hii si guarantee ya automatic success kwa kila multimodal Bayesian problem. Heavy-tailed jumps zinaweza kuongeza mode coverage, lakini katika high dimensions direction, block structure, acceptance rate, local mixing na computational cost lazima viangaliwe kwa pamoja. Usomaji sahihi ni kwamba utafiti unaonyesha horseshoe scale mixture ni alternative yenye nguvu na inayostahili utafiti zaidi dhidi ya exponential-barrier problem ya Brownian/Gaussian MCMC.
Mbinu na Matokeo ya Utafiti
Mbinu ya utafiti inajumuisha kufafanua continuous-time horseshoe-Langevin diffusion, kuthibitisha preservation ya target distribution, kujenga Metropolis-adjusted discrete-time samplers, kutoa polynomial theoretical bound kwa first passage kati ya modes, na kuchunguza behavior ya methods kupitia benchmarks nne.
1. Target distribution na standard Langevin starting point
Target posterior distribution:
\[ \pi(\theta) \propto \exp(-U(\theta)) \]
Standard overdamped Langevin diffusion:
\[ d\theta_t = -\nabla U(\theta_t)dt+\sqrt{2}dW_t \]
| Term | Maana | Jukumu katika utafiti |
|---|---|---|
| θ | Bayesian parameter vector | Unknowns zinazotakiwa kusampled ndani ya posterior. |
| π(θ) | Target posterior density | Inapaswa kuwa stationary distribution ya MCMC chain. |
| U(θ) | Potential energy / negative log density | Modes na barriers zinaamuliwa na function hii. |
| ∇U(θ) | Potential gradient | Inaelekeza Langevin chain kwenye high-density regions. |
| Wt | Brownian motion | Gaussian random driver. |
2. Horseshoe-Langevin diffusion
Core process inayopendekezwa:
\[ d\theta_t = -S_t \nabla U(\theta_t)dt+\sqrt{2S_t}dW_t \]
Scale process:
\[ S_t=\tau^2\lambda_t^2 \]
| Component | Definition | Maelezo |
|---|---|---|
| τ | Global scale | Hu-set overall magnitude ya horseshoe steps. |
| λt | Local scale yenye Half-Cauchy marginal | Mara nyingi small, mara chache very large steps. |
| St | Stochastic volatility | Humodulate instantaneous speed na noise ya Langevin dynamics. |
| √(2St)dWt | Scaled Brownian noise | Continuous-time counterpart ya heavy-tailed jump behavior. |
3. Preservation ya stationary distribution
Main condition ya Theorem 2:
\[ \int_0^\infty S_s ds = \infty \quad \text{a.s.} \]
Chini ya condition hii, π huhifadhiwa kama unique stationary distribution ya horseshoe-Langevin process. Proof inategemea time-change idea. Process hutenda kama standard Langevin dynamics iliyoharakishwa na kupunguzwa kwa nasibu; ikiwa total time scale huenda infinity, convergence to target distribution huhifadhiwa.
4. Augmentation ya Half-Cauchy scale
Makalic-Schmidt representation iliyotolewa:
\[ \lambda^2|\nu \sim IG\left(\frac{1}{2},\nu^{-1}\right) \]
\[ \nu \sim IG\left(\frac{1}{2},1\right) \]
Representation hii huwezesha half-Cauchy scale variable kusampled kwa inverse-gamma draws mbili na hutumiwa kuzalisha λ katika kila iteration.
5. Discrete-time samplers
| Sampler | Proposal structure | Main purpose | Theoretical status |
|---|---|---|---|
| HS-RWM | [ \theta'=\theta+\tau\lambda\xi ] | Heavy-tailed random-walk mode jumps. | π-reversible; theoretical first-passage bound iko kwa method hii. |
| HS-jump+MALA | Horseshoe jump + MALA mixture | Kuunganisha mode-jumping na local gradient-based mixing. | π-reversible kama Metropolis-adjusted mixture. |
| HS-axis+MALA | Horseshoe jump kwenye coordinate moja + MALA | Kulenga jump kwa coordinate level katika high dimensions. | Metropolis-adjusted version ni π-reversible; high-dimensional theorem bado open. |
HS-RWM proposal:
\[ \theta'=\theta+\tau\lambda\xi,\quad \xi\sim N(0,I_p),\quad \lambda\sim C^+(0,1) \]
HS-axis+MALA jump proposal:
\[ \theta'_j=\theta_j+\tau\lambda z,\quad z\sim N(0,1) \]
6. Tail behavior ya horseshoe increment
Lemma 8:
\[ P(\langle\tau\lambda\xi,u\rangle>R)\geq \frac{1}{4\pi}\arctan\left(\frac{\tau}{R}\right) \]
Asymptotic behavior:
\[ \frac{\tau}{4\pi R}+O(R^{-3}) \]
Gaussian counterpart:
\[ \Phi(R/\tau)\asymp \exp\left(-\frac{R^2}{2\tau^2}\right) \]
| Noise type | Large-jump probability | Maana kwa mode transition |
|---|---|---|
| Gaussian | Hupungua exponentially | Probability ya kuruka kwenye distant mode hutoweka haraka. |
| Horseshoe-scaled Gaussian | Hupungua polynomially | Rare lakini large mode-jumping steps hubaki possible. |
7. First-passage theorems
Polynomial upper bound kwa HS-RWM:
\[ E[T_{B_2}] \leq \frac{C R^{p+1}}{r^p\tau\rho} \]
Exponential lower bound kwa Brownian-driven Langevin:
\[ E[T^L_{B_2}] \geq C\exp(\Delta U/h) \]
| Term | Maana |
|---|---|
| R | Separation distance kati ya modes mbili. |
| p | Dimension ya posterior. |
| r | Radius ya acceptable region karibu na target mode. |
| τ | Horseshoe proposal scale. |
| ρ | Acceptability parameter inayohusiana na density ratio karibu na mode ya pili. |
| ΔU | Energy barrier height kwa Langevin. |
| h | Step size ya discretized Langevin. |
8. Benchmark 1: 2-D four-mode Gaussian mixture
| Feature | Value katika utafiti |
|---|---|
| Mode locations | (±4,0) na (0,±4) |
| Common variance | σ2 = 0.16 |
| Starting point | (4,0) |
| Iterations | 15.000 |
| Seeds | 5 |
| Quality metric | Sliced Wasserstein-2 |
| Sampler | Mode coverage | Transitions | Sliced W2 | Maelezo |
|---|---|---|---|---|
| RWM | 0.25 ± 0.00 | 0 ± 0 | 3.81 ± 0.06 | Inabaki kwenye initial mode. |
| MALA | 0.25 ± 0.00 | 0 ± 0 | 3.82 ± 0.06 | Gaussian/Langevin steps haziwezi kufanya mode transition. |
| PT-MALA | 1.00 ± 0.00 | 384 ± 43 | 1.62 ± 0.45 | Inafunika modes zote; ina cost ya temperature replicas 5. |
| HS-RWM | 1.00 ± 0.00 | 87 ± 13 | 1.05 ± 0.29 | Lowest sliced W2 na full coverage. |
| HS-jump+MALA | 0.95 ± 0.10 | 9 ± 3 | 2.00 ± 0.57 | Coverage kubwa lakini distributional quality dhaifu kuliko HS-RWM. |
9. Benchmark 2: Dimension scaling
Mode structure:
\[ \mu_k \in \{-3,+3\}^3\times\{0\}^{p-3} \]
Dimensions:
\[ p\in\{5,10,15,20\} \]
| Sampler | p = 5 | p = 10 | p = 15 | p = 20 | Maelezo |
|---|---|---|---|---|---|
| MALA | 0.12 ± 0.00 | 0.12 ± 0.00 | 0.17 ± 0.06 | 0.12 ± 0.00 | Karibu hakuna mode transitions. |
| PT-MALA | 1.00 ± 0.00 | 0.96 ± 0.06 | 1.00 ± 0.00 | 0.71 ± 0.12 | Strong coverage; cost ya replicas tano. |
| HS-RWM | 0.83 ± 0.12 | 0.17 ± 0.06 | 0.12 ± 0.00 | 0.12 ± 0.00 | Isotropic jump inaharibika katika high dimensions. |
| HS-axis+MALA | 1.00 ± 0.00 | 1.00 ± 0.00 | 1.00 ± 0.00 | 0.62 ± 0.10 | Meaningful coverage hadi p = 20 kwa single chain. |
10. Benchmark 3: Barrier height na crossing time
Barrier heights:
\[ \Delta U \in \{4.5,8,12.5,18,24.5,32\} \]
Mode separation:
\[ R=\sqrt{2\Delta U} \]
| Sampler | ΔU = 4.5 | ΔU = 8.0 | ΔU = 12.5 | ΔU = 18.0 | ΔU = 24.5 | ΔU = 32.0 |
|---|---|---|---|---|---|---|
| Langevin | 1145 | 28552 | ≥50000 | ≥50000 | ≥50000 | ≥50000 |
| HS-RWM | 18 | 16 | 28 | 24 | 35 | 30 |
Experiment inaonyesha Brownian/Langevin chain inagonga budget kadiri barrier height inavyoongezeka, huku HS-RWM ikibaki kati ya iterations 16–35 katika range iliyojaribiwa.
11. Benchmark 4: Bayesian variable selection
| Item | Value katika utafiti |
|---|---|
| Observations | n = 40 |
| Predictors | d = 8 |
| Correlation | ϱ = 0.95 kwa Predictor 1–2 na 3–4 |
| True coefficient | βtrue = (2,0,2,0,0,0,0,0) |
| Observation noise | σy = 0.4 |
| Prior | Continuous spike-and-slab, σ0 = 0.1, σ1 = 2, w = 0.5 |
| Iterations | 60.000 |
| Sampler | Distinct supports | Supports with >1% mass | ESSmin/sec | Maelezo |
|---|---|---|---|---|
| RWM | 3 | 3 | 11 | Haipati swap mode. |
| ULA | 4 | 2 | 87 | ESS ni haraka lakini haigundui swap support. |
| HS-RWM | 2 | 2 | 9 | Support discovery ni limited katika example hii. |
| HS-axis+ULA | 5 | 2 | 63 | Method pekee inayopata swap support pattern. |
12. Maana ya kisayansi ya figures
- Figure 1: Inalinganisha mode coverage, transition count na sliced Wasserstein-2 distance kwenye four-mode Gaussian mixture ya dimensions mbili. HS-RWM ina full coverage na lowest sliced W2.
- Figure 2: Inaonyesha mode coverage inavyobadilika kadiri dimension inavyoongezeka. MALA na isotropic HS-RWM zinaharibika, huku PT-MALA na HS-axis+MALA zikidumisha meaningful coverage hadi p = 20.
- Figure 3: Inaonyesha Langevin first-passage time ikigonga budget kadiri barrier height inavyoongezeka, huku HS-RWM ikibaki na low transition times katika barriers zote zilizojaribiwa.
- Figure 4: Inaonyesha samples kwenye β1-β2 plane katika Bayesian variable selection experiment. HS-axis+ULA ndiyo method pekee inayogundua alternative swap mode inayotokana na high correlation.
13. Main conclusions
- Brownian-driven Langevin na MALA-type methods zinaweza kuwa na exponential barrier-crossing problem katika multimodal posterior.
- Horseshoe-scaled noise inaunganisha small local steps na rare large jumps katika mechanism moja.
- Horseshoe-Langevin process huhifadhi target distribution π kama stationary distribution chini ya suitable positive stochastic-volatility conditions.
- Kwa HS-RWM, first-passage time kati ya modes ina polynomial upper bound katika mode separation R.
- Kwenye 2-D four-mode benchmark HS-RWM inafunika modes zote na kupata lowest sliced Wasserstein-2 distance.
- Kwenye dimension scaling, HS-axis+MALA inatoa meaningful mode coverage hadi p = 20 kwa single chain.
- Kwenye barrier-height experiment, HS-RWM inaonyesha transitions za haraka sana ikilinganishwa na exponential slowdown ya Langevin.
- Kwenye Bayesian variable-selection example, axis-aligned horseshoe variant inaweza kugundua alternative support mode inayotokana na correlation.
14. Vikwazo
- Utafiti ni preprint ambao peer-review status haiwezi kuthibitishwa kutoka kwenye maandishi.
- Theorem 11 ni kwa HS-RWM pekee na chini ya idealized two-basin target assumption.
- High-dimensional theoretical coverage guarantee ya HS-axis+MALA bado haijatolewa.
- Isotropic HS-RWM inaharibika wazi katika high dimensions; hii inaendana na dimension dependence ya theoretical bound.
- HS-axis+ULA inayotumika katika Bayesian variable-selection experiment haina Metropolis correction, hivyo si exact π-reversible sampler.
- Real large-scale Bayesian neural-network posteriors hazijajaribiwa katika utafiti huu.
- Block-coordinate horseshoe jumps, learned coordinate systems na score-based generative diffusion extensions zimeachwa kama future work.
Chanzo na Dokezo la Mbinu
Makala hii imeandaliwa kwa kutegemea utafiti “Horseshoe Diffusions for Multimodal Bayesian Posteriors” ulioandaliwa na Aleksandar Mijatović, Nicholas G. Polson na Vadim Sokolov. Affiliations za waandishi zimeorodheshwa kama University of Warwick Department of Statistics, University of Chicago Booth School of Business na George Mason University. Tarehe katika maandishi inaonekana kuwa June 1, 2026.
Kwa kuzingatia aina ya chanzo, muundo wa maandishi, tarehe na namna ya uwasilishaji, kazi hii inapaswa kutathminiwa kama preprint / rasimu ya makala ya utafiti wa kitaaluma. Kwa kuwa taarifa ya peer-reviewed journal acceptance, DOI au open peer-review haijathibitishwa katika maandishi, inafaa kutumia maelezo utafiti ambao peer-review yake haiwezi kuthibitishwa kutoka kwenye maandishi.
Katika kuandaa maudhui haya, horseshoe-Langevin SDE definition, stationary-distribution theorem, HS-RWM, HS-jump+MALA na HS-axis+MALA samplers, half-Cauchy tail lemma, polynomial first-passage theorem, Eyring–Kramers comparison, 2-D Gaussian-mixture benchmark, dimension-scaling experiment, barrier-height experiment, Bayesian variable-selection example, figures, tables na limitations katika discussion zimetumika kama msingi.
Hakuna madai ambayo hayapo kwenye maandishi—kama general MCMC success guarantee, superiority katika all multimodal posteriors, validated result katika high-dimensional Bayesian neural networks, completed theory kwa HS-axis+MALA, au peer-reviewed publication acceptance—yaliyoongezwa. Matokeo ya utafiti ni muhimu hasa kwa kuonyesha kwamba heavy-tailed proposals zinaweza kuboresha mode coverage katika multimodal posterior; lakini katika matumizi, method selection inapaswa kuzingatia target geometry, dimension, direction ya mode separation, acceptance rate, computational cost na posterior accuracy kwa pamoja.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *