

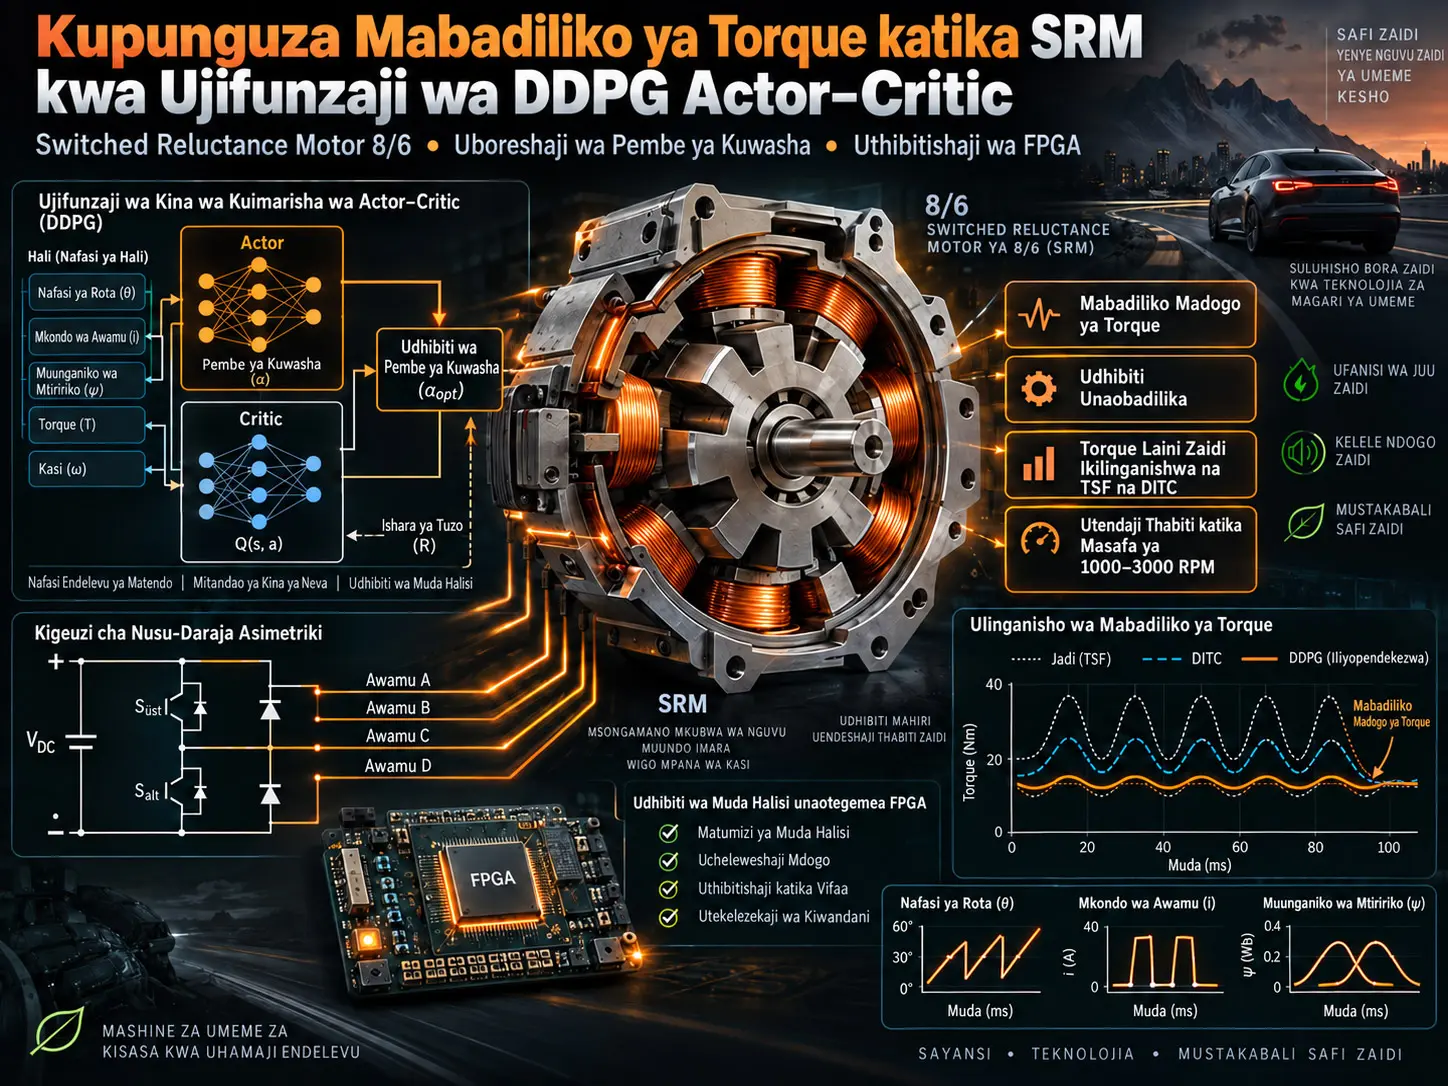
Kidhibiti cha SRM cha actor–critic kinachotegemea DDPG, ni mfumo wa udhibiti wa ujifunzaji wa kuimarisha unaochunguza hali za uendeshaji za Switched Reluctance Motor (SRM), kama vile mkondo, torque ya sumakuumeme, muunganiko wa mtiririko wa sumaku, kasi ya rota na nafasi ya rota, kisha kujifunza ofseti za pembe za kuwasha za awamu nne kama vitendo vyenye thamani endelevu. Utafiti unaendesha SRM ya awamu nne yenye nguzo 8/6 kupitia kigeuzi cha Asymmetrical Half-Bridge (ASHB); unafunza usanifu wa Deep Deterministic Policy Gradient (DDPG) actor–critic katika mazingira ya MATLAB Simulink R2024b na kutekeleza sera iliyojifunza kwa wakati halisi kwenye kidhibiti cha kidijitali cha Wavect kinachotegemea FPGA. Katika uigaji, mabadiliko ya torque kutoka kilele hadi kilele yaliyoripotiwa kwa mzigo wa 20 Nm na katika masafa ya 1000–3000 RPM ni kati ya %1,29 na %2,08. Hata hivyo, uthibitishaji wa maunzi kwa majaribio haukupima moja kwa moja mabadiliko ya torque ya papo hapo; hasa ulionyesha ukaribu wa torque ya wastani ya kimitambo na kasi na matokeo ya uigaji.
SRM ni mashine za umeme zisizohitaji sumaku za kudumu, zenye muundo rahisi wa rota, imara, zinazostahimili hitilafu na zinazoweza kufanya kazi katika masafa mapana ya kasi. Kwa upande mwingine, jiometri yenye ncha mbili za stator–rota, induktansi isiyo ya mstari inayotegemea nafasi ya rota na komutesheni ya awamu ya vipindi husababisha uzalishaji wa torque kuwa na mabadiliko. Mabadiliko haya yanaweza kusababisha mtetemo, kelele za akustiki, uchakavu wa kimitambo na kupungua kwa faraja ya uendeshaji.
Suluhisho linalopendekezwa na utafiti wa chanzo ni wakala wa DDPG anayejifunza pembe ya kuwasha kulingana na hali za uendeshaji badala ya kutumia wasifu wa mkondo usiobadilika au jedwali la komutesheni lililowekwa mapema. Mtandao wa actor huzalisha ofseti zinazofaa za kuwasha, huku mtandao wa critic ukitathmini mchango wa vitendo hivyo kwa ulaini wa torque wa muda mrefu kupitia Q-value. Kumbukumbu ya replay ya uzoefu, mitandao lengwa na masasisho laini huunga mkono uthabiti wa mafunzo.
Kwa Nini Mabadiliko ya Torque Hutokea katika SRM?
Sababu kuu ya mabadiliko ya torque katika Switched Reluctance Motor ni kwamba torque ya sumakuumeme inahusiana na mraba wa mkondo wa awamu na mteremko wa induktansi ya awamu unaobadilika kulingana na pembe ya rota; wakati wa komutesheni ya awamu, ikiwa mkondo wa awamu inayotoka unapungua huku mkondo wa awamu inayoingia haujengeki kwa kasi ya kutosha, mwendelezo wa torque ya jumla huvurugika, na athari hii inaweza kuongezwa na kujaa kwa sumaku, induktansi isiyo ya mstari inayotegemea nafasi ya rota na mwingiliano usio sahihi wa komutesheni.
Utaratibu wa torque ya sumakuumeme wa SRM
Katika SRM hakuna vilima vya rota wala sumaku za kudumu. Rota hujaribu kusogea kuelekea nafasi iliyolinganishwa inayopunguza reluctance ya mzunguko wa sumaku. Uhusiano wa msingi wa torque kwa awamu moja uliotolewa katika chanzo ni:
\[ T_{e,i}(\theta,t)=\frac{1}{2}i_i^2(t)\frac{dL_i(\theta)}{d\theta} \]
Hapa \(i_i(t)\) ni mkondo wa awamu; \(L_i(\theta)\) ni induktansi ya awamu inayotegemea pembe ya rota. \(dL_i/d\theta\) inaonyesha kasi ambayo induktansi hubadilika rota inapozunguka.
Mlinganyo una mahusiano mawili muhimu. Kwanza, torque inahusiana na mraba wa mkondo wa awamu; kwa hiyo athari ya mabadiliko ya mkondo kwenye torque si ya mstari. Pili, uzalishaji wa torque chanya hutokea hasa katika eneo ambako induktansi huongezeka pamoja na pembe ya rota, yaani \(dL/d\theta>0\). Kwa sababu hii ni muhimu kidhibiti kiipe awamu nishati katika eneo sahihi la rota.
Torque ya jumla ya sumakuumeme ya awamu nne imetolewa katika chanzo kama ifuatavyo:
\[ T_e(\theta,t)=\sum_{i\in\{A,B,C,D\}}T_{e,i}(\theta,t) =\frac{1}{2}\sum_i i_i^2(t)\frac{dL_i(\theta)}{d\theta} \]
Jumla hii inaeleza msingi wa kifizikia wa mkakati wa kupunguza mabadiliko ya torque: ikiwa mchango wa torque wa kila awamu unaweza kuingiliana kwa muda unaofaa, torque ya jumla ya sumakuumeme huwa laini zaidi.
Mabadiliko ya torque hupimwaje?
Kipimo kikuu cha chanzo cha mabadiliko ya torque kutoka kilele hadi kilele ni:
\[ TR(\%)=\frac{T_{\max}-T_{\min}}{T_{\mathrm{avg}}}\times100 \]
\(T_{\max}\) inaonyesha torque ya juu zaidi katika mzunguko mmoja wa umeme; \(T_{\min}\) torque ya chini zaidi; na \(T_{\mathrm{avg}}\) torque ya wastani. Kadiri uwiano unavyopungua, ndivyo uzalishaji wa torque unavyokubaliwa kuwa laini zaidi.
Utafiti pia unatoa umbo lililonormalishwa la RMS kwa tathmini ya wakati endelevu:
\[ TR_{\mathrm{RMS}}= \frac{ \sqrt{\frac{1}{T}\int_0^T [T_e(t)-T_{\mathrm{avg}}]^2dt} } {T_{\mathrm{avg}}} \]
Umbo hili huzingatia si tu pointi za juu na chini zaidi, bali pia ukubwa wa jumla unaofanana na nishati wa mikengeuko kutoka torque ya wastani katika kipindi kimoja cha umeme.
Dinamiki ya umeme ya awamu
Mlinganyo wa volteji wa awamu ya SRM katika chanzo ni:
\[ V_s(t)=R_i i_i(t)+\frac{d}{dt}[L_i(\theta(t))i_i(t)] \]
Kwa kufungua derivativi:
\[ V_s(t)=R_i i_i(t)+L_i(\theta)\frac{di_i(t)}{dt} +i_i(t)\dot{\theta}\frac{dL_i(\theta)}{d\theta} \]
hupatikana. Neno la mwisho linaonyesha uhusiano kati ya mwendo wa umeme na wa kimitambo. Kasi ya rota inapobadilika, volteji ileile na mkakati uleule wa komutesheni si lazima uzalishe tabia ileile ya mkondo. Hii ni mojawapo ya sababu za kifizikia zinazosababisha mbinu zinazotegemea pembe zisizobadilika za kuwasha kuwa na changamoto katika masafa mapana ya kasi.
Ramani ya majaribio ya induktansi
Katika utafiti, induktansi ya awamu haikuchukuliwa kama mkunjo wa kinadharia pekee. Katika mpangilio wa majaribio ulioonyeshwa kwenye kurasa 10–11, mita sahihi ya LCR ilitumika; rota ilizungushwa kwa mkono kwa hatua za nyuzi 10 na induktansi ya awamu katika kila nafasi ikarekodiwa. Rejeleo la nafasi ya rota lilifuatiliwa kwa incremental encoder iliyounganishwa kwenye mwisho usioendeshwa wa shaft na kupewa umeme wa 5 V DC.
Chanzo kinaripoti induktansi iliyolinganishwa ya 55 mH na induktansi isiyolinganishwa ya 12 mH. Wasifu uliopimwa wa induktansi uliingizwa katika mazingira ya udhibiti kama rejeleo la kifizikia linalomsaidia wakala kutambua maeneo yenye \(dL/d\theta\) chanya ya juu.
Kwa nini kigeuzi cha Asymmetrical Half-Bridge?
Kigeuzi cha ASHB cha awamu nne hutumia swichi mbili zinazodhibitiwa na diodi mbili kwa kila awamu. Utafiti unafafanua hali tatu kuu za umeme:
| Hali | Volteji ya awamu | Kazi kuu |
|---|---|---|
| Umagnetishaji | +\(V_{DC}\) | Swichi zote mbili zinazodhibitiwa zimewashwa; mkondo wa awamu huongezeka haraka. |
| Mzunguko huru | 0 V | Swichi moja imewashwa na nyingine imezimwa; mkondo wa awamu unaendelea kuzunguka. |
| Uondoaji wa sumaku | −\(V_{DC}\) | Swichi zote mbili zimezimwa; nishati ya sumaku kwenye koili hurudishwa kwenye basi la DC na mkondo wa awamu hupunguzwa. |
Udhibiti huru wa awamu wa ASHB na uwezo wa kuongeza/kupunguza mkondo kwa haraka ni muhimu kwa wakala wa DDPG kuweza kurekebisha muda wa kuwasha kwa kila awamu.
DDPG Hupunguzaje Mabadiliko ya Torque?
Kidhibiti cha DDPG hubadilisha hali iliyopimwa ya motor kuwa ofseti za pembe za kuwasha zenye thamani endelevu kwa awamu nne; mtandao wa actor huzalisha kitendo cha udhibiti, huku mtandao wa critic ukitathmini jumla ya zawadi ya baadaye ya kitendo hicho, na wakati wa mafunzo ratiba za komutesheni zinazosababisha mabadiliko madogo ya torque huimarishwa.
Tatizo la udhibiti linafafanuliwa kama Mchakato wa Maamuzi wa Markov
Chanzo kinafafanua mazingira ya ujifunzaji wa kuimarisha kama:
\[ M=(S,A,P,R,\gamma) \]
na kuufafanua kama Mchakato wa Maamuzi wa Markov.
- Nafasi ya hali \(S\): mikondo ya awamu, torque ya sumakuumeme, muunganiko wa mtiririko wa sumaku, kasi ya rota, nafasi ya rota na vitendo vya udhibiti vya awali.
- Nafasi ya vitendo \(A\): ofseti endelevu za pembe za kuwasha za awamu nne.
- Mpito \(P\): mpito wa motor kwenda hali mpya baada ya kitendo kutekelezwa.
- Zawadi \(R\): ishara ya utendaji inayohamasisha mabadiliko madogo ya torque na hali laini za uendeshaji.
- Kipengele cha punguzo \(\gamma\): uzito wa zawadi za baadaye katika uboreshaji wa sasa.
Lengo la sera ni kuongeza jumla ya zawadi iliyopunguzwa inayotarajiwa:
\[ J(\pi)=E_{\pi}\left[\sum_{k=0}^{\infty}\gamma^k r(s_k,a_k)\right] \]
Mtandao wa actor
Sera deterministi ya actor ni:
\[ a=\mu(s|\theta^\mu) \]
Chanzo kinaeleza kuwa mtandao wa actor hupokea vekta ya hali ya motor yenye vipimo 13; hutumia tabaka tatu fiche fully-connected zenye neuroni 256, 128 na 64 na huzalisha ofseti za pembe za kuwasha za awamu nne kupitia neuroni nne za pato. ReLU hutumiwa katika tabaka fiche na tanh hutumiwa kwenye pato.
Pato la tanh hubadilishwa kuwa kikomo cha kimwili cha pembe ili kuhakikisha kitendo kinabaki ndani ya eneo la komutesheni linalotekelezeka la motor.
Mtandao wa critic
Mtandao wa critic hupokea hali ya motor na kitendo cha actor, kisha:
\[ Q(s,a|\theta^Q) \]
hukadiria thamani ya kitendo ya muda mrefu inayowakilishwa na usemi huo. Chanzo kinaeleza kuwa critic huunganisha hali yenye vipimo 13 na kitendo chenye vipimo vinne kuwa ingizo lenye vipimo 17 kwa jumla; baada ya tabaka zenye neuroni 256 na 128 huzalisha Q-value moja ya skala.
Lengo la critic:
\[ y_k=r_k+\gamma Q'\left(s_{k+1}, \mu'(s_{k+1}|\theta^{\mu'})|\theta^{Q'}\right) \]
limeundwa hivyo. Critic hufunzwa kwa kupunguza mraba wa tofauti kati ya Q-value iliyokadiriwa na lengo hili.
Mwingiliano wa actor–critic
Actor “hajui” moja kwa moja kitendo sahihi. Hutumia gradient ya Q-value ya critic kwa kuzingatia kitendo:
\[ \nabla_{\theta^\mu}J \approx \frac{1}{N}\sum_{k=1}^{N} \nabla_aQ(s,a|\theta^Q)|_{a=\mu(s)} \nabla_{\theta^\mu}\mu(s|\theta^\mu) \]
Gradient hii humwelekeza actor kwenye pembe za kuwasha ambazo critic anazihusisha na zawadi ya juu zaidi ya muda mrefu.
Kumbukumbu ya replay ya uzoefu na mitandao lengwa
Kila mwingiliano:
\[ (s_k,a_k,r_k,s_{k+1}) \]
huhifadhiwa kama nne katika replay buffer. Wakati wa mafunzo, kuchukua kwa nasibu mini-batch kutoka uzoefu wa awali hupunguza uhusiano unaotokana na mfuatano wa muda.
Actor na critic pia wana nakala lengwa zinazosasishwa polepole. Katika utafiti, kipengele cha soft-update \(\tau=0.005\) kimetumika. Lengo ni kuzuia mabadiliko ya haraka katika mitandao inayojifunza yasitikise kupita kiasi thamani lengwa kwa wakati mmoja.
Kelele ya uchunguzi
Mwanzoni mwa mafunzo, kelele ya Ornstein–Uhlenbeck huongezwa kwenye kitendo:
\[ a_t=\mu(s_t|\theta^\mu)+N_t \]
Chanzo kinatoa vigezo vya kelele kuwa \(\mu=0\) na \(\sigma=0.25\). Njia hii huruhusu muda tofauti wa kuwasha kuchunguzwa katika nafasi ya vitendo endelevu.
Vigezo vikuu vya mafunzo
| Kigezo | Thamani |
|---|---|
| Kiwango cha kujifunza cha actor | 1 × 10⁻⁴ |
| Kiwango cha kujifunza cha critic | 2 × 10⁻⁴ |
| Kipengele cha punguzo \(\gamma\) | 0,99 |
| Sasisho la mtandao lengwa \(\tau\) | 0,005 |
| Replay buffer | 1 × 10⁶ sampuli |
| Mini-batch | 128 |
| Kelele ya uchunguzi | Ornstein–Uhlenbeck, μ = 0, σ = 0,25 |
| Mafunzo ya juu kabisa | 500 episode |
| Urefu wa episode | uigaji wa 1 s |
Chanzo kinaeleza tafsiri za kitabia za vigezo hivi kama “heuristic” na kinaweka wazi kwamba havitoi dhamana rasmi ya uthabiti au convergence.
Uhusiano kati ya zawadi na mabadiliko ya torque
Uhusiano rahisi wa zawadi uliotolewa katika uchambuzi wa matokeo ni:
\[ r=100-TR(\%) \]
Kadiri mabadiliko ya torque yanavyopungua, zawadi huongezeka. Kielelezo 24 kinaonyesha kwamba mabadiliko makubwa na zawadi ndogo mwanzoni mwa mafunzo hubadilika kuelekea mabadiliko madogo na zawadi kubwa baada ya takribani 0,15 s.
Hata hivyo, sehemu nyingine za makala zinaeleza kuwa kazi ya zawadi pia huadhibu hitilafu ya ufuatiliaji wa torque na mabadiliko ya udhibiti. Kwa hiyo Equation 30 inapaswa kuchukuliwa kama uhusiano wa wazi wa mstari unaotumika kutafsiri grafu ya matokeo; haipaswi kudhaniwa kuwa ndiyo mlinganyo pekee unaowakilisha maelezo yote ya muundo wa zawadi yaliyotolewa katika chanzo.
Mbinu na Matokeo ya Utafiti
Mfumo wa uigaji
Mfumo katika mazingira ya MATLAB Simulink R2024b una vipengele vinne vikuu vya kifizikia/udhibiti:
- SRM ya awamu nne yenye nguzo 8/6,
- kigeuzi cha nguvu cha ASHB cha awamu nne,
- bloku ya observation/state inayokusanya hali za motor,
- wakala wa DDPG actor–critic anayezalisha ofseti za pembe za kuwasha.
Katika Jedwali 3, chanzo kinatoa kwa uigaji 220 V DC link, mzigo wa 20 Nm, masafa ya kasi ya 1000–3000 RPM, induktansi iliyolinganishwa ya 55 mH na isiyolinganishwa ya 12 mH, pamoja na muunganiko wa juu wa mtiririko wa sumaku wa awamu wa 1,5 Wb.
Convergence ya ujifunzaji
Kielelezo 16 kinaonyesha kwamba episode reward na thamani za Episode Q0 zinazokadiriwa na critic huongezeka wakati wa mafunzo na kuingia katika eneo thabiti baada ya takribani 300–350 episode. Mafunzo yamewekwa kuwa ya juu kabisa 500 episode.
Chanzo kinafasiri tabia hii kama convergence ya sera ya actor–critic. Hata hivyo, utafiti hautoi uthibitisho wa kinadharia au kihisabati wa global convergence; Jedwali 2 pia linaweka wazi kuwa mipangilio iliyotumika haitoi dhamana rasmi ya uthabiti.
Mikondo ya awamu na muunganiko wa mtiririko wa sumaku
Kielelezo 17 kinaonyesha wasifu wa mikondo ya awamu nne unaofuatana na kuingiliana kwa sehemu. Chanzo kinatafsiri kutolingana kati ya awamu katika mikondo ya kilele ya takribani 20–22 A kama modulation ya mkondo iliyojifunza inayofidia nafasi ya rota na tofauti za induktansi.
Katika Kielelezo 18, muunganiko wa mtiririko wa sumaku huongezeka na kupungua kwa mpangilio katika kila awamu, na viwango vya kilele vinaripotiwa kuwa takribani 1,3–1,5 Wb. Wasifu huu wa nishati ya sumaku unaoingiliana huchangia mwendelezo wa torque ya jumla ya sumakuumeme.
Matokeo kati ya 1000–3000 RPM
| Kasi rejea (RPM) | Kasi thabiti (RPM) | Mzigo (Nm) | Torque ya wastani (Nm) | Tmax (Nm) | Tmin (Nm) | Muda wa kutulia (s) | Mabadiliko ya torque (%) |
|---|---|---|---|---|---|---|---|
| 1000 | 1012,4 | 20 | 20,53 | 20,74 | 20,31 | 0,3 | 2,08 |
| 1500 | 1513,3 | 20 | 20,79 | 20,96 | 20,65 | 0,3 | 1,48 |
| 2000 | 2008,6 | 20 | 21,06 | 21,21 | 20,94 | 0,3 | 1,29 |
| 2500 | 2506,9 | 20 | 21,32 | 21,51 | 21,22 | 0,3 | 1,38 |
| 3000 | 3038,6 | 20 | 21,61 | 21,89 | 21,51 | 0,3 | 1,75 |
Katika matokeo haya, mabadiliko ya chini zaidi yaliyoripotiwa ni %1,29 katika 2000 RPM; thamani ya juu zaidi ni %2,08 katika 1000 RPM. Katika pointi zote za uigaji zilizochunguzwa, thamani iko chini ya %3.
Ulinganisho wa DDPG-RL, TSF na DITC
| Kasi | DDPG-RL | TSF | DITC |
|---|---|---|---|
| 1500 RPM | 1,48% | 16,16% | 24,26% |
| 3000 RPM | 1,75% | 23,01% | 32,16% |
Ulinganisho ulifanywa chini ya modeli ileile ya motor 8/6, kigeuzi cha ASHB cha awamu nne, 220 V DC link, mzigo wa 20 Nm na pointi zilezile za kasi. Kwa TSF ilitumika cubic torque-sharing lookup table isiyobadilika; kwa DITC zilitumika hysteresis band na pembe za komutesheni zisizobadilika. DDPG-RL hubadilisha pembe za kuwasha kwa njia ya adaptive kupitia sera iliyojifunza.
Matokeo haya yanaunga mkono tu ulinganisho uliofanywa na usanidi wa TSF na DITC uliotekelezwa katika chanzo. Hitimisho pana zaidi kama “DDPG ni bora kuliko mbinu zote zinazowezekana za udhibiti wa kawaida katika hali zote” haliwezi kutolewa kutoka katika utafiti huu.
Uthibitishaji wa maunzi
Katika mpangilio wa majaribio ulioonyeshwa kwenye kurasa 35–38, SRM ya 8/6 imeunganishwa kimitambo na jenereta ya DC yenye excitation tofauti. Jenereta huunda mzigo wa kimitambo unaoweza kurekebishwa. Udhibiti wa motor inayoendeshwa kupitia kigeuzi cha ASHB ulitekelezwa na kidhibiti cha kidijitali cha Wavect kinachotegemea FPGA.
Chanzo kinaripoti sifa zifuatazo za motor ya majaribio:
| Sifa | Thamani |
|---|---|
| Nguvu ya shaft | 3,7 kW / 5 HP |
| Ugavi | 220 V |
| Mkondo | 5–10 A |
| Usanidi | nguzo 8 za stator / 6 za rota |
| Kasi nominali | 3000 RPM |
| Torque nominali | 8–25 Nm |
| Upinzani wa awamu | 0,22 Ω/faz |
| Moment ya inertia | 0,0055 kg·m² |
| Encoder | 24 PPR |
| Ufanisi ulioripotiwa | 90% |
Torque ya kimitambo inayotolewa na kifaa cha kupima torque–kasi kwa kitengo cha kg·m:
\[ T_{\mathrm{Nm}}=T_{\mathrm{kg\cdot m}}\times 9.81 \]
ilibadilishwa kuwa Nm kwa mlinganyo huu.
Matokeo ya torque ya wastani ya majaribio
| Kasi (RPM) | Torque (kg·m) | Torque (Nm) | Nguvu ya pato (kW) |
|---|---|---|---|
| 1002 | 2,09 | 20,51 | 2,16 |
| 1503 | 2,11 | 20,71 | 3,26 |
| 2001 | 2,13 | 20,90 | 4,38 |
| 2504 | 2,15 | 21,09 | 5,55 |
| 3005 | 2,17 | 21,28 | 6,67 |
Je, Mabadiliko ya Torque Yalipimwa Moja kwa Moja katika Uthibitishaji wa Majaribio?
Hapana. Katika utafiti wa chanzo, mpangilio wa majaribio hutoa vipimo vya torque ya wastani ya kimitambo, kasi ya shaft na nguvu ya pato; mabadiliko ya torque kutoka kilele hadi kilele yalihesabiwa kutoka maumbo ya mawimbi ya torque ya sumakuumeme yaliyosimuliwa kwa sababu kipimo cha lazima cha torque ya papo hapo chenye bandwidth ya juu hakikufanywa.
Tofauti hii ni muhimu kwa kutafsiri kwa usahihi kiwango cha ushahidi wa utafiti. Matokeo ya maunzi yanaonyesha kwamba sera ya DDPG iliyofunzwa inaweza kuendeshwa kwa wakati halisi kwenye FPGA na kwamba torque ya wastani ya majaribio iko karibu na torque ya wastani ya uigaji. Hata hivyo, thamani za %1,29–%2,08 katika Jedwali 7 si thamani za ripple zilizopimwa moja kwa moja kwa sensa ya torque ya majaribio.
Tofauti za kuripoti namba ndani ya chanzo
Chanzo kinaripoti baadhi ya vigezo kwa mizani tofauti katika sehemu tofauti, na si sahihi kuvipunguza kimya kimya kuwa thamani moja.
- Katika Jedwali 3 la uigaji 75 kW rated power imetajwa; motor ya majaribio katika Jedwali 10 imetolewa kama 3,7 kW / 5 HP.
- Katika Jedwali 3 mkondo wa awamu uliosimuliwa umeonyeshwa kuwa 5–10 A, wakati katika maelezo ya Kielelezo 17 inasemwa kuwa mikondo ya awamu inafikia thamani za kilele za takribani 20–22 A.
- Ingawa nguvu ya shaft ya 3,7 kW imetolewa kwa motor ya majaribio, Jedwali 11 linaripoti nguvu ya pato ya 5,55 kW na 6,67 kW katika pointi za kasi ya juu.
Kwa kuwa chanzo hakitoi maelezo ya kutosha kuhusu jinsi thamani hizi zinavyopaswa kupatanishwa, Verianla haizisahihishi kwa kuhesabu upya au kuongeza dhana. Ikiwa zitatumika kwa uzalishaji tena wa matokeo au kuongeza ukubwa wa muundo, pointi hizi zinapaswa kufafanuliwa na corresponding author.
Matokeo yanayoungwa mkono na utafiti
- Wakala wa DDPG anaweza kujifunza ofseti za pembe za kuwasha za awamu nne kama vitendo vya udhibiti endelevu.
- Katika hali za uigaji zilizochunguzwa, mabadiliko ya torque yaliripotiwa kuwa kati ya %1,29–%2,08.
- Ikilinganishwa na usanidi wa TSF na DITC katika utafiti huohuo, DDPG-RL ilizalisha mabadiliko madogo ya torque.
- Sera iliyojifunza ilihamishwa kwenye kidhibiti kinachotegemea FPGA na kuendeshwa katika mpangilio halisi wa motor.
- Thamani za torque ya wastani ya kimitambo ya majaribio zilipatikana kuwa karibu na torque za wastani za uigaji zilizoripotiwa.
- Nafasi endelevu ya vitendo ya DDPG inafaa kwa urekebishaji wa kina wa pembe ya kuwasha kwa kila awamu.
Matokeo ambayo hayajaungwa mkono na utafiti
- Haiwezi kusemwa kwamba mabadiliko ya torque ya %1,29–%2,08 yalipimwa moja kwa moja kwa sensa katika mfumo wa majaribio.
- Utendaji nje ya 1000–3000 RPM haujathibitishwa na majaribio haya.
- Haijaonyeshwa kwamba online learning inaweza kutekelezwa katika vidhibiti vyote vya embedded vya gharama nafuu.
- Haiwezi kuhitimishwa kwamba DDPG itatoa utendaji uleule katika jiometri zote za SRM, madaraja ya nguvu na hali za mzigo.
- Upunguzaji wa kelele za akustiki haukupimwa moja kwa moja; umeachwa kama mada ya kazi ya baadaye.
- Uboreshaji wa malengo mengi wa ufanisi wa nishati–torque ripple si sehemu ya utafiti huu.
- Chanzo hakitoi uthibitisho rasmi wa global stability au DDPG convergence.
Vikwazo na kazi za baadaye
Waandishi kwanza wanaeleza kwamba mafunzo na uthibitishaji vimewekewa mipaka katika eneo maalum la uendeshaji la 1000–3000 RPM. Kwenda mbali sana nje ya eneo hili kunaweza kuhitaji mafunzo mapya au adaptasheni ya ziada.
Kikwazo cha pili ni gharama ya offline training. Kujifunza sera kwa DDPG kunahitaji episode nyingi za uigaji; hata hivyo, mafunzo yakikamilika, katika utekelezaji wa wakati halisi sera hutumiwa kama kidhibiti kisichobadilika.
Kikwazo cha tatu ni jukwaa la ukokotoaji. Utafiti unaonyesha uwezekano wa utekelezaji kwenye majukwaa ya udhibiti wa kidijitali yenye utendaji wa juu kama FPGA; kwenye maunzi ya gharama nafuu kunaweza kuwa na vikwazo vya prosesa na kumbukumbu, hasa kwa online learning.
Mielekeo ya kazi ya baadaye ni pamoja na eneo pana la kasi, muda mfupi wa mafunzo, uboreshaji wa malengo mengi kati ya ufanisi na mabadiliko ya torque, ukandamizaji wa moja kwa moja wa kelele za akustiki, ujumuishaji na jukwaa la gari la umeme linalotumia betri, na mbinu zenye ufanisi zaidi za online adaptation.
Maelezo ya Chanzo na Mbinu
Utafiti asilia: Deep Deterministic Policy Gradient-Based Actor–Critic Reinforcement Learning for Torque Ripple Minimization in Switched Reluctance Motors
Waandishi: Divya Ramasamy; Sundaram Maruthachalam.
Taasisi: Department of Electrical and Electronics Engineering, PSG Institute of Technology and Applied Research; Department of Electrical and Electronics Engineering, PSG College of Technology, Tamilnadu, India.
Corresponding author: Divya Ramasamy.
Jarida: Machines.
Mchapishaji: MDPI.
Juzuu / toleo / makala: 14(3), 333.
DOI: 10.3390/machines14030333.
Iliwasilishwa: 9 Januari 2026.
Marekebisho: 25 Februari 2026.
Ilikubaliwa: 11 Machi 2026.
Ilichapishwa: 16 Machi 2026.
Aina ya chanzo na mapitio: Makala ya utafiti iliyopitia mapitio ya wenzao.
Leseni: Creative Commons Attribution 4.0 International (CC BY 4.0).
Ufadhili: Imeripotiwa kwamba utafiti haukupokea ufadhili maalum kutoka taasisi za ufadhili za umma, kibiashara au zisizo za faida.
Mgongano wa maslahi: Waandishi hawaripoti mgongano wa maslahi.
Upatikanaji wa data: Inaelezwa kwamba michango asilia ya utafiti inapatikana ndani ya makala na maswali ya ziada yanaweza kuelekezwa kwa corresponding author.
Michango ya waandishi: Uundaji wa dhana D.R. na S.M.; mbinu, programu na uthibitishaji D.R.; uchambuzi rasmi na rasilimali S.M.; rasimu ya awali D.R.; mapitio/uhariri D.R.; uonyeshaji D.R. na S.M.; usimamizi S.M.
Mbinu: Uainishaji wa induktansi kwa majaribio + mafunzo ya DDPG katika MATLAB Simulink + uigaji wa 8/6 SRM + ulinganisho wa TSF na DITC + utekelezaji wa maunzi wa wakati halisi unaotegemea FPGA.
Kikomo kikuu cha majaribio: Jaribio la maunzi linathibitisha tabia ya torque ya wastani ya kimitambo na kasi; asilimia ya mabadiliko ya torque haikuhesabiwa kutoka kipimo cha moja kwa moja cha torque ya papo hapo ya majaribio, bali kutoka torque ya sumakuumeme iliyosimuliwa.
Onyo la kuripoti ndani ya chanzo: Nguvu ya motor ya uigaji na ya majaribio pamoja na baadhi ya thamani za mkondo zimeripotiwa katika sehemu tofauti kwa namna zisizolingana moja kwa moja. Kwa kuwa chanzo hakitoi maelezo ya kutosha, thamani hizi hazijasahihishwa na Verianla wala kulazimishwa kuwa thamani moja ya pamoja.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *