

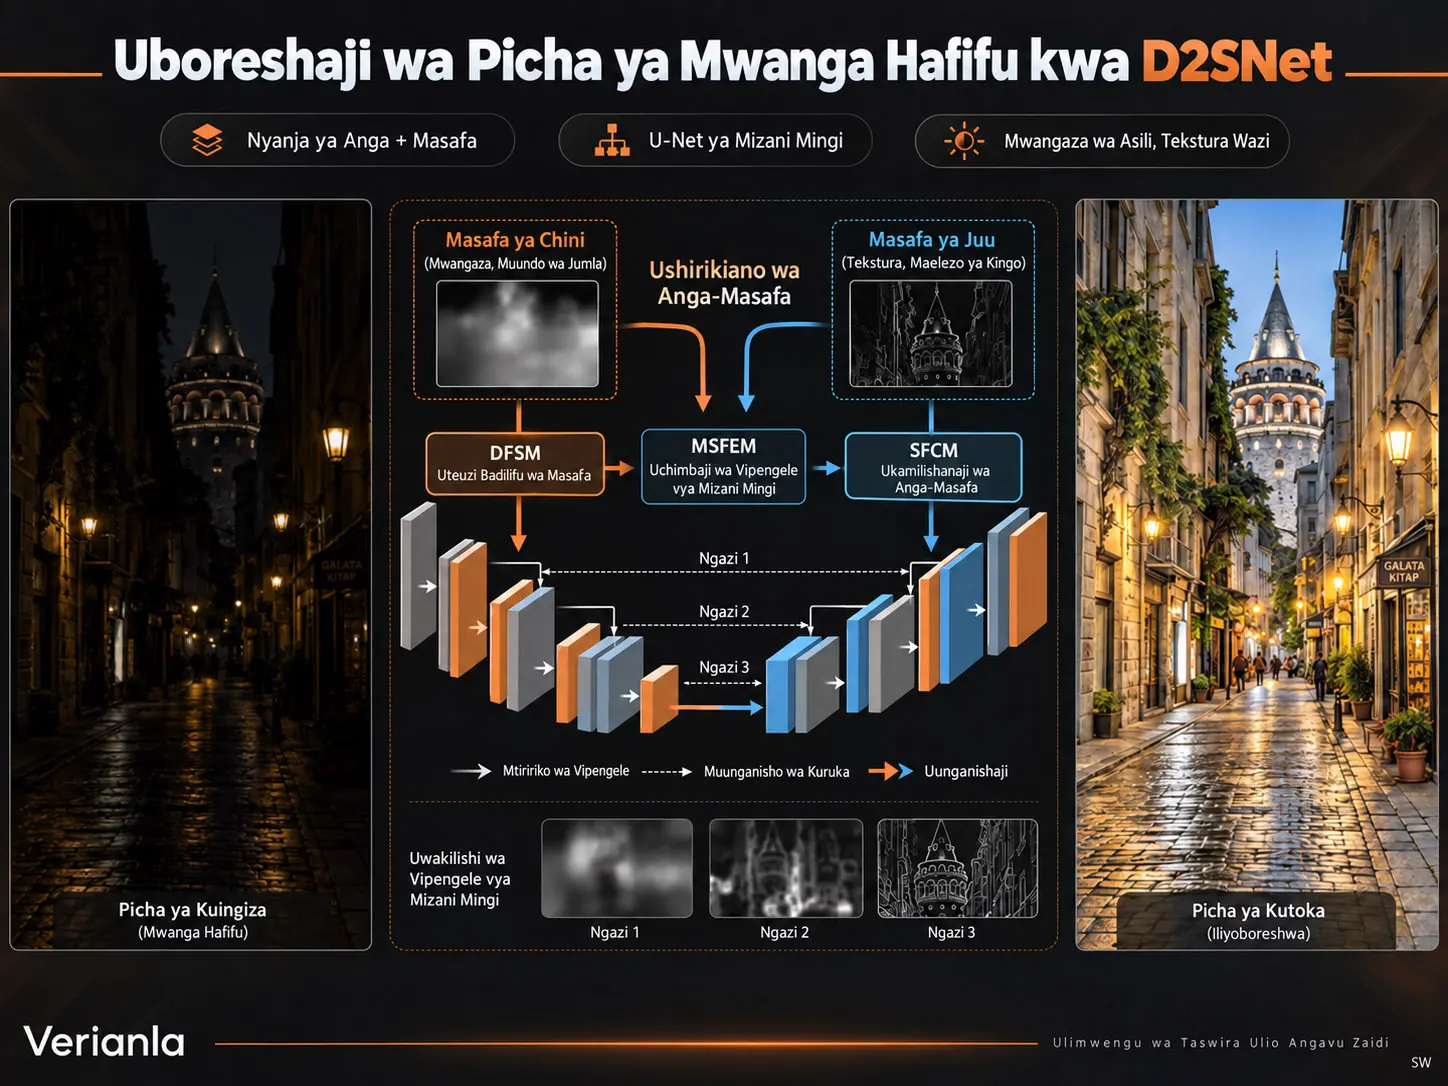
Dual-Domain Synergy Network (D2SNet) ni usanifu wa ujifunzaji wa kina unaoshughulikia tatizo la kuboresha picha za mwanga hafifu kwa kuchakata pamoja muundo wa anga wa picha na vipengele vya masafa ndani ya U-Net ya mizani mingi. Lengo kuu la modeli si kuangaza picha tu; bali pia kuzuia ukuzaji usio wa lazima wa kelele wakati mwangaza unarekebishwa, kuhifadhi rangi na kurejesha miundo midogo ya picha. D2SNet hufanya hivyo kupitia Moduli ya Uteuzi wa Masafa Inayobadilika (Dynamic Frequency Selection Module, DFSM), Moduli ya Utoaji wa Vipengele vya Mizani Mingi (Multi-Scale Feature Extraction Module, MSFEM) na Moduli ya Ukamilishanaji wa Anga na Masafa (Spatial-Frequency Complementarity Module, SFCM).
Badala ya kufanya utenganishaji wa moja kwa moja kwa kutumia misingi thabiti ya Fourier, cosine au wavelet, DFSM huzalisha makundi ya vichujio vya kupitisha masafa ya chini vinavyojifunzwa kutoka kwenye vipengele vya ingizo. Vichujio hivi hutenganisha vipengele vya masafa ya chini na ya juu; kisha mifumo ya uangalizi wa njia na wa anga huweka uzani kwa vipengele vya masafa vinavyofaa zaidi kwa uboreshaji. MSFEM hujaribu kunasa muktadha mpana na maelezo ya ndani kwa kuunganisha konvolusheni za depth-wise separable zilizopanuliwa za 3 × 3, 5 × 5 na 7 × 7 pamoja na tawi la ndani la 1 × 1. SFCM huunganisha mbinu hizi mbili na kiwango cha mwonekano wa juu cha U-Net kuu kupitia muundo mdogo wa SU-Net.
Katika utafiti wa chanzo, D2SNet ilitathminiwa kwenye seti pana ya benchmark ikijumuisha LOLv1, LOLv2-Real, LOLv2-Synthetic, LOL-Blur, Sony-Total-Dark, seti tano za data za mwanga hafifu zisizo na jozi, na majaribio ya utambuzi wa vitu ya ExDark. Kwa mfano, kwa LOLv1 ziliripotiwa 25.09 dB PSNR na 0.874 SSIM, kwa LOLv2-Synthetic 26.60 dB PSNR na 0.947 SSIM, na kwa LOL-Blur 27.78 dB PSNR na 0.906 SSIM. Modeli ina vigezo milioni 5.62 na hutumia 36.82 G FLOPs kwa kiraka cha ingizo cha 256 × 256.
Matokeo haya yanaonyesha kwamba D2SNet ni modeli yenye nguvu ya urejeshaji wa picha za mwanga hafifu chini ya seti za data na itifaki ya mafunzo iliyotumika katika utafiti. Hata hivyo, matokeo yanatokana na preprint ambayo haijapitiwa na wakaguzi wenza, na matokeo maalum ya benchmark hayamaanishi ubora wa jumla kwa kamera, sensa, viwango vya mwanga au aina zote za uharibifu katika mazingira halisi.
Tatizo la utafiti: kwa nini kuongeza mwangaza pekee hakutoshi?
Katika picha iliyopigwa kwenye mwanga hafifu, tatizo si tu kuwa kiwango cha wastani cha pikseli ni cha chini. Kelele ya sensa inaweza kuonekana zaidi, rangi zinaweza kupotoshwa, utofauti wa ndani kupungua, miundo midogo kupotea, na ikiwa mfiduo mrefu umetumika, ukungu unaotokana na mwendo au kamera unaweza kutokea. Kwa hiyo, mfumo mzuri wa kuboresha picha za mwanga hafifu unapaswa kurekebisha mwangaza wa jumla huku ukihifadhi maelezo, usiongeze kelele, na usitengeneze maeneo yasiyo ya asili yaliyoangazwa kupita kiasi.
Utafiti wa chanzo unajadili mbinu zilizopo kwa mitazamo miwili mikuu. Sehemu kubwa ya mbinu zinazotegemea CNN na Transformer hufanya kazi hasa katika uga wa anga. Mbinu zinazotumia uga wa masafa mara nyingi hutumia mabadiliko yaliyowekwa awali kama FFT, DCT au DWT. Kutoweza kwa mabadiliko haya thabiti kuzoea moja kwa moja muundo wa uharibifu wa mwanga hafifu unaobadilika kutoka picha moja hadi nyingine ndiko kunakounda msingi wa D2SNet.
D2SNet ni Nini na Kwa Nini Inatumia Nyanja Mbili Tofauti Pamoja?
D2SNet ni modeli ya kuboresha picha inayotegemea U-Net ambayo hutumia kwa pamoja muundo wa anga wa picha ya mwanga hafifu na vipengele vya masafa ya chini na ya juu ndani ya mtandao mmoja wa urejeshaji wa mizani mingi. Wakati uga wa anga hubeba taarifa kuhusu mahali vitu, maeneo na muktadha wa ndani vilipo, utenganishaji wa masafa huruhusu vipengele vinavyobadilika polepole vya mwangaza na vipengele vinavyobadilika haraka kama kingo, miundo na kelele kushughulikiwa kwa njia tofauti.
Mtiririko wa jumla wa data wa mtandao
Ingizo ni picha ya RGB ya mwanga hafifu yenye ukubwa wa \(3 \times H \times W\). Konvolusheni ya kwanza ya 3 × 3 hubadilisha picha kuwa uwakilishi wa vipengele vya awali wenye ukubwa wa \(C \times H \times W\). Kisha encoder kuu ya U-Net yenye mizani mitatu hupunguza mwonekano hatua kwa hatua huku ikiongeza idadi ya njia. Decoder hufanya kazi kwa mwelekeo wa kinyume na huunganishwa na vipengele kutoka encoder kupitia skip connections.
DFSM hutumika baada ya operesheni ya mwisho ya ResBlock katika kila kiwango cha mwonekano. MSFEM haijawekwa mfululizo katika kila kiwango; hutumiwa kwenye bottleneck za SU-Net na U-Net kuu. Kwa mujibu wa chanzo, uchaguzi huu unalenga kupunguza mapengo ya sampuli ya mara kwa mara na upotevu wa taarifa za anga ambao unaweza kujitokeza ikiwa idadi kubwa ya konvolusheni zilizopanuliwa zitatumika mfululizo.
Katika hatua ya mwisho, konvolusheni ya 3 × 3 hutumika na matokeo ya mtandao huunganishwa na picha ya awali ya mwanga hafifu kupitia residual connection ili kupata picha ya mwisho iliyoboreshwa.
Moduli tatu kuu
| Moduli | Jina kamili | Kazi kuu | Jukumu la kisayansi |
|---|---|---|---|
| DFSM | Dynamic Frequency Selection Module | Kutenganisha na kuweka uzani wa masafa kwa vichujio vinavyojifunzwa | Kuchagua vipengele muhimu vya masafa ya chini/juu kulingana na maudhui ya picha |
| MSFEM | Multi-Scale Feature Extraction Module | Kutoa vipengele vya anga kutoka kwa ukubwa tofauti wa receptive field | Kutoa muktadha wa kisemantiki kutoka wa jumla hadi wa ndani kwa uteuzi wa masafa |
| SFCM | Spatial-Frequency Complementarity Module | Kuunganisha SU-Net, MSFEM na DFSM katika mkondo mmoja wa uchakataji | Kuunda ukamilishanaji wa anga na masafa katika kiwango cha mwonekano wa juu |
DFSM Hufanyaje Uteuzi wa Masafa Unaoweza Kujifunzwa?
DFSM hugawanya vipengele vya ingizo katika makundi ya njia, huzalisha kerneli za kichujio cha kupitisha masafa ya chini zinazojifunzwa kutoka kwenye ingizo lenyewe, hutoa kipengele cha masafa ya chini kwa kuchuja na huunda kipengele cha masafa ya juu kama residual kati ya ingizo na kipengele cha masafa ya chini; kisha uzani wa uangalizi wa njia na wa anga huamua kwa nguvu mchango wa masafa ya chini na ya juu kwenye matokeo.
FFE: utenganishaji unaobadilika wa vipengele vya masafa
Ramani ya vipengele vya ingizo \(X \in \mathbb{R}^{C \times H \times W}\) hugawanywa katika makundi \(g\) kwenye mhimili wa njia:
Mlinganyo (1)
\[ X=[X^{1},X^{2},\ldots,X^{g}] \]
Idadi ya njia katika kila kundi hufafanuliwa kama \(C_i=C/g\). Njia ya kuzalisha kichujio hutumia global average pooling, konvolusheni ya 1 × 1, batch normalization na Softmax:
Mlinganyo (2)
\[ LPF=\operatorname{Softmax}\left(BN\left(Conv_{1\times1}(GAP(X))\right)\right) \]
Ukubwa wa vichujio vya kupitisha masafa ya chini vinavyozalishwa ni \(k^{2}\times g\). \(k\) inaonyesha ukubwa wa kerneli ya kichujio na \(g\) idadi ya makundi ya njia. Operesheni ya Softmax huzalisha uzani uliosanifishwa juu ya vipengele \(k^{2}\) vya kerneli.
Mlinganyo (3), kama ulivyochapishwa kwenye chanzo
\[ X^{i}_{low}= \sum_{p,q\in\mathcal{N}_{k}} \left( X^{i}(h+p,w+q)\cdot LPS^{i} \right) \]
Hapa \(h,w\) zinaonyesha nafasi ya sasa ya anga; \(\mathcal{N}_{k}\) inaonyesha ujirani wa ndani wa \(k\times k\). Ingawa maelezo katika maandishi ya chanzo yanaita kichujio husika LPF, taswira ya Mlinganyo (3) imechapisha alama LPS. Kwa kuwa chanzo hakisemi wazi kuwa hili ni kosa la uandishi, kutokulingana kati ya alama hizi mbili kunarekodiwa hapa bila kubadilishwa.
Kipengele cha masafa ya juu hupatikana kwa kutoa uwakilishi uliounganishwa wa makundi yote ya masafa ya chini kutoka kwenye kipengele cha awali:
Mlinganyo (4)
\[ X_{high}=X-[X^{1}_{low},X^{2}_{low},\ldots,X^{g}_{low}] \]
Muundo huu wa kihisabati ni muhimu: kipengele cha masafa ya juu hakihesabiwi kwa kichujio tofauti cha high-pass kilichowekwa, bali hufafanuliwa kama mabaki ya makadirio yanayojifunzwa ya masafa ya chini.
DAGG na utaratibu wa uangalizi mara mbili
Vipengele vya masafa ya chini na ya juu hupitishwa kwanza kwenye konvolusheni tofauti za 3 × 3 depth-wise. Kisha hutengenezwa njia mbili tofauti za fusion: \(X_{add}\) kwa jumlisho la kipengele kwa kipengele na \(X_{con}\) kwa kuunganisha katika mwelekeo wa njia. \(X_{add}\) hutumwa kwenye Dual Attention Module yenye njia sambamba za uangalizi wa njia na wa anga.
Mlinganyo (5)
\[ W_{ca}=Conv_{1\times1}\left( ReLU\left( Conv_{1\times1}(GAP(X_{add})) \right) \right) \]
\(W_{ca}\in\mathbb{R}^{C\times1\times1}\) ni kipengele cha uangalizi wa njia kinachoweka uzani kwa njia za vipengele zilizo muhimu zaidi kwa uboreshaji.
Mlinganyo (6)
\[ W_{sa}=Conv_{7\times7}\left( [GAP(X_{add}),GMP(X_{add})] \right) \]
\(W_{sa}\in\mathbb{R}^{1\times H\times W}\) huzalisha usambazaji wa uzani kati ya maeneo ya anga. Kwa mujibu wa maelezo ya chanzo, lengo ni kuyapa maeneo yaliyoharibika zaidi uangalizi mkubwa zaidi.
Uzani wa njia na wa anga huunganishwa na \(W_{casa}\) huzalishwa kwa Sigmoid. Muunganiko wa njia mbili za fusion ni kama ifuatavyo:
Mlinganyo (7)
\[ X_{fuse}= W_{casa}\cdot X_{add} + (1-W_{casa})\cdot Conv_{1\times1}(X_{con}) \]
Kisha hupatikana uzani uliosanifishwa mahsusi kwa vipengele vya masafa ya chini na ya juu:
Mlinganyo (8)
\[ W_{low},W_{high} = Split\left( Softmax(GAP(X_{fuse})) \right) \]
Matokeo ya DFSM:
Mlinganyo (9)
\[ X_{out} = W_{low}\cdot X_{low} + W_{high}\cdot X_{high} \]
Usemi huu wa mwisho unafupisha kazi kuu ya DFSM. Modeli haijumlishi vipengele vya masafa ya chini na ya juu kwa uwiano thabiti; huviunganisha tena kwa uzani unaojifunzwa kwa kila ingizo.
MSFEM: kuweka muktadha wa jumla na maelezo ya ndani katika moduli moja
MSFEM hupitisha vipengele vya ingizo kwanza kwenye batch normalization, konvolusheni ya 1 × 1 point-wise na uanzishaji wa GELU:
Mlinganyo (10)
\[ \hat{X} = GELU\left( Conv_{1\times1}(BN(X)) \right) \]
Katika tawi kubwa, konvolusheni tatu sambamba za depth-wise dilated hutumiwa:
Mlinganyo (11)
\[ X_{k} = DWDConv_{k\times k,d=3}(\hat{X}), \qquad k\in\{3,5,7\} \]
Kiwango cha dilation ni \(d=3\). Uhusiano wa receptive field unaofaa uliotolewa na chanzo ni:
\[ k_{eff}=k+(k-1)(d-1) \]
Kwa mujibu wa hilo, kerneli za 3 × 3, 5 × 5 na 7 × 7 hufikia receptive field zinazofaa za 7 × 7, 13 × 13 na 19 × 19 mtawalia. Hivyo, badala ya kutegemea kipimo kimoja cha kerneli, mfumo hujaribu kunasa muktadha wa anga wa masafa mafupi, ya kati na marefu zaidi.
Matokeo ya tawi kubwa:
Mlinganyo (12)
\[ X_{large} = Conv_{1\times1} \left( GELU \left( Conv_{1\times1} ([X_{3},X_{5},X_{7}]) \right) \right) \]
Tawi dogo hutumia konvolusheni ya 1 × 1 depth-wise pekee ili kukamilisha taarifa ya ndani:
Mlinganyo (13)
\[ X_{small} = Conv_{1\times1} \left( GELU \left( DWConv_{1\times1}(\hat{X}) \right) \right) \]
Chaguo muhimu la usanifu wa MSFEM ni kwamba moduli haitumiki mfululizo katika viwango vyote. Chanzo kinasema kwamba kutumia konvolusheni zilizopanuliwa katika mizani nyingi zinazofuatana kunaweza kusababisha pikseli zisizochukuliwa sampuli kwa mpangilio na kupotea kwa taarifa za anga; hivyo MSFEM huwekwa tu kwenye bottleneck za SU-Net na U-Net kuu.
Nafasi ya SFCM na U-Net ndogo
SFCM huchakata kwanza ingizo la \(C\times H\times W\) kwa ResBlock yenye konvolusheni mbili za 3 × 3 na ReLU. Kisha vipengele hupunguzwa hadi \(C\times H/2\times W/2\) kwa konvolusheni ya depth-wise yenye kernel=2 na stride=2 na kutumwa kwa MSFEM. Baada ya kurejeshwa kwenye mwonekano wa awali kwa bilinear interpolation, DFSM hutumika na skip connection huundwa na vipengele vya awali.
Muundo huu ulitumika tu katika mizani ya kwanza yenye mwonekano wa juu zaidi wa U-Net kuu. Matokeo ya ablation yanaonyesha kwamba kuongeza SU-Net pia kwenye mizani ya pili na ya tatu hupunguza FLOPs lakini pia PSNR. Matokeo haya yamehusishwa na tafsiri kwamba downsampling mpya katika viwango vya mwonekano wa chini inaweza kusababisha upotevu wa maelezo ya anga yenye manufaa.
Fungsi ya upotevu
Katika mafunzo ya D2SNet, upotevu wa \(L_{1}\) hutumiwa kwa uga wa anga na uga wa masafa.
Mlinganyo (14)
\[ L_{spatial} = \|Pred-GT\|_{1} \]
Hapa \(Pred\) inaonyesha picha inayozalishwa na mtandao, na \(GT\) inaonyesha picha rejea ya mwanga wa kawaida.
Mlinganyo (15)
\[ L_{frequency} = \|F(Pred)-F(GT)\|_{1} \]
\(F\) inaashiria fast Fourier transform (FFT). Upotevu huu wa masafa unalenga kuleta karibu uwakilishi wa masafa wa picha iliyotabiriwa na picha rejea.
Mlinganyo (16)
\[ L = L_{spatial} + \lambda L_{frequency} \]
Katika utafiti, \(\lambda=0.2\) ilichaguliwa. Hivyo uboreshaji wa jumla huweka kosa la urejeshaji wa anga kama sehemu kuu huku ukitoa uzani wa ziada kwa ulinganifu wa uga wa masafa.
Vipimo vya tathmini hupima nini?
PSNR ni kipimo cha ubora kinachohusiana na kosa la urejeshaji katika kiwango cha pikseli, na katika utafiti huu thamani kubwa inapendelewa. SSIM hupima mfanano wa kimuundo, na pia thamani kubwa ni bora. LPIPS hutathmini tofauti ya kiutambuzi katika nafasi ya vipengele vya kina; thamani ndogo ni bora. Kwa seti za data zisizo na picha rejea, BRISQUE na NIQE zilitumika, na katika zote thamani ndogo inapendelewa.
Mbinu na Matokeo ya Utafiti
Seti za data
Katika tathmini kuu za jozi zilitumika LOLv1, LOLv2-Real na LOLv2-Synthetic. Katika LOLv1 jozi 485 za picha za mwanga hafifu/kawaida zilitengwa kwa mafunzo na jozi 15 kwa majaribio. Uwiano wa mafunzo:majaribio kwa LOLv2-Real ni 689:100, na kwa LOLv2-Synthetic ni 900:100.
Seti ya data ya LOL-Blur ina jozi 12.000 za picha za mwanga hafifu/zilizotiwa ukungu na picha zenye ukali wa juu zilizoundwa kutoka mandhari 200; jozi 10.200 zilitumika kwa mafunzo na 1.800 kwa majaribio. Katika sehemu ya Sony-Total-Dark kuna jozi 2.697 za picha RAW za mfiduo mfupi na mrefu; jozi 2.099 zilitumika kwa mafunzo na 598 kwa majaribio.
Majaribio ya ujanibishaji bila picha rejea yalifanywa kwenye DICM, LIME, MEF, NPE na VV. Aidha, seti ya data ya utambuzi wa vitu ya ExDark ilitumika kutathmini athari ya uboreshaji wa mwanga hafifu kwenye kazi ya kiwango cha juu ya maono ya kompyuta.
Maelezo ya mafunzo na utekelezaji
| Kigezo | Thamani iliyotumika kwenye chanzo |
|---|---|
| Framework | PyTorch |
| Vifaa | NVIDIA A100 GPU moja |
| Optimizer | Adam |
| \(\beta_1\) | 0.9 |
| \(\beta_2\) | 0.999 |
| \(\epsilon\) | \(1\times10^{-8}\) |
| Learning rate ya mwanzo | \(1\times10^{-3}\) au \(1.2\times10^{-3}\) |
| Learning rate ya mwisho | \(5\times10^{-7}\) |
| Ratiba ya learning rate | Cosine annealing |
| Batch size | 32 |
| Patch size | 256 × 256 |
| Kerneli za kichujio cha DFSM | 3 × 3 na 5 × 5 |
| Idadi ya makundi ya FFE | 8 |
| Muda wa mafunzo wa LOLv1 / LOLv2 | 2.500 epoch |
| Muda wa mafunzo wa LOL-Blur | 1.500 epoch |
| Sony-Total-Dark | Mipangilio ileile ya msingi kama LOL-Blur |
Matokeo makuu ya benchmark za jozi
| Seti ya data | PSNR | SSIM | LPIPS |
|---|---|---|---|
| LOLv1 | 25.09 dB | 0.874 | 0.082 |
| LOLv2-Real | 23.80 dB | 0.877 | 0.076 |
| LOLv2-Synthetic | 26.60 dB | 0.947 | 0.027 |
| LOL-Blur | 27.78 dB | 0.906 | 0.075 |
| Sony-Total-Dark | 21.70 dB | 0.676 | 0.387 |
Ukubwa wa hesabu wa D2SNet umetolewa kwenye majedwali ya chanzo kama vigezo milioni 5.62 na 36.82 G FLOPs. Katika LOLv1 modeli ilifikia 25.09 dB PSNR, ikiwa 0.42 dB juu ya thamani ya 24.67 dB ya Diff-Retinex++. Katika LOLv2-Synthetic D2SNet ilipata 26.60 dB PSNR, 0.947 SSIM na 0.027 LPIPS.
Kwa LOLv2-Real, thamani za 23.80 dB PSNR na 0.877 SSIM za D2SNet ndizo za juu zaidi kwenye Jedwali 1 la chanzo. Hata hivyo, LPIPS yake ni 0.076, wakati CWNet imeripotiwa kuwa na 0.063 kwenye jedwali hilo hilo. Kwa hiyo, dai la maandishi ya chanzo kwamba ni “bora katika PSNR, SSIM na LPIPS zote” halilingani na safu ya LPIPS ya jedwali.
LOL-Blur: uboreshaji na kuondoa ukungu kwa pamoja
Katika jaribio la LOL-Blur, D2SNet ilitoa 27.78 dB PSNR, 0.906 SSIM na 0.075 LPIPS. Katika Jedwali 2 la chanzo, thamani hizi tatu zinaonekana kuwa bora kuliko mbinu nyingine zote za end-to-end na za mfululizo zilizoorodheshwa. Gharama ya hesabu ya 36.82 G FLOPs ni chini sana kuliko baadhi ya mbinu nzito zaidi, lakini si modeli nyepesi zaidi iliyolinganishwa.
Katika ulinganisho wa ubora wa chanzo, urejeshaji wa rangi, uhifadhi wa maelezo na kupunguzwa kwa ukungu katika matokeo ya D2SNet vimesisitizwa. Haya yanaungwa mkono na mifano ya kuona; hata hivyo, uteuzi wa mifano ya ubora si utafiti huru wa watumiaji unaowakilisha mandhari zote zinazowezekana.
Sony-Total-Dark: picha RAW zilizo gizani sana
Kwenye Sony-Total-Dark D2SNet ilipata 21.70 dB PSNR, 0.676 SSIM na 0.387 LPIPS. Katika ulinganisho wa chanzo, LEDNet ina 20.83 dB, 0.648 na 0.471 mtawalia. Jaribio hili linaonyesha kwamba usanifu ulitathminiwa si kwenye picha za kawaida za LOL pekee bali pia kwenye data RAW zenye mfiduo wa chini sana.
Seti za data zisizo na picha rejea
| Seti ya data | BRISQUE | NIQE |
|---|---|---|
| DICM | 18.16 | 3.77 |
| LIME | 14.63 | 3.66 |
| MEF | 13.22 | 3.38 |
| NPE | 13.21 | 4.01 |
| VV | 18.54 | 2.80 |
Kwenye LIME, MEF na VV, D2SNet hutoa thamani nzuri. Katika DICM, BRISQUE 18.16 ndiyo thamani ya chini zaidi kwenye jedwali la chanzo; NIQE 3.77 ni juu kidogo sana kuliko 3.76 ya DarkIR. Katika NPE, BRISQUE 13.21 ya D2SNet ni juu kuliko 12.88 ya DarkIR, na NIQE 4.01 ni juu kuliko 3.74 ya CIDNet. Kwa hiyo, matokeo hayapaswi kutafsiriwa kama “bora katika seti zote za data zisizo na jozi na katika vipimo vyote”.
Majaribio ya Ablation Yanaonyesha Mchango wa Vipengele Gani vya D2SNet?
Ablation za chanzo zinaonyesha kwamba mchango mkubwa zaidi wa moduli moja unatoka DFSM, MSFEM huleta faida ya ziada, na kutumia SU-Net tu katika mizani ya mwonekano wa juu zaidi ni bora zaidi kwa uwiano wa utendaji na hesabu; muundo kamili ulifikia 25.09 dB PSNR na 0.874 SSIM kwenye LOLv1.
Mchango wa moduli kuu
Mtandao wa msingi ulitoa 20.19 dB PSNR na 0.815 SSIM. Kuongeza MSFEM kwenye bottleneck ya U-Net kuu kuliongeza PSNR hadi 21.06 dB, huku kutumia DFSM katika mizani husika kukifikisha 23.68 dB. Waandishi wa chanzo wanaripoti hili kama ongezeko la 3.49 dB PSNR dhidi ya msingi kwa DFSM.
Kwa kuongeza SU-Net kwenye mizani ya kwanza, PSNR ilifikia 23.74 dB huku FLOPs zikishuka kutoka 38.13 G hadi 35.01 G. Kwa uwekaji wa baadaye wa MSFEM, mtandao kamili ulifikia 25.09 dB PSNR, 0.874 SSIM, vigezo 5.62 M na 36.82 G FLOPs.
Kwa nini SU-Net moja tu?
| Idadi ya SU-Net | PSNR | SSIM | FLOPs |
|---|---|---|---|
| 0 | 23.68 | 0.858 | 38.13 G |
| 1 | 23.74 | 0.858 | 35.01 G |
| 2 | 23.42 | 0.850 | 31.89 G |
| 3 | 23.27 | 0.850 | 28.77 G |
Kadri idadi ya SU-Net inavyoongezeka, ubora wa picha hupungua licha ya kupungua kwa hesabu. Tafsiri ya chanzo ni kwamba downsampling ya ziada katika tabaka za mwonekano wa chini inaweza kusababisha upotevu usioweza kurejeshwa wa maelezo ya anga.
Idadi ya makundi ya FFE
Kwa FFE, PSNR ni 23.57 dB kwa \(g=2\) na \(g=4\), 23.68 dB kwa \(g=8\), na 23.48 dB kwa \(g=16\). Kwa hiyo, makundi 8 yalichaguliwa katika modeli ya mwisho. Chanzo kinahusisha kushuka kwa makundi 16 na uwezekano wa overfitting; maelezo haya si utaratibu uliothibitishwa moja kwa moja bali ni tafsiri ya waandishi.
Kichujio kinachojifunzwa na muundo wa uangalizi
Katika ulinganisho wa FFE, kichujio cha Gaussian kilitoa 23.22 dB, kichujio cha Wavelet 23.21 dB na kichujio cha kupitisha masafa ya chini kinachojifunzwa 23.68 dB PSNR. Kwa upande wa DAGG, CBAM ilitoa 23.19 dB na muundo wa DAM wa utafiti 23.68 dB. Hivyo, majaribio ya chanzo yanaonyesha kwamba utenganishaji wa masafa unaojibadilisha kulingana na maudhui pamoja na mfumo sambamba wa uangalizi mara mbili vilichangia kwenye benchmark iliyochaguliwa.
Mchango wa mizani ya MSFEM
Konvolusheni tatu sambamba za 3 × 3 DWDConv zilitoa 20.34 dB, miundo mitatu sambamba ya 5 × 5 20.56 dB, na miundo mitatu sambamba ya 7 × 7 20.64 dB PSNR. Large Branch ya mizani mingi ilifikia 20.81 dB, na kutumia Large Branch pamoja na Small Branch kukafikia 21.06 dB. Kuongeza tawi dogo kulitoa faida ya 0.19 dB PSNR huku, kulingana na jedwali la chanzo, likiongeza tu 0.07 G FLOPs.
Matumizi ya utambuzi wa vitu ya ExDark
Utafiti pia ulijaribu athari ya uboreshaji wa picha si kwa kipimo cha ubora wa kuona pekee bali kwa kazi inayofuata ya maono ya kompyuta. Picha 7.363 katika seti ya data ya ExDark ziligawanywa kuwa picha 5.890 za mafunzo, 737 za uthibitishaji na 736 za majaribio. Baada ya picha kuboreshwa kwa modeli ya D2SNet iliyofunzwa kwenye LOLv2-Synthetic, kitambuzi cha vitu cha YOLO-V5 kilitumika.
Kwa preprocessing ya D2SNet, mAP ya jumla iliripotiwa kama 73.6 kwenye Jedwali 10 la chanzo. Thamani ya pili ya juu zaidi ya wastani ilikuwa 67.9 kwa SRENet; tofauti ni pointi 5.7. Katika kategoria ya “Dog”, D2SNet ilifikia 80.0, Diff-Retinex++ 72.8, tofauti ikiwa pointi 7.2. Katika mmoja wa mifano ya Kielelezo 9 cha chanzo, mashua ambayo haikutambuliwa kwenye picha ya mwanga hafifu ilitambuliwa na YOLO-V5 baada ya uboreshaji wa D2SNet kwa alama ya kujiamini 0.82.
Matokeo ya D2SNet Yanapaswa Kutafsiriwaje?
Matokeo ya D2SNet yanaunga mkono kwamba ushirikiano wa anga na masafa unaweza kuwa mbinu yenye nguvu ya urejeshaji chini ya seti za data za benchmark na mipangilio ya mafunzo iliyotumika katika utafiti; hata hivyo, kutokana na hadhi ya preprint, upeo mdogo wa seti za data na baadhi ya kutokulingana kwa maandishi na majedwali, matokeo hayapaswi kubadilishwa kuwa dai la ubora wa hakika na wa jumla kwa mifumo yote ya kamera halisi au hali zote za mwanga hafifu.
Hitimisho zinazoungwa mkono na utafiti
Majaribio ya chanzo yanaonyesha kwamba DFSM hutoa mchango mkubwa wa ablation, kuunganisha mizani tofauti za receptive field katika MSFEM hutoa PSNR ya juu kuliko matoleo ya mizani moja, na SU-Net moja iliyowekwa kwenye kiwango cha juu zaidi cha mwonekano huunda uwiano mzuri zaidi kati ya gharama ya hesabu na ubora. D2SNet pia ilijaribiwa kwenye seti za data zilizo na jozi, zisizo na jozi, zenye ukungu na zenye giza kali; na kupitia jaribio la ExDark, athari ya preprocessing kwenye utambuzi wa vitu pia ilitathminiwa.
Ujumla ambao utafiti hauungi mkono
Utafiti hauonyeshi kwamba D2SNet itatoa utendaji uleule katika sensa zote za kamera, mifano yote ya kelele, viwango vyote vya mwanga au vifaa vya embedded vya muda halisi. Chanzo hakiripoti kipimo cha latency kwenye kifaa maalum cha mkononi, edge accelerator au mfumo wa viwandani wa muda halisi. Aidha, uboreshaji wa vipimo vya picha za benchmark haumaanishi kwamba faida ya ukubwa huo itatokea katika kila kazi ya utambuzi wa kuona au maono ya kompyuta yenye umuhimu wa usalama.
Maelezo ya Chanzo na Mbinu
Kichwa asili: D2SNet: Dual-domain Synergy Network for Low-Light Image Enhancement
Waandishi: Feng Huang; Jing Guo; Jing Wu; Jiong Huang.
Mpangilio wa waandishi: Feng Huang → Jing Guo → Jing Wu → Jiong Huang.
Taasisi: Kwa mujibu wa rekodi rasmi ya SSRN, waandishi wote wanne wanahusishwa na Fuzhou University.
Mwandishi wa mawasiliano: Katika rekodi ya SSRN, Jing Guo ametajwa kama “Contact Author”. Toleo linaloonekana la PDF halitoi alama tofauti ya corresponding-author.
DOI: 10.2139/ssrn.7003581
Jukwaa: SSRN.
Rekodi rasmi:SSRN Abstract 7003581
Tarehe ya kuwasilisha/kurekodi: 26 Juni 2026.
Aina ya chanzo: Makala ya utafiti ya preprint.
Hali ya mapitio: PDF ya chanzo inaeleza wazi kwamba kazi haijapitiwa na wakaguzi wenza.
Jarida/juzuu/toleo: Chanzo hakitoi taarifa ya uchapishaji katika jarida lililopitiwa, juzuu au toleo.
Leseni/hakimiliki: Ukurasa wa rekodi wa SSRN unaeleza kwamba haki zimehifadhiwa na matumizi tena bila ruhusa hayaruhusiwi. Kwa hiyo, maandishi ya Verianla hayanukui muundo wa picha na majedwali ya chanzo; yanaeleza tu taarifa za kisayansi zinazoweza kuthibitishwa, mbinu, milinganyo na matokeo katika muundo huru wa kufundisha.
Mgongano wa maslahi: Waandishi wanasema hakuna maslahi ya kifedha yanayojulikana au uhusiano wa kibinafsi unaoweza kuathiri kazi.
Upatikanaji wa data: Chanzo kinaeleza kwamba data iliyotumika katika utafiti inapatikana kwa ombi.
Ufadhili: Hakuna tamko tofauti la ufadhili lililoripotiwa katika PDF iliyokaguliwa.
CRediT/michango ya waandishi: PDF iliyokaguliwa haitoi tamko la CRediT kwa kila mwandishi.
Kutokulingana kwa alama ndani ya chanzo: Katika taswira ya Mlinganyo (3) \(LPS^{i}\) imetumika, ilhali katika maelezo yanayohusiana kichujio cha kupitisha masafa ya chini kimeandikwa kama \(LPF^{i}\). Chanzo hakielezi sababu ya tofauti hii.
Kutokulingana kwa matokeo ndani ya chanzo: Maandishi yanasema D2SNet ndiyo bora katika PSNR, SSIM na LPIPS zote kwenye LOLv2-Real, lakini katika Jedwali 1 thamani ya LPIPS ya CWNet ni 0.063 na ya D2SNet ni 0.076. Kwa kuwa thamani ndogo ni bora kwa LPIPS, tathmini ya Verianla inategemea thamani za jedwali.
Kikomo cha kimethodolojia: Matokeo yanategemea utendaji wa modeli iliyojifunza ya urejeshaji wa picha katika seti teule za benchmark. Mapitio ya wenza, uzalishaji upya huru, vipimo vya latency kwenye vifaa tofauti na uthibitishaji mpana wa uwanjani havijaonyeshwa na chanzo hiki.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *