

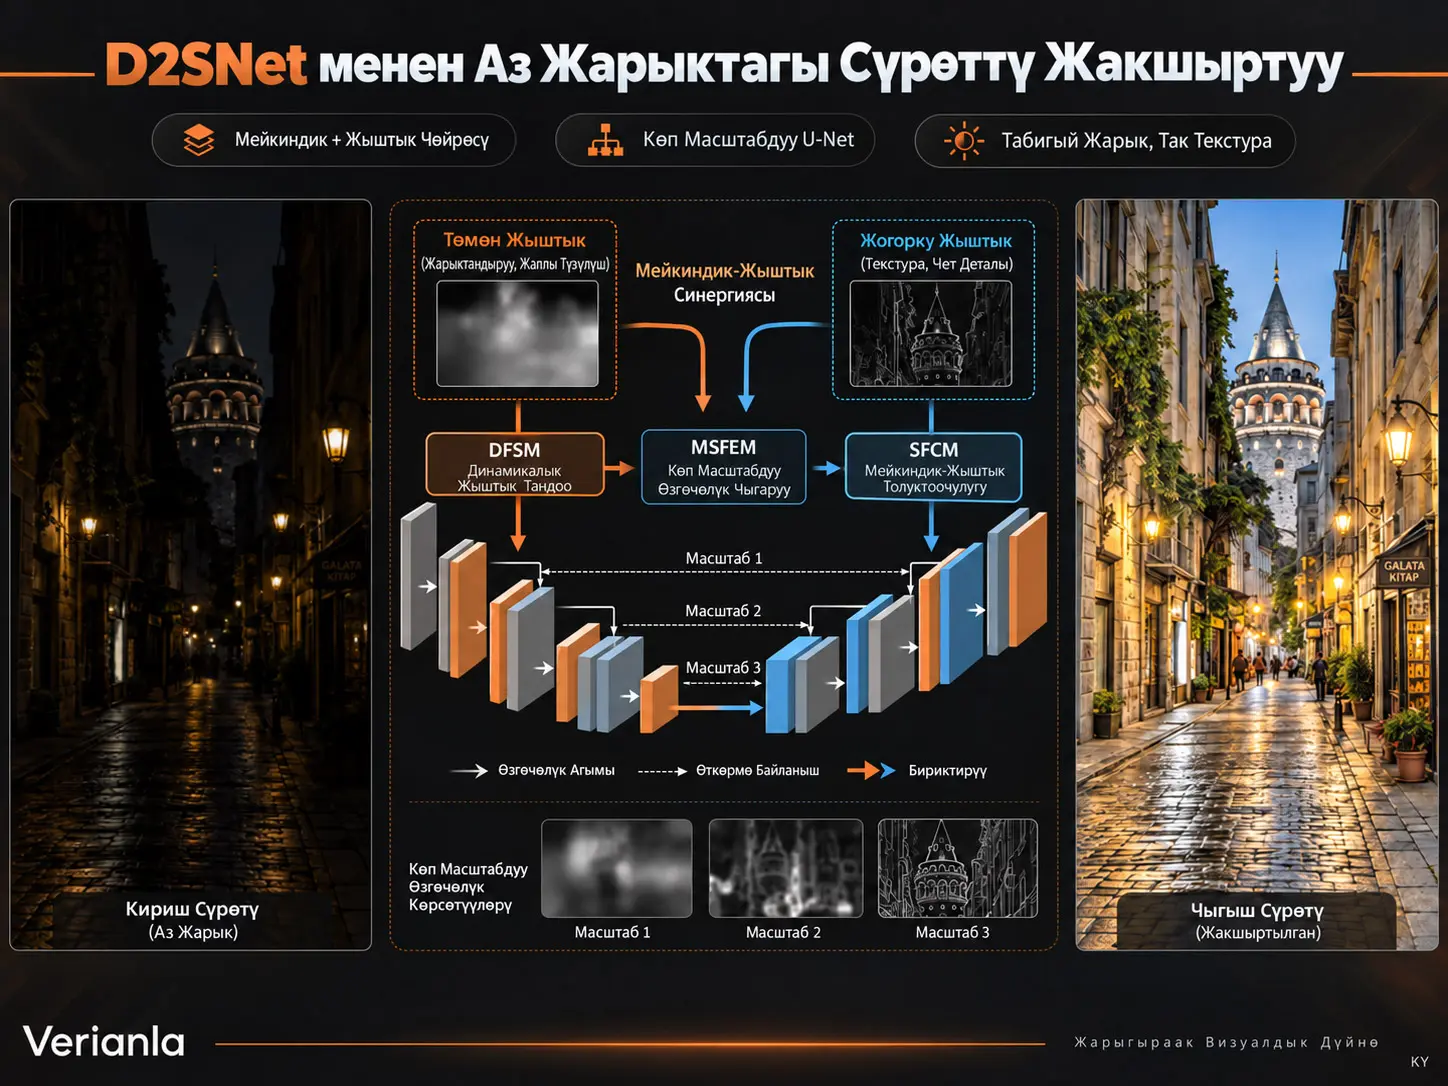
Dual-Domain Synergy Network (D2SNet) — аз жарыктагы сүрөттү жакшыртуу маселесинде сүрөттүн мейкиндик түзүмү менен жыштык компоненттерин көп масштабдуу U-Net ичинде бирге иштеткен терең үйрөнүү архитектурасы. Моделдин негизги максаты сүрөттү жөн гана жарыктандыруу эмес; жарыктандыруу оңдолуп жатканда ызы-чуунун керексиз түрдө күчөшүн чектөө, түстөрдү сактоо жана майда текстураларды кайра калыбына келтирүү. D2SNet муну Динамикалык Жыштык Тандоо Модулу (Dynamic Frequency Selection Module, DFSM), Көп Масштабдуу Белгилерди Чыгаруу Модулу (Multi-Scale Feature Extraction Module, MSFEM) жана Мейкиндик-Жыштык Толуктоочулук Модулу (Spatial-Frequency Complementarity Module, SFCM) аркылуу ишке ашырат.
DFSM туруктуу Fourier, косинус же wavelet базалары менен түз ажыратуунун ордуна кириш белгилеринен үйрөнүлгөн төмөн өткөрүүчү фильтр топторун түзөт. Бул фильтрлер төмөн жыштыктагы жана жогорку жыштыктагы белгилерди бөлөт; каналдык жана мейкиндиктик көңүл буруу механизмдери андан кийин кайсы жыштык компоненттери жакшыртуу үчүн пайдалуураак экенине салмак берет. MSFEM болсо 3 × 3, 5 × 5 жана 7 × 7 кеңейтилген depth-wise separable convolutionдарды 1 × 1 локалдык бутак менен айкалыштырып, кең контекстти да, жергиликтүү деталдарды да кармоого аракет кылат. SFCM бул эки ыкманы чакан SU-Net түзүмү аркылуу негизги U-Netтин жогорку чечилиш деңгээлине туташтырат.
Булак изилдөөдө D2SNet; LOLv1, LOLv2-Real, LOLv2-Synthetic, LOL-Blur, Sony-Total-Dark, беш жупташтырылбаган аз жарык маалымат топтому жана ExDark объект аныктоо эксперименттерин камтыган кең benchmark топтомунда бааланган. Мисалы, LOLv1де 25.09 dB PSNR жана 0.874 SSIM, LOLv2-Syntheticте 26.60 dB PSNR жана 0.947 SSIM, LOL-Blurда 27.78 dB PSNR жана 0.906 SSIM билдирилген. Модель 5.62 миллион параметр жана 256 × 256 кириш patch үчүн 36.82 G FLOPs менен иштейт.
Бул натыйжалар D2SNet изилдөөдө колдонулган маалымат топтомдору жана окутуу протоколу шартында күчтүү аз жарыкты калыбына келтирүү модели экенин көрсөтөт. Бирок натыйжалар рецензиядан өтө элек preprintтен алынган жана белгилүү benchmark натыйжалары реалдуу дүйнөдөгү бардык камера, сенсор, жарык деңгээли же бузулуу түрлөрү үчүн универсалдуу артыкчылык дегенди билдирбейт.
Изилдөө маселеси: эмне үчүн жарыкты гана күчөтүү жетишсиз?
Аз жарыкта тартылган сүрөттө маселе орточо пиксел интенсивдүүлүгүнүн төмөн болушу менен гана чектелбейт. Сенсордук ызы-чуу ачыгыраак көрүнүшү, түстөр бузулушу, локалдык контраст азайышы, майда текстуралар жоголушу жана узак экспозиция колдонулса кыймылдан же камерадан келип чыккан бүдөмүктүк пайда болушу мүмкүн. Ошондуктан жакшы аз жарык сүрөтүн жакшыртуу системасы бир жагынан глобалдык жарыктандырууну оңдосо, экинчи жагынан деталдарды сактап, ызы-чууну күчөтпөй жана табигый эмес ашыкча экспозицияланган аймактарды жаратпашы керек.
Булак изилдөө учурдагы ыкмаларды эки негизги жагынан талкуулайт. CNN жана Transformer негизиндеги ыкмалардын көбү негизинен мейкиндик чөйрөсүндө иштейт. Жыштык чөйрөсүн пайдаланган ыкмалар болсо көбүнчө FFT, DCT же DWT сыяктуу алдын ала белгиленген өзгөртүүлөрдү колдонушат. Бул туруктуу өзгөртүүлөрдүн аз жарык бузулуусунун сүрөттөн сүрөткө өзгөрүп турган түзүмүнө түздөн-түз ылайыкташа албашы D2SNetтин баштапкы чекити болуп саналат.
D2SNet Деген Эмне жана Эмне Үчүн Эки Ар Башка Чөйрөнү Бирге Колдонот?
D2SNet аз жарыктагы сүрөттүн мейкиндик түзүмүн жана төмөн-жогорку жыштык белгилерин бир эле көп масштабдуу калыбына келтирүү тармагында өз ара колдонуучу U-Net негизиндеги сүрөт жакшыртуу модели. Мейкиндик чөйрөсү объекттердин, аймактардын жана локалдык контексттин кайда жайгашканын алып жүрсө, жыштык бөлүү жайыраак өзгөргөн жарыктандыруу компоненттери менен чет, текстура жана ызы-чуу сыяктуу тезирээк өзгөргөн компоненттерди ар башкача иштетүүгө мүмкүндүк берет.
Тармактын жалпы маалымат агымы
Кириш \(3 \times H \times W\) өлчөмүндөгү аз жарыктуу RGB сүрөтү. Алгачкы 3 × 3 convolution сүрөттү \(C \times H \times W\) өлчөмүндөгү тайыз белгилер көрсөтмөсүнө айлантат. Андан кийин үч масштабдуу негизги U-Net encoder чечилишти баскычтап азайтып жатып каналдардын санын көбөйтөт. Decoder тескери багытта иштеп, encoderден келген белгилер менен skip байланыштар аркылуу биригет.
Ар бир чечилиш деңгээлинин акыркы ResBlock иштетүүсүнөн кийин DFSM колдонулат. MSFEM болсо ар бир деңгээлге туруктуу жайгаштырылбайт; SU-Net жана негизги U-Net bottleneckтеринде колдонулат. Булакка ылайык, бул тандоо көп сандагы кеңейтилген convolutionдор катары менен колдонулганда пайда болушу мүмкүн болгон үзгүлтүктүү sampling боштуктарын жана мейкиндик маалымат жоготуусун азайтууга багытталган.
Акыркы баскычта 3 × 3 convolution колдонулат жана тармактын чыгышы баштапкы аз жарыктагы сүрөт менен residual байланыш аркылуу бириктирилип, акыркы жакшыртылган сүрөт алынат.
Үч негизги модуль
| Модуль | Толук аты | Негизги милдети | Илимий ролу |
|---|---|---|---|
| DFSM | Dynamic Frequency Selection Module | Үйрөнүлүүчү фильтрлер менен жыштыкты ажыратуу жана салмактоо | Сүрөт мазмунуна жараша пайдалуу төмөн/жогорку жыштык компоненттерин тандоо |
| MSFEM | Multi-Scale Feature Extraction Module | Бир нече receptive field өлчөмүнөн мейкиндик белгилерин чыгаруу | Жыштык тандоого глобалдан локалга чейинки семантикалык контекст берүү |
| SFCM | Spatial-Frequency Complementarity Module | SU-Net, MSFEM жана DFSMди бирдиктүү иштетүү агымында бириктирүү | Жогорку чечилиш деңгээлинде мейкиндик-жыштык толуктоочулугун түзүү |
DFSM Үйрөнүлүүчү Жыштык Тандоону Кантип Аткарышат?
DFSM кириш белгилерин канал топторуна бөлөт, кириштин өзүнөн үйрөнүлгөн төмөн өткөрүүчү фильтр өзөктөрүн түзөт, төмөн жыштык компонентин фильтрлөө аркылуу чыгарат жана жогорку жыштык компонентин кириш менен төмөн жыштык компонентинин айырмасы катары түзөт; андан кийин каналдык жана мейкиндиктик көңүл буруу салмактары төмөн жана жогорку жыштыктардын чыгышка кошкон салымын динамикалык аныктайт.
FFE: жыштык компоненттерин динамикалык ажыратуу
Кириш белгилер картасы \(X \in \mathbb{R}^{C \times H \times W}\), канал огу боюнча \(g\) топко бөлүнөт:
Теңдеме (1)
\[ X=[X^{1},X^{2},\ldots,X^{g}] \]
Ар бир топтун канал саны \(C_i=C/g\) деп аныкталат. Фильтр түзүү жолу global average pooling, 1 × 1 convolution, batch normalization жана Softmax колдонулат:
Теңдеме (2)
\[ LPF=\operatorname{Softmax}\left(BN\left(Conv_{1\times1}(GAP(X))\right)\right) \]
Түзүлгөн төмөн өткөрүүчү фильтрлердин өлчөмү \(k^{2}\times g\). \(k\) фильтр өзөгүнүн өлчөмүн, \(g\) канал топторунун санын көрсөтөт. Softmax иши \(k^{2}\) өзөк элементи боюнча нормалдаштырылган салмактарды түзөт.
Теңдеме (3), булакта басылган түрүндө
\[ X^{i}_{low}= \sum_{p,q\in\mathcal{N}_{k}} \left( X^{i}(h+p,w+q)\cdot LPS^{i} \right) \]
Бул жерде \(h,w\) учурдагы мейкиндик позициясын; \(\mathcal{N}_{k}\) болсо \(k\times k\) локалдык коңшулукту билдирет. Булак текстинин түшүндүрмөсүндө тиешелүү фильтр LPF деп аталганы менен, Теңдеме (3) сүрөтүндө LPS белгиси басылган. Булак муну жазуу катасы деп ачык көрсөтпөгөндүктөн, эки белгилөөнүн ортосундагы дал келбестик бул жерде өзгөртүлбөй катталат.
Жогорку жыштык компоненти баштапкы белгиден бардык төмөн жыштык топторунун бириктирилген көрсөтмөсүн алып салуу менен алынат:
Теңдеме (4)
\[ X_{high}=X-[X^{1}_{low},X^{2}_{low},\ldots,X^{g}_{low}] \]
Бул математикалык түзүлүш маанилүү: жогорку жыштык компоненти өзүнчө туруктуу high-pass фильтр менен эсептелбестен, үйрөнүлүүчү төмөн жыштык баалоосунун калдыгы катары аныкталат.
DAGG жана кош көңүл буруу механизми
Төмөн жана жогорку жыштык белгилери алгач өз-өзүнчө 3 × 3 depth-wise convolutionдон өткөрүлөт. Андан кийин эки башка fusion жолу түзүлөт: элементтик кошуу менен \(X_{add}\), канал боюнча бириктирүү менен \(X_{con}\). \(X_{add}\), параллелдүү каналдык жана мейкиндиктик көңүл буруу жолдорунан турган Dual Attention Moduleга жөнөтүлөт.
Теңдеме (5)
\[ W_{ca}=Conv_{1\times1}\left( ReLU\left( Conv_{1\times1}(GAP(X_{add})) \right) \right) \]
\(W_{ca}\in\mathbb{R}^{C\times1\times1}\) кайсы белги каналдары жакшыртуу үчүн маанилүүрөөк экенин салмактаган каналдык көңүл буруу мүчөсү.
Теңдеме (6)
\[ W_{sa}=Conv_{7\times7}\left( [GAP(X_{add}),GMP(X_{add})] \right) \]
\(W_{sa}\in\mathbb{R}^{1\times H\times W}\) мейкиндик аймактарынын арасында салмак бөлүштүрүүнү түзөт. Булак түшүндүрмөсүнө ылайык, максат көбүрөөк бузулган аймактарга көбүрөөк көңүл буруу.
Каналдык жана мейкиндиктик салмактар бириктирилип, Sigmoid аркылуу \(W_{casa}\) түзүлөт. Эки fusion жолунун биригиши төмөнкүдөй:
Теңдеме (7)
\[ X_{fuse}= W_{casa}\cdot X_{add} + (1-W_{casa})\cdot Conv_{1\times1}(X_{con}) \]
Андан кийин төмөн жана жогорку жыштык компоненттерине тиешелүү нормалдаштырылган салмактар алынат:
Теңдеме (8)
\[ W_{low},W_{high} = Split\left( Softmax(GAP(X_{fuse})) \right) \]
DFSM чыгышы:
Теңдеме (9)
\[ X_{out} = W_{low}\cdot X_{low} + W_{high}\cdot X_{high} \]
Бул акыркы туюнтма DFSMдин негизги функциясын жыйынтыктайт. Модель төмөн жана жогорку жыштык белгилерин туруктуу катышта кошпойт; ар бир кириш үчүн үйрөнүлгөн салмактар менен кайра бириктирет.
MSFEM: глобалдык контекст менен локалдык деталдарды бир модулда сактоо
MSFEM кириш белгилерин алгач batch normalization, 1 × 1 point-wise convolution жана GELU активациясынан өткөрөт:
Теңдеме (10)
\[ \hat{X} = GELU\left( Conv_{1\times1}(BN(X)) \right) \]
Чоң бутакта үч параллелдүү depth-wise dilated convolution колдонулат:
Теңдеме (11)
\[ X_{k} = DWDConv_{k\times k,d=3}(\hat{X}), \qquad k\in\{3,5,7\} \]
Dilation катышы \(d=3\). Булак берген эффективдүү receptive field байланышы:
\[ k_{eff}=k+(k-1)(d-1) \]
Буга ылайык 3 × 3, 5 × 5 жана 7 × 7 өзөктөр тиешелүүлүгүнө жараша 7 × 7, 13 × 13 жана 19 × 19 эффективдүү receptive fieldге жетет. Ошентип бир гана өзөк масштабына байланып калбастан, кыска, орто жана узагыраак аралыктагы мейкиндик контекстин кармоого аракет жасалат.
Чоң бутактын чыгышы:
Теңдеме (12)
\[ X_{large} = Conv_{1\times1} \left( GELU \left( Conv_{1\times1} ([X_{3},X_{5},X_{7}]) \right) \right) \]
Кичине бутак 1 × 1 depth-wise convolution гана колдонуп локалдык маалыматты толуктайт:
Теңдеме (13)
\[ X_{small} = Conv_{1\times1} \left( GELU \left( DWConv_{1\times1}(\hat{X}) \right) \right) \]
MSFEMдин көңүл буруучу дизайн тандоосу — модул бардык деңгээлдерде катары менен колдонулбайт. Булак кеңейтилген convolutionдорду көп сандагы удаалаш масштабдарда колдонуу үзгүлтүктүү үлгү алынган пикселдерди жана мейкиндик маалымат жоготуусун жаратышы мүмкүн экенин айтып, MSFEMди SU-Net жана негизги U-Net bottleneckтерине гана жайгаштырат.
SFCM жана кичине U-Netтин жайгашуусу
SFCM \(C\times H\times W\) киришин адегенде эки 3 × 3 convolution жана ReLU камтыган ResBlock менен иштетет. Андан кийин белгилер kernel=2 жана stride=2 depth-wise convolution аркылуу \(C\times H/2\times W/2\) өлчөмүнө түшүрүлүп, MSFEMге жөнөтүлөт. Bilinear interpolation аркылуу кайра баштапкы чечилишке чыгарылгандан кийин DFSM колдонулат жана тайыз белгилер менен skip байланышы түзүлөт.
Бул түзүм негизги U-Netтин эң жогорку чечилишиндеги биринчи масштабында гана колдонулган. Ablation натыйжалары SU-Netти экинчи жана үчүнчү масштабдарга да кошуу FLOPsту азайтса да, PSNRды төмөндөтөрүн көрсөтөт. Бул табылга төмөн чечилиш деңгээлдеринде жаңы downsampling процесси пайдалуу мейкиндик деталдарын жоготушу мүмкүн деген түшүндүрмө менен байланышкан.
Жоготуу функциясы
D2SNetти окутууда мейкиндик чөйрөсү жана жыштык чөйрөсү үчүн тең \(L_{1}\) жоготуусу колдонулат.
Теңдеме (14)
\[ L_{spatial} = \|Pred-GT\|_{1} \]
Бул жерде \(Pred\) тармак чыгарган сүрөттү, \(GT\) болсо эталон нормалдуу жарык сүрөтүн көрсөтөт.
Теңдеме (15)
\[ L_{frequency} = \|F(Pred)-F(GT)\|_{1} \]
\(F\) тез Fourier өзгөртүүсүн (FFT) билдирет. Бул жыштык жоготуусу божомолдонгон сүрөт менен эталон сүрөттүн жыштык көрсөтмөлөрүн бири-бирине жакындатууга багытталган.
Теңдеме (16)
\[ L = L_{spatial} + \lambda L_{frequency} \]
Изилдөөдө \(\lambda=0.2\) тандалган. Демек жалпы оптималдаштыруу мейкиндик кайра куруу катасын негизги компонент катары сактап, жыштык чөйрөсүнүн шайкештигине кошумча салмак берет.
Баалоо метрикалары эмнени өлчөйт?
PSNR пиксел деңгээлиндеги кайра куруу катасы менен байланышкан сапат өлчөмү жана бул изилдөөдө жогорку маани жакшы деп эсептелет. SSIM түзүмдүк окшоштукту өлчөйт жана мында да жогорку маани жакшы. LPIPS терең белгилер мейкиндигиндеги кабылдоо айырмасын баалайт; төмөн маани жакшы. Эталон сүрөтү жок маалымат топтомдорунда BRISQUE жана NIQE колдонулган жана экөөндө тең төмөн маани артык.
Изилдөөнүн Ыкмасы жана Натыйжалары
Маалымат топтомдору
Негизги жупташтырылган баалоолордо LOLv1, LOLv2-Real жана LOLv2-Synthetic колдонулган. LOLv1де 485 аз/нормалдуу жарык сүрөт жубу окутууга, 15 жуп тестке бөлүнгөн. LOLv2-Real окутуу:test катышы 689:100, LOLv2-Synthetic катышы 900:100.
LOL-Blur маалымат топтому 200 көрүнүштөн түзүлгөн 12.000 аз-жарык/бүдөмүк жана жогорку-курчтук сүрөт жубунан турат; 10.200 жуп окутууга, 1.800 жуп тестке колдонулган. Sony-Total-Dark бөлүмүндө 2.697 кыска жана узак экспозициялуу RAW сүрөт жубу бар; 2.099 жуп окутууга, 598 жуп тестке колдонулган.
Эталон сүрөтү жок жалпылоо эксперименттери DICM, LIME, MEF, NPE жана VV үстүндө жүргүзүлгөн. Мындан тышкары, аз жарыкты жакшыртуунун жогорку деңгээлдеги компьютердик көрүү милдетине таасирин баалоо үчүн ExDark объект аныктоо маалымат топтому колдонулган.
Окутуу жана ишке ашыруу деталдары
| Параметр | Булакта колдонулган маани |
|---|---|
| Фреймворк | PyTorch |
| Жабдык | Бир NVIDIA A100 GPU |
| Optimizer | Adam |
| \(\beta_1\) | 0.9 |
| \(\beta_2\) | 0.999 |
| \(\epsilon\) | \(1\times10^{-8}\) |
| Баштапкы learning rate | \(1\times10^{-3}\) же \(1.2\times10^{-3}\) |
| Акыркы learning rate | \(5\times10^{-7}\) |
| Learning rate графиги | Cosine annealing |
| Batch size | 32 |
| Patch size | 256 × 256 |
| DFSM фильтр өзөктөрү | 3 × 3 жана 5 × 5 |
| FFE топ саны | 8 |
| LOLv1 / LOLv2 окутуу мөөнөтү | 2.500 epoch |
| LOL-Blur окутуу мөөнөтү | 1.500 epoch |
| Sony-Total-Dark | LOL-Blur менен бирдей негизги параметр жөндөөлөрү |
Негизги жупташтырылган benchmark натыйжалары
| Маалымат топтому | PSNR | SSIM | LPIPS |
|---|---|---|---|
| LOLv1 | 25.09 dB | 0.874 | 0.082 |
| LOLv2-Real | 23.80 dB | 0.877 | 0.076 |
| LOLv2-Synthetic | 26.60 dB | 0.947 | 0.027 |
| LOL-Blur | 27.78 dB | 0.906 | 0.075 |
| Sony-Total-Dark | 21.70 dB | 0.676 | 0.387 |
D2SNetтин эсептөө көлөмү булак таблицаларында 5.62 миллион параметр жана 36.82 G FLOPs деп берилет. LOLv1де модель 25.09 dB PSNR менен Diff-Retinex++тын 24.67 dB маанисинен 0.42 dB жогору болгон. LOLv2-Syntheticте D2SNet 26.60 dB PSNR, 0.947 SSIM жана 0.027 LPIPS алган.
LOLv2-Real үчүн D2SNetтин 23.80 dB PSNR жана 0.877 SSIM маанилери булак Таблица 1-деги эң жогорку маанилер. Бирок LPIPS мааниси 0.076, ал эми ошол эле таблицада CWNet үчүн 0.063 билдирилген. Ошондуктан булак текстиндеги “PSNR, SSIM жана LPIPSтин баарында эң мыкты” деген билдирүү таблицанын LPIPS тилкеси менен шайкеш эмес.
LOL-Blur: жакшыртуу жана бүдөмүктүктү азайтуу бирге
LOL-Blur экспериментинде D2SNet 27.78 dB PSNR, 0.906 SSIM жана 0.075 LPIPS чыгарган. Булак Таблица 2-де бул үч маани тизмедеги башка end-to-end жана ырааттуу ыкмалардан жакшыраак көрүнөт. Моделдин 36.82 G FLOPs эсептөө чыгымы айрым оорураак ыкмалардан кыйла төмөн болгону менен, салыштырылган эң жеңил модель эмес.
Булактын сапаттык салыштырууларында D2SNet чыгыштарында түстү калыбына келтирүү, деталдарды сактоо жана бүдөмүктүктү азайтуу баса белгиленет. Бул визуалдык мисалдар менен колдоого алынган; бирок сапаттык мисалдардын тандалышы бардык мүмкүн болгон көрүнүштөрдү өкүлдүк кылган көз карандысыз колдонуучу изилдөөсү эмес.
Sony-Total-Dark: өтө караңгы RAW сүрөттөр
Sony-Total-Dark үстүндө D2SNet 21.70 dB PSNR, 0.676 SSIM жана 0.387 LPIPS алган. Булак салыштыруусунда LEDNet тиешелүүлүгүнө жараша 20.83 dB, 0.648 жана 0.471 маанилерине ээ. Бул эксперимент архитектура стандарттуу LOL сүрөттөрүндө гана эмес, өтө төмөн экспозициялуу RAW маалыматтарында да бааланганын көрсөтөт.
Эталон сүрөтү жок маалымат топтомдору
| Маалымат топтому | BRISQUE | NIQE |
|---|---|---|
| DICM | 18.16 | 3.77 |
| LIME | 14.63 | 3.66 |
| MEF | 13.22 | 3.38 |
| NPE | 13.21 | 4.01 |
| VV | 18.54 | 2.80 |
LIME, MEF жана VV үстүндө D2SNet күчтүү маанилерди көрсөтөт. DICMде BRISQUE 18.16 менен булак таблицасындагы эң төмөн маани; NIQE 3.77 болсо DarkIRдын 3.76 маанисинен өтө аз жогору. NPEде D2SNetтин 13.21 BRISQUE мааниси DarkIRдын 12.88 маанисинен, 4.01 NIQE мааниси болсо CIDNetтин 3.74 маанисинен жогору. Ошондуктан натыйжаларды “бардык жупташтырылбаган маалымат топтомдорунда жана бардык метрикаларда эң мыкты” деп чечмелөөгө болбойт.
Ablation Эксперименттери D2SNetтин Кайсы Компоненттеринин Салымын Көрсөтөт?
Булак ablationдары эң чоң жалгыз модул салымы DFSMден келгенин, MSFEM кошумча пайда бергенин жана SU-Netти эң жогорку чечилиш масштабында гана колдонуу иштөө-эсептөө балансы жагынан ылайыктуураак экенин көрсөтөт; толук түзүм LOLv1 үстүндө 25.09 dB PSNR жана 0.874 SSIMге жеткен.
Негизги модулдардын салымы
Базалык тармак 20.19 dB PSNR жана 0.815 SSIM чыгарган. Негизги U-Net bottleneckине MSFEM кошулганда PSNR 21.06 dBге көтөрүлгөн, ал эми DFSM тиешелүү масштабдарда колдонулганда 23.68 dBге жеткен. Булак авторлору муну DFSM үчүн базалык деңгээлге салыштырмалуу 3.49 dB PSNR өсүшү деп билдирет.
SU-Netти биринчи масштабга кошкондо PSNR 23.74 dB болгон, FLOPs болсо 38.13 Gден 35.01 Gге түшкөн. Кийинки MSFEM жайгаштыруулары менен толук тармак 25.09 dB PSNR, 0.874 SSIM, 5.62 M параметр жана 36.82 G FLOPs маанисине жеткен.
Эмне үчүн бир гана SU-Net?
| SU-Net саны | PSNR | SSIM | FLOPs |
|---|---|---|---|
| 0 | 23.68 | 0.858 | 38.13 G |
| 1 | 23.74 | 0.858 | 35.01 G |
| 2 | 23.42 | 0.850 | 31.89 G |
| 3 | 23.27 | 0.850 | 28.77 G |
SU-Net саны көбөйгөн сайын эсептөө азайганы менен сүрөт сапаты төмөндөйт. Булактын түшүндүрмөсү боюнча төмөн чечилиш катмарларында кошумча downsampling кайтарылгыс мейкиндик детал жоготуусуна алып келиши мүмкүн.
FFE топ саны
FFE үчүн \(g=2\) жана \(g=4\) учурларында PSNR 23.57 dB, \(g=8\) учурунда 23.68 dB, \(g=16\) учурунда 23.48 dB. Ошондуктан акыркы моделде 8 топ тандалган. Булак 16 топтогу төмөндөөнү мүмкүн болгон overfitting менен байланыштырат; бул түшүндүрмө түздөн-түз далилденген механизм эмес, автордук интерпретация.
Үйрөнүлүүчү фильтр жана көңүл буруу дизайны
FFE салыштыруусунда Gaussian фильтр 23.22 dB, Wavelet фильтр 23.21 dB жана үйрөнүлүүчү төмөн өткөрүүчү фильтр 23.68 dB PSNR берген. DAGG жагында CBAM менен 23.19 dB, изилдөөнүн DAM түзүмү менен 23.68 dB алынган. Ошентип булак эксперименттери мазмунга ылайыкташкан жыштык ажыратуу да, колдонулган параллелдүү кош көңүл буруу механизми да тандалган benchmarkда салым бергенин көрсөтөт.
MSFEM масштабдарынын салымы
Үч параллелдүү 3 × 3 DWDConv 20.34 dB, үч параллелдүү 5 × 5 түзүм 20.56 dB, үч параллелдүү 7 × 7 түзүм 20.64 dB PSNR берген. Көп масштабдуу Large Branch 20.81 dBге, Large Branch менен Small Branchти бирге колдонуу 21.06 dBге жеткен. Кичине бутакты кошуу 0.19 dB PSNR пайда алып келип, булак таблицасына ылайык болгону 0.07 G кошумча FLOPs талап кылган.
ExDark объект аныктоо колдонмосу
Изилдөө сүрөттү жакшыртуунун визуалдык сапат метрикасына гана эмес, кийинки компьютердик көрүү милдетине таасирин да сынаган. ExDark маалымат топтомундагы 7.363 сүрөт 5.890 окутуу, 737 валидация жана 736 тест сүрөтү болуп бөлүнгөн. Сүрөттөр LOLv2-Synthetic үстүндө окутулган D2SNet модели менен жакшыртылгандан кийин YOLO-V5 объект детектору колдонулган.
D2SNet алдын ала иштетүүсү менен булак Таблица 10-до жалпы mAP 73.6 деп билдирилген. Экинчи эң жогорку орточо маани SRENet үчүн 67.9; айырма 5.7 упай. “Dog” категориясында D2SNet 80.0, Diff-Retinex++ 72.8 ге жетип, айырма 7.2 упай болгон. Булак Сүрөт 9-дагы мисалдардын биринде аз жарык сүрөтүндө аныкталбаган кайык D2SNet жакшыртуусунан кийин YOLO-V5 тарабынан 0.82 ишеним упайы менен аныкталган.
D2SNet Натыйжаларын Кантип Түшүндүрүү Керек?
D2SNet натыйжалары изилдөөдө колдонулган benchmark маалымат топтомдору жана окутуу жөндөөлөрү шартында мейкиндик-жыштык синергиясы күчтүү калыбына келтирүү ыкмасы болушу мүмкүн экенин колдойт; бирок preprint статусу, маалымат топтомдорунун чектелген камтуусу жана айрым текст-таблица дал келбестиктери натыйжаларды бардык реалдуу камера системалары же бардык аз жарык шарттары үчүн абсолюттук жана универсалдуу артыкчылык деп айтууга жол бербейт.
Изилдөө колдогон жыйынтыктар
Булак эксперименттери DFSM күчтүү ablation салымын бергенин, MSFEM ар башка receptive field масштабдарын бириктиргенде бир масштабдуу версиялардан жогору PSNR алганын жана эң жогорку чечилиш деңгээлине жайгаштырылган жалгыз SU-Net эсептөө чыгымы менен сапаттын ортосунда жакшыраак баланс түзгөнүн көрсөтөт. D2SNet ошондой эле жупташтырылган, жупташтырылбаган, бүдөмүк жана өтө караңгы маалымат топтомдорунда сыналган; ExDark эксперименти аркылуу объект аныктоо алдын ала иштетүүсүнө тийгизген таасири да бааланган.
Изилдөө колдобогон жалпылоолор
Изилдөө D2SNet бардык камера сенсорлорунда, бардык ызы-чуу моделдеринде, бардык жарык деңгээлдеринде же реалдуу убакыттагы embedded түзмөктөрдө бирдей натыйжа берет деп далилдебейт. Булак белгилүү мобилдик түзмөк, edge accelerator же реалдуу убакыттагы өнөр жай системасында latency өлчөөсүн билдирбейт. Мындан тышкары benchmark сүрөт метрикаларындагы жакшыртуу ар бир визуалдык кабылдоо же коопсуздук-критикалык компьютердик көрүү милдетинде ошол эле көлөмдө пайда болот дегенди билдирбейт.
Булак жана Ыкма Эскертүүсү
Түпнуска аталышы: D2SNet: Dual-domain Synergy Network for Low-Light Image Enhancement
Авторлор: Feng Huang; Jing Guo; Jing Wu; Jiong Huang.
Авторлордун ирети: Feng Huang → Jing Guo → Jing Wu → Jiong Huang.
Мекеме: SSRN расмий жазуусуна ылайык төрт автор тең Fuzhou University менен байланышкан.
Байланыш автору: SSRN жазуусунда Jing Guo “Contact Author” деп көрсөтүлгөн. PDFтин көрүнгөн версиясында өзүнчө corresponding-author белгиси берилген эмес.
DOI: 10.2139/ssrn.7003581
Платформа: SSRN.
Расмий жазуу:SSRN Abstract 7003581
Жөнөтүү/каттоо датасы: 26 июнь 2026.
Булак түрү: Preprint изилдөө макаласы.
Рецензия абалы: Булак PDF иш рецензиядан өтпөгөнүн ачык билдирет.
Журнал/том/сан: Булакта рецензияланган журнал жарыясы, том же сан маалыматы берилбейт.
Лицензия/автордук укук: SSRN каттоо барагында укуктар сакталгандыгы жана уруксатсыз кайра пайдаланууга жол берилбестиги айтылат. Ошондуктан Verianla тексти булактагы сүрөт жана таблица дизайнын көчүрбөйт; текшериле турган илимий маалыматты, ыкманы, теңдемелерди жана натыйжаларды гана өз алдынча окутуучу түзүмдө түшүндүрөт.
Кызыкчылыктардын кагылышы: Авторлор ишке таасир этиши мүмкүн болгон белгилүү каржылык кызыкчылык же жеке мамиле жок экенин билдиришет.
Маалымат жеткиликтүүлүгү: Булак изилдөөдө колдонулган маалыматтар суроо боюнча жеткиликтүү экенин билдирет.
Каржылоо: Каралган PDFте өзүнчө каржылоо билдирүүсү жок.
CRediT/автордук салымдар: Каралган PDFте авторлор боюнча CRediT салым билдирүүсү берилген эмес.
Булак ичиндеги белгилөө дал келбестиги: Теңдеме (3) сүрөтүндө \(LPS^{i}\), тиешелүү түшүндүрмө текстинде болсо төмөн өткөрүүчү фильтр үчүн \(LPF^{i}\) жазылышы колдонулган. Булак бул айырманын себебин түшүндүрбөйт.
Булак ичиндеги натыйжа дал келбестиги: Текст LOLv2-Realда D2SNet PSNR, SSIM жана LPIPSтин үчөөндө тең эң мыкты деп айтса, Таблица 1-де CWNetтин LPIPS мааниси 0.063, D2SNetтики 0.076. LPIPS үчүн төмөн маани жакшы болгондуктан Verianla баалоосунда таблица маанилери негиз катары алынган.
Методологиялык чек: Натыйжалар үйрөнүлгөн сүрөт калыбына келтирүү моделинин тандалган benchmark маалымат топтомдорундагы көрсөткүчүнө негизделет. Рецензия, көз карандысыз кайра өндүрүү, ар башка жабдыктагы latency өлчөөлөрү жана кең талаа валидациясы бул булак тарабынан көрсөтүлгөн эмес.
Пикир калтырыңыз
E-mail дарегиңиз жарыяланбайт. Милдеттүү талаалар * менен белгиленген