

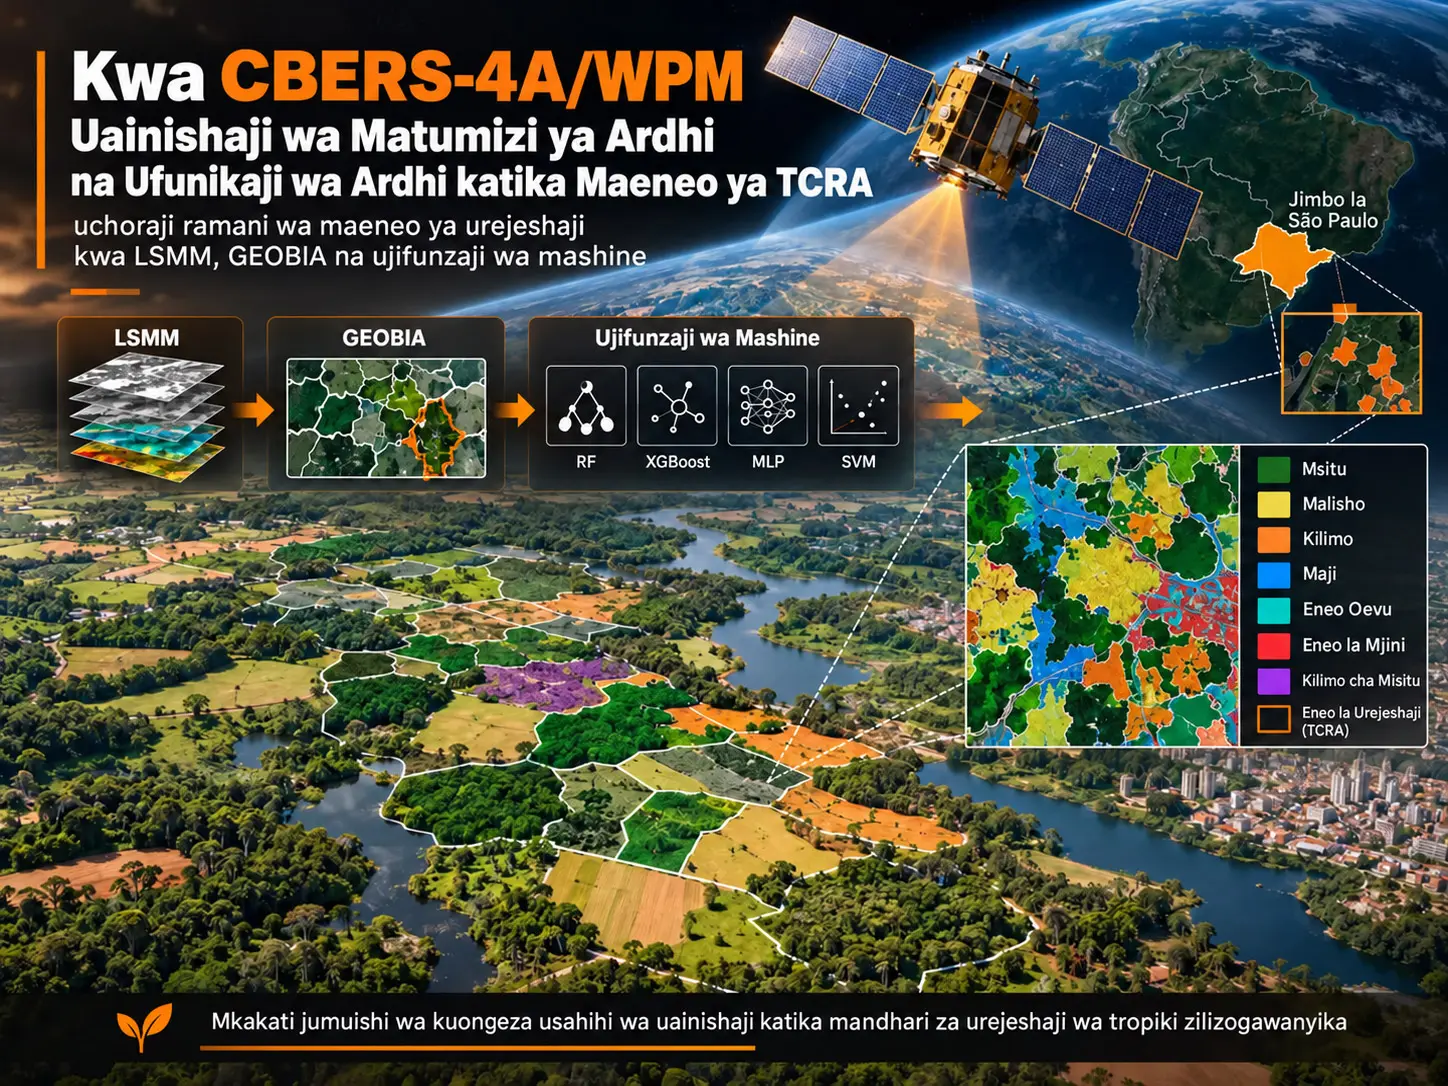
Kufuatilia maeneo ya urejeshaji wa ikolojia kwa kutumia picha za setilaiti kunaweza kuwa kugumu zaidi kuliko kuchora ramani za misitu mikubwa iliyo sawia. Hasa katika maeneo ya tropiki, vipande vidogo vya misitu, malisho, kilimo, udongo wazi, maji, maeneo oevu na nyuso za mijini vinaweza kupatikana karibu sana na kila kimoja. Pikseli moja ya setilaiti inapojumuisha nyuso kadhaa kwa wakati mmoja, mchanganyiko wa spektra unaotokea unaweza kufanya uainishaji wa kawaida wa matumizi ya ardhi na ufunikaji wa ardhi kuwa na utata.
Utafiti huu unaunganisha picha za setilaiti za CBERS-4A/WPM, Linear Spectral Mixture Model (LSMM), Geographic Object-Based Image Analysis (GEOBIA) na algoriti nne tofauti za ujifunzaji wa mashine unaosimamiwa katika mnyororo mmoja wa uchanganuzi ili kuchora ramani za maeneo ya Environmental Restoration Commitment Agreement (TCRA) katika jimbo la São Paulo, Brazili.
Eneo lililochunguzwa linajumuisha manispaa 47 na poligoni 902 za TCRA. Bendi za multispektrali za CBERS-4A/WPM zenye azimio la 8 m zilifanyiwa pan-sharpening kwa kutumia bendi ya pankromatiki ya 2 m, na hivyo kutoa picha za kazi za bendi nyingi zenye azimio la 2 m. Kisha, kwa kila kitu cha picha, pamoja na bendi ghafi za spektra, sehemu za uoto, udongo na kivuli zilihesabiwa kwa LSMM na jumla ya vipengele 63 viliundwa.
Miundo ya Random Forest, XGBoost, Multilayer Perceptron na Support Vector Machine ililinganishwa katika muundo uleule wa data. Random Forest ilifikia thamani ya juu zaidi ya overall accuracy ya takriban 0,66 katika jaribio la uteuzi wa vipengele vya Top-k. Hata hivyo, katika tathmini ya mwisho ya vipimo vingi iliyofuata katika makala, XGBoost ilionyesha utendaji wenye uwiano zaidi kwa takriban 0,41 F1 na 0,41 Kappa; RF ilitoa thamani ya juu zaidi ya precision ya takriban 0,58. Kwa kuwa matokeo ya RF=0,66 katika sehemu za Abstract na Conclusion za chanzo hayalingani kikamilifu na tofauti ya RF≈0,62 / XGB≈0,63 katika sehemu ya final comparative evaluation, miktadha hii miwili ya tathmini inapaswa kutenganishwa.
Uchambuzi wa uelezekaji wa SHAP ulionyesha kuwa hasa sehemu za uoto na kivuli zilizotokana na LSMM zilichangia kwa kiasi kikubwa katika kutenganisha madarasa. Kwa hiyo, utafiti unaonyesha kuwa katika mandhari changamano za urejeshaji, kutathmini pamoja muundo wa ndani ya pikseli, muundo wa vitu na ujifunzaji wa mashine badala ya kutumia bendi ghafi za setilaiti pekee kunaweza kutoa uwakilishi tajiri zaidi wa ardhi.
Kwa nini ni vigumu kuainisha maeneo ya urejeshaji wa tropiki kwa kutumia setilaiti?
Katika uainishaji wa utambuzi wa mbali, hali bora ni kila pikseli kuwakilisha darasa moja tu la ufunikaji wa ardhi. Hata hivyo, katika mandhari halisi za urejeshaji wa tropiki, dhana hii mara nyingi si sahihi.
Ndani au karibu na poligoni ndogo ya urejeshaji, uoto mchanga, msitu uliokomaa, malisho, kilimo, udongo wazi na barabara vinaweza kuwa karibu sana. Ishara ya sumakuumeme inayopimwa na sensa haifuati moja kwa moja mipaka ya kijiometri ya nyuso hizi; hasa katika maeneo ya mpito, pikseli moja inaweza kuwa na ishara ya pamoja ya spektra kutoka kwa vipengele kadhaa vya uso.
Tatizo hili linaitwa mixed pixel — pikseli mchanganyiko. Pikseli mchanganyiko ni hali ambapo seli moja ya picha ya kidijitali inawakilisha zaidi ya kipengele kimoja cha kimwili cha ufunikaji wa ardhi.
Kwa hiyo, mbinu ya suluhisho ya utafiti huu si ya njia moja pekee:
CBERS-4A/WPM → Pan-sharpening → LSMM → GEOBIA → Ujumuishaji wa vipengele → RF / XGBoost / MLP / SVM → Accuracy + F1 + Confusion Matrix + SHAP
TCRA ni nini?
TCRA inatumika katika makala kama kifupi cha neno Environmental Restoration Commitment Agreement. Jina lake la asili kwa Kireno ni Termos de Compromisso de Recuperação Ambiental.
Hizi ni nyenzo za kisheria nchini Brazili zinazofafanua wajibu, ratiba na mahitaji ya ufuatiliaji kuhusu urejeshaji wa maeneo yaliyoharibiwa chini ya sheria za mazingira. Lengo la utafiti si kutathmini uhalali wa kisheria wa makubaliano haya; bali ni kuchora kwa utaratibu zaidi ramani ya aina za ufunikaji wa ardhi zilizopo katika maeneo ya urejeshaji kwa kutumia picha za setilaiti.
Eneo la utafiti
Utafiti unajumuisha manispaa 47 katika jimbo la São Paulo ambako msongamano wa TCRA ni mkubwa na muundo wa mandhari ni changamano. Sehemu kubwa ya eneo iko ndani ya bioma ya Msitu wa Atlantiki; misitu asilia, malisho, maeneo ya kilimo, nyuso za mijini na hatua tofauti za urejeshaji hupatikana katika mandhari ileile.
| Sifa ya eneo la TCRA | Thamani ya chanzo |
|---|---|
| Poligoni za TCRA zilizochunguzwa | 902 |
| Eneo la chini kabisa | 0,27 ha |
| Eneo la juu kabisa | 8,76 ha |
| Eneo la wastani | 6,02 ha |
| Mkengeuko sanifu wa eneo | 1,86 ha |
| Variansi ya eneo | 3,40 ha |
Muundo huu wa maeneo madogo na yaliyogawanyika unaathiri moja kwa moja ugumu wa uainishaji. Katika poligoni ndogo, uwiano wa pikseli za mipakani huongezeka na ishara kutoka kwa madarasa jirani kama kilimo au malisho zinaweza kuathiri kipimo cha setilaiti ndani ya eneo la urejeshaji.
Picha ya CBERS-4A/WPM ilifikishwaje katika azimio la mita 2?
Sensa ya CBERS-4A/WPM hutoa njia nne za multispektrali: Blue, Green, Red na Near Infrared (NIR). Azimio lake la asili la anga ni 8 m. Sensa pia ina bendi ya pankromatiki yenye azimio la 2 m.
Katika utafiti, pan-sharpening ilitumika baada ya marekebisho ya radiometriki na kijiometri. Mchakato huu uliunganisha taarifa ya rangi/spektra ya bendi za multispektrali na maelezo ya anga yenye azimio la juu zaidi ya bendi ya pankromatiki, na hivyo kutengeneza picha za multispektrali zenye azimio la 2 m kwa ajili ya uchanganuzi.
Tofauti muhimu ya kiufundi hapa ni kwamba pan-sharpening haibadilishi kimwili kipimo cha awali cha multispektrali cha sensa kuwa kipimo kipya cha sensa ya multispektrali cha 2 m. Picha inayotolewa ni muunganiko wa data ya spektra ya 8 m na maelezo ya pankromatiki ya 2 m.
LSMM huwakilishaje kilicho ndani ya pikseli?
Linear Spectral Mixture Model huonyesha ishara ya spektra iliyopimwa ya pikseli moja kama mchanganyiko wenye uzani wa vipengele vya msingi vya uso. Kwa namna iliyorahisishwa:
\[ R_{\lambda} = \sum_{i=1}^{n} f_i r_{i,\lambda} + \varepsilon_{\lambda} \]
Hapa \(R_{\lambda}\) inawakilisha uakisi wa pikseli unaoonekana katika urefu fulani wa wimbi; \(r_{i,\lambda}\) saini ya spektra ya kipengele cha msingi cha uso; \(f_i\) uwiano wa kipengele hicho ndani ya pikseli; na \(\varepsilon_{\lambda}\) kosa baki la modeli.
Katika utafiti huu LSMM ilizalisha sehemu tatu za msingi:
| Kipengele cha LSMM | Taarifa kinachowakilisha |
|---|---|
| Vegetation fraction | Mchango wa uoto wa kijani ndani ya pikseli |
| Soil fraction | Mchango wa uso wazi/udongo |
| Shadow fraction | Kipengele cha kivuli na mwangaza mdogo |
Hivyo modeli inaweza kumpa kiainishaji si tu taarifa kwamba “pikseli hii inaonekana ya kijani”, bali pia uwiano unaokadiriwa wa vipengele tofauti vya uso ndani ya pikseli hiyo hiyo.
GEOBIA inatofautianaje na uainishaji wa pikseli?
GEOBIA — Geographic Object-Based Image Analysis — badala ya kutathmini kila pikseli kwa kujitegemea kabisa, huweka pamoja pikseli jirani na zinazofanana katika vitu vya anga.
Kwa njia hii, si tu rangi au uakisi wa pikseli bali pia taarifa kuhusu tekstcha, umbo, ujirani, usambazaji na muktadha wa kitu zinaweza kujumuishwa katika uainishaji.
Katika utafiti, Orfeo Toolbox 9.1.1 ilitumika katika mazingira ya QGIS na kwa ajili ya segmentation:
| Kigezo cha GEOBIA | Thamani |
|---|---|
| Scale | 10 |
| Shape | 0,05 |
| Compactness | 0,5 |
thamani hizo zilitumika. Uzani mdogo wa shape ulichaguliwa ili kuipa kipaumbele kufanana kwa spektra kuliko umbo la kijiometri.
Vipengele 63 viliundwaje?
Makundi manne ya awali ya spektra na makundi matatu ya sehemu za LSMM kwa pamoja yaliunda makundi saba ya msingi ya vigezo:
Blue + Green + Red + NIR + Soil + Vegetation + Shadow
Kwa kila kundi, viashiria tisa vya kitakwimu vilihesabiwa:
kiwango cha chini, kiwango cha juu, wastani, mkengeuko sanifu, p05, p25, p50, p75 na p95.
Hivyo:
\[ 7 \times 9 = 63 \]
vipengele vilizalishwa.
Uteuzi wa vipengele ulitumika kabla ya uainishaji ili kupunguza athari ya vigezo vinavyojirudia au vyenye taarifa ndogo.
Mbinu na Matokeo ya Utafiti
Ni madarasa gani ya ufunikaji wa ardhi yaliyotumika?
Mpango wa uainishaji uliundwa kwa ulinganifu na mfumo wa marejeo wa MapBiomas, na makundi makuu nane yalitathminiwa katika eneo la utafiti:
| Darasa | Maana ya msingi |
|---|---|
| Forest Formation | Miundo ya misitu asilia |
| Pasture | Malisho na maeneo yenye nyasi |
| Agriculture / Crops | Maeneo ya uzalishaji wa kilimo |
| Land Use Mosaic | Mosaiki zenye mchanganyiko wa zaidi ya aina moja ya matumizi ya ardhi |
| Urban Area | Makazi na mazingira yaliyojengwa |
| Wetlands | Maeneo oevu |
| Water | Mito, maziwa, mabwawa ya kuhifadhia maji na nyuso nyingine za maji |
| Silviculture | Mashamba ya miti / maeneo ya uzalishaji wa misitu |
Mafunzo na uthibitishaji ulifanywaje?
Data iligawanywa takriban %70 kwa mafunzo na %30 kwa uthibitishaji. Kwa kuwa idadi ya sampuli katika madarasa ya Forest Formation na Pasture ilikuwa kubwa zaidi kuliko katika madarasa ya wachache, balancing ilitumika kwenye seti ya mafunzo.
Sampuli kutoka madarasa ya Majority zilipunguzwa, huku sampuli zilizopo katika madarasa ya wachache zikihifadhiwa. Mgawo wa utofauti wa ukubwa wa sampuli kati ya madarasa ulipunguzwa kutoka 1,79 ya awali hadi 0,49 katika seti ya mafunzo iliyosawazishwa.
Seti ya uthibitishaji iliachwa ikiwa na usambazaji wa awali wa madarasa. Chaguo hili linalenga kupima jinsi modeli inavyofanya kazi chini ya muundo wa asili wa madarasa usio na uwiano.
Miundo minne ya ujifunzaji wa mashine
| Modeli | Muundo wa msingi uliotumika katika chanzo |
|---|---|
| Random Forest | Miti 500 ya maamuzi; kina cha juu kiliboreshwa wakati wa mafunzo. |
| XGBoost | Learning rate = 0,1; maximum depth = 6. |
| SVM | Radial Basis Function (RBF) kernel. |
| MLP | Safu moja iliyofichwa; neuroni 100. |
Je, Random Forest kweli ilikuwa modeli bora zaidi ya utafiti?
Kwa kuwa sehemu tofauti za chanzo zina miktadha miwili tofauti ya tathmini, jibu la neno moja halitakuwa sahihi.
Katika jaribio la uteuzi wa vipengele vya Top-k accuracy ya Random Forest ilianza karibu 0,40 wakati kipengele kimoja tu kilipotumika, ikapanda zaidi ya 0,60 karibu na vipengele 10 na kufikia kiwango cha juu cha takriban 0,66 karibu na vipengele 30. Kuongeza vipengele zaidi hakukuleta faida ya ziada iliyo wazi, na utendaji ulipungua kidogo.
Matokeo haya yanaonyesha kuwa vipengele vyote 63 havina manufaa kwa kiwango sawa; kikundi kidogo kiasi cha vipengele vyenye taarifa kinaweza kutoa sehemu kubwa ya utendaji.
Hata hivyo, katika sehemu ya final comparative evaluation ya makala, muundo ufuatao uliripotiwa:
| Modeli | Vipimo muhimu vilivyotajwa katika sehemu ya final |
|---|---|
| RF | Precision ≈ 0,58; Recall ≈ 0,33; F1 ≈ 0,38; katika maandishi ya final OA ≈ 0,62 |
| XGBoost | F1 ≈ 0,41; Kappa ≈ 0,41; Recall ≈ 0,40; OA ≈ 0,63 |
| MLP | F1 ≈ 0,40; Kappa ≈ 0,39; OA ≈ 0,63/0,62 kulingana na muktadha |
| SVM | Precision ≈ 0,24; Recall ≈ 0,43; F1 ≈ 0,14; Kappa ≈ 0,06; OA ≈ 0,10 |
Sehemu za Abstract na Conclusion za chanzo, kwa upande mwingine, zinatoa mpangilio wa overall accuracy wa RF=0,66, XGB=0,63, MLP=0,62 na SVM=0,10.
Kwa hiyo, tafsiri yenye kuaminika zaidi kwa Verianla ni kwamba RF ilitoa accuracy ya kilele cha juu zaidi chini ya uteuzi wa vipengele vya Top-k, huku XGBoost ikitoa matokeo yenye uwiano zaidi katika tathmini ya mwisho ya vipimo vingi. Nambari katika sehemu tofauti za chanzo hazifanani kikamilifu na hazipaswi kuunganishwa kimya kimya ili kuunda thamani moja mpya “sahihi”.
Kwa nini kuangalia overall accuracy pekee haitoshi?
Wakati madarasa hayana ukubwa sawa, overall accuracy inaweza kuathiriwa zaidi na mafanikio ya madarasa makubwa. Kwa mfano, Forest Formation na Pasture zimewakilishwa kwa kiwango kikubwa zaidi katika seti ya data.
Hata kama modeli inafanya vizuri katika madarasa ya wengi na vibaya katika madarasa madogo, accuracy ya jumla inaweza kuonekana kuwa ya juu kiasi. Kwa sababu hiyo, utafiti ulitathmini pamoja precision, recall, F1, Kappa, confusion matrix na vipimo vya ROC/AUC vya kila darasa.
SVM ni mfano mzuri wa tofauti hii. Recall ya takriban 0,43 si ya chini kuliko ya miundo mingine; lakini precision ni takriban 0,24 na F1 ni takriban 0,14. Hii ina maana kwamba ingawa inaweza kugundua sampuli nyingi halisi za madarasa, pia hufanya uteuzi mwingi usio sahihi wa madarasa.
Ni madarasa gani yalitenganishwa kwa urahisi zaidi?
Katika uchanganuzi wa one-vs-rest ROC wa XGBoost:
| Darasa | AUC |
|---|---|
| Water | 0,99 |
| Silviculture | 0,93 |
| Crops | 0,90 |
| Urban Area | 0,81 |
| Forest Formation | 0,79 |
| Pasture | 0,77 |
| Land Use Mosaic | 0,67 |
| Wetland | 0,67 |
Uwezo mkubwa wa kutenganisha darasa la Water una mantiki ya kifizikia; maji huonyesha tabia ya uakisi iliyo tofauti wazi na nyuso za nchi kavu katika eneo la NIR.
Katika madarasa ya Land Use Mosaic na Wetland, mipaka ya madarasa huwa na utata zaidi kwa sababu kitu kimoja kinaweza kuwa na aina nyingi za nyuso, unyevu wa udongo unaobadilika, ufunikaji wa mimea na hali za msimu.
Je, uchambuzi wa SHAP ulionyesha ujifunzaji wa mashine unaangalia nini?
Kwa ufuatiliaji wa mazingira, haitoshi kwa modeli ya ujifunzaji wa mashine kutoa tu matokeo sahihi au yasiyo sahihi. Ni muhimu pia kuelewa kwa nini vigezo vilivyotumika vinachangia katika modeli.
Kwa kusudi hili, utafiti ulitumia njia ya SHAP — SHapley Additive exPlanations.
Katika uchanganuzi wa global SHAP, vigezo vilivyotokana na LSMM vilikuwa miongoni mwa vipengele muhimu zaidi. Hasa:
LSMM_vegetation_min
kilijitokeza kama kitenganishi chenye nguvu cha madarasa.
Kwa Forest Formation, sehemu za vegetation na shadow zilikuwa muhimu, huku katika darasa la Water vipengele vya NIR vikiwa dhahiri zaidi. Katika Pasture, mchanganyiko wa sehemu za udongo na mimea ulikuwa muhimu; katika madarasa yenye utofauti mkubwa kama Urban na Wetland, mchango wa vipengele ulikuwa umetawanyika zaidi.
Kwa nini kivuli kinaweza kuwa kiashiria cha msitu?
Kwa mtazamo wa kwanza, kivuli kinaweza kuonekana kama kipengele kisichohitajika kinachoharibu uainishaji wa picha. Hata hivyo, katika misitu, kivuli kinaweza kubeba taarifa zisizo za moja kwa moja kuhusu muundo wa taji la miti, upangaji wa tabaka za wima, urefu wa miti na jiometria ya mwangaza.
Kwa hiyo, LSMM shadow fraction katika baadhi ya hali inaweza kusaidia kutenganisha msitu na madarasa kama malisho yenye ufunikaji wa mimea ulio laini na wa chini zaidi.
Kwa nini idadi ya vipengele haipaswi kuongezwa bila kikomo?
Jaribio la Top-k lilionyesha kuwa utendaji uliongezeka haraka kwa vipengele vya kwanza, ukafikia kilele karibu na vipengele 30, na baada ya hapo kuongeza vigezo vipya kulitoa manufaa kidogo sana.
Pia, uchanganuzi wa uhusiano unaonyesha kuwa vipengele vingi vilivyotokana na percentiles na takwimu tofauti za bendi ileile ya spektra vinaweza kuwa na uhusiano mkubwa kati yao.
Hali hii inaonyesha kuwa vipengele vingi zaidi havimaanishi moja kwa moja taarifa nyingi zaidi. Vigezo visivyo vya lazima au vinavyorudia taarifa vinaweza kuongeza gharama ya ukokotoaji na kuingiza kelele katika modeli.
Je, mfumo huu unathibitisha moja kwa moja mafanikio ya urejeshaji?
Hapana. Modeli ni mfumo wa uainishaji wa LULC. Kuonekana kwa poligoni ya TCRA wakati fulani kama “Forest Formation”, “Pasture” au darasa jingine hakuthibitishi peke yake kwamba malengo yote ya kiikolojia ya urejeshaji yametimizwa kwa mafanikio.
Mafanikio ya urejeshaji wa ikolojia yanaweza kuhitaji vigezo vipana zaidi kama muundo wa spishi, uotoaji upya wa asili, ubora wa makazi, kazi za mfumo wa ikolojia, hali ya udongo na maendeleo kwa muda.
Uwezo mkuu wa njia hii ni kuwezesha uchunguzi wa awali wa idadi kubwa ya maeneo ya urejeshaji kwa kiwango cha kikanda kwa haraka zaidi na kwa gharama ndogo, na kusaidia kuelekeza ukaguzi wa eneo.
Kizuizi muhimu zaidi cha utafiti
Utendaji wa modeli uliripotiwa kwa kutumia mgawanyo mmoja tu wa train-validation. Ingawa mbinu hii hutoa seti ndogo huru ya uthibitishaji, haionyeshi ni kwa kiwango gani matokeo yangebadilika data ikigawanywa kwa njia tofauti.
Waandishi wanaorodhesha kwa kazi zijazo:
- k-fold cross-validation,
- spatially stratified validation,
- picha za setilaiti za mfululizo wa muda,
- azimio la juu zaidi la anga,
- data za marejeo pana zaidi na zenye uwiano,
- mbinu mbadala za ujifunzaji wa mashine na ujifunzaji wa kina
na wanapendekeza mbinu hizi zitumike.
Kwa hiyo, thamani za accuracy na AUC katika utafiti huu hazipaswi kutumiwa moja kwa moja kama utendaji unaotarajiwa kwa miaka tofauti, mandhari tofauti za CBERS au nchi nyingine za tropiki.
Maelezo ya Chanzo na Mbinu
Kichwa asilia: CBERS 4A/WPM Image Classification for Mapping Land Use and Land Cover in TCRAs
Waandishi: Carla Rodrigues Santos; Francisco Salazar; Fernanda Beatriz Jordan Rojas Dallaqua; Bruno Schultz.
Corresponding authors: Carla Rodrigues Santos na Francisco Salazar.
Taasisi: Grupo de Pesquisa DEGET da Unemat, Sinop, Mato Grosso, Brazil; Visiona Tecnologia Espacial S.A., São José dos Campos, São Paulo, Brazil.
Jarida: Geographies.
Mchapishaji: MDPI.
Rekodi ya kibibliografia: Geographies 2026, 6, 84.
DOI:10.3390/geographies6030084
Tarehe: Iliwasilishwa 3 Juni 2026; marekebisho 16 Agosti 2026; ilikubaliwa 19 Agosti 2026; ilichapishwa 1 Septemba 2026.
Aina ya chanzo: Utafiti wa uainishaji wa matumizi ya ardhi/ufunikaji wa ardhi unaotegemea utambuzi wa mbali na ujifunzaji wa mashine unaosimamiwa.
Leseni: Creative Commons Attribution (CC BY).
Eneo la utafiti: Manispaa 47 na poligoni 902 za TCRA katika jimbo la São Paulo; hasa bioma ya Msitu wa Atlantiki.
Data ya setilaiti: CBERS-4A/WPM; bendi nne za multispektrali za 8 m + bendi ya pankromatiki ya 2 m; picha ya uchanganuzi ya 2 m baada ya pan-sharpening.
Usanifu wa vipengele: Blue, Green, Red, NIR + sehemu za LSMM soil, vegetation na shadow; jumla ya vipengele 63 kwa viashiria tisa vya kitakwimu.
Ujifunzaji wa mashine: Random Forest, XGBoost, Multilayer Perceptron na Support Vector Machine.
Uthibitishaji: Takriban %70 mafunzo / %30 validation huru; balancing katika seti ya mafunzo kulingana na kupunguza majority-class; usambazaji wa validation ulihifadhiwa.
Uelezekaji: Mchango wa vipengele kwa kiwango cha global na kwa kila darasa ulichunguzwa kwa SHAP.
Kizuizi kikuu cha kimetodolojia: Matumizi ya train-validation split moja tu na kutokuwepo kwa spatial cross-validation hupunguza uwezekano wa kujumlisha makadirio ya utendaji.
Dokezo la matokeo ndani ya chanzo: Abstract na Conclusion zinaripoti RF kama modeli yenye kiwango cha juu kwa OA≈0,66, huku sehemu ya kina ya final comparison ikitoa final OA≈0,62 kwa RF, tofauti na thamani ya kilele cha 0,66 katika jaribio la Top-k, na ≈0,63 kwa XGBoost na MLP. Sehemu hiyo hiyo inatafsiri XGBoost kuwa na uwiano zaidi kwa F1/Kappa. Maandishi haya ya Verianla hayachanganyi miktadha hii miwili.
Ufadhili: FAPESP — São Paulo Research Foundation, grant 2024/19134-1, Innovative Research in Small Business.
Upatikanaji wa data: Imeelezwa kuwa michango asilia ya utafiti imo ndani ya makala na maombi ya taarifa zaidi yanaweza kuelekezwa kwa corresponding authors.
Mgongano wa maslahi / uhusiano wa taasisi: Imeelezwa kuwa Francisco Salazar ni mfanyakazi wa Visiona Tecnologia Espacial S.A.; waandishi wengine hawakuripoti mgongano wa maslahi wa kibiashara au kifedha.
Msaada wa kiufundi: Visiona Tecnologia Espacial S.A. ilitoa msaada wa kiufundi; CETESB ilitoa mapendekezo ya kiufundi.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *