

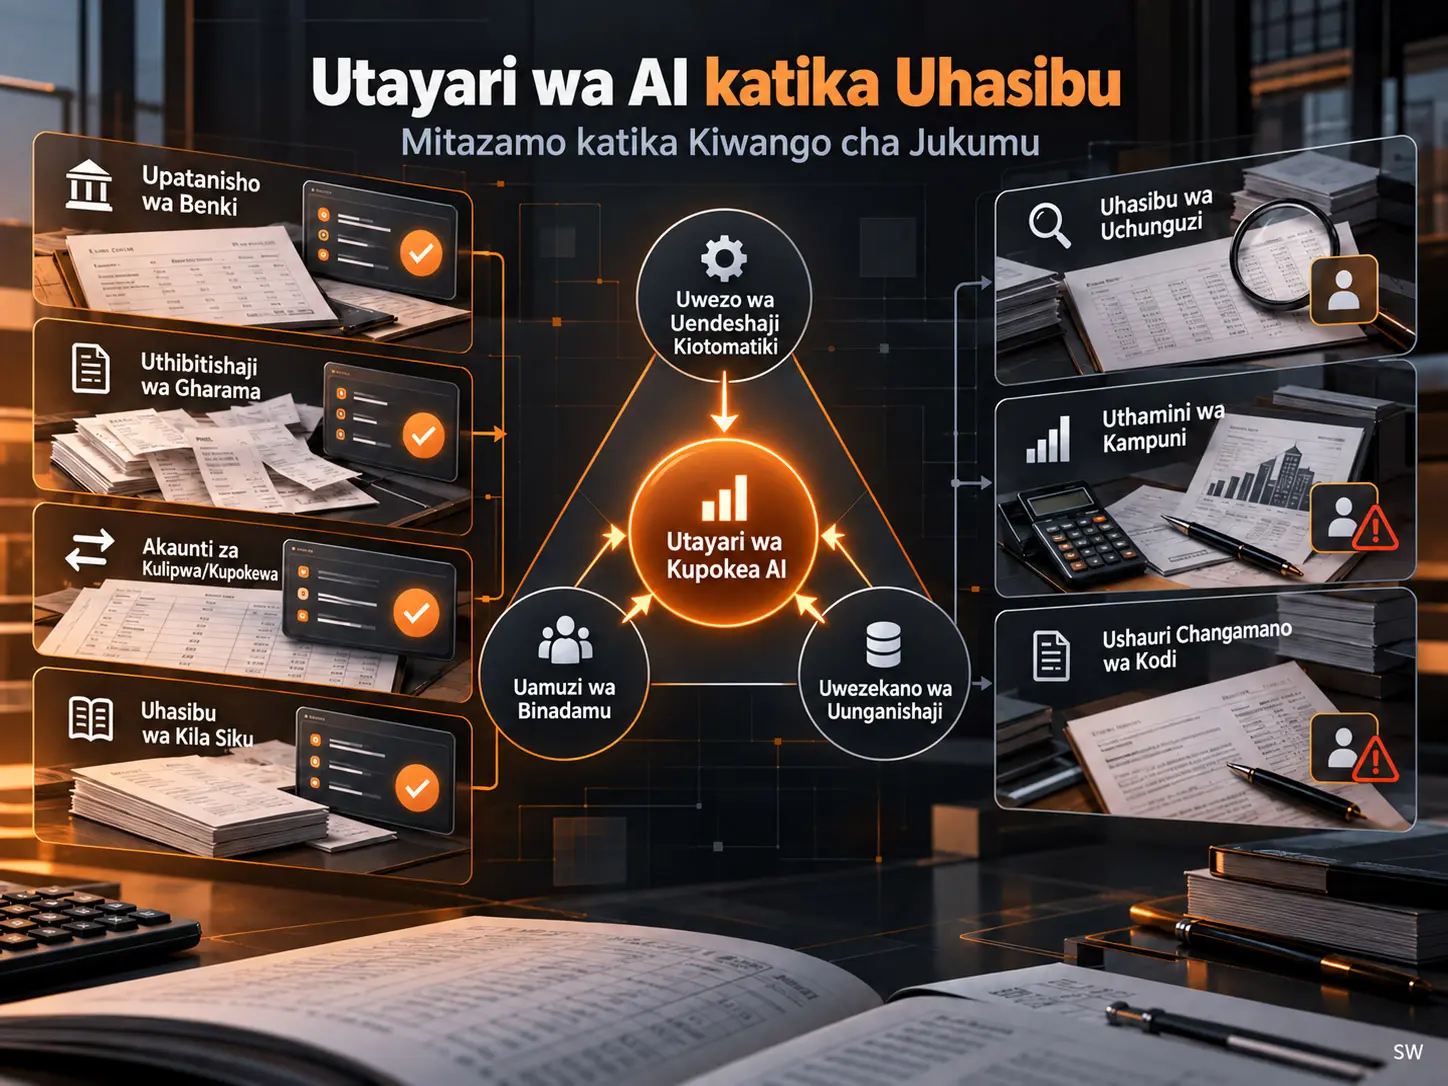
Utayari wa kupokea akili bandia katika kiwango cha jukumu (Adoption Readiness, AR) ni kipimo cha nia ya kitabia cha ngazi 1–5 kinachoonyesha kiwango ambacho mtaalamu wa uhasibu angekuwa tayari kutumia usaidizi wa AI ikiwa ungepatikana wakati wa kutekeleza kazi fulani. Utafiti wa Wil Martens unachunguza sifa za kazi zinazohusiana na utayari huu kwa kutumia uchunguzi 576 wa kiwango cha jukumu, uliotokana na wataalamu 24 wa uhasibu nchini Taiwan kutathmini kazi 24 wakilishi za uhasibu. Katika matokeo makuu ya ordered logistic regression, uwezo wa uendeshaji kiotomatiki na urahisi wa kuunganisha AI katika mtiririko wa kazi uliopo vilihusiana chanya na utayari wa juu wa kutumia AI, huku uzoefu mkubwa zaidi wa awali na mifumo ya GPT ukihusiana na utayari wa chini. Mgawo wa uhitaji wa uamuzi wa binadamu una mwelekeo hasi, lakini kwa kuwa chanzo kimeripoti p = 0,160, uhusiano huo haujathibitishwa kitakwimu.
Hoja kuu ya utafiti ni kwamba kupokelewa kwa AI katika uhasibu hakuwezi kuelezwa tu kwa kuzingatia nguvu au ufanisi wa teknolojia. Uwezo wa kukagua jukumu, kufuatilia chanzo cha matokeo, kuwepo kwa utaratibu wa reviewer sign-off, na uwezo wa kuweka matokeo ya AI katika mchakato uliopo wa udhibiti kwa namna inayoweza kutetewa pia vinahusiana na utayari wa kupokea AI. Mwandishi anajadili muundo huu katika mfumo wa task-governance fit, yaani ulinganifu kati ya jukumu na miundombinu ya utawala.
Hata hivyo, utafiti haupimi matumizi halisi ya AI, kiwango cha makosa, uokoaji wa gharama au utendaji wa kazi. Washiriki ni expert panel ndogo iliyochaguliwa kimakusudi, na kigeu cha matokeo si tabia halisi ya matumizi bali ni nia iliyoripotiwa ya kutumia. Kwa hiyo, matokeo yanapaswa kufasiriwa kama mahusiano ya kuendeleza nadharia na kuzalisha nadharia tete; hayapaswi kuonekana kuwa hitimisho madhubuti au la kisababishi kwa jumla ya wahasibu.
Tatizo kuu la utafiti
Uwezekano wa kiufundi wa kutumia mifumo ya akili bandia katika kazi za uhasibu haumaanishi kwamba wahasibu wataiamini mifumo hiyo kwa kiwango sawa. Kazi za kawaida kama upatanisho wa benki, uthibitishaji wa gharama au uchakataji wa akaunti zinazolipwa na zinazopokewa hazina kiwango sawa cha wajibu wa kitaaluma na uhasibu wa uchunguzi, uthamini wa kampuni au tathmini changamano za ukaguzi.
Kwa hiyo, utafiti unahamisha kitengo cha uchanganuzi kutoka kwa “mtumiaji” hadi “jukumu”. Badala ya kupima mtazamo wa jumla wa mtaalamu kuwa chanya au hasi kuhusu AI, unalenga swali hili: Kwa nini mtaalamu yuleyule anaweza kuwa na viwango tofauti vya utayari wa kutumia AI katika kazi mbalimbali za uhasibu?
Mikabala iliyoimarika kama Technology Acceptance Model (TAM), Unified Theory of Acceptance and Use of Technology (UTAUT) na Diffusion of Innovation kwa kawaida hulenga urahisi wa matumizi, manufaa, athari za kijamii au utayari binafsi wa kiteknolojia. Pengo la fasihi linalodaiwa na utafiti ni kwamba miundo hii haikamata vya kutosha uwezekano wa kukaguliwa, ufuatiliaji na miundo ya reviewer approval inayohusu jukumu mahususi katika taaluma zenye uwajibikaji mkubwa.
Ulinganifu wa jukumu na utawala ni nini?
Ulinganifu wa jukumu na utawala haumaanishi tu kwamba mfumo wa AI unaweza kutumika kiufundi katika jukumu fulani la kitaaluma, bali pia kwamba matokeo yake yanaweza kufuatiliwa, kuthibitishwa na kutetewa kitaaluma ndani ya michakato iliyopo ya idhini/mapitio. Katika utafiti huu, hasa kigeu cha Integration Feasibility kinawakilisha kiwango ambacho taratibu zilizopo za udhibiti kama audit trail, traceability, reviewer sign-off na approval workflow zinaunga mkono matumizi ya AI.
Tofauti hii ni muhimu. Programu ya AI iliyo rahisi kiufundi inaweza kuwa na uwezekano mdogo wa kuunganishwa ikiwa haijulikani ni nani atakayethibitisha matokeo au nani atawajibika kwa kosa. Kinyume chake, jukumu lenye maudhui changamano kama uhasibu wa uchunguzi linaweza kujumuisha nafasi ya usaidizi ya AI kwa udhibiti mkubwa zaidi kutokana na audit trail thabiti na taratibu za mapitio.
Vigeu vitano vikuu vya mtazamo
| Kigeu | Maelezo ya Kiswahili | Kipimo | Nafasi katika modeli |
|---|---|---|---|
| GPT Exposure | Uzoefu wa awali wa kitaaluma na zana za aina ya GPT | 1–5 Likert | Kigeu dhibiti |
| Automation Potential (AP) | Uwezekano wa vipengele vya jukumu kubadilishwa na AI | %0–100, kimegeuzwa kuwa makundi matano katika uchanganuzi | Kigeu kikuu cha ufafanuzi |
| Human Judgment Necessity (HJ) | Uhitaji wa uamuzi wa hiari, tafsiri ya kimaadili na uamuzi wa kitaaluma | 1–5 Likert | Kigeu kikuu cha ufafanuzi |
| Task Complexity (TC) | Upana wa eneo la maarifa na uchangamano wa muktadha wa jukumu | 1–10, kimepangwa upya hadi 1–5 katika uchanganuzi | Kigeu cha kimuktadha |
| Integration Feasibility (IC) | Uwezekano wa kuweka AI katika mchakato uliopo wa mapitio na udhibiti | Gharama ya uunganishaji 1–5; imesimbwa kinyume | Kigeu kikuu cha ufafanuzi |
| Adoption Readiness (AR) | Nia ya kutumia usaidizi wa AI katika jukumu fulani | Kipimo cha mpangilio cha 1–5 | Kigeu tegemezi |
Adoption Readiness iliulizwaje?
Kimsingi washiriki waliulizwa swali hili la nia ya kitabia: kama usaidizi wa AI ungetolewa kwa jukumu husika katika nafasi zao za sasa, wangekuwa tayari kuutumia kwa kiwango gani? Jibu lilipimwa kutoka 1 = strongly unwilling hadi 5 = strongly willing.
Kipimo hiki kinawakilisha nia ya matumizi, si tabia halisi. Mshiriki kutoa AR = 5 hakuonyeshi kwamba ametumia mfumo wa AI katika kazi halisi au kwamba mfumo ulitoa matokeo ya kuaminika.
Nadharia tete tatu kuu
H1: Automation Potential ya juu inahusiana na Adoption Readiness ya juu.
H2: Human Judgment Necessity ya juu inahusiana na Adoption Readiness ya chini.
H3: Integration Feasibility ya juu inahusiana na Adoption Readiness ya juu.
Task Complexity iliondolewa kwenye modeli kuu kwa sababu chanzo kinaeleza kuwa ina kolinearity kubwa na HJ. Katika maelezo makuu na sehemu ya uundaji modeli, sababu hii imetolewa kama r = 0,74, ilhali katika Spearman Table 3 iliyochapishwa mgawo wa HJ–TC ni 0,65. Thamani hizi mbili za chanzo zinapaswa kuripotiwa katika miktadha tofauti.
Nani alishiriki katika utafiti?
| Sifa | Mgawanyo |
|---|---|
| CPA | Watu 8 |
| Usimamizi | Watu 8 |
| Mfanyakazi wa uhasibu | Watu 4 |
| Mwalimu wa uhasibu | Watu 4 |
| Uzoefu wa miaka 0–5 | Watu 4 |
| Uzoefu wa miaka 6–20 | Watu 16 |
| Uzoefu wa miaka 20+ | Watu 4 |
| Mahojiano ya ufuatiliaji | Watu 20 |
Washiriki walitoka katika miktadha ya fedha na benki, teknolojia, ukarimu na elimu ya uhasibu. Usampulishaji ulifanywa kwa mbinu za kimakusudi na referral-based; lengo halikuwa uwakilishi wa kitakwimu wa idadi ya watu, bali kuhakikisha utofauti wa majukumu ya kitaaluma na uzoefu.
Kwa nini Taiwan ilichaguliwa?
Utafiti unatumia Taiwan kama critical case ambako uwezo wa juu wa kiteknolojia na muundo thabiti wa uwajibikaji wa kitaaluma vipo kwa pamoja. Katika mazingira ambako wahasibu wana sign-off binafsi na wajibu wa kisheria, AI inatarajiwa kutathminiwa si kwa ufanisi pekee bali pia kwa ufuatiliaji na uwezo wa kutetewa kitaaluma.
Kwa hiyo, muktadha wa nchi ni sehemu ya muundo wa utafiti; hata hivyo, matokeo hayawezi kuhamishwa moja kwa moja kwenda nchi nyingine.
Mitazamo kuhusu kazi inahusianaje?
Katika uchanganuzi wa uwiano wa Spearman, uhusiano chanya wa 0,60 uliripotiwa kati ya GPT Exposure na Automation Potential. Automation Potential ilionyesha uwiano wa −0,29 na Human Judgment Necessity, −0,33 na Task Complexity, na −0,36 na Integration Feasibility. Uwiano wa Spearman kati ya HJ na TC ni 0,65, kati ya HJ na IC ni 0,57, na kati ya TC na IC ni 0,50.
| Jozi ya vigeu | Uwiano wa Spearman |
|---|---|
| GPT Exposure – AP | 0,60*** |
| AP – HJ | −0,29*** |
| AP – TC | −0,33*** |
| AP – IC | −0,36*** |
| HJ – TC | 0,65*** |
| HJ – IC | 0,57*** |
| TC – IC | 0,50*** |
*** p < 0,001.
Muundo huu unaonyesha kwamba kazi za kawaida na zinazoweza kubadilishwa zinatofautishwa kimtazamo na kazi zinazohitaji uamuzi/uchangamano mkubwa; hata hivyo, uwiano hauonyeshi mwelekeo wa kisababishi.
Wahasibu wanaonekana tayari zaidi kutumia AI katika kazi zipi?
Matokeo makuu ya utafiti ni kwamba nia iliyoripotiwa ya kutumia AI iko juu zaidi katika kazi ambazo AI inaweza kuendesha kiotomatiki sehemu kubwa zaidi na inaweza kuunganishwa kwa urahisi zaidi katika mtiririko uliopo wa ukaguzi/mapitio. Kinyume chake, katika kazi zinazohitaji uamuzi mkubwa wa binadamu, mgawo wa utayari una mwelekeo hasi lakini haujathibitishwa kitakwimu; kwa hiyo, utafiti hauungi mkono hitimisho madhubuti kwamba “uamuzi wa binadamu unapoongezeka, AI hukataliwa”.
Kwa mfano, masasisho ya kawaida ya uhasibu, ukaguzi wa gharama za wafanyakazi na shughuli za payable/receivable zinaonekana kuwa miongoni mwa kazi zenye uwezo mkubwa wa kuendeshwa kiotomatiki; forensic accounting na business valuation zinaonyesha uchangamano mkubwa wa kazi na uhitaji mkubwa wa uamuzi wa binadamu.
Katika Appendix B, wastani wa juu zaidi wa Task Complexity ni 4,50 kwa forensic accounting na 4,17 kwa business valuation. Thamani za juu zaidi za Human Judgment Need ni 4,00 na 3,67 kwa mtiririko huo. Kwa Automation Potential, kila moja ya kazi za managing cash flow, examining expenses na payables & receivables inafikia wastani wa 4,00.
Mbinu na Matokeo ya Utafiti
Modeli kuu ya kitakwimu
Kwa kuwa kigeu tegemezi Adoption Readiness kiko katika kipimo cha mpangilio cha 1–5, modeli kuu ni ordered logistic regression. Kitengo cha uchanganuzi ni task-level rating 576. Kwa kuwa mshiriki yuleyule alitathmini kazi 24, uchunguzi haujitegemei kikamilifu; katika modeli kuu, makosa ya kawaida yalikokotolewa kwa namna ya cluster-robust katika kiwango cha respondent. respondent random intercept ilitumika katika vipimo vya ziada vya uthabiti.
| Kigeu | β | Odds Ratio | Kosa la kawaida | Tafsiri ya chanzo |
|---|---|---|---|---|
| GPT Exposure | −0,340 | 0,712 | 0,074 | p < 0,001; uhusiano hasi |
| Automation Potential | +0,476 | 1,610 | 0,086 | p < 0,001; uhusiano chanya |
| Human Judgment Necessity | −0,135 | 0,873 | 0,096 | Katika matini kuu p = 0,160; si muhimu |
| Integration Feasibility | +0,411 | 1,509 | 0,091 | p < 0,001; uhusiano chanya |
Modeli ina uchunguzi 576. Log-likelihood −899,61, AIC 1815, BIC 1850, McFadden R² 0,026 na Nagelkerke R² 0,084 zimeripotiwa. Thamani za chini za pseudo-R² zinaonekana na mwandishi kuwa zinaendana na hali ya kiuchunguzi ya utafiti na ukweli kwamba maamuzi ya kupokea AI yana sababu nyingi.
Onyo kuhusu alama ndani ya chanzo: Ingawa nyota moja imechapishwa katika safu ya HJ ya Table 5, katika sehemu hiyo hiyo imeandikwa wazi mara kadhaa kwamba p = 0,160 na kwamba uhusiano haukufikia conventional significance threshold. Kwa hiyo, H2 haipaswi kuwasilishwa kana kwamba imethibitishwa kitakwimu.
Matokeo ya odds ratio yanamaanisha nini?
Katika modeli ya ordered logit, odds ratio inaonyesha uhusiano kati ya ongezeko katika kigeu cha ufafanuzi na odds ya kuwa katika kategoria za juu za Adoption Readiness, huku vigeu vingine vikidhibitiwa. OR = 1,610 kwa AP na OR = 1,509 kwa IC zinaonyesha uhusiano kuelekea readiness ya juu, huku OR = 0,712 kwa GPT Exposure ikionyesha uhusiano kuelekea readiness ya chini; haya si athari za kisababishi.
Ukubwa wa athari ya Automation Potential
Chanzo hakikutoa mgawo pekee, bali pia kilikokotoa uwezekano wa kategoria za AR uliotabiriwa na modeli wakati vigeu vilihamishwa kutoka Q25 hadi Q75.
| Kigeu | P(AR=1), chini | P(AR=1), juu | P(AR=5), chini | P(AR=5), juu |
|---|---|---|---|---|
| Automation Potential | 0,364 | 0,181 | 0,098 | 0,219 |
| Integration Feasibility | 0,306 | 0,162 | 0,123 | 0,242 |
| GPT Exposure | 0,174 | 0,294 | 0,227 | 0,129 |
| Human Judgment Necessity | 0,207 | 0,256 | 0,191 | 0,153 |
Automation Potential inapoongezeka kutoka Q25 hadi Q75, modeli inapunguza P(AR=1) kutoka 0,364 hadi 0,181 na kuongeza P(AR=5) kutoka 0,098 hadi 0,219. Kwa Integration Feasibility, P(AR=5) inaongezeka kutoka 0,123 hadi 0,242. Uwezekano huu ni makadirio yanayotegemea modeli; si viwango halisi vya matumizi.
Kwa nini uzoefu wa GPT unaweza kuhusiana na utayari wa chini?
Mgawo wa GPT Exposure ni hasi na muhimu kitakwimu. Mwandishi anatafsiri hili kama experience-skepticism effect: uzoefu zaidi wa vitendo na modeli kubwa za lugha unaweza kuwafanya watumiaji waone kwa uhalisia zaidi mipaka ya modeli, hitaji la uthibitishaji na makosa yake.
Hata hivyo, utafiti huu haujaribu utaratibu huo moja kwa moja. Haiwezi kuhitimishwa kwamba “uzoefu zaidi wa GPT husababisha bila shaka hali ya kutilia shaka”. Mgawo hasi ni uhusiano unaoonekana katika data ya chanzo; experience-skepticism ni tafsiri ya kinadharia ya mwandishi inayolingana na uhusiano huo.
Kwa nini matokeo ya uamuzi wa binadamu yanapaswa kusomwa kwa tahadhari?
Mgawo wa Human Judgment Necessity ni hasi katika mwelekeo uliotarajiwa, lakini chanzo kinaripoti p = 0,160. Kwa hiyo, kuna ushahidi wa mwelekeo pekee lakini usio na hitimisho/inconclusive kwa H2.
Mwandishi anajadili mipaka miwili inayowezekana: athari inaweza kuwa dhaifu kweli katika sampuli hii ndogo, au uwiano mkubwa wa HJ na Task Complexity unaweza kuwa umepunguza usahihi wa mgawo huru. Pia, vipatanishi visivyopimwa kama aina ya jukumu, uzoefu wa kazi au asili ya uamuzi vinaweza kuwa na nafasi.
Mahojiano 20 ya ufuatiliaji yalitumika kwa kusudi gani?
Mahojiano ya ufuatiliaji yalitumika si kuchukua nafasi ya matokeo makuu ya kitakwimu, bali kuelewa muktadha wa kitaaluma wa vigawo. Mahojiano yalirekodiwa kwa lugha ya Mandarin na verbatim transcribe, back-translation ikatumika katika sehemu fulani, na maudhui yaliyosalia yakakaguliwa kwa mapitio ya lugha mbili.
Back-translation ilitumika kwa %29 pekee ya sehemu ndogo iliyolengwa ya transcript. Mwandishi anakubali wazi hili kuwa kizuizi cha muundo. thematic analysis kamili si matokeo makuu ya makala hii; imeelezwa kuwa imeripotiwa katika companion qualitative study.
Wasifu watatu wa majukumu
hierarchical clustering iliyotumia Ward linkage ilitoa nguzo tatu kwa kutumia thamani sanifu za GPT Exposure, AP, HJ, TC na IC. dendrogram kwenye ukurasa wa 11 inaonyesha suluhisho la nguzo tatu, na michoro ya kernel density iliyo chini yake inaonyesha tofauti katika wasifu wa vigeu vya nguzo.
| Nguzo | Wasifu mkuu | Mifano ya majukumu | Mkabala wa AI uliopendekezwa katika chanzo |
|---|---|---|---|
| Cluster 1 — Judgment-first | HJ na TC za juu; IC ya kati hadi juu | Forensic accounting, business valuation, audit leadership | Usaidizi wa mtindo wa Copilot + sign-off ya lazima ya binadamu |
| Cluster 2 — Automation-oriented | AP na GPT Exposure za juu; HJ ya chini | Uthibitishaji wa gharama, kazi za kila siku za uhasibu, payable/receivable | Eneo la kuanzia la moja kwa moja zaidi kwa kupokea AI |
| Cluster 3 — Intermediate | Kiwango cha kati kwa AP, HJ na IC | Upatanisho wa benki, uzingatiaji wa kanuni, utabiri wa kifedha | Uamuzi unategemea zaidi utawala wa kampuni na uzoefu wa kitaaluma |
Uundaji huu wa nguzo ni wa kimaelezo. Wasifu huu watatu haujathibitishwa kuwa madaraja ya asili au ya jumla ya kazi za uhasibu.
Ukaguzi wa uthabiti
Mtafiti alijaribu chaguo mbadala za upimaji kama kupanga upya asilimia za AP, kuchukulia GPT Exposure kuwa ordinal, na kusimba upya vipimo vya TC/IC, na akaripoti kuwa vigawo havikubadilika kwa kiasi kikubwa.
Vipimo vya Ordered logit na OLS vilitoa mwelekeo uleule wa jumla; makosa ya kawaida ya HC3 na nonparametric bootstrap confidence intervals yalitoa mahitimisho ya kitakwimu yanayofanana.
Katika uchanganuzi wa leave-one-respondent-out, vigawo vilibaki thabiti ndani ya kelele ya sampuli iliyotarajiwa. Miundo ya multivariate inayohusiana na ukubwa wa kampuni ilijaribiwa pia kwa permutation MANOVA iliyotumia 9999 permutation. Muundo wa nguzo tatu ulihifadhiwa kimaelezo kwa k-means na distance metrics mbadala.
Uchunguzi wa vipimo
| Kipimo | Thamani |
|---|---|
| Cronbach's α | 0,441 |
| Muda wa kujiamini wa %95 | [0,282; 0,573] |
| KMO | 0,643 |
| Bartlett χ²(10) | 274,219; p < 0,001 |
| Factor 1 eigenvalue | 2,006 |
| Utofauti ulioelezwa | 0,401 |
Mwandishi hatafsiri thamani ya chini ya Cronbach α kuwa kushindwa kwa kipimo kwa maana ya kawaida; kwa sababu AP, HJ, TC, IC na GPT Exposure ziliundwa si kama viashiria vya reflective vinavyorudia dhana moja ya latent, bali kama viashiria vya formative vinavyowakilisha sifa tofauti za kazi.
Katika uchanganuzi wa kipengele kimoja, loading ya GPT Exposure ni 0,117, AP 0,474, HJ −0,813, TC −0,780 na IC −0,706. Alama zinaonyesha mielekeo ya usimbaji wa vigeu.
Necessary Condition Analysis
Katika Necessary Condition Analysis ya kiuchunguzi, CE-FDH estimator na permutation tests zilitumika. Lengo lilikuwa kupima kama kigeu kimoja ni kizingiti cha lazima au bottleneck kwa Adoption Readiness.
Hakuna kipengele kilichofikia necessity threshold tofauti na sifuri katika viwango vya kawaida vya umuhimu. Kwa hiyo, matokeo ya chanzo hayaungi mkono madai makali ya kizingiti kama “bila IC ya juu, AI haiwezi kamwe kupokelewa” au “uzoefu wa GPT ni sharti la lazima”.
Mahitimisho yanayoungwa mkono na utafiti
- Automation Potential ya juu inahusiana chanya na AI Adoption Readiness ya juu.
- Integration Feasibility ya juu inahusiana chanya na Adoption Readiness ya juu.
- GPT Exposure ya juu inahusiana na Adoption Readiness ya chini.
- Human Judgment Necessity ina mwelekeo hasi lakini si ya uhakika kitakwimu kwa sababu p = 0,160.
- Task-level governance compatibility inaongeza thamani ya ufafanuzi zaidi ya mantiki ya ufanisi pekee katika kuelewa nia ya kupokea AI.
- Majukumu yanaweza kugawanywa katika wasifu watatu wa kimaelezo: judgment-first, automation-oriented na intermediate.
- Kazi za kawaida zinazohitaji uamuzi mdogo zinaonekana kuwa maeneo yaliyo wazi zaidi ya kuanzia kwa matumizi ya AI.
Mahitimisho yasiyoungwa mkono na utafiti
- Haijapimwa kama AI huongeza utendaji wa kazi wa wahasibu.
- Haijapimwa kama AI hupunguza kiwango cha makosa au gharama.
- Tabia halisi ya washiriki ya kutumia AI haikuzingatiwa.
- Paneli ya watu 24 haiwakilishi wahasibu wote wa Taiwan au taaluma ya uhasibu duniani.
- Haijathibitishwa kwamba uzoefu wa GPT husababisha kwa njia ya kisababishi hali ya kutilia shaka.
- Haijaonyeshwa kitakwimu kwamba uhitaji wa uamuzi wa binadamu hupunguza kwa uhakika kupokelewa kwa AI.
- cluster tatu si kategoria za jumla za kazi za uhasibu.
- Haiwezi kuhakikishwa kwamba mahusiano yaleyale yatatokea katika nchi zenye miundo tofauti ya udhibiti na uwajibikaji.
Vikwazo
Kikwazo muhimu zaidi ni muundo wa purposive expert-panel wa watu 24. Ingawa jumla ya uchunguzi 576 wa kiwango cha jukumu inaweza kuonekana kuwa kubwa, hii ni tathmini za kurudiwa za watu 24 pekee. Kwa hiyo, itakuwa makosa kufasiri uchunguzi 576 kama wataalamu 576 wanaojitegemea.
Kigeu cha matokeo si matumizi halisi bali self-reported behavioral intention. Ingawa kipimo cha AR cha kipengele kimoja kinaweza kutumika kama proxy katika fasihi ya technology acceptance, hakipimi tofauti vipengele vya kihisia, kiutambuzi na kitabia vya muundo huo.
Data ni ya sehemu-mtambuka na ya kimtazamo; mwelekeo wa kisababishi hauwezi kubainishwa. Uwezekano mkubwa wa uunganishaji unaweza kuongeza utayari wa AI, au washiriki walio wazi zaidi kwa AI wanaweza kuona uunganishaji wa kazi fulani kuwa rahisi zaidi.
Mahojiano yanatoa ufafanuzi wa kimuktadha, lakini uchanganuzi kamili wa ubora haujaripotiwa katika makala hii. Aidha, matumizi ya back-translation katika %29 pekee ya transcript yanapunguza wigo wa uthibitishaji wa lugha.
Mwandishi anapendekeza confirmatory surveys pana, miundo ya longitudinal, ulinganisho kati ya accountability regimes tofauti, na tafiti zinazoweza kutenganisha kama uhusiano kati ya GPT Exposure na readiness ya chini ni experience-based skepticism au athari ya cohort/mpito.
Maelezo ya Chanzo na Mbinu
Kichwa asili: Task-Level Perceptions of AI Readiness Among Accounting Professionals
Mwandishi: Wil Martens.
Taasisi: College of Management, National Sun Yat-sen University, Kaohsiung 80424, Taiwan.
Jarida: Accounting and Auditing.
Mchapishaji: MDPI, Basel, Switzerland.
Rekodi ya bibliografia: 2026, Volume 2, Issue 2, Article 7.
DOI: 10.3390/accountaudit2020007
Tarehe ya kuchapishwa: 8 Mei 2026.
Tarehe za uhariri: Received 21 January 2026; Revised 1 April 2026; Accepted 20 April 2026.
Aina ya chanzo: Utafiti wa kiuchunguzi wa task-survey / expert-panel uliopitiwa na wataalamu wenza; vipimo vilivyopangwa vya mtazamo katika kiwango cha jukumu vilitumiwa pamoja na mahojiano mafupi ya kuunga mkono.
Leseni: Creative Commons Attribution (CC BY).
Sampuli: 24 accounting professional × majukumu 24 = tathmini 576 za kiwango cha jukumu; mahojiano ya ufuatiliaji na watu 20.
Kigeu kikuu cha matokeo: Adoption Readiness (AR), kipimo cha 1–5 cha ordinal behavioral-intention.
Vigeu vikuu vya ufafanuzi: Automation Potential (AP), Human Judgment Necessity (HJ), Integration Feasibility (IC); GPT Exposure ni kigeu dhibiti. Task Complexity (TC) iliondolewa kwenye modeli kuu kwa sababu ya kolinearity, lakini ilihifadhiwa katika uchanganuzi wa kimaelezo na cluster.
Mbinu kuu ya kitakwimu: Ordered logistic regression; cluster-robust standard errors katika kiwango cha respondent. Miundo ya random-intercept, OLS, HC3 standard errors, nonparametric bootstrap, leave-one-respondent-out, permutation MANOVA na mbinu mbadala za cluster zilitumika katika uchanganuzi wa Robustness.
Uundaji wa nguzo: hierarchical clustering iliyotumia Ward linkage kwa thamani sanifu za GPT, AP, HJ, TC na IC; suluhisho la cluster tatu.
Mbinu ya ziada ya kiuchunguzi: Necessary Condition Analysis iliyotumia CE-FDH estimator na permutation tests.
Ufadhili: Hakuna ufadhili wa nje.
Maadili: Utafiti ulielezwa kuwa wa minimal-risk unaohusisha data ya dodoso isiyotambulisha washiriki na mahojiano ya hiari, na ikaelezwa kuwa mapitio rasmi ya bodi ya maadili hayakuhitajika chini ya kanuni zinazotumika za kitaifa na kitaasisi.
Ridhaa baada ya kupewa taarifa: Ilipatikana kutoka kwa washiriki wote.
Upatikanaji wa data: Data haipatikani hadharani kwa sababu ya vikwazo vya kimaadili na faragha; inaweza kupatikana kupitia corresponding author kwa ombi lenye msingi.
Mgongano wa maslahi: Mwandishi ametangaza kuwa hakuna mgongano wa maslahi.
Dokezo la kitakwimu ndani ya chanzo: Ingawa alama ya nyota imechapishwa kwa Human Judgment Necessity katika Table 5, matini kuu na dokezo la jedwali vinaeleza kuwa p = 0,160 na conventional significance threshold haikufikiwa. Katika tafsiri ya Verianla, thamani bayana ya p na tafsiri ya matini ya mwandishi zimehifadhiwa.
Mpaka mkuu wa tafsiri: Matokeo ni mahusiano ya mtazamo katika kiwango cha jukumu ndani ya expert panel ndogo iliyochaguliwa kimakusudi. Hayapaswi kufasiriwa kama athari ya kisababishi, matumizi halisi, utendaji wa mfumo au kiwango cha upokeaji katika idadi ya watu.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *