

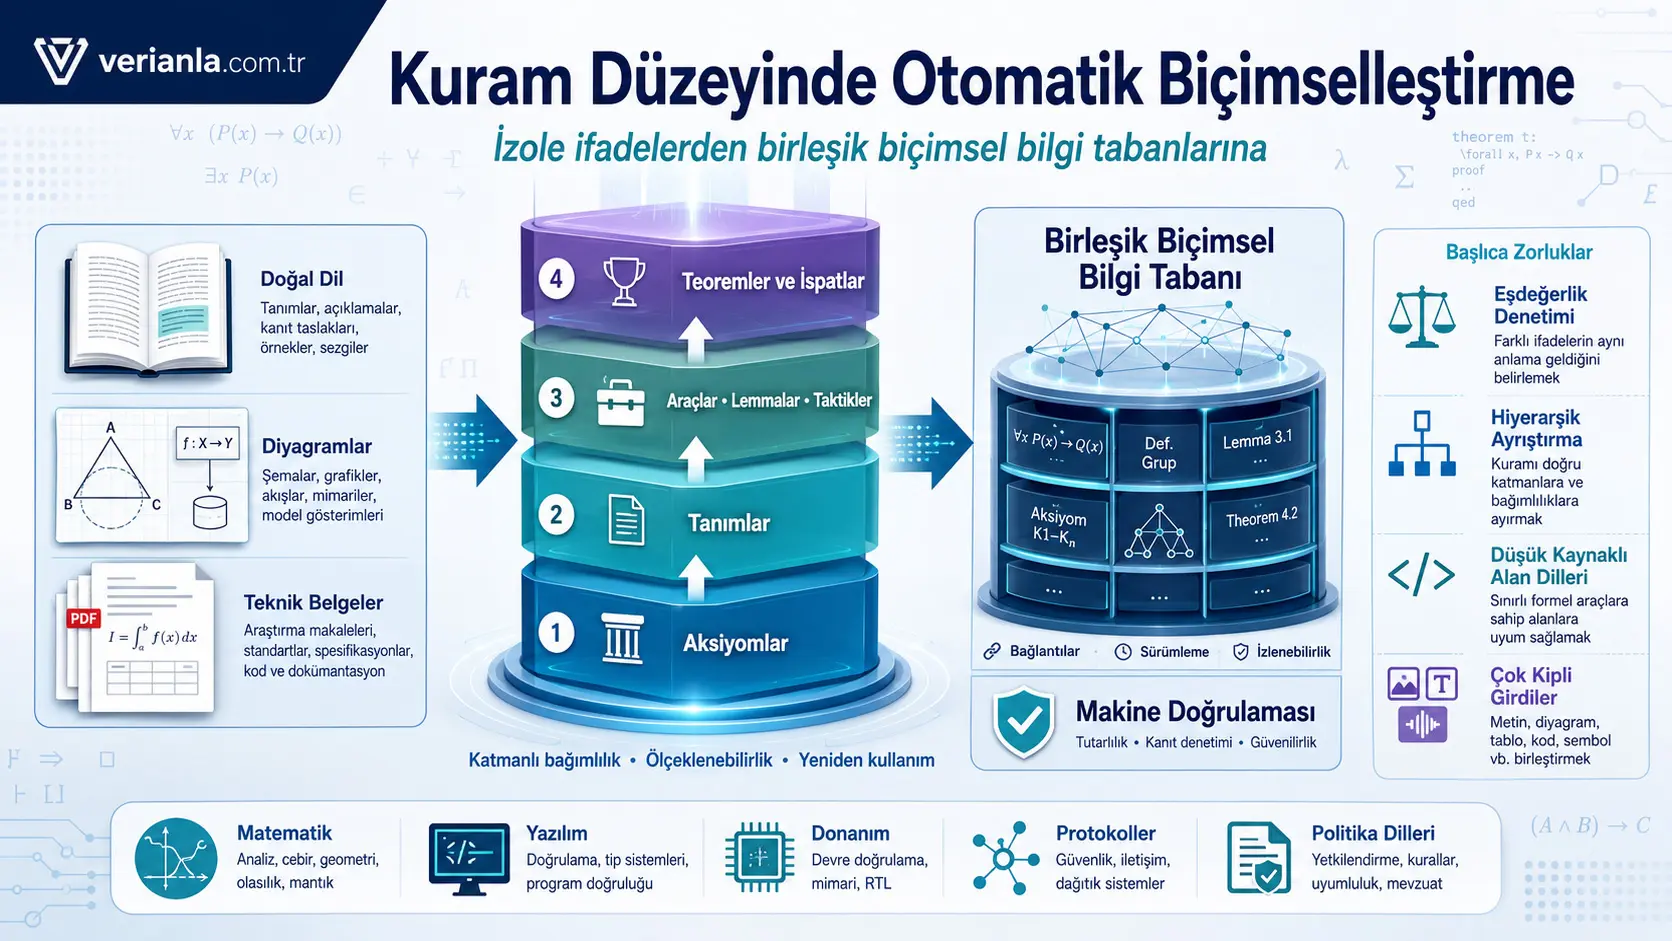
Utafiti huu unasema kwamba maarifa ya kihisabati, kisayansi na kiufundi yanayoelezwa kwa lugha asilia yanapaswa kubadilishwa kuwa muundo unaoweza kuthibitishwa na mashine si tu katika kiwango cha nadharia au kauli moja moja, bali pamoja na utegemezi wa nadharia nzima. Badala ya kutengeneza mfumo mpya wa majaribio, waandishi wanawasilisha position paper inayochunguza miradi iliyopo katika hisabati, sayansi, uthibitishaji wa programu na maunzi, fasihi ya autoformalization na matatizo ya tathmini ya eneo hili. Hoja kuu ni kwamba ili kuformalize teorema lengwa, axioms, definitions, notations, lemmas saidizi, proof tactics na utegemezi kati yao lazima kwanza vijengwe kama maktaba thabiti. Hata hivyo, utafiti hauwasilishi mfumo mpya wa mwisho hadi mwisho, seti ya data au uthibitishaji wa majaribio unaotekeleza mbinu iliyopendekezwa ya kiwango cha nadharia.
Makala inasisitiza kwamba kazi nyingi zilizopo za autoformalization hudhani kuwa tayari kuna maktaba rasmi zilizoiva. Kwa mfano, Mathlib katika mazingira ya Lean hutoa definitions na theorems nyingi saidizi mapema, hivyo kutafsiri kauli lengwa huonekana kuwa rahisi kudhibiti. Lakini katika maeneo yasiyo na miundombinu ya kutosha ya formalization, kama numerical analysis, maeneo maalum ya uhandisi, sera maalum za usalama au domain-specific languages za taasisi, tatizo kuu si kutafsiri kauli moja bali kujenga muktadha mzima wa kinadharia unaoifanya kauli hiyo iwe na maana.
Waandishi wanabainisha matatizo makuu manne mbele ya autoformalization ya kiwango cha nadharia: kuthibitisha kwa kuaminika kama formalizations zina maana sawa; kugawanya maandishi makubwa katika miundo ya utegemezi ya kihierarkia na kujifunza abstractions zinazoweza kutumiwa tena; kuzoea domain languages zenye rasilimali chache nje ya Lean; na kufasiri kwa pamoja inputs za multimodal kama maandishi, notation ya kihisabati, timing diagram, schematic au picha ya free-form. Kama suluhisho, wanapendekeza metrics za tathmini za kiwango cha nadharia, general-purpose models badala ya modeli zilizozidi kuzoea maktaba nyembamba, na common intermediate representation inayoweza kuunganisha lugha rasmi tofauti.
Autoformalization ni nini?
Autoformalization ni kubadilisha maarifa yanayotolewa kwa lugha asilia au semi-formal notation kuwa lugha rasmi inayoweza kukaguliwa na proof assistant au formal verifier. Tafsiri hii si kuandika upya sentensi kisintaksia tu. Kauli rasmi inayozalishwa lazima ihifadhi maana, assumptions, quantifiers, exceptions na dependencies za maandishi asilia.
Makala inatofautisha kazi ndogo mbili kuu:
- Statement autoformalization: Kubadilisha theorem, assumption au claim ya lugha asilia kuwa declaration rasmi.
- Proof autoformalization: Kubadilisha proof maalum ya lugha asilia kuwa proof script inayoweza kukaguliwa na mashine huku ikihifadhi muundo wake wa kimantiki.
Tofauti muhimu iliyosisitizwa katika Appendix B ni kwamba proof autoformalization si sawa na theorem proving ya jumla. Formal theorem prover inaweza kutafuta proof yoyote halali inayothibitisha kauli lengwa. Proof autoformalization, kwa upande mwingine, lazima ibaki mwaminifu kwa mkondo maalum wa mawazo katika proof ya asili ya lugha asilia. Proof mbili tofauti rasmi za theorem ile ile zinaweza kuwa sahihi; lakini ni moja tu kati yao inaweza kuwakilisha muundo wa kimantiki wa hoja ya asili inayotafsiriwa.
Autoformalization ya kiwango cha nadharia hubadilisha nini?
Kulingana na ufafanuzi wa waandishi, autoformalization ya kiwango cha nadharia ni kuunda axioms, definitions, notations, examples, lemmas saidizi, theorems, proofs, tactics na dependencies zote kati yao ndani ya upeo fulani kama maktaba moja rasmi thabiti. Mbinu hii inalenga kujenga architecture ya maarifa ambayo statements lengwa zinasimama juu yake, badala ya kutafsiri statements zilizotenganishwa.
“Theory-Level Autoformalization Tower” katika Kielelezo 2 kinaonyesha muundo wa tabaka nne kupitia Euclidean geometry:
| Tabaka | Maudhui | Kazi | Mfano wa Euclidean geometry |
|---|---|---|---|
| Tabaka 0 | Axiomatic definitions | Hufafanua objects na relations za msingi kabisa za nadharia. | Primitive types kama point na line; primitive relations kama kuwa upande mmoja au kuwa kati ya point mbili |
| Tabaka 1 | Derived definitions | Huunganisha primitive concepts kuunda objects za kihisabati zilizo changamano zaidi. | Inductive definitions kama angle; composite relations kama kuunda triangle |
| Tabaka 2 | Tools | Hurahisisha kusoma na kuthibitisha statements zinazofuata. | Notations, helper lemmas na proof tactics |
| Tabaka 3 | Targets | Hurahisisha kuonyesha theorems na proofs kuu juu ya infrastructure iliyojengwa. | Pythagorean theorem na target theorems zinazofanana |
Kulingana na matokeo yaliyonukuliwa katika makala, mojawapo ya mbinu bora zilizopo hufikia mafanikio ya %71,4 katika statements za Tabaka 3 chini ya assumption kwamba tabaka za chini tayari zimeformalizewa na binadamu. Waandishi, hata hivyo, wanasema kwamba mbinu zilizopo bado hazilengi kujenga moja kwa moja infrastructure yote ya Tabaka 0–2 kutoka mwanzo. Kwa hiyo, thamani ya %71,4 haipaswi kufasiriwa kama kiwango cha autoformalization ya nadharia nzima.
Kwa nini kutafsiri theorem moja haitoshi?
Theorem moja lengwa katika mazingira rasmi hutegemea infrastructure pana zaidi kuliko inavyoonekana. Aina ya kila object inayotumika, maana ya kila relation, notation zitakazotumika, matokeo saidizi na hatua za proof lazima ziwe zimefafanuliwa mapema. Maarifa mengi ambayo wataalamu huacha implicit katika lugha asilia lazima yaandikwe wazi katika mfumo rasmi.
Kwa mfano, mwanahisabati anaweza kuelewa kutoka kwa muktadha uhusiano wa concept ya “square” na properties za rectangle na rhombus. Katika mfumo rasmi, definitions au theorems zinazohakikisha uhusiano huu lazima ziwepo katika maktaba. Vivyo hivyo, hardware engineer anaweza kuelewa kutoka timing diagram kwamba signal inapaswa “kubaki stable kuanzia cycle inayofuata”; lakini katika formal property, operator wa “cycle inayofuata” lazima aandikwe wazi.
Kwa nini autoformalization ni muhimu?
Kuzalisha data kwa neural theorem provers
Maendeleo ya neural theorem proving systems yanategemea seti kubwa na za kuaminika za data rasmi. Kuzalisha formal counterparts za maandishi na proofs za kihisabati za lugha asilia kunaweza kuunda parallel training data kati ya lugha asilia na lugha rasmi. Statement formalization huzalisha targets mpya, wakati proof formalization hutoa proof steps zinazoweza kukaguliwa moja kwa moja.
Kuharakisha uthibitishaji wa kinadharia na kihandisi
Formal verification projects hazikagui tu theorem au mfumo wa mwisho; hujenga maktaba pana ya definitions, intermediate results na technical infrastructure. Jedwali 1 linaonyesha kwamba miradi iliyochaguliwa kutoka hisabati, sayansi, programu na maunzi ilihitaji muda na juhudi kubwa za wataalamu:
| Eneo | Mradi wa formalization | Verification tool | Mwanzo | Muda au hali iliyoripotiwa |
|---|---|---|---|---|
| Hisabati | Four Color Theorem | Coq | 2000 | Miaka 5 |
| Hisabati | Kepler Conjecture | HOL Light | 2003 | Miaka 11 |
| Hisabati | Odd Order Theorem | Coq | 2006 | Miaka 6 |
| Hisabati | Liquid Tensor Experiment | Lean | 2020 | Miaka 1,5 |
| Sayansi | Formalization ya chemical physics | Lean | 2022 | Mwaka 1 |
| Sayansi | Applied partial differential equations | HOL Light | 2022 | Inaendelea |
| Programu | CompCert | Coq | 2005 | Inaendelea |
| Programu | CertiKOS | Coq | 2010 | Inaendelea |
| Programu | Vellvm | Coq | 2012 | Inaendelea |
| Maunzi | ISA-Formal | Verilog model checkers | 2011 | Miaka 5 |
| Maunzi | CORE-V-Verif | UVM | 2019 | Inaendelea |
Ujumbe mkuu wa jedwali ni kwamba gharama kubwa katika formal verification mara nyingi si kupata proof moja, bali kujenga mtandao mzima wa definitions na helper results ambamo target inaweza kuundwa. Makala inatoa mfano kwamba formalization ya prime number theorem kwa binadamu ilichukua takribani miaka 1,5, wakati quantitative improvement iliyosaidiwa na AI iliformalizewa katika wiki tatu. Hata hivyo, upeo wa kazi hizi mbili si sawa na muda huo haupaswi kulinganishwa kama project metrics zinazolingana moja kwa moja.
Kuweka msingi na kuongoza natural-language reasoning
Reasoning inayozalishwa na large language models kwa lugha asilia inaweza kuwa na premises zisizolingana, assumptions zisizokuwepo au hatua zilizorukwa. Formal checker inaweza kubaini definitions za type isiyofaa, contradictions au hatua zisizoweza kuthibitishwa. Kwa mgawanyo unaotumiwa katika makala, “grounding” ni kuondoa hatua batili; “guidance” ni kutumia feedback ya checker ili modeli irekebishe output yake.
Faida hiyo hiyo inatumika kwa binadamu. Proofs za lugha asilia zinaweza kuruka hatua zinazoonekana routine, kutofafanua vya kutosha boundary cases nyeti au kubeba assumptions zisizohitajika. Formalization inaweza kufanya mapungufu haya yaonekane. Hata hivyo, makala haitetei kwamba formal verification ichukue nafasi kabisa ya reasoning ya lugha asilia, bali kwamba iikamilishe.
Mchango kwa uwezo wa general reasoning
Waandishi wanajadili kwamba verifiable feedback kutoka formal checker inaweza kufundisha tabia zinazoweza kuhamishwa kwa reasoning tasks nje ya hisabati. Hoja hii haimaanishi kwamba mafunzo ya mathematical formalization yamethibitishwa kuunda general intelligence moja kwa moja. Makala inatumia mahusiano ya performance kati ya maeneo tofauti ya reasoning na tafiti za mafunzo kwa verifiable rewards kama dalili zinazounga mkono mwelekeo huu wa utafiti.
Kwa nini miradi halisi ya formalization iko katika kiwango cha nadharia?
Ingawa Kepler conjecture ni claim moja ya kihisabati, formal verification yake ilihitaji kuundwa kwa mamia ya definitions na helper propositions. Katika miradi kama Liquid Tensor Experiment, sehemu muhimu za condensed mathematics zilipaswa kwanza kujengwa katika Lean ili theorem lengwa iweze kuonyeshwa. Mifano hii inaonyesha kwamba miradi halisi si kazi ya “kutafsiri sentensi moja kwenda lugha nyingine”.
Hoja ya pili ya waandishi ni utegemezi wa statement-level methods kwa maktaba zilizoiva. Rasilimali kama Lean Mathlib hutoa kiasi kikubwa cha infrastructure iliyoandikwa na binadamu katika algebra, analysis, number theory na maeneo mengine ya msingi ya hisabati. Ikiwa eneo halijawakilishwa vya kutosha ndani ya Mathlib, definitions na helper theorems zinazokosekana lazima zijengwe kabla ya kutafsiri target statement.
Hoja ya tatu ni kwamba theoretical discovery hutegemea abstractions mpya. Miundo ya algebra kama group, ring na field, au mtazamo unaolenga morphisms katika category theory, imeunganisha vipande vya maarifa vilivyokuwa vinaonekana tofauti chini ya muundo mmoja. Makala inapendekeza kwamba siku zijazo formal knowledge bases kubwa zinaweza kupangwa upya ili kupata miundo ya pamoja katika maeneo tofauti na abstractions mpya kurahisisha theoretical discovery. Hili si matokeo yaliyotekelezwa au kuthibitishwa kwa majaribio katika utafiti, bali ni long-term research vision.
Mitazamo mbadala na majibu ya waandishi
Mtazamo kwamba “natural-language reasoning inatosha”
Lugha asilia ni flexible kwa sababu haihitaji syntax maalum na ina training data pana zaidi. Modeli zenye nguvu zinaweza kutatua matatizo magumu ya hisabati kwa lugha asilia. Waandishi wanajibu kwa kutaja faida tatu za ziada za formal methods: feedback inayoweza kukaguliwa na mashine, modular trust katika timu kubwa bila kusoma tena kila undani, na uwezo wa kuscale si kwa learning pekee bali pia kwa search.
Mtazamo kwamba “kipaumbele kiwe theorem proving”
Theorem proving hutafuta proof halali kwa formal target iliyotolewa. Lakini target proposition na system properties lazima kwanza ziandikwe formally. Katika hardware verification, kwa mfano, hata ikiwa model checkers zimekomaa vya kutosha kujaribu properties, kueleza kwa usahihi property gani inapaswa kukaguliwa inaweza kuwa bottleneck kuu. Kwa maneno ya waandishi, autoformalization huzalisha meaningful targets ambazo theorem prover itafanya kazi juu yake.
Mtazamo kwamba “kuboresha statement-level methods ni realistic zaidi”
Statement-level methods zina measurable datasets na successful examples. Katika baadhi ya human–AI collaborations, experts kwanza huandaa “sketch” ya kina au dependency graph, kisha modeli huformalize helper propositions kwa mpangilio. Waandishi wanaona hii kama “semi-theory-level”; kwa sababu kazi ya kutengeneza dependency structure bado imeachwa kwa experts na basic definitions mara nyingi huchukuliwa kutoka Mathlib.
Tatizo la kwanza wazi: Usawa wa maana unaweza kukaguliwaje?
Katika autoformalization, haitoshi kwamba code inayozalishwa inakompaili. Formal statement inaweza kuwa valid lakini ikawakilisha kitu tofauti na maana asilia ya natural-language text. Kwa hiyo swali kuu la tathmini ni kama statements mbili zina maana sawa.
Upungufu wa reliable reference data
Kulingana na ukaguzi uliotajwa katika makala, katika matatizo 118 kati ya 371 ya ProofNet kulikuwa na human formalization error ambayo ilipatikana na kusahihishwa; kiwango hiki ni %31,8. Katika PutnamBench, baada ya kuchapishwa, makosa yalisahihishwa katika angalau formalizations 58 kati ya 672 za Lean, na error rate iliyoripotiwa ilikuwa %8,6. Waandishi pia wanasema kwamba datasets maalum za definition formalization zimebaki na definitions 56 za Wikipedia na 30 za arXiv; ProofFlowBench ina statements 184 za undergraduate level pamoja na proofs. Wakati makala iliandaliwa, ilielezwa kuwa hakukuwa na benchmark inayotathmini nadharia nzima.
Syntactic equality, logical equivalence na tatizo la context
Statements mbili zifuatazo zina maudhui yale yale ya kihisabati:
\[ \forall n \in \mathbb{N},\; P(n) \]
\[ \neg \exists n \in \mathbb{N},\; \neg P(n) \]
Hapa n ni natural number na P ni property iliyofafanuliwa juu ya natural numbers. Statement ya kwanza inamaanisha “natural numbers zote zina property P”, ya pili “hakuna natural number isiyo na property P”. Kwa kuwa syntax zao ni tofauti, exact text matching haitazitambua kuwa sawa; lakini kimantiki ni equivalent.
Kinyume chake, equivalence ifuatayo hutokana si na logical structure pekee bali na definitions na theorems katika Euclidean geometry:
\[ \mathrm{rectangle}(a) \land \mathrm{rhombus}(a) \]
\[ \mathrm{square}(a) \]
a ni geometric object inayochunguzwa. Ikiwa object ni rectangle na rhombus kwa pamoja, katika geometry inayofaa hiyo inafanya iwe square. Lakini ikiwa “rectangle”, “rhombus” na “square” zinachukuliwa tu kama arbitrary logical relations zisizopewa maana, hitimisho hili halitoki. Ili kutathmini equivalence, background theory itakayotumika lazima ibainishwe.
Kwa nini definitional equivalence pekee haitoshi?
Proof assistants kama Lean zinaweza kufungua definitions na kusimplify baadhi ya statements moja kwa moja. Lakini kutokana na recursive direction ya definition ya addition ya natural numbers, statements zifuatazo zinaweza zisireduce kwa namna moja:
[ m + 0 ]
[ 0 + m ]
m ni natural number na haina physical unit. Statement ya kwanza inaweza kureduce moja kwa moja hadi m kwa definition, wakati ya pili inaweza kukwama juu ya abstract variable. Ili kuanzisha equality ya pili, helper results zilizothibitishwa kama commutativity ya addition zinahitajika.
Hatari ya unrestricted proposition equivalence
Pia si salama kuchukulia propositions mbili zote zilizo true katika background theory kuwa equivalent. Mbinu hii inaweza kuhesabu statements mbili zenye maudhui tofauti kabisa, kama “1 + 1 = 2” na Fermat’s Last Theorem, kuwa sawa. BEq+ checker iliyochunguzwa katika makala hupunguza global context na general proof search na kupata precision %98,0 na recall %48,3. Kwa pure definitional equivalence, thamani zilizotolewa ni precision %100 na recall %30,9.
Hata hivyo, biconditional ya properties mbili tofauti lakini true inaweza kutoa mwonekano wa equivalence isiyo sahihi wakati automation tactics zinaweza kuthibitisha kila upande kwa urahisi na kwa kujitegemea:
\[ (n \cdot 1 = n) \leftrightarrow (n + 0 = n) \]
Propositions zote mbili ni true kwa natural numbers, lakini moja inahusu identity element ya multiplication na nyingine identity element ya addition. Kwa maana asilia inayoformalizewa, si property ile ile.
Mpaka wa subjective equivalence
Moja ya mifano muhimu zaidi katika makala ni integral ifuatayo:
\[ \int_{0}^{1} 2x^3 \ln(x^2+1)\,dx > 0 \]
Kwa kutumia commutativity ya addition, form ifuatayo ni wazi kuwa sawa kwa wasomaji wengi:
\[ \int_{0}^{1} 2x^3 \ln(1+x^2)\,dx > 0 \]
Integral ikihesabiwa, matokeo yanaweza pia kureduce hadi:
\[ \frac{1}{4} > 0 \]
x ni dimensionless mathematical integration variable inayobadilika kati ya 0 na 1; mfano huu si physical measurement. Statements mbili za kwanza zinafanana sana juu juu, wakati ya tatu hutoa matokeo yale yale baada ya integration kufanywa. Mfumo wa tathmini unapaswa kufanya computation kiasi gani? Kulingana na hoja ya makala, kiwango kinachotambulika cha equivalence hubadilika kulingana na maarifa na uwezo wa computation wa evaluator.
Boundary case inaonekana wazi zaidi kwa algebraic identity ifuatayo:
\[ (x-1)^2 + 2x = x^2 + 1 \]
Kwa mtu anayetambua equality hii haraka, equivalence ya integrals ni wazi; evaluator mwingine anaweza kuhitaji expansion na simplification. Kwa hiyo kila equivalence checker lazima ichague threshold ya computation na background knowledge itakayoruhusu.
Tatizo la pili wazi: Hierarchical decomposition na abstraction learning
Kuformalize textbook ndefu kunahitaji zaidi ya kugawanya maandishi katika sentensi huru. Mfumo lazima utambue definition gani ije kwanza, theorem gani inategemea helper results zipi, na concepts zipi zinaweza kuunganishwa chini ya reusable abstraction.
Mbinu za kugawa theorem proving katika subgoals zimeonyesha maendeleo makubwa. Makala inaripoti kwamba DeepSeek-Prover-V2 imefikia %88,9 kwenye miniF2F, na BFS-Prover-V2 %95,1. Lakini mifumo hii kwa kawaida hugawanya target proof moja katika subgoals. Kazi ya theory-level inahitaji kupanga textbooks nzima au technical documents zenye main theorems nyingi na dependencies zilizosokotana kwa kina.
Abstraction learning ina kazi mbili tofauti:
- Definition formalization: Kupata concepts zinazojirudia katika maandishi na kuzigeuza kuwa reusable formal definitions.
- Knowledge compression: Kugundua common structures katika formal libraries kubwa zilizopo na kuzalisha abstractions fupi, modular na general zaidi.
Waandishi wanapendekeza kwamba general-purpose language-model agents zinaweza kufaa zaidi katika hatua ya concept extraction kutoka natural-language corpora; baada ya formal library kujengwa, symbolic methods zinazochunguza common code structures zinaweza kufaa zaidi. Hata hivyo, kazi nyingi zilizopo zimewekewa mipaka katika composite mathematical relations; automatic construction ya axiomatic au algorithmic definitions bado kwa kiasi kikubwa haijatatuliwa.
Tatizo la tatu wazi: Low-resource domain languages nje ya Lean
Formal verification katika ulimwengu halisi haifanywi kwa Lean pekee. Taasisi hutumia special-purpose domain languages kwa constraint solving, protocol verification, hardware properties, static security analysis na access policies. Katika lugha nyingi hizi hakuna datasets kubwa za natural-language–formal-language pairs.
Lugha za automated theorem provers
SMT solvers hutumia forms kama SMT-LIB, na first-order theorem provers hutumia forms kama TPTP. Kielelezo 3 kinaonyesha tafsiri ya property ifuatayo kuhusu operation ya kudondosha elements kutoka list kutoka natural language kwenda formal language:
\[ \forall x,w,L,\; \mathrm{drop}(w,\mathrm{drop}(x,L)) = \mathrm{drop}(x+w,L) \]
Hapa L inawakilisha list, na x pamoja na w idadi ya elements zinazondolewa kutoka mwanzo wa list; hazina physical units. Statement inasema kwamba kwanza kuondoa elements x na kisha w ni sawa na kuondoa jumla ya elements x+w katika hatua moja. Ingawa Tons of Inductive Problems dataset ina formal statements, kutokuwepo kwa natural-language counterparts kunafanya parallel data generation kuwa ngumu.
Lugha za distributed protocol verification
Lugha kama Ivy na PVerifier huchunguza kama distributed protocols zinahifadhi safety properties katika reachable states zote. Katika Kielelezo 4, natural-language description ya Chang–Roberts leader election protocol inabadilishwa kuwa formal model pamoja na ring topology, initial leader, node identifiers na message-sending actions. IvyBench kuwa na formalized protocol proofs 54 pekee kunaonyesha data scarcity katika eneo hili.
Lugha za hardware verification
Hardware properties zinaweza kuonyeshwa kwa lugha kama SystemVerilog Assertions kupitia signal behaviors over time. Katika Kielelezo 5, textual design document na timing diagram lazima zisomwe pamoja. Kauli katika hati kwamba “source control information remains stable” inaonyesha kupitia timing diagram pekee kwamba stability inaanza kutumika kuanzia clock cycle inayofuata.
Formal property katika kielelezo ina muundo huu:
(VALID && !READY) |-> ##1 $stable(INFO)
VALID inaonyesha kwamba information ni valid, READY kwamba receiver yuko ready kukubali, INFO control information, na ##1 cycle inayofuata. Bila kutafsiri text na diagram pamoja, temporal relation ya ##1 inaweza kukosekana. Mfano huu unaonyesha kwamba autoformalization sahihi inahitaji si text processing pekee bali cross-modal reasoning.
Declarative programming languages
Appendix A inaeleza kwa nini declarative languages kama SQL, Cypher, CodeQL na Cedar zinaingia katika scope ya autoformalization. Lugha hizi hazisemi “how to compute” bali “which condition must hold”. Kutafsiri natural-language requirement kuwa Cedar policy ni zaidi ya kuhamisha maana iliyopo kwenda formal constraints kuliko kubuni algorithm mpya.
Kinyume chake, tafsiri kwenda imperative programming languages kama Python au C++ huongeza implementation details ambazo hazipo katika source text, kama data structures, control flow, algorithm na security choices. Kwa hiyo makala inaainisha imperative program synthesis kama generative task, si translation inayohifadhi maana.
Matokeo ya mfano yaliyoripotiwa kwa declarative languages ni:
| Eneo au dataset | Scope | Matokeo yaliyoripotiwa | Kikomo cha tafsiri |
|---|---|---|---|
| Text2Cypher | 44.387 natural-language–query pairs | %33 exact match kwa GPT-4o; %31 bila fine-tuning | Exact match inaweza kukosa queries zenye maana sawa lakini syntax tofauti. |
| Kuzalisha vulnerability queries kwa CodeQL | 176 CVE na 111 Java projects | %10 kwa Claude Code; %53,4 kwa agent structure inayosaidiwa na tool feedback na retrieval | Matokeo yanahusu task, projects na evaluation setup maalum. |
| IvyBench | Distributed protocol verification | Formalized protocol proofs 54 | Idadi hii si model performance, bali scope ndogo ya dataset. |
Kielelezo 6 kinaonyesha jinsi provisions tofauti za HIPAA kuhusu patient access, personal representatives na minors zinavyoformalizewa pamoja kwa Cedar variables na conditions za pamoja. Katika legal text ya mamia ya kurasa, provisions, exceptions na cross-references zimeunganishwa. Kufanikiwa kwa paragraph-level isolated examples hakumaanishi kwamba regulation nzima imetafsiriwa kwa consistency.
Tatizo la nne wazi: Multimodal inputs zaidi ya text
Makala inabainisha aina nne za input katika real-world formalization tasks:
- Natural-language descriptions na technical documents
- Mathematical notations au existing formal languages
- Timing diagrams, schematics, state machines na flow drawings
- Free-form images kama geometric drawings au user-interface examples
Katika geometry, between-ness ya points au intersection ya lines inaweza kuonekana kiasili kwenye drawing lakini ikahitaji definition ya kina katika text. Katika hardware, timing diagrams; katika protocols, state machines; na katika software, interface examples zinaweza kubeba sehemu muhimu ya formal content. Mfumo wa theory-level lazima utambue contradictions kati ya sources hizi, ufunue implicit assumptions na uziunganishe zote katika representation moja thabiti.
Pendekezo 1: Metrics za kuaminika za tathmini ya kiwango cha nadharia
Mpangilio bora wa tathmini ya theory-level unaopendekezwa na waandishi unapaswa kutimiza masharti matatu:
- Uhusishe si target statements pekee, bali pia definitions na dependencies za background theory.
- Precision na recall ya equivalence checker ziripotiwe kulingana na evaluations za experts.
- Uwepo wa background theory inayotumika kupima modeli katika training data uzuiwe au ukaguliwe wazi.
Kwa muda mfupi, inapendekezwa kujenga datasets zinazofaa; kwa muda wa kati, kulinganisha muda wa formalization unaosaidiwa na AI na usiosaidiwa pamoja na expert labor; na kwa muda mrefu, kupima kama common intermediate representation kweli inatoa faida dhidi ya direct formalization.
Pendekezo 2: General-purpose models badala ya narrow specialist models
Kulingana na mfano uliotolewa katika makala, Goedel-Formalizer-V2-32B ilipata mafanikio ya %0,0 kwenye LeanEuclidPlus dataset nje ya Mathlib, wakati base Qwen3-32B model ya model family ile ile ilipata %20,6. Waandishi wanafasiri mfano huu kama onyo la out-of-domain generalization failure kwa mifumo iliyofine-tune sana kwenye patterns za maktaba moja.
Mbinu iliyopendekezwa ni kutumia general-purpose models zilizofunzwa kwa data kutoka formal languages na domains nyingi, zikiwa zinaungwa mkono na verifier feedback, dependency retrieval, iterative correction na inference-time search. “General-purpose” hapa haimaanishi model architecture pekee, bali pia training-data mixture, reward design na evaluation scope.
Pendekezo 3: Common intermediate representation
Kielelezo 7 kinawasilisha architecture ambapo natural language, formal language, diagrams na images kwanza hubadilishwa kuwa common intermediate representation; kisha representation hiyo huhamishwa kwa namna inayoweza kuthibitishwa kwenda domain languages tofauti. Kielelezo hicho pia kinaonyesha general-purpose multimodal model agents na theory-level metrics zenye reliable equivalence checker kama sehemu za mtiririko huu.
Common intermediate representation ina masharti matatu ya design:
- Expressiveness: Lazima iweze kuwakilisha maana za domain languages tofauti.
- Verifiability: Type checking na proof checking lazima ziwezekane ndani ya intermediate representation yenyewe.
- Embeddability: Target domain languages lazima ziweze kuembedwa kwa kina cha kutosha ndani ya intermediate representation na transformation iweze kuthibitishwa.
Waandishi wanaonyesha Lean kama natural candidate kwa sababu ya dependent type theory, built-in type checker na metaprogramming capabilities. Hata hivyo, pendekezo hili halimaanishi kwamba Lean imethibitishwa kwa majaribio kuwa common representation bora kwa domain languages zote. Hasa kwa hardware timing, legal policies, protocol states na special institutional languages, expressiveness na practical usability zinahitaji kutathminiwa kando.
Matokeo yanayoungwa mkono na utafiti
- Real-world formal verification projects zinahitaji infrastructure pana ya definitions na helper results kuliko kutafsiri target statements pekee.
- Existing statement-level methods mara nyingi hutegemea human-prepared formal libraries na dependency sketches.
- Equivalence evaluation ni tatizo linalotegemea background theory na haliwezi kutatuliwa kwa syntactic matching pekee.
- Low-resource domain languages na multimodal technical documents zina changamoto tofauti na Lean-centered mathematics datasets.
- Theory-level datasets, general-purpose models na common intermediate representation ni concrete research directions zinazopaswa kuchunguzwa.
Matokeo ambayo utafiti haujathibitisha au kujaribu
- Makala haiwasilishi working end-to-end theory-level autoformalization system.
- Haijaonyeshwa kwa majaribio kwamba common intermediate representation iliyopendekezwa ni bora kuliko direct translation.
- Haijathibitishwa kwamba Lean ni universal intermediate language kwa mathematical, legal, software na hardware domains zote.
- Haijaonyeshwa kwamba theory-level autoformalization itazalisha mathematical discoveries mpya moja kwa moja.
- Kwa kuwa model results zilizotajwa zinatumia datasets na evaluation metrics tofauti, haziwezi kufasiriwa kama single common ranking.
- Formal verification haiwezi kuondoa moja kwa moja ambiguity zote au semantic mismatches katika natural-language reasoning.
Maana yake kwa kuzingatia zamani, sasa na siku zijazo
Miradi mikubwa ya formalization ya zamani imeonyesha kuaminika kwa machine-checked knowledge lakini imehitaji miaka ya expert labor. Leo, large language models zinaweza ku-automate kwa kiasi tasks kama translation kati ya natural na formal languages, dependency finding na proof repair. Mchango wa makala ni kupanua research target kutoka mafanikio ya isolated statements kuelekea construction ya entire knowledge architecture.
Ikiwa mbinu hii itafanikiwa katika siku zijazo, mathematical textbooks, technical standards, security policies, distributed-system protocols na hardware design documents zinaweza kubadilishwa kuwa formal libraries zinazoweza kukaguliwa zaidi. Uwezekano huu ni muhimu kwa software na hardware reliability, verification ya critical systems, mathematical knowledge management na auditability ya AI reasoning. Hata hivyo, real-world deployment inahitaji kutatua scalability, semantic fidelity, data leakage, multimodal interpretation na expert oversight.
Mbinu na Matokeo ya Utafiti
Muundo wa utafiti
Utafiti huu si experimental research, clinical study, simulation experiment au new-model comparison. Ni position paper iliyoandaliwa kwa ICML Position Paper Track. Mbinu yake inategemea conceptual classification ya existing autoformalization literature, comparison ya formal verification projects katika domains tofauti, discussion ya alternative views, identification ya open problems na development ya research proposals.
| Kipengele cha kimetodolojia | Kimetekelezwaje katika utafiti? |
|---|---|
| Conceptual definition | Theory-level autoformalization imefafanuliwa kama construction ya axioms, definitions, notations, examples, helper propositions, theorems, proofs, tactics na dependencies kama holistic library. |
| Cross-domain sampling | Representative formal verification projects kutoka mathematics, science, software na hardware zimelinganishwa. |
| Alternative-view analysis | Mitazamo mitatu inayotanguliza natural-language reasoning, theorem proving na statement-level formalization imejadiliwa. |
| Open-problem analysis | Matatizo manne yametambuliwa: equivalence checking, hierarchical decomposition na abstraction, low-resource domain languages, na multimodal inputs. |
| Solution proposals | Research directions tatu zimewasilishwa: theory-level benchmarks, general-purpose models na common intermediate representation. |
| Additional conceptual distinctions | Declarative na imperative program synthesis, pamoja na proof autoformalization na general theorem proving, zimetenganishwa. |
Data, sample na statistical analysis
- Hakuna new experimental dataset iliyoundwa.
- Hakuna human participant, patient, animal, cell, physical sample au control group.
- Hakuna model training, validation na test split iliyofanywa.
- Hakuna new algorithm iliyofunzwa au kuendeshwa.
- Hakuna statistical hypothesis test, p value, confidence interval au significance threshold iliyoripotiwa.
- Numerical results ni reported results za previous studies na datasets zilizochunguzwa katika makala.
Viashiria vikuu vya kiasi
| Kiashiria | Thamani iliyoripotiwa | Maana katika utafiti |
|---|---|---|
| Tabaka 3 statement formalization | %71,4 | Ni success iliyoripotiwa wakati lower layers zimeandaliwa na binadamu; si whole-theory performance. |
| ProofNet human formalization errors | 118/371, %31,8 | Inaonyesha kwamba reference formalizations pia zinaweza kuwa na makosa. |
| Makosa yaliyosahihishwa katika PutnamBench | Angalau 58/672, %8,6 | Inaonyesha hitaji la quality control katika expert-written formal references. |
| BEq+ equivalence checker | %98,0 precision, %48,3 recall | Inaonyesha kwamba coverage hubaki limited licha ya high precision. |
| Pure definitional equivalence | %100 precision, %30,9 recall | Hukosa valid equivalences nyingi huku ikiepuka false positives. |
| DeepSeek-Prover-V2, miniF2F | %88,9 | Ni mfano wa progress katika kugawa isolated proofs kuwa subgoals. |
| BFS-Prover-V2, miniF2F | %95,1 | Ni reported multi-agent subgoal-search performance; si theory-level textbook decomposition. |
| Goedel-Formalizer-V2-32B, LeanEuclidPlus | %0,0 | Imetolewa kama mfano wa out-of-domain generalization problem ya narrow fine-tuning. |
| Qwen3-32B, LeanEuclidPlus | %20,6 | Imeelezwa kwamba base general-purpose model ilipata matokeo ya juu zaidi katika mfano huo. |
| Text2Cypher | Pairs 44.387; %33 exact match | Inaonyesha compositional difficulty katika low-resource na schema-dependent domain languages. |
| CodeQL security-query generation | %10 na %53,4 kwa agent support | Inaonyesha ugumu wa task inayohitaji security na program-analysis knowledge kwa pamoja. |
Ujumbe wa kimetodolojia wa vielelezo
- Kielelezo 1: Kinafupisha hoja ya sehemu nne ya makala kama umuhimu, mitazamo mbadala, open problems na call for solutions.
- Kielelezo 2: Kinaonyesha four-layer theoretical dependency structure kutoka axioms hadi target proofs.
- Kielelezo 3: Kinaonyesha translation ya natural-language statement kuhusu list operation kwenda SMT-like formal structure.
- Kielelezo 4: Kinaonyesha modeling ya leader-election protocol katika ring topology kwa axioms, relations na actions.
- Kielelezo 5: Kinaonyesha kwamba text na timing diagram lazima zisomwe pamoja ili hardware property itafsiriwe kwa usahihi.
- Kielelezo 6: Kinaonyesha kuunganisha HIPAA provisions tofauti katika one Cedar policy structure kupitia common conditions.
- Kielelezo 7: Kinafupisha proposal ya verifiable transformation kutoka multimodal inputs kwenda common intermediate representation na kisha domain languages tofauti.
Matokeo makuu na kikomo cha tafsiri
Matokeo makuu ya utafiti si experimental performance value bali ni hoja kuhusu research agenda: ili autoformalization iwe scalable katika ulimwengu halisi, lazima ihame kutoka isolated target statements kuelekea construction ya entire theories. Waandishi wanaonyesha kwamba existing methods mara nyingi huacha definition, dependency, notation na helper-proof infrastructure kwa binadamu au maktaba zilizoiva.
Matokeo haya hayamaanishi kwamba theory-level systems ziko tayari kwa matumizi leo. Mapendekezo ya makala—reliable benchmarks, general-purpose models na common intermediate representation—ni research directions zinazopaswa kuendelezwa na kupimwa siku zijazo.
Maelezo ya Chanzo na Mbinu
- Jina kamili asilia la utafiti: Theory-Level Autoformalization: From Isolated Statements to Unified Formal Knowledge Bases
- Waandishi na mpangilio wao: Marcus J. Min; Mike He; Zhaoyu Li; Zixuan Yi; Sharad Malik; Aarti Gupta; Xujie Si; Osbert Bastani
- Co-first author au equal contribution: PDF haitaji equal contribution au co-first authorship.
- Waandishi waliotajwa kwa mawasiliano: Marcus J. Min, Mike He, Sharad Malik, Aarti Gupta, Xujie Si na Osbert Bastani
- Taasisi: University of Pennsylvania; Princeton University; University of Toronto
- Aina ya chanzo: Peer-reviewed conference position paper
- Mkutano: 43rd International Conference on Machine Learning, ICML 2026
- Aina ya presentation/acceptance: Position Paper Track, Spotlight
- Publication series: Proceedings of Machine Learning Research, PMLR 306
- Mchapishaji asilia: Proceedings of Machine Learning Research
- Mahali na mwaka wa mkutano: Seoul, South Korea, 2026
- Hali ya peer review: Ilitathminiwa chini ya ICML 2026 Position Paper Track na kukubaliwa kama Spotlight. Makala pia inawashukuru anonymous reviewers.
- DOI ya final conference publication: PDF iliyopakiwa haina separate DOI ya PMLR publication.
- arXiv identifier: arXiv:2607.13292
- arXiv DataCite DOI: 10.48550/arXiv.2607.13292; inaonyeshwa kwenye arXiv page kama pending registration. Identifier hii haipaswi kuwasilishwa kama separate DOI ya PMLR conference publication.
- Official au verified records:OpenReview study record, arXiv study record, SSRN study record
Makala hii ya Verianla iliandaliwa kwa kuchunguza utafiti uliopakiwa wa kurasa 16 kuanzia mwanzo hadi mwisho. Pamoja na main text, Table 1, Figures 1–7, mathematical equivalence examples, references na appendix sections kuhusu declarative program synthesis na proof autoformalization zilipitiwa. Hakuna scientific finding, method performance au experimental result kutoka nje ya PDF iliyoongezwa. External sources zilitumika tu kuthibitisha bibliographic information kama author order, publication platform, Spotlight status na arXiv identifier.
Kikomo kikuu cha utafiti ni kwamba hauwasilishi new theory-level system iliyotekelezwa na kutathminiwa kwa majaribio. Mafanikio ya directions tatu zilizopendekezwa bado hayajaonyeshwa kwa comparative experiments. Kwa kuwa projects na datasets zilizochunguzwa zina domains, scopes na metrics tofauti, reported success rates hazipaswi kulinganishwa moja kwa moja kwa ranking. Feasibility ya common intermediate representation, acceptable boundary ya equivalence checking, kiwango ambacho expert labor itapungua na jinsi semantic fidelity itakavyohifadhiwa katika multimodal documents bado ni open research questions.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *