

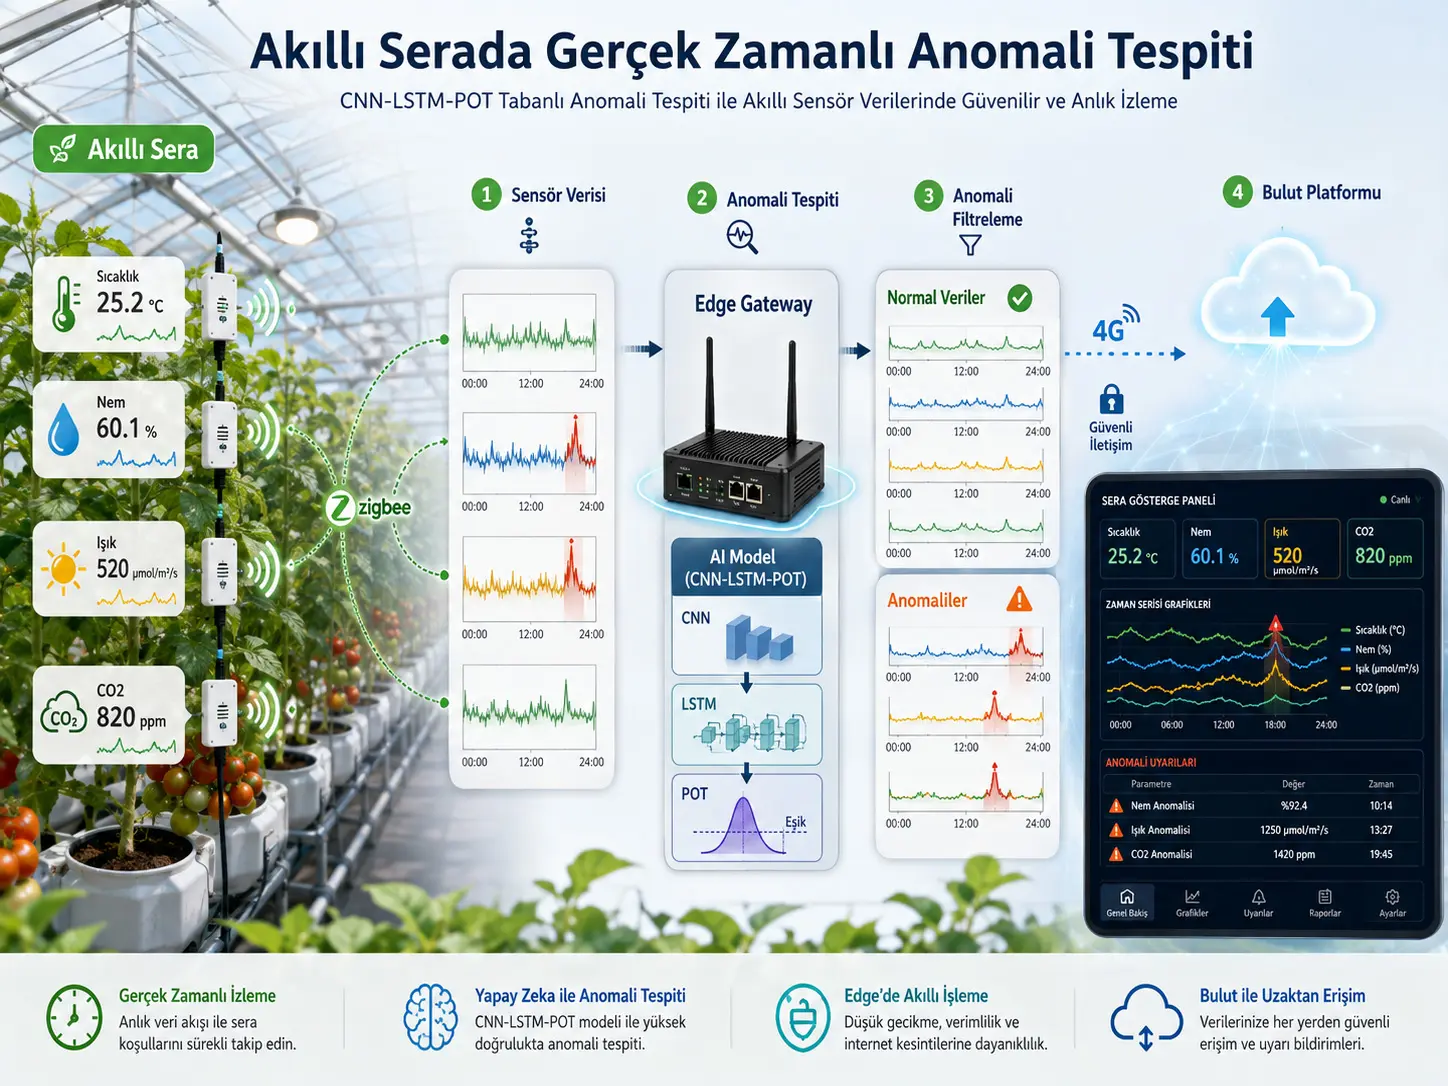
Utafiti huu unatengeneza mbinu mseto ya kutambua hitilafu inayoitwa CNN-LSTM-POT, inayolenga kubaini data zenye makosa au zisizo za kawaida kutoka kwa sensa za mazingira kama vile joto, unyevunyevu, kiwango cha mwanga na CO2 katika greenhouse mahiri, kabla data hizo hazijafika kwenye cloud, kwenye gateway ya greenhouse. Mfumo hutumia CNN kutoa vipengele vya eneo la karibu katika time series za sensa, LSTM yenye tabaka mbili kuunda modeli ya utegemezi wa muda, na mbinu ya Peaks Over Threshold (POT) kutathmini kwa njia inayobadilika kosa kati ya kipimo halisi na utabiri.
Katika usanifu wa vifaa wa utafiti, data za sensa hukusanywa kwenye nodi ya ukusanyaji data inayotegemea STM32F103C8T6, kuhamishwa kupitia Zigbee kwenda kwenye IoT gateway inayotegemea STM32H743, utambuzi wa hitilafu kufanywa kwenye gateway, na data zilizochujwa pekee kutumwa kwenye jukwaa la cloud kupitia muunganisho wa 4G. Hivyo, lengo ni kufanya utambuzi wa hitilafu moja kwa moja kwenye kifaa cha edge kilicho karibu na chanzo cha data.
Katika mazingira ya greenhouse yaliyodhibitiwa, jumla ya pointi 40.320 za data zilikusanywa kutoka aina nne za sensa kwa muda wa siku saba. Kila sensa ilitoa sampuli 10.080. Idadi ya hitilafu zilizothibitishwa ilikuwa 504 kwa kiwango cha mwanga, 412 kwa joto, 379 kwa unyevunyevu na 473 kwa CO2, jumla ikiwa 1768. Hitilafu hizo zilitokana na mchanganyiko wa sensor drift ya kawaida na uingiliaji wa kimwili uliodhibitiwa; lebo zilithibitishwa kwa ukaguzi wa mikono, kulinganisha na sensa za ziada na kutumia log za matukio ya mazingira.
Katika sehemu ya POT ya modeli, thamani chaguomsingi ya quantile iliwekwa kuwa 0,99 na kigezo cha umuhimu q=10−4. Katika uchambuzi wa unyeti wa chanzo, F1-score ya %92,2 iliripotiwa kwa quantile 0,99, na %92,6 kwa q=10−3. Thamani hizi zinahusu unyeti wa vigezo vya POT na hazipaswi kufasiriwa kama F1 moja ya jumla kwa majaribio yote ya utafiti.
Katika jaribio la edge kwenye STM32H743, modeli ya CNN-LSTM-POT ilionyesha ukubwa wa modeli wa 224,3 KB, matumizi ya kumbukumbu ya 156,8 KB, matumizi ya CPU ya %34,2, inference latency ya 23,6 ms na matumizi ya nishati ya 4,72 mJ. Ingawa LSTM hutumia rasilimali chache zaidi, katika matokeo ya kulinganisha ya utambuzi ya utafiti wa chanzo, CNN-LSTM-POT iliripotiwa kuwa modeli yenye nguvu zaidi kwa Precision, Recall na F1. Kwa hiyo, dai kuu la kiufundi la utafiti si kuwa “modeli ya haraka zaidi”, bali kuchanganya mafanikio ya juu ya utambuzi wa hitilafu na matumizi ya rasilimali yanayowezekana kwenye microcontroller.
Katika hali nne za gateway, viwango vya anomaly recognition vilivyoripotiwa na chanzo ni %92 kwa nodi moja–sensa moja, %76 kwa nodi moja–sensa nyingi, %86 kwa nodi nyingi–sensa moja na %70 kwa nodi nyingi–sensa nyingi. Kupungua kwa utendaji katika hali ngumu zaidi kunaelezwa na uwezekano wa hitilafu za vigezo vingi kufanana na mabadiliko ya kawaida ya mazingira na ugumu wa kuzitenganisha katika feature space yenye vipimo vingi.
Maoni kwa mtazamo wa Türkiye: Utafiti haukufanywa katika greenhouse za kibiashara au zinazoendeshwa nchini Türkiye. Hata hivyo, ufuatiliaji wa sensa za mazingira unaotegemea Zigbee/4G, edge gateway na mbinu ya kuchuja hitilafu vinaweza kubadilishwa kimawazo kwa matumizi ya greenhouse mahiri nchini Türkiye. Kwa matumizi halisi, mafunzo upya na uthibitishaji wa eneo unahitajika kwa kuzingatia hali ya hewa ya greenhouse ya eneo, aina za sensa, aina za mazao, ukubwa wa greenhouse, ubora wa mawasiliano yasiyotumia waya, usambazaji wa kawaida wa vigezo vya mazingira na gharama ya alarm za uongo. Viwango vya utambuzi wa gateway vya %70–%92 katika utafiti haviwezi kuchukuliwa kuwa utendaji halisi wa greenhouse nchini Türkiye.
Kwa nini hitilafu ni muhimu katika greenhouse mahiri?
Katika usimamizi wa greenhouse otomatiki, maamuzi ya udhibiti hutegemea data zinazotoka kwenye sensa. Sensa ya joto ikionyesha ongezeko la ghafla kimakosa, sensa ya unyevunyevu ikifanya drift, au kukiwa na mruko wa data kutokana na hitilafu ya mawasiliano, hali hiyo inaweza kusababisha maamuzi yasiyo sahihi kuhusu uingizaji hewa, umwagiliaji au udhibiti wa hali ya hewa.
Hoja ya kuanzia ya utafiti ni kwamba ingawa mifumo ya kawaida ya ufuatiliaji wa greenhouse hufaulu kukusanya data, si kila mfumo una utaratibu wa kutathmini uaminifu wa data ya sensa kwa wakati halisi.
Utafiti unahamisha utambuzi wa hitilafu moja kwa moja kwenye gateway badala ya kuacha kazi hiyo upande wa cloud. Hivyo, data inayodhaniwa kuwa na makosa inaweza kuchujwa kabla haijatumwa kwenye mfumo wa upstream.
Usanifu wa mfumo unafanyaje kazi?
Mtiririko wa data wa CNN-LSTM-POT kutoka sensa hadi cloud
| Hatua | Mchakato | Chanzo |
|---|---|---|
| 1. Kipimo cha mazingira | Sensa za kiwango cha mwanga, joto, unyevunyevu na CO2 huzalisha data za wakati halisi. | Usanifu wa mfumo na Sehemu 5 |
| 2. Nodi ya ukusanyaji data | Moduli inayotegemea STM32F103C8T6 hukusanya vipimo vya sensa na kutekeleza kazi za awali za uchakataji wa data. | Sehemu 1 na Sehemu 5 |
| 3. Uhamishaji wa Zigbee | Data kutoka nodi za sensa huhamishwa kupitia Zigbee kwenda upande wa coordinator/gateway. | Kielelezo 1 |
| 4. Edge gateway | Gateway inayotegemea STM32H743 huendesha modeli ya CNN-LSTM-POT. | Sehemu 1 na 4.6 |
| 5. Utabiri wa CNN-LSTM | CNN hutoa vipengele vya eneo la karibu; LSTM hutumia muundo wa muda kutabiri thamani inayotarajiwa ya sensa. | Sehemu 3.1 |
| 6. Uamuzi wa POT | Kosa la utabiri hulinganishwa na kizingiti cha POT kinachobadilika ili data iainishwe kuwa ya kawaida au yenye hitilafu. | Sehemu 3.2 |
| 7. 4G na cloud | Baada ya kuchujwa, data zinazokubaliwa kuwa halali hutumwa kwenye jukwaa la cloud kupitia 4G. | Kielelezo 1 |
Verianla Live: Mchakato huu umetayarishwa kutokana na usanifu wa mawasiliano wa greenhouse na mtiririko wa kazi wa CNN-LSTM-POT katika utafiti. Hakuna hatua mpya ya uchakataji ambayo haipo kwenye chanzo iliyoongezwa.
Kwa nini CNN na LSTM hutumiwa pamoja?
Modeli hushughulikia aina mbili tofauti za tatizo katika tabaka tofauti. CNN ya mwelekeo mmoja hutumiwa kutoa muundo wa kiwango kifupi na wa eneo la karibu wa ishara ya sensa katika sliding time window. Kisha tabaka za LSTM huunda modeli ya uhusiano wa muda wa muda mrefu zaidi kati ya uchunguzi wa zamani.
Data ghafi kwanza hupitishwa kwenye min–max normalization:
\[ x'= \frac{x-x_{\min}} {x_{\max}-x_{\min}} \]
Hapa \(x_{\min}\) na \(x_{\max}\) ni thamani za minimum na maximum ndani ya sliding window ya sasa. Vipimo vipya vinapotoka nje ya kiwango cha awali, vigezo vya normalization huhesabiwa upya kulingana na window ya sasa.
Katika tabaka la convolution, modeli hutumia:
\[ Z = ReLU(W \otimes X+b) \]
uhusiano huu. \(X\) inawakilisha mlolongo wa ingizo, \(W\) convolution kernel, \(b\) thamani ya bias, na \(Z\) mlolongo wa vipengele vya kiwango cha juu unaozalishwa na CNN.
Vipengele hivi hupelekwa kwenye tabaka mbili za LSTM zinazofuatana:
\[ h_{n1}=f(h_{n-1},z_n) \]
na:
\[ h_{n2}=f(h_{(n-1)2},h_{n1}) \]
Utabiri wa mwisho hutengenezwa kwa mabadiliko ya mstari kutoka hidden state ya tabaka la pili la LSTM:
\[ y=Vh_{n2} \]
Je, hitilafu huainishwa moja kwa moja na modeli?
Hapana. Kazi kuu ya CNN-LSTM ni kutabiri thamani inayofuata au inayotarajiwa ya sensa. Tofauti kati ya thamani halisi ya sensa na utabiri hutumiwa baadaye kama anomaly score.
Katika Algorithm 1, kosa la utabiri huhesabiwa kama:
\[ e_t= \left\|x_t-\hat{x}_t\right\|^2 \]
Thamani \(N\) za mwisho za kosa huhifadhiwa ndani ya sliding window na sehemu ya POT huunda modeli ya sehemu ya mwisho yenye thamani kali ya usambazaji wa makosa hayo.
Kwa nini POT ni tofauti na kizingiti kisichobadilika?
Anomaly threshold isiyobadilika inaweza kupoteza ufaafu wake kadiri hali za greenhouse zinavyobadilika. Mzunguko wa mchana–usiku, uingizaji hewa, umwagiliaji au hali ya hewa vinaweza kubadilisha usambazaji wa kawaida wa data ya sensa.
Mbinu ya Peaks Over Threshold hufit Generalized Pareto Distribution (GPD) kwenye thamani kali za makosa ya utabiri zinazozidi kizingiti fulani cha awali. Uwakilishi uliotumiwa kwa GPD katika chanzo ni:
\[ F(s) = P(S-m>s\mid m
Hapa \(m\) ni kizingiti cha awali, \(\gamma\) ni kigezo cha shape na \(\beta\) ni kigezo cha scale.
Kizingiti kinachobadilika cha hitilafu kimetolewa katika utafiti kama:
\[ w \simeq m+ \frac{\hat{\beta}}{\hat{\gamma}} \left[ \left( \frac{qN}{G} \right)^{-\hat{\gamma}} -1 \right] \]
Katika usemi huu, \(q\) ni kiwango kinachotarajiwa cha hitilafu, \(N\) ni ukubwa wa sliding window, na \(G\) ni idadi ya makosa yanayozidi kizingiti cha awali.
Vigezo vya POT hubadilisha matokeo kwa kiwango gani?
Uchambuzi wa unyeti wa quantile threshold unaonyesha kuwa kuchagua kizingiti cha chini kupita kiasi au cha juu kupita kiasi kunaweza kupunguza F1-score. Katika chanzo, matokeo ya juu zaidi ya unyeti wa quantile ni %92,2 katika kiwango cha 0,99.
F1-score kulingana na kizingiti cha quantile cha POT
| Quantile threshold | F1-score (%) | Chanzo |
|---|---|---|
| 0,90 | 88,6 | Jedwali 1 |
| 0,95 | 90,1 | Jedwali 1 |
| 0,98 | 91,6 | Jedwali 1 |
| 0,99 | 92,2 | Jedwali 1 |
| 0,995 | 91,5 | Jedwali 1 |
| 0,999 | 84,8 | Jedwali 1 |
Verianla Live: Thamani zimetolewa kutoka uchambuzi wa unyeti wa POT quantile wa utafiti wa chanzo. Jedwali linaloonekana limehifadhiwa kama chanzo cha data ya kisayansi.
Quantile inapoongezwa hadi 0,999, F1-score hushuka hadi %84,8. Matokeo haya yanaonyesha kuwa “kusogeza kizingiti kwenye eneo kali zaidi” pekee hakutoshi kupata anomaly detection bora.
Matokeo ya significance level q ni yapi?
| q | F1-score (%) |
|---|---|
| 10−2 | 86,0 |
| 10−3 | 92,6 |
| 10−4 | 92,2 |
| 5 × 10⁻⁵ | 90,4 |
| 10−5 | 82,8 |
Watafiti wanapendekeza quantile 0,995 na q=5×10⁻⁵ kwa mazingira thabiti ya greenhouse; quantile 0,98–0,99 na q=10−3 kwa mazingira yenye mabadiliko zaidi; na quantile 0,99 na q=10−4 kama mwanzo kwa mazingira yasiyojulikana au mchanganyiko.
Mapendekezo haya yanatokana na uchambuzi wa unyeti wa utafiti wa chanzo wenyewe na hayapaswi kuchukuliwa kuwa vigezo bora vya jumla kwa kila aina ya greenhouse.
Kwa nini ukubwa wa sliding window ni muhimu?
Window ndogo inaweza kuzoea usambazaji mpya kwa haraka zaidi na kupunguza ucheleweshaji wa anomaly detection; hata hivyo, kwa sababu ina data ndogo ya kihistoria, makadirio ya threshold yanaweza kuwa nyeti zaidi kwa noise. Window kubwa inaweza kutoa modeli ya takwimu iliyo thabiti zaidi lakini kuchelewesha kuzoea baseline mpya.
Utafiti unaeleza trade-off hii kinadharia lakini hautoi jedwali tofauti la benchmark ya namba kwa thamani mbalimbali za \(N\). Kwa hiyo, hakuna urefu maalumu wa sliding-window unaoweza kutolewa kama optimum kutoka kwenye chanzo.
Modeli ilifundishwaje?
- Idadi ya filters za 1D CNN: 32
- Ukubwa wa kernel: (3, 1)
- Tabaka za LSTM: 2
- Activation ya LSTM: tanh
- Dropout: 0,2
- Optimizer: Adam
- Learning rate ya mwanzo: 0,001
- Loss: Mean Squared Error
- Batch size: 64
- Training epoch: 30
- Mgawanyo wa data: %70 training, %15 validation, %15 test
Mgawanyo wa mpangilio wa muda unalenga kupunguza data leakage kutoka siku zijazo za time series kwenda kwenye data za zamani.
Je, ulinganisho wa baseline ulifanywa kwa haki?
Modeli zote za LSTM, BeatGAN na THOC zilitathminiwa kwa migawanyo ileile ya training, validation na test. Hyperparameter za baseline zilichaguliwa kwa grid search ili kuongeza validation F1-score.
Kwa modeli zinazotegemea error kama LSTM na BeatGAN, quantile threshold iliundwa kutoka usambazaji wa validation error; thamani ya one-class margin ya THOC ilirekebishwa kwenye validation set. Mbinu hii ni jaribio la watafiti kufanya vizingiti vya kulinganisha viwe karibu iwezekanavyo na mantiki sawa ya tathmini.
Ulinganisho wa kitakwimu unaonyesha nini?
Kila modeli iliendeshwa mara 10 kwa random seed tofauti na F1-score ya CNN-LSTM-POT ililinganishwa na modeli za baseline kwa kutumia paired t-test.
| Modeli iliyolinganishwa | Tofauti ya wastani ya F1 | t-statistic | p-value |
|---|---|---|---|
| LSTM | 0,02 | 3,15 | <0,01 |
| BeatGAN | 0,13 | 14,23 | <0,001 |
| THOC | 0,05 | 5,89 | <0,01 |
Chanzo kinafasiri matokeo haya kama tofauti zenye umuhimu wa kitakwimu kwa upande wa CNN-LSTM-POT. Hata hivyo, upeo wa majaribio haya umefungwa kwenye dataset ileile na mpangilio uleule wa majaribio.
Grafu ya loss inapaswa kusomwaje?
Maelezo ya utafiti yanasema training na validation loss curves zinaanza karibu 0,225 na kukaribiana karibu 0,025. Hata hivyo, picha ya Kielelezo 6 katika chanzo hailingani kikamilifu na maelezo hayo.
Kwenye grafu, training loss huanza karibu 0,225 na kushuka hadi karibu 0,06, huku validation loss ikianza karibu 0,07 na kushuka hadi takriban 0,025–0,03. Ingawa curves zote mbili zinaonyesha mwelekeo wa kupungua wakati wa mafunzo, hazionekani kuanzia na kuishia karibu na thamani sawa.
Kwa hiyo, inawezekana kuripoti maelezo ya chanzo ya “no signs of overfitting”; lakini grafu haipaswi kutumiwa kuhitimisha kuwa loss curves hizo mbili zime-converge kwenye thamani sawa.
Modeli ilipunguzwaje kwa kifaa cha edge?
Kwa sababu uwezo wa RAM wa STM32H743 ni mdogo, optimization mbili zilitumika.
Magnitude-based pruning: Baada ya mafunzo kukamilika, connections zenye absolute weight chini ya 0,01 ziliwekwa sifuri na kurukwa wakati wa inference. Muundo wa Sparse ulihifadhiwa katika format ya Compressed Row Storage na kisha modeli ikafanyiwa fine-tune.
Memory pooling na static allocation: Mahitaji ya Layer input/output na buffer za kati yalihesabiwa mapema, memory pool moja isiyobadilika ikatengwa, dynamic memory allocation ikapunguzwa wakati wa inference, na inapowezekana eneo la kumbukumbu la layer iliyotangulia likatumika tena.
Matumizi ya rasilimali kwenye STM32H743 yakoje?
| Modeli | Ukubwa wa modeli (KB) | Kumbukumbu (KB) | CPU (%) | Inference latency (ms) | Nishati (mJ) |
|---|---|---|---|---|---|
| CNN-LSTM-POT | 224,3 | 156,8 | 34,2 | 23,6 | 4,72 |
| LSTM | 128,6 | 102,4 | 21,5 | 15,2 | 3,04 |
| BeatGAN | 412,5 | 298,2 | 68,7 | 67,4 | 13,48 |
| THOC | 356,8 | 224,5 | 52,3 | 42,8 | 8,56 |
Jedwali hili linaonyesha tofauti muhimu: CNN-LSTM-POT si modeli yenye matumizi ya chini zaidi ya rasilimali. LSTM ni ndogo zaidi, hutumia kumbukumbu na nishati kidogo zaidi, na ina inference ya haraka zaidi. Sababu ya CNN-LSTM-POT katika utafiti ni kutoa utendaji wa juu zaidi wa anomaly detection kwa gharama hii ya ziada ya computation.
Je, data halisi ya greenhouse ilitumika?
Utafiti unaeleza mazingira yake ya majaribio kama controlled greenhouse simulation environment. Ingawa vipimo vya mazingira vilikusanywa kutoka kwa modules halisi za sensa kwa siku saba, tathmini si utafiti wa muda mrefu wa shambani katika greenhouse ya kibiashara inayofanya kazi.
Mgawanyo wa jumla ya sampuli 40.320 za sensa ni kama ifuatavyo:
| Sensa | Muda | Jumla ya data | Hitilafu iliyothibitishwa |
|---|---|---|---|
| Kiwango cha mwanga | Siku 7 | 10.080 | 504 |
| Joto | Siku 7 | 10.080 | 412 |
| Unyevunyevu | Siku 7 | 10.080 | 379 |
| CO2 | Siku 7 | 10.080 | 473 |
Ilithibitishwaje kwamba hitilafu hizo zilikuwa hitilafu kweli?
Utafiti ulitumia mbinu tatu tofauti za uthibitishaji wa ground-truth.
- Uthibitishaji wa mikono: Ishara za sensa zilikaguliwa na wataalamu pamoja na timestamp na log za mazingira.
- Ukaguzi wa kulinganisha na sensa ya ziada: Ikiwa tofauti kati ya sensa mbili za aina moja ilizidi standard deviation tatu, tukio hilo lilichunguzwa zaidi.
- Log za mfumo wa udhibiti: Mabadiliko ya sensa yalilinganishwa na matukio ya actuator kama uingizaji hewa, upashaji joto na umwagiliaji.
Kwa mfano, mabadiliko ya joto yanayotokea wakati mmoja na kuwashwa kwa uingizaji hewa yanaweza kuchukuliwa kuwa ya kawaida, wakati mruko unaofanana lakini usio na tukio linalolingana kwenye log unaweza kutathminiwa kama hitilafu inayowezekana.
Ni hali gani zilitumika katika majaribio ya gateway?
Hali nne tofauti ziliundwa:
- Nodi moja – hitilafu ya sensa moja
- Nodi moja – hitilafu ya sensa nyingi
- Nodi nyingi – hitilafu ya sensa moja
- Nodi nyingi – hitilafu ya sensa nyingi
Kila jaribio lilidumu saa sita, sampling interval ikawekwa kuwa dakika tatu, na chanzo kinaeleza kuwa kila hali ilirudiwa mara 50.
| Hali | Jumla ya data iliyotolewa kwenye jedwali | Data iliyotumwa kutoka gateway | Recognition Rate (%) |
|---|---|---|---|
| Nodi moja – sensa moja | 120 | 74 | 92 |
| Nodi moja – sensa nyingi | 120 | 82 | 76 |
| Nodi nyingi – sensa moja | 120 | 77 | 86 |
| Nodi nyingi – sensa nyingi | 120 | 85 | 70 |
Kiwango cha juu zaidi, %92, kilipatikana katika hali ya hitilafu iliyotengwa ya sensa moja; kiwango cha chini zaidi, %70, kilipatikana wakati nodi nyingi na sensa nyingi ziliharibika kwa wakati mmoja.
Watafiti wanaeleza kupungua kwa utendaji kwa sababu mbili: uhusiano kati ya hitilafu za sensa nyingi unaweza kufanana na mabadiliko ya kawaida ya mazingira, na feature space yenye vipimo vingi hujitokeza wakati sensa/nodi nyingi zinatathminiwa kwa wakati mmoja.
Kikomo cha kuripoti: Ingawa chanzo kinasema kila hali ilirudiwa mara 50, Jedwali 7 linatoa idadi ya jumla ya sampuli kuwa 120. Aidha, “Total Anomaly Data Points” katika equation ya Recognition Rate haijaonyeshwa kwenye jedwali kwa kila hali. Kwa hiyo, haiwezekani kuhesabu upya viwango hivyo kwa kujitegemea kutoka kwenye data ghafi.
Utafiti unasema nini?
- Vipengele vya CNN, LSTM na POT viliweza kuunganishwa katika mnyororo mmoja wa edge anomaly detection.
- Dynamic threshold inayotegemea POT inaweza kubadilika kulingana na usambazaji wa sasa wa prediction-error badala ya kutumia kizingiti kisichobadilika.
- Modeli iliyopendekezwa iliendeshwa kwenye STM32H743 kwa inference latency ya 23,6 ms na matumizi ya RAM ya 156,8 KB.
- Katika jaribio la chanzo, proposed model ilionyesha utendaji wa juu zaidi wa Precision, Recall na F1 miongoni mwa modeli za anomaly detection zilizolinganishwa.
- Katika matokeo ya paired t-test, tofauti za F1 dhidi ya LSTM, BeatGAN na THOC ziliripotiwa kuwa na umuhimu wa kitakwimu.
- Katika majaribio ya gateway, ilionekana kuwa anomaly recognition inaweza kushuka kutoka %92 hadi %70 kadiri ugumu unavyoongezeka.
- Edge filtering ilipunguza kiasi cha data kilichotumwa kwenye cloud katika jaribio la chanzo.
Utafiti hausemi au hauthibitishi nini?
- Modeli haijathibitishwa katika hali za muda mrefu za greenhouse za kibiashara.
- Haijaonyeshwa kwamba vigezo vilevile vya POT ni optimum kwa mimea, hali za hewa na aina mbalimbali za greenhouse.
- Modeli si chaguo la haraka zaidi wala lenye matumizi ya chini zaidi ya nishati; LSTM ina faida zaidi katika matumizi ya rasilimali.
- Haijapimwa kwa majaribio kwamba kuchuja hitilafu huongeza moja kwa moja mavuno ya mimea au ubora wa bidhaa.
- Haijathibitishwa kwa jaribio la moja kwa moja la udhibiti kwamba data mbovu ya sensa imezuiwa kusababisha madhara kwa mimea katika mfumo halisi wa closed-loop control.
- Utafiti haujajaribu tabia ya sensor drift na distribution shift kwa kipindi cha miezi au misimu.
- Namna Jedwali la Gateway Recognition Rate lilivyojumlisha marudio 50 haijaelezwa kikamilifu.
- Hakuna data inayoonyesha kwamba viwango vilevile vya usahihi vitapatikana katika mifumo ya greenhouse nchini Türkiye.
Mbinu na Matokeo ya Utafiti
Usanifu wa CNN-LSTM-POT
| Kipengele | Kazi | Muundo uliotumika kwenye chanzo |
|---|---|---|
| Sliding window | Kuingiza sampuli N za mwisho za sensa kwenye modeli | Window inayobadilika |
| Normalization | Kulinganisha viwango tofauti vya sensa | Min–max inayotegemea window |
| CNN | Kutoa vipengele vya eneo la karibu vya sensa/time series | Conv1D, filters 32, kernel (3,1), ReLU |
| LSTM | Kuunda modeli ya utegemezi wa muda | Tabaka 2, tanh, dropout 0,2 |
| Fully connected output | Kuzalisha thamani inayotarajiwa ya sensa | Mabadiliko ya mstari kutoka hidden state ya LSTM ya pili |
| Prediction residual | Tofauti kati ya halisi na utabiri | ||x − x̂||² |
| POT | Kuhesabu dynamic anomaly threshold | GPD + MLE |
Mipangilio chaguomsingi ya POT
| Kigezo | Thamani chaguomsingi |
|---|---|
| Quantile threshold ya mwanzo | 0,99 |
| Significance level q | 10−4 |
| Makadirio ya vigezo vya GPD | Maximum Likelihood Estimation |
Mpangilio wa mafunzo na tathmini
| Kigezo | Thamani |
|---|---|
| Training set | %70 |
| Validation set | %15 |
| Test set | %15 |
| Optimizer | Adam |
| Learning rate | 0,001 |
| Loss | MSE |
| Batch size | 64 |
| Epoch | 30 |
| Modeli za baseline | LSTM, BeatGAN, THOC |
Thamani zilizochaguliwa kutoka mipangilio optimum ya modeli za baseline
| Modeli | Muundo mkuu optimum |
|---|---|
| LSTM | 64 hidden unit, tabaka 2, dropout 0,2, learning rate 0,001 |
| BeatGAN | Latent dimension 32, tabaka 3 za generator, tabaka 3 za discriminator, adversarial weight 0,5 |
| THOC | Temporal window 20, dilations [1,2,4,8], one-class margin 0,5, hidden channels 64 |
Matokeo makuu ya kiasi
- F1 ya juu zaidi katika uchambuzi wa unyeti wa quantile: %92,2, quantile=0,99.
- F1 ya juu zaidi katika uchambuzi wa unyeti wa q: %92,6, q=10−3.
- CNN-LSTM-POT edge inference latency: 23,6 ms.
- Ukubwa wa modeli: 224,3 KB.
- Matumizi ya kumbukumbu wakati wa runtime: 156,8 KB.
- Matumizi ya CPU: %34,2.
- Matumizi ya nishati: 4,72 mJ/inference.
- Jumla ya data ya sensa ya siku saba: pointi 40.320.
- Idadi ya anomaly zilizothibitishwa kwenye chanzo: 1768.
- Kiwango cha Recognition Rate kilichoripotiwa katika hali za gateway: %70–%92.
Hitimisho muhimu zaidi
Matokeo ya kiufundi yenye nguvu zaidi ya utafiti ni kwamba muundo wa CNN-LSTM-POT unaolenga usahihi wa juu wa anomaly-detection uliweza kuendeshwa kwenye gateway ya daraja la STM32H743 bila kuhitaji desktop au cloud server. Hata hivyo, faida hii ina gharama ya rasilimali: LSTM peke yake ni ndogo zaidi, haraka zaidi na hutumia nishati kidogo zaidi. Kwa hiyo mfumo uliopendekezwa si “modeli nyepesi zaidi”, bali unapaswa kutathminiwa kama muwiano kati ya anomaly detection yenye nguvu zaidi na gharama inayokubalika ya edge.
Maelezo ya Chanzo na Mbinu
Jina kamili la utafiti asili: CNN-LSTM-POT-Based Anomaly Detection for Smart Greenhouse Sensor Data: A Real-Time Edge Deployment Approach
Waandishi na mpangilio wao: Jun Shu; Dengke Yang.
Mwandishi wa mawasiliano: Dengke Yang.
Mchango sawa/mwandishi wa kwanza sawa: Haijaelezwa katika chanzo.
Taasisi: School of Intelligent Manufacturing and Energy Engineering, Zhejiang University of Science and Technology, Hangzhou 310023, China.
Jarida: Future Internet
Mchapishaji: MDPI, Basel, Switzerland
Juzuu / toleo / makala: 18 / 4 / 205
Tarehe ya kupokelewa: 1 Machi 2026
Tarehe ya marekebisho: 5 Aprili 2026
Tarehe ya kukubaliwa: 8 Aprili 2026
Tarehe ya kuchapishwa: 13 Aprili 2026
DOI: 10.3390/fi18040205
Kiungo rasmi cha chapisho:https://doi.org/10.3390/fi18040205
Aina ya chanzo: Makala ya utafiti iliyopitia peer review; ukusanyaji wa data za sensa katika mazingira ya greenhouse simulation yaliyodhibitiwa, anomaly detection inayotegemea deep learning na tathmini ya deployment kwenye microcontroller halisi ya edge.
Hali ya peer review: Ni utafiti uliochapishwa katika jarida lililopitia peer review.
Leseni: Creative Commons Attribution (CC BY).
Ufadhili: Utafiti haukupokea ufadhili wa nje.
Upatikanaji wa data: Chanzo kinaeleza kuwa data ghafi zinazounga mkono matokeo zitatolewa na waandishi kwa ombi.
Mgongano wa maslahi: Waandishi wametangaza kuwa hakuna mgongano wa maslahi.
Michango ya waandishi: Kulingana na tamko la chanzo, conceptualization Dengke Yang; methodology Jun Shu na Dengke Yang; software, validation na investigation Jun Shu; original draft Jun Shu; review/editing Jun Shu; visualization Jun Shu na Dengke Yang; supervision Dengke Yang.
Shukrani: Chanzo kinamshukuru Yuanhua Quan kwa michango yake katika mchakato wa review/editing wa makala na supervision ya utafiti. Yuanhua Quan hajaorodheshwa miongoni mwa waandishi wa utafiti.
Mazingira ya majaribio: Utafiti ulifanywa, kwa maelezo ya waandishi, ndani ya controlled greenhouse simulation environment. Kwa hiyo haupaswi kutathminiwa kama uthibitishaji wa muda mrefu wa uendeshaji wa shambani katika greenhouse halisi ya kibiashara.
Dokezo la kuripoti ndani ya chanzo 1: Maandishi yanayoeleza Kielelezo 6 yanasema training na validation loss zinaanza karibu 0,225 na ku-converge karibu 0,025. Hata hivyo, kwenye picha ya kielelezo validation loss huanza karibu 0,07 na training loss huishia karibu 0,06. Kutolingana huku kati ya maandishi na grafu hakujasahihishwa kimya kimya katika maandishi ya Verianla.
Dokezo la kuripoti ndani ya chanzo 2: Sehemu 5.4 inaeleza kuwa kila hali ya jaribio ilirudiwa mara 50, wakati Jedwali 7 linatoa “Total Data Points” ya 120 kwa kila hali. Saa sita na sampling interval ya dakika tatu zinalingana na sampuli 120 kwa jaribio moja; haijaelezwa jinsi jedwali lilivyojumlisha marudio 50.
Dokezo la kuripoti ndani ya chanzo 3: Formula ya Recognition Rate hutumia variable “Total Anomaly Data Points”; hata hivyo, Jedwali 7 halitoi thamani hii kando kwa kila hali. Kwa hiyo, asilimia za recognition zilizoripotiwa haziwezi kuzalishwa upya kwa kutumia safu nyingine mbili za jedwali pekee.
Dokezo la istilahi: Katika sehemu kuu za mbinu, anomaly score hufafanuliwa kama “prediction residual/error”, ilhali baadhi ya maelezo ya POT hutumia istilahi “reconstruction error”. Modeli si mfumo wa reconstruction unaotegemea autoencoder, bali ni modeli ya utabiri ya CNN-LSTM; kwa hiyo maelezo ya Verianla yanatumia “kosa/masalio ya utabiri” kama istilahi kuu.
Kikomo cha tafsiri ya utendaji: Sehemu ya matokeo ya chanzo inasisitiza ubora wa proposed model katika real-time throughput na edge suitability. Hata hivyo, Jedwali 5 linaonyesha kwamba LSTM hutumia rasilimali chache zaidi kuliko CNN-LSTM-POT ikiwa na inference latency ya 15,2 ms, memory ya 102,4 KB na nishati ya 3,04 mJ. Kwa hiyo, faida ya proposed model imefasiriwa si kama kasi ya inference pekee, bali kama uwiano kati ya detection accuracy na matumizi ya rasilimali.
Vikwazo vikuu: Data zinatoka tu kwenye mazingira ya greenhouse yaliyodhibitiwa kwa siku saba. Utafiti haujathibitishwa kwa long-term seasonal distribution shift, aina tofauti za mazao, uendeshaji wa greenhouse za kibiashara, fleets kubwa za sensa au vifaa tofauti vya gateway. Katika hali ngumu zaidi ya nodi nyingi–sensa nyingi, recognition rate hushuka hadi %70. Vigezo vya POT na sliding-window vinapaswa kurekebishwa upya kulingana na mazingira ya matumizi.
Mbinu ya kisayansi, vigezo vya modeli, thamani za majaribio, vipimo vya utendaji na vikwazo katika maelezo haya ya Verianla vinategemea utafiti uliopitiwa. Uthibitishaji wa nje umetumiwa tu kuthibitisha utambulisho wa bibliografia wa chapisho, jarida na hali ya peer review; hakuna matokeo mapya ya majaribio au thamani ya utendaji iliyoongezwa kutoka nje ya chanzo.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *