

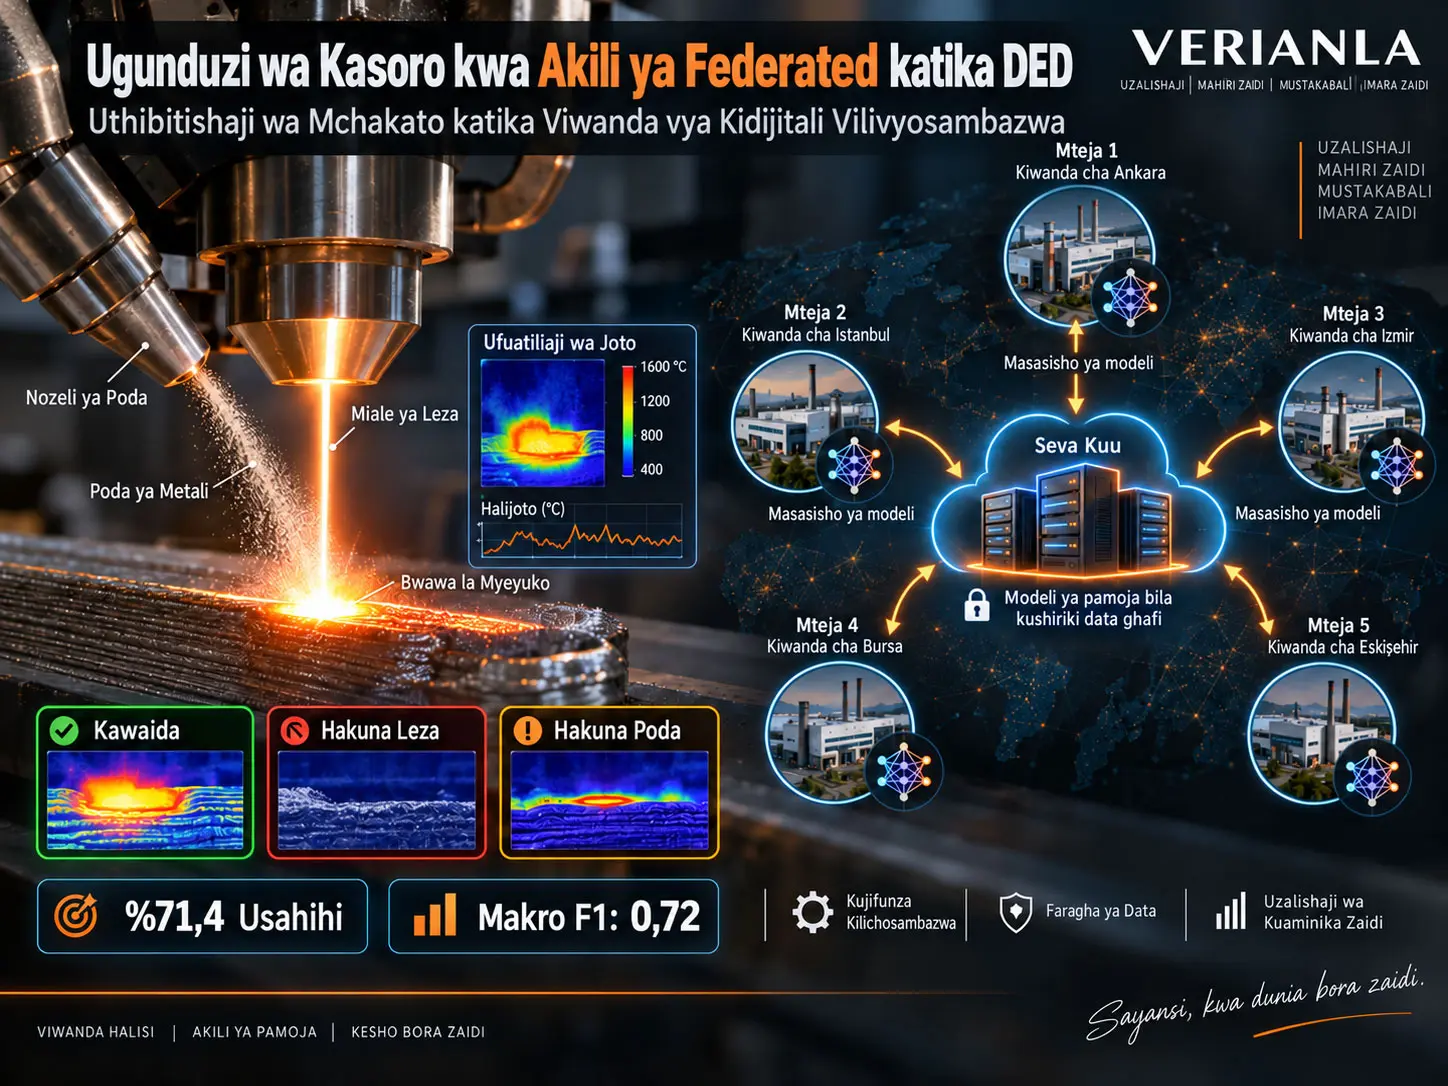
Directed Energy Deposition (DED) ni mbinu ya utengenezaji ongezi wa metali ambapo poda ya metali au waya huyeyushwa kwa chanzo cha joto chenye nishati kubwa na kuwekwa juu ya uso kwa tabaka. Katika mifumo ya DED, kuzimika kwa leza, kukatika kwa ulishaji wa poda au kutokuwa thabiti kwa mchakato wa joto kunaweza kuathiri moja kwa moja ubora wa sehemu. Utafiti huu unapendekeza mfumo wa msingi wa Federated Learning (FL) unaolenga kuwezesha maeneo tofauti ya uzalishaji kufundisha modeli ya pamoja ya uainishaji wa kasoro bila kuunganisha data ghafi za mchakato katika hifadhi moja ya kati. Data za jedwali za mashine na sensa zilizopatikana kutoka majaribio ya DED yaliyofanywa katika Missouri University of Science and Technology ziligawanywa katika vikundi vidogo vinavyowakilisha wateja watano wa federated; hali tatu za mchakato ziliainishwa: Normal, No Laser na No Powder. Mfumo hutumia urekebishaji wa vipengele kwa kiwango cha kimataifa, MLP ya kina yenye nodi 256–128–64–32, uzito ulioongezwa kwa darasa la No Powder na raundi 60 za Federated Averaging. Modeli ya mwisho ya kimataifa ilifikia usahihi wa %71.4 na macro F1 ya 0.72. Katika darasa la Normal F1 ilikuwa 0.86, katika No Powder F1 ilikuwa 0.68 na recall 0.83, huku No Laser ikiwa na F1 ya 0.62. Federated MLP ilionyesha utendaji wa madarasa ulio na uwiano mzuri zaidi kuliko MLP ya kina iliyowekwa katikati, wakati marejeo ya kati ya Random Forest na XGBoost yalifikia usahihi wa jumla ulio juu kidogo, karibu %73. Utafiti unaonyesha kwamba data ghafi za mchakato zinaweza kubaki kwa wateja; hata hivyo, kwa kuwa differential privacy au cryptographic secure aggregation haikutumika, matokeo hayapaswi kufasiriwa kama dhamana rasmi ya faragha. Aidha, wateja watano si viwanda vitano halisi na huru; ni mazingira ya federated yaliyosimuliwa kwa kugawanya chanzo kimoja cha data ya majaribio katika vikundi vidogo vitano.
Katika mtazamo wa Distributed Digital Factory (DDF), uwezo wa uzalishaji unaweza kusambazwa katika maeneo tofauti ya kimwili badala ya kuzingatiwa katika kiwanda kimoja. Katika muundo huu, ingawa kujenga modeli za pamoja za ubora kunavutia, mapishi ya uzalishaji, vigezo vya mashine, rekodi za sensa na matokeo ya mchakato huenda zisitakiwe kushirikiwa katika mfumo wa kati kwa sababu ya siri za biashara, miliki bunifu na usalama.
Federated Learning hutoa mtazamo tofauti kwa tatizo hili. Kila mteja hufundisha modeli ya ndani juu ya data yake mwenyewe; badala ya data ghafi, vigezo vya modeli hutumwa kwenye safu ya kati ya uunganishaji. Seva huunganisha masasisho haya, hutengeneza modeli mpya ya kimataifa na kuisambaza tena kwa wateja.
Federated Learning Inaunganishaje Data za DED Bila Kuzikusanya Katikati?
Katika federated learning kila mteja wa DED huhifadhi data zake za ndani za mashine na sensa katika eneo lake la data, husasisha modeli ya pamoja ya MLP kwa ndani na hutuma kwenye seva ya kati ya FedAvg uzito wa modeli pekee. Seva huunda modeli ya wastani iliyopimwa kwa ukubwa wa data za wateja; hivyo mifumo ya pamoja ya kasoro hujifunzwa bila kuhitaji kuhamisha rekodi ghafi za mchakato kwenye data lake ya kati.
Mfumo wa majaribio wa DED
Majaribio ya kimwili katika utafiti wa chanzo yalifanywa kwenye mfumo wa ndani wa DED uliotengenezwa katika Missouri University of Science and Technology. Mfumo unajumuisha leza ya Nd:YAG yenye pato la juu la 1 kW, mfumo wa mwendo wa mhimili mitatu XYZ, kichwa cha leza kutoka juu, nozzle ya ulishaji wa poda ya off-axis inayofanya kazi kwa pembe dhidi ya mhimili wa leza, mfumo wa gesi kinga na kishikilia substrate cha mviringo.
Ili kufuatilia tabia ya joto, thermocouple za aina ya K ziliwekwa kwenye substrate na kamera mbili za joto za kasi kubwa zilitumika. Kamera ya kwanza hutazama kutoka juu na kufuatilia usambazaji na kuenea kwa halijoto ya bwawa la kuyeyuka, huku kamera ya pili ikitazama kutoka upande na kufuatilia kina, jiometri na tabia ya kuganda.
Katika Figure 2 ya chanzo, eneo la joto limegawanywa katika maeneo matatu makuu:
- Kiini cha halijoto ya juu: \(T>900^\circ C\)
- Bwawa la kuyeyuka: \(T>850^\circ C\)
- Mushy zone: eneo la mpito wa kuganda
Kutoka kwenye taarifa hizi za joto na vigezo vya mashine hupatikana vipengele kama Melt Pool Area (MPA), mushy-zone temperature na peak temperature. Kiainishaji cha federated hakipeleki picha za joto moja kwa moja kwenye CNN; kinatumia vipengele vya jedwali vilivyotokana na mashine na sensa.
Hali tatu za mchakato
| Darasa | Maana ya kimwili |
|---|---|
| No Laser | Leza kutokuwa hai wakati wa uwekaji |
| No Powder | Ulishaji wa poda kukatika wakati leza ikiwa imewashwa |
| Normal | Mwingiliano thabiti wa leza–poda |
Je, Wateja Watano wa Federated Ni Viwanda Vitano Tofauti Kweli?
Hapana. Usanifu wa kimawazo wa utafiti unawakilisha viwanda vitano huru vya DED, lakini kwa mujibu wa sehemu ya mbinu, data za majaribio zilitokana na seti tatu halisi za hali za mchakato zilizopatikana kutoka mfumo wa DED wa Missouri S&T, na seti hizo ziligawanywa katika vikundi vidogo vitano ili kusimulia wateja watano huru. Kwa hiyo matokeo hayapaswi kufasiriwa kama uthibitishaji wa uga uliofanywa katika viwanda vitano halisi vya kijiografia vyenye tofauti za vifaa, nyenzo na waendeshaji.
Seti za data za wateja hutofautiana kati ya sampuli 149 na 989. Kila mteja hugawa data yake kwa %70 ya mafunzo na %30 ya majaribio kwa kutumia stratified random sampling. Chanzo hufafanua ukubwa tofauti wa sampuli na mgawanyo wa madarasa kama muundo wa non-independent and non-identically distributed (non-IID).
Tofauti hii ni muhimu: katika hali halisi ya multi-factory non-IID, mtengenezaji wa mashine, optics za leza, kalibresheni, aloi, jiometri, mwitikio wa sensa na tabia ya mwendeshaji zinaweza kubadilika. Utafiti huu haupimi moja kwa moja utofauti huo wa uga kwa majaribio; badala yake hugawanya data iliyopo katika vikundi tofauti vya wateja na kupima tabia ya uboreshaji wa federated.
Urekebishaji wa vipengele kwa kiwango cha kimataifa
Ili kulinganisha mizani ya vipengele kati ya wateja tofauti, wastani wa kimataifa \(\mu\) na mkengeuko wa kawaida \(\sigma\) hutumika:
\[ X^*=\frac{X-\mu}{\sigma}. \]
Chanzo kinasema kuwa ni thamani za \(\mu\) na \(\sigma\) pekee zinazotumwa kwa wateja na vipimo ghafi havishirikiwi. Hata hivyo, hakuna secure-aggregation tofauti au itifaki ya kriptografia iliyoelezwa kuhusu namna takwimu za kimataifa zilivyokusanywa kwa usalama kutoka kwa wateja.
Usanifu wa MLP ya Ndani na FedAvg Ulijengwaje?
Kila mteja hufundisha MLP ileile ya kina yenye safu 256–128–64–32; mafunzo ya ndani hudumu epoch tano na katika kila moja ya raundi 60 za mawasiliano uzito huunganishwa kwa njia ya FedAvg kwa uwiano wa kiasi cha data. Darasa la No Powder lilipewa uzito wa hasara mara tatu ili kuongeza recall ya hali hiyo.
| Safu | Muundo |
|---|---|
| 1 | Dense 256 + ReLU + Dropout 0.3 |
| 2 | Dense 128 + ReLU + Dropout 0.3 |
| 3 | Dense 64 + ReLU |
| 4 | Dense 32 + ReLU |
| Pato | 3 logits: No Laser, No Powder, Normal |
Uzito wa madarasa:
\[ w=[1.0,\ 3.0,\ 1.0] \]
uliwekwa hivyo. Mpangilio ni No Laser, No Powder na Normal.
Uboreshaji wa ndani hutumia Adam na:
learning rate = 0.001
na epoch tano huendeshwa ndani ya kila federated communication round.
FedAvg
Modeli ya kimataifa huhesabiwa kwa:
\[ \theta_{\mathrm{global}} = \sum_{k=1}^{K} \frac{n_k}{N} \theta_k \]
Hapa \(\theta_k\) ni vigezo vya modeli ya ndani ya mteja \(k\); \(n_k\) ni kiasi cha data ya mteja huyo na:
\[ N=\sum_{k=1}^{K}n_k \]
ni jumla ya idadi ya sampuli.
Kwa hiyo wateja wenye seti kubwa za data huchangia zaidi kwenye uzito wa kimataifa. Chanzo pia kinasema kuwa wateja wadogo wanaweza kuchangia utofauti wa gradient, hasa kwa mifumo ya kasoro iliyo nadra au tofauti.
Mbinu na Matokeo ya Utafiti
Muunganiko katika raundi 60 za mawasiliano
Katika Figure 6 usahihi wa kimataifa unaanza karibu %35. Katika raundi tano za kwanza huongezeka hadi karibu %58. Baada ya raundi ya kumi huendelea kwa muda mrefu katika eneo lilelile kwa mabadiliko madogo, kisha katika raundi kumi za mwisho huonekana kipindi cha pili cha kuongezeka na kufikia:
usahihi wa %71.4
kiwango hicho kinafikiwa.
Chanzo hutafsiri tabia hii kama federated convergence iliyo thabiti licha ya data non-IID za wateja.
Utendaji katika madarasa matatu
| Darasa | Precision | Recall | F1 | Support |
|---|---|---|---|---|
| No Laser | 0.70 | 0.56 | 0.62 | 997 |
| No Powder | 0.58 | 0.83 | 0.68 | 1038 |
| Normal | 1.00 | 0.75 | 0.86 | 1012 |
| Macro Avg | 0.76 | 0.71 | 0.72 | 3047 |
Darasa la Normal lina F1 ya juu zaidi. Precision ya 1.00 inaonyesha kuwa karibu sampuli zote ambazo modeli iliziita Normal katika seti ya majaribio zilikuwa kweli Normal; recall ya 0.75 inaonyesha kuwa takribani robo moja ya sampuli halisi za Normal zilihamishwa kwenda darasa jingine.
Darasa la No Powder lina recall ya kasoro iliyo juu zaidi: 0.83. Kwa upande mwingine precision yake ni 0.58; yaani modeli inapotoa utabiri wa No Powder hukusanya idadi kubwa ya false positive kutoka sampuli za No Laser na Normal.
Confusion matrix inaonyesha nini?
Katika confusion matrix ya chanzo kuna takribani:
| Halisi / Utabiri | No Laser | No Powder | Normal |
|---|---|---|---|
| No Laser | 560 | 437 | 0 |
| No Powder | 178 | 858 | 2 |
| Normal | 63 | 189 | 760 |
Hitilafu iliyo wazi zaidi iko katika mwelekeo wa No Laser → No Powder. Hili linaweza kuwa na maana ya kimwili; katika hali zote mbili mwingiliano wa kawaida wa nishati na nyenzo katika mchakato wa DED huvurugika, na ikiwa vigezo vya jedwali vya mashine/sensa pekee vinatumika, alama za hitilafu hizo mbili zinaweza kufanana.
Je, Modeli ya Federated Ni Bora Kuliko Modeli za Kati?
Siyo bora kuliko kila modeli. Federated MLP iliyopendekezwa ina usahihi wa %71.4 na macro F1 ya 0.72, hivyo inafanya vizuri zaidi kwa kiasi kikubwa kuliko MLP ya kina iliyowekwa katikati; hata hivyo, Random Forest na XGBoost za kati zilitoa alama za juu kidogo, karibu %73 usahihi na 0.736–0.737 macro F1. Faida kuu ya federated katika utafiti huu si kupata usahihi wa juu kabisa, bali kutoa utendaji wa ushindani na wa madarasa mengi ulio na uwiano mzuri bila kukusanya data ghafi mahali pamoja.
| Modeli | Accuracy | Macro F1 |
|---|---|---|
| Logistic Regression | 0.57 | 0.544 |
| SVM (RBF) | 0.70 | 0.688 |
| Random Forest | 0.73 | 0.737 |
| XGBoost | 0.73 | 0.736 |
| Centralized deep MLP | 0.58 | 0.484 |
| Proposed FL | 0.71 | 0.72 |
MLP ya kati ilishindwa hasa katika darasa la No Laser na kutoa F1 ya 0.00. Kwa upande mwingine federated MLP ilitoa F1 ya 0.62 kwa No Laser, 0.68 kwa No Powder na 0.86 kwa Normal.
Utafiti wa ablation
| Toleo la modeli | Accuracy | Macro F1 |
|---|---|---|
| Hakuna class weights | 61.8% | 0.59 |
| Shallow MLP | 63.5% | 0.62 |
| Hakuna global normalization | 66.2% | 0.65 |
| Modeli kamili | 71.4% | 0.72 |
Matokeo ya ablation yanaonyesha kwamba vipengele vyote vitatu vinachangia utendaji wa jumla. Kushuka kwa ukubwa zaidi hutokea class weights zinapoondolewa. Kuondoa global normalization pia kunaunga mkono wazo kwamba tofauti za mizani ya vipengele kati ya wateja zinaweza kuvuruga mafunzo.
Hoja ya uthibitishaji wa ndani ya chanzo kuhusu kutokuwiana kwa madarasa
Waandishi hulichukulia No Powder kama darasa la wachache na kuongeza uzito wake hadi 3.0. Hata hivyo, katika seti ya mwisho ya majaribio support ni No Laser = 997, No Powder = 1038 na Normal = 1012. No Powder si darasa lenye idadi ndogo zaidi katika seti hii iliyounganishwa. Pia, nguzo za madarasa kwa kila mteja katika Figure 4 hazionyeshi kutokuwiana kwa kiwango kikubwa sana kimataifa.
Kutokuwiana kwa madarasa kunaweza kuwa tata zaidi katika vikundi vidogo vya mafunzo ya ndani; lakini kwa kuwa idadi ya kina ya mteja×darasa haijawekwa katika jedwali, msingi kamili wa kiasi wa hoja ya class-weighting hauwezi kujengwa upya kutoka chanzo. Verianla huhifadhi jambo hili kama dokezo la uthibitishaji wa mbinu ndani ya chanzo.
“Privacy-Preserving” Hapa Inamaanisha Nini?
Katika utafiti huu “privacy-preserving” kimsingi humaanisha kwamba rekodi ghafi za mchakato wa DED hubaki kwa wateja wa ndani na ni masasisho ya modeli pekee yanayotumwa kwenye seva ya kati. Kwa kuwa differential privacy, secure multiparty computation, homomorphic encryption au cryptographic secure aggregation haikutumika katika makala, mbinu hii haipaswi kutathminiwa kama dhamana kamili ya faragha iliyo rasmi au inayostahimili mashambulizi.
Tofauti hii ni muhimu kwa mazingira ya uzalishaji. Kutoziweka katikati rekodi ghafi za nguvu ya leza, kasi, ulishaji wa poda, sensa na mchakato wa joto ni faida muhimu kwa miliki bunifu na mamlaka juu ya data. Hata hivyo, uzito wa modeli au gradient pia unaweza kuvuja taarifa katika baadhi ya modeli za mashambulizi. Chanzo hakikujaribu hatari hizi kwa majaribio.
Vivyo hivyo, neno “cyber-resilient” si matokeo ya ustahimilivu dhidi ya mashambulizi yaliyothibitishwa kwa majaribio katika utafiti. Mashambulizi ya Label-flipping, Byzantine client, model poisoning, gradient inversion au malicious-server hayakutumika katika seti ya majaribio ya utafiti huu.
Je, Darasa la Normal Linatoa Uthibitishaji wa Mchakato Kati ya Viwanda Kweli?
Utafiti unatetea kwamba darasa la Normal si lebo tu ya “hakuna kasoro”; linaweza kutumika kama hali ya uendeshaji iliyojifunzwa inayowakilisha mwingiliano thabiti wa leza–poda, saini za joto zinazolingana na mienendo inayokubalika ya vigezo vya mchakato. Wazo hili linaweza kuwa muhimu baadaye kwa kutathmini uthabiti wa mchakato kati ya viwanda; hata hivyo, utafiti wa sasa haukufanya qualification halisi ya viwanda vingi, certification au uthibitishaji wa ubora wa sehemu.
Kwa maneno mengine, kutambuliwa kwa uthabiti kwa hali ya Normal na modeli ya kimataifa katika vikundi tofauti vya wateja kunaweza kuwa kiashiria cha awali cha process-state validation. Lakini matokeo haya hayachukui nafasi ya:
- uthibitishaji wa sifa za kimitambo,
- upimaji wa porosity,
- uthibitishaji wa microstructure,
- uhakiki wa vipimo,
- certification ya sehemu za anga/tiba
.
Matokeo yanayoungwa mkono na utafiti
- Modeli ya pamoja ya MLP inaweza kufundishwa kwa FedAvg bila kuhamisha data ghafi za DED kwenye data lake moja ya kati.
- Chini ya wateja watano waliosimuliwa, federated training ya raundi 60 ilifikia muunganiko kwa uthabiti.
- Modeli kamili ilitoa usahihi wa %71.4 na macro F1 ya 0.72.
- Recall ya No Powder ilifikia 0.83.
- Federated MLP ilionyesha utendaji wa madarasa ulio na uwiano mzuri zaidi kuliko centralized deep MLP.
- Global normalization, mtandao wa kina na class weighting zilichangia utendaji katika matokeo ya ablation.
- Darasa la Normal linaweza kutumika kama kiashiria kinachowezekana cha ufuatiliaji wa hali ya mchakato uliosambazwa.
Majumuisho yasiyoungwa mkono na utafiti
- Utafiti si jaribio la uga lililothibitishwa katika viwanda vitano halisi vya kijiografia.
- Kugawa data kwa wateja watano hakuwakilishi domain shift yote ya kweli ya mashine-kiwanda.
- Modeli ya federated haikuonyesha usahihi wa jumla ulio juu kuliko Random Forest na XGBoost.
- Neno “Privacy-preserving” halimaanishi dhamana ya differential privacy au faragha ya kriptografia.
- Neno “Cyber-resilient” halijathibitishwa kwa majaribio ya adversarial attack.
- Kutambuliwa kwa darasa la Normal peke yake si ushahidi wa ubora wa sehemu, sifa za kimitambo au certification.
- Modeli inaainisha hali tatu tu za mchakato; haijaonyeshwa kuainisha moja kwa moja kasoro zote za DED kama porosity, crack, lack-of-fusion au balling.
- Chanzo hakielezi kikamilifu kwa nini No Powder ni minority class inayohitaji class weight ya 3.0 ikizingatiwa thamani za mwisho za support zilizoripotiwa.
Kazi zijazo
Waandishi wanapendekeza katika siku zijazo kutumia sensa za ziada kama pyrometry, multispectral imaging na acoustic emission; kuongeza mbinu za robust aggregation dhidi ya masasisho mabaya au ya ubora wa chini kutoka kwa wateja; na kuunganisha federated learning na simuleringi za digital twin ili kuzalisha hali sintetiki za kasoro.
Maelezo ya Chanzo na Mbinu
Utafiti asilia:Federated Intelligence for Distributed Digital Factories: A Privacy-Preserving Framework for Process Validation and Defect-Risk Modeling in Directed Energy Deposition.
Waandishi: Md Sazol Ahmmed, Sung-Heng Wu, Sriram Praneeth Isanaka na Frank Liou.
Taasisi: Missouri University of Science and Technology, Rolla, Missouri, USA.
Mwandishi wa mawasiliano: Katika rekodi ya SSRN, Md Sazol Ahmmed.
DOI: 10.2139/ssrn.7205817.
Hali ya uchapishaji: Preprint ya kurasa 33 iliyochapishwa kwenye SSRN tarehe 30 Julai 2026 na ambayo haijapitia mapitio ya wenzao.
Miundombinu ya majaribio: Mfumo wa DED wenye leza ya Nd:YAG ya juu zaidi 1 kW uliotengenezwa katika Missouri S&T; mfumo wa mwendo wa XYZ, off-axis powder nozzle, gesi kinga, thermocouple ya aina ya K na kamera mbili za joto za kasi kubwa.
Wateja wa federated: Ingawa chanzo kinazungumzia kimawazo wateja watano wa viwanda vilivyosambazwa, sehemu ya mbinu inaeleza kuwa seti tatu halisi za hali za mchakato ziligawanywa katika vikundi vidogo vitano ili kusimulia wateja watano.
Data za kuingiza: Vipengele sita vya jedwali; mipangilio ya mashine, taarifa za nyenzo/sensa na vipimo vya mchakato kama Melt Pool Area, mushy-zone region temperature na peak temperature.
Modeli: 256–128–64–32 MLP, ReLU, 0.3 dropout katika safu mbili za kwanza, pato la madarasa matatu.
Federated training: FedAvg, 60 communication round, 5 local epoch kwa kila raundi, Adam, learning rate 0.001.
Class weights: [1.0, 3.0, 1.0] — No Laser, No Powder, Normal.
Programu: Python 3, PyTorch 2.x, NumPy, pandas, scikit-learn; mazingira ya Google Colab GPU.
Mpaka wa faragha: Imeonyeshwa kuwa data ghafi hubaki ndani; lakini differential privacy, secure aggregation au cryptographic privacy mechanism haikutumika.
Dokezo la uthibitishaji ndani ya chanzo: Ingawa darasa la No Powder linasemekana kupewa uzito kama minority class, thamani za mwisho za test support ni 997/1038/1012 na hazionyeshi wazi darasa dogo kimataifa. Kwa kuwa mgawanyo wa mafunzo ya ndani haujatolewa kwa maelezo ya kiasi ya kutosha katika chanzo, haiwezekani kujenga upya kikamilifu hoja hiyo.
Upatikanaji wa data: Hakuna Data Availability Statement iliyo tofauti na wazi inayoonekana katika chanzo; kwa hiyo hakuna taarifa iliyoongezwa kana kwamba kuna data repository ya umma.
Hakimiliki: Rekodi ya SSRN inasema haki zote zimehifadhiwa. Badala ya kunakili moja kwa moja vielelezo vya chanzo, kifaa cha DED, usanifu wa kiwanda cha federated na matokeo ya uainishaji vinapaswa kuchorwa upya kwa namna asilia kwa Verianla.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *