

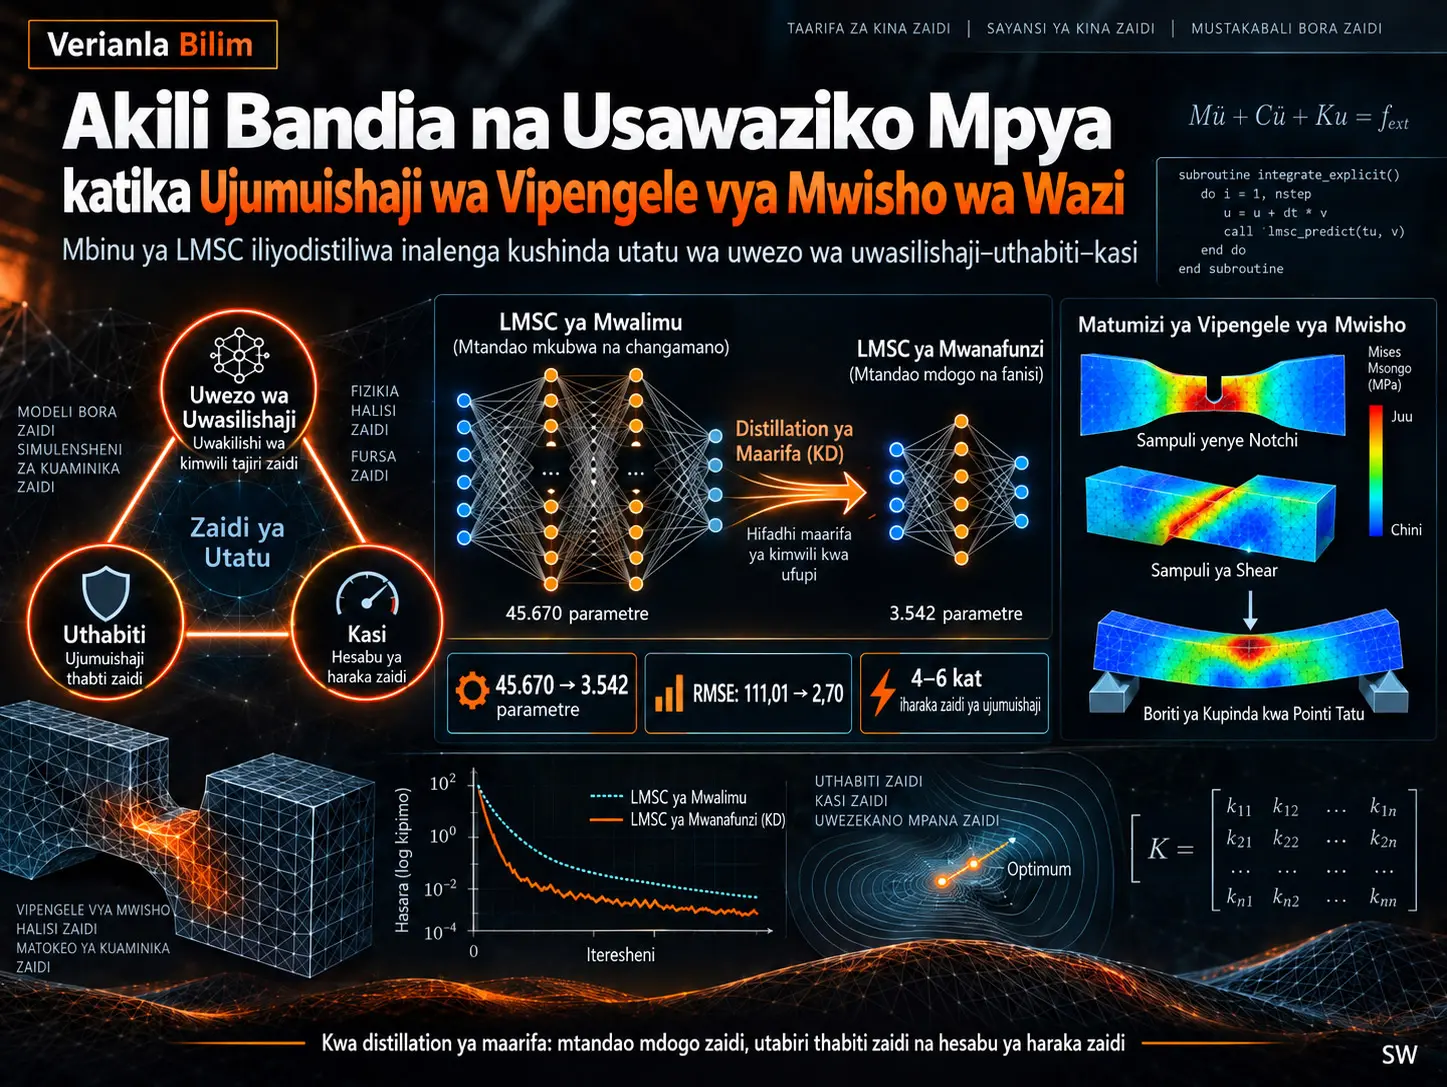
Katika uchanganuzi mkubwa wa vipengele vya mwisho wa wazi kama vile uundaji wa metali, modeli ya nyenzo ya kikonstitutivu huendeshwa tena na tena katika kila hatua ya muda na katika idadi kubwa sana ya nukta za ujumuishaji. Ingawa modeli ya kawaida ya von Mises yenye ukakamavu wa isotropiki inaaminika kimwili, tathmini hii ya mara kwa mara huleta gharama kubwa ya ukokotoaji. Modeli mbadala zinazotegemea mitandao ya neva zina uwezo wa kupunguza gharama hii; hata hivyo, mitandao midogo na ya haraka inaweza kuonyesha kutokuwa thabiti kwa kihesabu wakati wa ujumuishaji wa wazi kutokana na kuongezeka kwa makosa ya utabiri yanayofuatana.
Utafiti huu unafafanua mgongano huo kama “Utatu wa Uwezo wa Uwasilishaji–Uthabiti–Kasi” na kwa suluhisho unaunganisha Linearized Minimal State Cells (LMSC), ujumuishaji wa Abaqus VUMAT unaotegemea native Fortran na mbinu ya Knowledge Distillation (KD). Wakati modeli kubwa na yenye usahihi wa juu ya LMSC ya mwalimu ilikuwa na vigezo 45.670, mtandao wa mwanafunzi mwepesi sana ulipunguzwa hadi vigezo 3.542; hivyo kufikiwa takriban mara 12,89 ya ukandamizaji wa vigezo.
Hata hivyo, matokeo muhimu zaidi ya utafiti si kupunguza ukubwa wa modeli pekee. Mitandao midogo ambayo haijafanyiwa distillation inaweza kuonyesha kosa dogo kwenye mkusanyiko wa data wa nje ya mtandao, lakini katika ujumuishaji wa vipengele vya mwisho wa wazi inaweza kukusanya makosa ya mkazo hatua kwa hatua na kuwa isiyo thabiti. Kwa mfano, RMSE ya mtandaoni ya usanidi u=6, w=50 ilipanda hadi 111,01, ilhali baada ya knowledge distillation RMSE ya usanifu huohuo ilishuka hadi 2,70 na mkengeuko wa kikatastrofia ukaondolewa.
Katika uchanganuzi wa mvutano wenye notchi, shear na kupinda kwa nukta tatu, modeli za wanafunzi zilizofanyiwa distillation zilitengeneza nyuga za mkazo na mikondo ya mzigo–uhamisho iliyo karibu na suluhisho la marejeo la Abaqus von Mises. Kwa kutumia native Fortran, BLAS/VML, batch processing na uboreshaji wa mpangilio wa kumbukumbu, imeripotiwa kuwa katika uchanganuzi wenye iteresheni nyingi mtandao mdogo zaidi ulitoa muda wa ukokotoaji unaofanana na modeli iliyojengewa ndani ya Abaqus, na katika baadhi ya usanidi wa CPU hata muda mfupi kwa hadi %24.
Kwa nini kutumia mtandao wa neva hakumaanishi moja kwa moja uchanganuzi wa vipengele vya mwisho kuwa wa haraka zaidi?
Kubadilisha modeli ya kikonstitutivu na mtandao wa neva kunaweza kinadharia kupunguza gharama ya ujumuishaji wa kihisabati; lakini katika programu halisi ya vipengele vya mwisho si idadi ya shughuli za kihisabati za mtandao pekee iliyo muhimu. Kusoma uzani wa mtandao kutoka kwenye diski, kuhamisha data kati ya Python na Fortran, miito kwenda kwenye maktaba za nje za machine learning na utekelezaji usiofanisi wa operesheni ndogo za matrisi vinaweza kufuta kabisa faida ya kinadharia ya mtandao.
Chanzo kinaeleza kuwa mbinu ya awali ya ujumuishaji wa LMSC katika baadhi ya majaribio inaweza kufanya kazi polepole kwa mara 4–6 kuliko modeli ya kimwili iliyojengewa ndani ya Abaqus. Kwa hiyo waandishi hushughulikia tatizo la kasi si kama suala la “mtandao mdogo zaidi” pekee, bali pia kama tatizo la usanifu wa programu.
Utatu wa Uwezo wa Uwasilishaji–Uthabiti–Kasi ni Nini?
Kulingana na ufafanuzi wa utafiti, modeli mbadala ya kikonstitutivu yenye mafanikio lazima itimize masharti matatu kwa wakati mmoja: iweze kuwakilisha historia tata ya mkazo–mnyumbuliko kwa usahihi wa kutosha, ibaki thabiti katika ujumuishaji wa wazi wa kitanzi kilichofungwa bila kukuza makosa madogo ya kihesabu, na ifanye kazi kwa kasi ya kutosha kufanya uingizwaji wa modeli ya kimwili ya kikonstitutivu uwe na maana. Mitandao mikubwa hutoa uwezo wa uwasilishaji na uthabiti lakini ni polepole; mitandao iliyopunguzwa kupita kiasi ni ya haraka lakini inaweza kupoteza uwezo wa uwasilishaji au uthabiti wa mtandaoni.
Kwa nini usahihi wa nje ya mtandao unaweza kupotosha?
Katika jaribio la nje ya mtandao, mtandao hupewa taarifa sahihi ya historia ya kimwili katika kila hatua ya utabiri. Katika ujumuishaji wa vipengele vya mwisho wa wazi, hali ya ndani inayotolewa na mtandao katika hatua moja ya muda huhamishwa hadi hatua inayofuata.
Kwa hiyo kosa dogo:
- huingia kwenye kigezo cha hali ya ndani,
- hubadilisha kidogo utabiri unaofuata,
- utabiri uliobadilika huwa ingizo la hali inayofuata,
- kosa linaweza kukua kupitia mrejesho unaojirudia.
Chanzo kinaita hali hii autoregressive error accumulation.
Kwa mfano, modeli LMSC_u6_w25 inaonekana nzuri sana kwa test loss ya nje ya mtandao:
Losstest = 9,9 × 10⁻⁵
Lakini RMSE ya mtandaoni ndani ya Abaqus VUMAT:
RMSE = 5,10
inakuwa.
Kwa LMSC_u6_w50 tofauti ni kubwa zaidi:
Losstest = 6,17 × 10⁻³
Online RMSE = 111,01
Matokeo haya yanaonyesha kuwa uthabiti wa ujumuishaji wa wazi hauwezi kutathminiwa kwa kuangalia tu MSE ya nje ya mtandao au thamani ya validation loss.
Knowledge Distillation Inaufanyaje Mtandao Mdogo wa LMSC Kuwa Thabiti?
Katika utafiti huu, knowledge distillation haitumiki tu kama mbinu ya kuifundisha modeli ndogo matokeo ya modeli kubwa. Mtandao wa mwanafunzi hujifunza thamani halisi za mkazo kutoka Abaqus na pia njia laini zaidi na endelevu za mkazo kutoka kwa mtandao wa mwalimu wenye uwezo mkubwa. Waandishi wanapendekeza kuwa malengo haya laini hufanya nafasi ya uwakilishi wa ndani ya mtandao mdogo kuwa laini zaidi na kuunda aina ya uratibu wa kitopolojia dhidi ya ukuaji wa makosa yanayofuatana.
Modeli ya mwalimu
Mwalimu aliyechaguliwa:
- Kipimo cha hali: u = 10
- Upana wa safu iliyofichwa: w = 100
- Idadi ya safu zisizo za mstari: d = 3
- Vigezo: 45.670
- Offline test loss: 9,16 × 10⁻⁵
- Online RMSE: 1,79
Mtandao huu una uwezo mkubwa wa uwasilishaji na uthabiti; lakini gharama ya forward pass katika kiwango cha komponenti ni kubwa.
Mwanafunzi mwepesi sana
LMSC_u6_w25:
- u = 6
- w = 25
- Vigezo 3.542
- Takriban 12,89× ndogo kuliko mwalimu
Baada ya KD, uzani bora wa distillation uliripotiwa kuwa takriban α = 0,6.
Mwanafunzi wa w=50
LMSC_u6_w50 ilionyesha mkengeuko mkubwa wa mtandaoni kabla ya distillation. Katika utafiti, uzani bora wa KD ulichaguliwa kuwa takriban α = 0,9.
| Modeli | Test loss | Online RMSE |
|---|---|---|
| Mwalimu LMSC_u10_w100 | 9,16×10⁻⁵ | 1,79 |
| LMSC_u6_w25 | 9,90×10⁻⁵ | 5,10 |
| LMSC-KD_u6_w25_α0.6 | 1,04×10⁻⁴ | 3,94 |
| LMSC_u6_w50 | 6,17×10⁻³ | 111,01 |
| LMSC-KD_u6_w50_α0.9 | 2,8×10⁻⁵ | 2,70 |
Hasara ya knowledge distillation
Hasara katika mafunzo ya mwanafunzi inajumuisha kwa pamoja lebo halisi za Abaqus na malengo laini ya mtandao wa mwalimu:
\[ L_{\mathrm{student}} = \alpha \frac{1}{N} \sum \left\| \hat{y}_{student}-y_{true} \right\|^2 + (1-\alpha) \frac{1}{N} \sum \left\| \hat{y}_{student}-\hat{y}_{teacher} \right\|^2 \]
Neno la kwanza linawakilisha ulinganifu na lebo halisi za kimwili, na la pili linawakilisha ulinganifu na njia laini zaidi ya kikonstitutivu ya mwalimu.
Loss landscape inaonyesha nini?
Kielelezo 15 cha chanzo na grafu kwenye ukurasa wa 56 wa PDF zinaonyesha uso wa loss chini ya perturbation ndogo za uzani wa modeli.
Katika mtandao wa mwalimu, uso unaozunguka minimum ni mpana na kwa kiasi fulani una ulinganifu. Katika modeli ndogo ambazo hazijafanyiwa distillation, maeneo makali zaidi, membamba na yasiyo na ulinganifu yanaonekana. Baada ya KD, uso unaozunguka minimum wa mitandao ya wanafunzi unakuwa tena wenye mpangilio zaidi.
Waandishi wanahusisha muundo huu mpana na laini wa minimum na ustahimilivu mkubwa zaidi dhidi ya perturbation ndogo za hali ya ndani zinazotokea wakati wa ujumuishaji endelevu.
Uamilishaji wa neuroni unaonyesha nini?
Grafu za violin kwenye ukurasa wa 57 wa chanzo zinalinganisha usambazaji wa uamilishaji wa tanh.
Modeli ya mwalimu hufanya kazi takriban katika:
−0,709 hadi +0,573
masafa.
Mtandao u6_w50 ambao haujafanyiwa distillation hufikia takriban:
−0,867
katika minimum. Derivative ya tanh:
\[ \frac{d}{dx}\tanh(x)=1-y^2 \]
kwa hiyo, kwa hesabu ya waandishi, gradient ya eneo inayobaki katika sehemu hii hushuka hadi takriban %24,8.
Baada ya KD, uamilishaji wa kiwango cha chini unasogezwa hadi takriban −0,521 na mtiririko wa gradient katika sehemu dhaifu zaidi huongezeka hadi takriban %72,8.
Kinyume chake, tatizo la mtandao u6_w25 si saturation, bali uamilishaji kubanwa kupita kiasi katika takriban −0,298 hadi +0,289. Chanzo kinaita hali hii “topological stiffness”. Baada ya KD, masafa ya uamilishaji hupanuka na uwezo wa mtandao wa uwakilishi usio wa mstari huongezeka.
Kwa Nini Ujumuishaji wa Native Fortran ni Muhimu Sana?
Kuwa na modeli ya machine learning yenye kasi haitoshi ikiwa safu inayoiunganisha na programu ya vipengele vya mwisho ni polepole. Kwa sababu hiyo, utafiti huu ulitekeleza tena forward pass yote ya LMSC ndani ya VUMAT kwa native Fortran.
Hakuna mazingira ya nje ya utekelezaji wa ML
Wakati wa utekelezaji hakuna mwito wa PyTorch au TensorFlow. Uzani wa mtandao husomwa mara moja tu mwanzoni mwa simuleringi na baadaye huhifadhiwa katika muundo wa read-only Fortran MODULE ulioko RAM.
BLAS na VML
Operesheni nzito za matrisi zimewekewa vectorization kwa BLAS, na kazi kama tanh na exp kwa kutumia Intel MKL Vector Mathematical Library.
Mpangilio wa kumbukumbu
Matrisi za uzani hutranspose mapema kwa mujibu wa muundo wa kumbukumbu wa column-major wa Fortran. Lengo ni kutoa ufikiaji wa stride-1 ili kuboresha matumizi ya CPU cache na utendaji wa SIMD.
Batch processing
Nukta za ujumuishaji hupangwa kwa vifurushi badala ya kuchakatwa moja moja. Chanzo kinatoa kama mfano:
BATCH_SIZE = 128
thamani.
Kwa njia hii, badala ya miito midogo ya mtandao mmoja mmoja, operesheni nzito za matrisi zinazoweza kufanyiwa vectorization hutekelezwa.
Mbinu na Matokeo ya Utafiti
Uundaji wa data za mafunzo
Katika uzalishaji wa data, kipengele kimoja cha C3D8R chenye nodi 8 na reduced-integration kilitumika.
Training set:
- Njia 10.000 huru za mnyumbuliko
Validation set:
- Njia 1.000 huru za mnyumbuliko
Kila njia iliundwa kwa segmenti 125 za piecewise-linear. Kila segmenti iligawanywa katika hatua ndogo 16 na hivyo:
125 × 16 = 2.000 ongezeko ndogo za mnyumbuliko
zikapatikana.
Njia za nasibu ziliundwa ili mpaka wa elastiki-plastiki, kupakia upya na mabadiliko ya mwelekeo yatokee mara kwa mara.
Modeli ya nyenzo ya marejeo
Modeli ya marejeo inaunganisha sharti la yield la kawaida la von Mises na ukakamavu wa isotropiki wa Swift.
Mkazo sawia wa Von Mises:
\[ \bar{\sigma} = \sqrt{\frac{3}{2}\mathbf{s}:\mathbf{s}} \]
Sharti la yield:
\[ f= \bar{\sigma} - \sigma_y(\bar{\varepsilon}^{p}) \leq 0 \]
Ukakamavu wa Swift:
\[ \sigma_y = K \left( \varepsilon_0+\bar{\varepsilon}^{p} \right)^n \]
| E | ν | K | ε₀ | n |
|---|---|---|---|---|
| 70.000 MPa | 0,32 | 650 MPa | 0,0001 | 0,07 |
Sifa kuu ya LMSC
LMSC hutenganisha ukubwa wa ongezeko la mnyumbuliko na mwelekeo wake. Kwa njia hii inajaribiwa kupunguza utegemezi bandia wa ukubwa wa muda/hatua unaobadilika wa FE kwenye hali ya ndani ya RNN.
Usasishaji wa hali ya ndani hufanywa kwa fomu ya uchanganuzi katika chanzo, na kutumia usasishaji wa closed-form badala ya ujumuishaji wa kihesabu wa hatua tofauti kama Forward Euler ni msingi wa sifa ya self-consistency ya LMSC.
Jaribio la mzunguko la kipengele kimoja
Teacher model ilifuatilia mizunguko ya marejeo ya mkazo–mnyumbuliko kwa karibu hadi karibu kufanana kabisa.
Katika mtandao u6_w25 kabla ya distillation, mkengeuko mdogo huonekana hasa kwenye pembe za elastiki-plastiki.
Katika mtandao u6_w50, chini ya mzunguko endelevu, amplitude drift huongezeka hatua kwa hatua na kuwa mkengeuko wa makroskopiki.
Baada ya KD, mizunguko ya mkazo ya mitandao yote miwili ilikaribia tena mkondo wa marejeo. Grafu kwenye kurasa 42–44 za PDF zinaonyesha wazi tofauti hii.
Mvutano wenye notchi
| Modeli | Mises ya Juu Zaidi | Tofauti na marejeo |
|---|---|---|
| Marejeo ya Abaqus | 557,2 MPa | — |
| Teacher | 560,5 MPa | +3,3 MPa |
| u6_w25 | 565,7 MPa | +8,5 MPa |
| KD u6_w25 | 558,0 MPa | +0,8 MPa |
| u6_w50 | 644,3 MPa | +87,1 MPa |
| KD u6_w50 | 556,7 MPa | −0,5 MPa |
Jaribio la shear
| Modeli | Mises ya Juu Zaidi |
|---|---|
| Marejeo | 609,5 MPa |
| Teacher | 607,2 MPa |
| u6_w25 | 611,3 MPa |
| KD u6_w25 | 607,9 MPa |
| u6_w50 | 646,5 MPa |
| KD u6_w50 | 608,5 MPa |
Kupinda kwa nukta tatu
| Modeli | Mises ya Juu Zaidi |
|---|---|
| Marejeo | 598,8 MPa |
| Teacher | 597,3 MPa |
| u6_w25 | 595,4 MPa |
| u6_w50 | 648,0 MPa |
| KD u6_w50 | 597,6 MPa |
Kontua za Mises kwenye kurasa 45–47 za chanzo zinaonyesha si tu thamani ya juu zaidi, bali pia kwamba baada ya KD mipaka ya anga ya mikanda yenye mkazo mkubwa inakaribia suluhisho la marejeo.
Tabia ya mzigo–uhamisho
Takriban mizigo ya kilele ya modeli za marejeo:
- Mvutano wenye notchi: 2,67 kN.
- Shear: 1,00 kN.
- Kupinda kwa nukta tatu: 30,72 kN.
Mtandao u6_w50 ambao haujafanyiwa distillation hufikia takriban:
- 3,37 kN,
- 1,09 kN,
- 37,17 kN
katika vilele na hivyo kutoa makadirio ya juu kupita kiasi katika majaribio yote matatu.
Baada ya KD, mikondo ya mzigo–uhamisho ya modeli za wanafunzi inaingiliana kwa kiasi kikubwa na mikondo ya marejeo na mwalimu. Tabia hii inaonekana kwenye grafu tatu katika kurasa 48–50 za PDF.
Muda wa ukokotoaji
Katika uchanganuzi wa mvutano wenye notchi, kwa takriban iteresheni 1.000.000, muda uliotolewa katika chanzo kwa modeli u6_w25 iliyoboreshwa ni:
| CPU | Abaqus Ref | Optimize LMSC |
|---|---|---|
| 1 | 7.909 s | 6.528 s |
| 2 | 7.485 s | 5.689 s |
| 4 | 5.717 s | 5.488 s |
| 8 | 5.710 s | 5.421 s |
| 16 | 5.674 s | 5.379 s |
Katika hali hii ya iteresheni nyingi, LMSC ni ya haraka kuliko marejeo katika usanidi wote wa CPU.
Katika takriban iteresheni 100.000, faida inaweza kutoweka kwa sababu gharama za kuanzisha na miito ya VUMAT zinakuwa sehemu kubwa zaidi.
Gharama ya muda ya ukubwa wa mtandao
Katika jaribio la kupinda kwa nukta tatu lenye CPU 16 na takriban iteresheni 1.000.000, chanzo kinaripoti takriban:
- Ref: 3.347 s
- u6_w25-opt: 6.796 s
- u10_w100-opt: 15.417 s
.
Mfano huu unaonyesha mpaka muhimu: mtandao mkubwa na sahihi zaidi unaweza kuwa na usahihi wa juu wa kikonstitutivu lakini ukaleta adhabu kubwa ya kasi katika simuleringi halisi ya FE.
Sheria ya Amdahl na faida inayopungua
Katika mvutano wenye notchi kwa CPU 16:
- Teacher: 5.971 s
- Ultra-light student: 5.379 s
ingawa vigezo vya mtandao vinatofautiana kwa mara 12,89.
Sababu ni kwamba muda wa jumla wa FE hauundwi na modeli ya kikonstitutivu pekee. Mawasiliano sambamba, contact, usasishaji wa kinematiki na operesheni za history-variable huwa sehemu kubwa zaidi ya muda wa jumla kadiri modeli inavyopungua.
Matokeo yanayoungwa mkono moja kwa moja na utafiti
- Ujumuishaji wa native Fortran umeondoa gharama kubwa za I/O na cross-language ikilinganishwa na mbinu za awali za LMSC embedding.
- Knowledge distillation imeongeza kwa kiasi kikubwa uthabiti wa mtandaoni wa open-FE wa mitandao midogo ya LMSC.
- Thamani ndogo ya loss ya nje ya mtandao si kiashiria cha kutosha cha uthabiti wa mtandaoni.
- Baada ya KD, RMSE ya mtandaoni ya mtandao u6_w50 ilishuka kutoka 111,01 hadi 2,70.
- Mwanafunzi mwenye vigezo 3.542 ni takriban 12,89× mdogo kuliko mwalimu mwenye vigezo 45.670.
- Modeli zenye KD zilitoa matokeo yaliyo karibu na marejeo katika nyuga za mkazo za mvutano, shear na kupinda kwa nukta tatu.
- Katika baadhi ya hali za iteresheni nyingi, modeli ultra-light iliyoboreshwa ilitoa muda mfupi wa wall-clock kuliko modeli ya Mises iliyojengewa ndani ya Abaqus.
- Loss landscape na usambazaji wa uamilishaji vinaonyesha kuwa baada ya KD jiometri ya uwakilishi wa ndani imebadilika.
Matokeo ambayo utafiti hauungi mkono moja kwa moja
- Haijathibitishwa kuwa kila modeli ya kikonstitutivu ya mtandao wa neva itakuwa thabiti kwa knowledge distillation.
- KD haitoi dhamana ya kihisabati ya uthabiti kwa uchanganuzi wote wa vipengele vya mwisho wa wazi.
- Kupungua kwa idadi ya vigezo kwa mara 12,89 hakumaanishi kuwa suluhisho la FE linakuwa la haraka kwa mara 12,89.
- LMSC si ya haraka kuliko modeli iliyojengewa ndani ya Abaqus katika idadi zote za iteresheni na komponenti zote.
- Utafiti hautumii majaribio halisi ya kimwili ya mvutano/shear/kupinda kama ground truth ya uthibitishaji; marejeo makuu ni modeli ya kawaida ya Mises ya Abaqus.
- Tabia ya plastiki anisotropiki, utegemezi wa kasi, uharibifu au kuvunjika havijathibitishwa katika utafiti huu.
- Mbinu ya “topological regularizer” ni tafsiri ya waandishi inayoungwa mkono na uchanganuzi wa loss-landscape na uamilishaji; si theorem ya jumla ya kihisabati.
Maelezo ya Chanzo na Mbinu
Kichwa asilia:Breaking the Expressivity-Stability-Speed Trilemma in Explicit FE Integration via Distilled Linearized Minimal State Cells
Waandishi: Xudong Yang; Yanfeng Yang; Heng Li.
Taasisi: State Key Laboratory of Solidification Processing, School of Materials Science and Engineering, Northwestern Polytechnical University; Research & Development Institute of Northwestern Polytechnical University in Shenzhen.
Aina ya chanzo: Preprint ya mechanics ya ukokotoaji / uundaji modeli wa kikonstitutivu unaosaidiwa na machine learning.
Jukwaa: SSRN.
Nambari ya rekodi ya SSRN: 7381099.
Hali ya peer review: Kazi iliyopakiwa inaeleza katika kila ukurasa kwamba haijapitia peer review.
Modeli ya kikonstitutivu ya marejeo: kigezo cha yield cha von Mises (J2) + ukakamavu wa isotropiki wa Swift.
Programu ya marejeo ya vipengele vya mwisho: Abaqus/Standard kwa uzalishaji wa data na Abaqus/Explicit VUMAT kwa ujumuishaji.
Mtandao mkuu wa neva: Linearized Minimal State Cells (LMSC).
Mbinu kuu ya ukandamizaji/uratibu: Knowledge Distillation.
Mwalimu: u=10, d=3, w=100; vigezo 45.670.
Mwanafunzi mwepesi sana: u=6, w=25; vigezo 3.542; takriban 12,89× ukandamizaji wa vigezo.
Mkusanyiko wa data: njia 10.000 za training na 1.000 za validation za mnyumbuliko; segmenti 125 na ongezeko ndogo 2.000 kwa kila njia.
Uthibitishaji wa kimuundo: Mvutano wenye notchi, shear ya eneo na kupinda kwa nukta tatu.
Uboreshaji wa programu: Library-free native Fortran, upakiaji wa vigezo mara moja, global read-only weights, BLAS, Intel MKL VML, memory transposition, ufikiaji wa stride-1, batch processing na SIMD.
Upatikanaji wa data: Waandishi wanaeleza kuwa data zote zilizokokotolewa au kuchambuliwa katika utafiti huu zimo ndani ya makala.
Ufadhili: Utafiti uliungwa mkono na National Natural Science Foundation of China na programu mbalimbali za utafiti za Shenzhen, Shaanxi na vyuo vikuu vya kati.
Mgongano wa maslahi: Waandishi wanatangaza kuwa hakuna maslahi yanayoshindana.
Taarifa ya matumizi ya AI: Waandishi wanaeleza kuwa walitumia Gemini 3 Pro kuboresha sarufi na mtiririko wa lugha; walihakiki na kuhariri wenyewe maudhui ya kiufundi na wanachukua jukumu la matokeo.
Mpaka mkuu wa kisayansi: Utafiti hautumii historia ya mkazo iliyopimwa kutoka kwa sampuli za metali za majaribio kama physical ground truth; badala yake unatumia modeli ya von Mises–Swift ndani ya Abaqus. Kwa hiyo mafanikio yaliyoonyeshwa kimsingi ni kuzalisha upya modeli ya kawaida ya kikonstitutivu ya kihesabu kwa modeli mbadala yenye gharama ndogo.
Mpaka wa ujumlishaji: Anisotropic yielding, viscoplasticity na continuum damage mechanics zinatajwa tu kama maeneo ya kazi ya baadaye.
Mpaka wa uthabiti: Matokeo ya “catastrophic autoregressive divergence eliminated” ya utafiti ni matokeo ya ukokotoaji wa kimajaribio kwa modeli na njia za upakiaji zilizochunguzwa; si dhamana rasmi ya uthabiti kwa matatizo yote ya open FE.
Mpaka wa kasi: Faida ya kasi inategemea idadi ya iteresheni, ukubwa wa mtandao, idadi ya CPU na aina ya tatizo. Katika uchanganuzi wenye iteresheni chache, modeli native ya Abaqus inaweza kuwa ya haraka zaidi.
Mpaka wa Amdahl: Kadiri mtandao unavyopungua, constitutive inference huwa sehemu ndogo zaidi ya muda wa jumla wa ukokotoaji; kwa hiyo faida ya wall-clock kutokana na ukandamizaji wa vigezo si ya mstari.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *