

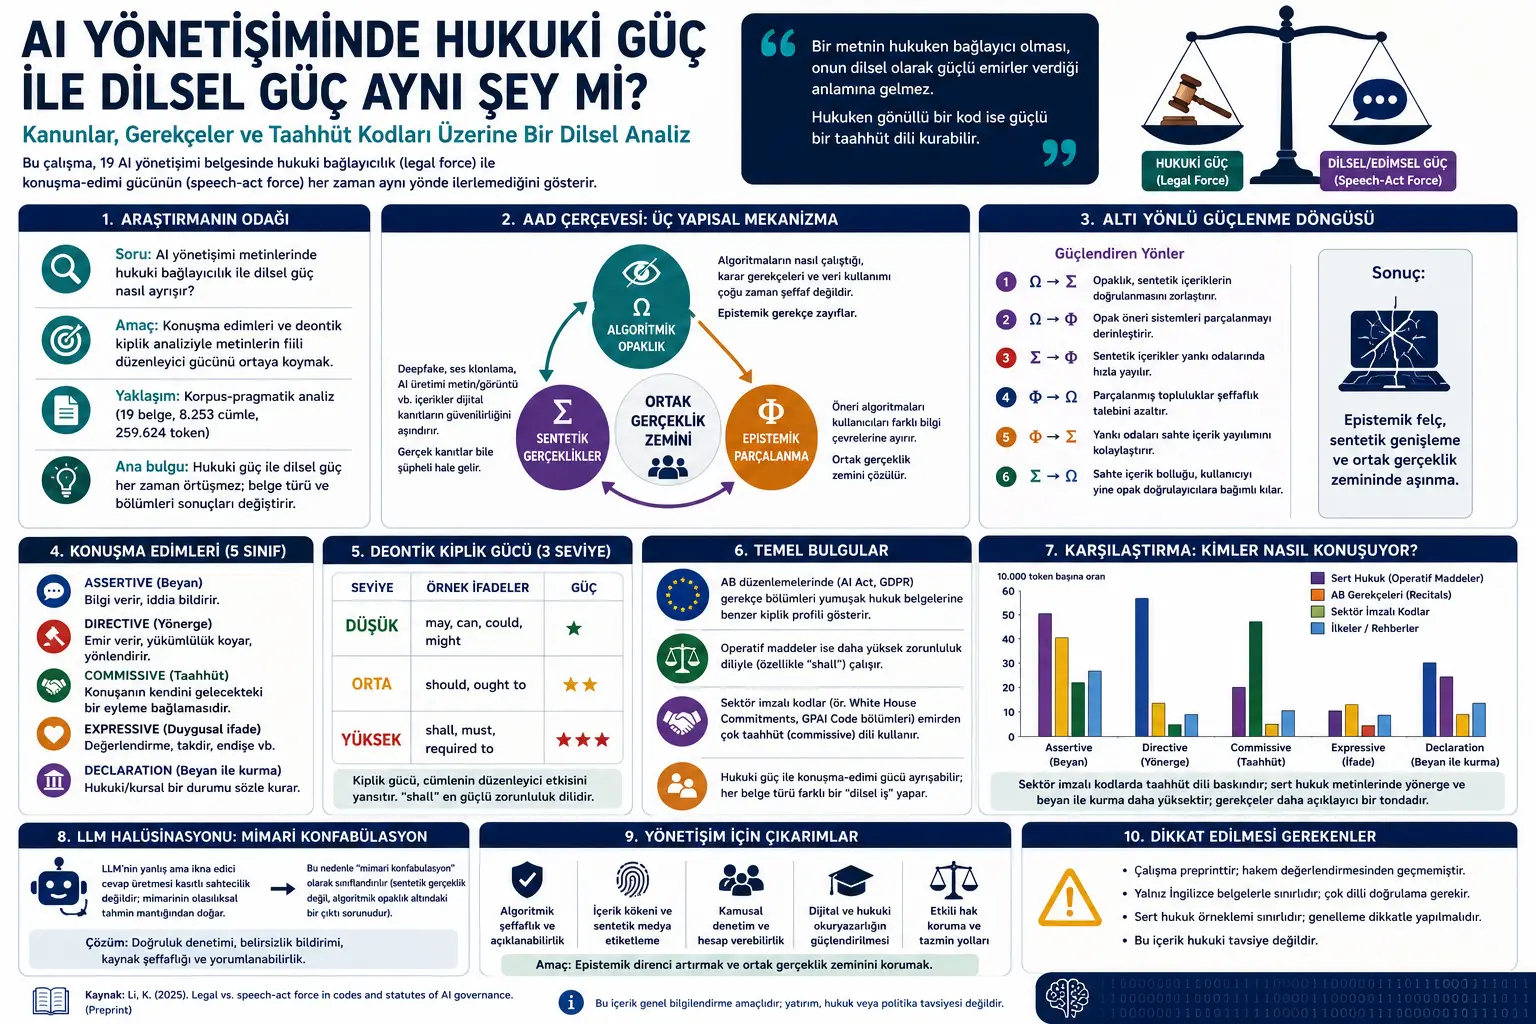
Bu çalışma yapay zekâ yönetişimi, hukuk dili, edimbilim, korpus dilbilimi ve düzenleyici metin analizi alanlarının kesişiminde yer alan bir preprint makaledir. Metinde çalışmanın hakem değerlendirmesinden geçmediği açıkça belirtilmektedir. Bu nedenle çalışma, kesinleşmiş hakemli yayın gibi değil; yapay zekâ yönetişimi belgelerinin dilsel işleyişini inceleyen güncel ve tartışmaya açık bir araştırma olarak okunmalıdır.
Makalenin ana sorusu şudur: Bir AI yönetişimi metninin hukuken bağlayıcı olması, onun dilsel olarak da güçlü emirler verdiği anlamına gelir mi? Ya da hukuken bağlayıcı olmayan bir sektör kodu, dilsel olarak güçlü bir taahhüt dili kurabilir mi? Yazar bu sorulara “evet/hayır” düzeyinde değil, metin içindeki konuşma edimleri ve kiplik dağılımları üzerinden yanıt arar.
Konuşma edimi, bir cümlenin yalnız bilgi aktarmakla kalmayıp aynı zamanda bir iş yapmasıdır. Örneğin “şunu yapmak zorundasın” bir yönlendirme; “şunu yapmayı taahhüt ediyoruz” bir taahhüt; “bu kavram şu anlama gelir” ise hukuki tanım kuran bir beyan olabilir. Deontik kiplik ise zorunluluk, izin, gereklilik ve tavsiye gibi düzenleyici dil güçlerini anlatır. İngilizce hukuk dilinde “shall”, “must”, “should”, “may” gibi ifadeler bu açıdan önemlidir.
Bu içerik hukuki tavsiye değildir. AI Act, GDPR, Colorado AI Act, GPAI Code of Practice veya benzeri düzenleme belgeleriyle ilgili uygulama kararları için güncel mevzuat, yetkili kurum açıklamaları ve hukuk uzmanlığı dikkate alınmalıdır.
Makale, yapay zekâ yönetişimi belgelerinin yalnız ne söylediğini değil, nasıl söylediğini inceliyor. Çalışmanın temel iddiası, hukuki bağlayıcılık ile konuşma-edimi gücünün birbirinden ayrılabileceğidir. Bir metin hukuken bağlayıcı olabilir; fakat bazı bölümleri dilsel olarak yumuşak, açıklayıcı veya gerekçelendirici bir tonda kalabilir. Tersine, hukuken gönüllü olan bir sektör kodu, şirketleri doğrudan “biz yapacağız” veya “taahhüt ediyoruz” diliyle güçlü biçimde kendine bağlayabilir.
Çalışma 19 AI yönetişimi belgesinden oluşan bir korpus kullanır. Korpus, AB Yapay Zekâ Tüzüğü, GDPR, Colorado AI Act, White House Voluntary Commitments, General-Purpose AI Code of Practice bölümleri, OECD ilkeleri, NIST çerçeveleri, HLEG etik rehberleri ve Avrupa Komisyonu yorumlayıcı belgeleri gibi farklı türde metinleri içerir.
Yazarın bulduğu iki ana ayrışma dikkat çekicidir. Birincisi, AB düzenlemelerinde gerekçe bölümleri, yani recitals, hukuken bağlayıcı metnin içinde yer alsa da kiplik açısından yumuşak hukuk belgelerine benzer. Operatif maddeler ise “shall” gibi yüksek zorunluluk diliyle daha sert bir düzenleyici kayıt oluşturur. İkincisi, sektör tarafından imzalanan AI kodları hukuken gönüllü görünse de “Companies will…” ve “Signatories commit to…” gibi ifadelerle güçlü bir kendini bağlama dili kurar.
Problem Ne?
Hukuk ve düzenleme metinleri çoğu zaman “sert hukuk” ve “yumuşak hukuk” ayrımıyla okunur. Sert hukuk, bağlayıcı kanun, tüzük veya yönetmelik gibi metinleri ifade eder. Yumuşak hukuk ise rehber, ilke, etik çerçeve, gönüllü taahhüt veya politika belgesi gibi doğrudan bağlayıcı olmayan metinleri kapsar. Ancak bu ayrım her zaman metnin dilsel işleyişini açıklamaz.
Makalenin ele aldığı temel problem, hukuki güç ile söz-edimi gücünün karıştırılmasıdır. Hukuki güç, metnin resmi hukuk düzeni içinde ne kadar bağlayıcı olduğuyla ilgilidir. Söz-edimi gücü ise metnin diliyle ne yaptığıdır: emir mi veriyor, tanım mı kuruyor, ilke mi açıklıyor, taahhüt mü oluşturuyor, yoksa yalnız bilgi mi aktarıyor?
Bu ayrım AI yönetişimi alanında özellikle önemlidir. Çünkü yapay zekâ düzenlemesi yalnız klasik kanun maddelerinden oluşmaz. Etik ilkeler, şirket taahhütleri, gönüllü kodlar, AB düzenlemelerinin gerekçeleri, yorumlayıcı kılavuzlar ve birlikte-düzenleme belgeleri aynı alanda yan yana bulunur. Bu belgelerin hepsi “AI yönetişimi”ne aittir; fakat aynı dilsel işlevi görmez.
Örneğin AB AI Act’in operatif maddeleri “şu yükümlülük uygulanır” gibi yüksek zorunluluk diliyle çalışabilir. Aynı metnin gerekçe bölümleri ise “üye devletler şunu dikkate almalıdır” gibi daha açıklayıcı veya yönlendirici bir ton kullanabilir. Benzer şekilde, hukuken gönüllü bir şirket taahhüdü “şirketler şunu yapacak” dediğinde, klasik emir vermese bile güçlü bir toplu söz verme etkisi doğurabilir.
Yöntem Ne Öneriyor?
Çalışma korpus-pragmatik bir yöntem kullanır. Korpus, belirli bir araştırma amacıyla toplanmış metin kümesidir. Bu makalede korpus, 19 AI yönetişimi belgesinden oluşur. Toplam analiz verisi 8.253 cümle ve 259.624 token olarak belirtilmiştir. Token, dil işleme çalışmalarında kelime, noktalama veya anlamlı metin parçası gibi sayılabilen birimlere verilen addır.
Yazar, belgeleri üç ana eksende sınıflandırır: sert hukuk/yumuşak hukuk ayrımı, sektör tarafından imzalanıp imzalanmama durumu ve belge türü. Ayrıca AB AI Act ve GDPR gibi AB düzenlemeleri gerekçe bölümü ve operatif maddeler olarak ayrıştırılır. Bu ayrım önemlidir; çünkü aynı hukuki belgenin farklı bölümleri farklı dilsel güçle çalışabilir.
Metinlerdeki konuşma edimleri kural tabanlı ve çözümleyici destekli bir sınıflandırıcıyla etiketlenir. Kural tabanlı yaklaşım, modelin hangi cümleyi neden hangi sınıfa koyduğunun izlenebilmesini sağlar. Bu, özellikle hukuk dili gibi denetlenebilirliğin önemli olduğu alanlarda avantajdır.
Sınıflandırıcı beş ana konuşma edimi sınıfı kullanır: assertive, directive, commissive, expressive ve declaration. Assertive, bilgi veren veya iddia bildiren cümlelerdir. Directive, okuyucuya veya muhataba bir şey yaptırmaya çalışan emir, zorunluluk veya yönlendirme cümleleridir. Commissive, konuşanın kendisini gelecekteki bir eyleme bağladığı taahhüt cümleleridir. Expressive, değerlendirme veya duygu bildiren ifadelerdir. Declaration ise hukuki ya da kurumsal bir durumu sözle kuran beyanlardır.
Çalışma ayrıca kiplik gücünü düşük, orta ve yüksek bantlara ayırır. “May”, “can”, “could” düşük; “should” ve “ought to” orta; “shall”, “must” ve “required to” yüksek deontik güç olarak değerlendirilir. Bu sayede metinlerin yalnız hangi konuşma edimini kullandığı değil, o edimi hangi güçle yaptığı da ölçülür.
Formüller Ne Anlatıyor?
Bu çalışma matematiksel teori kurmaktan çok dilsel sınıflandırma ve istatistiksel karşılaştırma yapar. Yine de yöntemi anlamak için bazı temel hesap ve gösterimler önemlidir. Aşağıdaki MathJax blokları, çalışmadaki ana ölçüm mantığını CMS uyumlu biçimde özetler.
Bu ifade, çalışmanın veri evrenini gösterir. Korpus; sert hukuk düzenlemeleri, sektör imzalı kodlar, ilkeler, etik rehberler, operasyonel çerçeveler ve yorumlayıcı belgeleri birlikte içerir.
Bu şema, sınıflandırıcının her cümleyi beş ana konuşma edimi kategorisinden birine yerleştirdiğini gösterir. Hukuk dili çoğu zaman birden fazla işlevi aynı anda taşıyabilir; çalışma pratik analiz için tek etiketli bir karar ağacı kullanır.
Bu formül, deontik kiplik gücünün üç seviyeli ölçümünü açıklar. Düşük kiplik izin veya olasılık; orta kiplik tavsiye veya gereklilik; yüksek kiplik ise güçlü zorunluluk ya da bağlayıcı emir etkisi üretir.
Bu hesap, farklı uzunluktaki belgelerin karşılaştırılabilmesi için konuşma edimi oranlarının 10.000 token başına normalize edildiğini gösterir. Böylece kısa bir belgeyle uzun bir tüzük daha adil karşılaştırılabilir.
Bu kısa ifade çalışmanın ana tezini özetler. Bir metnin hukuken bağlayıcı olması, her bölümünün aynı dilsel güçle emir verdiği anlamına gelmez. Aynı şekilde, hukuken gönüllü bir metin de güçlü taahhüt diliyle yüksek konuşma-edimi gücü üretebilir.
Bu ifade, AB düzenlemelerinin gerekçe bölümlerinin kiplik bakımından yumuşak hukuk belgelerine yakın durduğunu anlatır. Makalede EU AI Act ve GDPR gerekçelerinin modal güç ortalaması yaklaşık 1.97–1.99 iken operatif maddelerde bu değer yaklaşık 2.72–2.75 düzeyine çıkar.
Bu şema, sektör tarafından imzalanan belgelerde emir dilinden çok taahhüt dilinin baskın olduğunu gösterir. “Companies will…” ve “Signatories commit to…” gibi yapılar, düzenleyici işlevi emirden çok söz verme ve kendini bağlama yoluyla kurar.
Bu istatistikler yöntemin güvenilirliğini anlatır. Cohen’s kappa, iki insan etiketleyicinin ne kadar tutarlı çalıştığını gösterir. F1 skoru ise sınıflandırıcının doğruluk ve yakalama başarısını birlikte ölçer. Commissive sınıfındaki yüksek F1 değeri, çalışmanın sektör kodlarıyla ilgili ana taahhüt bulgusunun sınıflandırıcı hatasına karşı daha dayanıklı olduğunu gösterir.
Grafik, Tablo ve Şema Ana Mesajı
İlk ana tablo, yumuşak hukuk ve sert hukuk karşılaştırmasını verir. Sert hukuk metinleri daha yüksek kiplik gücü, daha fazla deklarasyon ve daha yoğun direktif dili gösterir. Buna karşılık yumuşak hukuk belgelerinde assertive yani açıklayıcı/bilgi verici cümle yoğunluğu daha fazladır. Ancak bu tablo tek başına tüm resmi açıklamaz; çünkü yumuşak hukuk grubu içinde sektör imzalı kodlar çok farklı bir dilsel profil sergiler.
İkinci ana tablo, AB düzenlemelerindeki gerekçe ve operatif madde ayrımını gösterir. EU AI Act ve GDPR’de gerekçe bölümlerinin kiplik gücü yaklaşık 1.97–1.99 aralığındadır. Operatif maddelerde ise değer yaklaşık 2.72–2.75’e çıkar. Bu, aynı hukuki belgenin içinde iki ayrı dilsel kayıt bulunduğunu gösterir. Gerekçeler daha çok “should” ve “may” çevresinde dönerken, operatif maddeler “shall” etrafında yoğunlaşır.
Üçüncü tablo, sektör imzalı belgelerle diğer belgeler arasındaki farkı gösterir. Sektör imzalı belgelerde commissive oranı yüksek, directive oranı düşüktür. Başka bir ifadeyle bu belgeler “siz şunu yapmalısınız” demekten çok “biz şunu yapacağız” veya “imzacılar şunu taahhüt eder” diliyle çalışır. Bu, klasik hukuk metni analizinde daha az dikkat gören bir düzenleyici güç biçimidir.
Principal component analysis görselleştirmesi, 19 belgeyi beş özellikli bir matris üzerinde kümeler halinde konumlandırır. Üç ana grup görünür: bağlayıcı düzenlemeler, sektör imzalı belgeler ve ilke/çerçeve türündeki açıklayıcı belgeler. Yazar eksenleri aşırı yorumlamaz; önemli noktanın, özellikle sektör imzalı belgelerin yöntemler arasında tutarlı biçimde ayrı bir küme oluşturması olduğunu belirtir.
Ek tablolarda korpusun belge dağılımı ayrıntılandırılır. EU AI Act, GDPR ve Colorado AI Act sert hukuk tarafını; White House Voluntary Commitments ve GPAI Code of Practice bölümleri sektör imzalı kodları; HLEG, OECD, NIST, OSTP ve Avrupa Komisyonu belgeleri ise farklı yumuşak hukuk, operasyonel çerçeve ve yorumlayıcı belge türlerini oluşturur.
Deneyler Nasıl Yapılmış?
Bu çalışma laboratuvar deneyi değil, korpus temelli dil analizi ve istatistiksel karşılaştırma çalışmasıdır. İlk adımda 19 AI yönetişimi belgesi toplanmış, düz metne dönüştürülmüş ve cümlelere ayrılmıştır. Çok kısa veya çok uzun cümleler, tablo kalıntıları ve sayfa düzeninden gelen artık parçalar analizin dışında bırakılmıştır.
İkinci adımda cümleler konuşma edimi sınıflarına ayrılmıştır. Bunun için spaCy tabanlı çözümleme, deontik operatör sözlükleri, commissive fiiller, declaration formülleri ve karar ağacı kullanılmıştır. Karar ağacında declaration önce, ardından commissive, expressive, directive ve assertive sınıfları gelir. Bu sıralama, bazı hukuk cümlelerinin birden fazla işlev taşıyabilmesi nedeniyle tercih edilmiştir.
Üçüncü adımda 300 cümlelik bir alt örneklem iki bağımsız dilbilim etiketleyicisi tarafından değerlendirilmiştir. Etiketleyiciler arası güvenilirlik yüksek bulunmuştur. Daha sonra kural tabanlı sınıflandırıcının bu insan etiketleriyle ne kadar uyumlu olduğu ölçülmüştür. Özellikle commissive sınıfındaki yüksek başarı, sektör imzalı belgelerdeki taahhüt yoğunluğu bulgusunu destekler.
Dördüncü adımda belgeler grup karşılaştırmalarına sokulmuştur. Önceden belirlenen ana karşılaştırma yumuşak hukuk ve sert hukuk ayrımıdır. Ayrıca sektör imzalı belgeler ile diğer belgeler karşılaştırılmış, sonra sektör belgeleri hariç tutularak ilkeler/rehberler ile bağlayıcı düzenlemeler karşılaştırılmıştır.
Beşinci adımda AB düzenlemeleri bölüm düzeyinde ayrıştırılmıştır. Gerekçe bölümleri ile operatif maddeler ayrı ayrı hesaplanmış ve modal güç, direktif oranı, deklarasyon oranı gibi ölçüler kıyaslanmıştır. Bu bölüm düzeyi analiz, makalenin en önemli katkılarından biridir; çünkü belge düzeyi ortalamaların gerçek dilsel farkı maskeleyebileceğini gösterir.
Sonuçlar Ne Gösteriyor?
Çalışmanın ilk ana sonucu, AB düzenlemelerinde gerekçe ve operatif madde bölümlerinin aynı dilsel kayıtla çalışmadığıdır. Gerekçeler hukuken bağlayıcı düzenleme içinde yer alsa da kiplik açısından yumuşak hukuk belgelerine benzer. Operatif maddeler ise yüksek deontik güçle, özellikle “shall” merkezli bağlayıcı dil kurar.
İkinci sonuç, belge düzeyinde yapılan analizlerin yanıltıcı olabileceğidir. EU AI Act’in tüm metni tek ortalama değerle incelendiğinde, gerekçe bölümlerinin yumuşaklığı ile operatif maddelerin sertliği birbirine karışır. Bu durumda ne gerekçelerin gerçek tonu ne de operatif maddelerin düzenleyici yoğunluğu net görünür. Bu nedenle hukuk dili analizi, bölüm düzeyini dikkate almalıdır.
Üçüncü sonuç, sektör imzalı AI kodlarının klasik yumuşak hukuk belgeleri gibi okunamayacağıdır. White House Voluntary Commitments ve GPAI Code of Practice bölümleri, yüksek commissive yoğunluğu gösterir. Yani bu belgeler emir vermek yerine imzacının kendisini eyleme bağladığı bir dil kullanır. Hukuken gönüllü olmaları, dilsel olarak zayıf oldukları anlamına gelmez.
Dördüncü sonuç, konuşma edimi gücünün hukuki güçten ayrılabileceğidir. Bir metin hukuken güçlü olabilir ama bazı bölümleri dilsel olarak daha yumuşak olabilir. Bir metin hukuken gönüllü olabilir ama dilsel olarak güçlü taahhütler kurabilir. Bu çift yönlü ayrışma, AI yönetişimi metinlerini yalnız “bağlayıcı/bağlayıcı değil” diye ayırmanın yetersiz olduğunu gösterir.
Beşinci sonuç, yorumlayıcı belgelerde assertive ve declaration sınırının metodolojik olarak zor olduğudur. Bir cümle aynı yüzey biçimine sahip olsa bile, ana düzenlemede yer aldığında hukuki gerçeklik kurabilir; yorumlayıcı rehberde yer aldığında ise yalnız mevcut hukuki durumu açıklayabilir. Bu nedenle metnin kurumsal konumu, konuşma edimi sınıflandırmasında belirleyicidir.
Bu Neden Önemli?
Bu çalışma, yapay zekâ yönetişimini yalnız içerik veya hukuk seviyesi üzerinden değil, dilsel işlev üzerinden de okumamız gerektiğini gösterir. Bir belge “etik ilke”, “kanun”, “gönüllü taahhüt” veya “rehber” olabilir; fakat asıl düzenleyici etkisi, cümlelerin nasıl emir verdiği, nasıl tanım kurduğu, nasıl söz verdiği veya nasıl açıklama yaptığıyla yakından ilişkilidir.
AI düzenlemeleri hızla çoğalırken bu ayrım önem kazanır. Şirketler, devletler, AB kurumları, standart kuruluşları ve hükümetler arası yapılar farklı metin türleri üretir. Bu metinlerin hepsi “AI yönetişimi” ekosisteminin parçasıdır; fakat her biri farklı bir dilsel mekanizmayla işler. Bazısı doğrudan yükümlülük koyar; bazısı yorum yapar; bazısı ortak ilke bildirir; bazısı şirketleri kendi sözleriyle bağlar.
Hukuk dili açısından çalışma, preambular text yani gerekçe/giriş bölümlerinin analizde ihmal edilmemesi gerektiğini gösterir. Gerekçeler doğrudan bağlayıcı hükümler olmayabilir; fakat düzenlemenin amaç, değer ve yorum çerçevesini kurar. Bu nedenle onların yumuşak hukuk belgeleriyle benzer modal profil göstermesi teorik olarak önemlidir.
AI yönetişimi açısından ise sektör taahhütlerinin farklı bir düzenleyici güç taşıyabileceği ortaya çıkar. “Biz yapacağız” veya “imzacılar taahhüt eder” dili, klasik kanun emri değildir. Fakat kamusal beklenti, itibar baskısı, birlikte-düzenleme ve gelecekteki denetim ilişkileri içinde gerçek bir yönetişim işlevi görebilir.
Verianla açısından bu makale, düzenleyici metinlerin yalnız hukukçular için değil, dilbilimciler ve sosyal bilimciler için de önemli bir veri alanı olduğunu gösterir. AI yönetişimini anlamak için yalnız maddelere bakmak yetmez; metnin hangi edimle konuştuğuna da bakmak gerekir.
Dikkat Noktaları
Çalışma preprinttir ve hakem değerlendirmesinden geçmemiştir. Bu nedenle yöntem, veri seçimi, sınıflandırıcı kuralları ve sonuç yorumları akademik inceleme sürecinde değişebilir veya geliştirilebilir.
Korpus İngilizce belgelerle sınırlıdır. Bu, özellikle AB düzenlemeleri açısından önemlidir; çünkü EU AI Act ve GDPR birçok dilde hukuken geçerli metinlere sahiptir. İngilizcedeki “should” ve “shall” ayrımı, Fransızca veya Almanca gibi dillerde birebir aynı şekilde görünmeyebilir. Yazar da bu nedenle çapraz dil doğrulamasının gerekli olduğunu belirtir.
Sert hukuk karşılaştırması yalnız üç bağlayıcı metne dayanır. Bu, sonuçların tüm hukuk metinlerine genellenmesini sınırlı hale getirir. Daha geniş bir karşılaştırma için farklı ülkelerden ve sektörlerden daha fazla bağlayıcı AI veya dijital düzenleme metni eklenmelidir.
Sektör imzalı kodlar için bulgu güçlü görünse de etkili örneklem küçüktür. White House Voluntary Commitments tek bir bağlamdır; GPAI Code of Practice bölümleri ise aynı AB AI Act Article 56 sürecinden doğan yakın belgelerden oluşur. Bu nedenle “bütün sektör kodları böyledir” sonucu çıkarılmamalıdır.
Kural tabanlı sınıflandırıcı denetlenebilirlik sağlar; ancak hukuk dili karmaşık ve çok işlevlidir. Bazı cümleler aynı anda hem tanım kurabilir hem emir verebilir. Tek etiketli sınıflandırma pratik bir çözüm sunar, fakat çok etiketli veya dereceli modeller ileride daha zengin sonuçlar verebilir.
Bu içerik hukuki tavsiye değildir. AI yönetişimi belgelerinin bağlayıcı niteliği, uygulama gücü ve hukuki etkisi ilgili ülke, kurum, belge türü ve yürürlük koşullarına göre değerlendirilmelidir.
Sonuç
Makale, AI yönetişimi metinlerinde hukuki güç ile konuşma-edimi gücünün her zaman örtüşmediğini gösteren dikkat çekici bir korpus-pragmatik çalışma sunuyor. AB düzenlemelerinin gerekçe bölümleri hukuki metnin içinde yer almasına rağmen yumuşak hukuk belgelerine benzer modal profil gösterebilir. Operatif maddeler ise çok daha güçlü zorunluluk diliyle çalışır.
Öte yandan, hukuken gönüllü görünen sektör imzalı AI kodları güçlü bir taahhüt dili kurabilir. Bu belgelerde düzenleyici iş, doğrudan emirle değil, imzacıların kendilerini gelecekteki eylemlere bağlamasıyla yürür. Bu nedenle yapay zekâ yönetişimi belgeleri yalnız sert/yumuşak hukuk çizgisine yerleştirilerek anlaşılamaz.
Çalışmanın en önemli mesajı şudur: Düzenleyici metinler yalnız hukuki statüleriyle değil, dilsel edimleriyle de çalışır. Bir metin ne kadar bağlayıcıdır sorusu kadar, hangi cümlelerle emir verdiği, hangi cümlelerle taahhüt kurduğu, hangi cümlelerle açıklama yaptığı ve hangi bölümde hangi kiplik gücünü kullandığı da önemlidir.
Verianla için bu çalışma, yapay zekâ yönetişimi tartışmalarında dilin teknik bir ayrıntı değil, düzenleyici gücün kendisini taşıyan temel araç olduğunu gösterir. Kanun maddeleri, gerekçeler, ilkeler ve şirket taahhütleri aynı alanda konuşur; fakat aynı söz-edimiyle konuşmaz.
Kaynak ve Yöntem Notu
Bu yazı, Kunming Li tarafından hazırlanan “Legal vs. speech-act force in codes and statutes of AI governance” başlıklı preprint çalışma temel alınarak hazırlanmıştır. Çalışma; AI yönetişimi belgeleri, konuşma edimleri, deontik kiplik, commissive taahhüt dili, AB düzenlemelerinde gerekçe-operatif madde ayrımı, sektör imzalı AI kodları, kural tabanlı sınıflandırma ve korpus-pragmatik yöntemleri birlikte ele almaktadır.
Bu içerik birebir çeviri değildir; çalışmanın ana fikri Verianla yayın çizgisine uygun biçimde sadeleştirilmiş ve özgün Türkçe editoryal makaleye dönüştürülmüştür.
Metin, hakem değerlendirmesinden geçmemiş bir preprint üzerinden hazırlandığı için kesin akademik uzlaşı veya hukuki yorum gibi okunmamalıdır. Hukuki uygulamalar için güncel mevzuat ve uzman görüşü dikkate alınmalıdır.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir