

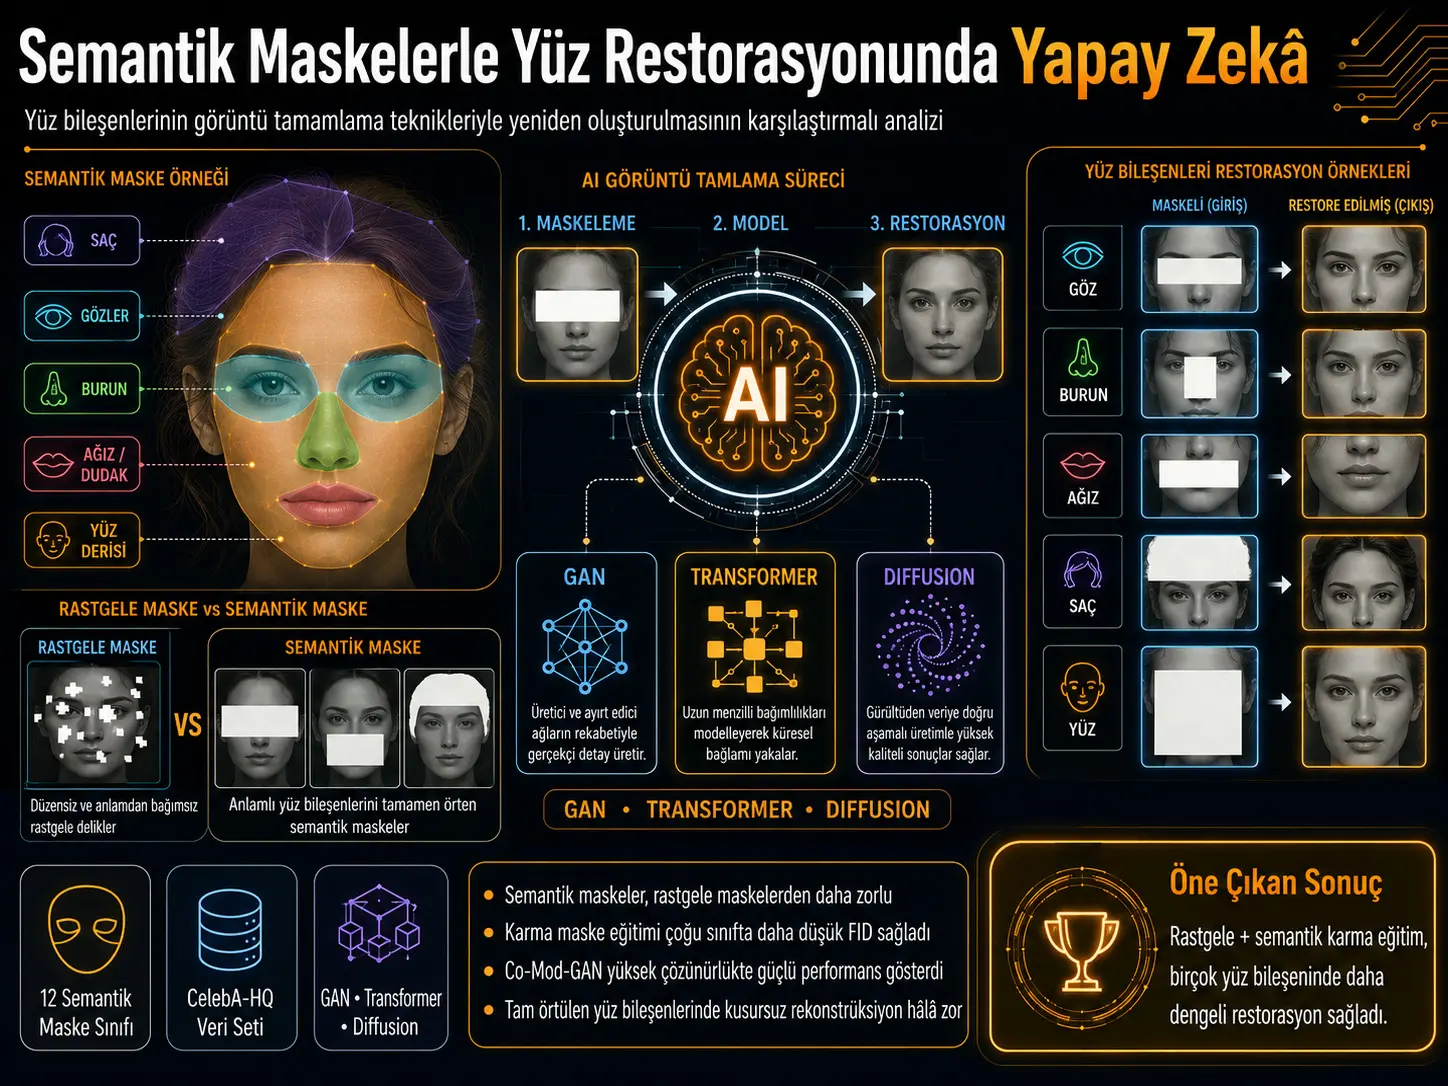
Bu araştırma, göz, burun, ağız, saç veya yüz derisi gibi bir yüz bileşeni semantik bir maskeyle tamamen gizlendiğinde güncel yapay zekâ tabanlı görüntü tamamlama (image inpainting) yöntemlerinin eksik bölgeyi ne ölçüde yeniden oluşturabildiğini karşılaştırmaktadır. CelebA-HQ/CelebAMask-HQ yüz görüntüleri ve 12 farklı semantik maske sınıfı kullanılarak MI-GAN, Latent-based, CMT, MAT, LaMa, Co-Mod-GAN, MADF ve sınırlı ölçekte RePaint gibi farklı mimari aileler değerlendirilmiştir. Çalışmanın ikinci aşamasında MAT modeli 24.000 eğitim görüntüsüyle rastgele, semantik ve bu iki maske tipini birleştiren karma stratejiler altında sıfırdan yeniden eğitilmiş ve 6000 görüntü üzerinde test edilmiştir. Karma maske eğitimi, FID bakımından 12 semantik maske sınıfının 10'unda en düşük değeri vermiş; bir sınıfta rastgele maskeyle eşit sonuç elde etmiş, en geniş birleşik maske sınıfında ise daha kötü performans göstermiştir. Buna rağmen çalışma, tamamen örtülmüş yüz bileşenlerinin hatasız veya özgün kişiye kimliksel olarak doğru biçimde geri getirilebildiğini göstermemektedir.
Araştırmanın temel güçlüğü, rastgele maskeler ile semantik maskeler arasındaki bilgi farkıdır. Rastgele maske bir gözün, dudağın veya saç bölgesinin yalnız bir kısmını örtebilir ve model geride kalan piksel yapısından yararlanabilir. Semantik maske ise hedef bileşenin tamamını kaldırarak yerel yapısal ipuçlarını ortadan kaldırır. Model bu durumda görünmeyen bölgeyi yalnız çevredeki yüz geometrisi, doku, simetri ve eğitim sırasında öğrendiği istatistiksel ilişkilerden tahmin etmek zorundadır.
Çalışmanın görsel deneyleri bu farkın yalnız metriklerde değil, oluşturulan yüzlerde de ortaya çıktığını göstermektedir. Modeller; kalın veya siyah kirpikler, yanlış hizalanmış göz bebekleri, birleşmiş dudaklar ve dişler, belirgin maske sınırları, değişen cilt tonları, gerçekçi olmayan saç akışı, eksik kulaklar veya kimi durumlarda fazladan göz gibi yapısal hatalar üretebilmektedir. Bu nedenle düşük bir FID değeri tek başına anatomik veya kimliksel olarak kusursuz rekonstrüksiyon anlamına gelmez.
| Deney unsuru | Çalışmada kullanılan yapı | Yorum sınırı |
|---|---|---|
| Temel veri seti | Yaklaşık 30.000 CelebA-HQ yüz görüntüsü, 1024 × 1024 | Klinik hasta veya travma veri seti değildir. |
| Semantik maske sınıfı | 12 sınıf (A–L) | Belirlenen yüz bileşenleri tamamen gizlenmektedir. |
| Değerlendirilen çözünürlükler | 256, 512 ve 1024 | Her model bütün çözünürlüklerde değerlendirilmemiştir. |
| Temel metrikler | FID, P-IDS, U-IDS | P-IDS/U-IDS yönü konusunda kaynak içinde tanım–yorum uyuşmazlığı vardır. |
| MAT yeniden eğitim | 24.000 eğitim + 6000 test görüntüsü | 512 × 512 çözünürlükte gerçekleştirilmiştir. |
| Maske eğitim stratejileri | Rastgele, semantik, karma | Karma yaklaşım çoğu fakat bütün maske sınıflarında üstün değildir. |
Görüntü tamamlama problemi neden semantik maskelerde zorlaşıyor?
Görüntü tamamlama, bir görüntüde eksik veya gizlenmiş bölgenin çevresindeki bilgi kullanılarak yapay biçimde yeniden oluşturulmasıdır. İnsan yüzlerinde bu görev özellikle zordur; çünkü gözlerin birbirine göre konumu, burun–ağız geometrisi, çene yapısı, saç akışı, cilt tonu ve yüz simetrisi gibi birbiriyle ilişkili çok sayıda özellik bulunmaktadır.
Çalışmada kullanılan semantik maskeler rastgele şekilli boşluklardan farklıdır. Maskeler, belirli bir anatomik/görsel bileşenin segmentasyon etiketini kullanarak o bileşenin tamamını gizler. Örneğin göz maskesi gözlerle birlikte kaşları; ağız sınıfları üst dudak, alt dudak ve ağız bölgesinin farklı kombinasyonlarını; saç maskesi saçın tamamını; “face” maskesi ise boyun, göz, burun, ağız ve kulaklar hariç yüz derisini örter.
Bu işlem, modele kısmen görünen bir göz veya dudak bırakmadığından rekonstrüksiyon problemi belirsizleşir. Aynı görünür yüz çevresine uyabilecek çok sayıda olası göz, dudak veya saç biçimi bulunabilir. Dolayısıyla üretilen görüntünün görsel açıdan inandırıcı olması, gizlenen özgün bileşenin gerçekten aynısının geri getirildiği anlamına gelmez.
Hangi yapay zekâ modelleri incelendi?
Araştırmacılar önceki görüntü tamamlama literatüründen farklı mimari aileleri temsil eden yöntemler seçmiştir. Bunlar arasında GAN tabanlı, Transformer tabanlı, latent temsile dayanan ve difüzyon tabanlı sistemler bulunmaktadır.
| Model | Temel çözünürlük bilgisi | Çalışmadaki rolü |
|---|---|---|
| MI-GAN | 256 | Mobil cihazlar için tasarlanmış hafif görüntü tamamlama modeli. |
| Latent-based | 256 | Kesikli latent kodlara dayalı çoğulcu görüntü tamamlama yaklaşımı. |
| CMT | 256 | Continuous-Mask-Aware Transformer yaklaşımı. |
| MAT | 256 ve 512 | Mask-Aware Transformer; CelebA ve FFHQ modelleri değerlendirildi. |
| LaMa | 256, 512 ve kaynak tablolarında 1024 | Fourier convolutions kullanan geniş maskeli inpainting yaklaşımı. |
| Co-Mod-GAN | 512 ve 1024 | Yüksek çözünürlüklü görüntü tamamlamada değerlendirildi. |
| MADF | 512 | Mask-aware cascaded refinement yaklaşımı. |
| RePaint | Kaynak model tablosunda 256 | Difüzyon tabanlı yöntem; yüksek hesaplama maliyeti nedeniyle yalnız sınırlı örnekle değerlendirildi. |
RePaint'in kapsamı diğer modellerden belirgin biçimde farklıdır. Araştırmacılar, tek bir görüntüyü tek bir semantik maske sınıfıyla tamamlamanın yaklaşık beş dakika sürdüğünü; 10 görüntünün 12 sınıfla değerlendirilmesinin yaklaşık 10 saat gerektirdiğini bildirmiştir. Bu nedenle RePaint yalnız 10 görüntü üzerinde denenmiş ve diğer yöntemlerle aynı ölçekli nicel karşılaştırmaya dahil edilmemiştir.
Veri seti ve semantik segmentasyon nasıl kullanıldı?
Araştırmada CelebA-HQ tabanlı yaklaşık 30.000 yüksek kaliteli yüz görüntüsü kullanılmıştır. Özgün görüntüler 1024 × 1024 çözünürlüktedir ve model gereksinimlerine göre yeniden ölçeklendirilmiştir. Yüz semantik segmentasyonunda 19 sınıflı yapı esas alınmıştır.
Çalışmanın Şekil 1'i, özgün yüz görüntüsünün yanında yüzün semantik olarak bölümlere ayrıldığı görünümü göstermektedir. Saç, yüz derisi, gözler/kaşlar, burun, kulaklar, üst dudak, alt dudak ve ağız farklı bölgeler olarak kodlanmıştır. Böylece rastgele dikdörtgen veya fırça izi biçimindeki maskeler yerine gerçek yüz bileşeninin sınırlarını izleyen maskeler üretilebilmiştir.
| Maske | Gizlenen temel bileşen |
|---|---|
| A | Gözler ve kaşlar |
| B | Burun |
| C | Üst dudak + alt dudak + ağız |
| D | Alt dudak |
| E | Üst dudak |
| F | Ağız |
| G | Saç |
| H | Kulaklar/ilgili küpe bölgesi |
| I | Yüz derisi |
| J | Burun + üst dudak + alt dudak + ağız |
| K | Gözler + burun + dudaklar + ağız |
| L | Yüz derisi + saç + kulaklar |
Verianla Live: Deneyin temel akışı
| Aşama | Çalışmadaki işlem |
|---|---|
| 1. Yüz görüntüleri | CelebA-HQ/CelebAMask-HQ görüntüleri kullanıldı. |
| 2. Semantik segmentasyon | 19 sınıflı yüz segmentasyonundan hedef bileşenler çıkarıldı. |
| 3. Maske oluşturma | A–L arasında 12 semantik maske sınıfı tanımlandı. |
| 4. Önceden eğitilmiş model karşılaştırması | Farklı GAN, Transformer, latent ve difüzyon temelli modeller değerlendirildi. |
| 5. Çözünürlük karşılaştırması | Model desteğine göre 256, 512 ve 1024 çözünürlükleri incelendi. |
| 6. MAT yeniden eğitimi | Rastgele, semantik ve karma maskelerle üç ayrı eğitim gerçekleştirildi. |
| 7. İstatistiksel doğrulama | 6000 görüntüden oluşturulan bootstrap alt örnekleriyle FID farkları test edildi. |
FID, P-IDS ve U-IDS neyi ölçüyor?
Araştırmacılar piksel düzeyindeki PSNR ve SSIM yerine Inception özellik uzayına dayanan algısal metrikleri tercih etmiştir. En temel ölçüt Fréchet Inception Distance (FID) değeridir. FID, gerçek ve oluşturulmuş görüntü dağılımlarının özellik uzayındaki farkını karşılaştırır ve çalışmada daha düşük FID daha iyi sonuç olarak değerlendirilmiştir:
\[ FID(p_r,p_g)=\|\mu_r-\mu_g\|_2^2+ Tr\left(\Sigma_r+\Sigma_g-2(\Sigma_r\Sigma_g)^{1/2}\right) \]
Burada \(\mu_r\) ve \(\mu_g\) gerçek ve üretilmiş görüntü özelliklerinin ortalamalarını; \(\Sigma_r\) ve \(\Sigma_g\) ise kovaryans matrislerini temsil eder.
Makale ayrıca P-IDS ve U-IDS ölçütlerini kullanmaktadır. Bununla birlikte kaynakta önemli bir yöntemsel tutarsızlık bulunmaktadır. Verilen denklemler bu ölçütleri gerçek ve üretilmiş görüntü özellikleri arasındaki karesel uzaklıkların ortalaması biçiminde yazmaktadır:
\[ P\text{-}IDS=\frac{1}{N}\sum_{i=1}^{N}\|f(x_i)-f(x'_i)\|_2^2 \]
\[ U\text{-}IDS=\frac{1}{N}\sum_{i=1}^{N}\|f_u(x_i)-f_u(x'_i)\|_2^2 \]
Bu denklem biçiminde daha küçük uzaklık daha yakın özellik eşleşmesi anlamına gelir. Ancak çalışmanın Tablo 4 açıklaması ve sonuç yorumları P-IDS/U-IDS için daha yüksek değerleri en iyi performans olarak sıralamaktadır. Kaynak bu yön farklılığını açıklamadığı için burada P-IDS ve U-IDS sonuçları yazarların raporladığı biçimde aktarılacak, fakat metrik yönü bağımsız olarak kesinleştirilmeyecektir.
256 çözünürlükte hangi modeller öne çıktı?
256 × 256 çözünürlükte FID bakımından MI-GAN 12 semantik maske sınıfının 10'unda ilk üçe girmiş ve dört sınıfta en iyi değeri sağlamıştır. Latent-based model dokuz sınıfta ilk üçe girmiş ve altı sınıfta en iyi FID değerini vermiştir. MAT ise sekiz maske sınıfında ilk üç arasında yer almıştır.
Çalışmanın kendi P-IDS yorumuna göre MI-GAN bütün maske sınıflarında en yüksek P-IDS değerini sağlamış; U-IDS'de ise 10 sınıfta en yüksek sonucu vermiştir. Bununla birlikte P-IDS/U-IDS yönüne ilişkin yukarıda belirtilen denklem–yorum uyuşmazlığı nedeniyle bu sıralama FID sonuçlarıyla aynı kesinlikte yorumlanmamalıdır.
512 çözünürlükte görsel hatalar nelerdi?
512 × 512 karşılaştırmasında MAT'ın FFHQ modeli FID bakımından 12 maske sınıfının tamamında ilk üç model arasında yer almış ve yedi sınıfta en iyi FID değerini vermiştir. CelebA tabanlı MAT modeli 11 sınıfta ilk üçe girmiştir.
Ancak çalışmanın Şekil 2'sindeki görsel örnekler nicel skorların tek başına yeterli olmadığını göstermektedir. Araştırmacılar LaMa ve MADF'nin göz restorasyonlarında bulanık veya birbirine karışmış gözler üretebildiğini; LaMa'nın bazı burun maskelerinde küçük bir burun ve çift ağız benzeri yapı oluşturabildiğini; MAT'ın bazı yüz maskelerinde kirpikleri kalınlaştırdığını; Co-Mod-GAN'ın burun çevresinde görünür sınırlar bırakabildiğini; MADF'nin ise kimi örneklerde fazladan göz veya dudakların üzerine taşan dişler oluşturduğunu bildirmiştir.
1024 çözünürlükte Co-Mod-GAN ile LaMa arasındaki fark
1024 × 1024 değerlendirmesinde yalnız Co-Mod-GAN ve LaMa karşılaştırılmıştır. FID bakımından Co-Mod-GAN 12 semantik maske sınıfının 11'inde LaMa'dan daha düşük değer elde etmiştir. Tek istisna üst dudak maskesi E'dir; burada LaMa'nın FID değeri 0,37, Co-Mod-GAN'ın değeri 0,72'dir.
Verianla Live: 1024 çözünürlükte seçilmiş zor maskelerde FID
Daha düşük FID daha iyi dağılımsal benzerliği ifade eder. Bu görselleştirme özellikle büyük veya yapısal olarak zor semantik bölgeleri göstermektedir.
| Maske sınıfı | Co-Mod-GAN FID | LaMa FID |
|---|---|---|
| G — Saç | 11,60 | 41,85 |
| I — Yüz | 11,24 | 33,61 |
| J — Burun + ağız bölgesi | 3,93 | 9,20 |
| K — Göz + burun + ağız bölgesi | 6,23 | 18,58 |
| L — Yüz + saç + kulaklar | 65,73 | 206,07 |
Şekil 3'te LaMa'nın 256, 512 ve 1024 çözünürlükteki örnekleri yan yana gösterilmekte ve çözünürlük yükseldikçe bazı yüz bileşenlerinde belirgin bozulmalar görülebilmektedir. Şekil 4'te ise Co-Mod-GAN'ın 512 ve 1024 çıktıları birbirine daha yakın görünmektedir. Bu gözlem kaynak yazarlarının Co-Mod-GAN'ı yüksek çözünürlük için daha etkili model olarak değerlendirmesine temel oluşturmaktadır.
Bununla birlikte yöntem metninde “LaMa yüksek çözünürlükte etkisiz bulunduğu için 512 ve 256'da değerlendirildi” anlamına gelen bir ifade yer almasına rağmen daha sonraki bölüm, Tablo 5 ve Şekil 3 açıkça 1024 LaMa sonuçları sunmaktadır. Bu kaynak içi çelişki çözülmeden korunmalıdır.
Hangi yüz bileşenleri modeller için daha sorunlu?
Sonuçlar tek bir modelin bütün yüz bölgelerinde güvenilir üstünlük göstermediğini ortaya koymaktadır. Kaynak çalışmanın model bazında görsel incelemesinde şu hata türleri raporlanmıştır:
- Göz: aşırı kalın kirpik, siyah göz, göz bebeği hizası veya renk uyuşmazlığı, bulanık ya da karışmış göz yapısı.
- Ağız ve dudak: dudakların birleşmesi, gerçekçi olmayan veya çatlak dişler, dişlerin dudağın üzerine taşması, alt dudak hizası ve renk sorunları.
- Yüz derisi: maske sınırlarının görünmesi, cilt tonu farkı, yüzün kısalması/incelmesi, yansıma benzeri yapılar.
- Saç: doğal olmayan akış, renk sürekliliği kaybı, parça parça saç üretimi veya maskedeki bazı bölgelerin arka plan/kulakla doldurulması.
- Kulak: eksik kulak veya kulak bölgesinin saçla değiştirilmesi.
- Burun: birçok modelde görece başarılı olmakla birlikte bazı durumlarda eksik, küçük veya sınırları belirgin rekonstrüksiyon.
Ek Şekil A1, göz, ağız/dudak, yüz ve burun+ağız kombinasyonlarının yakınlaştırılmış kesitlerini model bazında karşılaştırmaktadır. Bu yakın görünüm, tam görüntüde fark edilmesi zor olan kirpik kalınlığı, dudak–diş birleşmesi ve renk geçişi gibi kusurları daha açık hale getirmektedir.
Çalışmanın Yöntemi ve Bulguları
Deney donanımı
| Bileşen | Çalışmada bildirilen özellik |
|---|---|
| GPU | 2 × NVIDIA A800 Active |
| GPU belleği | GPU başına 40 GB |
| CUDA | 12.0 |
| CPU | Intel Xeon w9-3495X |
| CPU çekirdeği | 56 çekirdek, 1,9–4,8 GHz |
| RAM | 256 GB |
| Depolama kullanımı | 286 GB |
Model çalışma süreleri
Çalışma, RePaint dışındaki yöntemlerin tek görüntü başına 0,3 saniyeden kısa sürede görüntü tamamlayabildiğini belirtmektedir. Tablo 6'ya göre 2000 görüntülük işlem süreleri aşağıdaki gibidir:
| Model | Kaynak Tablo 6'da bildirilen süre |
|---|---|
| MAT | 256: 3 dk; 512: 5 dk |
| Co-Mod-GAN | 512: 1 dk; 1024: 2 dk |
| MADF | 512 sütununda 6 dk |
| CMT | 512 sütununda 1 dk |
| Latent-based | 512 sütununda 10 dk |
| MI-GAN | 512 sütununda 2 dk |
| LaMa | 256: 0,5–1 dk; 512: 1,5 dk; 1024: 5 dk |
| RePaint | 512 sütununda yaklaşık 5 dk/görüntü |
Burada kaynak içi bir çözünürlük uyuşmazlığı bulunmaktadır. Model seçimi Tablo 1, CMT, Latent-based, MI-GAN ve RePaint'i 256 çözünürlükle tanımlarken hesaplama süresi Tablo 6 bu modellerin sürelerini 512 × 512 sütununa yerleştirmektedir. Makale bunun nedenini açıklamamaktadır; bu nedenle süre tablosu yukarıda kaynakta göründüğü biçimde aktarılmıştır.
MAT neden yeniden eğitildi?
512 çözünürlük karşılaştırmalarında güçlü sonuç veren MAT, semantik maske problemi için üç ayrı eğitim stratejisinin karşılaştırılmasında kullanılmıştır:
- Yalnız rastgele maskelerle eğitim,
- Yalnız semantik maskelerle eğitim,
- Rastgele ve semantik maskelerin birlikte kullanıldığı karma eğitim.
MAT modeli her deneyde sıfırdan başlatılmıştır. Eğitimde 24.000 görüntü, testte 6000 görüntü kullanılmıştır. Adam optimizer'ın öğrenme oranı \(1\times10^{-4}\), \(\beta_1=0.9\) ve \(\beta_2=0.999\) olarak belirlenmiş; batch size 8 ve eğitim süresi 100 epoch olarak uygulanmıştır. Batch büyüklüğü, GPU başına mevcut 40 GB bellek sınırı nedeniyle 8 ile sınırlandırılmıştır.
Standart veri artırma olarak rastgele yatay çevirme ve döndürme kullanılmış, ek renk jitter veya başka geometrik dönüşüm uygulanmamıştır. Her eğitim oturumunun yaklaşık 7 gün 13 saat sürdüğü bildirilmiştir.
Rastgele maske neden yalnız semantik maskeden daha iyi çıktı?
İlk yeniden eğitim sonucunda, semantik maskelerle test yapılmasına rağmen yalnız rastgele maskelerle eğitilen MAT modeli, yalnız semantik maskelerle eğitilen MAT'tan genel olarak daha düşük FID vermiştir. Yazarlar bunu rastgele maskelerin çok daha çeşitli kayıp bölgeleri oluşturması ve modelin görüntünün tamamındaki bağlamsal ilişkileri öğrenmeye zorlanmasıyla açıklamaktadır.
Bu açıklama çalışma tarafından önerilen bir yorumdur. Araştırma, overfitting mekanizmasını ayrı deneylerle doğrudan ölçmemiştir; dolayısıyla “rastgele maske kesin olarak overfitting'i azaltır” biçiminde nedensel bir genelleme yapılmamalıdır.
Karma maske stratejisinin FID sonuçları
| Maske | Rastgele eğitim FID | Semantik eğitim FID | Karma eğitim FID |
|---|---|---|---|
| A | 1,46 | 1,78 | 1,25 |
| B | 0,93 | 0,95 | 0,93 |
| C | 2,01 | 3,73 | 1,59 |
| D | 0,75 | 1,20 | 0,71 |
| E | 0,74 | 1,40 | 0,56 |
| F | 2,36 | 2,05 | 1,24 |
| G — Saç | 12,51 | 17,38 | 7,10 |
| H | 3,90 | 3,91 | 3,33 |
| I — Yüz | 8,16 | 9,25 | 5,69 |
| J | 2,46 | 4,00 | 2,20 |
| K | 3,56 | 5,00 | 3,03 |
| L — Yüz + saç + kulaklar | 115,51 | 114,35 | 130,82 |
Karma eğitim A, C, D, E, F, G, H, I, J ve K sınıflarında iki tekli stratejiden de daha düşük FID vermiştir. B sınıfında rastgele eğitimle aynı FID değeri olan 0,93 elde edilmiştir. En geniş maske olan L sınıfında ise karma eğitimin FID'si 130,82'ye yükselmiş ve hem rastgele hem de semantik eğitimden daha kötü olmuştur. Bu nedenle sonuç “karma yöntem her durumda üstün” biçiminde genellenemez.
Bootstrap doğrulaması ne gösterdi?
Araştırmacılar FID farklarının yalnız belirli test örneklerinden kaynaklanıp kaynaklanmadığını incelemek için 6000 görüntülük test kümesinden bootstrap analizi gerçekleştirmiştir. Her değerlendirmede 1000 benzersiz görüntü seçilmiş ve işlem 100 kez tekrarlanmıştır. Aynı görüntü tek bir bootstrap örneğinde tekrarlanmamış, fakat farklı bootstrap örneklerinde yeniden bulunabilmiştir.
Ek Tablo A2'de karma maske eğitiminin A, C, D, E, F, G, I, J ve K maske sınıflarında hem rastgele hem semantik eğitimden daha düşük FID sağladığı ve farkların p<0,01 düzeyinde istatistiksel olarak anlamlı olduğu işaretlenmiştir. B ve H için bu çift yönlü anlamlılık işaretlenmemiştir; L sınıfında karma yaklaşım daha kötü FID vermiştir.
| Seçilmiş maske | Rastgele FID, ortalama ± SS | Semantik FID, ortalama ± SS | Karma FID, ortalama ± SS | Kaynak sonucu |
|---|---|---|---|---|
| C — Tam ağız/dudak | 2,03 ± 0,05 | 3,76 ± 0,09 | 1,60 ± 0,04 | Karma, her ikisinden p<0,01 daha düşük. |
| G — Saç | 12,66 ± 0,33 | 17,43 ± 0,42 | 7,15 ± 0,21 | Karma, her ikisinden p<0,01 daha düşük. |
| I — Yüz | 8,22 ± 0,21 | 9,30 ± 0,24 | 5,71 ± 0,15 | Karma, her ikisinden p<0,01 daha düşük. |
| L — Yüz + saç + kulak | 116,10 ± 3,23 | 114,90 ± 3,19 | 131,45 ± 3,51 | Karma yaklaşım üstün değildir. |
Görsel örnekler karma yaklaşımı nasıl gösteriyor?
Şekil 5'te rastgele, semantik ve karma maskeyle eğitilen MAT modellerinin yüz, saç ve tam ağız/dudak restorasyonları yan yana gösterilmiştir. Yazarların görsel değerlendirmesine göre rastgele maskeyle eğitilen model yüz rengini çevreye daha iyi karıştırabilse de yüz geometrisi kısa ve tutarsız görünebilir. Semantik eğitim yüz şekline daha çok yaklaşabilmekte, ancak cilt tonu çevresiyle uyuşmayabilmektedir. Karma eğitim bu iki hata tipi arasında daha dengeli sonuç üretmiştir.
Saçta rastgele eğitim saç akışında, semantik eğitim ise renk sürekliliğinde sorun yaşayabilirken karma strateji iki özelliği daha iyi dengelemiştir. Ağız örneğinde de karma eğitim görsel olarak diğer iki stratejiden daha iyi sunulmuştur. Ancak bunlar seçilmiş görsel örneklerdir; çalışma bağımsız insan değerlendiricilerle körlenmiş bir algısal kullanıcı çalışması raporlamamaktadır.
Çalışmanın tanımladığı yapısal sınırlılıklar
Araştırmacılar yalnız eğitim verisini değiştirmekle sorunun tamamen çözülemeyeceğini ve mevcut mimarilerin yapısal sınırları bulunduğunu savunmaktadır:
- Yerel receptive field ve convolutional bias: Tam semantik maske, CNN/GAN modellerinin kullanabileceği yerel ipuçlarını tamamen ortadan kaldırabilir.
- Zayıf global ve semantik muhakeme: Transformer ve difüzyon modelleri geniş bağlamı modelleyebilse de, görüntüdeki anatomik bileşenler arasındaki kesin yapısal ilişkiyi her zaman koruyamaz.
- Sınırlı yapısal öncüller: Modeller yüz anatomisini açık kurallar biçiminde bilmez; çoğunlukla eğitim verisindeki istatistiksel ilişkileri öğrenir.
- Belirsizlik: Tamamen görünmeyen bir bileşen için birden fazla görsel olarak makul çözüm bulunabilir.
Yazarlar gelecekte yüz bileşenlerini açık biçimde modelleyen, yüz geometrisini ve bileşen bağımlılıklarını hesaba katan mimarilerin; adaptif maske eğitimlerinin ve bileşene özgü kayıp fonksiyonlarının araştırılmasını önermektedir.
Çalışma neyi kanıtlamıyor?
- Bir maskenin altında bulunan özgün göz, ağız, burun veya saçın kimliksel olarak doğru biçimde geri kazanılabildiğini kanıtlamıyor.
- Üretilen yüz bileşenlerinin anatomik olarak tıbbi rekonstrüksiyon için güvenilir olduğunu kanıtlamıyor.
- Çalışma gerçek hasta, travma, yanık veya cerrahi yüz rekonstrüksiyonu verisi kullanmıyor.
- Gizlilik koruma veya yüz tanıma sistemlerinde gerçek kimlik koruma başarısını ölçmüyor.
- Karma maske yaklaşımının bütün maskelerde veya bütün inpainting mimarilerinde üstün olduğunu göstermiyor.
- Düşük FID'nin insan gözünde veya kimlik koruma açısından kusursuz sonuç anlamına geldiğini göstermiyor.
- RePaint diğer modellerle eşit örnek sayısı ve hesaplama bütçesi altında karşılaştırılmadığı için difüzyon modellerinin genel olarak daha kötü olduğu sonucunu desteklemiyor.
Kaynak ve Yöntem Notu
| Tam özgün çalışma adı | Evaluating AI-Based Image Inpainting Techniques for Facial Components Restoration Using Semantic Masks |
|---|---|
| Yazarlar | Hussein Sharadga; Abdullah Hayajneh; Erchin Serpedin |
| Eş katkı | Kaynakta eş birinci/eş katkı beyanı belirtilmemiştir. |
| Sorumlu yazar | Hussein Sharadga |
| Kurumlar | School of Engineering, Texas A&M International University, ABD; King Abdullah II School of Engineering, Princess Sumaya University for Technology, Ürdün; Department of Electrical and Computer Engineering, Texas A&M University, ABD. |
| Kaynak türü | Hakemli araştırma makalesi; karşılaştırmalı yapay zekâ/görüntü işleme benchmark ve yeniden eğitim çalışması. |
| Hakemlik durumu | Hakemli dergide yayımlanmış makale; preprint değildir. |
| Dergi | AI |
| Yayınevi | MDPI |
| Cilt / sayı / makale | 2026, 7(4), 119 |
| DOI | 10.3390/ai7040119 |
| Alınma / revizyon / kabul / yayın | 8 Şubat 2026 / 12 Mart 2026 / 23 Mart 2026 / 30 Mart 2026 |
| Resmî bağlantı | https://doi.org/10.3390/ai7040119 |
| Lisans | Creative Commons Attribution (CC BY). |
Finansman, veri ve çıkar çatışması
Yazarlar araştırmanın dış finansman almadığını bildirmiştir. Makale işlem ücretinin Texas A&M International University tarafından karşılandığı belirtilmiştir. Yazarlar çıkar çatışması bulunmadığını beyan etmiştir.
Çalışmada kullanılan yüz görüntüleri, kamuya açık CelebAMask-HQ veri setinden alınmıştır ve kaynak çalışma bu veri setinin yalnız ticari olmayan araştırma amacıyla kullanıldığını belirtmektedir. Yazarlar ham yüz görüntülerini yeniden dağıtma iznine sahip olmadıklarını ifade etmektedir.
Üretken yapay zekâ kullanım beyanı
Kaynak çalışmanın teşekkür bölümünde yazarlar, makalenin okunabilirliğini iyileştirmek amacıyla ChatGPT'nin “GPT-5 mini, free version” sürümünü kullandıklarını; sonrasında içeriği kendilerinin gözden geçirip düzenlediklerini ve yayımlanan metnin sorumluluğunu üstlendiklerini bildirmiştir. Bu beyan araştırmanın deneysel görüntü tamamlama sonuçlarının ChatGPT tarafından üretildiği anlamına gelmez.
Yazar katkıları
Kavramsallaştırmaya üç yazar da katkıda bulunmuştur. Metodoloji, yazılım, veri düzenleme ve proje yönetimi Hussein Sharadga ile Abdullah Hayajneh tarafından yürütülmüş; doğrulama ve araştırma çalışmalarına üç yazar da katılmıştır. Özgün taslak Hussein Sharadga ve Abdullah Hayajneh tarafından hazırlanmış; üç yazar da gözden geçirme ve düzenleme sürecine katkı sağlamıştır.
Kaynak içi tutarsızlıkların kaydı
- P-IDS ve U-IDS denklemleri uzaklık ölçüsü biçiminde tanımlanırken tablolar ve metin daha yüksek değeri daha iyi performans olarak yorumlamaktadır. Kaynak bu farklılığı açıklamamaktadır.
- Yöntem metni LaMa'nın yüksek çözünürlükte etkisiz bulunması nedeniyle 256 ve 512'de değerlendirildiğini söylerken daha sonra 1024 LaMa sonuçları raporlanmaktadır.
- Model Tablo 1 CMT, Latent-based, MI-GAN ve RePaint için 256 çözünürlüğünü bildirirken hesaplama süresi Tablo 6 bu modellerin sürelerini 512 × 512 sütununda göstermektedir.
Temel sınırlılıklar
- Sonuçlar tek temel yüz veri seti ailesine dayanmaktadır.
- Klinik veya travmatik yüz rekonstrüksiyonu veri seti kullanılmamıştır.
- Her model aynı çözünürlüklerde ve aynı hesaplama bütçesiyle test edilmemiştir.
- RePaint yalnız 10 görüntü üzerinde sınırlı olarak değerlendirilmiştir.
- Görsel kalite değerlendirmeleri için bağımsız, körlenmiş insan değerlendirici çalışması sunulmamıştır.
- FID dağılımsal algısal benzerlik ölçüsüdür; özgün kişinin gerçek kayıp yüz bileşeninin yeniden oluşturulduğunu kanıtlamaz.
- En geniş L semantik maske sınıfında karma eğitim daha kötü FID üretmiştir.
- Kaynakta P-IDS/U-IDS metrik yönüne ilişkin tanım ve yorum uyuşmazlığı bulunmaktadır.
Çalışmanın en güçlü sonucu, tamamen gizlenen semantik yüz bileşenlerinin mevcut görüntü tamamlama modelleri için hâlâ zor bir problem olması ve maske çeşitliliğinin eğitim performansını önemli ölçüde etkileyebilmesidir. Karma rastgele–semantik eğitim stratejisi birçok yüz bileşeninde FID'yi iyileştirmiş olsa da, çalışma kusursuz yüz rekonstrüksiyonuna ulaşıldığını değil, tam tersine bunun hâlâ açık bir araştırma problemi olduğunu göstermektedir.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir