

“Yapay Zekâ Doktorların Yerini Alacak mı?” Sorusu Neden Yetersiz?
Sağlık hizmetlerinde yapay zekâ tartışması çoğu zaman iki uç görüş arasında ilerler. Bir tarafta yapay zekânın doktorları kısa sürede gereksiz hâle getireceği, diğer tarafta tıbbın karmaşıklığı, etik sorumluluk ve hasta-hekim ilişkisi nedeniyle sağlık hizmetlerinin otomasyona karşı korunaklı olduğu savunulur.
Çalışma, iki yaklaşımın da tıbbi işi tek parça gibi ele aldığı için yetersiz olduğunu ileri sürmektedir.
Bir onkologun yaptığı işler aynı bilişsel niteliğe sahip değildir. Aynı çalışma günü içinde hekim:
- Laboratuvar sonuçlarını karşılaştırabilir,
- Bir görüntüleme raporunu evreleme açısından yorumlayabilir,
- Moleküler biyobelirteci tedavi kılavuzuyla eşleştirebilir,
- İlaç dozunu toksisiteye göre değiştirebilir,
- Bir klinik araştırmaya uygunluğu değerlendirebilir,
- Yaşam beklentisini hastaya açıklayabilir,
- Hastanın yaşam kalitesiyle tedavi kazancı arasındaki tercihini anlamaya çalışabilir.
Bu görevlerin bir bölümü yapılandırılmış veri ve açık kurallarla yürütülür. Diğerleri ise eksik bilgi, çelişen hedefler, hastanın değerleri ve ilişkisel sorumluluk içerir.
Bu nedenle çalışmanın temel analiz birimi “hekim” veya “uzmanlık alanı” değil, tekil bilişsel görevdir.
Görev Ayrıştırma Nedir?
Görev ayrıştırma, karmaşık bir iş akışının tanımlanabilir girişleri ve çıktıları bulunan daha küçük faaliyetlere bölünmesidir.
Onkolojide “tedavi kararı vermek” tek bir görev gibi görünse de gerçekte şu alt işlemleri içerebilir:
- Patoloji tanısını doğrulamak,
- Tümörün evresini belirlemek,
- Moleküler biyobelirteçleri sınıflandırmak,
- Hastanın performans durumunu değerlendirmek,
- Kılavuza uygun tedavi seçeneklerini listelemek,
- Klinik çalışma seçeneklerini taramak,
- İlaçların göreli yarar ve risklerini karşılaştırmak,
- Eşlik eden hastalıkları hesaba katmak,
- Hastanın hedef ve tercihlerini anlamak,
- Nihai öneriyi oluşturmak ve açıklamak.
Bu görevler birbirlerinden ayrıldığında, yapay zekânın hangi bölümde güçlü, hangi bölümde sınırlı olduğu daha açık hâle gelir.
Otomasyon Potansiyeli Endeksi Nedir?
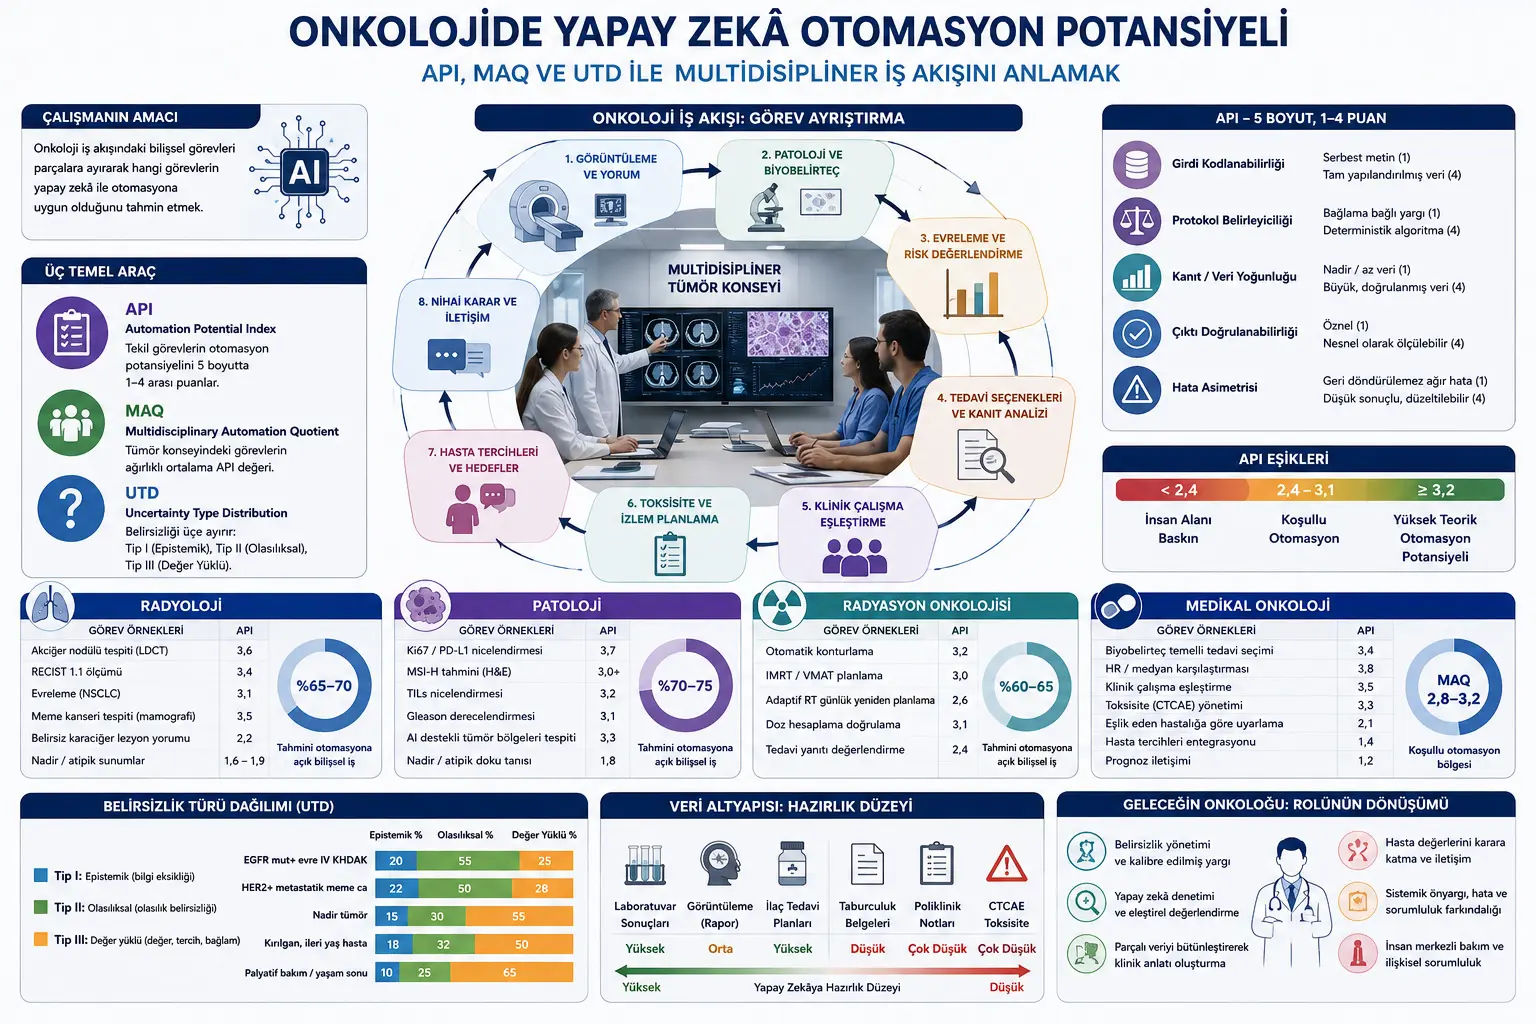
Automation Potential Index, yani Otomasyon Potansiyeli Endeksi, her klinik görevi beş boyutta değerlendiren prototip bir puanlama aracıdır.
Her boyut 1 ile 4 arasında puanlanır. Beş puanın ortalaması görevin API değerini oluşturur.
\[ API_t = \frac{ C_t + D_t + E_t + V_t + A_t }{5} \]
Bu formül çalışmada ayrı bir denklem olarak yazılmamıştır; araçta tarif edilen aritmetik ortalamayı göstermek amacıyla ifade edilmiştir.
Formülde:
- \(C_t\), girdinin kodlanabilirliğini,
- \(D_t\), protokol belirleyiciliğini,
- \(E_t\), kanıt veya veri yoğunluğunu,
- \(V_t\), çıktının doğrulanabilirliğini,
- \(A_t\), hata asimetrisini temsil eder.
API’nin Beş Boyutu
| Boyut | Temel Soru | Düşük Puan Örneği | Yüksek Puan Örneği |
|---|---|---|---|
| Girdi kodlanabilirliği | Görevin girdisi makine tarafından okunabilir mi? | Serbest anlatımlı ve eksik klinik not | Tam yapılandırılmış sayısal veya dijital veri |
| Protokol belirleyiciliği | Çıktıyı açık bir kural veya kılavuz belirliyor mu? | Bağlama dayalı bireysel yargı | Algoritmik veya deterministik karar |
| Kanıt yoğunluğu | Model eğitimi için yeterli ve kaliteli veri var mı? | Nadir tümör veya küçük örneklem | Büyük ve doğrulanmış veri setleri |
| Çıktı doğrulanabilirliği | Sonucun doğru olup olmadığı nesnel biçimde ölçülebilir mi? | Öznel veya tartışmalı çıktı | Ölçülebilir ve bağımsız doğrulanabilir çıktı |
| Hata asimetrisi | Bir yapay zekâ hatasının sonucu ne kadar ağır ve geri döndürülebilir? | Geri döndürülemez veya ölümcül sonuç | Düşük sonuçlu ve kolayca düzeltilebilir hata |
API Eşikleri
Çalışmada görevler üç temel bölgeye ayrılmaktadır:
| API Değeri | Sınıflandırma | Yorum |
|---|---|---|
| 3,2 ve üzeri | Yüksek teorik otomasyon potansiyeli | Uygun veri koşullarında görevin büyük bölümü teknik olarak otomasyona açık görünür. |
| 2,4–3,1 | Koşullu otomasyon | Yapay zekâ desteği mümkündür; insan denetimi ve bağlamsal değerlendirme gerekir. |
| 2,4’ün altı | İnsan alanı baskın | Bağlamsal yargı, değerler, düşük veri yoğunluğu veya ağır hata riski belirgindir. |
Yazar bu eşiklerin klinik verilerle kalibre edilmediğini açık biçimde belirtmektedir. Değerler, puanlama mantığını görünür kılmak için seçilmiş geçici sınırlardır.
Yüksek API Değeri “Otonom Kullanım Uygundur” Anlamına Gelir mi?
Hayır.
Çalışma teknik otomasyona uygunluk ile klinik olarak otonom kullanıma izin verilmesini birbirinden ayırmaktadır.
Bir görev:
- Veri bakımından tamamen yapılandırılmış,
- Kuralları açık,
- Çıktısı nesnel,
- Yapay zekâ tarafından yüksek doğrulukla yürütülebilir
olabilir.
Ancak hata gerçekleştiğinde sonuç ağırsa insan doğrulaması yine gerekli olabilir.
Örneğin kemoterapi dozu hesaplamak matematiksel olarak otomasyona uygun görünebilir. Fakat hastanın böbrek işlevindeki güncel değişiklik kayda geçirilmemişse, otomatik hesaplanan doz tehlikeli olabilir.
Dolayısıyla yüksek API puanı, görevin teknik olarak kodlanabilir olduğunu gösterir; doğrudan insan gözetiminin kaldırılmasını önermez.
3. Sayfadaki API Tablosu Ne Gösteriyor?
Çalışmanın 3. sayfasındaki tablo API’nin beş değerlendirme boyutunu yan yana göstermektedir. En düşük puanlar serbest anlatımlı, bağlama bağımlı, veri bakımından yetersiz, öznel ve geri döndürülemez hata riski taşıyan görevlere verilmektedir.
En yüksek puanlar ise tam yapılandırılmış veriye dayanan, açık algoritmalarla yürütülen, büyük doğrulama veri setleri bulunan, çıktısı ölçülebilir ve hatası düzeltilebilir görevlere ayrılmaktadır.
Bu tablo çalışmanın bütün düşünsel çerçevesini özetler: Yapay zekânın gücü yalnızca model mimarisinden değil, görevin veri ve karar yapısından kaynaklanmaktadır.
Radyolojide Otomasyon Potansiyeli
Çalışmaya göre radyoloji, onkoloji iş akışındaki yüksek hacimli bilişsel girdilerden biridir.
Radyolojik görüntüler DICOM formatında dijital olarak saklanır. Ayrıca birçok görüntüleme görevi RECIST, Lung-RADS, PI-RADS ve LI-RADS gibi standartlaştırılmış değerlendirme kurallarına sahiptir.
Bu özellikler radyolojik görevlerin girdi kodlanabilirliğini ve protokol belirleyiciliğini artırmaktadır.
| Radyoloji Görevi | API | Çalışmadaki Bölge |
|---|---|---|
| Düşük doz BT’de akciğer nodülü tespiti | 3,6 | Yüksek |
| Yarı otomatik RECIST 1.1 ölçümü | 3,4 | Yüksek |
| Küçük hücreli dışı akciğer kanserinde evreleme BT’si | 3,1 | Çalışma tablosunda yüksek olarak sınıflandırılmıştır |
| Mamografide meme kanseri tespiti | 3,5 | Yüksek |
| Belirsiz karaciğer lezyonunun karakterizasyonu | 2,2 | Yapay zekâ destekli |
| Nadir veya atipik görüntüleme sunumları | 1,6–1,9 | İnsan alanı |
Yazar, iyi tanımlanmış yaygın solid tümörlerde radyolojik bilişsel işlerin yaklaşık %65–70’inin uygun veri koşullarında otomasyona açık olabileceğini tahmin etmektedir.
Bu yüzde doğrudan iş gücü azalması anlamına gelmez. Görüntü kalitesi kontrolü, klinik bağlam, tesadüfi bulgular, nadir durumlar ve son klinik sorumluluk radyoloğun rolünü sürdürür.
Belirsiz Karaciğer Lezyonu Neden Düşük Puan Alıyor?
Belirsiz bir karaciğer lezyonunun yorumlanması yalnızca görüntü özelliklerine bağlı olmayabilir.
Karar şu verileri gerektirebilir:
- Hastanın bilinen kanseri,
- Karaciğer hastalığı öyküsü,
- Önceki görüntüler,
- Kontrastlanma deseni,
- Laboratuvar sonuçları,
- Tedavi öyküsü,
- Lezyonun zaman içindeki değişimi.
Bu veriler eksik veya farklı sistemlerde dağınık olduğunda yalnızca görüntüyü analiz eden model yetersiz kalabilir.
Patolojide Otomasyon Potansiyeli
Dijital patoloji, cam preparatların tüm slayt görüntüleme sistemleriyle dijitalleştirilmesine dayanmaktadır.
Girdi tamamen dijital hâle geldiğinde yapay zekâ:
- Hücre ve tümör alanlarını belirleyebilir,
- Biyobelirteç yoğunluğunu ölçebilir,
- Gleason derecelendirmesine yardımcı olabilir,
- Hematoksilen-eozin görüntülerinden moleküler özellik tahmin edebilir,
- Tümör infiltre eden lenfositleri nicelleştirebilir.
Çalışmada Ki67 ve PD-L1 ölçümü için API 3,7 verilmiştir. Bu, çerçevedeki en yüksek tekil görev puanlarından biridir.
Yüksek puanın nedenleri şunlardır:
- Girdi dijitaldir,
- Çıktı sayısal olabilir,
- Sonuç uzmanlar arasında karşılaştırılabilir,
- Büyük görüntü veri setleri üretilebilir,
- Tekrarlanabilirlik insan gözlemine göre artırılabilir.
Çalışma ayrıca rutin histoloji görüntülerinden mikrosatellit instabilitesi tahmin eden modellerin AUC değerlerinin 0,85’in üzerine çıktığını aktarmaktadır.
Nadir veya atipik dokuların tanısı ise API 1,8 ile insan alanında tutulmuştur. Çünkü nadir durumlarda eğitim verisi az, hata sonucu ağır ve bağlamsal yorum gereksinimi yüksektir.
Patolojide Tahmini Otomasyon Oranı
Yazar, yaygın tümörlerde patoloji görevlerinin yaklaşık %70–75’inin uygun veri koşullarında otomasyona veya güçlü yapay zekâ desteğine açık olabileceğini ileri sürmektedir.
Bu oran patoloğun ortadan kalkacağı anlamına gelmez. Rolün şu alanlara kayması beklenebilir:
- Zor ve atipik vakaların değerlendirilmesi,
- Yapay zekâ çıktılarının kalite kontrolü,
- Makroskopik örnekleme kararları,
- Klinik ve moleküler verilerin bütünleştirilmesi,
- Modelin güvenilir olmadığı durumların tanınması.
Radyasyon Onkolojisinde Otomasyon
Radyasyon onkolojisi, görüntü işleme, anatomik konturlama, doz hesaplama ve tedavi planlama gibi yapılandırılmış işlemler içerir.
Çalışmada:
- Prostat, baş-boyun, akciğer ve rektum gibi yaygın endikasyonlarda otomatik konturlama için API 3,2,
- IMRT ve VMAT için bilgi tabanlı planlamada API 3,0,
- Çevrim içi uyarlanabilir radyoterapide günlük planın yapay zekâ yardımıyla yeniden hesaplanmasında API 2,6
verilmiştir.
Uyarlanabilir radyoterapi daha düşük puan almaktadır; çünkü günlük anatomik değişikliklerin klinik anlamı ve tedavi planının güvenliği hekim doğrulaması gerektirir.
Standart endikasyonlardaki radyasyon onkolojisi görevlerinin tahmini otomasyon oranı %60–65 olarak verilmiştir.
Medikal Onkoloji Neden Daha Heterojen?
Medikal onkoloji bir uçta neredeyse algoritmik tedavi seçimlerini, diğer uçta değer yüklü ve ilişkisel kararları içerir.
Örneğin metastatik küçük hücreli dışı akciğer kanserinde EGFR, ALK veya ROS1 gibi moleküler sürücü saptandığında ilk basamak tedavi seçimi büyük ölçüde kılavuz algoritmasına bağlanabilir.
Buna karşılık çok sayıda eşlik eden hastalığı bulunan, kırılgan ve tedavi toleransı belirsiz bir hastada aynı algoritmayı uygulamak yeterli olmayabilir.
| Medikal Onkoloji Karar Düğümü | API | Bölge |
|---|---|---|
| Biyobelirteç temelli ilk basamak tedavi seçimi | 3,4 | Yüksek |
| Tedavi seçeneklerinde hazard oranı ve medyan karşılaştırması | 3,8 | Yüksek |
| Klinik araştırma uygunluk eşleştirmesi | 3,5 | Yüksek |
| Evrelemeden küratif veya palyatif amaç belirlemeye geçiş | 3,1 | Yüksek/koşullu sınır |
| CTCAE toksisite derecelendirmesi ve yönetimi | 3,3 | Yüksek |
| İmmün kontrol noktası inhibitörü yan etki yönetimi | 3,2 | Yüksek |
| Ağır onkoloji dışı eşlik eden hastalıklara göre şema uyarlaması | 2,1 | Yapay zekâ destekli |
| Hasta tercihleri ve işlevsel gidişatın bütünleştirilmesi | 1,4 | İnsan alanı |
| Belirsizlik altında prognoz iletişimi | 1,2 | İnsan alanı |
Hazard Oranı Karşılaştırması Neden En Yüksek Puanlardan Birini Alıyor?
İki klinik araştırmadaki hazard oranlarını, güven aralıklarını ve medyan sağkalım sürelerini karşılaştırmak matematiksel ve metin tabanlı bir görevdir.
Yeterli veri sunulduğunda yapay zekâ:
- Çalışmaları bulabilir,
- İlgili hasta gruplarını ayırabilir,
- Sonuç ölçütlerini karşılaştırabilir,
- Mutlak ve göreli yararı hesaplayabilir,
- Kanıt tablosu oluşturabilir.
Ancak bu karşılaştırma, tedavinin belirli bir hasta için uygun olduğuna tek başına karar vermez. Hastanın yaşı, eşlik eden hastalıkları, toksisite toleransı, yaşam beklentisi ve tercihleri ayrıca değerlendirilmelidir.
Klinik Araştırma Eşleştirmesi
Klinik araştırmaların dahil edilme ve dışlanma ölçütleri çoğu zaman uzun ve karmaşıktır.
Yapay zekâ sistemleri:
- Tümör türünü,
- Evreyi,
- Moleküler profili,
- Önceki tedavileri,
- Performans durumunu,
- Organ işlevlerini,
- Coğrafi erişimi
deney ölçütleriyle eşleştirebilir.
Çalışmada aktarılan bir araştırmaya göre birden fazla otomatik eşleştirme aracının birlikte kullanılması, tek araç kullanımına göre belirlenen deney seçeneklerini %26’ya kadar artırmıştır.
Bununla birlikte yanlış veya eksik elektronik kayıtlar, uygun hastaların gözden kaçmasına ya da uygun olmayan hastaların seçilmesine neden olabilir.
7. Sayfadaki Otomasyon Matrisi
Çalışmanın 7. sayfasındaki şekil, onkoloji görevlerini iki eksende sınıflandırmaktadır:
- Yatay eksen: girdinin yapılandırılmamış anlatımdan tam dijital veriye doğru kodlanabilirliği,
- Dikey eksen: çıktının bağlamsal yargıdan deterministik algoritmaya doğru ilerlemesi.
Matris dört bölgeye ayrılmıştır:
| Bölge | Örnek Görevler |
|---|---|
| Yüksek otomasyon potansiyeli | PD-L1/Ki67 ölçümü, hazard oranı karşılaştırması, RECIST ölçümü, klinik çalışma eşleştirmesi, Gleason derecelendirmesi |
| Yapay zekâ destekli | Uyarlanabilir radyoterapi, belirsiz lezyon yorumu, eşlik eden hastalığa göre tedavi uyarlaması |
| Geçiş alanı | Serbest metinden bilgi çıkarma, anlatı temelli evreleme raporu, taburculuk belgesi ayrıştırma |
| İnsan alanı baskın | Nadir tümör tanısı, hasta tercihleri, prognoz iletişimi ve yaşam sonu kararları |
Şekil, otomasyon potansiyelinin yalnızca görevin karmaşıklığına değil, bilginin hangi formatta bulunduğuna da bağlı olduğunu göstermektedir.
Multidisipliner Otomasyon Katsayısı Nedir?
Multidisciplinary Automation Quotient, yani MAQ, tek tek görevlerin API puanlarını bir araya getirerek bütün multidisipliner kararın otomasyon potansiyelini tahmin etmeyi amaçlar.
Çalışmada MAQ, nihai karara katkı sağlayan görevlerin ağırlıklı ortalama API değeri olarak tanımlanmaktadır.
\[ MAQ = \frac{ \sum_{t=1}^{n} w_t API_t }{ \sum_{t=1}^{n} w_t } \]
Bu formülde:
- \(API_t\), t görevinin otomasyon potansiyelini,
- \(w_t\), görevin nihai multidisipliner karardaki göreli ağırlığını temsil eder.
Bu matematiksel gösterim, çalışmadaki tanımın açıklayıcı ifadesidir.
Tümör Konseyi Neden Tekil Görevlerin Toplamından Daha Fazlasıdır?
Multidisipliner tümör konseyi, radyoloji, patoloji, cerrahi, radyasyon onkolojisi ve medikal onkolojinin çıktılarının basitçe yan yana konduğu bir toplantı değildir.
Konsey şu işlevleri yerine getirir:
- Çelişen bulguları uzlaştırır,
- Eksik bilgiyi belirler,
- Farklı tedavi hedefleri arasında öncelik kurar,
- Hasta düzeyindeki özel koşulları hesaba katar,
- Kanıtın doğrudan uygulanamadığı durumlarda ortak yargı üretir.
Bu nedenle tekil görevler yüksek API puanı alsa bile bütün MDT kararının MAQ değeri daha düşük olabilir.
Çalışmada iyi tanımlanmış ve moleküler olarak karakterize edilmiş yaygın solid tümörler için MAQ değerlerinin 2,8–3,2 arasında olduğu tahmin edilmiştir. Bu aralık yüksek koşullu otomasyon bölgesine karşılık gelmektedir.
Yapay Zekâ ile Klinisyen Performansı Nasıl Karşılaştırıldı?
Çalışma, onkolojinin farklı alanlarında yapay zekâ ile klinik temel performansı karşılaştıran yayımlanmış araştırmaları anlatısal olarak incelemiştir.
Örnek alanlar şunlardır:
- Kemoterapiye bağlı hematolojik toksisite tahmini,
- Küçük hücreli dışı akciğer kanserinde sağkalım tahmini,
- Anti-PD-1 veya anti-PD-L1 tedavisine yanıt tahmini,
- Hepatoselüler karsinomda transarteriyel kemoembolizasyon yanıtı,
- Yapay zekâ tedavi önerilerinin tümör konseyi kararlarıyla uyumu.
Çalışma bu araştırmalardaki AUC, C-indeksi, duyarlılık ve uyum oranlarını tek bir meta-analitik değerde birleştirmemiştir.
Yazar bunun nedenini çalışmalar arasındaki büyük farklılıklarla açıklamaktadır:
- Hasta grupları farklıdır,
- Sonuç ölçütleri farklıdır,
- Doğrulama biçimleri farklıdır,
- Klinisyen karşılaştırma grupları aynı değildir,
- Veri kalitesi ve seçimi değişmektedir.
Bu nedenle çalışmanın ulaştığı sonuç nicel değil nitel bir sonuçtur: İyi tanımlanmış, verisi zengin ve kontrollü görevlerde yapay zekâ modelleri klinik temel performansa ulaşabilir veya onu aşabilir.
Kontrollü Deney Başarısı Gerçek Klinik Başarıyla Aynı mı?
Hayır.
Çalışma, kıyaslama sonuçlarının ideal koşullardaki teorik üst sınırlar olarak görülmesi gerektiğini özellikle vurgulamaktadır.
Kontrollü araştırmalarda model genellikle:
- Eksiksiz veri,
- Önceden seçilmiş hasta grubu,
- Tek bir görev,
- Temizlenmiş görüntü veya kayıt,
- Açık sonuç tanımı
ile değerlendirilir.
Günlük klinikte ise kayıtlar eksik, zaman baskısı yüksek, hastalar karmaşık ve kararlar çok boyutludur.
Hekim Süreksizliği Sorunu
Çalışmanın özgün tartışmalarından biri, kanser hastasının uzun tedavi süreci boyunca aynı hekim tarafından izlenmemesidir.
24–36 aylık bir tedavi döneminde hasta:
- Farklı poliklinik hekimleri,
- Nöbetçi ekipler,
- Merkez ve çevre hastane ekipleri,
- Rotasyon yapan hekimler,
- Acil servis çalışanları
tarafından değerlendirilebilir.
Her yeni hekim, hastanın klinik öyküsünü elektronik belgelerden yeniden kurmak zorundadır.
Çalışmada aktarılan araştırmalara göre sağlık hizmeti geçişlerinin %28–40’ında kritik bilgilerin atlanabildiği bildirilmiştir.
Hangi Bilgiler Kaybolabilir?
Özellikle standartlaştırılması zor bilgiler kaybolmaya açıktır:
- Doz azaltma kararının gerçek gerekçesi,
- Hastanın yan etkileri olduğundan hafif anlatma eğilimi,
- Sözlü olarak ifade edilmiş fakat kayda geçirilmemiş tercihler,
- Önceki klinisyenin belirsizlik değerlendirmesi,
- Hastanın işlevsel durumundaki yavaş değişim,
- Tedaviyi sürdürme isteğindeki zaman içindeki farklılaşma.
Yazar, yapılandırılmış ve birlikte çalışabilir bir elektronik sağlık kaydına erişen yapay zekâ sisteminin bu geçişler arasında bilgi sürekliliğini koruyabileceğini ileri sürmektedir.
Boylamsal Bilgi Bütünlüğü
Çalışma bu potansiyel avantajı Longitudinal Information Integrity, yani Boylamsal Bilgi Bütünlüğü olarak adlandırmaktadır.
Bu, yapay zekânın insanlardan daha iyi klinik yargıya sahip olduğu anlamına gelmez.
Daha sınırlı bir sistem avantajını ifade eder:
Yapay zekâ, uygun altyapı bulunduğunda yıllara yayılan çok sayıda laboratuvar, görüntüleme, ilaç, toksisite ve klinik not verisini her karar noktasında birlikte tarayabilir.
Ancak bilgi kayda hiç geçirilmemişse yapay zekâ da bu bilgiyi bilemez.
Elektronik Sağlık Kaydı Otomasyonun Temel Şartıdır
Çalışmadaki tüm otomasyon tahminleri, klinik verilerin yapılandırılmış, makine tarafından okunabilir ve birlikte çalışabilir olduğu varsayımına bağlıdır.
İtalya’daki Fascicolo Sanitario Elettronico 2.0 altyapısı örnek olarak incelenmiştir.
| Belge Türü | Yapay Zekâ Kullanımı | Yapılandırma Düzeyi | Bilgi Sürekliliğine Katkı |
|---|---|---|---|
| Laboratuvar sonuçları | Kan değerleri ve toksisite izlemi | Yüksek | Yüksek |
| Görüntüleme raporları | Radyolojik analiz | Orta; görüntü dijital, rapor çoğunlukla anlatı | Orta |
| İlaç tedavi planları | Etkileşim ve protokol kontrolü | Yüksek | Yüksek |
| Taburculuk belgeleri | Evre, eşlik eden hastalık ve önceki tedavilerin çıkarılması | Düşük; serbest metin | Düşük, kritik boşluk |
| Poliklinik notları | Bağlamsal karar desteği | Çok düşük | Çok düşük, temel boşluk |
| CTCAE toksisite kayıtları | Boylamsal yan etki profili | Çok düşük veya eksik | Düşük, kritik boşluk |
9. Sayfadaki Veri Hazırlık Matrisi
Çalışmanın 9. sayfasındaki tablo, yapay zekâ açısından en hazır verilerin laboratuvar sonuçları ve düzenlenmiş ilaç planları olduğunu göstermektedir.
En büyük boşluklar ise serbest metin hâlindeki poliklinik notları, taburculuk özetleri ve yetersiz kaydedilen toksisite verileridir.
Bu sonuç önemli bir politika çıkarımına yol açmaktadır: Onkolojide yapay zekâ kapasitesini artırmak için yalnızca daha güçlü modeller geliştirmek yeterli değildir. Klinik kayıt kalitesinin ve veri standartlarının da geliştirilmesi gerekir.
Teorik Otomasyon ile Operasyonel Otomasyon Arasındaki Fark
Çalışma iki otomasyon düzeyini ayırmaktadır:
| Kavram | Tanım |
|---|---|
| Teorik otomasyon potansiyeli | Eksiksiz, yapılandırılmış ve birlikte çalışabilir veri altında teknik olarak ulaşılabilecek üst sınır |
| Operasyonel otomasyon potansiyeli | Bir kurumun gerçek kayıt kalitesi, veri altyapısı ve iş akışı içinde uygulanabilecek düzey |
Bir görev algoritmik olarak kolay olsa bile gerekli veri kayıtta yoksa gerçek otomasyon mümkün değildir.
Bu nedenle aynı yapay zekâ sistemi farklı hastanelerde çok farklı sonuçlar verebilir.
Belirsizlik Türü Dağılımı Nedir?
Uncertainty Type Distribution, yani Belirsizlik Türü Dağılımı, klinik belirsizliği üç kategoriye ayırmaktadır.
Tip I: Epistemik belirsizlik
Karar için gerekli bilgi henüz kayıtta yoktur; fakat ilke olarak elde edilebilir.
Örnekler:
- Moleküler test sonucunun henüz çıkmamış olması,
- Yeni görüntüleme gereksinimi,
- Performans durumunun kaydedilmemiş olması,
- Organ fonksiyon testinin eksik olması.
Bilgi elde edildiğinde karar algoritmik veya olasılıksal hâle gelebilir.
Tip II: Olasılıksal belirsizlik
Gerekli veriler mevcuttur; ancak hangi seçeneğin en iyi olduğu kesin değildir.
Örnekler:
- Tedavi yanıtı olasılığı,
- Nüks riski,
- Toksisite ihtimali,
- Sağkalım tahmini.
Bu alan, makine öğrenmesi ve yapay zekâ destekli çıkarımın temel kullanım alanıdır.
Tip III: Değer yüklü belirsizlik
Hiçbir veri miktarı tek başına “doğru” kararı belirleyemez. Karar hastanın değerlerini, tercihlerini, yaşam hedeflerini, prognoz algısını ve ilişkisel bağlamı içerir.
Örnekler:
- Yaşam süresini uzatabilecek fakat ağır toksisite oluşturabilecek tedaviyi kabul edip etmeme,
- Yoğun tedavi ile yaşam kalitesi arasında seçim,
- Yaşam sonu bakım hedefleri,
- Hastanın bağımsızlığını koruma isteği,
- Aile sorumlulukları ve kişisel anlam.
Çalışma bu alanı indirgenemez insan alanı olarak tanımlamaktadır.
UTD Senaryoları
| Klinik Senaryo | Tip I | Tip II | Tip III | Yapay Zekâ Kullanımı |
|---|---|---|---|---|
| EGFR mutasyonlu evre IV küçük hücreli dışı akciğer kanseri | %20 | %55 | %25 | Yüksek |
| ALK/ROS1 pozitif evre IV küçük hücreli dışı akciğer kanseri | %18 | %52 | %30 | Yüksek |
| Metastatik HER2 pozitif meme kanseri | %22 | %50 | %28 | Yüksek |
| Metastatik MSI-H kolorektal kanser | %25 | %45 | %30 | Orta-yüksek |
| Radikal tedavi uygulanmış evre III akciğer kanserinde adjuvan karar | %22 | %58 | %20 | Yüksek |
| Erken evre hormon reseptörü pozitif meme kanserinde adjuvan karar | %20 | %52 | %28 | Yüksek |
| Tipik sunumlu nadir tümör | %15 | %30 | %55 | Az |
| Kırılgan, ileri yaşlı ve çoklu hastalığı bulunan hasta | %18 | %32 | %50 | Sınırlı |
| Palyatif bakım ve yaşam sonu kararları | %10 | %25 | %65 | En düşük |
10. Sayfadaki UTD Grafiği
Çalışmanın 10. sayfasındaki yatay yığılmış çubuk grafik, moleküler sürücüsü tanımlanmış kanserlerde mavi ve yeşil alanların, yani bilgi edinimiyle çözülebilen ve olasılıksal modellemeye açık kararların baskın olduğunu göstermektedir.
Nadir tümör, kırılgan yaşlı hasta ve palyatif bakım senaryolarında sarı alan, yani değer yüklü belirsizlik belirgin biçimde büyümektedir.
Palyatif bakım kararlarında Tip III belirsizlik %65’e ulaşmaktadır. Bu, yaşam sonu kararlarının çoğunlukla tek bir “en yüksek sağkalım olasılığı” hesabıyla çözülemeyeceğini anlatır.
Yapay Zekâ İnsan Değerlerini Hiç Kullanamaz mı?
Yapay zekâ hastanın kayıtlı tercihlerini özetleyebilir, karar seçeneklerini açıklayabilir ve benzer hasta sonuçlarını gösterebilir.
Ancak çalışma, değer yüklü kararların yalnızca verilerin işlenmesinden oluşmadığını savunmaktadır.
Bu kararlar:
- Hastanın neyi kabul edilebilir gördüğünü,
- Belirsizliği nasıl deneyimlediğini,
- Hangi yaşam hedefini önceliklendirdiğini,
- Ailesi ve hekimiyle kurduğu ilişkiyi,
- Kararın sorumluluğunu kimin taşıdığını
içerir.
Bu nedenle yapay zekâ değerleri kaydedebilir veya görünür kılabilir; fakat değerin kendisini hasta adına belirleyemez.
Hata Yapısı Nasıl Değişecek?
Çalışma, yapay zekânın hatayı ortadan kaldırmayacağını; bireysel hatadan sistematik hataya geçiş yaratabileceğini savunmaktadır.
İnsan hataları çoğu zaman:
- Kişiye özgü,
- Değişken,
- Dağınık,
- Belirli bir karar vericiye bağlanabilir
niteliktedir.
Yapay zekâ hataları ise:
- Aynı tür hastalarda tekrar edebilir,
- Eğitim verisindeki önyargıyı geniş ölçekte çoğaltabilir,
- Yeni hastane veya nüfusta performans kaybedebilir,
- Gerçek hastalık sinyali yerine veri toplama biçimine ait kestirme yolları öğrenebilir.
Önyargı ve Dağılım Değişimi
Çalışma, tıbbi yapay zekâdaki bilinen başarısızlık örneklerine de yer vermektedir.
Bir nüfus sağlığı algoritmasının klinik ihtiyacın yerine geçmiş sağlık harcamasını kullandığı için Siyah hastaları daha az yönlendirdiği aktarılmıştır.
Başka bir örnekte, belirli hastanelerin verileriyle geliştirilen pnömoni tespit modelinin dış kurumlarda belirgin performans kaybı yaşadığı belirtilmiştir.
Bu başarısızlıklar şu riskleri göstermektedir:
- Vekil değişken önyargısı,
- Dağılım kayması,
- Kestirme öğrenme,
- Temsil edilmeyen hasta gruplarında hata,
- Kurumlar arası genellenebilirlik sorunu.
Sorumluluk Kime Ait Olacak?
Mevcut sistemlerde klinik kararın hukuki sorumluluğu çoğunlukla kararı onaylayan hekime yüklenir.
Bu yapı, hekim hem kararı üreten hem de onaylayan bilişsel aktör olduğunda anlamlıdır.
Ancak yapay zekâ:
- Kanıtı buluyor,
- Veriyi birleştiriyor,
- Seçenekleri sıralıyor,
- Risk tahmini yapıyor,
- Öneriyi oluşturuyorsa
hekimin yalnızca son onayı vermesi gerçekten bağımsız klinik doğrulama sayılabilir mi?
Çalışma, bu sorunun mevcut sorumluluk düzenlemelerinde tam olarak çözülmediğini vurgulamaktadır.
Onkoloji Eğitimi Nasıl Değişmeli?
Geleneksel uzmanlık eğitimi şu becerilere yoğun biçimde yatırım yapmaktadır:
- Görüntü ve patoloji örüntülerini tanımak,
- Kılavuzları ezberlemek ve uygulamak,
- Klinik araştırma sonuçlarını karşılaştırmak,
- Standart tedavi algoritmalarını öğrenmek.
Çalışmaya göre bunlar aynı zamanda yapay zekânın en hızlı ilerlediği alanlardır.
İnsanların daha uzun süre vazgeçilmez kalacağı beceriler ise çoğu eğitim programında sistematik olarak öğretilmemektedir.
Yazar üç eğitim alanını öne çıkarmaktadır:
1. Kalibre edilmiş belirsizlik yönetimi
Eksik veya çelişkili kanıt altında karar verebilmek ve belirsizliği hastaya doğru biçimde aktarabilmek.
2. Üstbilişsel yapay zekâ denetimi
Modelin çıktısını yalnızca kabul etmek yerine:
- Verinin hastaya uygun olup olmadığını,
- Modelin hangi nüfusta eğitildiğini,
- Dağılım dışı durum bulunup bulunmadığını,
- Önerinin hangi eksik bilgiye dayandığını
sorgulayabilmek.
3. Bütünleştirici klinik anlatı
Parçalı laboratuvar, görüntüleme, tedavi, toksisite ve hasta deneyimi verilerini anlamlı bir hastalık öyküsünde birleştirebilmek.
Çalışmanın En Güçlü Tezi
Çalışmaya göre onkolojinin yapay zekâya karşı gerçek koruma alanı mevzuat veya meslek unvanı değildir.
Gerçek insan alanı şuralarda bulunmaktadır:
- Değer yüklü belirsizlik,
- İlişkisel sorumluluk,
- Eksik kanıt altında yargı,
- Hasta tercihleri,
- Yaşam hedefleri,
- Karmaşık klinik bağlamın bütünleştirilmesi.
Ancak bu insan alanı kendiliğinden korunmayacaktır. Eğitim ve klinik kültür içinde bilinçli biçimde geliştirilmesi gerekir.
Çalışmanın Güçlü Yönleri
- “Doktor mu, yapay zekâ mı?” ikiliğini görev düzeyinde parçalamaktadır.
- Otomasyon potansiyelini değerlendirilebilir beş boyuta ayırmaktadır.
- Tekil görev ile bütün multidisipliner karar arasındaki farkı MAQ ile görünür kılmaktadır.
- Klinik belirsizliği veri eksikliği, olasılık ve değer boyutlarına ayırmaktadır.
- Radyoloji, patoloji, radyasyon onkolojisi ve medikal onkolojiyi aynı çerçevede ele almaktadır.
- Elektronik sağlık kaydı kalitesini otomasyonun temel koşulu olarak göstermektedir.
- Uzun tedavi süreçlerinde hekim değişiminin bilgi kaybına etkisini tartışmaktadır.
- Yapay zekânın sistematik hata, önyargı ve dağılım kayması risklerini görmezden gelmemektedir.
- Onkoloji eğitimi için yeni beceri alanları önermektedir.
Çalışmanın Sınırlılıkları
1. API, MAQ ve UTD doğrulanmış araçlar değildir
Üç araç da yazar tarafından önerilen prototip kavramsal modellerdir. Klinik gözlemlerle ileriye dönük doğrulanmamıştır.
2. Puanlar uzman tahminidir
API değerleri birincil veri setinden hesaplanmamıştır. Literatür ve iş akışı yorumuna dayanmaktadır.
3. Eşikler ampirik olarak kalibre edilmemiştir
3,2 ve 2,4 eşikleri geçici sınıflandırma noktalarıdır. Klinik sonuçlarla doğrulanmış sınırlar değildir.
4. Otomasyon yüzdeleri gerçek iş ölçümü değildir
Radyoloji için %65–70, patoloji için %70–75 ve radyasyon onkolojisi için %60–65 oranları zaman-hareket analiziyle ölçülmemiştir.
5. UTD oranları birincil hasta verisine dayanmaz
Tip I, II ve III belirsizlik yüzdeleri yazarın model tahminleridir.
6. Kıyaslama çalışmaları heterojendir
Farklı sonuç ölçütleri ve hasta grupları nedeniyle çalışmalar doğrudan karşılaştırılamaz.
7. Yayımlanma yanlılığı olabilir
Başarılı yapay zekâ sonuçlarının yayımlanma ihtimali başarısız sonuçlara göre daha yüksek olabilir.
8. İdeal veri altyapısı varsayılmıştır
Gerçek hastanelerde kayıtlar eksik, serbest metin ağırlıklı ve sistemler arası uyumsuz olabilir.
9. Yüksek gelirli sağlık sistemlerine odaklanmıştır
Çerçeve ağırlıklı olarak İtalya ve gelişmiş elektronik kayıt altyapısı bağlamında geliştirilmiştir. Düşük kaynaklı sistemlere doğrudan genellenemez.
10. İnsan emeğinin fiziksel ve örgütsel boyutu sınırlı ele alınmıştır
Çalışma bilişsel görevleri analiz etmektedir. Muayene, girişim, komplikasyon yönetimi, ekip koordinasyonu ve bakım organizasyonu gibi bilişsel olmayan veya karma görevler aynı ayrıntıyla değerlendirilmemiştir.
11. Üretken yapay zekâ desteği kullanılmıştır
Yazar, literatür arama desteği, bibliyografik doğrulama, yapısal taslak ve İngilizce dil düzenlemesi için Claude kullandığını açıklamıştır. İçeriği gözden geçirip nihai sorumluluğu üstlendiğini belirtmiştir.
Araştırma Ne Söylemiyor?
Çalışma, onkologların %70’inin işini kaybedeceğini söylememektedir.
Radyolojinin veya patolojinin kısa sürede tamamen otonom sistemlere devredilmesini de önermemektedir.
Yüksek otomasyon potansiyeli, görevin teknik özelliklerini ifade eder; iş gücü sonucunu veya klinik uygulama kararını değil.
Araştırma ayrıca yapay zekânın değer yüklü kararları hiçbir zaman destekleyemeyeceğini iddia etmez. Yapay zekâ bilgiyi düzenleyebilir ve seçenekleri açıklayabilir; fakat hastanın değerleri adına nihai tercihi belirleyemez.
Gelecekte Nasıl Doğrulanmalı?
Çalışma üç temel araştırma önceliği önermektedir.
1. UTD’nin gerçek tümör konseylerinde ölçülmesi
Farklı kanser türlerinde kararların ne kadarının bilgi eksikliği, olasılık veya değer temelli belirsizlik içerdiği ileriye dönük gözlemlenmelidir.
2. Veri altyapısının ölçülmesi
Hastanelerde hangi verilerin yapılandırılmış, eksiksiz ve birlikte çalışabilir olduğu değerlendirilmelidir.
3. Yapay zekânın bütün hasta yoluna etkisinin test edilmesi
Yalnızca tek görev doğruluğu değil, şu sonuçlar ölçülmelidir:
- Devir teslim kalitesi,
- Hekimler arasındaki karar tutarlılığı,
- Toksisitenin erken saptanması,
- Tümör konseyi karar süresi,
- Hasta güvenliği,
- Yaşam kalitesi,
- Klinik sonuçlar.
Genel Sonuç
Bu preprint çalışma, onkolojide yapay zekâ otomasyonunu meslekler üzerinden değil görevler üzerinden değerlendiren bir kavramsal çerçeve sunmaktadır.
Automation Potential Index, klinik görevleri veri kodlanabilirliği, protokol belirleyiciliği, kanıt yoğunluğu, çıktı doğrulanabilirliği ve hata sonucu bakımından puanlamaktadır.
Multidisciplinary Automation Quotient, farklı disiplinlerin görevlerini bütün multidisipliner karar içinde birleştirmeyi amaçlamaktadır.
Uncertainty Type Distribution ise klinik belirsizliği bilgi eksikliği, olasılıksal belirsizlik ve değer yüklü belirsizlik olarak üçe ayırmaktadır.
Çalışmanın örneklerine göre görüntü analizi, biyobelirteç ölçümü, klinik araştırma eşleştirmesi, kılavuz temelli tedavi seçimi ve toksisite sınıflandırması yüksek teorik otomasyon potansiyeline sahiptir.
Nadir tümörler, ağır eşlik eden hastalıklar, kırılganlık, hasta tercihleri, prognoz iletişimi ve yaşam sonu kararları ise insan yargısının baskın olduğu alanlar olarak kalmaktadır.
Yapay zekânın onkolojideki gerçek etkisi yalnızca algoritmaların doğruluğuna bağlı değildir. Elektronik kayıtların eksiksizliği, yapılandırılması, birlikte çalışabilirliği ve klinik bağlamı koruyabilmesi aynı derecede önemlidir.
Çalışmanın en önemli mesajı, geleceğin onkoloğunun bugünkünden daha az gerekli olmayacağı; fakat gerekli olmasını sağlayan becerilerin değişeceğidir.
Protokole bağlı hesaplama ve örüntü tanıma görevlerinin bir bölümü yapay zekâya devredilirken, onkologların temel rolü yapay zekâyı denetlemek, eksik bilgiyi fark etmek, parçalı veriyi bütünleştirmek, belirsizliği yönetmek ve hastanın değerlerini klinik karara dönüştürmek olabilir.
Çalışmanın Yöntemi ve Bulguları
Araştırma birincil hasta verisi kullanan deneysel veya gözlemsel çalışma değildir. Görev ayrıştırma, anlatısal literatür taraması ve yazar tarafından geliştirilen kavramsal puanlama araçlarına dayanmaktadır.
Onkolojik iş akışı ESMO, AIOM ve NCCN kılavuzları, İtalya’daki bölgesel PDTA belgeleri ve multidisipliner onkoloji iş akışına ilişkin yayımlanmış literatür kullanılarak bilişsel görevlere ayrılmıştır.
Her görev beş boyutta 1–4 arasında puanlanmış ve ortalama API değeri hesaplanmıştır.
| Önerilen Araç | Analiz Birimi | Amacı |
|---|---|---|
| API | Tekil bilişsel görev | Görevin teorik otomasyon potansiyelini tahmin etmek |
| MAQ | Multidisipliner karar süreci | Farklı görevlerin nihai karardaki ağırlıklı otomasyon potansiyelini hesaplamak |
| UTD | Klinik senaryodaki belirsizlik | Belirsizliğin bilgi eksikliği, olasılık ve değer boyutlarına dağılımını göstermek |
Çalışmanın temel tahminleri şunlardır:
| Alan | Uygun Veri Koşullarında Tahmini Otomasyona Açık Bilişsel İş |
|---|---|
| Radyoloji | %65–70 |
| Patoloji | %70–75 |
| Radyasyon onkolojisi | %60–65 |
| Moleküler olarak tanımlanmış yaygın solid tümörlerde MDT kararı | MAQ 2,8–3,2; koşullu otomasyon bölgesi |
Moleküler sürücüsü belirlenmiş senaryolarda Tip I ve Tip II belirsizliğin toplamı yaklaşık %70–80 arasındadır. Nadir tümör, kırılgan yaşlı hasta ve palyatif bakım kararlarında Tip III değer yüklü belirsizlik %50–65’e ulaşmaktadır.
Çalışmadaki bütün sayısal puanlar ve yüzdeler yazar tarafından oluşturulan kavramsal tahminlerdir. Birincil klinik veriyle kalibre edilmemiştir.
Kaynak ve Yöntem Notu
Bu makale, “A Conceptual Task-Based Framework for Estimating AI Automation Potential in Multidisciplinary Oncology Workflows: Introducing the API, MAQ, and UTD Instruments” başlıklı çalışmaya dayanmaktadır.
Belgede yazar bilgileri kör hakemlik amacıyla çıkarılmıştır. Metinde açık biçimde “This preprint research paper has not been peer reviewed” ifadesi bulunmaktadır. Çalışma SSRN üzerinde preprint olarak sunulmuş ve hakem değerlendirmesinden geçmemiştir.
Çalışma API, MAQ ve UTD adında üç yeni prototip araç önermektedir. Araçlar ileriye dönük gözlemsel çalışmalarla doğrulanmamıştır. Boyutlar, ağırlıklar, eşikler ve örnek puanlar uzman görüşüne dayalı yaklaşık değerlerdir.
Literatür taraması, yapay zekâ ile klinik temel performansı nicel olarak karşılaştıran hakemli araştırmalara odaklanmıştır. Ancak farklı görev ve ölçütlerin heterojenliği nedeniyle meta-analiz yapılmamıştır.
Çalışma herhangi bir dış finansman veya çıkar çatışması bildirmemiştir.
Yazar, literatür arama desteği, bibliyografik kaynak doğrulama, yapısal taslak hazırlama ve İngilizce dil düzenlemesi için Anthropic Claude kullandığını açıklamıştır. Metni sonradan gözden geçirdiğini ve içeriğin sorumluluğunu üstlendiğini belirtmiştir.
Çalışmada bildirilen otomasyon oranları gerçek hastane iş yükü ölçümleri değildir. “Teorik otomasyon potansiyeli” uygun ve eksiksiz veri koşullarındaki teknik üst sınırı ifade etmektedir.
Bu içerikte çalışmanın ileri sürmediği iş kaybı oranları, tam otonom klinik kullanım, kanıtlanmış hasta yararı veya kesin gelecek tahminleri eklenmemiştir. API, MAQ ve UTD sonuçları klinik uygulama aracı olarak değil, doğrulanmayı bekleyen kavramsal tahminler olarak aktarılmıştır.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir