


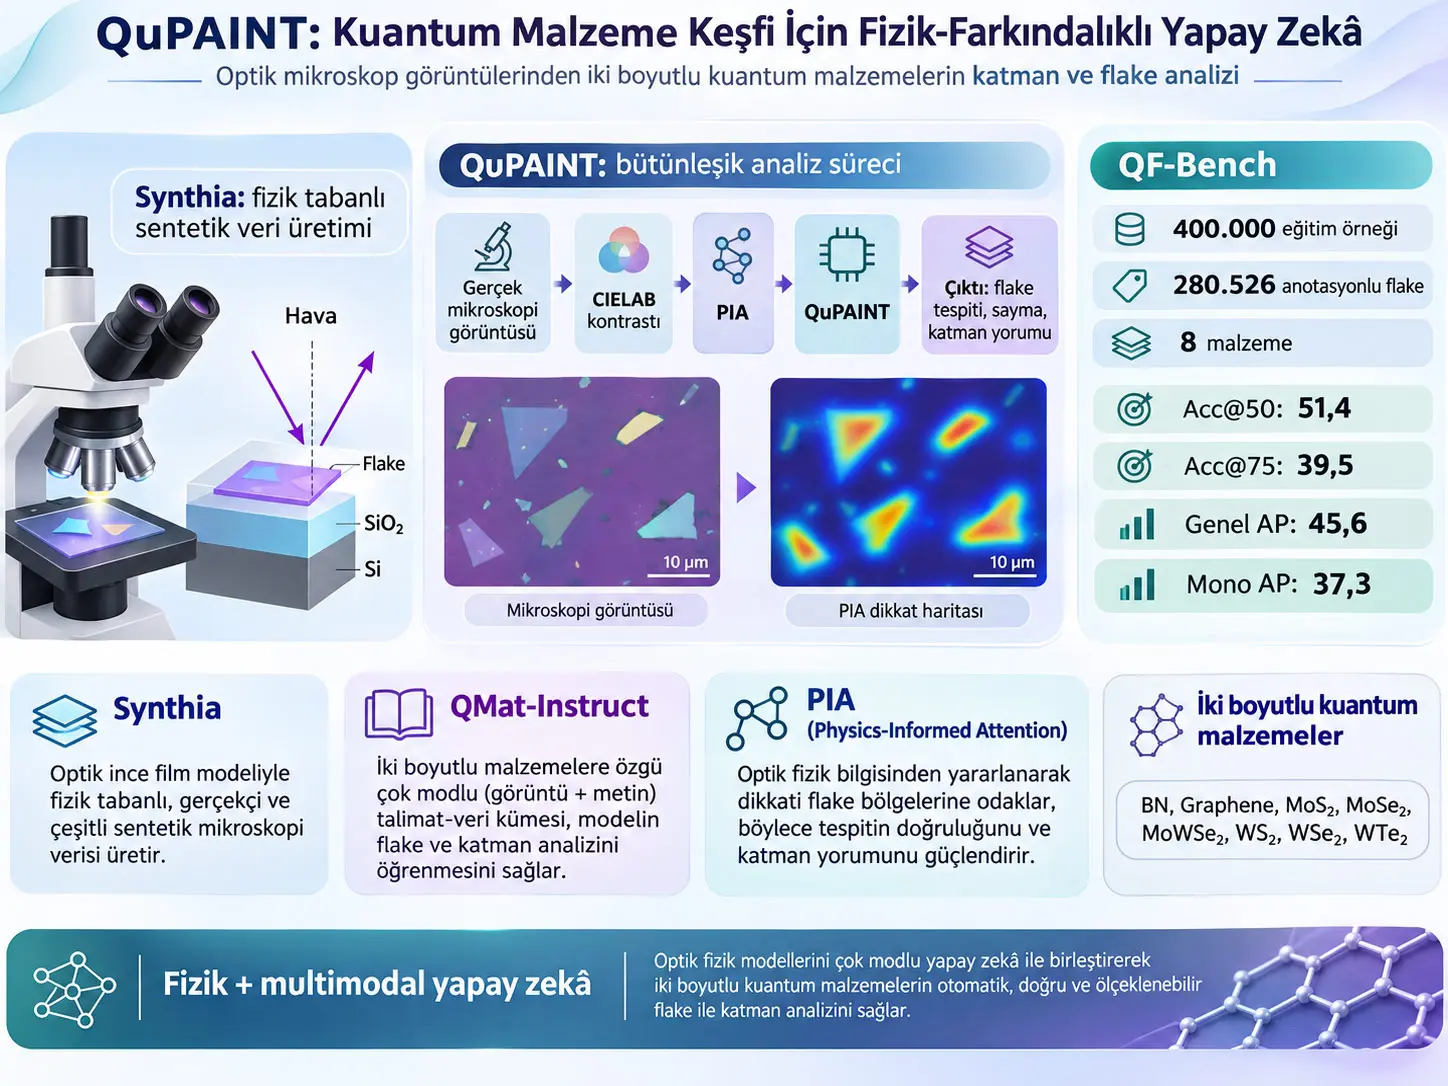
QuPAINT (Physics-Aware Instruction Tuning), iki boyutlu kuantum malzemelerin optik mikroskop görüntülerini fiziksel optik öncüller ile çok kipli yapay zekâyı birlikte kullanarak karakterize etmeyi amaçlayan bir multimodal model çerçevesidir. Çalışma dört birbirine bağlı bileşen kurar: Synthia, ince-film girişimini Transfer Matrix Method (TMM) ile modelleyerek fiziksel olarak temellendirilmiş sentetik flake görüntüleri üretir; QMat-Instruct, bu görüntüleri fizik-bilgili soru–cevap çiftleriyle birleştirir; Physics-Informed Attention (PIA), mikroskop görüntüsündeki flake–substrat renk kontrastını CIELAB uzayında ölçerek görsel tokenları fiziksel açıdan yeniden ağırlıklandırır; QF-Bench ise farklı iki boyutlu malzemeler ve görüntüleme koşulları üzerinde modeli değerlendirmek için anotasyonlu bir benchmark sağlar.
Buradaki “kuantum malzeme” ifadesi, yöntemin bir kuantum bilgisayar üzerinde çalıştığı anlamına gelmez. Kullanılan öğrenme mimarisi klasik yapay zekâ ve bilgisayarlı görü modelidir. “Kuantum” niteliği, grafen, MoS2, WTe2, h-BN ve benzeri atomik incelikteki malzemelerin elektronik, optik ve kuantum özelliklerinin katman sayısına güçlü biçimde bağlı olmasından gelir. Çalışmanın hedefi yeni bir kuantum parçacığı veya yeni bir malzeme sentezlemek değil; mevcut iki boyutlu flake'leri optik mikroskop görüntülerinden daha güvenilir biçimde bulmak, konumlandırmak ve katman sınıflarıyla ilişkilendirmektir.
Kaynak, gerçek laboratuvar iş akışındaki temel problemi şöyle tanımlar: optik mikroskopi çok sayıda flake'in hızlı biçimde görüntülenmesine olanak verir fakat kalınlığı doğrudan ve kesin olarak sağlamaz; Atomic Force Microscopy (AFM) ise nanometre ölçeğinde kalınlık ölçümü sağlayabilir fakat yavaştır, fiziksel örnek aktarımı gerektirir ve büyük veri toplamada ölçeklenmesi zordur. Ayrıca mono-, bi- ve birkaç katmanlı flake'ler arasındaki görsel kontrast farkları; aydınlatma, kamera, substrat kalınlığı ve beyaz dengesi kaynaklı değişimlerden daha küçük olabilir. Bu nedenle yalnız RGB görünümüne dayanan genel nesne tespit modelleri farklı laboratuvarlara aktarılırken zorlanabilir.
QMat-Instruct eğitim verisi sekiz malzeme için malzeme başına 50.000 örnek olacak biçimde toplam 400.000 örnek içerir. Kaynak, gerçek ve fizik tabanlı sentetik görüntüleri birlikte kullanır. Eğitimde mikroskop görüntüleri 448×448 boyutuna getirilir ve üst üste binmeyen 14×14 patch'lere ayrılır. Görsel taraf InternViT uygulamasını kullanır; text encoder Qwen3'ten başlatılır. AdamW optimizer, \(2\times10^{-5}\) learning rate, \(1\times10^{-4}\) weight decay, batch size 4 ve 2 epoch kullanılmış; eğitim 16 A100 GPU üzerinde yürütülmüştür.
QF-Bench tablosunda BN, Graphene, MoS2, MoSe2, MoWSe2, WS2, WSe2 ve WTe2 olmak üzere sekiz malzemede toplam 280.526 flake anotasyonu raporlanmaktadır. Bunların 2.546'sı Mono, 3.417'si Few ve 274.563'ü Thick kategorisindedir. Bu dağılım, ince ve özellikle tek katmanlı flake sınıflarının benchmark içinde çok daha az temsil edildiğini açıkça gösterir.
Instruction grounding değerlendirmesinde QuPAINT-2B, Acc@50 = 51,4 ve Acc@75 = 39,5 elde ederek aynı tabloda verilen InternVL-2B ve Qwen3VL-2B modellerinin üzerinde sonuç vermiştir. Genel flake tespitinde QuPAINT-8B 45,6 AP, 60,5 AP50 ve 47,9 AP75; mono-layer tespitinde ise 37,3 AP, 52,8 AP50 ve 39,9 AP75 raporlamaktadır. Bu sayılar çalışmanın QF-Bench değerlendirmesine aittir; farklı mikroskoplar, substratlar veya doğrulanmamış malzeme sistemlerinde aynı performansın garanti edildiği anlamına gelmez.
Çalışma ayrıca iki temel sınırlılık bildirir. Synthia gerçek mikroskoplarda görülen bütün flake kusurlarını ve bütün görüntüleme çeşitliliğini yeniden üretemediğinden yeni laboratuvarlarda domain gap kalabilir. QuPAINT'ın ikinci temel sınırı multimodal modelin maksimum token uzunluğudur; aşırı yoğun flake içeren görüntüler çok fazla görsel token üretirse model sahnenin tamamını işlemek konusunda zorlanabilir.
QuPAINT Bir Kuantum Bilgisayarı mı Kullanıyor?
Hayır. QuPAINT, klasik GPU'larda eğitilen bir bilgisayarlı görü ve multimodal büyük dil modeli çerçevesidir; “quantum” sözcüğü hesaplama donanımını değil, analiz edilen iki boyutlu kuantum malzemeleri ifade eder. Fiziksel optik model TMM ile ince-film girişimini hesaplar, PIA optik kontrastı görsel attention öncülüne dönüştürür ve multimodal model bu bilgiyi görüntü ve metinle birlikte işler.
İki boyutlu kuantum malzemelerde katman sayısı neden bu kadar önemlidir?
Atomik incelikte iki boyutlu malzemelerde yalnızca birkaç atomik katmanın eklenmesi veya çıkarılması elektronik bant yapısını, optik yanıtı ve başka kuantum özelliklerini değiştirebilir. Bu nedenle bir flake'in yalnız “orada olup olmadığını” bulmak yeterli değildir; monolayer, bilayer veya daha kalın bir bölge olup olmadığı da bilimsel olarak önemlidir.
Kaynak, örnek olarak graphene, MoS2 ve WTe2 gibi sistemleri verir. Ancak çalışmanın kendisi bu malzemelerin elektronik bant yapılarını hesaplamaz. Araştırmanın doğrudan görevi, katman sayısıyla ilişkili optik kontrastın görüntü işleme ve multimodal öğrenme için kullanılabilir hâle getirilmesidir.
Optik mikroskop ile AFM arasındaki fark
| Yöntem | Avantaj | Sınırlılık | Çalışmadaki rol |
|---|---|---|---|
| Optik mikroskopi | Binlerce flake'i hızlı biçimde görüntüleyebilir. | Katman kalınlığını tek başına kesin biçimde vermez; renk aydınlatma ve substrattan etkilenir. | QuPAINT'ın ana görüntü girdisini oluşturur. |
| Atomic Force Microscopy (AFM) | Nanometre ölçeğinde fiziksel kalınlık ölçümü sağlar. | Yavaştır; flake'in yeniden bulunması, örnek aktarımı ve tek tek ölçüm gerekir. | Optik görünümden otomatik tahmin ihtiyacının motivasyonunu oluşturur. |
QuPAINT'ın amacı AFM'nin fiziksel ölçüm yeteneğini ortadan kaldırdığını kanıtlamak değildir. Model optik görüntüden aday flake ve katman sınıfı çıkarımı yapar. Kritik fiziksel karakterizasyon gereken deneylerde AFM, Raman spektroskopisi veya başka bağımsız ölçüm yöntemlerinin gereksiz hâle geldiği sonucunu bu çalışma desteklemez.
Synthia İki Boyutlu Kuantum Malzeme Görüntülerini Nasıl Üretiyor?
Synthia, gerçek mikroskop arka planları üzerine yerleştirilecek sentetik iki boyutlu flake'lerin renklerini rastgele seçmek yerine, hava–flake–SiO2–Si katman sisteminin ince-film girişimini Transfer Matrix Method ile hesaplayan, sonucu CIE renk uzayına dönüştüren ve daha sonra gerçek görüntünün beyaz dengesi ile temiz substrat bölgelerine uyarlayan fizik tabanlı bir sentetik veri üretim çerçevesidir.
Transfer Matrix Method neden gerekli?
İki boyutlu bir flake optik mikroskopta yalnız kendi “doğal rengi” nedeniyle görünmez. Flake, SiO2 ve Si gibi katmanların sınırlarında ışık tekrar tekrar yansır ve iletilir. Farklı optik yollar arasında oluşan faz farkı belirli dalga boylarını güçlendirip diğerlerini zayıflatabilir. Bu olay ince-film girişimidir.
Synthia, her katmanı karmaşık kırılma indisi:
ve fiziksel kalınlık \(d_l\) ile tanımlar. \(n_l\) kırılma indisinin gerçek kısmını, \(k_l\) absorpsiyonla ilişkili sönüm kısmını, \(\lambda\) ışığın dalga boyunu gösterir. Kırılma indisleri boyutsuzdur; \(\lambda\) ve \(d_l\) aynı uzunluk biriminde ele alınmalıdır.
Denklem (1): Katman sınırındaki Fresnel katsayıları
\(r_{l,l+1}\), \(l\). katmandan \(l+1\). katmana geçişte yansıma genlik katsayısını; \(t_{l,l+1}\), iletim genlik katsayısını temsil eder. Bunlar doğrudan ışık şiddeti değildir; elektrik alan genlikları arasındaki oranlardır ve boyutsuzdur.
Katman içinde ışığın ilerlemesi faz gecikmesi üretir. Kaynak bu ilişkiyi:
şeklinde kullanır ve her katmanın yayılımını bir \(P_l\) propagation matrix ile temsil eder. Fiziksel anlam açıktır: aynı kalınlıkta daha büyük kırılma indisi optik yolu artırır; aynı malzemede daha büyük dalga boyu ise birim kalınlık başına faz birikimini azaltır.
Denklem (2): Bütün katmanların transfer-matrix zinciri
\(u_0=1\), gelen elektrik alan genliğinin normalizasyonudur. \(v\), toplam yansımış alan genliği; \(u\), substrata iletilen alan genliğidir. \(M_{l,l+1}\), arayüz transfer matrix'ini; \(P_l\), \(l\). tabakadaki propagation matrix'i temsil eder.
Yansıma:
ile hesaplanır. \(R(\lambda)\) boyutsuz bir yoğunluk oranıdır ve ışığın dalga boyuna bağlıdır.
Kaynak sentetik flake üretiminde görünür tayfı:
aralığında \(D\) ayrık dalga boyunda örneklemektedir.
Denklem (3): Yansıma tayfı RGB rengine nasıl dönüşüyor?
\(\mathbf{S}(\lambda)\in\mathbb{R}^{3\times1}\), CIE 1931 renk-eşleme fonksiyonlarının üç renk bileşenini; \(I(\lambda)\), standart aydınlatıcının spektrumunu; \(R(\lambda)\), hesaplanan reflectance değerini temsil eder. Sonuç \(\mathbf{x}\), RGB renk bileşenleriyle ilişkilendirilen üç bileşenli renk vektörüdür.
Kaynak aynı ifadeyi matrix biçiminde:
olarak da yazar. \(\circ\), element-wise product yani aynı dalga boyundaki aydınlatma ile yansıma değerlerinin eleman bazında çarpılmasıdır.
Optik model Python'daki tmm paketiyle uygulanmıştır. Synthia, örneğin graphene, MoS2, WSe2 ve h-BN için dalga boyuna bağlı \(n(\lambda)\) ve \(k(\lambda)\) fonksiyonlarını kullanarak farklı kalınlıklardaki reflectance spektrumlarını hesaplar.
Synthia'nın önceki sentetik üretime eklediği bileşenler
| Özellik | MaskTerial | Synthia |
|---|---|---|
| Birden fazla malzeme kaynağından flake şekilleri | Var | Var |
| Fizik tabanlı optik simülasyon (TMM) | Var | Var |
| Kişiselleştirilmiş renk kalibrasyonu | Yok | Var |
| CIE standardının kullanılması | Yok | Var |
| Mevcut flake'lerle çakışmayı önleme | Yok | Var |
White-Balance-Aware modülü neden gerekli?
Gerçek mikroskop görüntülerinde kullanıcı veya cihaz RGB kanallarına farklı gain değerleri uygulayabilir. Aynı malzeme ve substrat bile farklı laboratuvarlarda farklı renklerde görünebilir. Synthia bu farkı fizik modelini terk ederek değil, fizik modelinden üretilen renge gerçek referans görüntüsünden çıkarılan kanal kazançlarını uygulayarak ele alır.
Substrate-Aware modül neden gerekli?
Sentetik flake rastgele herhangi bir piksele yerleştirilirse gerçek flake'lerin, kirlerin veya başka yapıların üzerine binebilir. Bu durum fiziksel olarak gerçekçi olmayan compositing artefact'ları oluşturabilir. Synthia PIA tabanlı dikkat haritasından düşük dikkatli, temiz substrat bölgelerini seçerek sentetik flake'i yalnız geçerli bölgelere yerleştirmeyi amaçlar.
Synthia Algorithm 1'in işlem sırası
| Aşama | İşlem | Amaç |
|---|---|---|
| 1 | Referans substratın median rengi çıkarılır. | Gerçek görüntünün renk kalibrasyonunu temsil etmek. |
| 2 | Hava–SiO2–Si substratının TMM reflectance spektrumu hesaplanır. | Fizik modelinin beklediği substrat rengini bulmak. |
| 3 | CIE projeksiyonuyla fiziksel substrat rengi hesaplanır. | Spektrumu görüntü renk uzayına taşımak. |
| 4 | Gerçek ve model substrat renkleri arasından kanal bazlı gain \(g\) çıkarılır. | White-balance farkını modellemek. |
| 5 | PIA haritası oluşturulup normalize edilir. | Temiz substrat bölgelerini belirlemek. |
| 6 | 90. yüzdelik eşiğe göre substrat maskesi elde edilir. | Yüksek kontrastlı mevcut flake/tekstür bölgelerini dışlamak. |
| 7 | Random flake mask ve malzemeye uygun thickness örneklenir. | Sentetik flake geometrisi ve fiziksel kalınlığını seçmek. |
| 8 | Mevcut yapılarla örtüşmeyen koordinat seçilir. | Fiziksel olarak anlamsız overlap'ı engellemek. |
| 9 | Hava–flake–SiO2–Si yığını için reflectance hesaplanır. | Katman sayısına bağlı optik görünümü oluşturmak. |
| 10 | Reflectance CIE ile renge dönüştürülür ve white-balance gain uygulanır. | Gerçek mikroskop görüntüsüne daha uyumlu renk üretmek. |
| 11 | Sentetik flake gerçek substrat bölgesine maskeyle kompoze edilir. | Son sentetik mikroskop görüntüsünü oluşturmak. |
QMat-Instruct nedir?
QMat-Instruct, yazarların kuantum malzeme karakterizasyonu için geliştirdiği çok kipli physics-aware instruction veri setidir. Her örnek yalnız bir mikroskop görüntüsü veya bounding box etiketi değildir; görüntüye bağlı doğal dil sorusu ve fiziksel görünümü açıklayan cevap içerir.
Kaynak örnek görevleri üç temel sınıfta verir: flake sayma, flake konumlandırma ve belirli bir katman sınıfının mevcut olup olmadığını doğrulama. Açıklamalarda kontrast, renk kayması ve kenar saydamlığı gibi ince-film girişimiyle ilişkili görsel ipuçları bulunur.
Kaynak eğitim setinde sekiz malzeme kullanır:
BN, Graphene, MoS2, MoSe2, MoWSe2, WS2, WSe2 ve WTe2.
Her malzeme için 50.000 sample oluşturulduğu ve toplam eğitim örneğinin:
olduğu kaynakta açıkça belirtilmektedir.
Physics-Informed Attention (PIA) Neyi Ölçüyor?
Physics-Informed Attention (PIA), her görüntü patch'inin CIELAB renk uzayındaki median renginin görüntünün median substrat renginden Öklid uzaklığını hesaplayarak flake–substrat optik kontrastını temsil eden bir dikkat öncülü üretir; QuPAINT bu fizik tabanlı skoru öğrenilebilir bir affine düzeltmeden geçirip görsel tokenları ağırlıklandırmak için kullanır.
Vision encoder: Denklem (4)
\(I\in\mathbb{R}^{H\times W\times C}\), mikroskop görüntüsüdür. \(H\) görüntü yüksekliği, \(W\) genişliği, \(C\) kanal sayısıdır. \(Enc_v\) vision encoder; \(v_i\), \(i\). patch için \(d\)-boyutlu görsel embedding; \(k\), toplam patch/token sayısıdır.
PIA her patch için:
physics-based contrast score üretir.
Neden fizik skoru doğrudan kullanılmıyor?
Saf fizik modeli laboratuvarın gerçek kamera spectral response'unu, white-balance tercihlerini ve tüm illumination farklarını tam olarak bilemeyebilir. Bu nedenle QuPAINT fiziksel öncülü sabit bırakmak yerine yalnız ölçek ve bias'ı öğrenen küçük bir kalibrasyon ekler.
Denklem (5): Öğrenilebilir PIA düzeltmesi
\(\sigma\), logistic sigmoid fonksiyonudur. \(\alpha_i\), ham fizik tabanlı attention score; \(w\) ve \(b\), eğitim sırasında öğrenilen tek boyutlu ölçek ve kaydırma parametreleridir. \(\beta_i\), görsel token üzerinde uygulanacak düzeltilmiş attention ağırlığıdır.
Denklem (6): Görsel tokenların fiziksel ağırlıklandırılması
\(\beta_i\) küçükse ilgili patch embedding'in modele katkısı bastırılır; büyükse görsel token daha güçlü taşınır. Ancak bu, fiziksel olarak “bu patch kesin flake'dir” anlamına gelmez. \(\beta_i\), multimodal model içinde kullanılan bir attention ağırlığıdır.
Denklem (7): Metin encoder
\(T=\{T_1,\ldots,T_L\}\), kullanıcı talimatı veya fizik-bilgili soru dizisidir. \(Enc_t\), text encoder; \(t_j\), her metin tokenının embedding'idir.
Denklem (8): Multimodal çıktı
Fizik ağırlıklı görsel tokenlar ile metin tokenları multimodal decoder'a verilir. \(Y\), modelin ürettiği cevap token dizisidir; \(M\), çıktı uzunluğudur.
Denklem (9): Autoregressive dil-modeli kaybı
\[ \mathcal{L}_{LM} = -\frac{1}{M} \sum_{j=1}^{M} \log P_\theta \left( y_j \mid y_{
Bu loss, doğru sonraki tokena verilen olasılığı yükseltmeye çalışır. \(y_{
PIA için ayrıca bağımsız bir doğrudan supervision loss uygulanmaz. \(w\) ve \(b\), dil-modeli loss'undan gelen backpropagation yoluyla dolaylı olarak optimize edilir. Böylece fiziksel attention tamamen serbest bir neural attention'a dönüştürülmeden küçük bir öğrenilebilir kalibrasyon kazanır.
CIELAB neden RGB yerine kullanılıyor?
RGB değerleri doğrudan kamera spectral response'u, exposure ve white-balance işlemlerinden etkilenebilir. CIELAB ise luminance \(L^\ast\) ile iki chromatic coordinate olan \(a^\ast\) ve \(b^\ast\)'yi ayıran perceptual bir renk uzayıdır. Kaynak, flake ile substrat arasındaki CIELAB mesafesini thin-film interference kaynaklı reflectance farkına daha dayanıklı bir image-space proxy olarak kullanır.
Denklem (10): CIELAB perceptual contrast
\(\Phi\), RGB'den CIELAB'a nonlinear dönüşüm; \(I(x)\), incelenen pixel/patch rengi; \(I_{bg}\), substrat arka plan rengi; \(\|\cdot\|_2\), Öklid normudur.
\(\Delta E\) fiziksel uzunluk, enerji veya elektrik alan birimine sahip değildir. CIELAB koordinatları arasındaki algısal renk farkını temsil eden boyutsuz bir contrast skorudur.
Denklem (11): Patch-level PIA skoru
\(\hat I_k\), \(k\). patch'in median rengidir. \(I_{bg}\), bütün görüntü veya seçilmiş region-of-interest içindeki median arka plan rengidir.
Ek materyal: ΔE ile optik reflectance arasındaki birinci-derece bağlantı
Supplementary material, CIELAB contrast'ın fiziksel optik modelle bağlantısını bir first-order Taylor approximation üzerinden açıklar. Flake'in substrata göre spectral reflectance farkı:
olarak tanımlanır. Mono- ve few-layer flakes için \(\|\Delta R\|_\infty\)'nin küçük olduğu varsayımı altında RGB→LAB dönüşümü substrat rengi çevresinde lineerleştirilir:
\(J_\Phi(I_{bg})\), RGB→LAB dönüşümünün \(I_{bg}\) noktasındaki Jacobian matrix'idir. \(E(\lambda)\), illumination spectrum; \(S(\lambda)\), kamera/renk matching spectral response; \(\Delta R(\lambda)\), flake'in substrata göre reflectance farkıdır.
Kaynak ardından belirli pozitif \(c\) sabiti için:
bağıntısını verir.
Bu ispatın yorum sınırı önemlidir: kaynak \(\Delta E\)'yi katman sayısıyla yerel olarak monotonic bir proxy şeklinde gerekçelendirir. Bu, bütün malzemelerde, bütün thickness aralıklarında ve bütün optik düzenlerde global olarak tek-değerli “ΔE → katman sayısı” dönüşümünün kanıtlandığı anlamına gelmez.
Supplementary White-Balance denklemleri
Gerçek referans substratın kanal bazlı ortalama rengi:
Burada \(M_{sub}\), temiz substrat piksellerini seçen binary maskedir.
Fizik modelinden hesaplanan white-balance öncesi substrat rengi:
Kaynak diagonal channel-gain yaklaşımıyla:
ifadesini verir. \(\oslash\), element-wise division'dır.
Bu gain sentetik görüntünün her RGB kanalına:
şeklinde uygulanır ve sonuç \([0,1]\) aralığına clip edilir.
Supplementary Substrate-Aware yerleşim denklemleri
LAB attention haritası:
üretildikten sonra:
ile normalize edilir.
Temiz substrat maskesi:
olarak tanımlanır. Yüksek-attention bölgeleri flake veya yüksek tekstürlü alan kabul edilip dışarıda bırakılır.
Sentetik flake maskesi \(M_i\), seçilen koordinatta temiz substratla uyumlu olmalıdır:
\(\odot\), element-wise multiplication'dır. Sonucun sıfır olması sentetik flake maskesinin mevcut yasak bölgeyle kesişmemesi gerektiğini ifade eder.
Seçilmiş malzeme \(s\), layer stack \(S=\{\mathrm{air},s,\mathrm{SiO_2},\mathrm{Si}\}\) ve thickness \(t_i\) için:
reflectance spectrum hesaplanır.
Bu spectrum CIE renk projeksiyonuyla:
RGB renge dönüştürülür.
Son compositing:
ile yapılır. \(M_i=1\) olan flake piksellerinde sentetik renk kullanılır; \(M_i=0\) olan piksellerde gerçek substrat görüntüsü korunur.
Çalışmanın Yöntemi ve Bulguları
QF-Bench Neyi Ölçüyor ve Neden Önemli?
QF-Bench, QuPAINT ve diğer modellerin farklı iki boyutlu malzemelerde flake tespiti ve katman sınıfına duyarlı localization başarısını ortak protokolle karşılaştırmak için oluşturulan anotasyonlu benchmark'tır; kaynak sekiz malzemede 280.526 flake anotasyonu bildirir ve model performansını genel flake, mono-layer flake ve instruction-grounding görevlerinde ölçer.
Model eğitimi ve inference ayarları
| Parametre | Değer | Rol |
|---|---|---|
| Görsel uygulama | InternViT | Vision encoder altyapısı |
| Görüntü boyutu | 448×448 | Model girdisi |
| Patch | 14×14, üst üste binmeyen | Vision token üretimi |
| Text encoder initialization | Qwen3 | Talimat embedding'leri |
| Optimizer | AdamW | Parametre optimizasyonu |
| Learning rate | \(2\times10^{-5}\) | Optimizer adım büyüklüğü |
| Weight decay | \(1\times10^{-4}\) | Regularization |
| Batch size | 4 | Mini-batch boyutu |
| Epoch | 2 | Eğitim turu |
| GPU | 16 × A100 | Eğitim donanımı |
| Augmentation | Random crop, horizontal flip, CIELAB color jitter | Illumination ve white-balance robustness |
| Inference temperature | \(T=0.2\) | Üretim sampling ayarı |
QF-Bench flake dağılımı
| Malzeme | Mono | Few | Thick | Toplam |
|---|---|---|---|---|
| Toplam | 2.546 | 3.417 | 274.563 | 280.526 |
| BN | 13 | 111 | 10.100 | 10.224 |
| Graphene | 1.856 | 2.081 | 4.270 | 8.207 |
| MoS2 | 246 | 536 | 108.352 | 109.134 |
| MoSe2 | 24 | 32 | 1.327 | 1.383 |
| MoWSe2 | 9 | 35 | 293 | 337 |
| WS2 | 43 | 5 | 2.144 | 2.192 |
| WSe2 | 207 | 35 | 6.195 | 6.437 |
| WTe2 | 148 | 582 | 141.882 | 142.612 |
Kaynak içi kategori sınırı notu: ana metin QF-Bench için “mono-layer, few-layer (2–5 layers) ve thick (5+ layers)” ifadesini kullanmaktadır. Bu yazım 5 katmanlı örneği iki sınıra birden dahil ediyor gibi görünmektedir. Verianla bunu 2–4 biçiminde sessizce değiştirmemiştir. Table 2 yalnız Mono/Few/Thick sayımlarını verdiği için 5-layer örneklerin hangi kategoriye fiilen kodlandığını bu PDF'den kesinleştirmek mümkün değildir.
AP, AP50 ve AP75 neyi ölçer?
Kaynak standart object-detection metrikleri olan AP, AP50 ve AP75'i kullanır. Temel localization ölçüsü Intersection over Union (IoU)'dur. Aşağıdaki IoU formülü bu metrikleri açıklamak için verilen standart bilgisayarlı görü arka planıdır; çalışmanın yeni bulgusu değildir:
\(B_{\mathrm{pred}}\), modelin tahmin ettiği bounding box; \(B_{\mathrm{gt}}\), ground-truth kutusudur. IoU 1'e yaklaştıkça iki kutu daha güçlü örtüşür.
AP50, 0,50 IoU eşiğindeki precision–recall performansını; AP75, daha katı 0,75 IoU eşiğindeki performansı temsil eder. AP75'in yüksek olması yalnız flake'in yaklaşık bölgesini bulmanın değil, bounding box'ın daha sıkı konumlandırılmasının da iyi olduğuna işaret eder.
Instruction grounding sonuçları
| Model | Acc@50 | Acc@75 |
|---|---|---|
| InternVL-2B | 43,3 | 30,8 |
| Qwen3VL-2B | 45,8 | 32,1 |
| QuPAINT-2B | 51,4 | 39,5 |
Instruction grounding, modelin yalnız doğal dil cevabı oluşturmasını değil, talimatla ilgili flake bölgesini doğru görüntü konumuna bağlayabilmesini değerlendirir. Kaynak RefCOCO değerlendirme protokolünü takip ettiğini belirtmektedir.
Genel ve mono-layer flake tespiti
| Model | Genel Flake Detection | Mono Flake Detection | Parametre | FLOPs | ||||
|---|---|---|---|---|---|---|---|---|
| AP | AP50 | AP75 | AP | AP50 | AP75 | |||
| MaskRCNN-R50 | 18,7 | 36,5 | 17,8 | 9,8 | 28,9 | 9,0 | 44M | 134,4B |
| MaskRCNN-R101 | 20,3 | 38,1 | 18,9 | 11,1 | 30,6 | 10,3 | 63M | 334,8B |
| ViTDet (base) | 17,4 | 35,2 | 16,5 | 8,7 | 27,6 | 7,8 | 86M | 1,3T |
| ViTDet (large) | 18,9 | 37,0 | 17,3 | 9,9 | 29,8 | 8,5 | 300M | 4,1T |
| YOLOv11-m | 24,8 | 41,9 | 21,1 | 17,0 | 27,2 | 16,4 | 20M | 68,0B |
| YOLOv11-l | 26,9 | 43,0 | 23,5 | 18,9 | 29,8 | 17,3 | 25M | 86,9B |
| YOLOv11-x | 29,6 | 44,5 | 24,6 | 19,8 | 31,3 | 18,7 | 57M | 194,9B |
| Co-DETR | 22,7 | 35,9 | 23,3 | 12,2 | 25,3 | 11,4 | 304M | 119,4B |
| RT-DETRv2 | 27,5 | 37,2 | 27,0 | 17,5 | 37,8 | 14,7 | 76M | 259,0B |
| MaskTerial | 23,8 | 41,0 | 25,4 | 16,8 | 35,5 | 17,2 | 45M | 150,7B |
| φ-Adapt | 30,3 | 49,1 | 27,4 | 24,1 | 38,2 | 23,4 | 91M | 368,3B |
| QuPAINT-1B | 36,9 | 50,7 | 38,6 | 28,0 | 42,9 | 29,5 | 1,1B | 1,5T |
| QuPAINT-2B | 38,7 | 53,6 | 41,2 | 30,2 | 45,5 | 32,0 | 2,3B | 3,4T |
| QuPAINT-4B | 42,4 | 58,2 | 46,8 | 34,1 | 50,2 | 38,0 | 4,7B | 7,9T |
| QuPAINT-8B | 45,6 | 60,5 | 47,9 | 37,3 | 52,8 | 39,9 | 8,5B | 14,5T |
Tablo iki eğilimi aynı anda gösterir. Birincisi, kaynak benchmark'ında QuPAINT varyantları karşılaştırılan baseline modellerin üzerinde sonuç vermektedir. İkincisi, QuPAINT içinde model ölçeği 1B'den 8B'ye büyüdükçe AP değerleri yükselirken parametre ve FLOP maliyeti de büyük ölçüde artmaktadır. Dolayısıyla sonuç yalnız “daha iyi accuracy” değil, aynı zamanda daha yüksek computational cost içeren bir scaling trade-off göstermektedir.
Kaynak içi YOLO adlandırma uyumsuzluğu: Table 4'te YOLOv11-m/l/x değerleri görünmektedir. Buna karşın sonuç metninin bazı cümlelerinde “YOLOv8-x” ve Table 4 ile uyuşmayan 28,3/19,0 AP değerleri yazılmıştır. Verianla nicel karşılaştırmada görünür Table 4 değerlerini kaynak-of-truth olarak aktarmış; metindeki farklılığı ayrıca görünür bırakmıştır.
PAD ve PIA ablasyonu
| PAD | PIA | AP | AP50 | AP75 |
|---|---|---|---|---|
| Yok | Yok | 28,1 | 42,7 | 30,3 |
| Yok | Var | 30,6 | 44,8 | 32,6 |
| Var | Yok | 31,7 | 46,5 | 33,4 |
| Var | Var | 34,1 | 50,2 | 38,0 |
Baseline yapı 28,1 AP iken yalnız PIA 30,6 AP'ye, yalnız PAD 31,7 AP'ye ve iki bileşenin birlikte kullanılması 34,1 AP'ye ulaşmaktadır. Kaynak bunu iki fizik-bilgili bileşenin tamamlayıcı etkisi olarak yorumlar.
Ancak “ablation iyileşti, dolayısıyla fiziksel mekanizma kanıtlandı” sonucu çıkarılmamalıdır. Ablasyon, bu iki model bileşeninin benchmark performansına katkı verdiğini gösterir; model attention ağırlıklarının gerçek malzeme fiziğinin bütün neden-sonuç yapısını temsil ettiğini kanıtlamaz.
Kaynak içi terminoloji notu: yöntemin ana adı bütün makale boyunca Physics-Informed Attention (PIA) iken bölüm 6.3'te bir yerde “Physical Interaction Attention” yazılmıştır. Aynı bölüm PAD için “Physics-Aware Description” ifadesini kullanırken Table 5 caption'ında farklı bir açılım görülmektedir. Verianla PIA'yı makalenin yöntem bölümündeki canonical adıyla korur ve diğer yazımları ayrı bir yeni modül olarak değerlendirmez.
Supplementary QMat-Instruct örnekleri ne gösteriyor?
Supplementary Figure 6–15, sentetik optik mikroskop görüntüleriyle model arasındaki soru–cevap örneklerini göstermektedir. Kaynak output'u üç görsel bölüme ayırır: flake candidate enumeration, physics-informed reasoning ve structured final conclusion. Bu örnekler modelin yalnız bir sınıf etiketi üretmek yerine önce aday bölgeleri belirlemeyi, sonra optik görünüm üzerine gerekçe üretmeyi ve son olarak yapılandırılmış bir sonuç vermeyi hedeflediğini göstermektedir.
Bu supplementary örneklerdeki bounding-box koordinatları bu Verianla makalesine taşınmamıştır; çünkü her bir örneğin ham görüntüsü ve coordinate output'u okuyucu için ana bilimsel sonucu anlamada gerekli değildir ve kaynak görsellerini yeniden yayımlamak yerine yöntem mantığını açıklamak daha güvenlidir.
QF-Bench'in tamamı yayımlanmış mı?
Supplementary material, veri büyüklüğü nedeniyle QF-Bench'in o sürümde yalnız 50 örneğinin yayımlandığını belirtir. Release yapısı COCO JSON formatındadır ve `images`, `annotations` ve `categories` gibi üst düzey alanlar kullanır. Her flake için bounding-box anotasyonu bulunur.
QuPAINT Sonuçları Nasıl Yorumlanmalıdır?
QuPAINT sonuçları, fizik tabanlı sentetik üretim ile fizik-bilgili multimodal representation'ın çalışmanın QF-Bench ve instruction-grounding testlerinde güçlü performans verdiğini gösterir; ancak bu sonuçlar optik görüntüden yapılan tahminlerin AFM, Raman veya başka fiziksel ölçümlerin yerine her koşulda geçebileceğini, yeni bir laboratuvarda aynı AP değerlerinin korunacağını veya modelin yeni kuantum malzemeler keşfettiğini kanıtlamaz.
Çalışmanın güçlü yönleri
Çalışma veri kıtlığı problemine yalnız “daha büyük yapay zekâ modeli” ile yaklaşmaz. Veri üretiminde TMM tabanlı ince-film fiziğini, white-balance uyarlamasını ve substrate-aware yerleşimi kullanarak synthetic data'nın fiziksel gerçekçiliğini artırmaya çalışır.
PIA, full optical modelin her inference patch'inde yeniden çalıştırılmasını gerektirmeden CIELAB contrast'ı fiziksel bir proxy olarak kullanır. Bu yaklaşım, tamamen data-driven attention ile tamamen sabit fizik modelinin arasında hibrit bir yapı kurar.
Kaynak yalnız genel flake detection'a değil, daha düşük kontrastlı mono-layer detection'a ayrıca bakmaktadır. Böylece kolay sınıfların ortalama performansı daha zor tek-katman problemindeki hataları gizleyemez.
Model scaling, instruction grounding ve PAD/PIA ablasyonu ayrı olarak raporlanmıştır. Bu sayede hangi bileşenin ne ölçüde katkı verdiği en azından benchmark düzeyinde incelenebilir.
Çalışmanın temel sınırlılıkları
Synthetic-to-real domain gap: Synthia fizik tabanlı olsa bile bütün mikroskop, kamera, illumination, contamination, kırık/çatlak flake ve başka gerçek kusur çeşitlerini yeniden üretemez.
Token sınırı: Çok yoğun görüntülerde flake sayısı ve görsel token miktarı mevcut multimodal modellerin context/token kapasitesini aşabilir.
Veri dengesizliği: QF-Bench tablosunda Thick kategorisi Mono ve Few sınıflarından sayısal olarak çok daha büyüktür. Kaynak bu dengesizliği tabloyla görünür kılar fakat bütün olası class-imbalance etkilerini ayrı bir istatistiksel analizle çözmez.
Fiziksel doğrulama sınırı: QuPAINT'ın çıktısı optik görüntüye dayanır. Modelin bounding box veya layer yorumunu doğrudan fiziksel kalınlık ölçümü olarak kabul etmek uygun değildir.
İstatistiksel raporlama: Kaynak AP, Acc@50 ve Acc@75 gibi benchmark metriklerini raporlar; ana performans tablolarında confidence interval, p-value veya run-to-run standard deviation verilmemektedir. Bu nedenle Verianla sonuçlara kaynakta bulunmayan istatistiksel anlamlılık iddiası eklememektedir.
Kategori tanımı: QF-Bench ana metnindeki “Few = 2–5” ve “Thick = 5+” sınırları 5 katmanda örtüşmektedir ve kaynak bu PDF içinde bu sınırı açık biçimde çözmemektedir.
Çalışmanın desteklediği sonuçlar
Synthia'nın TMM, CIE renk dönüşümü, white-balance correction ve substrate-aware placement bileşenlerini birleştiren physics-based synthetic generation yaklaşımı sağladığı kaynakta açıkça gösterilmektedir.
QMat-Instruct'ın sekiz malzemede toplam 400.000 physics-aware multimodal training sample ürettiği raporlanmaktadır.
PIA'nın CIELAB \(\Delta E\) tabanlı kontrast skorunu öğrenilebilir affine calibration ile visual embeddings'e uyguladığı yöntem denklemleriyle gösterilmektedir.
QuPAINT varyantlarının kaynak Table 4'te karşılaştırılan detector'lara göre daha yüksek genel ve mono-layer AP değerleri verdiği raporlanmaktadır.
PAD ve PIA'nın birlikte kullanılması ablasyon tablosunda her iki bileşenin tek başına kullanıldığı konfigürasyonlardan daha yüksek AP değerleri vermektedir.
Çalışmanın desteklemediği genellemeler
Çalışma bir kuantum bilgisayar veya kuantum algoritması kullanarak görüntü analizi yapmamaktadır.
Çalışma modelin optik görüntüden atomik katman sayısını bütün materyaller ve bütün mikroskop koşulları altında hatasız belirlediğini göstermemektedir.
Çalışma AFM veya diğer bağımsız malzeme karakterizasyon yöntemlerinin artık gereksiz olduğunu göstermemektedir.
Çalışma Table 4'teki AP değerlerinin farklı laboratuvarlarda aynı kalacağını garanti etmemektedir.
Çalışma fizik-informed attention'ın gerçekten bütün fiziksel mekanizmayı öğrendiğini kanıtlamamaktadır; benchmark performansına katkısını göstermektedir.
Çalışma yeni bir kuantum malzeme sentezlediğini veya yeni bir fiziksel faz keşfettiğini raporlamamaktadır.
Kaynak ve Yöntem Notu
Özgün başlık: QuPAINT: Physics-Aware Instruction Tuning Approach to Quantum Material Discovery
Yazarlar: Xuan-Bac Nguyen, Hoang-Quan Nguyen, Sankalp Pandey, Tim Faltermeier, Nicholas Borys, Hugh Churchill, Khoa Luu.
Yazar sırası: Kaynakta verildiği biçimde korunmuştur.
Eş katkı: Yüklenen PDF'de eş katkı/eş birinci yazar beyanı açık biçimde işaretlenmemiştir.
Corresponding author: Yüklenen PDF birden fazla e-posta adresi vermektedir fakat tek bir corresponding author'ı yıldız veya ayrı bir açıklamayla açıkça tanımlamamaktadır; bu nedenle karşılık uydurulmamıştır.
Kurum 1: CVIU Lab, University of Arkansas, USA.
Kurum 2: University of Utah, USA.
Kurum 3: Department of Physics, University of Arkansas, USA.
Yüklenen kaynak türü: arXiv preprint, v1.
arXiv: arXiv:2602.17478v1 [cs.CV].
arXiv ilk gönderim tarihi: 19 Şubat 2026.
arXiv-issued DOI: 10.48550/arXiv.2602.17478.
Güncel yayın statüsü: Çalışma daha sonra IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR) Findings 2026 proceedings içinde hakemli konferans makalesi olarak yayımlanmıştır.
CVPR yayın yılı: 2026.
CVPR yayın ayı: Haziran 2026.
Proceedings sayfa aralığı: 8684–8694.
CVPR proceedings DOI: Güvenilir resmî kayıtta doğrulanamadığı için verilmemiştir.
Resmî CVF yayın sayfası: https://openaccess.thecvf.com/content/CVPR2026F/html/Nguyen_QuPAINT_Physics-Aware_Instruction_Tuning_Approach_to_Quantum_Material_Discovery_CVPRF_2026_paper.html
Proje sayfası: https://uark-cviu.github.io/projects/qupaint/
Hakemlik durumu: Yüklenen arXiv v1 kendi başına preprint'tir; çalışma daha sonra CVPR 2026 Findings içinde yayımlandığından güncel eser statüsü hakemli konferans yayınıdır.
Bilimsel alan: Computer vision, multimodal machine learning, two-dimensional quantum materials ve optical microscopy.
Çalışma türü: Physics-informed machine-learning yöntem geliştirme + sentetik veri üretimi + gerçek/sentetik mikroskopi veri benchmark değerlendirmesi.
Kuantum bilgisayar kullanımı: Yok. “Quantum” çalışılan malzeme sınıfını ifade eder.
Synthia: Transfer Matrix Method tabanlı thin-film interference simulation, CIE 1931 color conversion, personalized white-balance correction ve substrate-aware synthetic placement kullanır.
QMat-Instruct: Kaynakta alandaki ilk büyük ölçekli physics-aware instruction dataset olarak sunulmaktadır. Sekiz malzeme için 50.000'er sample, toplam 400.000 sample raporlanır.
QuPAINT: Vision Transformer görsel embedding'lerini Physics-Informed Attention skorlarıyla kalibre edip metin embedding'leriyle MLLM decoder'da birleştiren multimodal çerçevedir.
PIA: CIELAB uzayında flake/patch median rengi ile substrat median rengi arasındaki \(\Delta E\) mesafesini physics-aware proxy olarak kullanır.
QF-Bench: Kaynak Table 2'de sekiz malzemede 280.526 anotasyonlu flake raporlanmaktadır.
QF-Bench release durumu: Supplementary material, veri büyüklüğü nedeniyle o sürümde 50 örneğin yayımlandığını ve formatın COCO JSON olduğunu belirtmektedir.
Eğitim görüntü boyutu: 448×448.
Patch: Üst üste binmeyen 14×14 patch'ler.
Vision implementation: InternViT.
Text encoder initialization: Qwen3.
Optimizer: AdamW.
Learning rate: \(2\times10^{-5}\).
Weight decay: \(1\times10^{-4}\).
Batch size: 4.
Epoch: 2.
Eğitim donanımı: 16 A100 GPU.
Data augmentation: Random cropping, horizontal flipping ve CIELAB color jitter.
Inference temperature: \(T=0.2\).
En yüksek Table 4 genel detection sonucu: QuPAINT-8B için 45,6 AP, 60,5 AP50 ve 47,9 AP75.
En yüksek Table 4 mono detection sonucu: QuPAINT-8B için 37,3 AP, 52,8 AP50 ve 39,9 AP75.
Instruction grounding: QuPAINT-2B için Acc@50 = 51,4 ve Acc@75 = 39,5.
Ablasyon: PAD + PIA birlikte 34,1 AP, 50,2 AP50 ve 38,0 AP75 verir.
Kaynak içi YOLO uyumsuzluğu: Table 4 YOLOv11-x ve 29,6/19,8 AP değerlerini verirken ana sonuç metninin bazı cümlelerinde YOLOv8-x ve 28,3/19,0 değerleri görülmektedir. Verianla tablonun görünür nicel değerlerini korumuştur.
Kaynak içi PIA/PAD terminoloji uyumsuzluğu: Yöntem boyunca canonical ad Physics-Informed Attention iken bölüm 6.3'te bir yerde farklı açılım kullanılmıştır. PAD adı da metin ve caption arasında tam tutarlı değildir.
Kaynak içi layer-category sınırı: Ana metinde Few = 2–5 ve Thick = 5+ biçiminde yazıldığı için 5-layer sınırı belirsizdir. Sessiz düzeltme yapılmamıştır.
Finansman: Kaynak, MonArk NSF Quantum Foundry'nin National Science Foundation QAMASE-i programı altında NSF Award No. DMR-1906383 desteğini belirtmektedir.
Hesaplama altyapısı desteği: Arkansas High-Performance Computing Center GPU kaynakları.
Data Availability: PDF'de ayrı bir formal Data Availability başlığı bulunmamaktadır; supplementary material QF-Bench'ten 50 örneğin COCO JSON biçiminde yayımlandığını belirtmektedir.
Code Availability: Yüklenen PDF'de ayrı formal Code Availability statement bulunmamaktadır; proje URL'si verilmiştir.
Çıkar çatışması: Yüklenen PDF'de ayrı conflict-of-interest / competing-interest statement belirlenmemiştir; bu nedenle “çıkar çatışması yoktur” varsayımı yapılmamıştır.
Yazar katkıları: Yüklenen PDF'de ayrı CRediT veya author-contribution statement belirlenmemiştir.
Lisans: Yüklenen PDF ve doğrulanan CVF landing page üzerinde Verianla açısından doğrudan figür yeniden kullanımını güvenle dayandırabileceğimiz açık bir Creative Commons lisansı doğrulanmamıştır. Açık erişim, otomatik olarak sınırsız yeniden kullanım izni kabul edilmemiştir.
Temel yorum sınırı: Çalışma optik mikroskop görüntülerinde physics-aware AI karakterizasyonunun benchmark performansını göstermektedir; bağımsız fiziksel kalınlık ölçüm yöntemlerinin yerine koşulsuz geçiş, bütün laboratuvarlara aynı performansla genelleme veya yeni kuantum malzeme keşfi kanıtı değildir.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir