


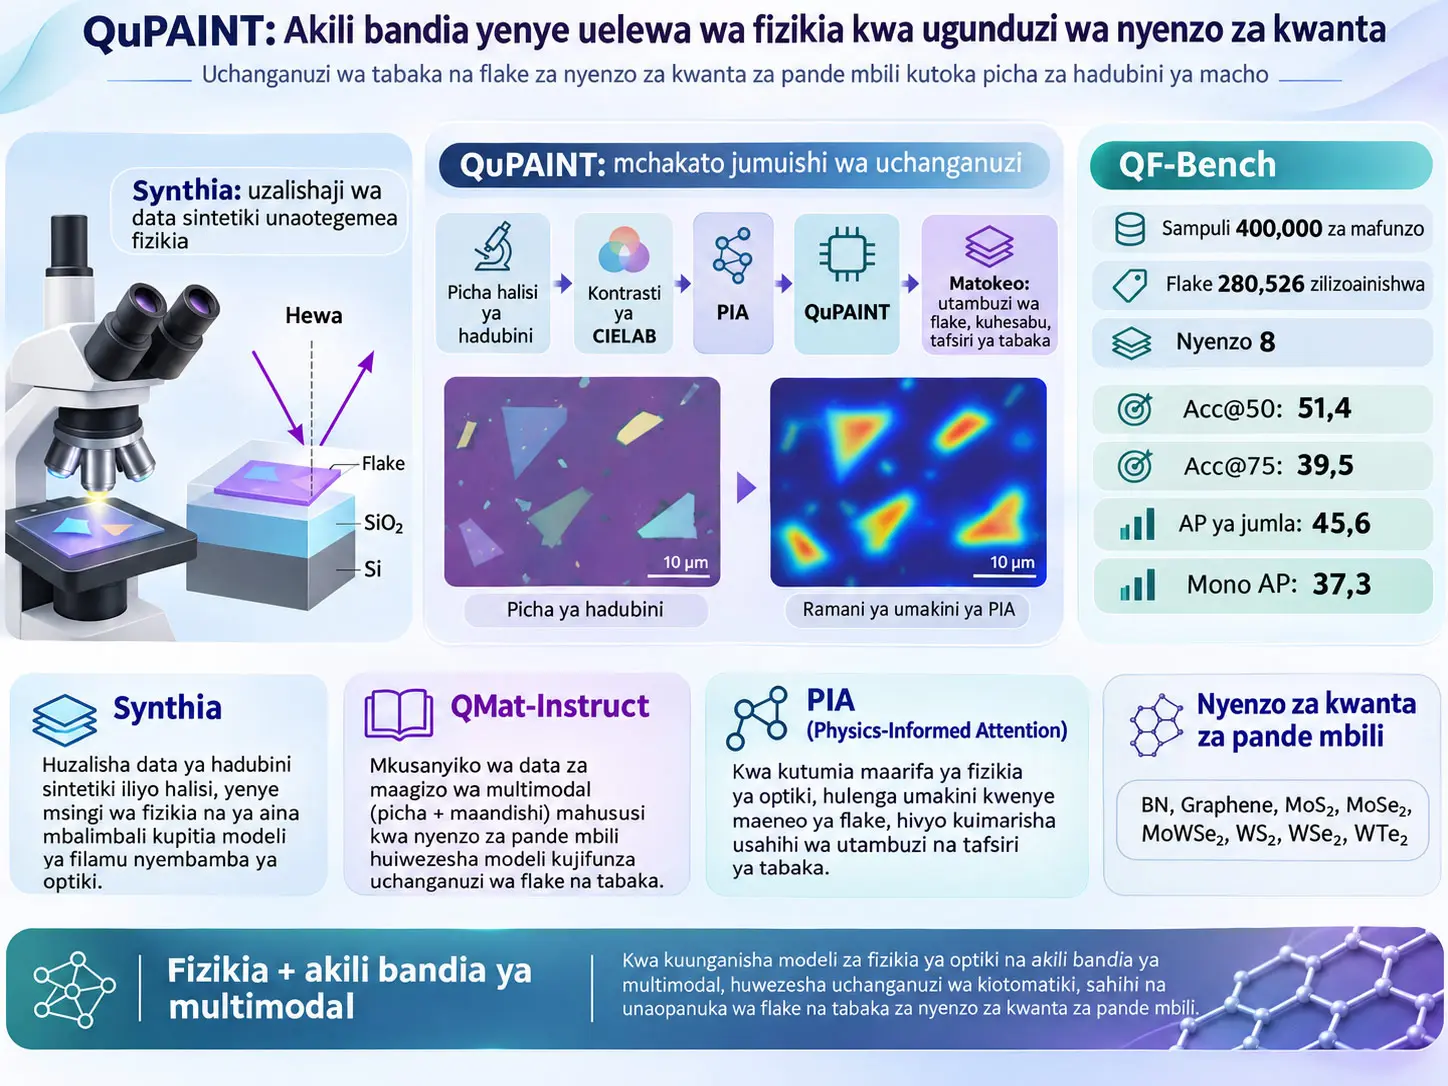
QuPAINT (Physics-Aware Instruction Tuning) ni mfumo wa modeli ya multimodal unaolenga kutambua na kueleza picha za hadubini ya macho za nyenzo za kwanta za pande mbili kwa kutumia kwa pamoja maarifa tangulizi ya optiki ya kifizikia na akili bandia ya multimodal. Utafiti unaunda vipengele vinne vinavyohusiana: Synthia huzalisha picha sintetiki za flake zenye msingi wa fizikia kwa kuiga mwingiliano wa filamu nyembamba kwa Transfer Matrix Method (TMM); QMat-Instruct huunganisha picha hizi na jozi za maswali na majibu zenye taarifa ya fizikia; Physics-Informed Attention (PIA) hupima utofauti wa rangi wa flake–substrat katika picha ya hadubini kwenye nafasi ya CIELAB na kupima upya token za kuona kwa kuzingatia fizikia; huku QF-Bench ikitoa benchmark yenye anoteshini ya kutathmini modeli kwenye nyenzo tofauti za pande mbili na hali mbalimbali za upigaji picha.
Kauli ya “nyenzo ya kwanta” hapa haimaanishi kuwa mbinu inaendeshwa kwenye kompyuta ya kwanta. Usanifu wa kujifunza unaotumiwa ni modeli ya kawaida ya akili bandia na computer vision. Sifa ya “kwanta” inatokana na ukweli kwamba sifa za kielektroniki, kioptiki na za kwanta za nyenzo nyembamba kwa kiwango cha atomu kama graphene, MoS2, WTe2, h-BN na nyingine zinazofanana hutegemea sana idadi ya tabaka. Lengo la utafiti si kusanisi chembe mpya ya kwanta au nyenzo mpya; ni kutambua, kuweka mahali na kuhusisha flake zilizopo za pande mbili na madarasa ya tabaka kwa kuaminika zaidi kutokana na picha za hadubini ya macho.
Chanzo kinafafanua tatizo kuu katika mtiririko wa kazi wa maabara halisi hivi: microscopy ya macho huruhusu flake nyingi kupigwa picha kwa haraka lakini haitoi unene kwa njia ya moja kwa moja na sahihi; Atomic Force Microscopy (AFM) inaweza kutoa kipimo cha unene kwa kiwango cha nanomita lakini ni polepole, inahitaji uhamishaji wa sampuli kimwili na ni vigumu kuipanua kwa ukusanyaji mkubwa wa data. Zaidi ya hayo, tofauti za utofauti wa kuona kati ya flake za mono-, bi- na tabaka chache zinaweza kuwa ndogo kuliko mabadiliko yanayotokana na mwangaza, kamera, unene wa substrat na white balance. Kwa hiyo modeli za jumla za object detection zinazotegemea tu mwonekano wa RGB zinaweza kupata ugumu zinapohamishwa kati ya maabara tofauti.
Data ya mafunzo ya QMat-Instruct ina jumla ya 400.000 sampuli, kwa sampuli 50.000 kwa kila nyenzo kati ya nyenzo nane. Chanzo hutumia pamoja picha halisi na picha sintetiki zenye msingi wa fizikia. Wakati wa mafunzo, picha za hadubini hubadilishwa kuwa 448×448 na kugawanywa katika patch za 14×14 zisizoingiliana. Upande wa kuona hutumia utekelezaji wa InternViT; text encoder huanzishwa kutoka Qwen3. AdamW optimizer, \(2\times10^{-5}\) learning rate, \(1\times10^{-4}\) weight decay, batch size 4 na 2 epoch zilitumiwa; mafunzo yaliendeshwa kwenye 16 A100 GPU.
Katika jedwali la QF-Bench, katika nyenzo nane — BN, Graphene, MoS2, MoSe2, MoWSe2, WS2, WSe2 na WTe2 — jumla ya anoteshini 280.526 za flake zimeripotiwa. Kati ya hizi, 2.546 ni Mono, 3.417 ni Few na 274.563 ni katika kategoria ya Thick. Mgawanyo huu unaonyesha wazi kwamba madarasa ya flake nyembamba, hasa za tabaka moja, yanawakilishwa kwa kiwango kidogo sana ndani ya benchmark.
Katika tathmini ya instruction grounding, QuPAINT-2B ilipata Acc@50 = 51,4 na Acc@75 = 39,5, na kutoa matokeo yaliyo juu ya modeli za InternVL-2B na Qwen3VL-2B zilizo kwenye jedwali hilo hilo. Katika utambuzi wa jumla wa flake, QuPAINT-8B inaripoti 45,6 AP, 60,5 AP50 na 47,9 AP75; katika utambuzi wa mono-layer inaripoti 37,3 AP, 52,8 AP50 na 39,9 AP75. Namba hizi ni za tathmini ya QF-Bench katika utafiti huu; hazimaanishi kuwa utendaji huo huo umehakikishwa kwa hadubini tofauti, substrat tofauti au mifumo ya nyenzo ambayo haijathibitishwa.
Utafiti pia unaripoti mapungufu mawili makuu. Kwa kuwa Synthia haiwezi kuzalisha upya kasoro zote za flake na utofauti wote wa upigaji picha unaoonekana kwenye hadubini halisi, domain gap inaweza kubaki katika maabara mpya. Kizuizi cha pili kikuu cha QuPAINT ni urefu wa juu wa token wa modeli ya multimodal; ikiwa picha zenye msongamano mkubwa sana wa flake zinazalisha token nyingi mno za kuona, modeli inaweza kupata ugumu kuchakata eneo lote.
Je, QuPAINT Inatumia Kompyuta ya Kwanta?
Hapana. QuPAINT ni mfumo wa computer vision na modeli kubwa ya lugha ya multimodal unaofunzwa kwenye GPU za kawaida; neno “quantum” halirejelei vifaa vya kukokotoa, bali nyenzo za kwanta za pande mbili zinazochanganuliwa. Modeli ya optiki ya kifizikia hukokotoa mwingiliano wa filamu nyembamba kwa TMM, PIA hubadilisha utofauti wa kioptiki kuwa kipaumbele cha visual attention, na modeli ya multimodal huchakata taarifa hii pamoja na picha na maandishi.
Kwa nini idadi ya tabaka ni muhimu sana katika nyenzo za kwanta za pande mbili?
Katika nyenzo za pande mbili zenye unene wa kiwango cha atomu, kuongeza au kuondoa tabaka chache tu za atomu kunaweza kubadilisha muundo wa bendi za kielektroniki, mwitikio wa kioptiki na sifa nyingine za kwanta. Kwa hiyo haitoshi kujua tu kama flake “ipo”; pia ni muhimu kisayansi kujua kama ni monolayer, bilayer au eneo lenye unene mkubwa zaidi.
Chanzo kinatoa mifumo kama graphene, MoS2 na WTe2 kama mifano. Hata hivyo, utafiti wenyewe haukokotoi miundo ya bendi za kielektroniki za nyenzo hizi. Kazi ya moja kwa moja ya utafiti ni kufanya utofauti wa kioptiki unaohusiana na idadi ya tabaka uweze kutumiwa katika uchakataji wa picha na ujifunzaji wa multimodal.
Tofauti kati ya hadubini ya macho na AFM
| Mbinu | Faida | Kizuizi | Jukumu katika utafiti |
|---|---|---|---|
| Microscopy ya macho | Inaweza kupiga picha maelfu ya flake kwa haraka. | Haiwezi kutoa kwa uhakika unene wa tabaka peke yake; rangi huathiriwa na mwangaza na substrat. | Huunda ingizo kuu la picha la QuPAINT. |
| Atomic Force Microscopy (AFM) | Hutoa kipimo cha unene wa kimwili kwa kiwango cha nanomita. | Ni polepole; inahitaji flake kupatikana tena, sampuli kuhamishwa na vipimo kufanywa kimoja baada ya kingine. | Hutoa motisha ya hitaji la makadirio ya kiotomatiki kutokana na mwonekano wa kioptiki. |
Lengo la QuPAINT si kuthibitisha kuwa uwezo wa AFM wa kupima kimwili umeondolewa. Modeli hutoa makadirio ya flake zinazoweza kuwa wagombea na madarasa ya tabaka kutokana na picha ya kioptiki. Utafiti huu hauungi mkono hitimisho kwamba AFM, Raman spectroscopy au mbinu nyingine huru za vipimo zimekuwa zisizo za lazima katika majaribio yanayohitaji characterization muhimu ya kifizikia.
Synthia Inazalishaje Picha za Nyenzo za Kwanta za Pande Mbili?
Synthia ni mfumo wa uzalishaji wa data sintetiki wenye msingi wa fizikia ambao, badala ya kuchagua rangi za flake sintetiki za pande mbili kwa nasibu ili kuziweka juu ya mandharinyuma halisi za hadubini, hukokotoa mwingiliano wa filamu nyembamba wa mfumo wa tabaka za hewa–flake–SiO2–Si kwa Transfer Matrix Method, hubadilisha matokeo kwenda kwenye nafasi ya rangi ya CIE, kisha huyaoanisha na white balance ya picha halisi na maeneo safi ya substrat.
Kwa nini Transfer Matrix Method inahitajika?
Flake ya pande mbili haionekani kwenye hadubini ya macho kwa sababu tu ya “rangi yake ya asili”. Mwanga huakisiwa na kupitishwa mara kwa mara kwenye mipaka ya tabaka kama flake, SiO2 na Si. Tofauti ya awamu inayotokea kati ya njia tofauti za kioptiki inaweza kuimarisha baadhi ya urefu wa mawimbi na kudhoofisha mingine. Tukio hili ni mwingiliano wa filamu nyembamba.
Synthia hufafanua kila tabaka kwa kielezo changamani cha refractive:
na unene wa kimwili \(d_l\). \(n_l\) huonyesha sehemu halisi ya kielezo cha refractive, \(k_l\) sehemu ya kupungua inayohusiana na ufyonzaji, na \(\lambda\) urefu wa wimbi la mwanga. Vielezo vya refractive havina kipimo; \(\lambda\) na \(d_l\) vinapaswa kuchukuliwa katika kitengo kimoja cha urefu.
Mlinganyo (1): Coefficients za Fresnel kwenye mpaka wa tabaka
\(r_{l,l+1}\) inawakilisha coefficient ya amplitude ya uakisi katika mpito kutoka tabaka la \(l\) kwenda \(l+1\); \(t_{l,l+1}\) inawakilisha coefficient ya amplitude ya upitishaji. Hizi si intensity ya mwanga moja kwa moja; ni uwiano kati ya amplitudes za uga wa umeme na hazina kipimo.
Usambazaji wa mwanga ndani ya tabaka huzalisha ucheleweshaji wa awamu. Chanzo hutumia uhusiano huu:
na huwakilisha usambazaji katika kila tabaka kwa propagation matrix ya \(P_l\). Maana ya kifizikia ni wazi: kwa unene ule ule, kielezo kikubwa zaidi cha refractive huongeza njia ya kioptiki; kwa nyenzo ile ile, urefu mkubwa zaidi wa wimbi hupunguza mkusanyiko wa awamu kwa kila kitengo cha unene.
Mlinganyo (2): Mlolongo wa transfer-matrix wa tabaka zote
\(u_0=1\) ni urekebishaji wa amplitude ya uga wa umeme unaoingia. \(v\) ni amplitude ya jumla ya uga ulioakisiwa; \(u\) ni amplitude ya uga unaopitishwa kwenda kwenye substrat. \(M_{l,l+1}\) inawakilisha interface transfer matrix; \(P_l\) inawakilisha propagation matrix katika tabaka la \(l\).
Uakisi:
hukokotolewa kwa uhusiano huu. \(R(\lambda)\) ni uwiano wa intensity usio na kipimo na hutegemea urefu wa wimbi la mwanga.
Chanzo husampuli wigo unaoonekana katika uzalishaji wa flake sintetiki kwenye:
kwa urefu wa mawimbi \(D\) tofauti.
Mlinganyo (3): Wigo wa uakisi unabadilishwaje kuwa rangi ya RGB?
\(\mathbf{S}(\lambda)\in\mathbb{R}^{3\times1}\) inawakilisha vipengele vitatu vya rangi vya CIE 1931 color-matching functions; \(I(\lambda)\) wigo wa illuminant ya kawaida; na \(R(\lambda)\) thamani ya reflectance iliyokokotolewa. Matokeo \(\mathbf{x}\) ni vector ya rangi yenye vipengele vitatu vinavyohusishwa na vipengele vya rangi vya RGB.
Chanzo pia huandika usemi huo huo katika umbo la matrix:
Hapa \(\circ\) ni element-wise product, yaani kuzidisha kwa kila kipengele thamani za mwangaza na uakisi kwa urefu ule ule wa wimbi.
Modeli ya optiki imetekelezwa kwa kifurushi cha tmm katika Python. Synthia hukokotoa spectra za reflectance kwa unene tofauti kwa kutumia functions za \(n(\lambda)\) na \(k(\lambda)\) zinazotegemea urefu wa wimbi, kwa mfano kwa graphene, MoS2, WSe2 na h-BN.
Vipengele ambavyo Synthia inaongeza kwenye uzalishaji sintetiki uliotangulia
| Kipengele | MaskTerial | Synthia |
|---|---|---|
| Maumbo ya flake kutoka vyanzo vingi vya nyenzo | Ndiyo | Ndiyo |
| Simulation ya optiki yenye msingi wa fizikia (TMM) | Ndiyo | Ndiyo |
| Ukalibishaji binafsi wa rangi | Hapana | Ndiyo |
| Matumizi ya kiwango cha CIE | Hapana | Ndiyo |
| Kuzuia kuingiliana na flake zilizopo | Hapana | Ndiyo |
Kwa nini moduli ya White-Balance-Aware inahitajika?
Katika picha halisi za hadubini, mtumiaji au kifaa kinaweza kutumia thamani tofauti za gain kwa channels za RGB. Hata nyenzo na substrat ile ile inaweza kuonekana kwa rangi tofauti katika maabara tofauti. Synthia hushughulikia tofauti hii si kwa kuacha modeli ya fizikia, bali kwa kutumia channel gains zilizotolewa kutoka picha halisi ya rejea kwenye rangi iliyozalishwa na modeli ya fizikia.
Kwa nini moduli ya Substrate-Aware inahitajika?
Ikiwa flake sintetiki itawekwa kwa nasibu kwenye pikseli yoyote, inaweza kufunika flake halisi, uchafu au miundo mingine. Hali hii inaweza kuunda compositing artefact zisizo halisi kifizikia. Synthia hulenga kuweka flake sintetiki kwenye maeneo halali pekee kwa kuchagua maeneo safi ya substrat yenye attention ya chini kutoka kwenye ramani ya attention inayotegemea PIA.
Mfuatano wa hatua za Synthia Algorithm 1
| Hatua | Operesheni | Lengo |
|---|---|---|
| 1 | Rangi ya median ya substrat ya rejea hutolewa. | Kuwakilisha ukalibishaji wa rangi wa picha halisi. |
| 2 | Wigo wa TMM reflectance wa substrat ya hewa–SiO2–Si hukokotolewa. | Kupata rangi ya substrat inayotarajiwa na modeli ya fizikia. |
| 3 | Rangi ya kifizikia ya substrat hukokotolewa kwa projection ya CIE. | Kuhamisha wigo kwenda kwenye nafasi ya rangi ya picha. |
| 4 | Channel-based gain \(g\) hutolewa kati ya rangi za substrat halisi na za modeli. | Kuiga tofauti ya white-balance. |
| 5 | Ramani ya PIA huundwa na ku-normalize. | Kutambua maeneo safi ya substrat. |
| 6 | Mask ya substrat hupatikana kwa kizingiti cha percentile ya 90. | Kuondoa maeneo yaliyopo ya flake/texture yenye utofauti wa juu. |
| 7 | Random flake mask na thickness inayofaa kwa nyenzo husampuliwa. | Kuchagua jiometri ya flake sintetiki na unene wake wa kimwili. |
| 8 | Coordinate isiyoingiliana na miundo iliyopo huchaguliwa. | Kuzuia overlap isiyo na maana kifizikia. |
| 9 | Reflectance hukokotolewa kwa stack ya hewa–flake–SiO2–Si. | Kuunda mwonekano wa kioptiki unaotegemea idadi ya tabaka. |
| 10 | Reflectance hubadilishwa kuwa rangi kwa CIE na white-balance gain hutumiwa. | Kuzalisha rangi inayolingana zaidi na picha halisi ya hadubini. |
| 11 | Flake sintetiki huunganishwa kwa mask kwenye eneo halisi la substrat. | Kuunda picha ya mwisho ya hadubini sintetiki. |
QMat-Instruct ni nini?
QMat-Instruct ni dataset ya multimodal physics-aware instruction iliyotengenezwa na waandishi kwa characterization ya nyenzo za kwanta. Kila sampuli si picha ya hadubini au lebo ya bounding box pekee; ina swali la lugha asilia linalohusishwa na picha na jibu linaloeleza mwonekano wa kifizikia.
Chanzo hutoa majukumu ya mfano katika makundi matatu makuu: kuhesabu flake, kuweka flake mahali, na kuthibitisha kama darasa fulani la tabaka lipo. Maelezo yanajumuisha vihisishi vya kuona vinavyohusiana na mwingiliano wa filamu nyembamba kama utofauti, mabadiliko ya rangi na uwazi wa kingo.
Chanzo hutumia nyenzo nane katika seti ya mafunzo:
BN, Graphene, MoS2, MoSe2, MoWSe2, WS2, WSe2 na WTe2.
Chanzo kinaeleza wazi kwamba sample 50.000 ziliundwa kwa kila nyenzo na kwamba jumla ya sampuli za mafunzo ni:
.
Physics-Informed Attention (PIA) Inapima Nini?
Physics-Informed Attention (PIA) huzalisha kipaumbele cha attention kinachowakilisha utofauti wa kioptiki wa flake–substrat kwa kukokotoa umbali wa Euclidean kati ya rangi ya median ya kila patch ya picha katika nafasi ya CIELAB na rangi ya median ya substrat ya picha; QuPAINT hupitisha alama hii yenye msingi wa fizikia katika marekebisho ya affine yanayoweza kujifunzwa na kuitumia kupima token za kuona.
Vision encoder: Mlinganyo (4)
\(I\in\mathbb{R}^{H\times W\times C}\) ni picha ya hadubini. \(H\) ni urefu wa picha, \(W\) ni upana, na \(C\) ni idadi ya channels. \(Enc_v\) ni vision encoder; \(v_i\), kwa patch ya \(i\), ni visual embedding ya vipimo \(d\); na \(k\) ni jumla ya patch/token.
PIA huzalisha kwa kila patch:
physics-based contrast score.
Kwa nini alama ya fizikia haitumiwi moja kwa moja?
Modeli safi ya fizikia huenda isijue kikamilifu spectral response halisi ya kamera ya maabara, mapendeleo ya white-balance na tofauti zote za illumination. Kwa hiyo QuPAINT huongeza ukalibishaji mdogo unaojifunza scale na bias pekee badala ya kuacha kipaumbele cha fizikia kikiwa kisichobadilika.
Mlinganyo (5): Marekebisho ya PIA yanayoweza kujifunzwa
\(\sigma\) ni logistic sigmoid function. \(\alpha_i\) ni raw physics-based attention score; \(w\) na \(b\) ni parameters za scale na shift za dimension moja zinazojifunzwa wakati wa mafunzo. \(\beta_i\) ni uzito wa attention uliorekebishwa unaotumika kwenye token ya kuona.
Mlinganyo (6): Upimaji wa kifizikia wa token za kuona
Ikiwa \(\beta_i\) ni ndogo, mchango wa patch embedding husika kwenye modeli hupunguzwa; ikiwa ni kubwa, token ya kuona hubebwa kwa nguvu zaidi. Hata hivyo, hii haimaanishi kifizikia kwamba “patch hii hakika ni flake”. \(\beta_i\) ni uzito wa attention unaotumika ndani ya modeli ya multimodal.
Mlinganyo (7): Text encoder
\(T=\{T_1,\ldots,T_L\}\) ni maelekezo ya mtumiaji au mlolongo wa swali lenye taarifa ya fizikia. \(Enc_t\) ni text encoder; \(t_j\) ni embedding ya kila token ya maandishi.
Mlinganyo (8): Tokeo la multimodal
Token za kuona zilizopimwa kwa fizikia na token za maandishi hupelekwa kwenye multimodal decoder. \(Y\) ni mlolongo wa token za jibu zinazozalishwa na modeli; \(M\) ni urefu wa matokeo.
Mlinganyo (9): Autoregressive language-model loss
\[ \mathcal{L}_{LM} = -\frac{1}{M} \sum_{j=1}^{M} \log P_\theta \left( y_j \mid y_{
Loss hii hujaribu kuongeza uwezekano uliotolewa kwa token sahihi inayofuata. \(y_{
Hakuna direct supervision loss huru inayotumika kwa PIA. \(w\) na \(b\) huoptimize kwa njia isiyo ya moja kwa moja kupitia backpropagation inayotoka kwenye language-model loss. Kwa njia hii, attention ya kifizikia hupata ukalibishaji mdogo unaoweza kujifunzwa bila kubadilishwa kuwa neural attention iliyo huru kabisa.
Kwa nini CIELAB inatumika badala ya RGB?
Thamani za RGB zinaweza kuathiriwa moja kwa moja na spectral response ya kamera, exposure na michakato ya white-balance. CIELAB ni nafasi ya rangi ya perceptual inayotenganisha luminance \(L^\ast\) na chromatic coordinates mbili, \(a^\ast\) na \(b^\ast\). Chanzo hutumia umbali wa CIELAB kati ya flake na substrat kama image-space proxy yenye ustahimilivu zaidi kwa tofauti ya reflectance inayotokana na thin-film interference.
Mlinganyo (10): CIELAB perceptual contrast
\(\Phi\) ni nonlinear transformation kutoka RGB kwenda CIELAB; \(I(x)\) ni rangi ya pixel/patch inayochunguzwa; \(I_{bg}\) ni rangi ya mandharinyuma ya substrat; na \(\|\cdot\|_2\) ni Euclidean norm.
\(\Delta E\) haina kitengo cha urefu wa kimwili, nishati au uga wa umeme. Ni alama ya contrast isiyo na kipimo inayowakilisha tofauti ya rangi inayoonekana kati ya coordinates za CIELAB.
Mlinganyo (11): Alama ya PIA katika kiwango cha patch
\(\hat I_k\) ni rangi ya median ya patch ya \(k\). \(I_{bg}\) ni rangi ya median ya mandharinyuma katika picha nzima au region-of-interest iliyochaguliwa.
Nyenzo ya ziada: Uhusiano wa daraja la kwanza kati ya ΔE na optical reflectance
Supplementary material hufafanua uhusiano wa CIELAB contrast na modeli ya optiki ya kifizikia kupitia first-order Taylor approximation. Tofauti ya spectral reflectance ya flake ikilinganishwa na substrat hufafanuliwa kama:
Kwa dhana kwamba \(\|\Delta R\|_\infty\) ni ndogo kwa mono- na few-layer flakes, ubadilishaji wa RGB→LAB huwekewa linear approximation karibu na rangi ya substrat:
\(J_\Phi(I_{bg})\) ni Jacobian matrix ya ubadilishaji RGB→LAB katika nukta \(I_{bg}\). \(E(\lambda)\) ni illumination spectrum; \(S(\lambda)\) ni spectral response ya kamera/rangi; na \(\Delta R(\lambda)\) ni tofauti ya reflectance ya flake ikilinganishwa na substrat.
Kisha chanzo kinatoa, kwa constant chanya maalum \(c\):
uhusiano huo.
Kikomo cha tafsiri ya uthibitisho huu ni muhimu: chanzo kinahalalisha \(\Delta E\) kama proxy ya ndani iliyo monotonic na idadi ya tabaka. Hii haimaanishi kuwa ubadilishaji wa thamani moja wa kimataifa “ΔE → idadi ya tabaka” umethibitishwa kwa nyenzo zote, masafa yote ya thickness na mipangilio yote ya kioptiki.
Milinganyo ya Supplementary White-Balance
Rangi ya wastani kwa channel ya substrat halisi ya rejea ni:
Hapa \(M_{sub}\) ni binary mask inayochagua pikseli safi za substrat.
Rangi ya substrat kabla ya white-balance inayokokotolewa kutoka modeli ya fizikia ni:
Chanzo kinatoa kwa mbinu ya diagonal channel-gain:
ambapo \(\oslash\) ni element-wise division.
Gain hii hutumika kwa kila channel ya RGB ya picha sintetiki kama:
na matokeo huwekwa ndani ya masafa \([0,1]\) kwa clip.
Milinganyo ya uwekaji ya Supplementary Substrate-Aware
Ramani ya LAB attention:
baada ya kuzalishwa:
hu-normalize.
Mask ya substrat safi:
Maeneo yenye high-attention huchukuliwa kuwa flake au maeneo yenye texture nyingi na huondolewa.
Mask ya flake sintetiki \(M_i\) lazima iendane na substrat safi kwenye coordinate iliyochaguliwa:
\(\odot\) ni element-wise multiplication. Matokeo kuwa sifuri yanaonyesha kwamba mask ya flake sintetiki haipaswi kukatiza eneo lililokatazwa lililopo.
Kwa nyenzo iliyochaguliwa \(s\), layer stack \(S=\{\mathrm{air},s,\mathrm{SiO_2},\mathrm{Si}\}\) na thickness \(t_i\):
reflectance spectrum hukokotolewa.
Spectrum hii hubadilishwa kuwa rangi ya RGB kwa projection ya rangi ya CIE:
.
Compositing ya mwisho hufanywa kwa:
Katika pikseli za flake zenye \(M_i=1\), rangi sintetiki hutumiwa; katika pikseli zenye \(M_i=0\), picha halisi ya substrat huhifadhiwa.
Mbinu na Matokeo ya Utafiti
QF-Bench Inapima Nini na Kwa Nini Ni Muhimu?
QF-Bench ni benchmark yenye anoteshini iliyoundwa ili kulinganisha utambuzi wa flake na mafanikio ya localization yanayohisi darasa la tabaka ya QuPAINT na modeli nyingine kwenye nyenzo tofauti za pande mbili kwa protokali ya pamoja; chanzo kinaripoti anoteshini 280.526 za flake katika nyenzo nane na hupima utendaji wa modeli katika majukumu ya flake kwa ujumla, mono-layer flake na instruction-grounding.
Mipangilio ya mafunzo ya modeli na inference
| Parameta | Thamani | Jukumu |
|---|---|---|
| Utekelezaji wa kuona | InternViT | Miundombinu ya Vision encoder |
| Ukubwa wa picha | 448×448 | Ingizo la modeli |
| Patch | 14×14, zisizoingiliana | Uzalishaji wa Vision token |
| Text encoder initialization | Qwen3 | Embedding za maelekezo |
| Optimizer | AdamW | Uboreshaji wa parameta |
| Learning rate | \(2\times10^{-5}\) | Ukubwa wa hatua ya optimizer |
| Weight decay | \(1\times10^{-4}\) | Regularization |
| Batch size | 4 | Ukubwa wa mini-batch |
| Epoch | 2 | Mzunguko wa mafunzo |
| GPU | 16 × A100 | Vifaa vya mafunzo |
| Augmentation | Random crop, horizontal flip, CIELAB color jitter | Ustahimilivu kwa illumination na white-balance |
| Inference temperature | \(T=0.2\) | Mpangilio wa sampling wa uzalishaji |
Mgawanyo wa flake katika QF-Bench
| Nyenzo | Mono | Few | Thick | Jumla |
|---|---|---|---|---|
| Jumla | 2.546 | 3.417 | 274.563 | 280.526 |
| BN | 13 | 111 | 10.100 | 10.224 |
| Graphene | 1.856 | 2.081 | 4.270 | 8.207 |
| MoS2 | 246 | 536 | 108.352 | 109.134 |
| MoSe2 | 24 | 32 | 1.327 | 1.383 |
| MoWSe2 | 9 | 35 | 293 | 337 |
| WS2 | 43 | 5 | 2.144 | 2.192 |
| WSe2 | 207 | 35 | 6.195 | 6.437 |
| WTe2 | 148 | 582 | 141.882 | 142.612 |
Dokezo la mpaka wa kategoria ndani ya chanzo: maandishi makuu hutumia kauli “mono-layer, few-layer (2–5 layers) na thick (5+ layers)” kwa QF-Bench. Uandishi huu unaonekana kuingiza sampuli ya tabaka 5 katika mipaka yote miwili. Verianla haijabadilisha kimya kimya kuwa 2–4. Kwa kuwa Table 2 inatoa tu hesabu za Mono/Few/Thick, haiwezekani kuthibitisha kutoka PDF hii kategoria ambayo sampuli za 5-layer zilikodishwa kwa kweli.
AP, AP50 na AP75 zinapima nini?
Chanzo hutumia metrics za kawaida za object-detection AP, AP50 na AP75. Kipimo cha msingi cha localization ni Intersection over Union (IoU). Formula ya IoU hapa chini ni msingi wa kawaida wa computer vision uliotolewa kueleza metrics hizi; si matokeo mapya ya utafiti:
\(B_{\mathrm{pred}}\) ni bounding box iliyotabiriwa na modeli; \(B_{\mathrm{gt}}\) ni ground-truth box. IoU inapokaribia 1, mwingiliano wa box mbili huwa mkubwa zaidi.
AP50 inawakilisha utendaji wa precision–recall katika kizingiti cha 0,50 IoU; AP75 inawakilisha utendaji katika kizingiti kikali zaidi cha 0,75 IoU. AP75 ya juu inaashiria si tu kupata eneo la takriban la flake, bali pia kuweka bounding box kwa usahihi zaidi.
Matokeo ya instruction grounding
| Modeli | Acc@50 | Acc@75 |
|---|---|---|
| InternVL-2B | 43,3 | 30,8 |
| Qwen3VL-2B | 45,8 | 32,1 |
| QuPAINT-2B | 51,4 | 39,5 |
Instruction grounding hutathmini si tu kama modeli inaweza kuunda jibu la lugha asilia, bali pia kama inaweza kuunganisha eneo la flake linalohusiana na maelekezo na eneo sahihi la picha. Chanzo kinasema kuwa kilifuata protokali ya tathmini ya RefCOCO.
Utambuzi wa flake kwa ujumla na mono-layer
| Modeli | General Flake Detection | Mono Flake Detection | Parameta | FLOPs | ||||
|---|---|---|---|---|---|---|---|---|
| AP | AP50 | AP75 | AP | AP50 | AP75 | |||
| MaskRCNN-R50 | 18,7 | 36,5 | 17,8 | 9,8 | 28,9 | 9,0 | 44M | 134,4B |
| MaskRCNN-R101 | 20,3 | 38,1 | 18,9 | 11,1 | 30,6 | 10,3 | 63M | 334,8B |
| ViTDet (base) | 17,4 | 35,2 | 16,5 | 8,7 | 27,6 | 7,8 | 86M | 1,3T |
| ViTDet (large) | 18,9 | 37,0 | 17,3 | 9,9 | 29,8 | 8,5 | 300M | 4,1T |
| YOLOv11-m | 24,8 | 41,9 | 21,1 | 17,0 | 27,2 | 16,4 | 20M | 68,0B |
| YOLOv11-l | 26,9 | 43,0 | 23,5 | 18,9 | 29,8 | 17,3 | 25M | 86,9B |
| YOLOv11-x | 29,6 | 44,5 | 24,6 | 19,8 | 31,3 | 18,7 | 57M | 194,9B |
| Co-DETR | 22,7 | 35,9 | 23,3 | 12,2 | 25,3 | 11,4 | 304M | 119,4B |
| RT-DETRv2 | 27,5 | 37,2 | 27,0 | 17,5 | 37,8 | 14,7 | 76M | 259,0B |
| MaskTerial | 23,8 | 41,0 | 25,4 | 16,8 | 35,5 | 17,2 | 45M | 150,7B |
| φ-Adapt | 30,3 | 49,1 | 27,4 | 24,1 | 38,2 | 23,4 | 91M | 368,3B |
| QuPAINT-1B | 36,9 | 50,7 | 38,6 | 28,0 | 42,9 | 29,5 | 1,1B | 1,5T |
| QuPAINT-2B | 38,7 | 53,6 | 41,2 | 30,2 | 45,5 | 32,0 | 2,3B | 3,4T |
| QuPAINT-4B | 42,4 | 58,2 | 46,8 | 34,1 | 50,2 | 38,0 | 4,7B | 7,9T |
| QuPAINT-8B | 45,6 | 60,5 | 47,9 | 37,3 | 52,8 | 39,9 | 8,5B | 14,5T |
Jedwali linaonyesha mienendo miwili kwa wakati mmoja. Kwanza, katika benchmark ya chanzo, variants za QuPAINT hutoa matokeo yaliyo juu ya baseline models zinazolinganishwa. Pili, ndani ya QuPAINT, kadiri ukubwa wa modeli unavyoongezeka kutoka 1B hadi 8B, thamani za AP huongezeka huku gharama za parameta na FLOP nazo zikiongezeka kwa kiwango kikubwa. Kwa hiyo matokeo hayaonyeshi tu “accuracy bora”, bali pia scaling trade-off yenye computational cost kubwa zaidi.
Utofauti wa majina ya YOLO ndani ya chanzo: Table 4 inaonyesha thamani za YOLOv11-m/l/x. Hata hivyo, baadhi ya sentensi katika maandishi ya matokeo zinaandika “YOLOv8-x” na thamani za 28,3/19,0 AP ambazo hazilingani na Table 4. Katika ulinganisho wa kiasi, Verianla imewasilisha thamani zinazoonekana za Table 4 kama source-of-truth na imeacha tofauti ya maandishi ionekane pia.
Ablation ya PAD na PIA
| PAD | PIA | AP | AP50 | AP75 |
|---|---|---|---|---|
| Hapana | Hapana | 28,1 | 42,7 | 30,3 |
| Hapana | Ndiyo | 30,6 | 44,8 | 32,6 |
| Ndiyo | Hapana | 31,7 | 46,5 | 33,4 |
| Ndiyo | Ndiyo | 34,1 | 50,2 | 38,0 |
Muundo wa baseline una 28,1 AP; PIA pekee hufikia 30,6 AP, PAD pekee 31,7 AP, na matumizi ya vipengele vyote viwili pamoja hufikia 34,1 AP. Chanzo hutafsiri hili kama athari inayokamilishana ya vipengele viwili vyenye taarifa ya fizikia.
Hata hivyo, hitimisho la “ablation imeimarika, kwa hiyo mekanizimu ya kifizikia imethibitishwa” halipaswi kufanywa. Ablation inaonyesha kuwa vipengele hivi viwili vya modeli vinachangia utendaji wa benchmark; haithibitishi kuwa attention weights za modeli zinawakilisha muundo mzima wa sababu na athari wa fizikia halisi ya nyenzo.
Dokezo la istilahi ndani ya chanzo: jina kuu la mbinu katika makala yote ni Physics-Informed Attention (PIA), lakini sehemu ya 6.3 inaandika “Physical Interaction Attention” mahali pamoja. Sehemu hiyo hiyo hutumia “Physics-Aware Description” kwa PAD, huku caption ya Table 5 ikionyesha upanuzi tofauti. Verianla huhifadhi PIA kwa jina lake canonical katika sehemu ya mbinu na haichukulii uandishi mwingine kama moduli mpya tofauti.
Mifano ya Supplementary QMat-Instruct inaonyesha nini?
Supplementary Figure 6–15 zinaonyesha mifano ya maswali na majibu kati ya picha sintetiki za hadubini ya macho na modeli. Chanzo hugawanya output katika sehemu tatu za kuona: flake candidate enumeration, physics-informed reasoning na structured final conclusion. Mifano hii inaonyesha kwamba modeli inalenga kwanza kutambua maeneo yanayowezekana, kisha kutoa sababu kuhusu mwonekano wa kioptiki, na hatimaye kutoa hitimisho lenye muundo, badala ya kutoa lebo ya darasa pekee.
Coordinates za bounding-box katika mifano hii ya supplementary hazijahamishwa kwenye makala hii ya Verianla; kwa sababu picha ghafi na coordinate output ya kila mfano si lazima kwa msomaji kuelewa matokeo makuu ya kisayansi, na ni salama zaidi kueleza mantiki ya mbinu badala ya kuchapisha upya picha za chanzo.
Je, QF-Bench yote imechapishwa?
Supplementary material inaeleza kuwa kutokana na ukubwa wa data, ni mifano 50 pekee ya QF-Bench iliyochapishwa katika toleo hilo. Muundo wa release uko katika format ya COCO JSON na hutumia fields za kiwango cha juu kama `images`, `annotations` na `categories`. Kila flake ina anoteshini ya bounding-box.
Matokeo ya QuPAINT Yanapaswa Kutafsiriwaje?
Matokeo ya QuPAINT yanaonyesha kuwa uzalishaji sintetiki wenye msingi wa fizikia na representation ya multimodal yenye taarifa ya fizikia hutoa utendaji mzuri katika majaribio ya QF-Bench na instruction-grounding ya utafiti; hata hivyo, matokeo haya hayathibitishi kuwa makadirio yanayotokana na picha ya kioptiki yanaweza kuchukua nafasi ya AFM, Raman au vipimo vingine vya kifizikia katika hali zote, kwamba thamani zile zile za AP zitahifadhiwa katika maabara mpya, au kwamba modeli imegundua nyenzo mpya za kwanta.
Nguvu za utafiti
Utafiti haukabili tatizo la uhaba wa data kwa “modeli kubwa zaidi ya akili bandia” pekee. Katika uzalishaji wa data, unajaribu kuongeza uhalisia wa kifizikia wa synthetic data kwa kutumia fizikia ya filamu nyembamba inayotegemea TMM, marekebisho ya white-balance na uwekaji wa substrate-aware.
PIA hutumia CIELAB contrast kama proxy ya kifizikia bila kuhitaji full optical model kuendeshwa tena katika kila inference patch. Mbinu hii huunda muundo mseto kati ya data-driven attention kamili na modeli ya fizikia iliyowekwa kabisa.
Chanzo hakichunguzi tu general flake detection bali pia mono-layer detection yenye contrast ya chini zaidi. Hivyo utendaji wa wastani wa madarasa rahisi hauwezi kuficha makosa katika tatizo gumu zaidi la tabaka moja.
Model scaling, instruction grounding na ablation ya PAD/PIA zimeripotiwa kando. Kwa hiyo, angalau katika kiwango cha benchmark, inaweza kuchunguzwa kila kipengele kinachangia kwa kiwango gani.
Mapungufu makuu ya utafiti
Synthetic-to-real domain gap: Hata kama Synthia ina msingi wa fizikia, haiwezi kuzalisha upya aina zote za hadubini, kamera, illumination, contamination, flake zilizovunjika/kupasuka na kasoro nyingine halisi.
Kikomo cha token: Katika picha zenye msongamano mkubwa sana, idadi ya flake na kiasi cha token za kuona vinaweza kuzidi uwezo wa context/token wa modeli za multimodal zilizopo.
Kutokuwiana kwa data: Katika jedwali la QF-Bench, kategoria ya Thick ni kubwa sana kwa idadi kuliko madarasa ya Mono na Few. Chanzo kinafanya kutokuwiana huku kuonekane katika jedwali lakini hakitatui athari zote zinazowezekana za class-imbalance kwa uchanganuzi tofauti wa kitakwimu.
Kikomo cha uthibitishaji wa kifizikia: Tokeo la QuPAINT linategemea picha ya kioptiki. Si sahihi kuchukulia bounding box au tafsiri ya layer ya modeli kama kipimo cha moja kwa moja cha unene wa kimwili.
Kuripoti takwimu: Chanzo kinaripoti metrics za benchmark kama AP, Acc@50 na Acc@75; confidence interval, p-value au run-to-run standard deviation hazitolewi katika majedwali makuu ya utendaji. Kwa hiyo Verianla haiongezi dai la statistical significance ambalo halipo katika chanzo.
Ufafanuzi wa kategoria: Mipaka ya “Few = 2–5” na “Thick = 5+” katika maandishi makuu ya QF-Bench inaingiliana kwenye tabaka 5 na chanzo hakitatui mpaka huu wazi katika PDF hii.
Matokeo yanayoungwa mkono na utafiti
Chanzo kinaonyesha wazi kwamba Synthia hutoa mbinu ya physics-based synthetic generation inayounganisha TMM, CIE color conversion, white-balance correction na substrate-aware placement.
Inaripotiwa kwamba QMat-Instruct ilizalisha jumla ya 400.000 physics-aware multimodal training sample katika nyenzo nane.
Milinganyo ya mbinu inaonyesha kwamba PIA hutumia alama ya contrast inayotegemea CIELAB \(\Delta E\) kwenye visual embeddings kupitia affine calibration inayoweza kujifunzwa.
Inaripotiwa kwamba variants za QuPAINT hutoa thamani za juu zaidi za general na mono-layer AP kuliko detector zilizolinganishwa katika Table 4 ya chanzo.
Matumizi ya PAD na PIA pamoja hutoa thamani za AP zilizo juu zaidi katika jedwali la ablation kuliko configurations zinazotumia kila kipengele peke yake.
Ujumlishaji ambao utafiti hauungi mkono
Utafiti hautumii kompyuta ya kwanta au algorithm ya kwanta kufanya uchanganuzi wa picha.
Utafiti hauonyeshi kwamba modeli huamua idadi ya tabaka za atomu kutoka picha ya kioptiki bila kosa katika nyenzo zote na hali zote za hadubini.
Utafiti hauonyeshi kwamba AFM au mbinu nyingine huru za characterization ya nyenzo zimekuwa zisizo za lazima.
Utafiti hauhakikishi kwamba thamani za AP katika Table 4 zitabaki zile zile katika maabara tofauti.
Utafiti hauthibitishi kwamba physics-informed attention imejifunza kweli mekanizimu yote ya kifizikia; unaonyesha mchango wake katika utendaji wa benchmark.
Utafiti hauripoti kuwa umesanisi nyenzo mpya ya kwanta au kugundua awamu mpya ya kifizikia.
Maelezo ya Chanzo na Mbinu
Kichwa asili: QuPAINT: Physics-Aware Instruction Tuning Approach to Quantum Material Discovery
Waandishi: Xuan-Bac Nguyen, Hoang-Quan Nguyen, Sankalp Pandey, Tim Faltermeier, Nicholas Borys, Hugh Churchill, Khoa Luu.
Mpangilio wa waandishi: Umehifadhiwa kama ulivyotolewa katika chanzo.
Mchango sawa: Katika PDF iliyopakiwa, taarifa ya mchango sawa/mwandishi mwenza wa kwanza haijawekewa alama wazi.
Corresponding author: PDF iliyopakiwa inatoa anwani kadhaa za barua pepe lakini haitambui corresponding author mmoja kwa wazi kwa nyota au maelezo tofauti; kwa hiyo hakuna taarifa iliyobuniwa.
Taasisi 1: CVIU Lab, University of Arkansas, USA.
Taasisi 2: University of Utah, USA.
Taasisi 3: Department of Physics, University of Arkansas, USA.
Aina ya chanzo kilichopakiwa: arXiv preprint, v1.
arXiv: arXiv:2602.17478v1 [cs.CV].
Tarehe ya kwanza ya kutumwa arXiv: 19 Februari 2026.
arXiv-issued DOI: 10.48550/arXiv.2602.17478.
Hali ya sasa ya uchapishaji: Utafiti ulichapishwa baadaye kama makala ya mkutano iliyopitiwa na wenzao katika proceedings za IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR) Findings 2026.
Mwaka wa uchapishaji wa CVPR: 2026.
Mwezi wa uchapishaji wa CVPR: Juni 2026.
Masafa ya kurasa za proceedings: 8684–8694.
CVPR proceedings DOI: Haijatolewa kwa sababu haikuweza kuthibitishwa katika rekodi rasmi ya kuaminika.
Ukurasa rasmi wa uchapishaji wa CVF: https://openaccess.thecvf.com/content/CVPR2026F/html/Nguyen_QuPAINT_Physics-Aware_Instruction_Tuning_Approach_to_Quantum_Material_Discovery_CVPRF_2026_paper.html
Ukurasa wa mradi: https://uark-cviu.github.io/projects/qupaint/
Hali ya peer review: arXiv v1 iliyopakiwa yenyewe ni preprint; kwa kuwa utafiti baadaye ulichapishwa katika CVPR 2026 Findings, hali ya sasa ya kazi ni chapisho la mkutano lililopitiwa na wenzao.
Eneo la kisayansi: Computer vision, multimodal machine learning, two-dimensional quantum materials na optical microscopy.
Aina ya utafiti: Physics-informed machine-learning development ya mbinu + uzalishaji wa data sintetiki + tathmini ya benchmark ya data halisi/sintetiki ya microscopy.
Matumizi ya kompyuta ya kwanta: Hakuna. “Quantum” inarejelea darasa la nyenzo linalochunguzwa.
Synthia: Hutumia Transfer Matrix Method-based thin-film interference simulation, CIE 1931 color conversion, personalized white-balance correction na substrate-aware synthetic placement.
QMat-Instruct: Inawasilishwa katika chanzo kama physics-aware instruction dataset ya kwanza ya kiwango kikubwa katika eneo hili. Sample 50.000 kwa kila moja ya nyenzo nane, jumla ya sample 400.000, zimeripotiwa.
QuPAINT: Ni mfumo wa multimodal unaokalibisha visual embeddings za Vision Transformer kwa alama za Physics-Informed Attention na kuziunganisha na text embeddings katika MLLM decoder.
PIA: Hutumia umbali wa \(\Delta E\) kati ya rangi ya median ya flake/patch na rangi ya median ya substrat katika nafasi ya CIELAB kama physics-aware proxy.
QF-Bench: Table 2 ya chanzo inaripoti flake 280.526 zenye anoteshini katika nyenzo nane.
Hali ya release ya QF-Bench: Supplementary material inaeleza kuwa kwa sababu ya ukubwa wa data, mifano 50 ilichapishwa katika toleo hilo na format ni COCO JSON.
Ukubwa wa picha za mafunzo: 448×448.
Patch: Patch za 14×14 zisizoingiliana.
Vision implementation: InternViT.
Text encoder initialization: Qwen3.
Optimizer: AdamW.
Learning rate: \(2\times10^{-5}\).
Weight decay: \(1\times10^{-4}\).
Batch size: 4.
Epoch: 2.
Vifaa vya mafunzo: 16 A100 GPU.
Data augmentation: Random cropping, horizontal flipping na CIELAB color jitter.
Inference temperature: \(T=0.2\).
Matokeo ya juu zaidi ya general detection katika Table 4: Kwa QuPAINT-8B, 45,6 AP, 60,5 AP50 na 47,9 AP75.
Matokeo ya juu zaidi ya mono detection katika Table 4: Kwa QuPAINT-8B, 37,3 AP, 52,8 AP50 na 39,9 AP75.
Instruction grounding: Kwa QuPAINT-2B, Acc@50 = 51,4 na Acc@75 = 39,5.
Ablation: PAD + PIA pamoja hutoa 34,1 AP, 50,2 AP50 na 38,0 AP75.
Utofauti wa YOLO ndani ya chanzo: Table 4 inatoa YOLOv11-x na thamani za 29,6/19,8 AP, huku baadhi ya sentensi za maandishi makuu ya matokeo zikionyesha YOLOv8-x na 28,3/19,0. Verianla imehifadhi thamani za kiasi zinazoonekana katika jedwali.
Utofauti wa istilahi wa PIA/PAD ndani ya chanzo: Katika mbinu yote jina canonical ni Physics-Informed Attention, lakini sehemu ya 6.3 hutumia upanuzi tofauti mahali pamoja. Jina la PAD pia halilingani kikamilifu kati ya maandishi na caption.
Mpaka wa layer-category ndani ya chanzo: Kwa kuwa maandishi makuu yanaandika Few = 2–5 na Thick = 5+, mpaka wa 5-layer haueleweki. Hakuna marekebisho ya kimya kimya yaliyofanywa.
Ufadhili: Chanzo kinataja msaada wa MonArk NSF Quantum Foundry chini ya programu ya National Science Foundation QAMASE-i, NSF Award No. DMR-1906383.
Msaada wa miundombinu ya kukokotoa: Rasilimali za GPU za Arkansas High-Performance Computing Center.
Data Availability: PDF haina kichwa tofauti cha formal Data Availability; supplementary material inaeleza kwamba mifano 50 ya QF-Bench ilichapishwa katika format ya COCO JSON.
Code Availability: PDF iliyopakiwa haina formal Code Availability statement tofauti; URL ya mradi imetolewa.
Mgongano wa maslahi: Katika PDF iliyopakiwa hakuna conflict-of-interest / competing-interest statement tofauti iliyotambuliwa; kwa hiyo haijadhaniwa kuwa “hakuna mgongano wa maslahi”.
Michango ya waandishi: Katika PDF iliyopakiwa hakuna CRediT au author-contribution statement tofauti iliyotambuliwa.
Leseni: Kwenye PDF iliyopakiwa na CVF landing page iliyothibitishwa, hakuna leseni wazi ya Creative Commons iliyothibitishwa ambayo ingeweza kuhalalisha kwa uhakika matumizi ya moja kwa moja ya tena ya vielelezo kwa Verianla. Open access haijachukuliwa moja kwa moja kuwa ruhusa ya matumizi ya tena bila kikomo.
Kikomo kikuu cha tafsiri: Utafiti unaonyesha utendaji wa benchmark wa physics-aware AI characterization katika picha za hadubini ya macho; si ushahidi wa kuchukua nafasi bila masharti ya mbinu huru za kupima unene wa kimwili, kujumlisha kwa utendaji ule ule katika maabara zote, au kugundua nyenzo mpya ya kwanta.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *