

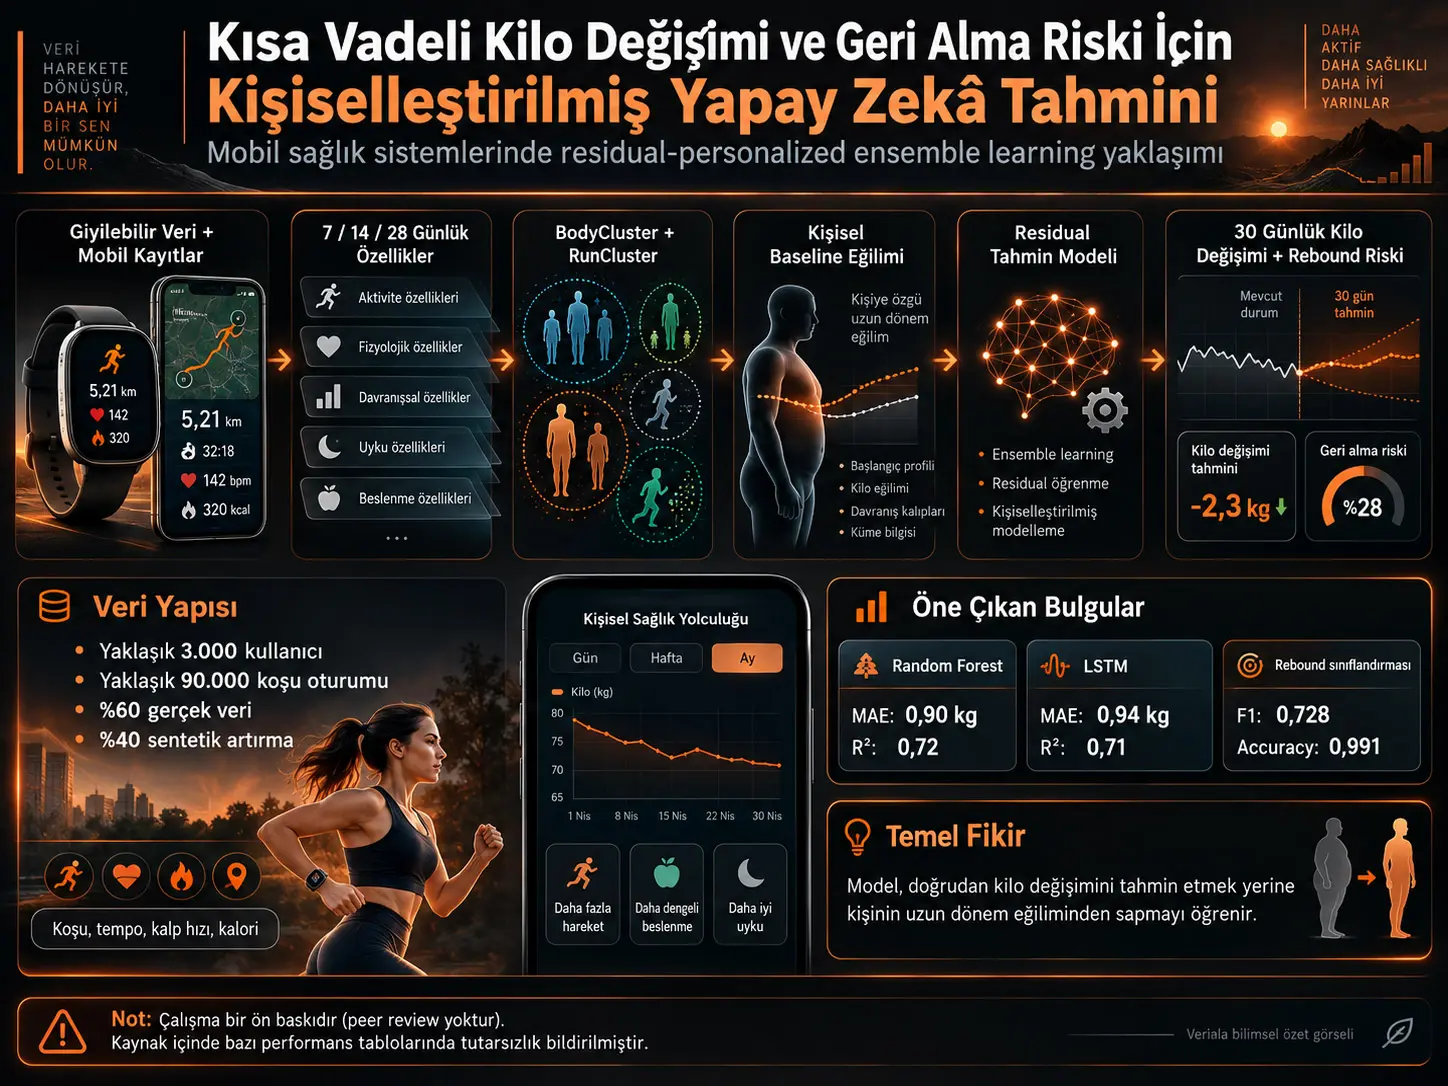
Giyilebilir cihazlar koşu mesafesi, süre, tempo, kalp hızı ve tahmini kalori tüketimi gibi çok miktarda davranışsal veri üretebilir. Ancak bu verilerin çoğu fitness uygulamasında geçmiş aktivitenin özetlenmesi için kullanılır. Bu çalışma, aynı verileri kullanarak bir kullanıcının önümüzdeki 30 günlük vücut ağırlığı değişimini ve en az 1 kg'lık kısa vadeli kilo artışı riskini tahmin etmeye çalışan bir makine öğrenmesi çerçevesi önermektedir.
Çalışmanın temel yaklaşımı doğrudan kilo değişimini tahmin etmek yerine her kullanıcı için önce kişisel bir uzun dönem kilo eğimi hesaplamak, ardından makine öğrenmesi modeline yalnızca bu temel eğilimden sapmayı tahmin ettirmektir. Yazarlar bu yöntemi residual personalization olarak adlandırmaktadır.
Kaynak veri setinde yaklaşık 3.000 kullanıcı ve 90.000 geçerli koşu oturumu bulunmaktadır. Ancak veri setinin yaklaşık %60'ı gerçek giyilebilir cihaz kayıtlarından, yaklaşık %40'ı ise seyrek davranış ve rebound örüntülerini artırmak amacıyla sentetik olarak oluşturulmuş kullanıcı yörüngelerinden oluşmaktadır.
Kullanıcı davranışı 7, 14 ve 28 günlük geriye dönük pencerelerde özetlenmiş; yaş, boy ve kilo üzerinden BodyCluster, koşu davranışı üzerinden RunCluster değişkenleri üretilmiştir. Linear Regression, SVR, Random Forest, BP–MLP ve LSTM modelleri karşılaştırılmıştır.
Kaynağın temel performans tablosunda Random Forest için MAE = 0,90 kg ve R² = 0,72; LSTM için MAE = 0,94 kg ve R² = 0,71 raporlanmaktadır. Rebound sınıflandırmasında Random Forest accuracy = 0,991 ve F1 = 0,728 olarak verilmiştir.
Ancak makale içinde önemli bir sayısal raporlama sorunu bulunmaktadır. Başka bir tabloda aynı 30 günlük tahmin problemi için residual Random Forest MAE değeri 0,143 kg olarak verilmektedir. Çalışma bu yaklaşık altı katlık farkı açıklamamaktadır. Dolayısıyla performans sayıları bağımsız dış doğrulama yapılmadan kesin bir ürün doğruluğu olarak değerlendirilmemelidir.
Neden herkes için tek bir kilo tahmin modeli yeterli olmayabilir?
İnsanların kilo değişimi aynı egzersize aynı biçimde yanıt vermez. Başlangıç ağırlığı, vücut yapısı, alışılmış aktivite düzeyi, enerji dengesi ve çok sayıda fizyolojik unsur kişiler arasında farklıdır.
Bu nedenle aynı miktarda koşu yapan iki kişinin 30 günlük ağırlık eğilimi farklı olabilir.
Çalışmanın önerdiği residual-personalization yaklaşımı bu farkı modelin tahmin etmek zorunda olduğu toplam sinyalden ayırmaya çalışır.
Kişisel baseline nasıl hesaplandı?
Her kullanıcı için zaman içindeki kilo verisine doğrusal bir OLS eğilimi uygulanmıştır:
\[ \hat w_{u,t}=\alpha_u t+\beta_u. \]
Burada \(\alpha_u\), kullanıcının günlük ortalama kilo değişim eğimini temsil eder.
30 günlük beklenen temel değişim:
\[ 30\alpha_u \]
olarak hesaplanır.
Modelin öğrenmeye çalıştığı residual hedef:
\[ \Delta w'_{u,t} = (w_{u,t+30}-w_{u,t}) - 30\alpha_u. \]
Bu işlem modelin kişiden kişiye değişen uzun dönem trend yerine kısa dönem davranış değişikliklerine odaklanmasını amaçlar.
Koşu Davranışı Modele Nasıl Aktarıldı?
Her kullanıcı için geçmiş koşu kayıtları 7, 14 ve 28 günlük geriye dönük zaman pencerelerinde özetlenmiştir.
Temel özellikler:
- toplam koşu mesafesi,
- toplam koşu süresi,
- toplam kalorik harcama,
- ortalama tempo,
- ortalama kalp hızı.
Ayrıca hız, kilometre başına enerji tüketimi ve kilo/boy oranı gibi türetilmiş göstergeler kullanılmıştır.
Bu çok ölçekli yapı, yalnız son birkaç koşuyu değil kısa ve orta vadeli egzersiz düzenini aynı modelde temsil etmeyi amaçlar.
BodyCluster ve RunCluster Nedir?
Çalışma kullanıcı özelliklerini iki farklı kümelenme alanına ayırmıştır.
BodyCluster, yaş, boy ve kilo gibi daha sabit antropometrik özelliklerden türetilmiştir.
RunCluster, koşu mesafesi, süre, tempo ve enerji harcaması gibi davranışsal özelliklerden türetilmiştir.
K-Means analizinde hem Body hem Run alanında iki küme en yüksek silhouette değerini vermiştir.
Body için k=2 silhouette değeri 0,3088, Run için 0,3149'dur.
Ward hiyerarşik kümelemesi de iki baskın küme yapısını desteklemiştir.
Bu kümeler sağlık tanısı değildir. Bunlar yalnız modelin özellik uzayında bulduğu kullanıcı gruplarıdır.
30 Günlük Kilo Değişimi ve Rebound Riski Nasıl Tanımlandı?
Ana regresyon hedefi:
\[ \Delta W_{30}=W_{t+30}-W_t \]
olarak tanımlanmıştır.
Negatif sonuç kilo kaybını, pozitif sonuç kilo artışını temsil eder.
Çalışmadaki rebound-risk etiketi:
\[ \Delta W_{30}\ge1,0\text{ kg} \]
olması durumunda 1 olarak atanmıştır.
Dolayısıyla burada “rebound”, uzun dönem klinik kilo geri kazanımının kapsamlı tanımı değildir; yalnız 30 gün içinde en az 1 kg ağırlık artışını ifade eden model etiketidir.
Sentetik Veri Neden Kullanıldı?
Gerçek wearable kullanıcılarında kısa sürede belirgin kilo geri kazanımı gibi bazı olaylar seyrek görülebilir. Yazarlar bu nedenle veri çeşitliliğini artırmak ve rebound sınıfının temsilini güçlendirmek amacıyla sentetik kullanıcı yörüngeleri oluşturmuştur.
Sentetik kilo:
\[ W_{t+1}=W_t+\beta_u+\epsilon_t \]
stokastik modeliyle üretilmiştir.
Koşu özellikleri ise gerçek veri setinden hesaplanan çok değişkenli ortalama ve kovaryans yapısından örneklenmiştir.
Yazarlar gerçek ve sentetik özellik dağılımları için KS testleri uygulamış ve birçok özellikte α=0,05 düzeyinde anlamlı farklılık bulmadıklarını bildirmiştir.
Bununla birlikte sentetik verinin gerçek veriye benzer marjinal dağılım göstermesi, gerçek insan davranışının bütün zamansal, metabolik veya nedensel yapısının yeniden üretildiği anlamına gelmez.
Çalışmanın Yöntemi ve Bulguları
Veri seti
Yaklaşık 3.000 kullanıcı ve 90.000 geçerli koşu oturumu analiz edilmiştir. Kullanıcıların yaklaşık %60'ı gerçek wearable kayıtlarından, kalan yaklaşık %40'lık veri ise sentetik yörüngelerden oluşmaktadır.
Train / validation / test ayrımı
Veri kullanıcı düzeyinde %70 eğitim, %15 doğrulama ve %15 test olarak ayrılmıştır.
Bir kullanıcının bütün oturumları yalnız tek bir bölmede tutulmuş; böylece aynı kişinin kayıtlarının hem eğitim hem test setinde bulunmasının önüne geçilmeye çalışılmıştır.
Rolling windows
7, 14 ve 28 günlük geriye dönük özellik pencereleri oluşturulmuştur.
Modeller
- Linear Regression,
- Support Vector Regressor,
- Random Forest,
- BP–MLP,
- LSTM.
Makalenin ana regresyon tablosu
| Model | MAE (kg) | R² |
|---|---|---|
| Linear Regression | 1,35 | 0,48 |
| SVR | 1,02 | 0,65 |
| Random Forest | 0,90 | 0,72 |
| BP–MLP | 0,96 | 0,70 |
| LSTM | 0,94 | 0,71 |
Bu tabloya göre Random Forest en iyi sonucu vermiştir.
Sınıflandırma
| Görev | Model | Accuracy | F1 |
|---|---|---|---|
| Kilo kaybı | Logistic Regression | 0,877 | 0,862 |
| Kilo kaybı | Random Forest | 0,893 | 0,874 |
| Rebound | Logistic Regression | 0,986 | 0,703 |
| Rebound | Random Forest | 0,991 | 0,728 |
Body × Run çapraz özelliği
BodyCluster ve RunCluster'ın birlikte temsil edilmesi MAE'yi yaklaşık 0,05 kg azaltmış, R²'yi yaklaşık 0,03 yükseltmiştir.
Hedef dağılımı
| İstatistik | ΔW30 |
|---|---|
| N | 27.972 |
| Ortalama | 0,0226 kg |
| Standart sapma | 0,4947 kg |
| Minimum | −2,000 kg |
| Medyan | 0,0077 kg |
| Maksimum | 1,760 kg |
Kaynak içi performans tutarsızlığı
Makalenin Table 9'unda Linear Regression için raw ΔW30 MAE değeri 0,144 kg, residual Random Forest için 0,143 kg olarak raporlanmaktadır. Aynı makalenin Table 10'unda ise Linear Regression MAE = 1,35 kg ve Random Forest MAE = 0,90 kg olarak verilir.
Kaynak bu iki ölçeği nasıl uzlaştırdığını açıklamamaktadır. Dolayısıyla performans değerlerinin nihai ürün doğruluğu olarak kullanılmadan önce yazarlar tarafından açıklanması veya bağımsız biçimde yeniden üretilmesi gerekir.
Cramér's V raporlama notu
Makale BodyCluster ile RunCluster arasında V = 0,30 düzeyinde orta bir ilişki bildirmektedir. Ancak yayımlanan satır-normalize kontenjans tablosunda iki BodyCluster'ın Run dağılımları yaklaşık 53/47 oranında ve neredeyse aynıdır. Ham sayımlar sunulmadığı için bu katsayı Verianla tarafından bağımsız biçimde doğrulanamamaktadır.
Çalışmanın desteklediği sonuçlar
- Kişisel baseline eğilimini ayırıp residual tahmin kullanmak uygulanabilir bir kişiselleştirme yaklaşımıdır.
- Koşu davranışı farklı zaman pencerelerinde birleştirilerek kısa vadeli tahmin özellikleri üretilebilir.
- Kaynağın temel performans tablosunda nonlinear ve ensemble modeller linear regression'dan daha yüksek performans göstermektedir.
- Body ve Run bilgilerini birleştiren çapraz özellik küçük fakat tutarlı performans artışı göstermiştir.
- Random Forest, kaynak tablolarda test edilen modeller arasında en güçlü sonuçlardan birini vermektedir.
Çalışmanın desteklemediği sonuçlar
- Sistem klinik olarak doğrulanmış bir kilo yönetimi aracı değildir.
- Modelin gerçek dünyadaki her kullanıcıda yaklaşık 0,9 kg hata yaptığı kesin biçimde doğrulanmamıştır.
- %99 rebound accuracy, tek başına %99 güvenilir klinik risk tahmini anlamına gelmez.
- Koşu davranışının gözlenen kilo değişiminin nedeni olduğu bu çalışmayla kanıtlanmamıştır.
- Sentetik veri gerçek insan metabolizmasının eksiksiz simülasyonu değildir.
- BodyCluster veya RunCluster sağlık tanısı veya klinik kategori değildir.
- Prospektif, bağımsız ve uzun dönem klinik validasyon yapılmamıştır.
Kaynak ve Yöntem Notu
Özgün çalışma:Residual-Personalized Ensemble Learning for Short-Term Weight Change and Rebound Risk Prediction in Mobile Health Systems
Yazarlar: Khasherdene Baasankhuu; Yanpeng Qu.
Kurum: Dalian Maritime University.
Kaynak: SSRN preprint.
30 sayfalık sürümün SSRN yayın tarihi: 19 Haziran 2026.
SSRN DOI: 10.2139/ssrn.6958925
Hakemlik durumu: Preprint; kaynak PDF açıkça “not peer reviewed” olarak işaretlenmiştir.
Lisans: All rights reserved; no reuse allowed without permission.
Çıkar çatışması: SSRN kaydında yazarlar rekabet eden finansal veya kişisel çıkar bildirmemektedir.
Finansman: SSRN kaydı dış finansman alınmadığını bildirmektedir.
Veri yapısı: Yaklaşık 3.000 kullanıcı, yaklaşık 90.000 koşu oturumu; yaklaşık %60 gerçek wearable verisi ve %40 sentetik augmentation.
Temel yöntemsel sınırlılıklar: Veri kaynağının önemli bölümü sentetiktir; bağımsız dış kohort doğrulaması gösterilmemiştir; diyet, ilaç, hastalık, uyku ve diğer önemli kilo belirleyicileri modelde kapsamlı biçimde temsil edilmemektedir; performans tabloları arasında açıklanmayan sayısal uyuşmazlık vardır; cluster-association tablosuyla raporlanan Cramér's V değeri arasında görünür bir tutarlılık sorunu bulunmaktadır; rebound sınıfı çalışmaya özgü ≥1 kg / 30 gün eşiğidir.
Verianla anlatım ilkesi: Bu içerik kaynak preprintin tam metin çevirisi değildir. Model tasarımı, veri yapısı, sentetik augmentation, performans sonuçları ve kaynak içi belirsizlikler korunmuş; çalışma bağımsız ve eleştirel bir öğretici yapı içinde yeniden anlatılmıştır. Akademik kullanımda ve model performansının yeniden değerlendirilmesinde özgün preprint ile mümkünse kod/veri çıktıları birlikte incelenmelidir.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir